Comprendre les modèles de langage et de vision et leurs applications
Découvre les modèles de langage et de vision, leur fonctionnement et leurs nombreuses applications en IA. Découvre comment ces modèles combinent les capacités visuelles et linguistiques.
Dans un article précédent, nous avons exploré comment GPT-4o peut comprendre et décrire des images avec des mots. Nous observons également cette capacité dans d’autres nouveaux modèles, comme Google Gemini et Claude 3. Aujourd’hui, nous approfondissons ce concept pour expliquer le fonctionnement des modèles vision-langage et la manière dont ils combinent données visuelles et textuelles.
Ces modèles peuvent réaliser toute une série de tâches impressionnantes, comme générer des légendes détaillées pour des photos, répondre à des questions sur des images et même créer du nouveau contenu visuel à partir de descriptions textuelles. En intégrant harmonieusement les informations visuelles et linguistiques, les modèles vision-langage changent notre façon d’interagir avec la technologie et de comprendre le monde qui nous entoure.
Fonctionnement des modèles vision-langage#
Avant d’examiner les applications des modèles vision-langage (VLM), voyons ce qu’ils sont et comment ils fonctionnent. Les VLM sont des modèles d’IA avancés qui combinent les capacités des modèles de vision et de langage pour traiter à la fois des images et du texte. Ils reçoivent des images accompagnées de leurs descriptions textuelles et apprennent à établir des liens entre les deux. La composante visuelle du modèle extrait les détails des images, tandis que la composante linguistique comprend le texte. Cette collaboration permet aux VLM de comprendre et d’analyser aussi bien les images que le texte.
Voici les principales capacités des modèles vision-langage :
- Génération de légendes d’images : Générer un texte descriptif à partir du contenu des images.
- Questions-réponses visuelles (VQA) : Répondre aux questions portant sur le contenu d’une image.
- Génération d’images à partir de texte : Créer des images à partir de descriptions textuelles.
- Recherche croisée texte-image : Trouver les images pertinentes à partir d’une requête textuelle, et inversement.
- Création de contenu multimodal : Combiner des images et du texte pour générer du nouveau contenu.
- Compréhension de scène et détection d’objets : Identifier et catégoriser les objets et les détails présents dans une image.
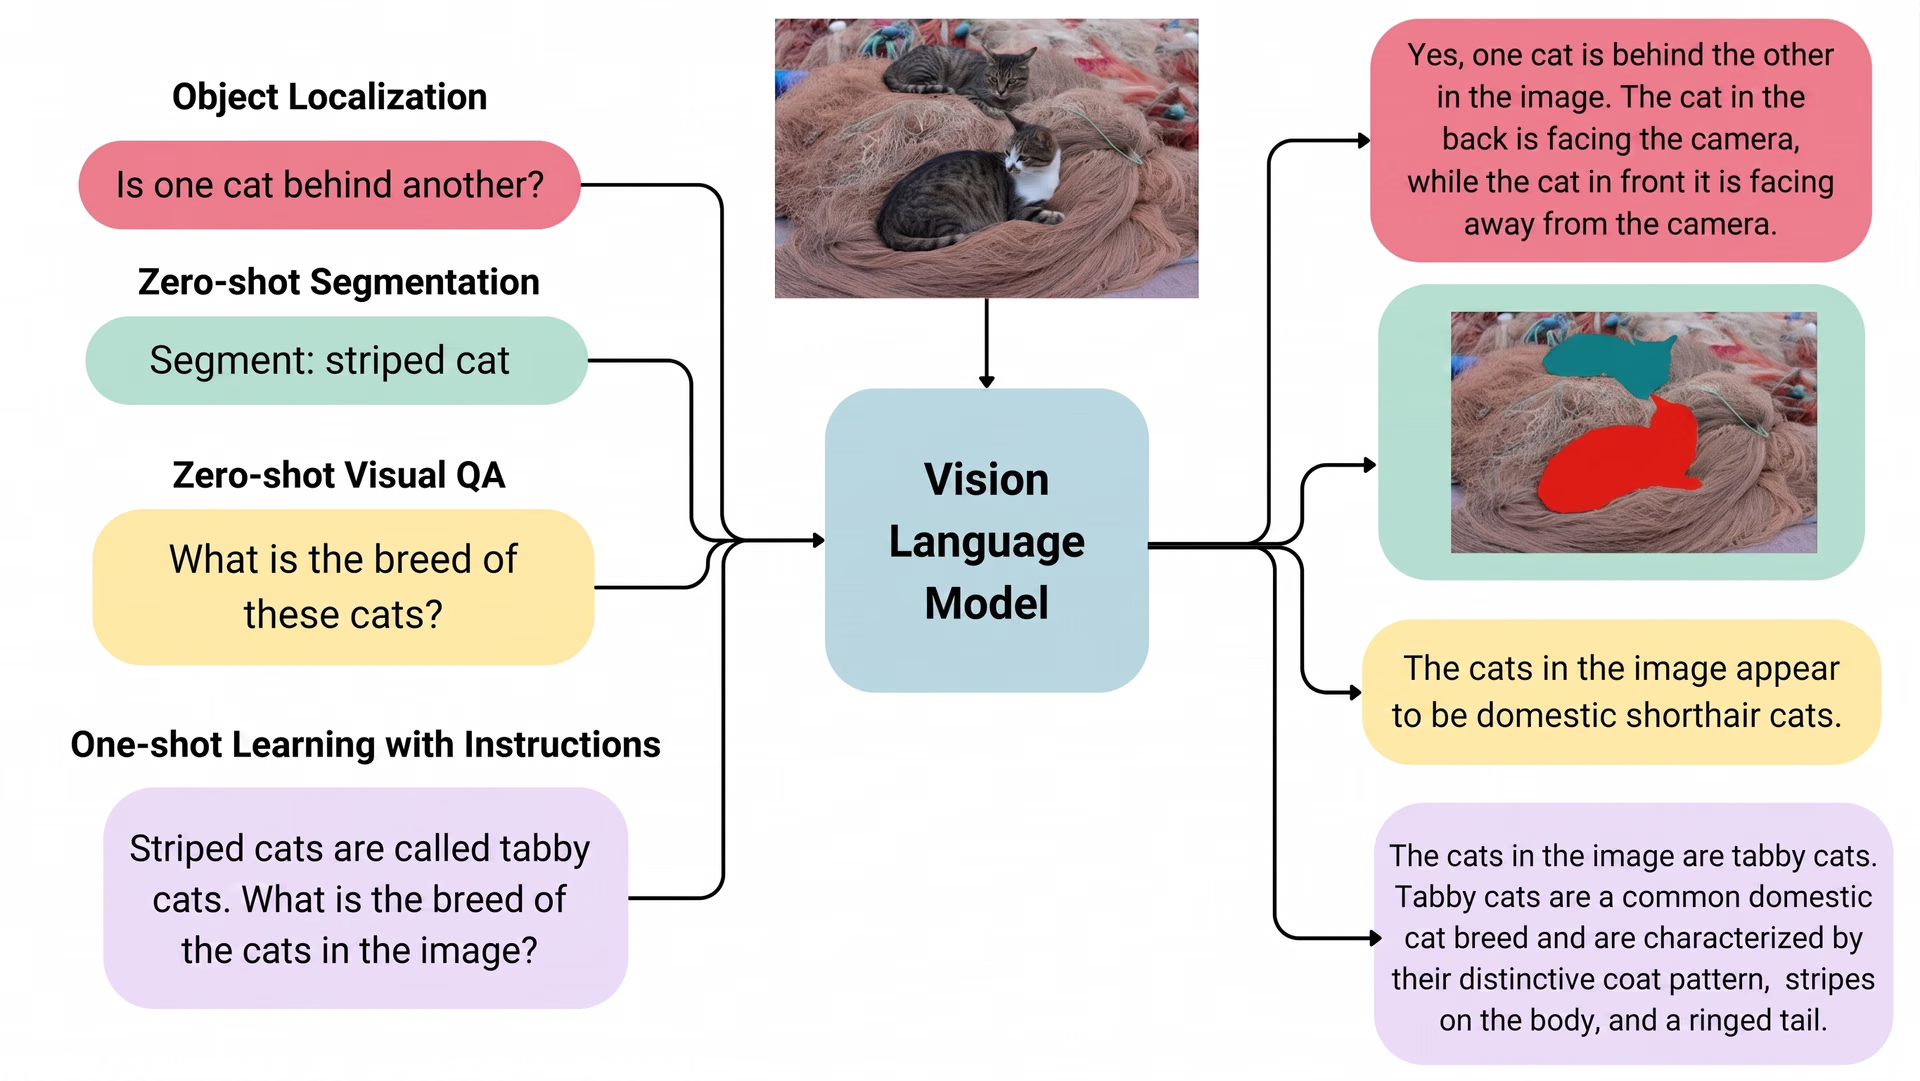
Fig. 1. Exemple des capacités d’un modèle vision-langage.
Voyons maintenant les architectures VLM courantes et les techniques d’apprentissage utilisées par des modèles connus comme CLIP, SimVLM et VisualGPT.
Apprentissage contrastif#
L’apprentissage contrastif est une technique qui permet aux modèles d’apprendre en comparant les différences entre des points de données. Il calcule le degré de similarité ou de différence entre les exemples et cherche à minimiser la perte contrastive, qui mesure ces différences. Cette approche est particulièrement utile en apprentissage semi-supervisé, où un petit ensemble d’exemples étiquetés aide le modèle à étiqueter de nouvelles données qu’il n’a pas encore vues. Par exemple, pour comprendre à quoi ressemble un chat, le modèle le compare à des images de chats similaires et à des images de chiens. En repérant des caractéristiques comme la structure du visage, la taille du corps et le pelage, les techniques d’apprentissage contrastif permettent de distinguer un chat d’un chien.
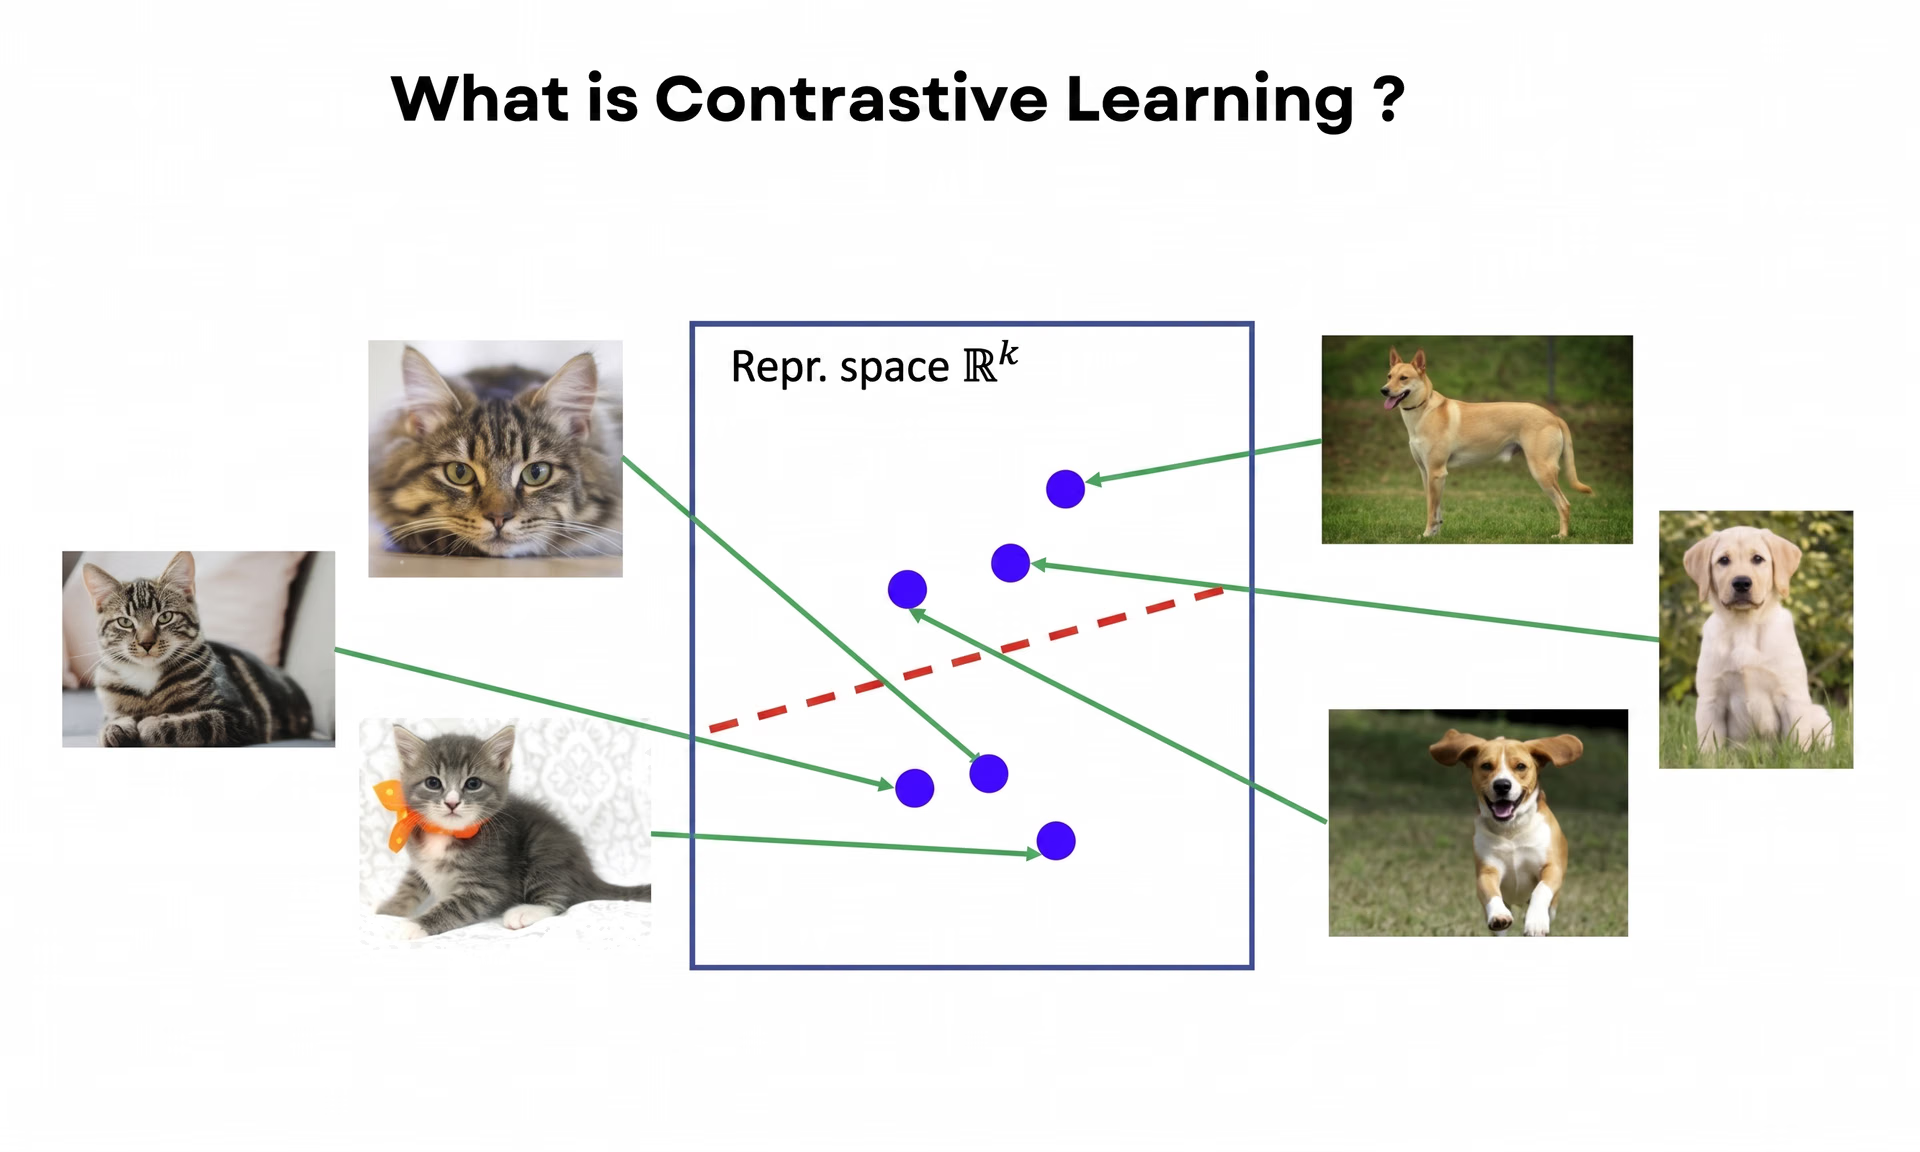
Fig. 2. Fonctionnement de l’apprentissage contrastif.
CLIP est un modèle vision-langage qui utilise l’apprentissage contrastif pour associer des descriptions textuelles à des images. Son fonctionnement repose sur trois étapes simples. D’abord, il entraîne les composants du modèle qui comprennent le texte et les images. Ensuite, il convertit les catégories d’un jeu de données en descriptions textuelles. Enfin, il identifie la description qui correspond le mieux à une image donnée. Grâce à cette méthode, le modèle CLIP peut produire des prédictions précises, même pour des tâches sur lesquelles il n’a pas été spécifiquement entraîné.
PrefixLM#
PrefixLM est une technique de traitement automatique du langage naturel (NLP) utilisée pour entraîner des modèles. Elle commence par une partie de phrase (un préfixe) et apprend à prédire le mot suivant. Dans les modèles vision-langage, PrefixLM aide le modèle à prédire les mots suivants à partir d’une image et d’un fragment de texte donné. Elle utilise un Vision Transformer (ViT), qui divise une image en petites zones, chacune représentant une partie de l’image, puis les traite dans l’ordre.
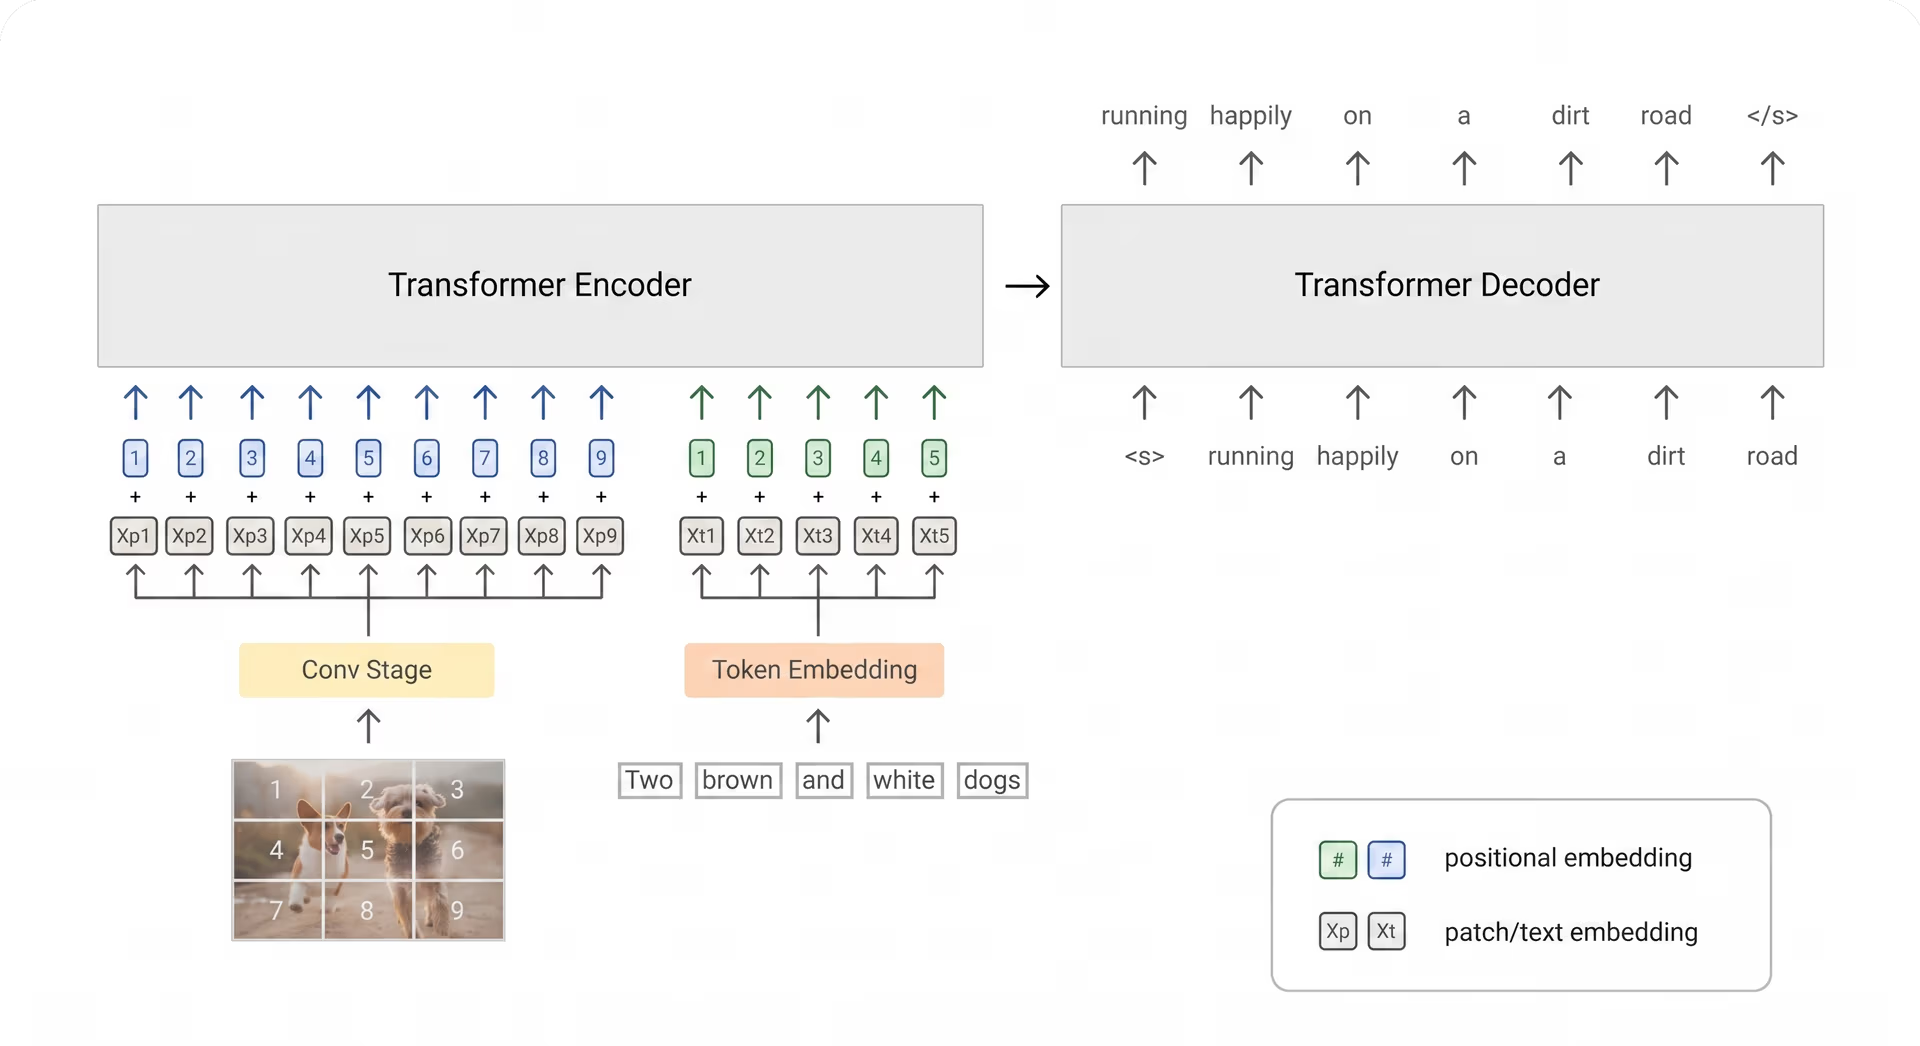
Fig. 3. Exemple d’entraînement d’un VLM utilisant la technique PrefixLM.
SimVLM est un VLM qui utilise la technique d’apprentissage PrefixLM. Il repose sur une architecture Transformer plus simple que celle des modèles précédents, tout en obtenant de meilleurs résultats lors de différents tests. Son architecture apprend à associer des images à des préfixes textuels à l’aide d’un encodeur Transformer, puis à générer du texte avec un décodeur Transformer.
Fusion multimodale par attention croisée#
La fusion multimodale par attention croisée est une technique qui améliore la capacité d’un modèle vision-langage préentraîné à comprendre et à traiter des données visuelles. Elle consiste à ajouter des couches d’attention croisée au modèle, ce qui lui permet de prêter attention simultanément aux informations visuelles et textuelles.
Voici comment cela fonctionne :
- Les objets importants d’une image sont identifiés et mis en évidence.
- Les objets mis en évidence sont traités par un encodeur visuel, qui convertit les informations visuelles dans un format que le modèle peut comprendre.
- Les informations visuelles sont transmises à un décodeur, qui interprète l’image en s’appuyant sur les connaissances du modèle de langage préentraîné.
VisualGPT est un bon exemple de modèle qui utilise cette technique. Il comprend une fonctionnalité spéciale appelée unité d’activation à auto-rétablissement (SRAU), qui aide le modèle à éviter un problème courant appelé disparition du gradient. La disparition du gradient peut entraîner la perte d’informations importantes par les modèles pendant l’entraînement, mais SRAU permet au modèle de maintenir de bonnes performances.
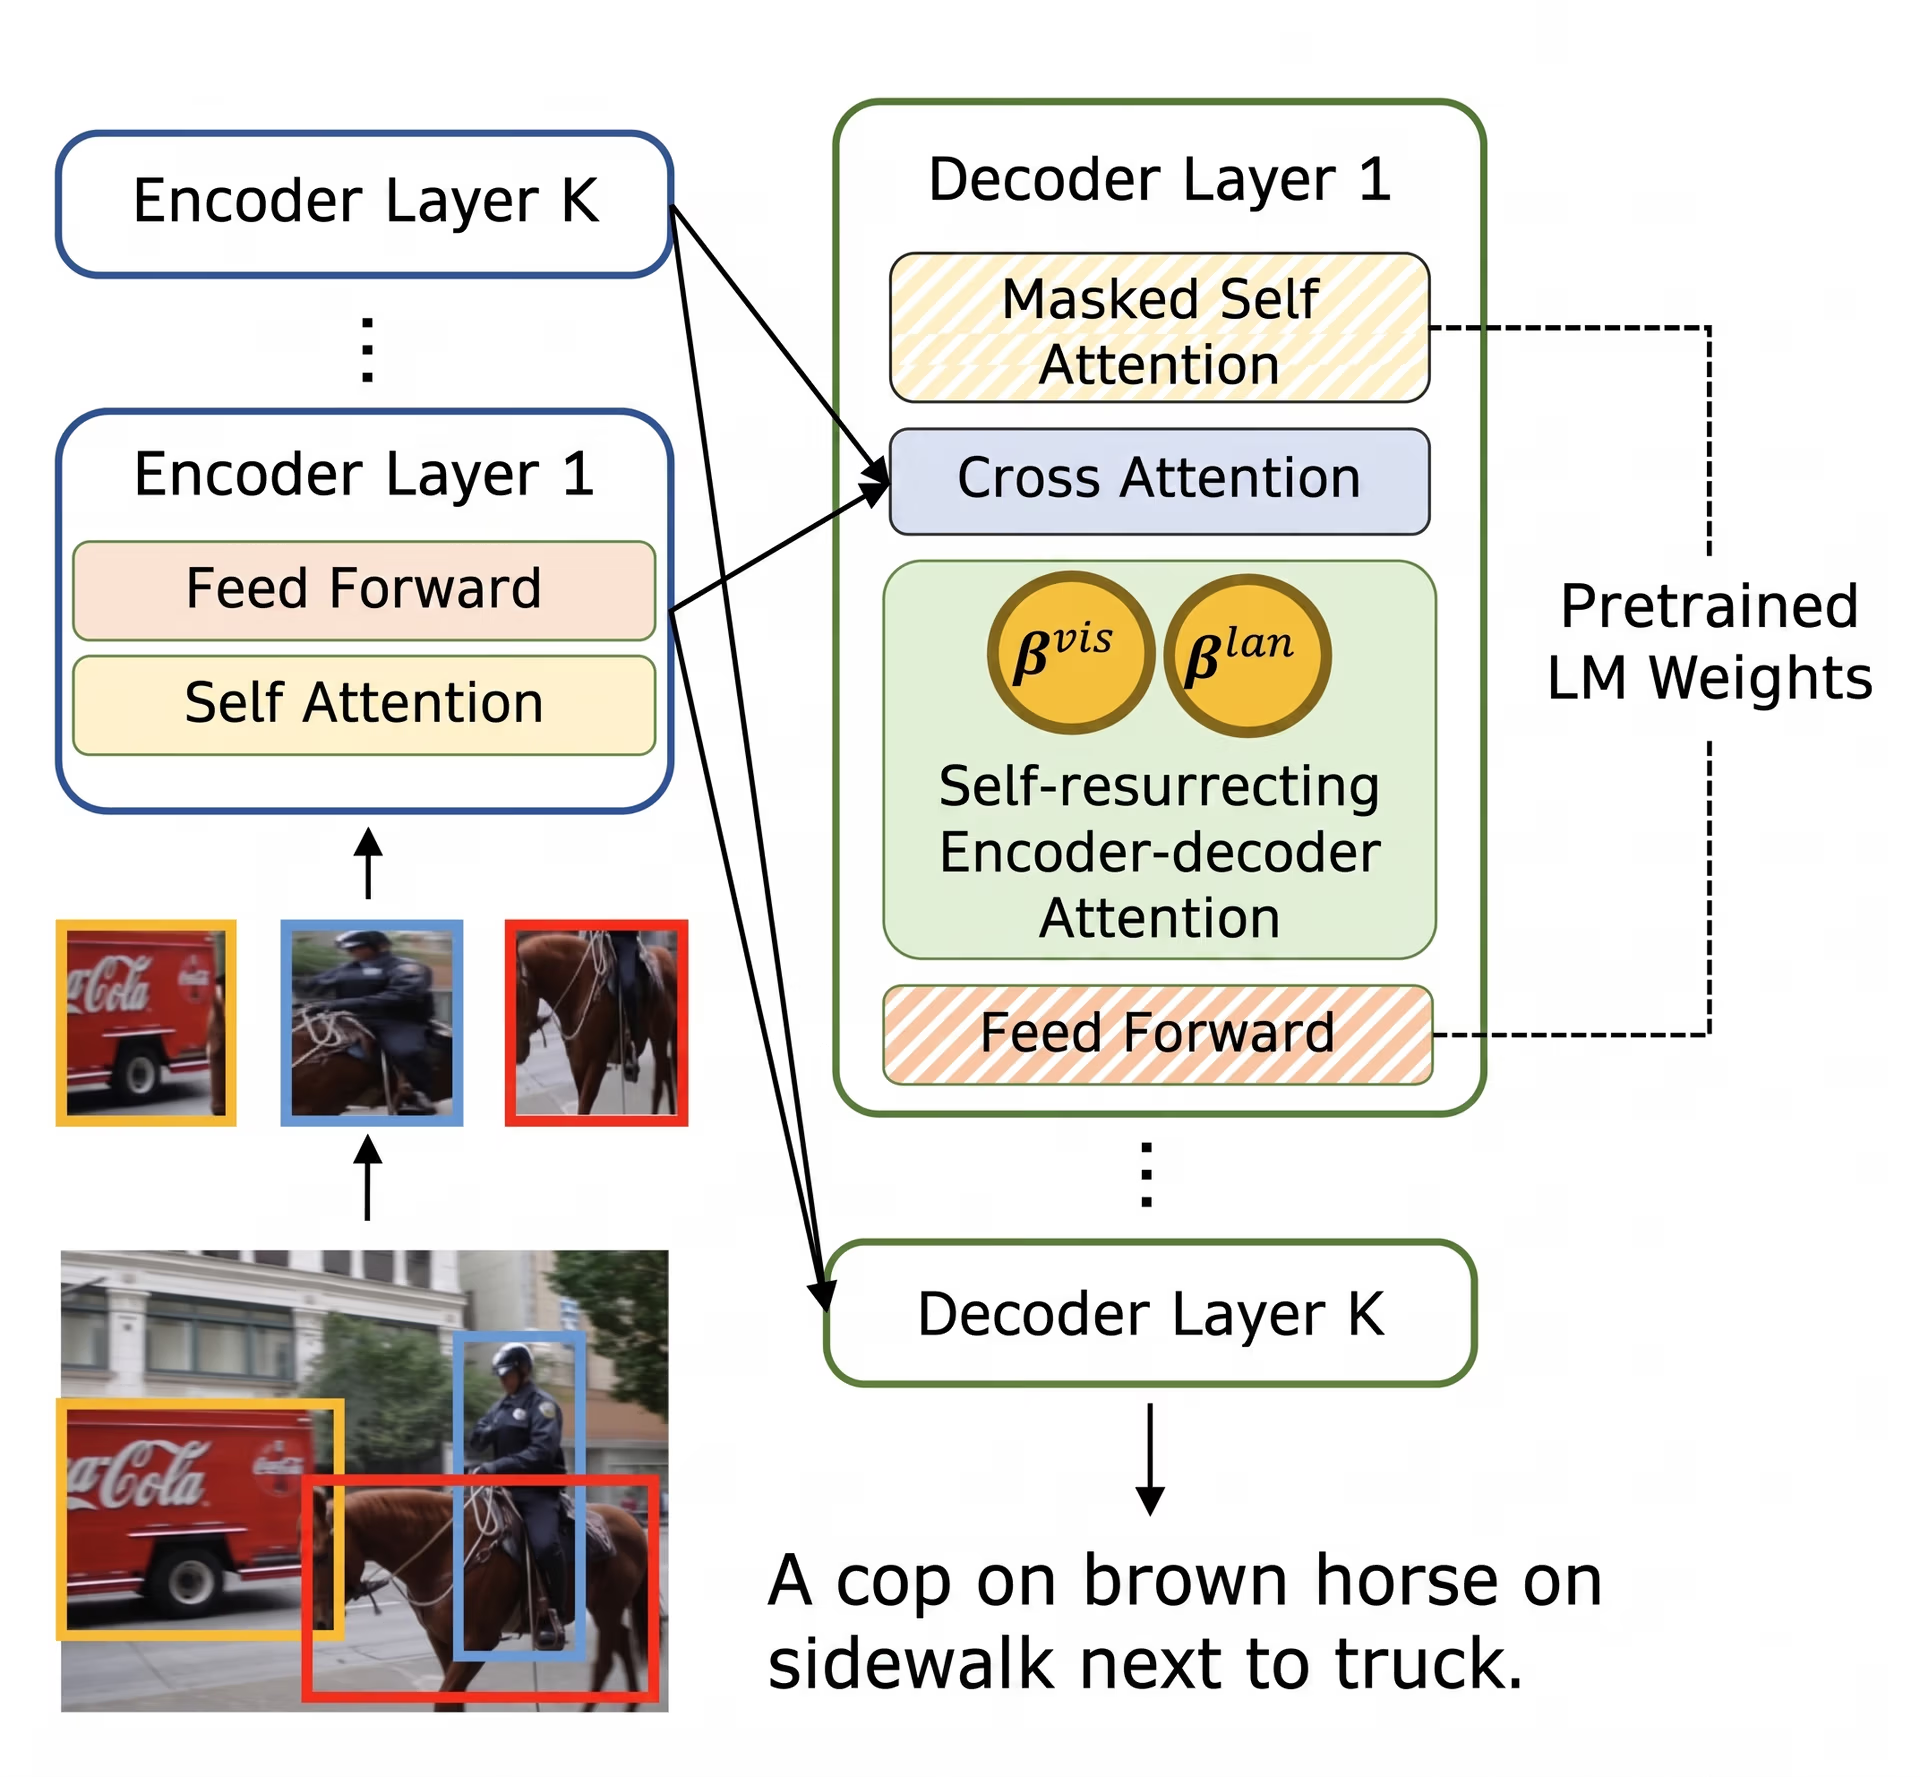
Fig. 4. Architecture du modèle VisualGPT.
Applications des modèles vision-langage#
Les modèles vision-langage ont des retombées dans de nombreux secteurs. De l’amélioration des plateformes de commerce électronique à l’accessibilité accrue d’Internet, les applications potentielles des VLM sont prometteuses. Découvrons-en quelques-unes.
Génération de descriptions de produits#
Quand tu fais des achats en ligne, tu vois des descriptions détaillées pour chaque produit, mais les rédiger peut prendre beaucoup de temps. Les VLM simplifient ce processus en automatisant la génération de ces descriptions. Les commerçants en ligne peuvent générer directement des descriptions détaillées et précises à partir des images de produits grâce aux modèles vision-langage.
Des descriptions de produits de qualité aident les moteurs de recherche à identifier les produits à partir des caractéristiques précises qu’elles mentionnent. Par exemple, une description contenant « manches longues » et « col en coton » aide les clients à trouver plus facilement une « chemise en coton à manches longues ». Elle les aide également à trouver rapidement ce qu’ils cherchent et, par conséquent, augmente les ventes et la satisfaction client.
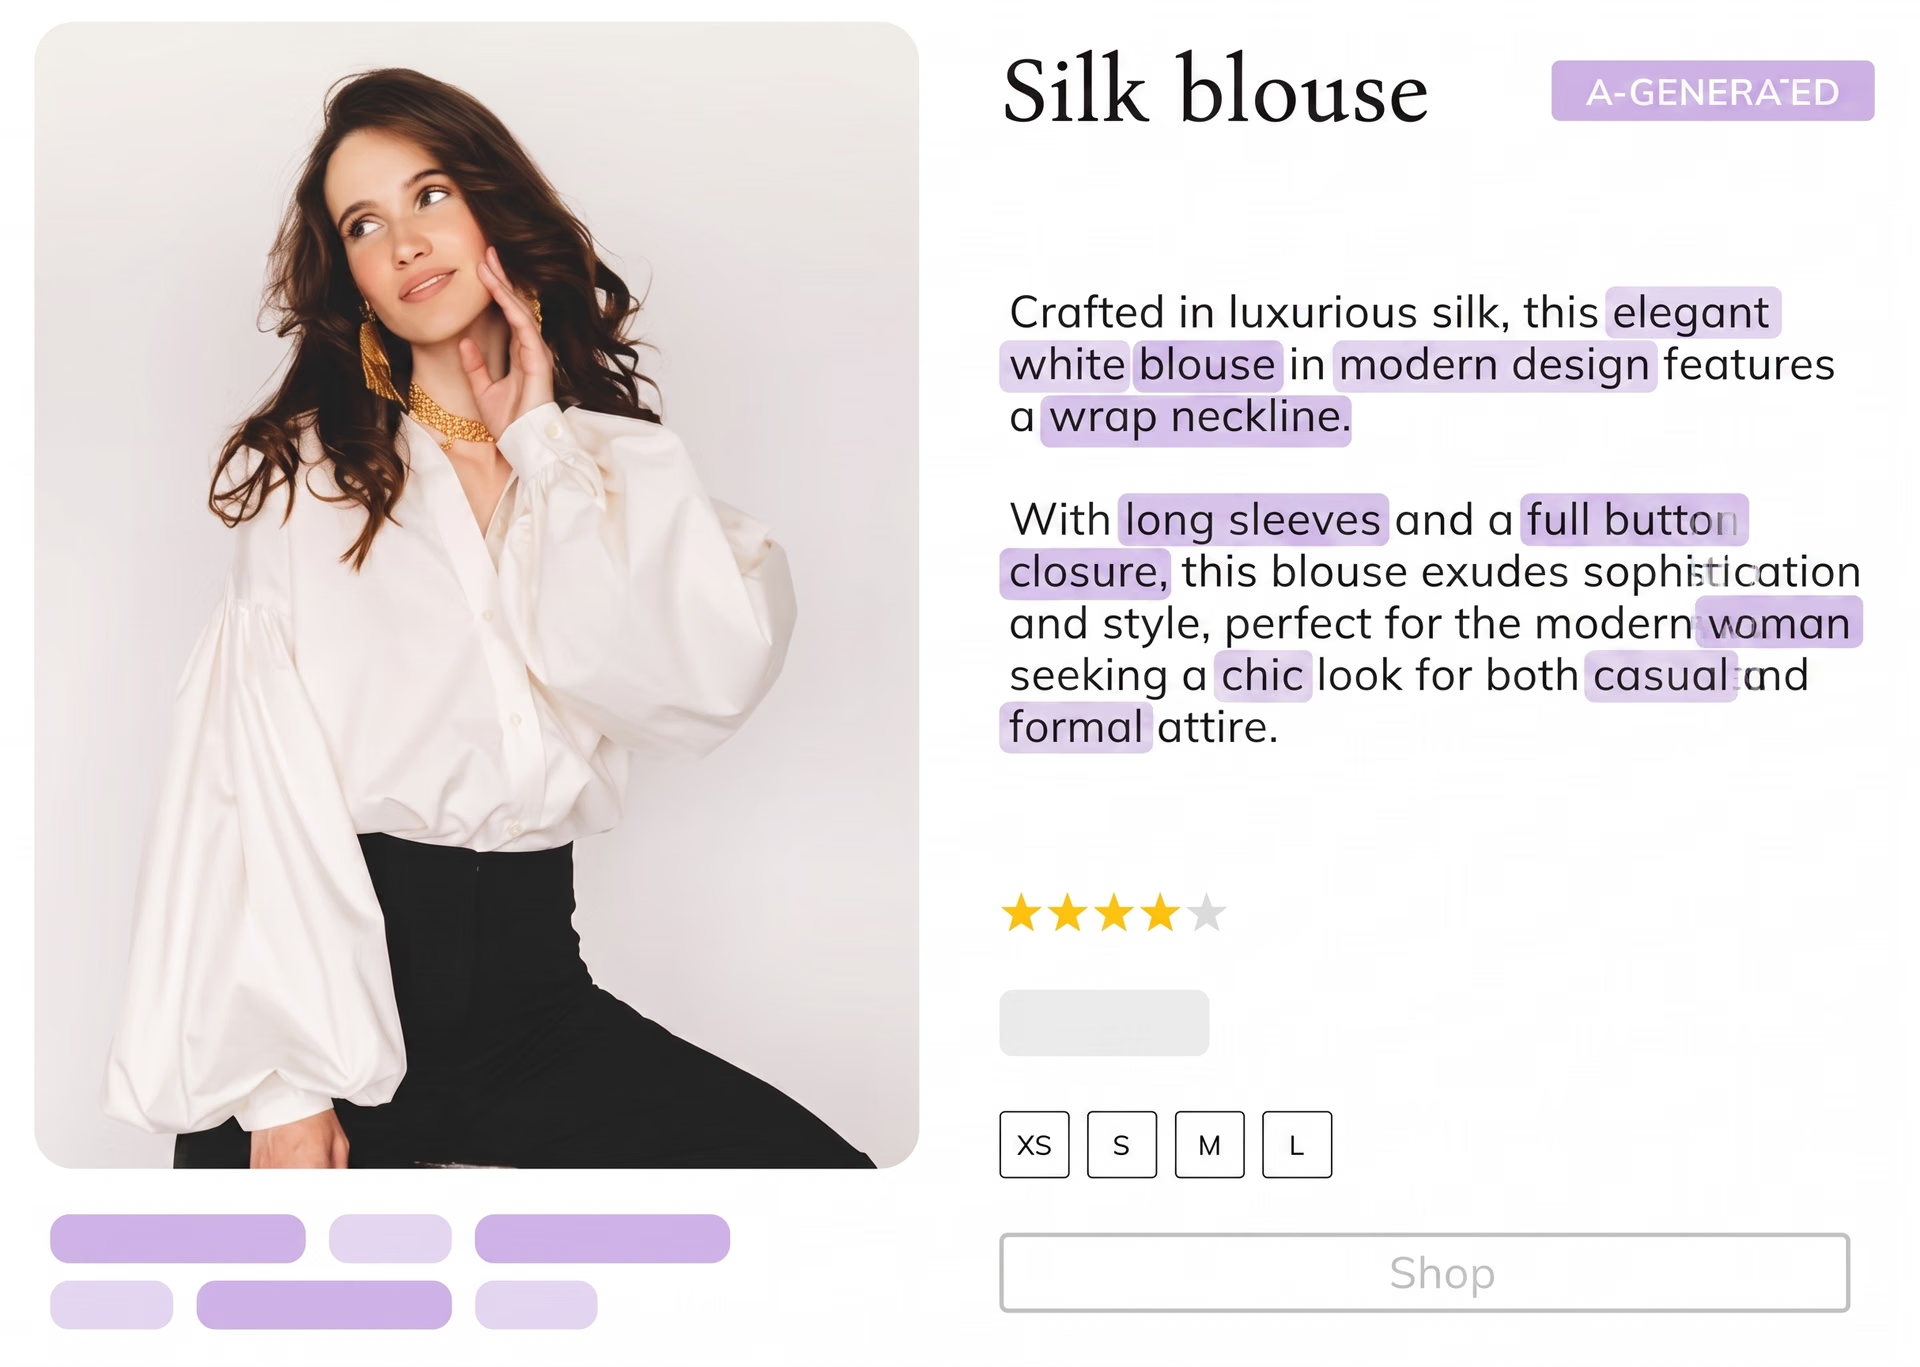
Fig. 5. Exemple de description de produit générée par l’IA.
Les modèles d’IA générative, comme BLIP-2, sont des exemples de VLM sophistiqués capables de prédire directement les attributs d’un produit à partir d’images. BLIP-2 utilise plusieurs composants pour comprendre et décrire avec précision les produits de commerce électronique. Il commence par traiter et comprendre les aspects visuels du produit à l’aide d’un encodeur d’images. Un Transformer d’interrogation interprète ensuite ces informations visuelles en fonction de questions ou de tâches précises. Enfin, un grand modèle de langage génère des descriptions de produits détaillées et précises.
Rendre Internet plus accessible#
Les modèles vision-langage peuvent rendre Internet plus accessible grâce à la génération de légendes d’images, notamment pour les personnes malvoyantes. Traditionnellement, les utilisateurs doivent saisir des descriptions du contenu visuel sur les sites Web et les réseaux sociaux. Par exemple, quand tu publies sur Instagram, tu peux ajouter un texte alternatif destiné aux lecteurs d’écran. Les VLM peuvent toutefois automatiser cette tâche.
Quand un VLM voit l’image d’un chat assis sur un canapé, il peut générer la légende « Un chat assis sur un canapé », rendant la scène compréhensible pour les personnes malvoyantes. Les VLM utilisent des techniques comme le prompting few-shot, qui leur permet d’apprendre à partir de quelques exemples d’images et de légendes, ainsi que le prompting chain-of-thought, qui les aide à décomposer logiquement des scènes complexes. Ces techniques rendent les légendes générées plus cohérentes et détaillées.
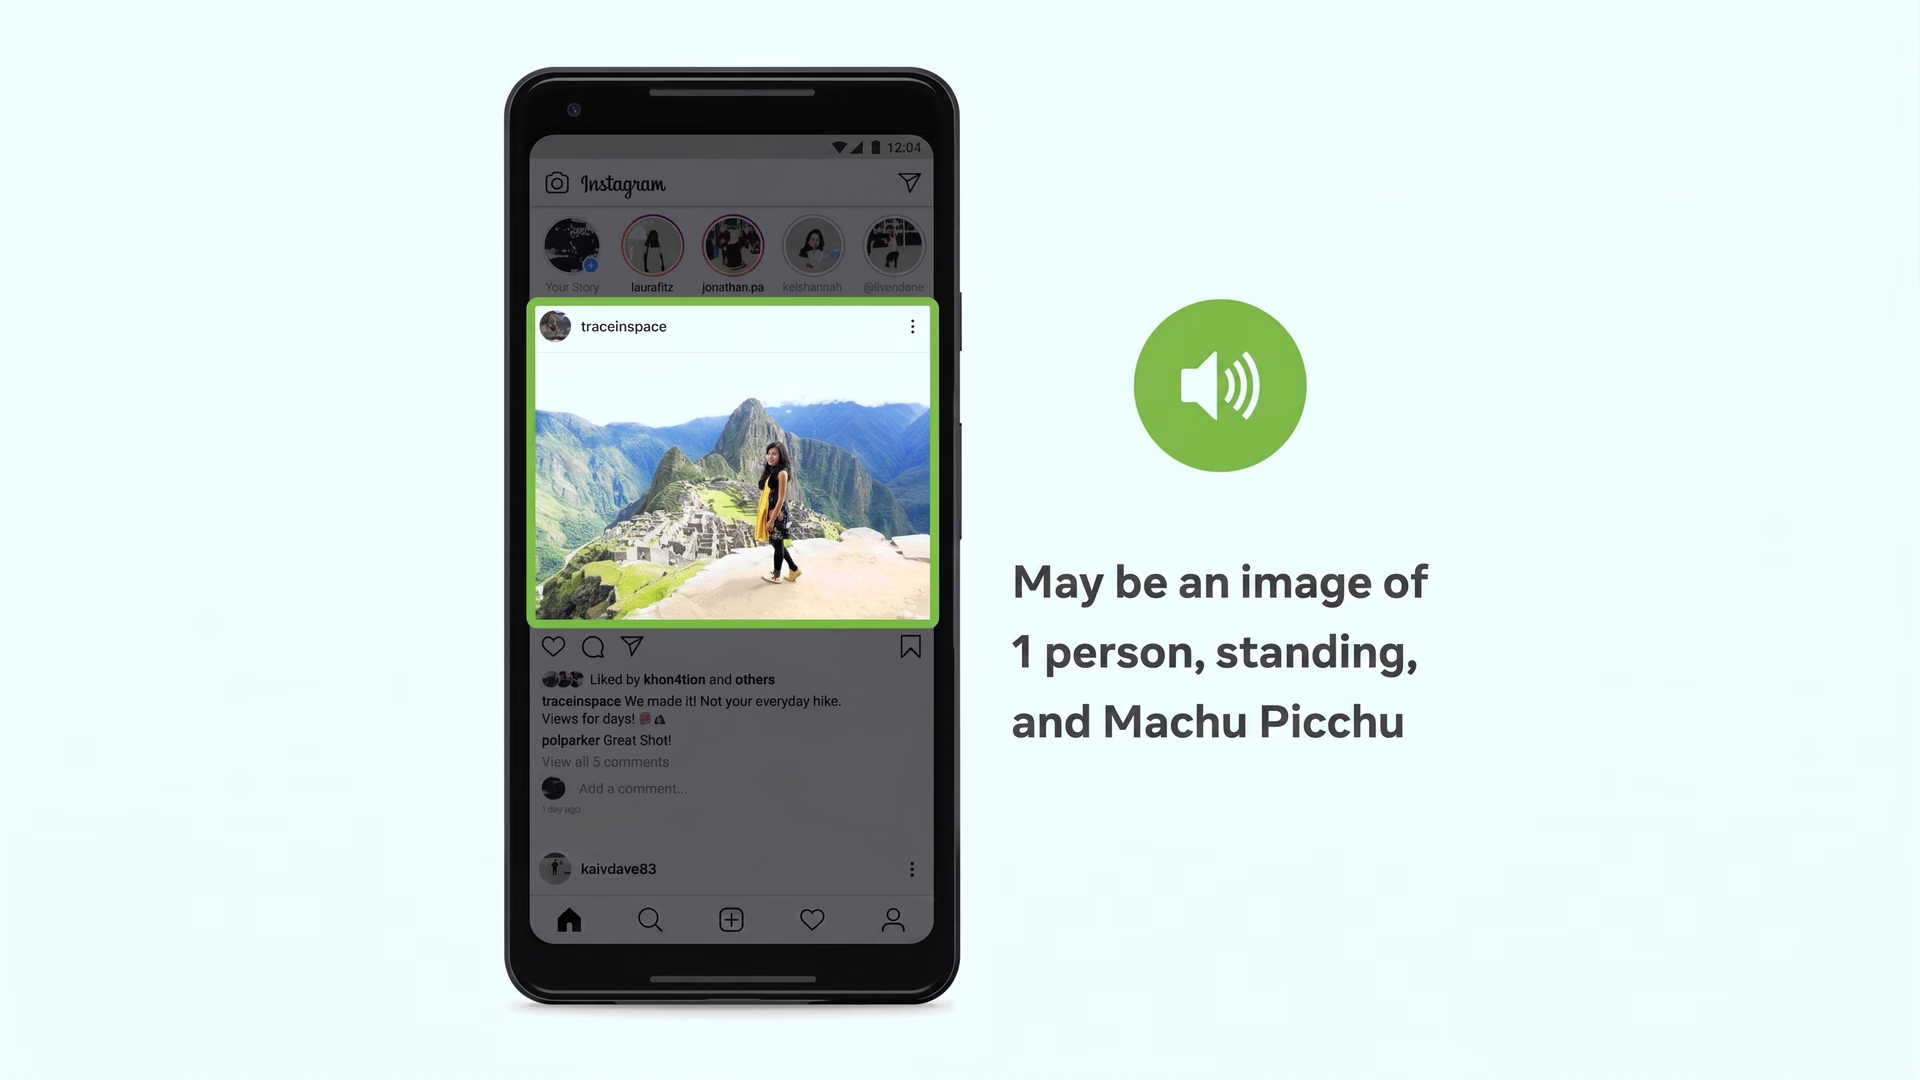
Fig. 6. Utiliser l’IA pour générer des légendes d’images.
Dans cette optique, la fonctionnalité de Google « Obtenir des descriptions d’images de Google » dans Chrome génère automatiquement des descriptions pour les images dépourvues de texte alternatif. Même si ces descriptions générées par l’IA ne sont pas aussi détaillées que celles rédigées par des humains, elles fournissent tout de même des informations utiles.
Avantages et limites des modèles vision-langage#
Les modèles vision-langage (VLM) offrent de nombreux avantages en combinant des données visuelles et textuelles. Voici quelques-uns de leurs principaux atouts :
- Meilleure interaction humain-machine : Permettre aux systèmes de comprendre les entrées visuelles et textuelles, et d’y répondre, afin d’améliorer les assistants virtuels, les chatbots et la robotique.
- Diagnostic et analyse avancés : Aider le secteur médical en analysant des images et en générant des descriptions, en proposant un second avis aux professionnels de santé et en détectant des anomalies.
- Récits interactifs et divertissement : Générer des récits captivants en combinant des entrées visuelles et textuelles afin d’améliorer l’expérience utilisateur dans les jeux vidéo et la réalité virtuelle.
Malgré leurs capacités impressionnantes, les modèles vision-langage présentent aussi certaines limites. Voici quelques points à garder à l’esprit concernant les VLM :
- Besoins élevés en calcul : L’entraînement et le déploiement des VLM nécessitent d’importantes ressources de calcul, ce qui les rend coûteux et moins accessibles.
- Dépendance aux données et biais : Les VLM peuvent produire des résultats biaisés s’ils sont entraînés sur des jeux de données peu diversifiés ou biaisés, ce qui risque de perpétuer les stéréotypes et la désinformation.
- Compréhension limitée du contexte : Les VLM peuvent avoir du mal à comprendre la vue d’ensemble ou le contexte et générer des résultats trop simplifiés ou incorrects.
Points clés à retenir#
Les modèles vision-langage ont un potentiel considérable dans de nombreux domaines, comme le commerce électronique et la santé. En combinant données visuelles et textuelles, ils peuvent stimuler l’innovation et transformer les secteurs d’activité. Il est toutefois essentiel de développer ces technologies de manière responsable et éthique afin de garantir une utilisation équitable. À mesure que les VLM évoluent, ils amélioreront des tâches comme la recherche à partir d’images et contribueront aux technologies d’assistance.
Pour continuer à découvrir l’IA, rejoins notre communauté ! Explore notre dépôt GitHub pour voir comment nous utilisons l’IA afin de créer des solutions innovantes dans des secteurs comme la fabrication et la santé. 🚀









