Comment Ultralytics YOLO26 s’entraîne plus intelligemment avec ProgLoss, STAL et MuSGD
Découvrez comment Ultralytics YOLO26 s’entraîne de manière plus fiable grâce à l’équilibrage progressif des pertes, à l’assignation des étiquettes adaptée aux petits objets et à l’optimiseur MuSGD.
 Abirami Vina11 min de lecture
La semaine dernière, nous avons lancé Ultralytics YOLO26, un modèle de vision par ordinateur en temps réel conçu d’abord pour les appareils en périphérie. Comme les précédents modèles Ultralytics YOLO, tels qu’Ultralytics YOLO11, YOLO26 prend en charge les principales tâches de vision par ordinateur que connaissent les utilisateurs, notamment la détection d’objets, la segmentation d’instances et l’estimation de pose.
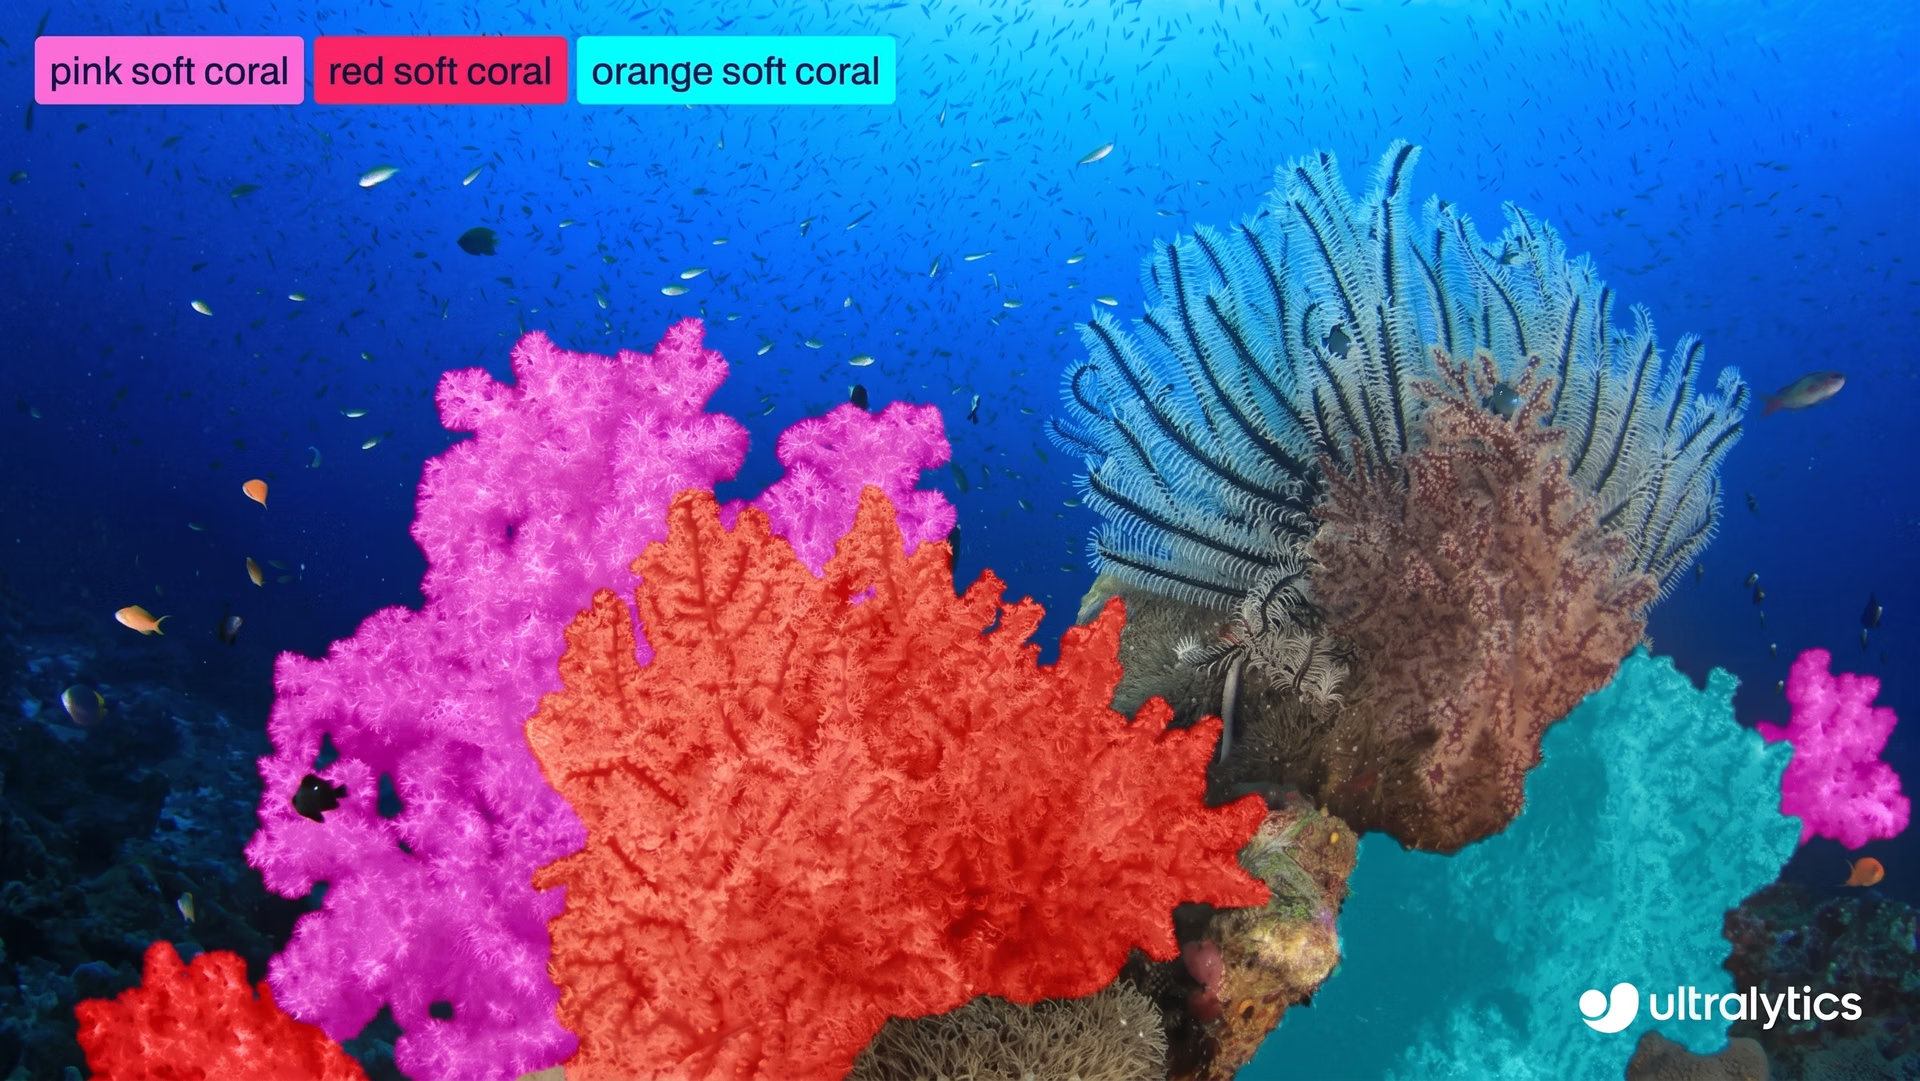
Fig. 1. Exemple d’utilisation d’Ultralytics YOLO26 pour segmenter des objets dans une image.
Cependant, Ultralytics YOLO26 n’est pas une simple mise à jour incrémentale. Même si les tâches prises en charge peuvent sembler familières, ce nouveau modèle marque une avancée dans la manière dont les modèles de vision par ordinateur sont entraînés. Avec YOLO26, l’objectif dépasse l’efficacité de l’inférence et vise aussi à rendre l’entraînement plus stable.
Ultralytics YOLO26 a été conçu en tenant compte de l’ensemble du cycle d’entraînement. Cela se traduit par une convergence plus rapide, des entraînements plus fiables et un comportement cohérent du modèle. Ces améliorations sont particulièrement importantes dans les flux de travail du monde réel, où la fiabilité de l’entraînement influe directement sur la rapidité avec laquelle les modèles peuvent être améliorés et déployés.
Pour ce faire, Ultralytics YOLO26 introduit plusieurs innovations ciblées en matière d’entraînement, comme l’équilibrage progressif des pertes (ProgLoss), l’assignation des étiquettes adaptée aux petits objets (STAL) et l’optimiseur MuSGD. Ensemble, ces changements améliorent l’équilibrage des pertes d’apprentissage, l’assignation des étiquettes et le comportement de l’optimisation au fil du temps.
Dans cet article, nous allons voir comment fonctionne chacun de ces mécanismes et pourquoi ils rendent Ultralytics YOLO26 plus facile à entraîner et plus fiable à grande échelle. Commençons !
Ultralytics YOLO26 : conçu pour un entraînement plus intelligent, pas seulement pour une exécution plus rapide#
Ultralytics YOLO26 rationalise nativement l’ensemble du pipeline d’inférence en éliminant le recours à des étapes de post-traitement comme la suppression non maximale (NMS). Au lieu de générer de nombreuses prédictions qui se chevauchent, puis de les filtrer, YOLO26 produit directement les détections finales à partir du réseau.
Il s’agit d’un modèle YOLO26 de bout en bout, dans lequel la prédiction, la résolution des doublons et les résultats finaux sont tous appris au sein même du réseau. Cela simplifie le déploiement et améliore l’efficacité de l’inférence, tout en influençant la façon dont le modèle apprend pendant l’entraînement.
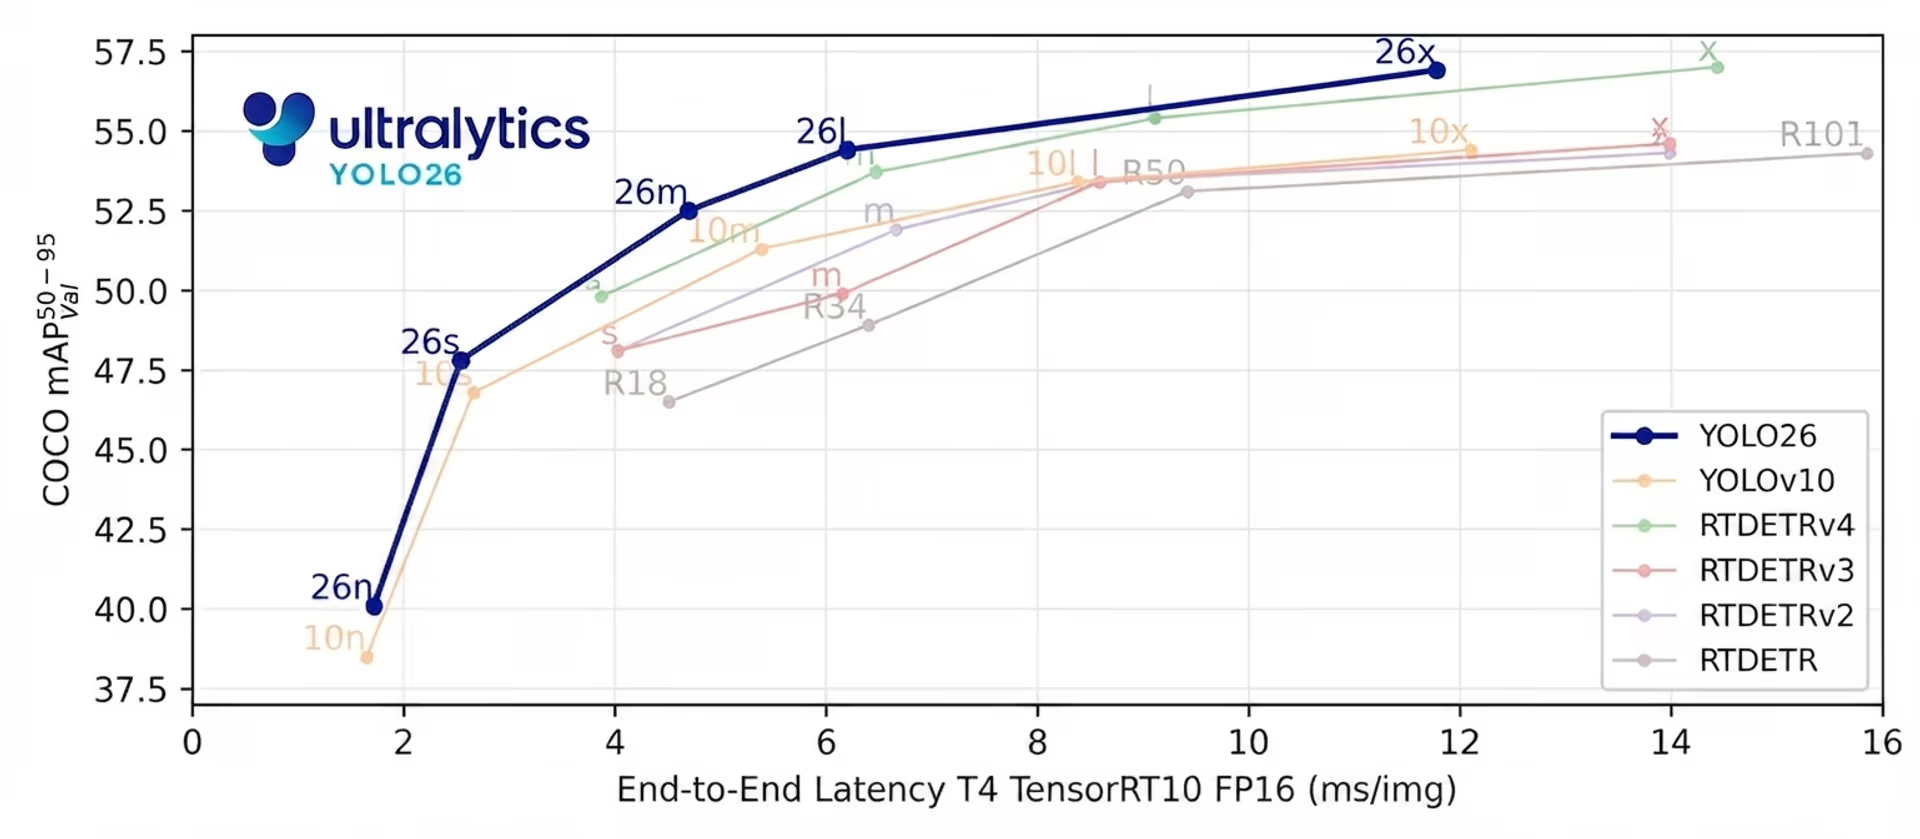
Fig. 2. YOLO26 offre une inférence de pointe de bout en bout, sans NMS (Source)
Dans un système de bout en bout comme celui-ci, l’entraînement et l’inférence sont étroitement liés. Comme aucune étape de post-traitement externe ne vient corriger les prédictions par la suite, le modèle doit apprendre à prendre des décisions claires et sûres pendant l’entraînement lui-même.
Il est donc particulièrement important d’aligner les objectifs d’entraînement sur le comportement en inférence. Toute différence entre la manière dont le modèle est entraîné et celle dont il est utilisé au moment de l’inférence peut entraîner un apprentissage instable ou une convergence plus lente.
Ultralytics YOLO26 répond à ce besoin en concevant dès le départ son processus d’entraînement en fonction des usages réels. Au lieu de se concentrer uniquement sur la vitesse d’inférence, le système d’entraînement est conçu pour assurer un apprentissage stable sur de longues sessions, une convergence cohérente pour toutes les tailles de modèles, de Nano à Extra Large, et des performances robustes sur des jeux de données variés.
Comment deux têtes d’entraînement améliorent l’apprentissage dans Ultralytics YOLO26#
L’une des principales innovations d’entraînement d’Ultralytics YOLO26 s’appuie sur une approche à deux têtes d’entraînement utilisée dans les précédents modèles YOLO. Dans les modèles de détection d’objets, une tête désigne la partie du réseau chargée de produire les prédictions.
Autrement dit, les têtes de détection apprennent à prédire où se trouvent les objets dans une image et de quels objets il s’agit. Pour cela, elles régressent les coordonnées des boîtes englobantes, c’est-à-dire qu’elles apprennent à estimer la position et la taille de chaque objet dans l’image d’entrée.
Pendant l’entraînement, le modèle apprend en minimisant une perte, qui mesure numériquement l’écart entre ses prédictions et les réponses correctes, ou vérité terrain. Une perte plus faible signifie que les prédictions du modèle sont plus proches de la vérité terrain, tandis qu’une perte plus élevée indique des erreurs plus importantes. Le calcul de la perte guide la mise à jour des paramètres du modèle pendant l’entraînement.
Ultralytics YOLO26 utilise deux têtes de détection pendant l’entraînement. Elles partagent le même modèle sous-jacent, mais ont des fonctions différentes. La tête un-à-un est celle utilisée au moment de l’inférence. Elle apprend à associer chaque objet à une seule prédiction sûre, ce qui est essentiel à la conception de bout en bout sans NMS de YOLO26.
La tête un-à-plusieurs, quant à elle, est utilisée uniquement pendant l’entraînement. Elle permet d’associer plusieurs prédictions au même objet, ce qui fournit une supervision plus dense. Ce signal d’apprentissage plus riche contribue à stabiliser l’entraînement et à améliorer la précision, en particulier au début.
Dans Ultralytics YOLO26, les deux têtes utilisent le même calcul de perte pour la régression des boîtes et la classification. Les implémentations antérieures appliquaient un équilibre fixe entre ces deux signaux de perte pendant tout l’entraînement.
En pratique, toutefois, l’importance de chaque tête évolue au fil du temps. Une supervision dense est surtout utile au début, tandis que l’alignement sur le comportement en inférence devient plus important par la suite. Ultralytics YOLO26 est conçu en tenant compte de ce constat, qui explique directement comment il rééquilibre les signaux d’apprentissage au fil de l’entraînement.
Ultralytics YOLO26 utilise l’équilibrage progressif de la perte#
Alors, comment Ultralytics YOLO26 répond-il à ces besoins d’apprentissage qui évoluent pendant l’entraînement ? Il utilise l’équilibrage progressif de la perte pour ajuster le poids des signaux d’apprentissage au fil du temps.
ProgLoss fonctionne en faisant varier dynamiquement la contribution de chaque tête à la perte totale au fil de l’entraînement. Au début, la tête un-à-plusieurs reçoit un poids plus important afin de stabiliser l’apprentissage et d’améliorer le rappel. À mesure que l’entraînement progresse, l’équilibre se déplace progressivement vers la tête un-à-un, ce qui aligne davantage l’entraînement sur le comportement en inférence.
Cette transition progressive permet à Ultralytics YOLO26 d’apprendre dans le bon ordre. Au lieu de forcer le modèle à optimiser simultanément des objectifs concurrents, l’équilibrage progressif de la perte privilégie le signal d’apprentissage le plus utile à chaque étape de l’entraînement. Il en résulte une convergence plus fluide, moins de sessions d’entraînement instables et des performances finales plus cohérentes.
Comment STAL aide Ultralytics YOLO26 à apprendre à partir de très petits objets#
Une autre amélioration intéressante de l’entraînement d’Ultralytics YOLO26 concerne la manière dont le modèle associe les cibles d’entraînement aux prédictions, un processus appelé assignation des étiquettes. Ce processus associe les objets de vérité terrain aux prédictions candidates, souvent appelées ancres.
Ces associations déterminent quelles prédictions reçoivent une supervision et contribuent à la perte. Ultralytics YOLO26 s’appuie sur une méthode existante d’assignation des étiquettes appelée apprentissage de l’alignement des tâches (TAL), conçue pour mieux aligner la classification et la localisation pendant l’entraînement.
Bien que TAL fonctionne bien pour la plupart des objets, l’entraînement a révélé une limite importante. Pendant le processus d’association, les objets très petits pouvaient être entièrement ignorés. En pratique, les objets de moins de 8 pixels environ dans une image d’entrée de 640 pixels ne recevaient souvent aucune assignation d’ancre. Dans ce cas, le modèle ne reçoit que peu, voire pas du tout, de supervision pour ces objets, ce qui rend leur détection fiable difficile à apprendre.
Pour résoudre ce problème, Ultralytics YOLO26 introduit l’attribution d’étiquettes adaptée aux petites cibles (STAL). STAL modifie le processus d’attribution afin que les petits objets ne soient pas ignorés pendant l’entraînement. Plus précisément, lors de la sélection des candidats, toute largeur ou hauteur de boîte inférieure à 8 pixels est portée à 16 pixels, tandis que la boîte d’origine est conservée pour l’appariement et la régression. Ainsi, même les objets minuscules contribuent systématiquement à la fonction de perte d’entraînement.
En renforçant la supervision des petites cibles, STAL améliore la stabilité de l’apprentissage et les performances de détection dans les situations où les objets petits ou éloignés sont fréquents. Cette amélioration est particulièrement importante pour les applications YOLO26 conçues pour l’edge, comme l’imagerie aérienne, la robotique et les systèmes de l’Internet des objets (IoT), où les objets sont souvent petits, éloignés ou partiellement visibles et où une détection fiable est essentielle.
Ultralytics YOLO26 introduit l’optimiseur MuSGD#
Pour rendre l’entraînement plus stable et prévisible, Ultralytics YOLO26 introduit également un nouvel optimiseur appelé MuSGD. Cet optimiseur vise à améliorer la convergence et la fiabilité de l’entraînement des modèles de détection de bout en bout, en particulier lorsque la taille des modèles et la complexité de l’entraînement augmentent.
Pour qu’un réseau neuronal puisse apprendre et mettre à jour ses poids pendant l’entraînement, nous calculons une erreur, également appelée perte. Le modèle évalue l’écart de ses prédictions à l’aide d’une valeur de perte, calcule des gradients qui indiquent comment modifier ses paramètres, puis met à jour ces paramètres afin de réduire l’erreur. La descente de gradient stochastique (SGD) est un optimiseur très répandu qui effectue ces mises à jour et rend l’entraînement efficace et évolutif.
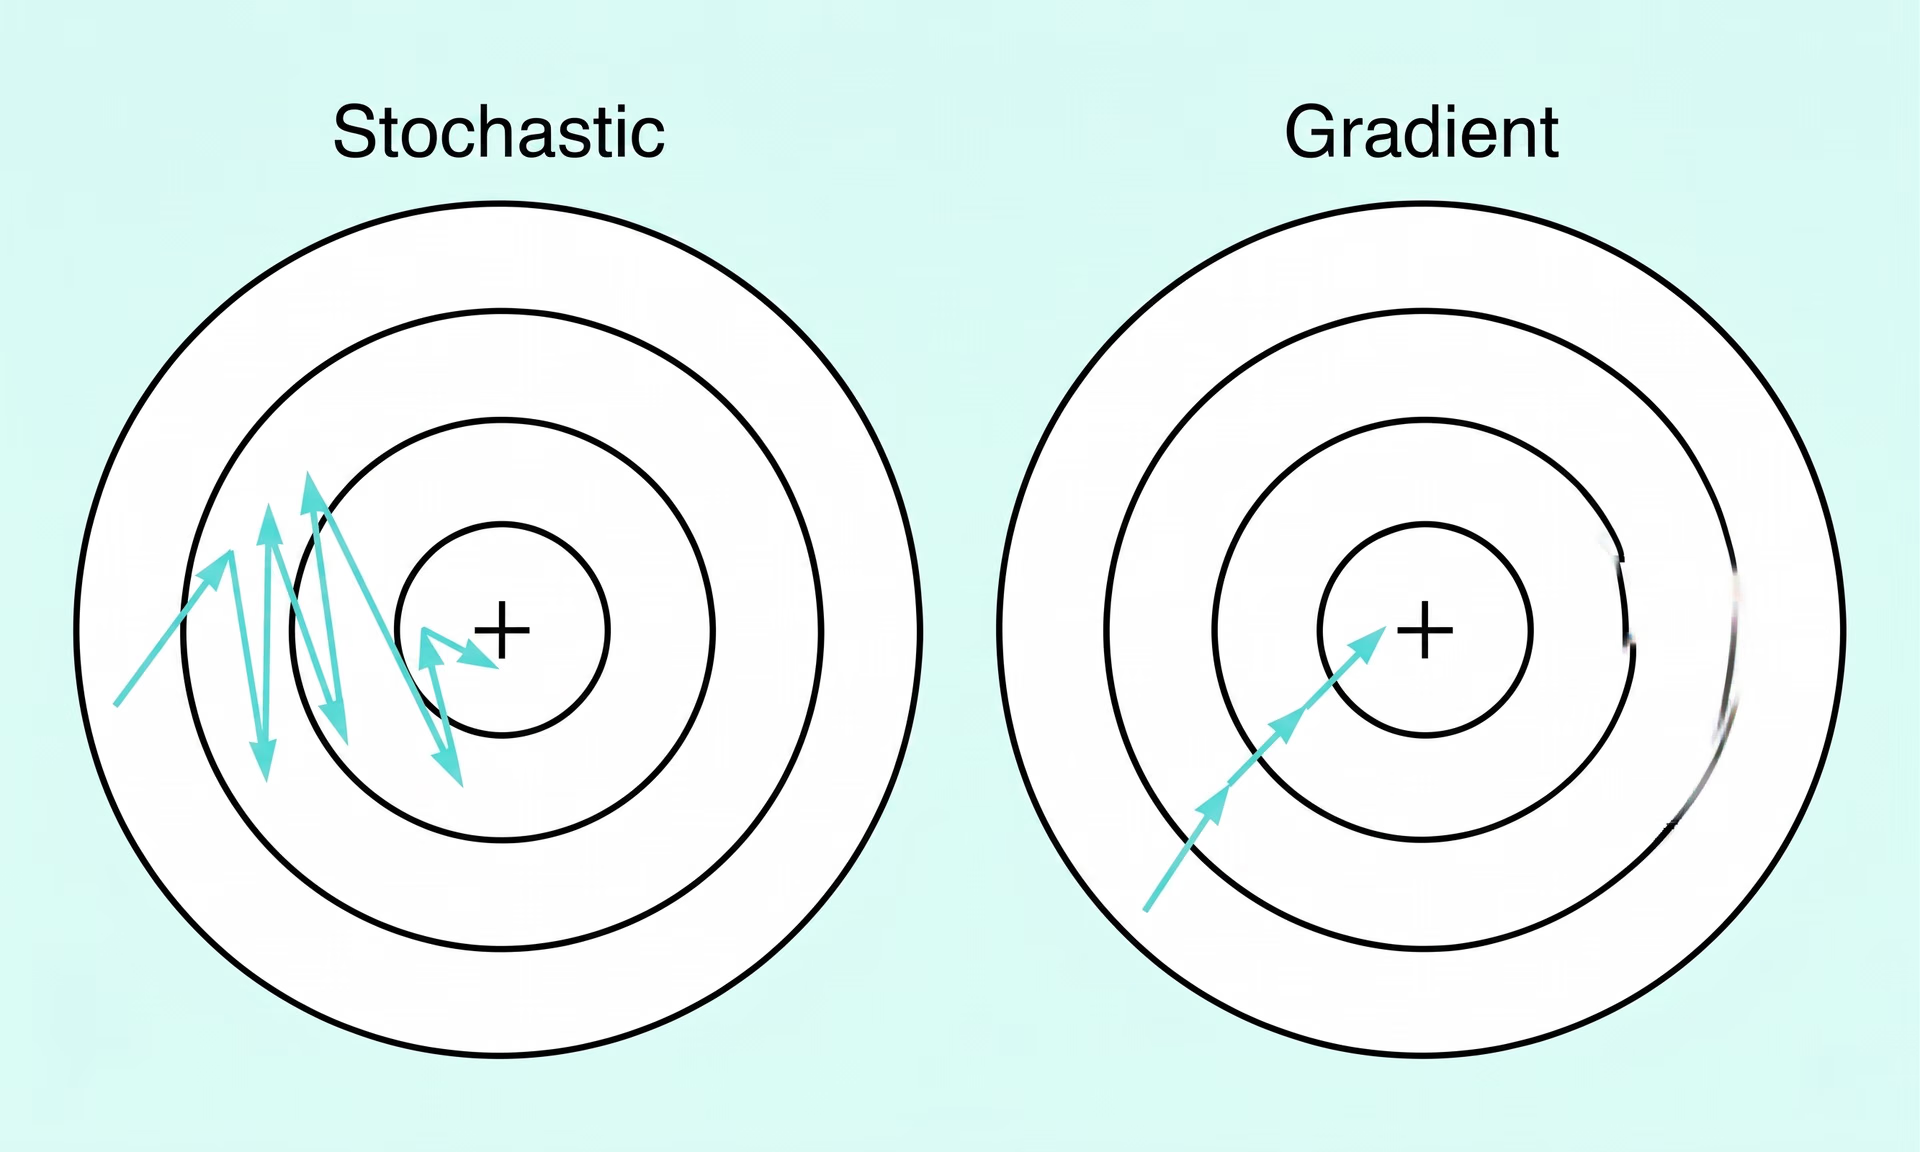
Fig. 3. Descente de gradient stochastique et descente de gradient (Source)
MuSGD s’appuie sur cette base bien connue en intégrant des idées d’optimisation inspirées de Muon, une méthode utilisée pour entraîner les grands modèles de langage (LLM). Ces idées ont été influencées par des avancées récentes comme Kimi K2 de Moonshot AI, qui a montré qu’une mise à jour des paramètres mieux structurée pouvait améliorer le comportement de l’entraînement.
Ultralytics YOLO26 utilise une stratégie de mise à jour hybride. Certains paramètres sont mis à jour en combinant des mises à jour inspirées de Muon et SGD, tandis que d’autres utilisent uniquement SGD. YOLO26 peut ainsi introduire davantage de structure dans le processus d’optimisation tout en conservant la robustesse et les propriétés de généralisation qui ont fait l’efficacité de SGD.
Il en résulte une optimisation plus fluide, une convergence plus rapide et un comportement d’entraînement plus prévisible quelle que soit la taille du modèle. MuSGD contribue ainsi de manière essentielle à rendre Ultralytics YOLO26 plus facile à entraîner et plus fiable à grande échelle.
L’importance des innovations d’entraînement d’Ultralytics YOLO26#
Les innovations d’entraînement d’Ultralytics YOLO26, associées à des fonctionnalités clés comme sa conception de bout en bout, sans NMS et pensée pour l’edge, rendent le modèle plus facile à entraîner et plus fiable à grande échelle. Tu te demandes peut-être ce que cela signifie concrètement pour les applications de vision par ordinateur.
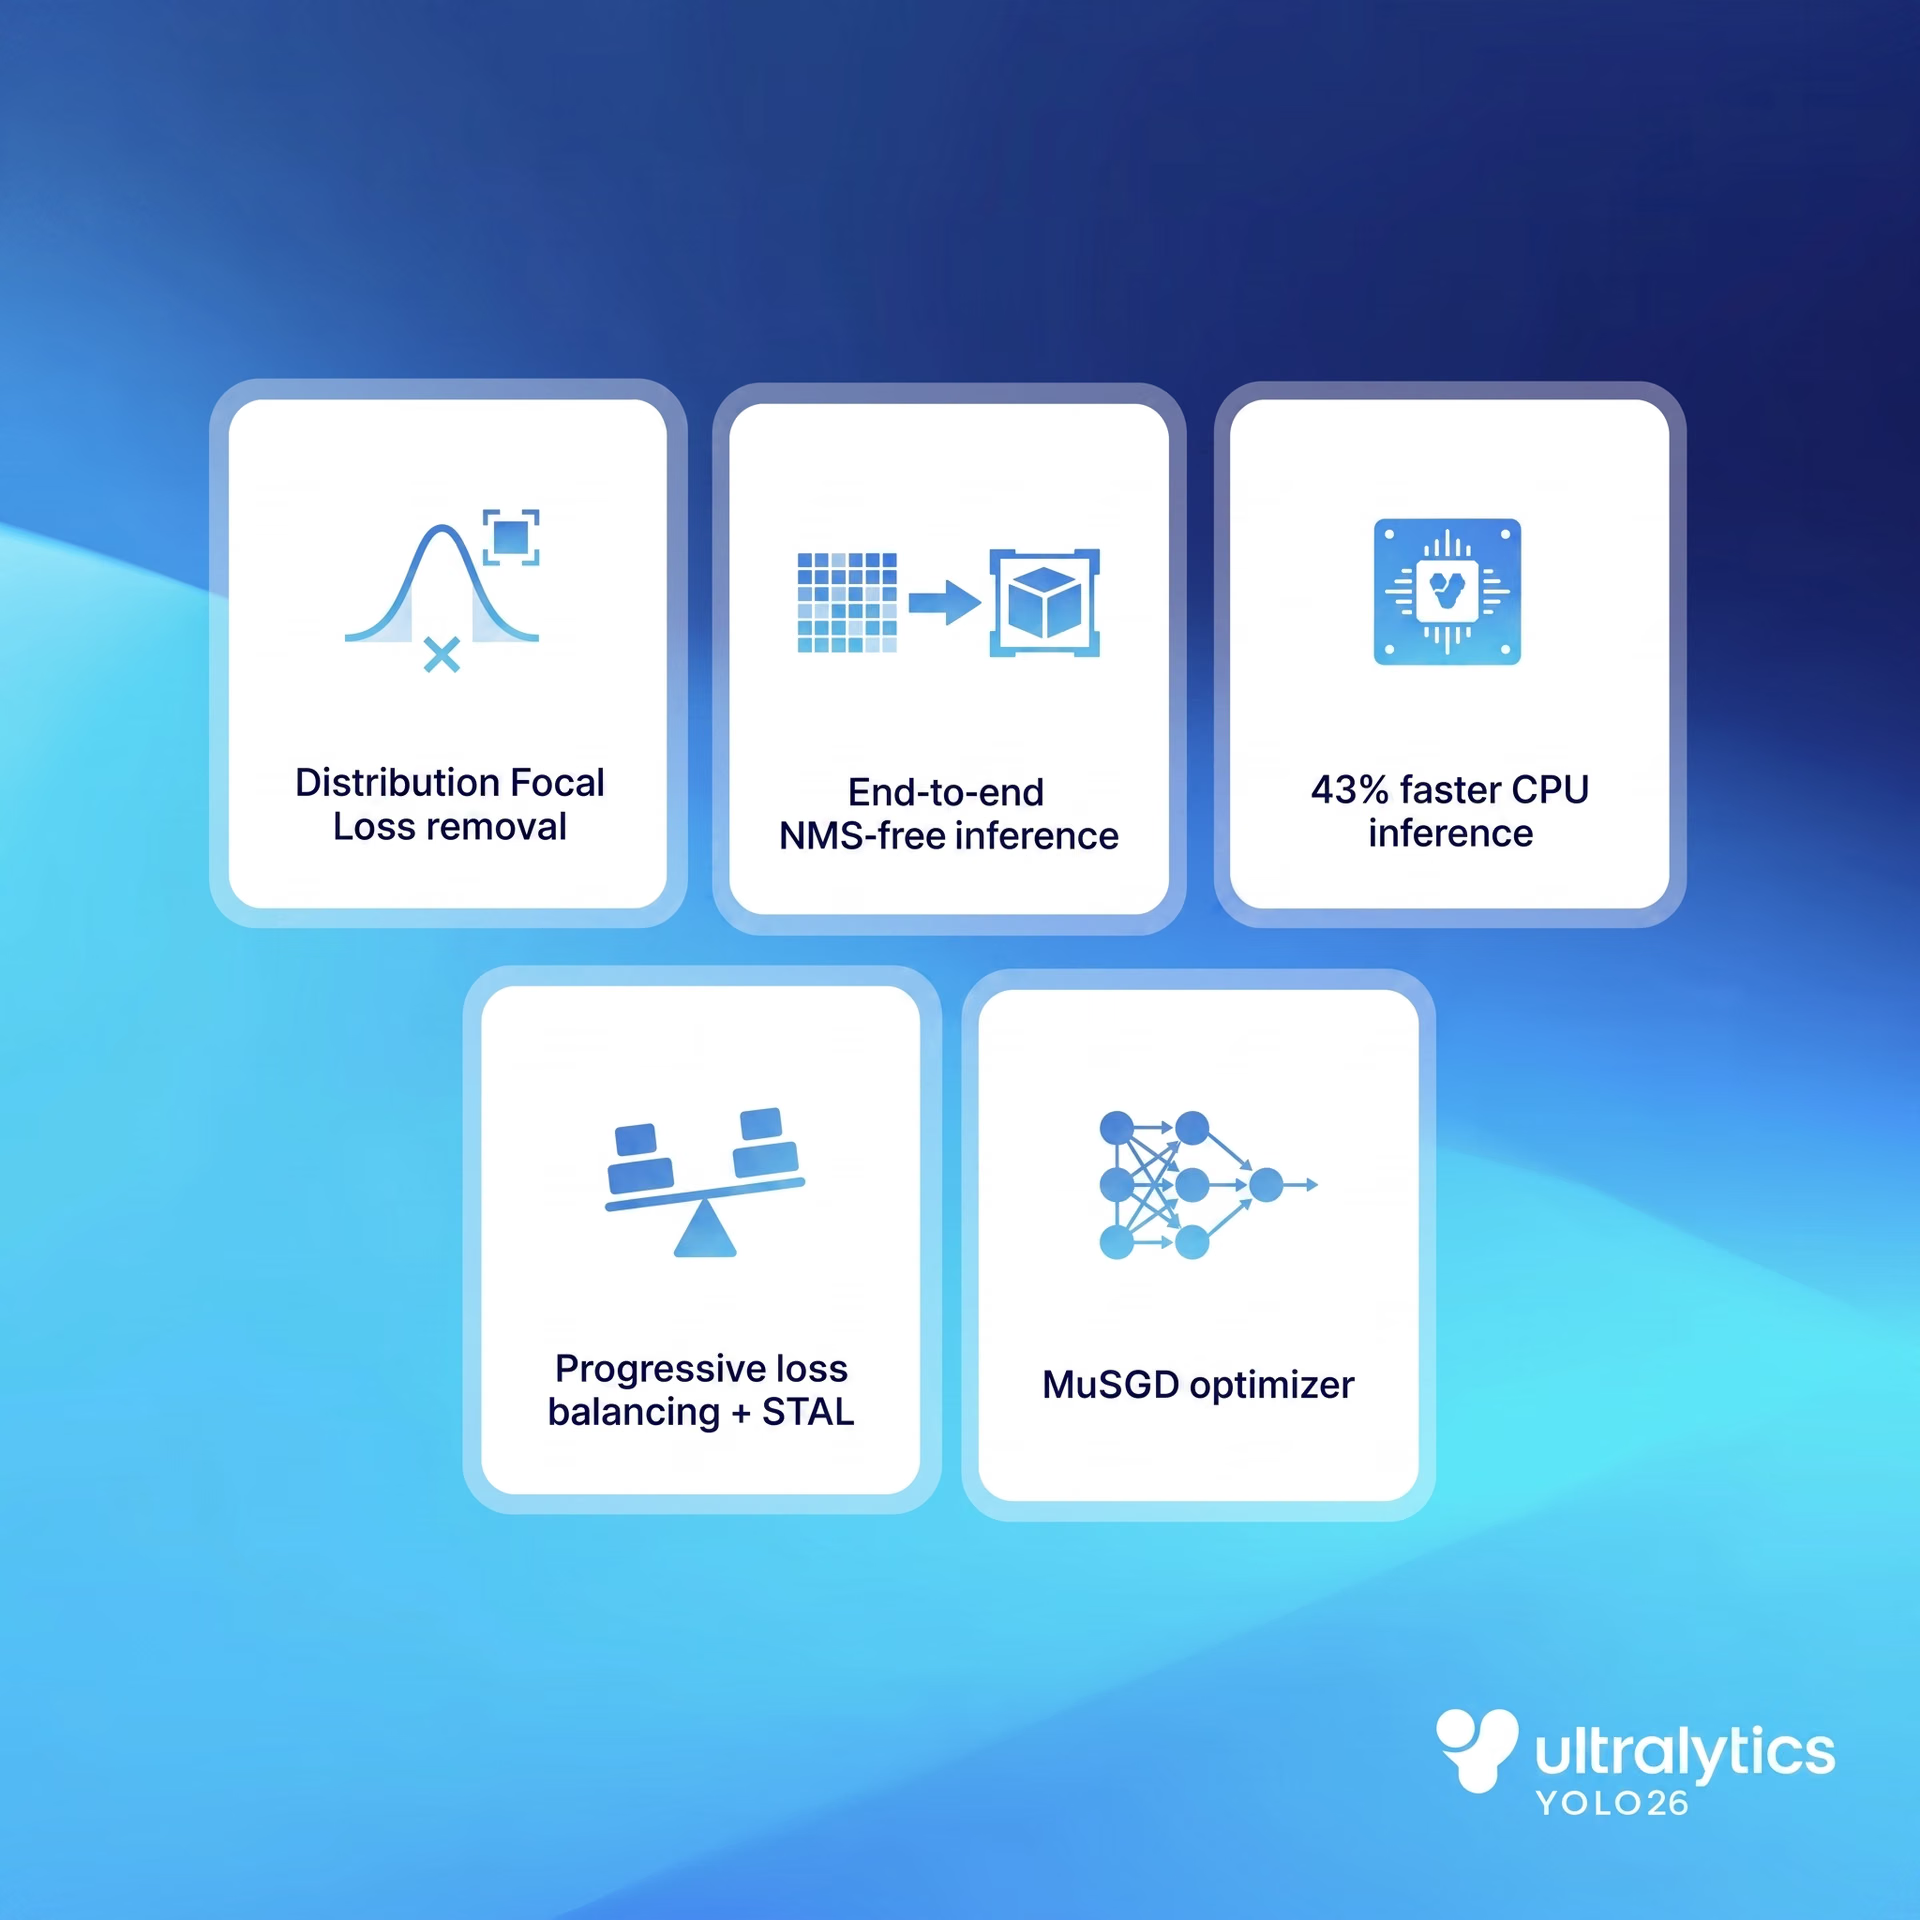
Fig. 4. Aperçu des principales fonctionnalités de YOLO26 (Source)
Concrètement, cela facilite grandement le déploiement de la vision par ordinateur là où elle est réellement utilisée. Les modèles s’entraînent de manière plus prévisible, s’adaptent plus régulièrement à différentes tailles et sont plus faciles à adapter à de nouveaux jeux de données. Cela réduit les frictions entre l’expérimentation et le déploiement, notamment dans les environnements où la fiabilité et l’efficacité comptent autant que les performances brutes.
Par exemple, dans les applications de robotique et de vision industrielle, les modèles doivent souvent être réentraînés fréquemment lorsque les environnements, les capteurs ou les tâches évoluent. Avec Ultralytics YOLO26, les équipes peuvent itérer plus rapidement sans craindre des sessions d’entraînement instables ni un comportement incohérent selon la taille des modèles.
Points clés à retenir#
La fiabilité des systèmes de vision par ordinateur dépend autant de la façon dont les modèles sont entraînés que de leurs performances au moment de l’inférence. En améliorant l’équilibre des signaux d’apprentissage, le traitement des petits objets et la progression de l’optimisation, Ultralytics YOLO26 rend l’entraînement plus stable et plus facile à faire passer à l’échelle. La recette d’entraînement de YOLO26 décrit les paramètres utilisés pour les points de contrôle officiels. Cette priorité accordée à la fiabilité de l’entraînement aide les équipes à passer plus facilement de l’expérimentation au déploiement dans le monde réel, en particulier pour les applications conçues d’abord pour la périphérie.
Tu veux en savoir plus sur l’IA ? Consulte notre dépôt GitHub pour en découvrir davantage. Rejoins notre communauté active et découvre les innovations dans des secteurs comme l’IA dans la logistique et l’IA visuelle dans l’industrie automobile. Pour te lancer dès aujourd’hui dans la vision par ordinateur, consulte nos options de licence.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









