L’impact de la conception plus rapide d’Ultralytics YOLO26, pensée pour la périphérie
Découvre comment Ultralytics YOLO26 est plus rapide en périphérie et pourquoi cela compte pour les applications de vision par ordinateur de nouvelle génération qui exigent une faible latence et une grande efficacité.
 Abirami Vina14 min de lecture
Plus tôt cette semaine, Ultralytics a officiellement lancé Ultralytics YOLO26, un modèle YOLO plus rapide, plus léger et plus compact, conçu pour améliorer les performances des systèmes de vision par ordinateur en périphérie. YOLO26 prend en charge les mêmes tâches de vision essentielles que les modèles YOLO précédents, notamment la détection d’objets et la segmentation d’instances.
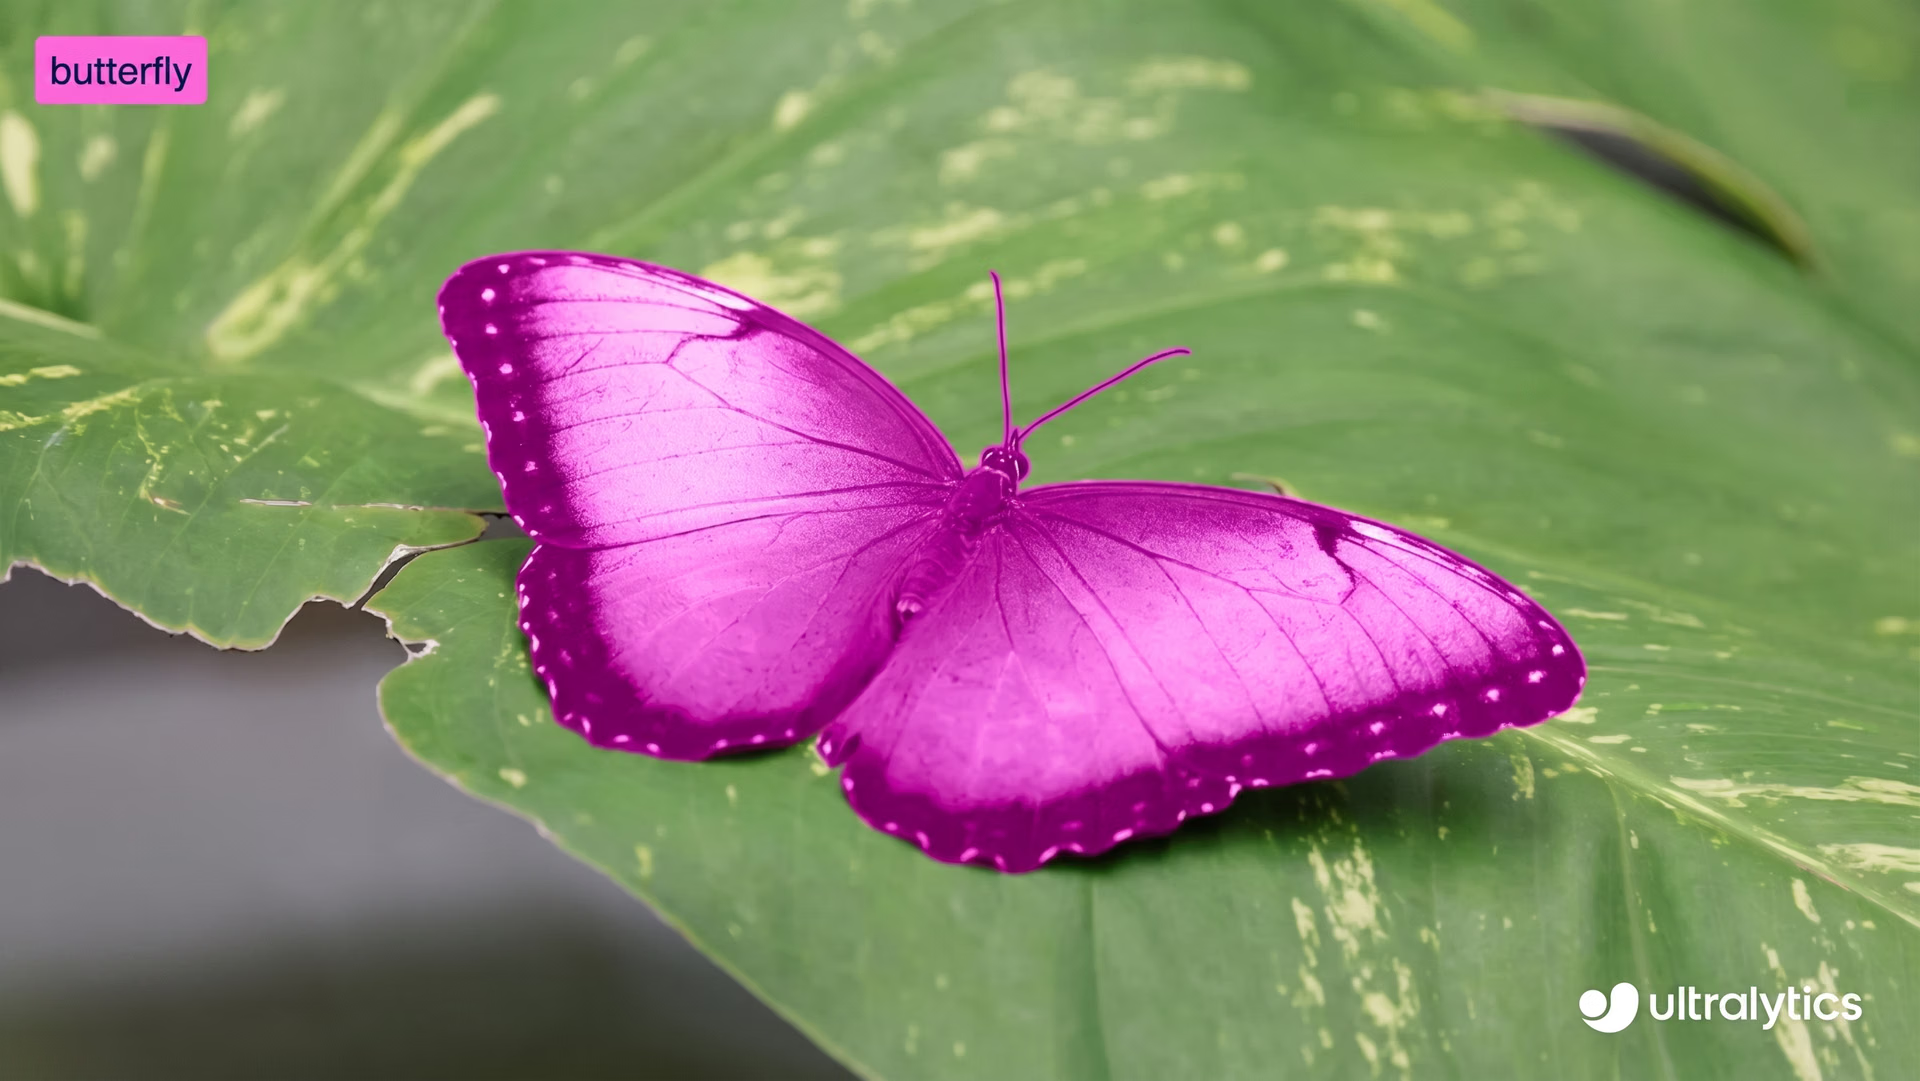
Fig. 1. Exemple de segmentation d’un objet avec Ultralytics YOLO26.
La principale différence entre Ultralytics YOLO26 et les modèles précédents tient à l’environnement pour lequel il a été conçu. Plutôt que d’optimiser principalement les unités de traitement graphique (GPUs) dans le cloud ou les performances axées sur les benchmarks, YOLO26 a été conçu dès le départ pour être déployé dans des conditions réelles sur des appareils en périphérie et du matériel embarqué.
À mesure que la vision par ordinateur passe de la recherche à la production, la réalité des contraintes de performance se précise. Les environnements edge se caractérisent par des budgets de latence serrés, des contraintes de mémoire, d’alimentation et de température, ainsi que par la nécessité d’un comportement prévisible sur des plateformes variées.
Dans ces conditions, les performances globales du système dépendent non seulement de la vitesse brute d’inférence, mais aussi de l’efficacité de l’ensemble du pipeline. Les frais généraux du post-traitement, la pression sur la mémoire et les chemins d’exécution propres à chaque plateforme constituent souvent des goulots d’étranglement.
Ultralytics YOLO26 répond à ces défis avec une approche plus rapide, pensée d’abord pour l’edge, qui prend en compte l’ensemble du pipeline d’inférence plutôt que des métriques propres à un modèle. En privilégiant l’optimisation pour l’edge, en simplifiant le pipeline d’inférence et en supprimant les étapes de post-traitement superflues, YOLO26 améliore la vitesse, ce qui réduit la latence et renforce la fiabilité en production.
Dans cet article, nous allons voir comment les choix architecturaux d’Ultralytics YOLO26 se traduisent par des gains de performances en conditions réelles, et pourquoi accélérer le traitement sur l’edge change fondamentalement les possibilités des applications de vision par ordinateur de nouvelle génération.
La réalité du déploiement sur l’edge#
L’exécution de modèles de vision par ordinateur sur l’edge est très différente de leur exécution dans le cloud. Dans le cloud, les systèmes ont généralement accès à de puissants GPU, à une grande quantité de mémoire et à du matériel stable. Sur l’edge, ces mêmes hypothèses ne s’appliquent pas.
La plupart des déploiements edge reposent sur des architectures matérielles variées, et non sur des GPU. Les appareils utilisent généralement plusieurs processeurs spécialisés pour différentes tâches. Ces processeurs sont optimisés pour l’efficacité et la faible consommation, plutôt que pour la puissance de calcul brute des GPU du cloud.
La latence constitue une autre contrainte majeure. Les systèmes edge doivent souvent respecter des limites strictes de temps réel, où même de faibles retards peuvent affecter la réactivité ou la sécurité. Dans ces situations, la latence de bout en bout compte davantage que la vitesse brute d’inférence. Un modèle peut sembler rapide sur le papier, mais ne pas être à la hauteur une fois le post-traitement et les transferts de données pris en compte.
La mémoire joue également un rôle important. De nombreux appareils edge disposent d’une mémoire limitée et de caches partagés. Les grands tenseurs intermédiaires et une utilisation inefficace de la mémoire peuvent ralentir les systèmes, même si le modèle lui-même est efficace.
Les limites d’alimentation et de température imposent d’autres contraintes. Les appareils edge fonctionnent souvent sans refroidissement actif et avec un budget énergétique fixe. Les performances doivent être efficaces et durables, pas seulement élevées pendant de courtes périodes.
À tout cela s’ajoute la nécessité d’assurer la cohérence des déploiements edge. Les modèles doivent se comporter de la même manière sur différents appareils et environnements d’exécution. Le code propre à une plateforme ou les étapes complexes de post-traitement peuvent introduire des différences subtiles qui compliquent le déploiement et la maintenance des systèmes.
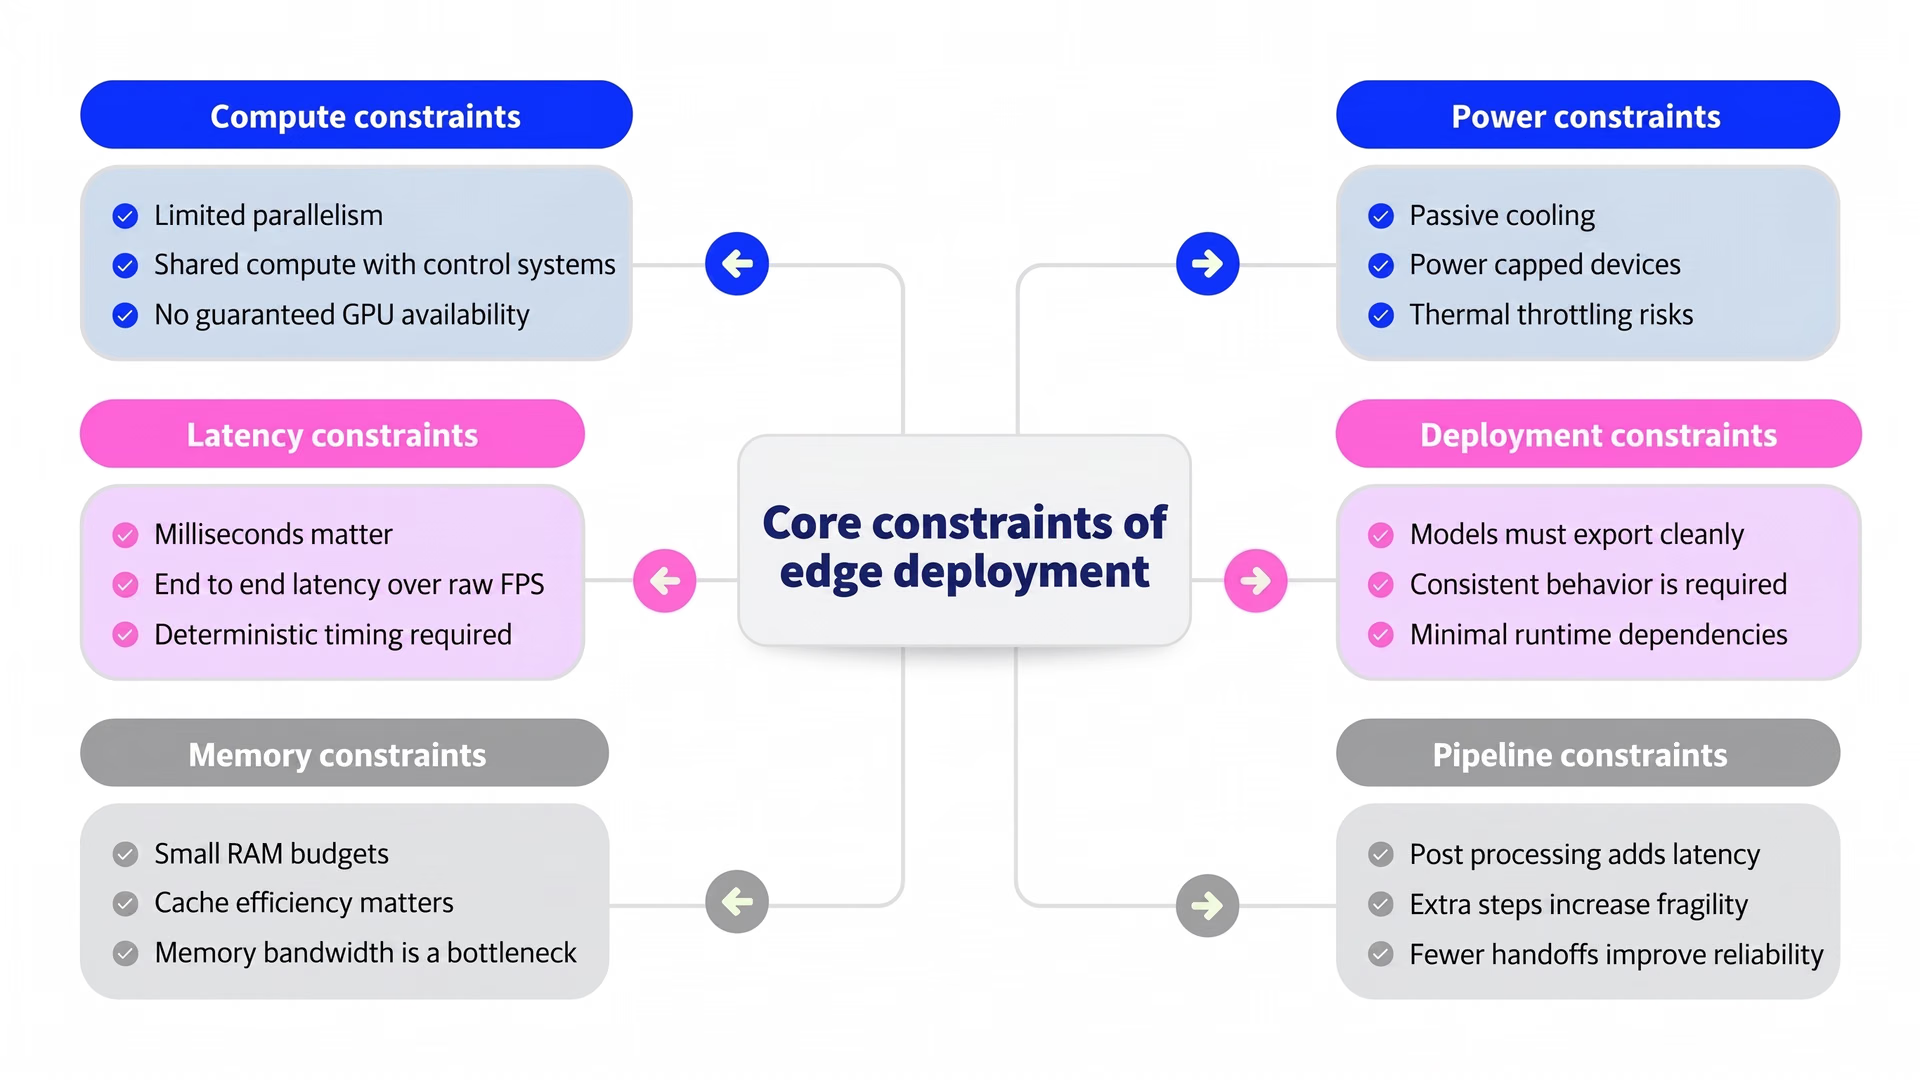
Fig. 2. Aperçu des contraintes liées au déploiement sur l’edge. Image de l’auteur.
Ces contraintes définissent ce que signifie réellement la performance sur l’edge. Autrement dit, la performance se mesure à l’échelle du pipeline entier, et non à l’aide d’une seule métrique.
Pourquoi la vision sur l’edge exige un modèle de performance différent#
Quel est donc le lien entre les contraintes du déploiement sur l’edge et les exigences d’un modèle de vision par ordinateur conçu pour l’edge ? Ce lien devient évident lorsque les modèles passent du contexte de la recherche aux systèmes en conditions réelles.
Dans le cloud, les performances sont souvent mesurées à l’aide de benchmarks comme la vitesse et la précision de l’inférence. Sur l’edge, ces métriques ne racontent qu’une partie de l’histoire. Les systèmes de vision fonctionnent généralement sur du matériel hétérogène : l’inférence du réseau neuronal est déléguée à des accélérateurs spécialisés, tandis que d’autres parties du pipeline s’exécutent sur des processeurs généralistes.
Dans ce contexte, la vitesse du modèle ne suffit pas. L’essentiel est de savoir comment se comporte le système entier une fois le modèle déployé. Un modèle peut sembler rapide lorsqu’il fonctionne seul, mais ne pas être à la hauteur si le post-traitement, les transferts de données ou les étapes propres à une plateforme génèrent des frais supplémentaires.
C’est pourquoi la vision sur l’edge exige un modèle de performance axé sur l’efficacité du système dans son ensemble, plutôt que sur des benchmarks isolés. Ultralytics YOLO26 reflète cette évolution en privilégiant l’optimisation pour l’edge, une inférence rationalisée et une exécution de bout en bout conçue pour les déploiements en conditions réelles.
La base de la vitesse : une conception pensée d’abord pour l’edge#
Sur l’edge, les performances dépendent de l’adéquation entre le modèle et l’architecture matérielle réelle de l’appareil. Concevoir d’abord pour l’edge garantit que les systèmes de vision fonctionnent de manière fiable sur des plateformes réelles, quelle que soit la combinaison d’unités de traitement disponibles.
Une approche pensée d’abord pour l’edge privilégie une exécution prévisible et efficace sur du matériel hétérogène, plutôt que d’adapter après coup des modèles optimisés pour les GPU du cloud. Concrètement, cela signifie privilégier les opérations qui se prêtent bien aux accélérateurs de réseaux neuronaux, réduire au minimum les tâches non neuronales exécutées en dehors du modèle et limiter la complexité superflue susceptible de ralentir l’exécution de bout en bout.
Ultralytics YOLO26 a été conçu en tenant compte de ces contraintes. Son architecture vise des performances cohérentes plutôt qu’un débit maximal dans des conditions idéales. En simplifiant les chemins d’exécution et en éliminant les calculs superflus, YOLO26 réduit les frais généraux du pipeline d’inférence et exploite mieux les capacités d’accélération et la hiérarchie mémoire disponibles sur l’appareil.
Cette approche améliore également la fiabilité. L’optimisation pensée d’abord pour l’edge rend les temps d’exécution plus prévisibles et limite les pics de latence, ce qui est essentiel pour les systèmes temps réel. Au lieu de s’appuyer sur du matériel spécialisé ou un post-traitement lourd pour gagner en vitesse, Ultralytics YOLO26 mise sur l’efficacité de l’ensemble du pipeline d’inférence.
L’inférence de bout en bout et le coût du post-traitement#
Tu te demandes peut-être ce que signifie la suppression des étapes de post-traitement superflues. Pour le comprendre, prenons un peu de recul et examinons le fonctionnement des systèmes traditionnels de détection d’objets.
Dans de nombreux pipelines de détection d’objets, l’inférence ne s’arrête pas lorsque le modèle produit ses prédictions. Le modèle génère plutôt un grand nombre de boîtes englobantes qui se chevauchent, qu’il faut ensuite filtrer et affiner avant de pouvoir les utiliser. Ce nettoyage repose sur des étapes de post-traitement exécutées en dehors du modèle lui-même.
L’une des étapes de post-traitement les plus courantes est la suppression non maximale, ou NMS. NMS compare les boîtes englobantes qui se chevauchent et conserve les détections les plus sûres, en éliminant les doublons correspondant au même objet. Cette méthode est efficace, mais elle ajoute des calculs une fois l’inférence terminée.
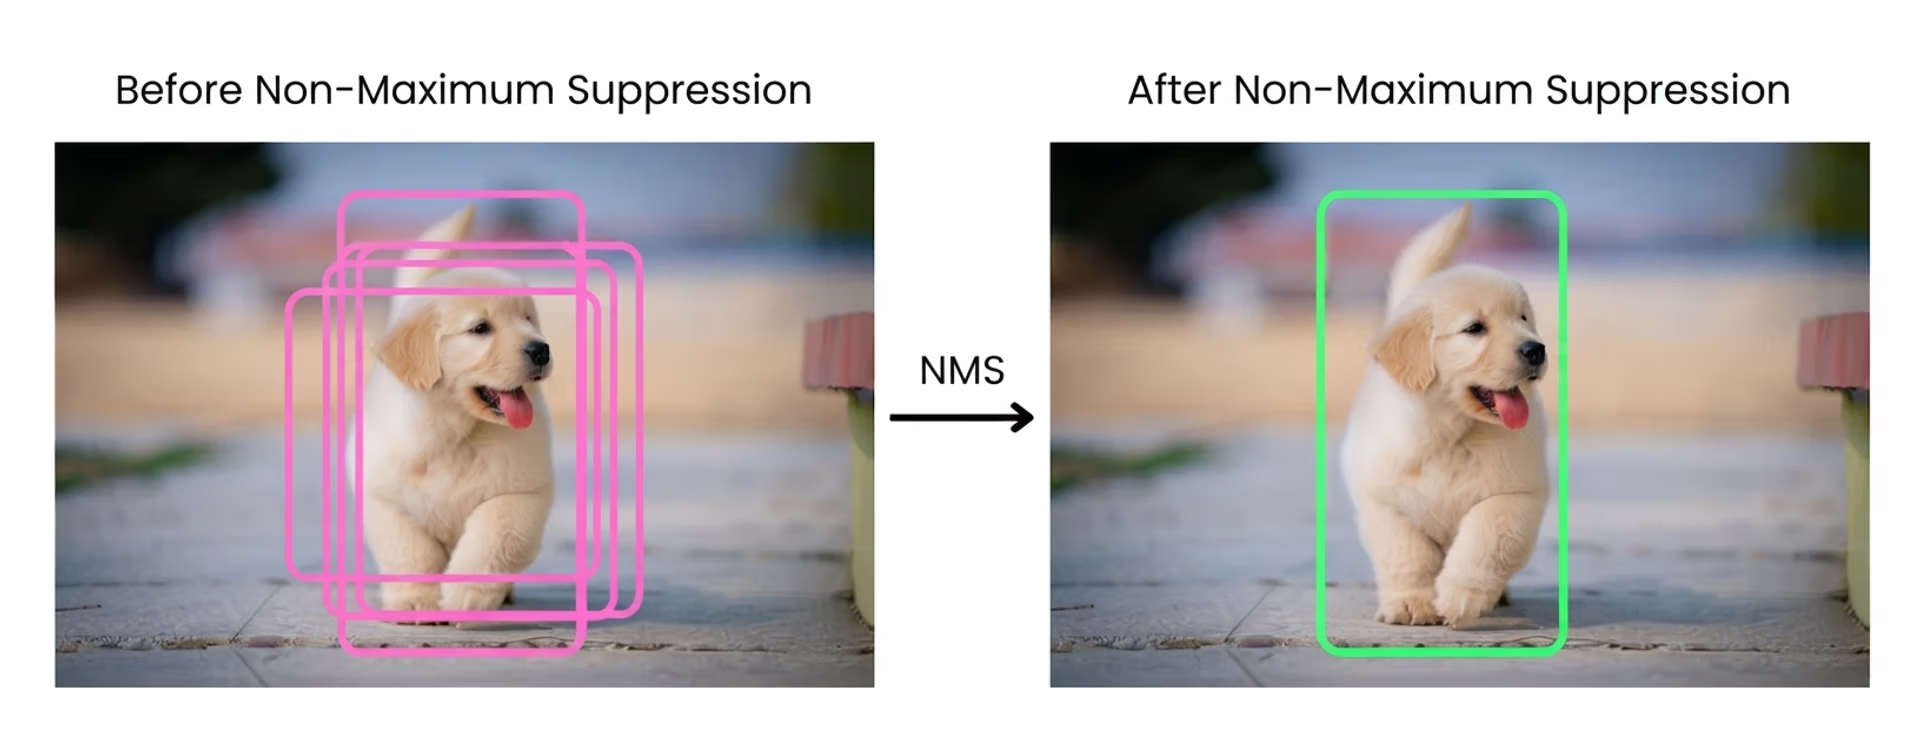
Fig. 3. Comprendre NMS. Image de l’auteur.
Sur l’edge, ce travail supplémentaire a un coût. Les étapes de post-traitement comme NMS sont mal adaptées aux accélérateurs spécialisés utilisés pour l’inférence des réseaux neuronaux, qui sont optimisés pour les calculs neuronaux denses plutôt que pour les opérations riches en contrôle ou gourmandes en mémoire.
NMS ajoute donc de la latence et sollicite davantage la mémoire, et son coût augmente avec le nombre de détections. Même lorsque le modèle lui-même est rapide, NMS peut encore représenter une part importante du temps d’exécution total.
Le post-traitement accroît également la complexité du système. Comme il est exécuté en dehors du modèle, il doit être implémenté séparément pour chaque environnement d’exécution et chaque cible matérielle. Cela entraîne souvent des chemins d’exécution propres à chaque plateforme, des comportements incohérents d’un appareil à l’autre et des pipelines de déploiement plus fragiles.
Surtout, le post-traitement contredit l’idée d’une véritable performance de bout en bout. Mesurer la vitesse d’inférence du modèle ne reflète pas le comportement du système en production. Ce qui compte au final, c’est le temps total entre l’entrée et la sortie, en incluant chaque étape du pipeline.
Dans ces situations, le post-traitement devient un goulot d’étranglement invisible sur l’edge. Il ajoute de la latence, consomme des ressources CPU et complique le déploiement, tout en restant extérieur au modèle lui-même.
Comment Ultralytics YOLO26 supprime NMS et pourquoi cela accélère l’inférence#
YOLO26 supprime NMS en s’attaquant à la cause première des détections en double, plutôt qu’en les éliminant après l’inférence. Au lieu de produire de nombreuses prédictions qui se chevauchent et doivent être filtrées, le modèle est entraîné à générer directement un ensemble plus restreint de détections finales fiables.
Cela est possible en modifiant la manière dont les détections sont apprises pendant l’entraînement. Ultralytics YOLO26 favorise une relation un-à-un plus claire entre les objets et les prédictions, ce qui réduit la redondance à la source. Les détections en double sont ainsi éliminées au sein même du réseau plutôt que par un post-traitement externe.
La suppression de NMS a un effet immédiat sur les performances sur l’edge. Comme NMS s’adapte mal aux accélérateurs de réseaux neuronaux, son élimination réduit les transferts de mémoire et évite les coûteuses étapes de traitement non neuronal. La latence de bout en bout diminue et les performances deviennent plus prévisibles, notamment sur les appareils edge où le post-traitement peut autrement occuper une part notable du temps d’exécution total.
Cela simplifie également le pipeline d’inférence. Avec moins d’étapes à l’extérieur du modèle, les transferts de données et les passages de relais entre composants diminuent. La sortie du modèle étant déjà le résultat final, l’exécution devient plus prévisible.
La suppression de DFL pour une véritable performance de bout en bout#
Ultralytics YOLO26 apporte une autre innovation en supprimant la Distribution Focal Loss, ou DFL, utilisée dans les précédents modèles YOLO pour la régression des boîtes englobantes. Au lieu de prédire directement une coordonnée unique, les modèles utilisant DFL apprenaient une distribution de valeurs possibles, puis en déduisaient une boîte englobante finale. Cette approche a contribué à améliorer la précision de localisation et constituait une avancée importante dans les générations précédentes.
Au fil du temps, toutefois, DFL a aussi entraîné des compromis. La prédiction de distributions accroît les calculs et complexifie l’architecture du modèle, ce qui peut ralentir l’inférence sur les CPU et compliquer l’exportation des modèles vers différents formats de déploiement. DFL imposait également des plages de régression fixes, susceptibles de limiter la flexibilité lors de la détection d’objets très grands.
Ultralytics YOLO26 supprime DFL dans le cadre de sa transition vers une architecture de bout en bout plus simple. La régression des boîtes englobantes a été repensée pour être plus directe, ce qui réduit les calculs superflus tout en maintenant la précision. Cette modification s’inscrit dans l’approche sans NMS de YOLO26.
D’où vient l’accélération de 43 % de l’inférence sur CPU#
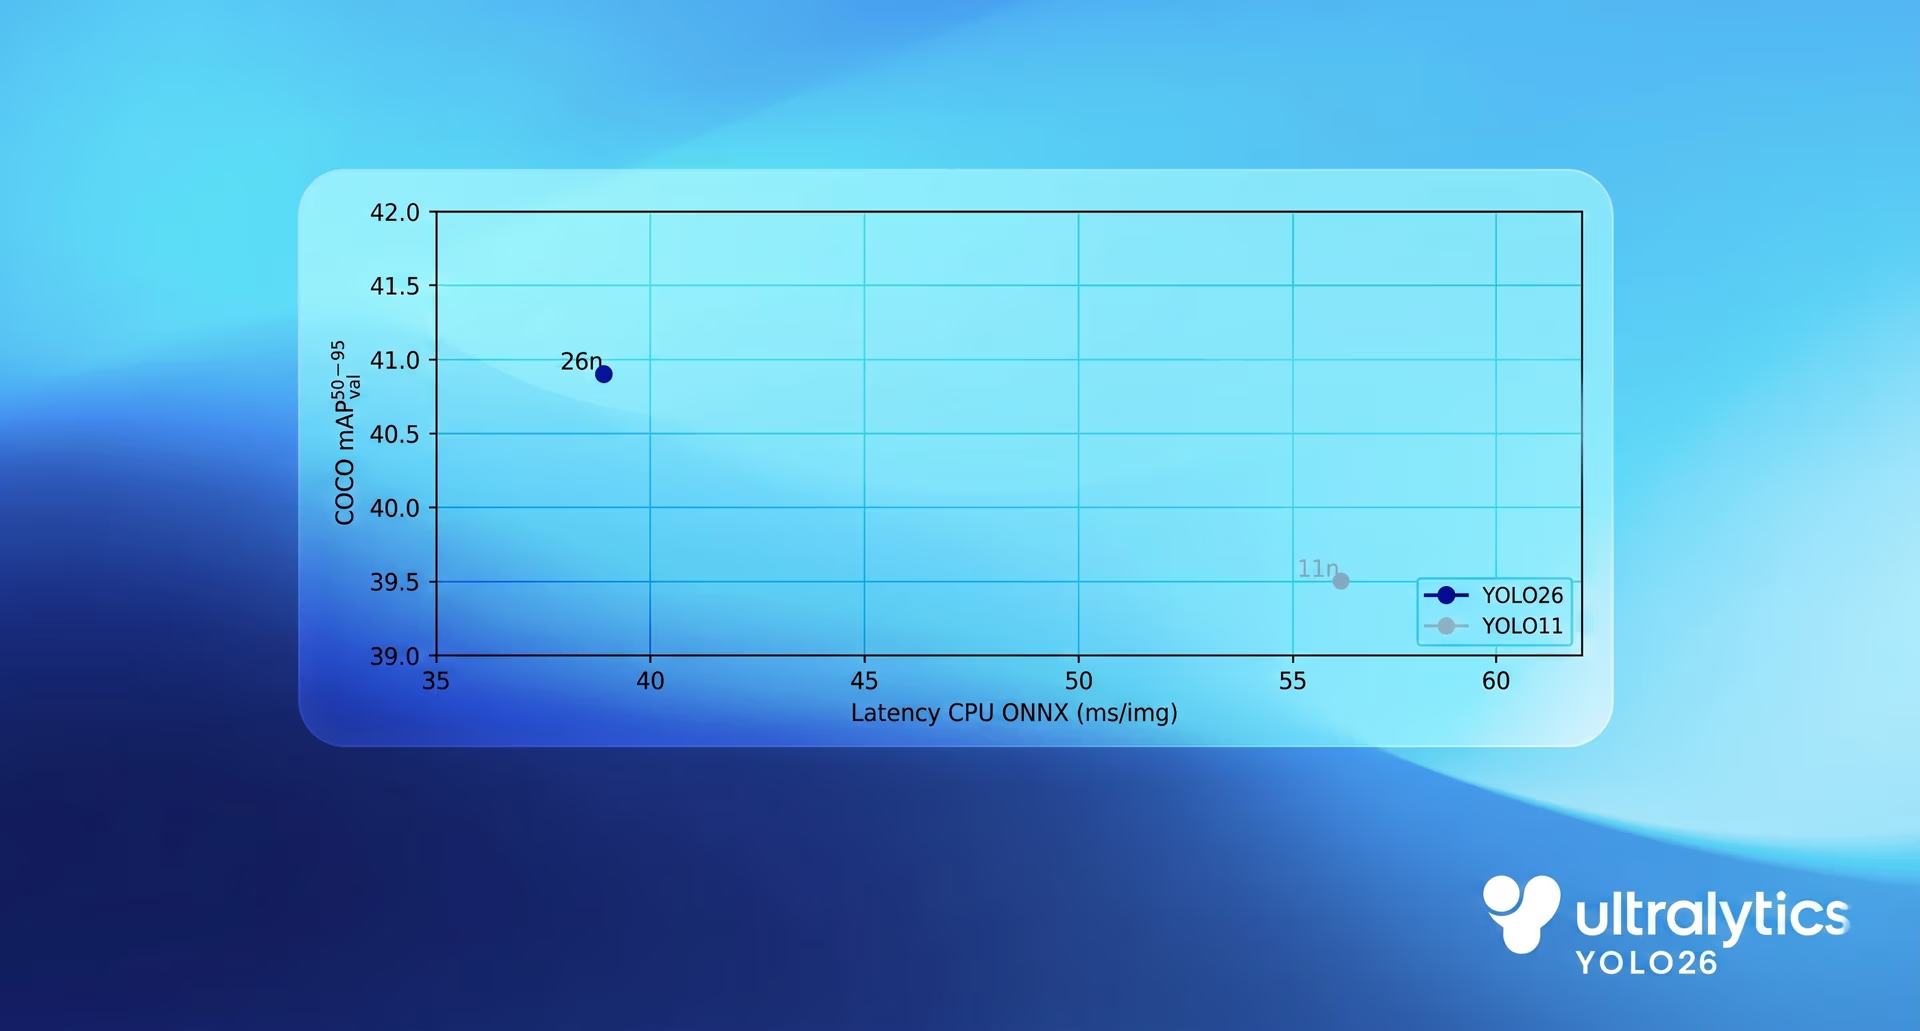
Dans les benchmarks sur CPU, YOLO26 affiche une nette amélioration des performances par rapport aux anciens modèles YOLO. Comparé à Ultralytics YOLO11, le modèle nano YOLO26 offre une inférence sur CPU jusqu’à 43 % plus rapide, un écart qui a un effet notable dans les déploiements réels en périphérie.
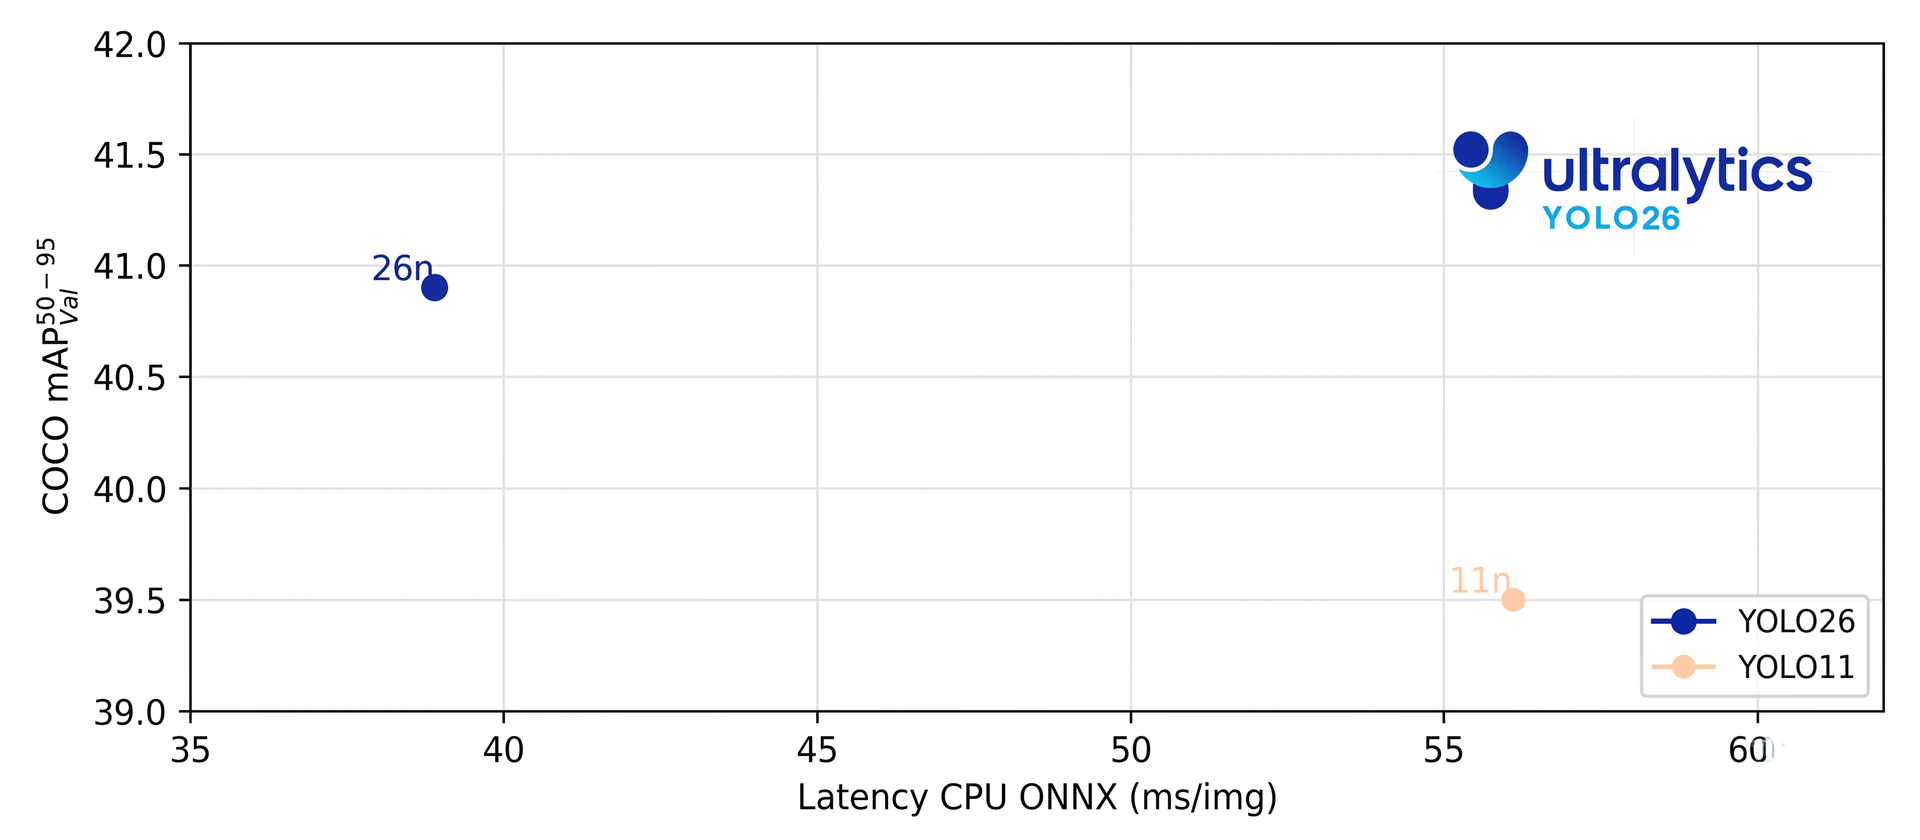
Fig. 4. Benchmark de la vitesse de YOLO26 d’Ultralytics sur CPU.
Ce gain provient de la simplification de l’ensemble du pipeline d’inférence, plutôt que de l’optimisation d’un seul composant. L’exécution de bout en bout supprime les frais généraux du post-traitement, une méthode plus directe de régression des boîtes englobantes réduit les calculs, et des choix de conception privilégiant le CPU améliorent l’efficacité de l’exécution sur les processeurs généralistes.
Ensemble, ces changements réduisent la latence, diminuent la charge du CPU et accélèrent les performances tout en les rendant plus cohérentes sur du matériel edge utilisé en conditions réelles.
L’impact d’Ultralytics YOLO26 sur le déploiement et les exports sur l’edge#
Les gains de performances d’Ultralytics YOLO26 vont au-delà d’une inférence plus rapide. En simplifiant le modèle et en réduisant la charge mémoire, il devient plus facile à déployer et plus fiable dans différents environnements edge.
La conception de bout en bout d’Ultralytics YOLO26 simplifie également l’exportation. Avec moins de composants auxiliaires et sans étapes de post-traitement externes, les modèles exportés sont entièrement autonomes. Cela réduit les dépendances propres à chaque plateforme et contribue à garantir un comportement cohérent entre les environnements d’exécution et les cibles matérielles.
Concrètement, Ultralytics YOLO26 peut être déployé plus facilement sur des appareils en périphérie, comme des caméras, des robots et des systèmes embarqués, grâce à différents formats d’exportation. Ce que tu exportes est ce que tu exécutes, avec moins d’étapes d’intégration et moins de risques de dérive lors du déploiement.
Une inférence plus rapide sur l’edge au service de la robotique et de l’IA visuelle industrielle#
Jusqu’ici, nous avons vu comment la conception d’Ultralytics YOLO26, pensée d’abord pour l’edge, améliore les performances à l’échelle du système. Son véritable impact tient toutefois à la manière dont il facilite l’intégration de l’IA visuelle dans des applications réelles.
Par exemple, dans les environnements de robotique et industriels, les systèmes de vision doivent souvent respecter des contraintes strictes de temps réel. Les décisions doivent être prises rapidement et de manière cohérente, avec des ressources de calcul limitées et sans dépendre d’une connexion au cloud. Ultralytics YOLO26 permet de répondre concrètement à ces exigences.
Les applications comme la navigation des robots et la manipulation d’objets bénéficient d’une latence plus faible et d’une inférence plus prévisible, ce qui permet aux robots de réagir en douceur aux changements de leur environnement. De même, en milieu industriel, les modèles de vision peuvent fonctionner directement sur les lignes de production pour détecter les défauts, suivre les composants et surveiller les processus sans introduire de retard ni de complexité supplémentaire.
En permettant une inférence rapide et fiable sur du matériel périphérique, Ultralytics YOLO26 contribue à faire de l’IA visuelle une composante naturelle de la robotique et des systèmes industriels, plutôt qu’un défi de déploiement et de maintenance.
Points clés à retenir#
Ultralytics YOLO26 a été conçu pour l’edge, où les contraintes du monde réel, comme la latence, la mémoire et la fiabilité, déterminent ce qui est possible. En concevant le modèle autour d’une exécution privilégiant le CPU, d’une inférence de bout en bout et d’un déploiement simplifié, YOLO26 rend l’IA visuelle facile à intégrer dans des systèmes réels. Cette approche axée sur l’edge permet un large éventail d’applications, de la robotique et de la vision industrielle à l’IA embarquée et exécutée directement sur l’appareil, où les performances et la prévisibilité sont primordiales.
Rejoins notre communauté grandissante et explore notre dépôt GitHub pour découvrir des ressources pratiques sur l’IA. Pour développer avec l’IA visuelle dès aujourd’hui, découvre nos options de licence. Découvre comment l’IA dans l’agriculture transforme les pratiques agricoles et comment l’IA visuelle dans les soins de santé façonne l’avenir en consultant nos pages de solutions.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









