Apprentissage auto-supervisé pour le débruitage : décryptage étape par étape
Découvre le fonctionnement de l’apprentissage auto-supervisé pour le débruitage, pourquoi les images sont bruitées et les principales méthodes et étapes utilisées pour restaurer des détails visuels nets.
Les caméras ne capturent pas toujours le monde comme nous le percevons. Un portrait pris en basse lumière ou une photo d’une voiture roulant rapidement peut paraître granuleux, flou ou déformé.
Des capteurs lents, des environnements sombres et les mouvements peuvent introduire de minuscules mouchetures de bruit qui adoucissent les contours et masquent des détails importants. Lorsque cette netteté disparaît, même les systèmes avancés d’IA et d’apprentissage automatique peuvent avoir du mal à comprendre ce que contient une image, car de nombreux systèmes intelligents dépendent de ces détails fins pour fonctionner correctement.
Par exemple, la vision par ordinateur est une branche de l’intelligence artificielle qui permet aux machines d’interpréter des images et des vidéos. Pour y parvenir avec précision, les modèles d’IA de vision ont toutefois besoin de données visuelles propres et de haute qualité pour leur apprentissage.
Plus précisément, des modèles comme Ultralytics YOLO11 et le prochain Ultralytics YOLO26 prennent en charge des tâches telles que la détection d’objets, la segmentation d’instances et l’estimation de pose, et peuvent être entraînés sur mesure pour différents cas d’usage. Ces tâches reposent sur des indices visuels nets tels que les contours, les textures, les couleurs et les détails structurels fins.
Lorsque le bruit masque ces caractéristiques, le modèle reçoit des signaux d’apprentissage plus faibles, ce qui complique l’apprentissage de motifs précis. Par conséquent, même de petites quantités de bruit peuvent réduire les performances dans les applications réelles.
Précédemment, nous avons vu comment l’apprentissage auto-supervisé débruite les images. Dans cet article, nous allons approfondir le fonctionnement des techniques de débruitage auto-supervisé et la manière dont elles contribuent à récupérer des informations visuelles pertinentes. C’est parti !
Types courants de bruit dans les images du monde réel#
Avant d’examiner l’utilisation de l’apprentissage auto-supervisé pour le débruitage d’images, revenons d’abord sur les raisons pour lesquelles les images deviennent bruitées.
Les images d’objets et de scènes du monde réel sont rarement parfaites. Un faible éclairage, une qualité de capteur limitée et des mouvements rapides peuvent introduire des perturbations aléatoires dans les pixels individuels de l’image. Ces perturbations au niveau des pixels, appelées bruit, réduisent la netteté globale et rendent les détails importants plus difficiles à voir.
Lorsque le bruit masque les contours, les textures et les motifs subtils, les systèmes de vision par ordinateur peinent à reconnaître les objets ou à interpréter les scènes avec précision. Des conditions différentes produisent des types de bruit différents, chacun affectant l’image à sa manière.
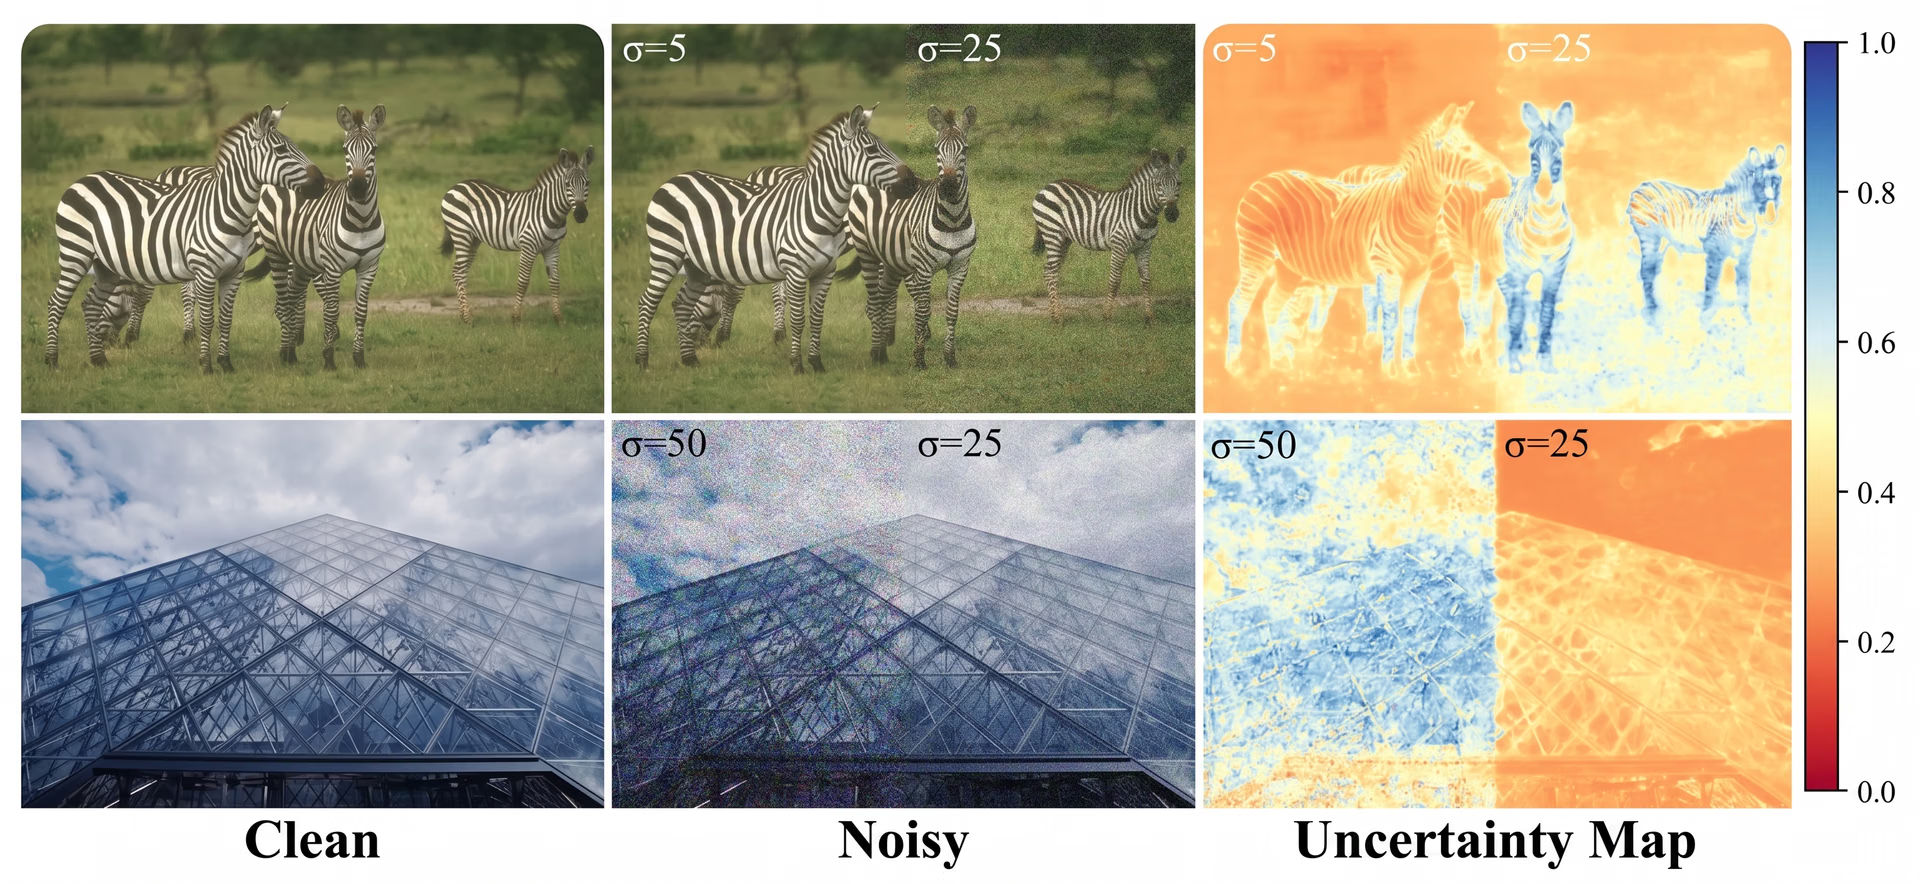
Fig. 1. Exemple de la manière dont le bruit peut accroître l’incertitude dans une image. (Source)
Voici quelques-uns des types de bruit les plus courants présents dans les images :
- Bruit gaussien : Ce type de bruit se manifeste par un grain doux et aléatoire causé par des interférences électroniques du capteur ou des fluctuations thermiques. Il suit une distribution gaussienne (normale), dans laquelle de petites variations des pixels floutent les détails fins et réduisent la netteté globale.
- Bruit de Poisson : Également appelé bruit de grenaille, ce type de bruit survient dans des conditions de faible luminosité ou avec des temps d’exposition courts. Sa variance augmente avec la luminosité, mais le bruit est souvent plus visible dans les zones sombres, car moins de photons sont capturés, ce qui entraîne un rapport signal/bruit plus faible.
- Bruit sel et poivre : Ce type de bruit se manifeste par des pics nets de pixels noirs ou blancs. Il est généralement causé par des erreurs de transmission, une corruption des bits ou des capteurs d’appareil photo défectueux, et entraîne souvent l’absence ou la corruption de valeurs de pixels.
- Bruit de speckle : Ce type de bruit se manifeste par des motifs granuleux ressemblant à des taches et est courant en imagerie médicale, radar et échographique. Il est causé par des interférences et une diffusion du signal, ce qui réduit le contraste et rend les contours plus difficiles à détecter.
Quand utiliser le débruitage auto-supervisé ?#
Alors, qu’est-ce qui rend le débruitage auto-supervisé si particulier ? Il est particulièrement efficace lorsque des images propres de référence n’existent tout simplement pas ou sont trop difficiles à capturer.
C’est souvent le cas en photographie en basse lumière, en imagerie à ISO élevé, en imagerie médicale et scientifique, ou dans tout environnement où le bruit est inévitable et où collecter des données de référence parfaites est irréaliste. Au lieu d’avoir besoin d’exemples propres, le modèle apprend directement à partir des images bruitées dont tu disposes déjà, ce qui le rend adaptable aux motifs de bruit propres à ta caméra ou à ton capteur.
Le débruitage auto-supervisé est également une excellente option si tu veux améliorer les performances des tâches de vision par ordinateur en aval, mais que ton jeu de données contient beaucoup d’images incohérentes ou bruitées. En récupérant des contours, des textures et des structures plus nets, ces méthodes aident des modèles comme YOLO à détecter, segmenter et comprendre les scènes de manière plus fiable. En résumé, si tu travailles avec des données bruitées et que des images d’entraînement propres ne sont pas disponibles, le débruitage auto-supervisé constitue souvent la solution la plus pratique et la plus efficace.
Les techniques fondamentales du débruitage auto-supervisé#
Comme nous l’avons vu précédemment, le débruitage auto-supervisé est une approche d’IA fondée sur l’apprentissage profond qui permet aux modèles d’apprendre directement à partir d’images bruitées, sans dépendre d’annotations propres. Il repose sur les principes de l’apprentissage auto-supervisé, dans lequel les modèles génèrent leurs propres signaux d’apprentissage à partir des données elles-mêmes.
Autrement dit, un modèle peut s’enseigner à lui-même en utilisant des images bruitées à la fois comme entrée et comme source de son signal d’apprentissage. En comparant différentes versions corrompues d’une même image ou en prédisant des pixels masqués, le modèle apprend quels motifs représentent une structure réelle et lesquels ne sont que du bruit. Grâce à une optimisation itérative et à la reconnaissance de motifs, le réseau améliore progressivement sa capacité à distinguer le contenu pertinent d’une image des variations aléatoires.
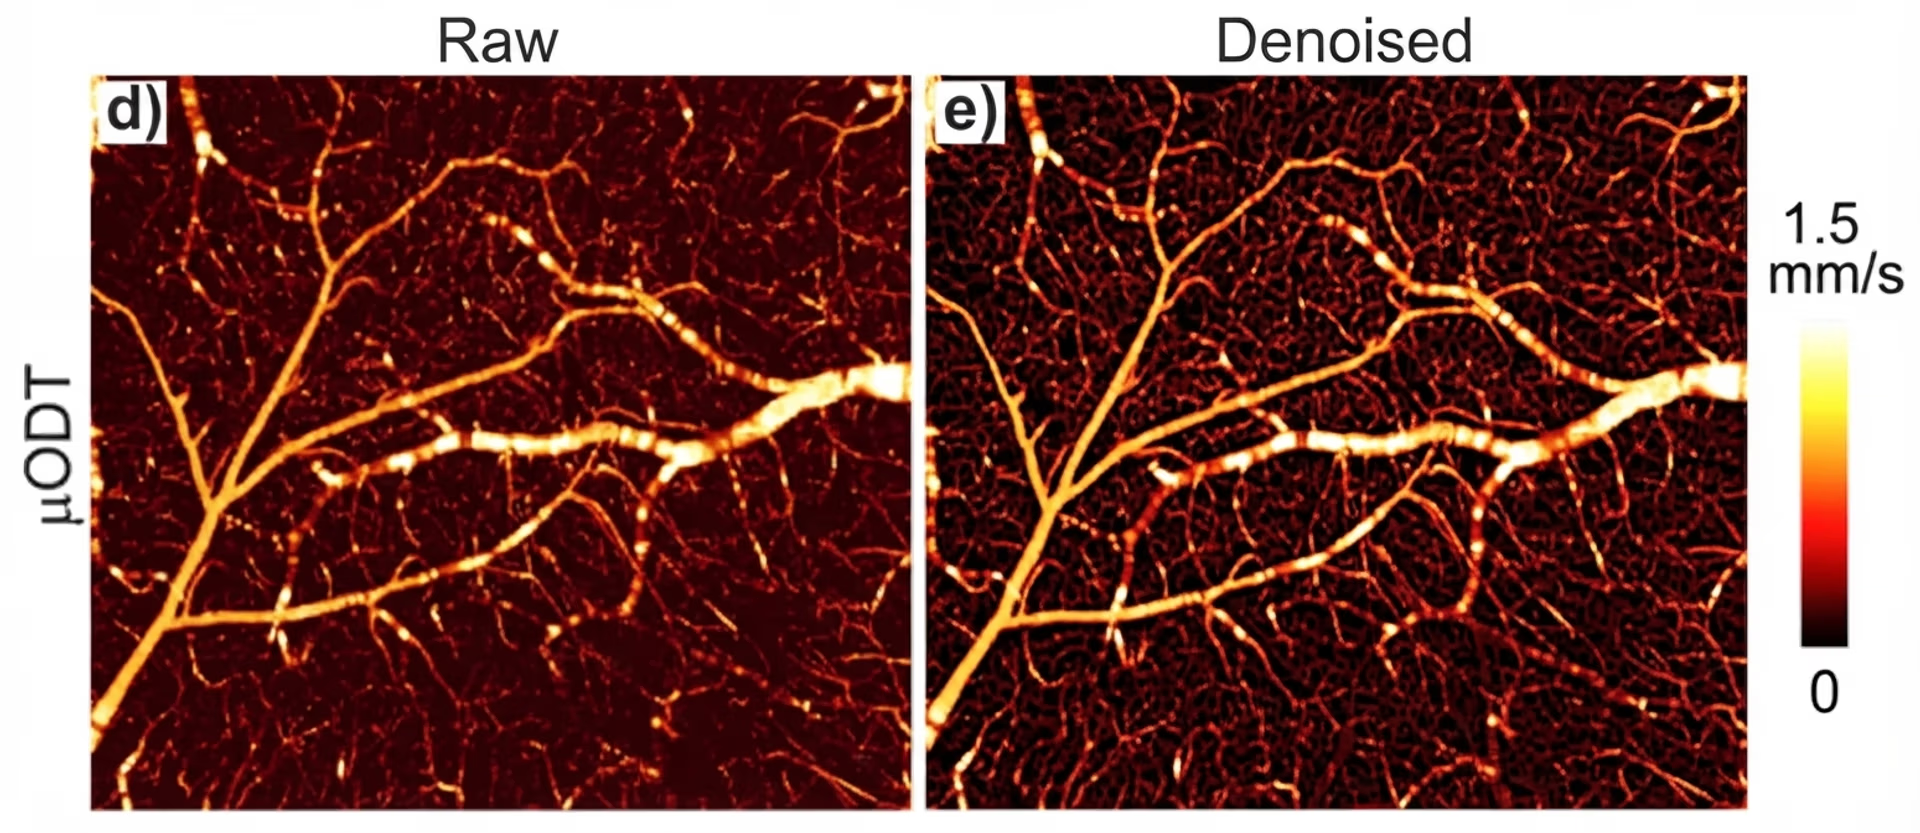
Fig. 2. Une image brute et une image débruitée. (Source)
Cela est rendu possible par des stratégies d’apprentissage spécifiques qui guident le modèle pour séparer la structure stable de l’image du bruit aléatoire. Examinons maintenant de plus près les techniques et algorithmes fondamentaux qui rationalisent ce processus, ainsi que la manière dont chaque approche aide les modèles à reconstruire des images plus propres et plus fiables.
Méthodes de débruitage d’images par paires#
De nombreuses premières méthodes d’apprentissage auto-supervisé pour le débruitage fonctionnaient en comparant deux versions bruitées d’une même image. Comme le bruit change aléatoirement chaque fois qu’une image est capturée ou corrompue, tandis que la structure réelle reste identique, ces différences peuvent servir de signal d’apprentissage pour un modèle.
Ces approches sont couramment appelées méthodes de débruitage d’images par paires, car elles utilisent ou génèrent des paires d’images bruitées pendant l’entraînement. Par exemple, l’approche Noise2Noise (proposée par Jaakko Lehtinen et son équipe) entraîne un modèle à l’aide de deux images indépendamment bruitées de la même scène. Les motifs de bruit différant entre les deux versions, le modèle apprend à identifier les détails cohérents qui représentent l’image sous-jacente réelle.
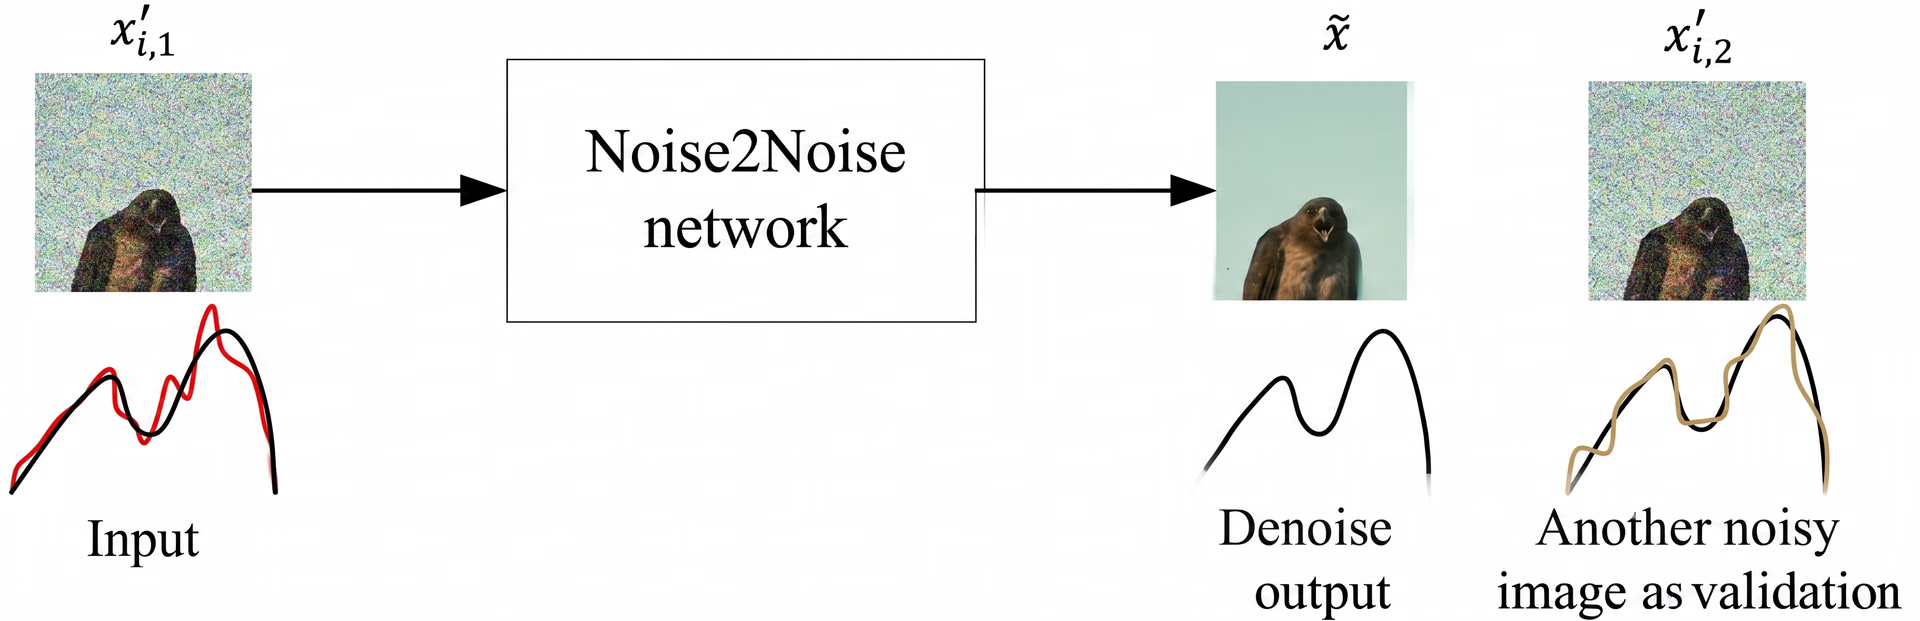
Fig. 3. Fonctionnement de Noise2Noise (Source)
Au fil du temps, cela apprend au réseau à supprimer le bruit aléatoire et à préserver la structure réelle, même s’il ne voit jamais d’image de référence propre. Imagine une situation simple : tu prends deux photos d’une rue peu éclairée pendant la nuit.
Chaque image contient les mêmes bâtiments, lumières et ombres, mais le bruit granuleux apparaît à des endroits différents. En comparant ces deux photos bruitées pendant l’entraînement, un modèle auto-supervisé peut apprendre quels motifs visuels sont stables et lesquels sont causés par le bruit, améliorant ainsi progressivement sa capacité à reconstruire des images plus propres.
Méthodes d’apprentissage auto-supervisé du débruitage fondées sur les zones aveugles#
Alors que les méthodes par paires reposent sur la comparaison de deux versions différemment corrompues d’une même image, les méthodes fondées sur les zones aveugles adoptent une approche différente. Elles permettent à un modèle d’apprendre à partir d’une seule image bruitée en masquant certains pixels afin que le réseau ne puisse pas voir leurs valeurs corrompues.
Le modèle doit ensuite prédire les pixels masqués en utilisant uniquement le contexte environnant. L’idée centrale est que le bruit est aléatoire, tandis que la structure sous-jacente d’une image ne l’est pas.
En empêchant le modèle de recopier la valeur bruitée d’un pixel, les méthodes fondées sur les zones aveugles l’incitent à déduire quelle devrait être cette valeur à partir de motifs d’image stables, tels que les contours, les textures ou les dégradés de couleur voisins. Des techniques comme Noise2Void (présentée par Alexander Krull et son équipe) et Noise2Self (développée par Joshua Batson et Loïc Royer) mettent en œuvre ce principe en masquant des pixels individuels ou de petites zones voisines, puis en entraînant le modèle à les reconstruire.
Des approches plus avancées, notamment Noise2Same et PN2V, améliorent la robustesse en imposant des prédictions cohérentes sur plusieurs versions masquées ou en modélisant explicitement la distribution du bruit afin d’estimer l’incertitude. Comme ces méthodes ne nécessitent qu’une seule image bruitée, elles sont particulièrement utiles dans les domaines où capturer des images propres ou appariées est difficile, voire impossible, comme la microscopie, l’astronomie, l’imagerie biomédicale ou la photographie en basse lumière.
Méthodes de débruitage assistées par Transformer#
La plupart des méthodes de débruitage auto-supervisé par paires et fondées sur les zones aveugles reposent sur des réseaux neuronaux convolutifs (CNNs) ou des réseaux de débruitage. Les CNNs sont une excellente option pour ces approches, car ils se concentrent sur les motifs locaux, notamment les contours, les textures et les petits détails.
Des architectures comme U-Net sont largement utilisées, car elles combinent des caractéristiques très détaillées avec des informations multi-échelles. Cependant, les CNNs opèrent principalement dans des voisinages limités, ce qui signifie qu’ils peuvent manquer des relations importantes s’étendant sur de plus grandes régions d’une image.
Les méthodes de débruitage de pointe assistées par Transformer ont été introduites pour remédier à cette limitation. Au lieu d’examiner uniquement les pixels voisins, la méthode proposée utilise des mécanismes d’attention pour comprendre comment les différentes parties d’une image sont liées les unes aux autres.
Certains modèles utilisent une attention globale complète, tandis que d’autres recourent à une attention par fenêtres ou hiérarchique pour réduire les calculs, mais ils sont généralement conçus pour capturer une structure à longue portée que les CNNs seuls ne peuvent pas saisir. Cette vision plus large aide le modèle à restaurer des textures répétitives, des surfaces lisses ou de grands objets qui nécessitent des informations provenant de l’ensemble de l’image.
Autres méthodes de débruitage d’images#
Outre les techniques auto-supervisées, il existe également plusieurs autres moyens de nettoyer les images bruitées. Les méthodes traditionnelles, comme le filtrage bilatéral, le débruitage par ondelettes et les moyennes non locales, utilisent des règles mathématiques simples pour atténuer le bruit tout en essayant de préserver les détails importants.
Par ailleurs, il existe aussi des approches fondées sur l’apprentissage profond, notamment des modèles supervisés qui apprennent à partir de paires d’images propres et bruitées, ainsi que des réseaux antagonistes génératifs (GANs) qui produisent des résultats plus nets et plus réalistes. Cependant, ces méthodes nécessitent généralement une meilleure qualité d’image pour l’entraînement.
Fonctionnement du débruitage d’images auto-supervisé, étape par étape#
Puisque nous venons de passer en revue plusieurs techniques différentes, tu te demandes peut-être si chacune fonctionne d’une manière complètement différente, étant donné qu’elles utilisent leurs propres architectures. Cependant, elles suivent toutes un pipeline similaire qui commence par la préparation des données et se termine par l’évaluation du modèle.
Examinons maintenant de plus près, étape par étape, le fonctionnement global du processus de débruitage d’images auto-supervisé.
Étape 1 : Prétraitement et normalisation#
Avant que le modèle puisse commencer à apprendre à partir d’images bruitées, la première étape consiste à s’assurer que toutes les images ont un aspect cohérent. Les photos réelles peuvent être très différentes.
Certaines images peuvent être trop lumineuses, d’autres trop sombres, et certaines peuvent présenter des couleurs légèrement décalées. Si nous transmettons directement ces variations à un modèle, il lui devient plus difficile de se concentrer sur l’apprentissage de l’apparence du bruit.
Pour y remédier, chaque image passe par une normalisation et un prétraitement de base. Cela peut inclure la mise à l’échelle des valeurs de pixels dans une plage standard, la correction des variations d’intensité ou le recadrage et le redimensionnement. L’essentiel est que le modèle reçoive des données propres pouvant servir d’entrées stables et comparables.
Étape 2 : Création d’un signal d’apprentissage auto-supervisé#
Une fois les images normalisées, l’étape suivante consiste à créer un signal d’apprentissage qui permet au modèle d’apprendre sans jamais voir d’image propre. Les méthodes de débruitage auto-supervisé y parviennent en veillant à ce que le modèle ne puisse pas simplement recopier les valeurs de pixels bruitées qu’il reçoit.
Elles créent plutôt des situations dans lesquelles le modèle doit s’appuyer sur le contexte environnant de l’image, qui contient une structure stable, et non sur le bruit imprévisible. Les différentes méthodes y parviennent de façons légèrement différentes, mais l’idée centrale reste la même.
Certaines approches masquent temporairement certains pixels, obligeant ainsi le modèle à les déduire à partir de leurs voisins, tandis que d’autres génèrent une version corrompue séparément de la même image bruitée afin que l’entrée et la cible contiennent un bruit indépendant. Dans les deux cas, l’image cible contient des informations structurelles pertinentes, mais empêche le réseau d’accéder à la valeur bruitée originale du pixel qu’il est censé prédire.
Comme le bruit change aléatoirement tandis que l’image sous-jacente reste cohérente, cette configuration incite naturellement le modèle à apprendre à quoi ressemble la véritable structure et à ignorer le bruit qui varie d’une version à l’autre.
Étape 3 : Apprentissage du débruitage pour récupérer la structure de l’image#
Une fois le signal d’apprentissage en place, le modèle peut commencer à apprendre à séparer la structure pertinente de l’image du bruit grâce à l’entraînement du modèle. Chaque fois qu’il prédit un pixel masqué ou à nouveau corrompu, il doit s’appuyer sur le contexte environnant plutôt que sur la valeur bruitée qui occupait initialement cet emplacement.
Au fil de nombreuses itérations ou époques, le réseau apprend à reconnaître les types de motifs qui restent stables dans une image, comme les contours, les textures et les surfaces lisses. Il apprend également à ignorer les fluctuations aléatoires qui caractérisent le bruit.
Par exemple, imagine une photo en basse lumière où une surface paraît extrêmement granuleuse. Bien que le bruit varie d’un pixel à l’autre, la surface sous-jacente reste lisse. En déduisant à plusieurs reprises les pixels masqués dans de telles régions, le modèle devient progressivement plus efficace pour identifier le motif stable sous-jacent au bruit et le reconstruire plus proprement.
Grâce au processus d’entraînement du modèle, le réseau apprend une représentation interne de la structure de l’image. Cela permet au modèle de récupérer des détails cohérents, même lorsque l’entrée est fortement corrompue.
Étape 4 : Validation et résultats de réduction du bruit#
Une fois que le modèle a appris à prédire les pixels masqués ou à nouveau corrompus, la dernière étape consiste à évaluer ses performances sur des images complètes. Pendant les tests, le modèle reçoit une image bruitée entière et produit une version débruitée complète en fonction de ce qu’il a appris sur la structure des images. Pour mesurer l’efficacité de ce processus, la sortie est comparée à des images de référence propres ou à des jeux de données de référence standard.
Deux métriques couramment utilisées sont le PSNR (rapport signal/bruit de crête), qui mesure la proximité de la reconstruction avec la vérité terrain propre, et le SSIM (indice de similarité structurelle), qui évalue dans quelle mesure les caractéristiques importantes telles que les contours et les textures sont préservées. Des scores plus élevés indiquent généralement un débruitage plus précis et visuellement plus fiable.
Jeux de données d’images utilisés pour l’entraînement et l’évaluation comparative#
Les recherches sur le débruitage auto-supervisé, publiées notamment dans les revues IEEE et les conférences CVF telles que CVPR, ICCV et ECCV, et largement diffusées sur arXiv, s’appuient souvent sur un mélange de jeux de données synthétiques et réels pour évaluer les performances des modèles d’apprentissage profond dans des conditions contrôlées et pratiques. D’une part, les jeux de données synthétiques commencent par des images propres auxquelles on ajoute un bruit artificiel, ce qui facilite la comparaison des méthodes à l’aide de métriques comme le PSNR et le SSIM.
Voici quelques jeux de données couramment utilisés, auxquels on ajoute généralement un bruit synthétique pour l’évaluation comparative :
- Kodak24 : Ce jeu de données fournit des photographies de scènes naturelles de haute qualité, couramment utilisées pour comparer visuellement les résultats du débruitage.
- DIV2K : Ce jeu de données haute résolution contient des images variées et détaillées, utilisées pour évaluer la fidélité des textures et la qualité globale de la restauration.
Les jeux de données bruités du monde réel, en revanche, contiennent des images capturées directement par des capteurs d’appareils photo dans des conditions de faible luminosité, d’ISO élevé ou autres conditions difficiles. Ces jeux de données testent la capacité d’un modèle à gérer un bruit complexe et non gaussien, difficile à simuler facilement.
Voici quelques jeux de données bruités du monde réel très utilisés :
- SIDD : Ce jeu de données fournit des paires réelles d’images bruitées et propres, capturées avec des capteurs de smartphones dans diverses conditions d’éclairage.
- DND : Il comprend des photographies à ISO élevé qui reproduisent des motifs réalistes de bruit de capteur présents dans les appareils photo grand public.
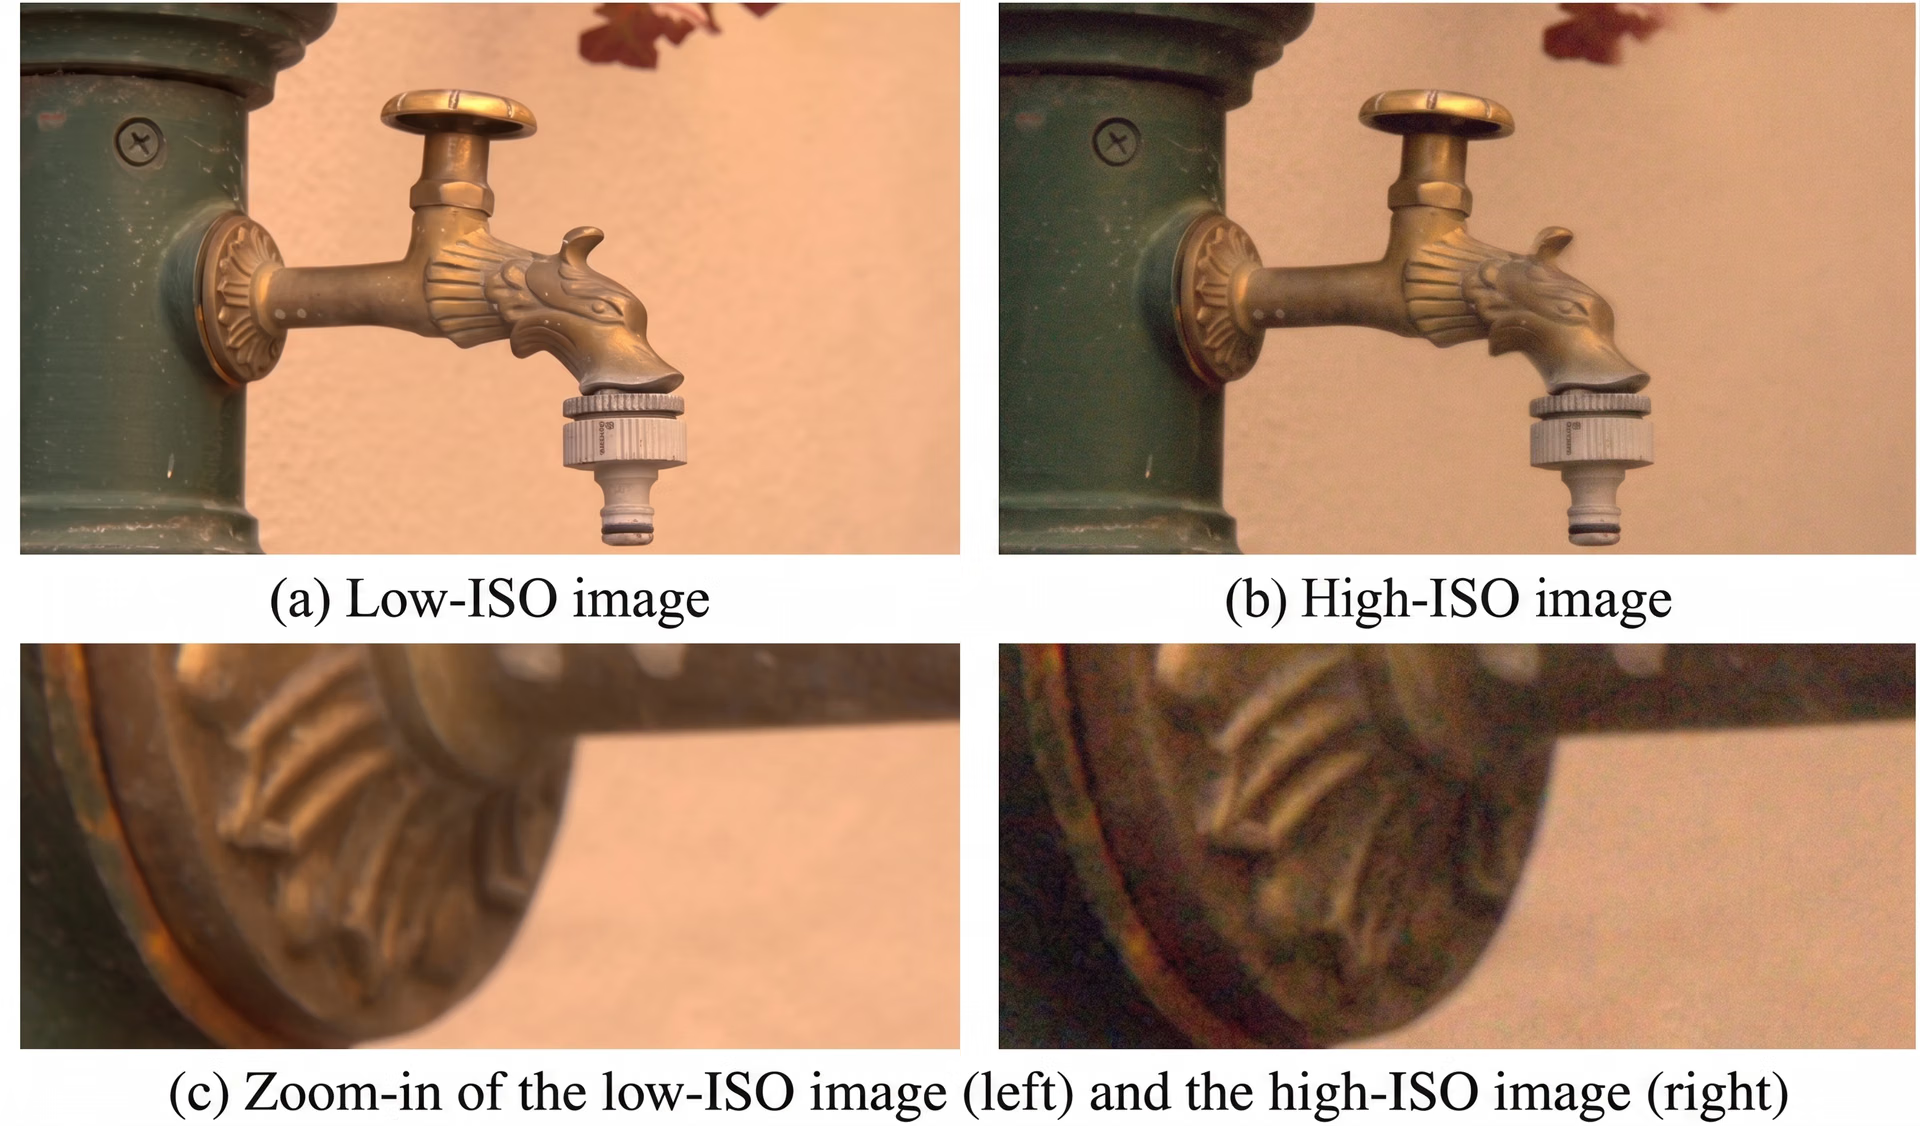
Fig. 4. Un exemple issu du jeu de données DND. (Source)
Facteurs à prendre en compte lors de l’entraînement d’un modèle de débruitage auto-supervisé#
Voici quelques facteurs et limites à prendre en compte si tu prévois d’entraîner un modèle de débruitage auto-supervisé fondé sur l’apprentissage profond :
- Faire correspondre la distribution du bruit : Les images bruitées utilisées pour l’entraînement doivent refléter le même bruit que celui auquel le modèle sera confronté en utilisation réelle ; un bruit différent entraîne une mauvaise généralisation.
- Garantir la diversité des données d’entraînement : Une variation limitée peut provoquer un surapprentissage ou un lissage excessif des textures complexes.
- Connaître les limites liées au type de bruit : Les méthodes auto-supervisées ont davantage de difficultés avec les bruits structurés, corrélés ou non aléatoires.
- Tester sur différents appareils ou capteurs : Les performances du débruitage peuvent varier considérablement selon les caméras ou les systèmes d’imagerie.
Points clés à retenir#
Le débruitage auto-supervisé offre aux passionnés d’IA un moyen pratique de nettoyer les images en utilisant uniquement les données bruitées dont nous disposons déjà. En apprenant à reconnaître la structure réelle sous-jacente au bruit, ces méthodes peuvent récupérer des détails visuels importants. À mesure que la technologie de débruitage progresse, elle rendra probablement un large éventail de tâches de vision par ordinateur plus fiables dans les situations du quotidien.
Rejoins notre communauté grandissante ! Consulte notre dépôt GitHub pour en savoir plus sur l’IA. Si tu souhaites créer des solutions de vision par ordinateur, découvre nos options de licence. Explore les avantages de la vision par ordinateur dans le commerce de détail et découvre comment l’IA dans l’industrie manufacturière fait la différence !








