Qu’est-ce que l’estimation de profondeur monoculaire ? Aperçu
Découvre le fonctionnement de l’estimation de profondeur monoculaire, sa comparaison avec les méthodes de profondeur basées sur des capteurs et son rôle dans la perception 3D évolutive des systèmes de vision.
 Abirami Vina21 min de lecture
Les voitures autonomes sont conçues pour comprendre ce qui se passe autour d’elles afin de pouvoir rouler en toute sécurité. Pour cela, elles doivent aller au-delà de la simple reconnaissance d’objets comme les piétons ou les autres véhicules.
Elles doivent également connaître la distance qui les sépare de ces objets afin de réagir correctement. Pourtant, donner aux machines cette perception de la distance n’a rien de simple. Contrairement aux humains, elles ne perçoivent pas naturellement la profondeur à partir d’images et doivent apprendre explicitement à le faire.
L’une des raisons est que la plupart des caméras capturent le monde sous forme d’images plates en deux dimensions. Transformer ces images en représentations reflétant la profondeur et la structure 3D du monde réel est complexe, surtout lorsque les systèmes doivent fonctionner de manière fiable dans des conditions quotidiennes.
Fait intéressant, la vision par ordinateur, branche de l’IA qui se concentre sur l’interprétation et la compréhension des données visuelles, permet aux machines de mieux comprendre le monde à partir d’images. Par exemple, l’estimation de profondeur monoculaire est une technique de vision par ordinateur qui estime la distance des objets à partir d’une seule image prise par une caméra.
En apprenant des indices visuels comme la taille des objets, la perspective, la texture et les ombres, ces modèles peuvent prédire la profondeur sans s’appuyer sur des capteurs supplémentaires comme le LiDAR (détection et télémétrie par la lumière) ou des caméras stéréo. Dans cet article, nous allons découvrir en quoi consiste l’estimation de la profondeur monoculaire, son fonctionnement et certaines de ses applications concrètes.
Brève introduction à l’estimation de profondeur monoculaire#
L’estimation de profondeur monoculaire permet à une machine de comprendre à quelle distance se trouvent les objets en utilisant une seule image. Comme cette approche ne repose que sur une seule caméra, elle présente plusieurs avantages, notamment un coût réduit et des exigences matérielles plus simples.
Elle peut par exemple être utilisée dans des robots domestiques abordables équipés d’une seule caméra. Même à partir d’une image unique, le système robotique peut déterminer quels murs sont les plus proches et quelles portes sont plus éloignées, et déduire la profondeur globale de l’espace.
Souvent, une image unique ne contient pas d’informations permettant de déterminer l’échelle réelle ; l’estimation de profondeur monoculaire porte donc généralement sur la profondeur relative. Autrement dit, elle peut déterminer quels objets sont les plus proches et lesquels sont plus éloignés, même si les distances exactes ne sont pas connues.
Lorsqu’un modèle est entraîné sur des données contenant des distances de référence ou une profondeur absolue, par exemple des mesures de profondeur provenant de capteurs comme le LiDAR, il peut apprendre à prédire des distances en unités réelles, comme les mètres. Sans ce type de données de référence, le modèle peut tout de même déduire la profondeur relative, mais ne peut pas estimer les distances absolues de manière fiable.
L’estimation de profondeur monoculaire produit généralement une carte de profondeur, c’est-à-dire une image où chaque pixel représente la proximité ou l’éloignement de la partie correspondante de la scène. Une carte de profondeur fournit aux systèmes de vision une compréhension élémentaire de la structure 3D de l’environnement.
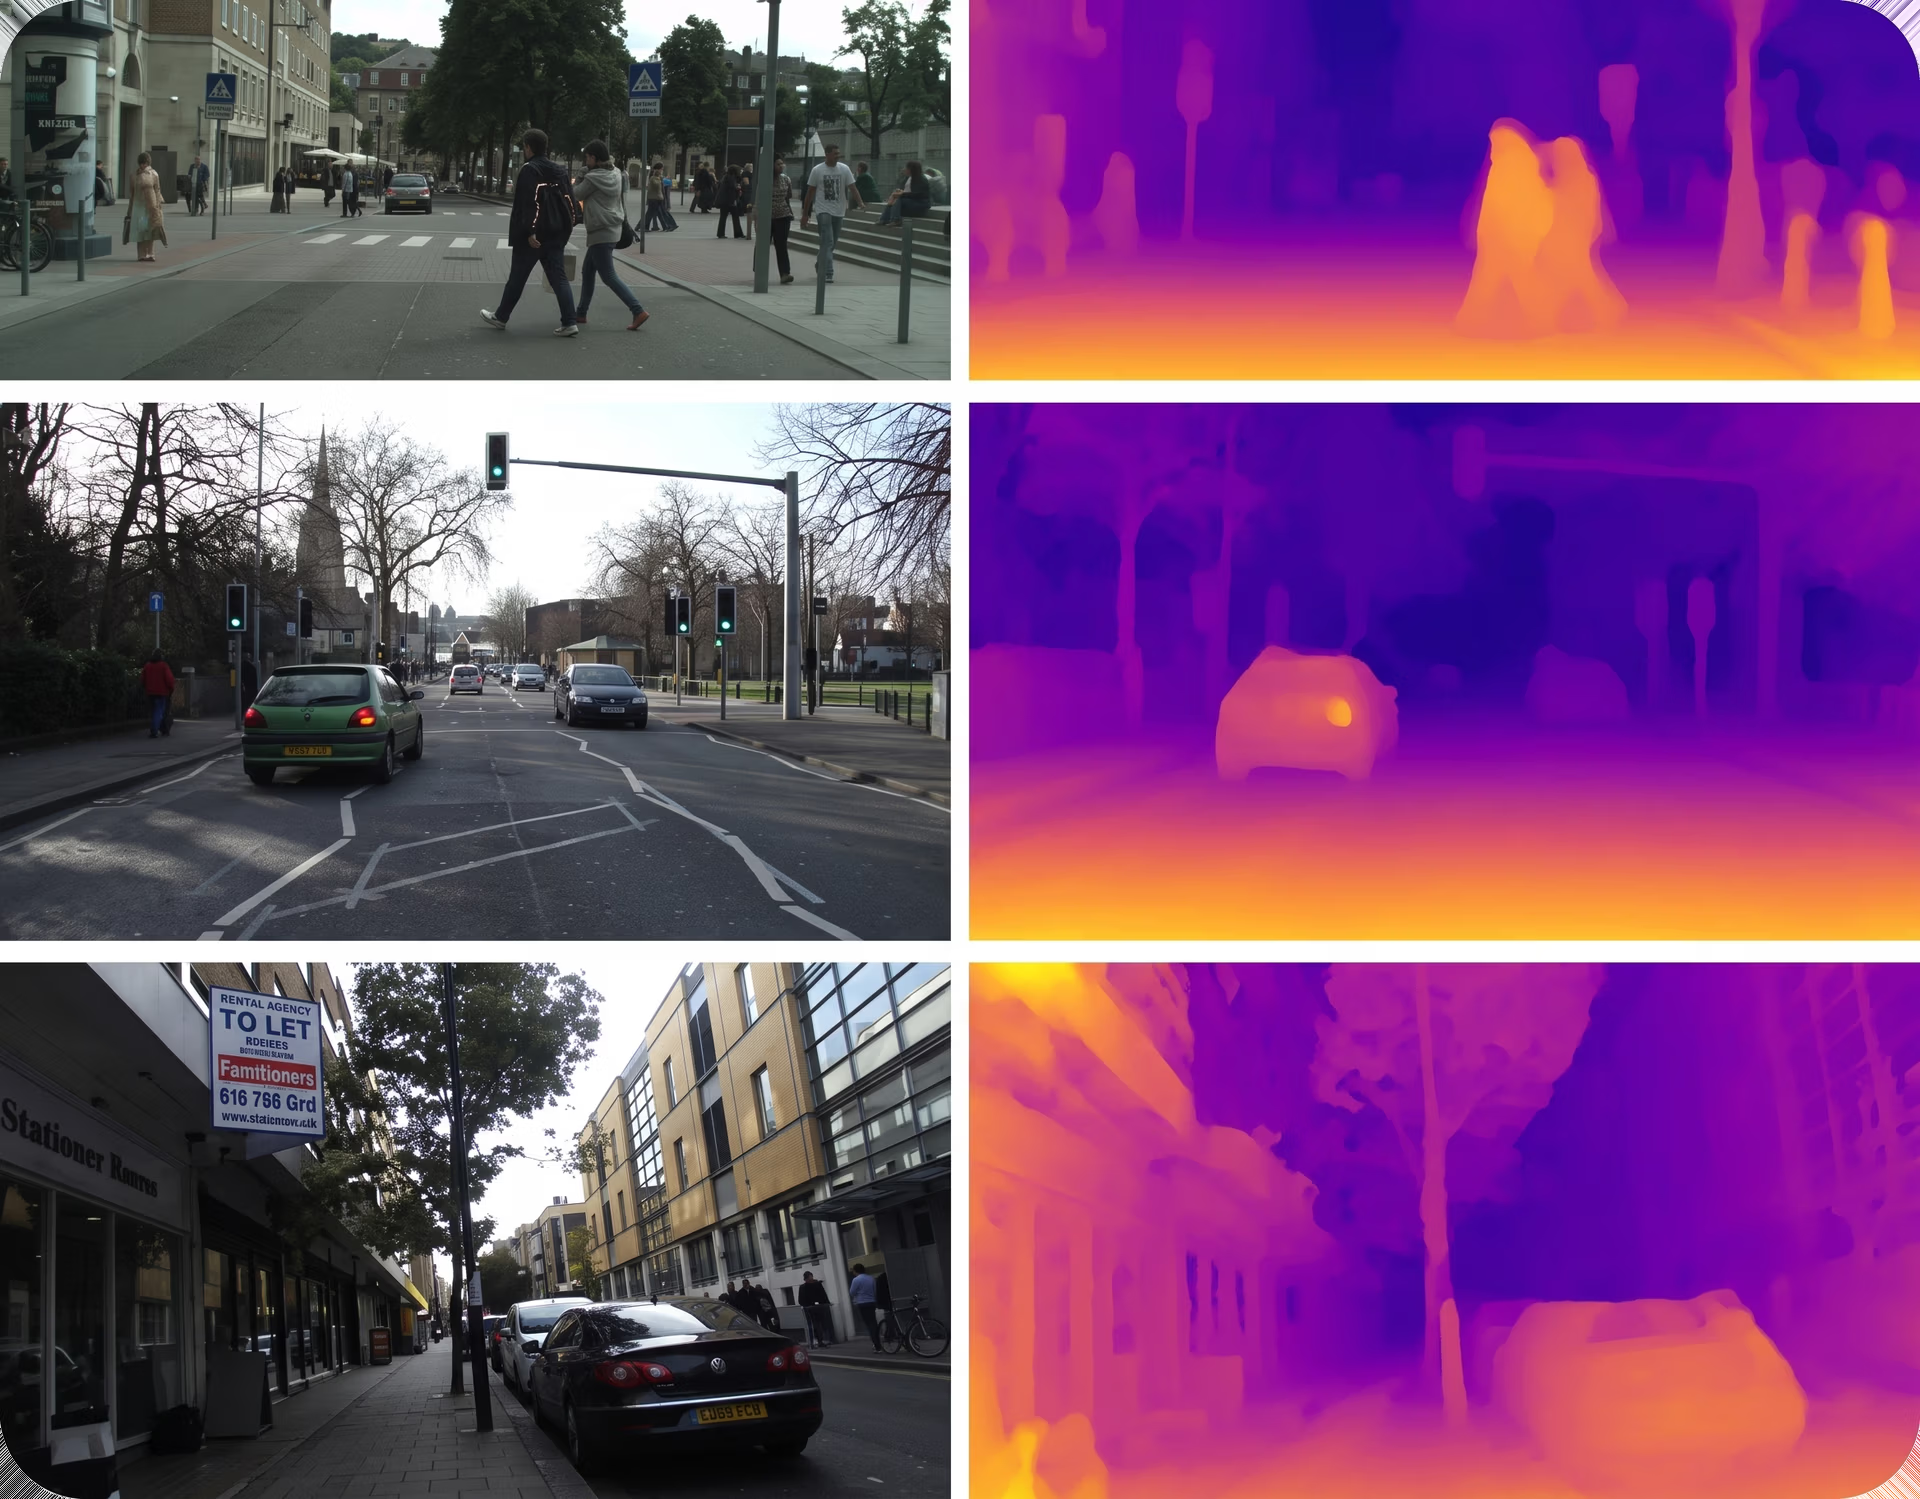
Fig. 1. Exemple de carte de profondeur prédite à l’aide de l’estimation de profondeur monoculaire (Source)
Des capteurs aux images : estimer la profondeur#
L’estimation de profondeur peut se faire de plusieurs façons, en fonction des capteurs disponibles, des contraintes matérielles et des exigences de précision. Les méthodes traditionnelles s’appuient souvent sur plusieurs points de vue ou sur des capteurs spécialisés pour mesurer directement la distance.
La vision stéréoscopique est une approche courante qui estime la profondeur en comparant deux images synchronisées prises depuis des points de vue légèrement différents. En mesurant l’écart entre les points correspondants des deux images, le système peut déduire la distance entre les objets et la caméra.
Une autre approche repose sur les systèmes RGB-D (rouge, vert, bleu et profondeur), qui utilisent des capteurs de profondeur actifs pour mesurer directement la distance de chaque pixel. Ces systèmes peuvent fournir des informations de profondeur précises dans des environnements contrôlés, mais nécessitent du matériel supplémentaire.
Les méthodes basées sur le LiDAR utilisent quant à elles des impulsions laser pour générer des représentations tridimensionnelles précises d’une scène. Bien que très précis, les capteurs LiDAR sont souvent coûteux et alourdissent considérablement la complexité matérielle.
À l’inverse, l’estimation de profondeur monoculaire déduit la profondeur à partir d’une seule image RGB. Comme elle ne dépend ni de plusieurs caméras ni de capteurs spécialisés, elle est plus facile à déployer à grande échelle et constitue une bonne option lorsque le coût et les ressources matérielles sont limités.
Apprendre la profondeur à partir d’une seule image#
Pour estimer la profondeur à partir d’une seule image, les modèles de profondeur monoculaire apprennent à reconnaître les indices visuels que les humains utilisent instinctivement pour évaluer les distances. Ces indices comprennent les lignes de perspective, la taille des objets, la densité des textures, le chevauchement des objets et les ombres, qui donnent tous des indications sur la distance entre les objets et la caméra.
Ces indices se combinent pour créer une perception de la profondeur. Les objets qui paraissent plus petits ou sont partiellement masqués sont souvent plus éloignés, tandis que des détails plus nets et une apparence visuelle plus grande suggèrent généralement qu’un objet est plus proche.
Pour apprendre ces motifs, les modèles de profondeur monoculaire sont entraînés sur de grands jeux de données d’images, souvent associés à des informations de profondeur obtenues à partir d’autres sources, comme le LiDAR ou des systèmes stéréoscopiques. Pendant l’entraînement, les modèles apprennent les liens entre les indices visuels et la profondeur, ce qui leur permet d’inférer les distances à partir d’une seule image au moment de l’inférence.
Grâce à des données d’entraînement variées, les modèles de vision modernes peuvent généraliser cette compréhension acquise à un large éventail d’environnements, y compris des scènes intérieures et extérieures, et gérer des points de vue inconnus.
Tour d’horizon des différentes techniques d’estimation de profondeur monoculaire#
Nous allons maintenant examiner les principales approches utilisées pour estimer la profondeur à partir d’une seule image, ainsi que l’évolution de ces méthodes au fil du temps.
Approches classiques et géométriques#
Les premières méthodes d’estimation de profondeur s’appuyaient sur des règles visuelles simples liées à la géométrie de la caméra. Des indices comme la perspective, la taille des objets et le fait qu’un objet en masque un autre servaient à estimer les distances.
Par exemple, lorsque deux objets similaires apparaissaient à des tailles différentes, on supposait que le plus petit était plus éloigné. Ces approches fonctionnaient assez bien dans des environnements contrôlés, où des facteurs comme l’éclairage, la position de la caméra et la configuration de la scène restaient constants.
Cependant, ces hypothèses sont souvent mises à mal dans les scènes du monde réel. Les variations d’éclairage, les changements de point de vue et la complexité accrue des scènes peuvent rendre les estimations de profondeur peu fiables, ce qui limite l’efficacité des méthodes classiques dans des environnements non contrôlés.
Premières approches de machine learning#
Les premières méthodes de machine learning ont rendu l’estimation de profondeur plus flexible en apprenant directement les motifs à partir des données. Au lieu de s’appuyer uniquement sur des règles géométriques fixes, ces modèles tentaient d’apprendre le lien entre les informations visuelles et la distance, en traitant la prédiction de profondeur comme un problème de régression fondé sur des indices comme les contours, les textures et les variations de couleur.
La sélection de ces caractéristiques constituait une étape essentielle du processus. Les ingénieurs devaient décider quels signaux visuels extraire et comment les représenter, et les performances du modèle dépendaient fortement de ces choix.
Bien que cette approche ait mieux fonctionné que les méthodes précédentes, elle avait encore des limites. Si les caractéristiques sélectionnées ne prenaient pas en compte des éléments de contexte importants, les prédictions de profondeur étaient moins précises. À mesure que les scènes devenaient plus complexes et variées, ces modèles peinaient souvent à produire des résultats fiables.
Algorithmes de deep learning#
La plupart des systèmes modernes d’estimation de profondeur monoculaire utilisent le deep learning, c’est-à-dire des réseaux neuronaux comportant de nombreuses couches et capables d’apprendre des motifs complexes à partir des données. Ces modèles apprennent à prédire directement la profondeur à partir d’images et produisent des cartes de profondeur.
De nombreuses approches reposent sur les réseaux neuronaux convolutifs (CNNs), un type de réseau neuronal conçu pour traiter des images en détectant des motifs comme les contours et les formes. Ces modèles utilisent souvent une architecture encodeur-décodeur : l’encodeur extrait les caractéristiques visuelles de l’image et le décodeur les convertit en carte de profondeur. Le traitement de l’image à plusieurs échelles aide le modèle à saisir la configuration globale de la scène tout en préservant la netteté des contours des objets.
Les modèles plus récents cherchent à comprendre les relations entre les différentes parties d’une image. Les modèles basés sur les Transformers et les Vision Transformers (ViT) utilisent des mécanismes d’attention, qui permettent au modèle de déterminer quelles régions de l’image sont les plus pertinentes et d’établir des liens entre des zones éloignées les unes des autres. Le modèle peut ainsi construire une compréhension plus cohérente de la profondeur à l’échelle de toute la scène.
Certains systèmes combinent les deux approches. Les modèles hybrides CNN–Transformer utilisent les CNN pour capturer les détails locaux les plus fins et les Transformers pour modéliser le contexte global de la scène. Cette combinaison améliore souvent la précision, mais nécessite généralement davantage de ressources informatiques, comme de la mémoire et de la puissance de traitement supplémentaires.
Pourquoi la compréhension de la profondeur est importante pour les systèmes d’IA visuelle#
En découvrant l’estimation de profondeur monoculaire, tu te demandes peut-être pourquoi la compréhension de la profondeur joue un rôle si important dans les systèmes d’IA basés sur la vision.
Lorsqu’un système peut estimer la distance des objets et des surfaces, il comprend mieux la configuration d’une scène et les relations entre ses différents éléments. Cette conscience spatiale est essentielle pour prendre des décisions fiables, notamment dans des applications concrètes comme la conduite autonome.
Les informations de profondeur apportent également un contexte précieux à d’autres tâches de vision par ordinateur. Par exemple, la détection d’objets, prise en charge par des modèles comme Ultralytics YOLO26, peut indiquer au système quels éléments sont présents dans une scène, tandis que la profondeur aide à déterminer où se trouvent ces objets par rapport à la caméra et les uns par rapport aux autres.
Ensemble, ces capacités ouvrent la voie à un large éventail d’applications d’IA visuelle, comme la création de cartes 3D, la navigation dans des environnements complexes et la compréhension globale d’une scène.
Les robots et les véhicules autonomes s’appuient sur ces informations pour se déplacer en toute sécurité, éviter les obstacles et réagir aux changements en temps réel. Par exemple, l’approche de conduite par vision seule de Tesla s’appuie sur des images de caméra combinées à l’estimation de profondeur, plutôt que sur le LiDAR, pour comprendre à quelle distance se trouvent les objets et où ils sont positionnés sur la route.
Fonctionnement des modèles d’estimation de profondeur monoculaire#
Bien que les architectures des modèles varient, la plupart des modèles d’estimation de profondeur monoculaire suivent un processus similaire pour convertir une seule image en carte de profondeur. Voici un bref aperçu des principales étapes :
- Entrée et prétraitement : Le flux de travail commence par une image d’entrée. Avant d’être transmise au modèle, l’image originale est généralement redimensionnée, normalisée et convertie en tenseur, un format que les réseaux neuronaux utilisent pour traiter efficacement les données d’image.
- Extraction de caractéristiques : Un réseau encodeur analyse l’image pour en extraire des caractéristiques visuelles pertinentes. Ces caractéristiques capturent des informations comme les textures, les contours des objets et la configuration globale de la scène. La plupart des modèles travaillent à plusieurs échelles afin de comprendre à la fois les détails fins et la structure globale.
- Inférence de la profondeur : À partir des caractéristiques extraites, le modèle combine les détails locaux et le contexte global pour déduire les relations spatiales dans la scène. À cette étape, il apprend quelles régions de l’image sont plus proches de la caméra et lesquelles en sont plus éloignées.
- Génération de la carte de profondeur : Un décodeur convertit ensuite ces informations en une carte de profondeur dense. Une valeur de profondeur est attribuée à chaque pixel de l’image, souvent en combinant des prédictions issues de différentes échelles pour améliorer la précision et la cohérence.
Entraînement des modèles d’estimation de profondeur monoculaire#
Le processus que nous venons de décrire suppose que nous disposons déjà d’un modèle entraîné ou préentraîné. Mais comment se déroule réellement l’entraînement d’un modèle d’estimation de profondeur monoculaire ?
L’entraînement commence par la préparation des données d’image afin qu’elles puissent être traitées efficacement par le réseau. Les images d’entrée sont redimensionnées et normalisées à une échelle uniforme, puis transmises au modèle, qui génère une carte de profondeur prédite estimant la distance de chaque pixel.
La carte de profondeur prédite est ensuite comparée aux données de profondeur de référence à l’aide d’une fonction de perte, qui mesure l’écart entre la prédiction du modèle et la profondeur réelle de référence. Cette valeur de perte représente l’erreur actuelle du modèle et fournit un signal permettant de l’améliorer.
Un optimiseur utilise ce signal pour mettre à jour le modèle en ajustant ses poids internes. Pour ce faire, il calcule le gradient, qui décrit la variation de la perte par rapport à chaque paramètre du modèle, puis applique ces mises à jour de manière répétée au fil de plusieurs époques, c’est-à-dire plusieurs parcours complets du jeu de données d’entraînement.
Ce processus itératif d’entraînement supervisé est guidé par des hyperparamètres tels que le taux d’apprentissage, qui détermine l’ampleur de chaque étape de mise à jour, et la taille du lot, qui définit le nombre d’images traitées simultanément. Comme l’entraînement implique un grand nombre d’opérations mathématiques, il est généralement accéléré à l’aide d’une unité de traitement graphique (GPU), particulièrement adaptée aux calculs parallèles.
Une fois l’entraînement terminé, le modèle est évalué à l’aide de métriques d’évaluation standard sur un jeu de validation constitué d’images qui n’ont pas été utilisées pendant l’entraînement. Cette évaluation permet de mesurer la capacité du modèle à généraliser à de nouvelles données.
Le modèle entraîné peut ensuite être réutilisé ou affiné pour de nouveaux scénarios. Dans l’ensemble, ce processus d’entraînement permet aux modèles d’estimation de profondeur monoculaire de produire des estimations cohérentes, indispensables aux tâches en aval comme la reconstruction 3D et le déploiement dans le monde réel.
Découverte des modèles de pointe et des tendances de la recherche#
L’estimation de profondeur monoculaire a rapidement progressé à mesure que les modèles sont devenus plus aptes à comprendre des scènes entières plutôt que de simples détails visuels. Les premières approches produisaient souvent des cartes de profondeur irrégulières, surtout dans les environnements complexes.
Les modèles plus récents, comme ceux présentés dans des travaux de recherche récemment publiés sur arXiv, accordent davantage d’importance au contexte global, ce qui donne des prédictions de profondeur plus stables et réalistes. Des modèles reconnus comme MiDaS et DPT ont contribué à cette évolution en apprenant la profondeur à partir de jeux de données variés et en haute résolution, puis en généralisant efficacement à de nombreuses scènes.
Des modèles plus récents, notamment ZoeDepth et Depth Anything V2, s’appuient sur ces travaux pour améliorer la cohérence d’échelle tout en conservant de bonnes performances dans de nombreux contextes. Ces progrès sont souvent mesurés à l’aide de jeux de données de référence courants comme KITTI et NYU Depth V2, qui couvrent des scènes extérieures et intérieures.
Une autre tendance marquée consiste à trouver un équilibre entre précision et praticité. Les modèles plus petits sont optimisés pour la vitesse et peuvent fonctionner en temps réel sur des appareils edge ou mobiles, tandis que les modèles plus grands privilégient une résolution supérieure et la précision de la profondeur à longue portée. Par exemple, les modèles de profondeur Ultralytics YOLO26 vont du modèle léger YOLO26n-depth, destiné aux applications edge en temps réel, au modèle YOLO26x-depth, plus grand et plus précis.
Applications de l’estimation de profondeur monoculaire#
Passons maintenant à quelques exemples concrets qui montrent comment l’estimation de profondeur monoculaire permet de déduire la structure 3D d’une scène à partir d’une seule image.
Dans tous ces cas, il faut garder à l’esprit que les informations de profondeur sont des estimations déduites d’indices visuels, et non des mesures précises. L’estimation de profondeur monoculaire est donc utile pour comprendre la disposition relative et les relations spatiales, mais ne remplace pas les capteurs conçus pour mesurer précisément les distances, comme le LiDAR ou les systèmes stéréoscopiques.
Cartographie du terrain et navigation par drone#
Les drones évoluent souvent dans des environnements où les signaux GPS sont peu fiables, comme les forêts, les chantiers, les zones sinistrées ou les zones urbaines denses. Pour voler en toute sécurité dans ces conditions, ils doivent comprendre le terrain environnant et connaître la distance qui les sépare des obstacles. Auparavant, cela nécessitait généralement l’ajout de capteurs comme le LiDAR ou des caméras stéréoscopiques, qui augmentent le poids, la consommation d’énergie et le coût total.
L’estimation de profondeur monoculaire est une solution plus simple. Avec une seule caméra RGB, les drones peuvent estimer la profondeur à partir d’images et se construire une représentation 3D élémentaire de leur environnement. Ils peuvent ainsi détecter des obstacles comme des bâtiments, des arbres ou des changements brusques de terrain, puis ajuster leur trajectoire en temps réel.
Ces estimations de profondeur facilitent des tâches de navigation essentielles, notamment l’évitement des obstacles, le contrôle de l’altitude et l’atterrissage en toute sécurité. Ainsi, les drones légers peuvent effectuer des tâches de cartographie, d’inspection et de navigation sans dépendre de capteurs de profondeur spécialisés.
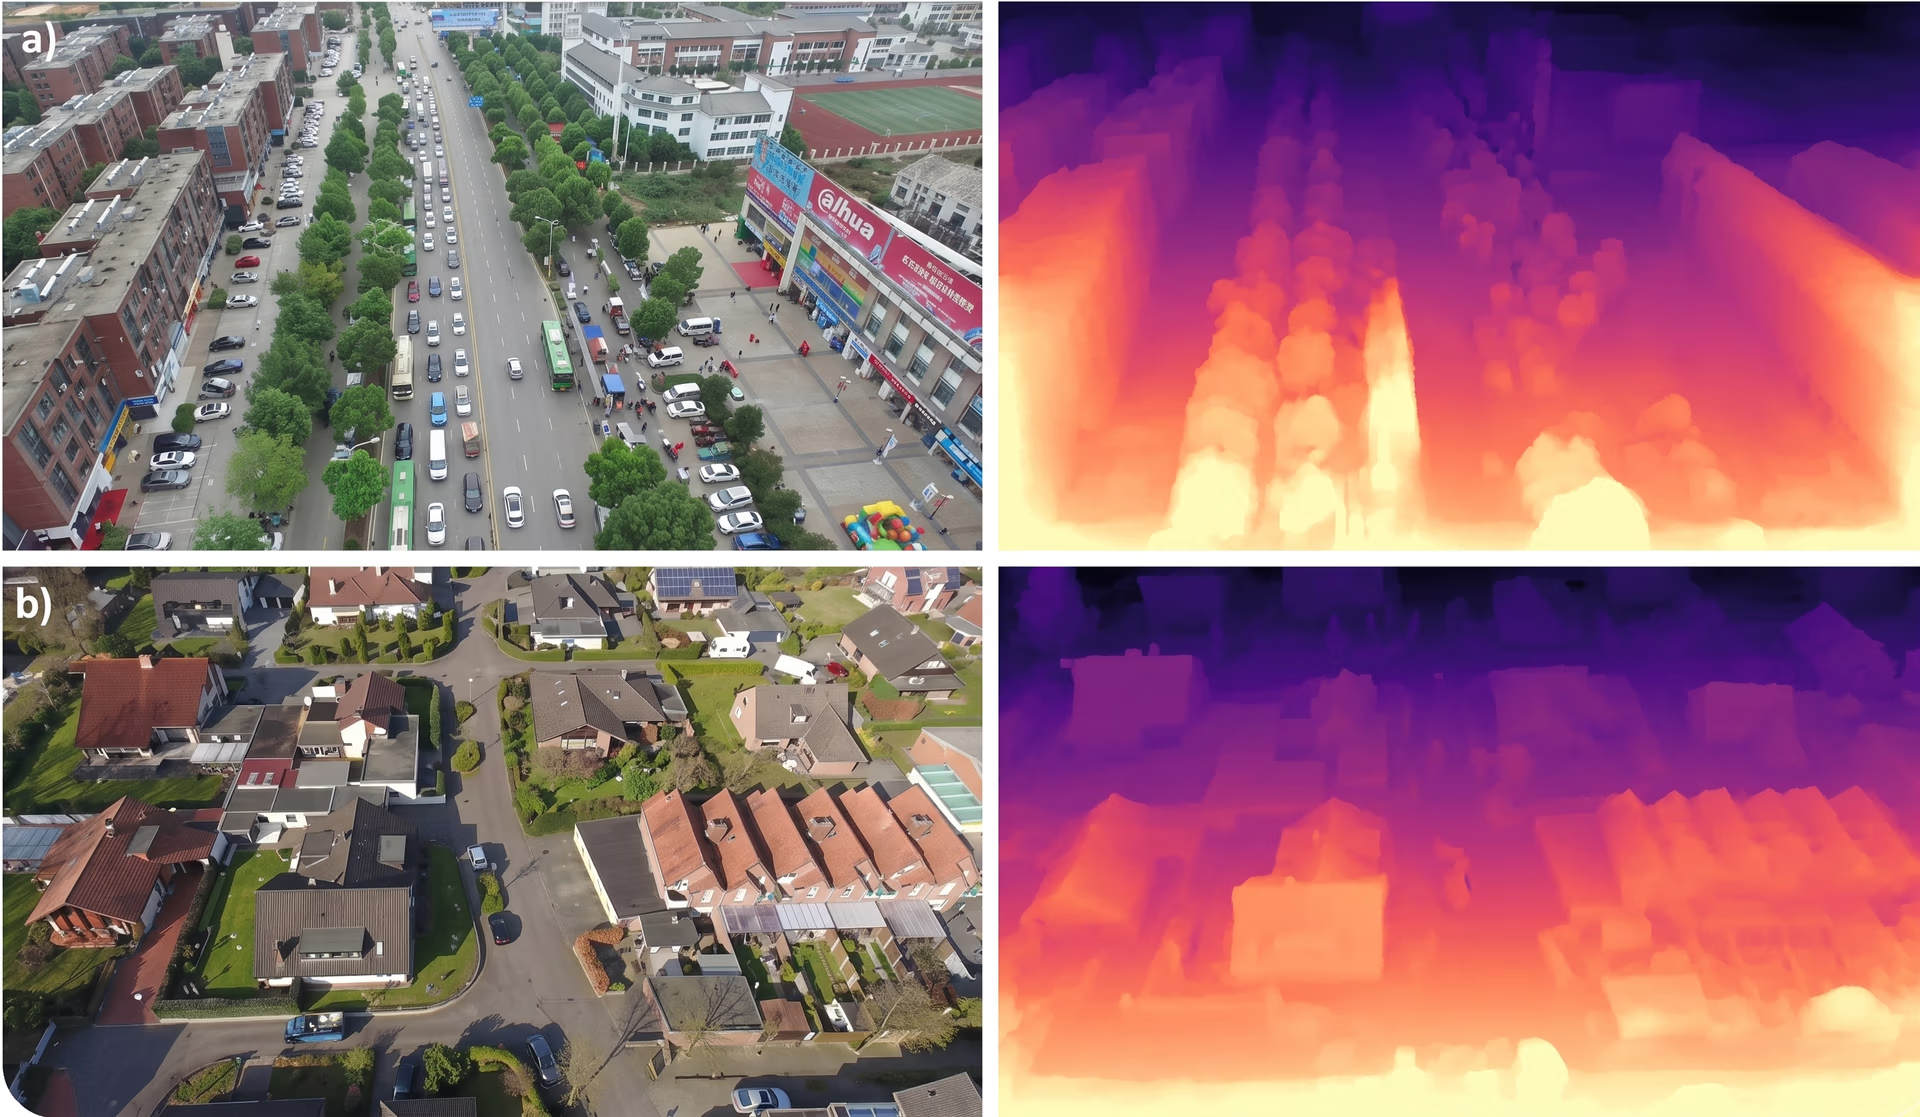
Fig. 2. L’estimation de profondeur monoculaire peut servir à analyser des images de drone (Source)
Combler les angles morts des véhicules de course autonomes#
Les véhicules autonomes s’appuient généralement beaucoup sur des capteurs LiDAR, qui utilisent des impulsions laser pour mesurer les distances et créer une vue 3D de la route. Bien que très précis, le LiDAR peut rencontrer des difficultés au niveau des sommets abrupts, des pentes raides, des occultations ou des changements soudains d’inclinaison du véhicule, et renvoyer parfois des données de profondeur éparses ou manquantes.
L’estimation monoculaire de la profondeur peut contribuer à combler ces lacunes en fournissant des informations denses sur la profondeur à partir d’une seule image RVB, même lorsque les données LiDAR sont incomplètes. Prenons le cas d’une voiture autonome qui approche rapidement du sommet d’une côte. Les faisceaux LiDAR peuvent dépasser la route au-delà du sommet, laissant planer une incertitude sur ce qui se trouve devant.
L’estimation de la profondeur à partir d’une caméra peut toutefois encore inférer la forme de la route à partir d’indices visuels comme la perspective et la texture, ce qui aide le véhicule à maintenir une perception fiable jusqu’à ce que les données LiDAR se stabilisent. Ensemble, le LiDAR et l’estimation monoculaire de la profondeur permettent une perception plus stable et un contrôle plus sûr dans des conditions de conduite difficiles.
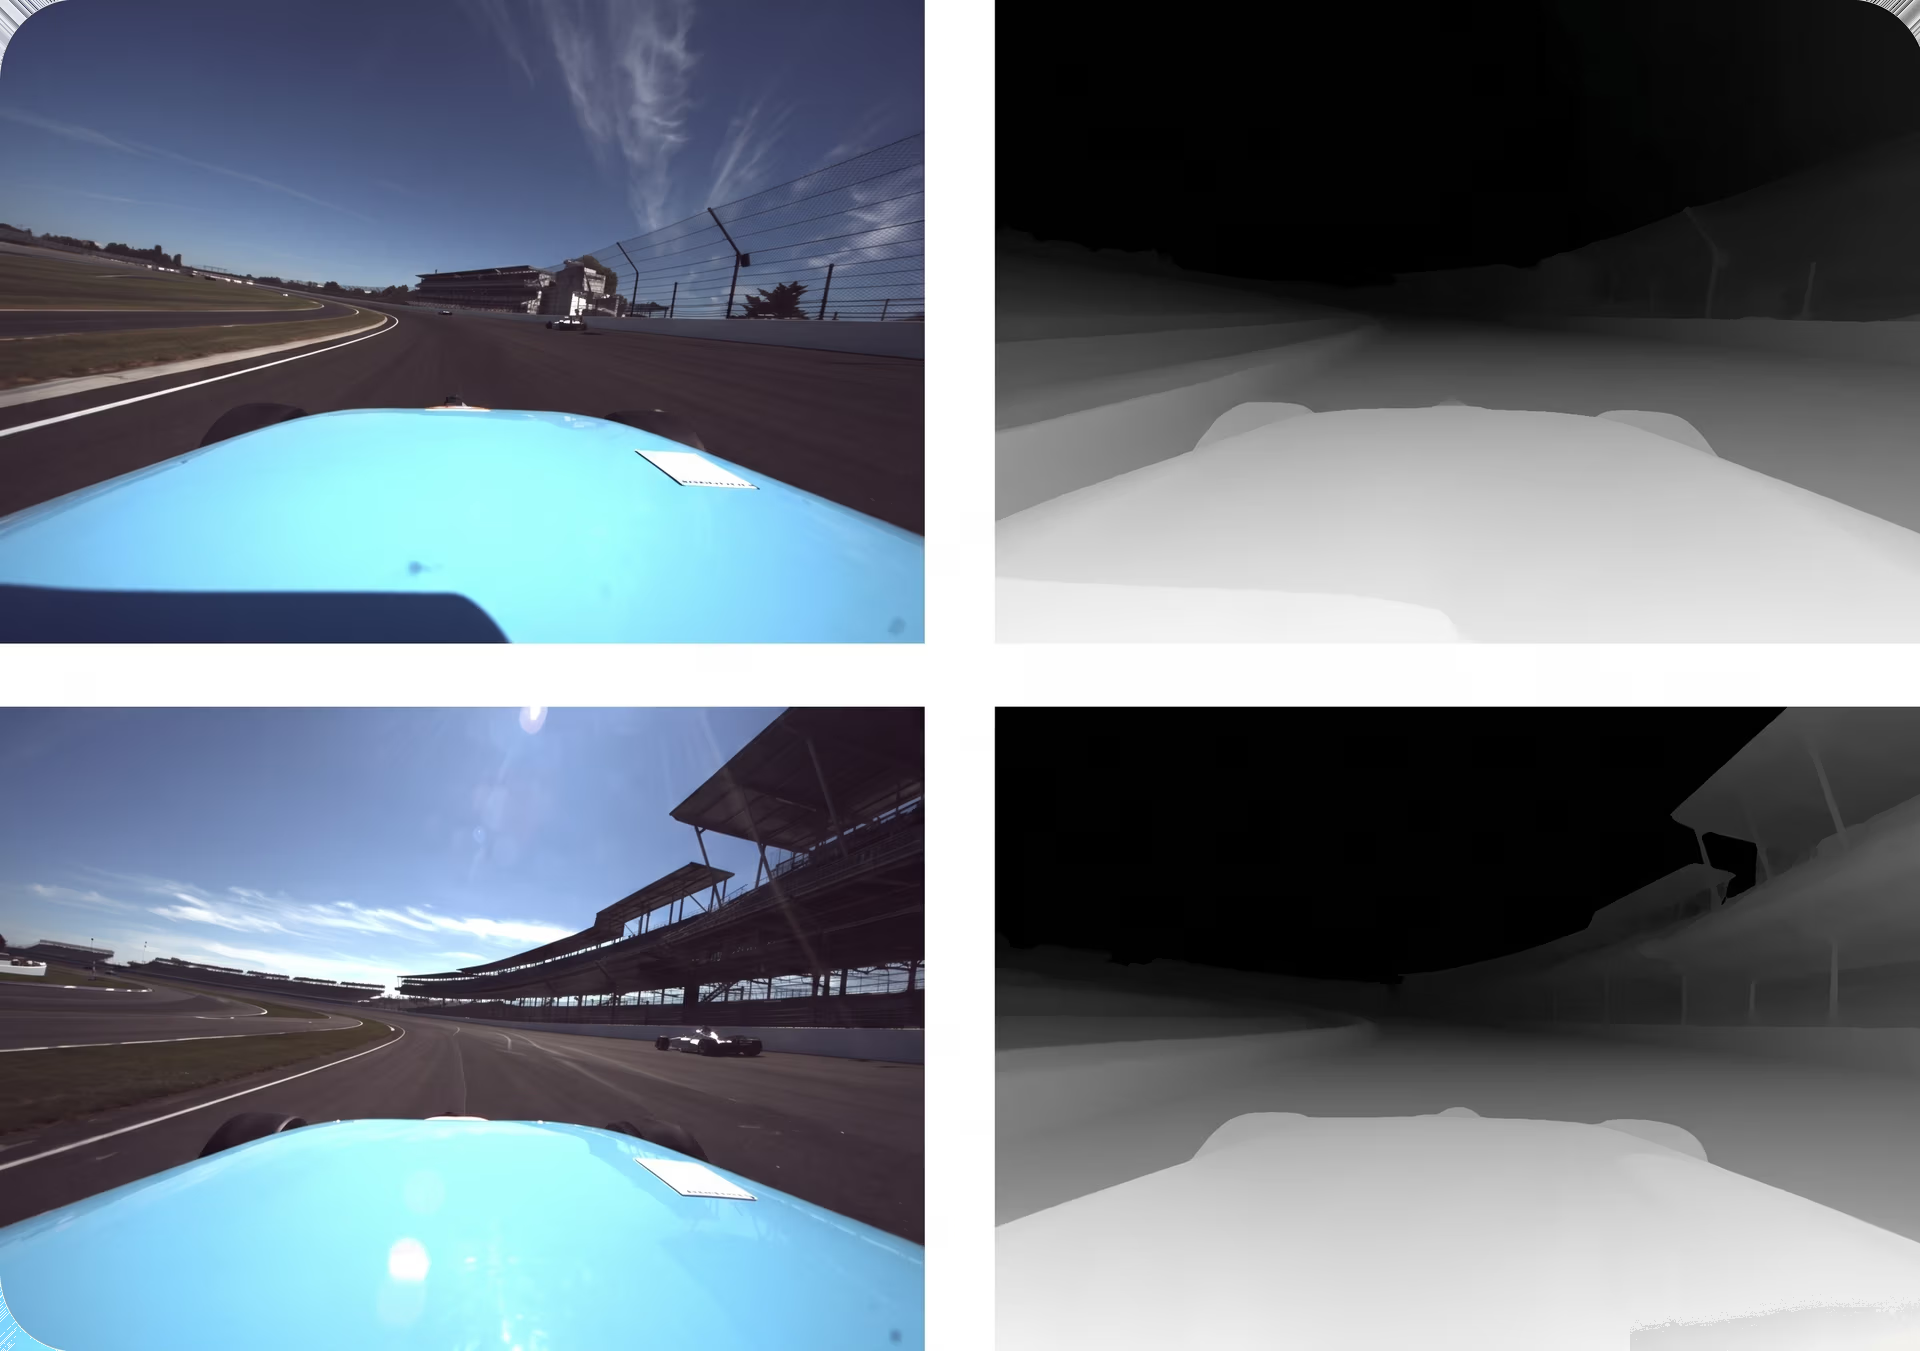
Fig. 3. Visualisation de l’utilisation de l’estimation monoculaire de la profondeur pour la course autonome (Source)
Navigation robotique et évitement des obstacles#
Les robots sont souvent utilisés dans des endroits où il n’existe pas de cartes détaillées et où les conditions changent constamment. Pour se déplacer en toute sécurité, ils doivent savoir de manière fiable de combien d’espace ils disposent et où se trouvent les obstacles.
L’estimation monoculaire de la profondeur peut fournir cette perception spatiale à l’aide d’une seule caméra RVB, sans dépendre d’un matériel lourd ou coûteux. En apprenant à repérer des indices visuels comme l’échelle et la perspective, les modèles d’estimation de la profondeur peuvent générer des cartes de profondeur denses de l’environnement. Les robots peuvent ainsi clairement percevoir la distance qui les sépare des surfaces et des objets.
En particulier, lorsque les informations de profondeur sont combinées à des tâches de vision par ordinateur comme la détection d’objets et la segmentation sémantique, les robots peuvent obtenir une vision plus complète de leur environnement. Ils peuvent identifier les objets, comprendre à quelle distance ils se trouvent et déterminer où ils peuvent se déplacer en toute sécurité. Cela permet d’éviter les obstacles, de détecter les espaces libres et de planifier des trajectoires en temps réel.
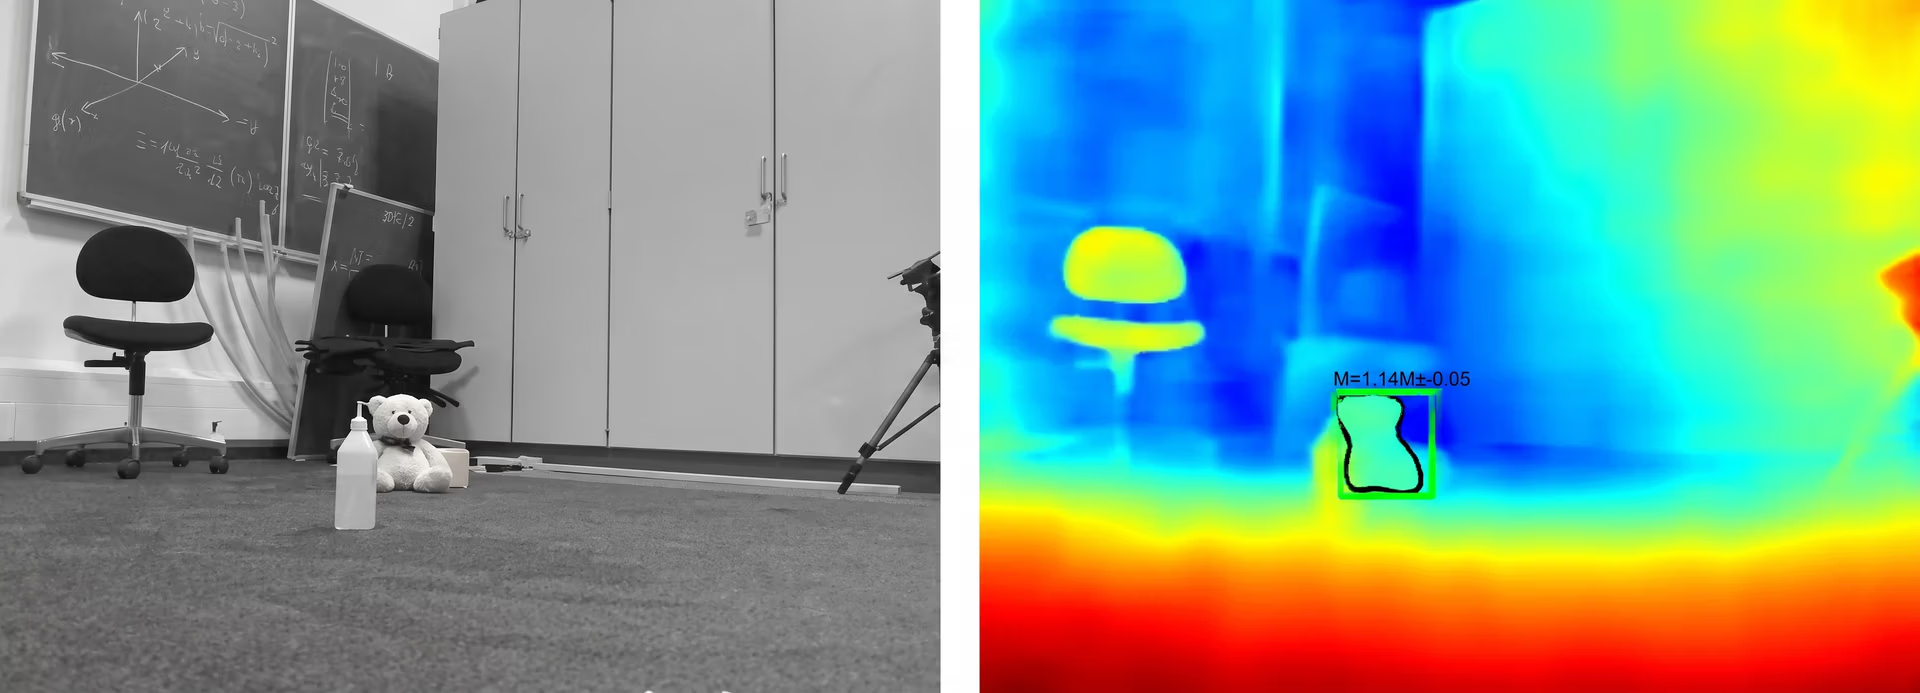
Fig. 4. Détection d’objets à l’aide de l’estimation monoculaire de la profondeur et de la détection d’objets (Source)
Avantages et inconvénients de l’estimation monoculaire de la profondeur#
Voici quelques-uns des principaux avantages de l’estimation monoculaire de la profondeur :
- Légère et économe en énergie : L’utilisation d’une seule caméra réduit le poids du système et sa consommation d’énergie, ce qui est particulièrement important pour les robots mobiles, les drones et les systèmes embarqués.
- Facile à combiner avec d’autres capteurs : La profondeur monoculaire peut compléter d’autres capteurs, comme le LiDAR ou le radar, en comblant les lacunes ou en apportant de la redondance.
- Fonctionne dans de nombreux environnements : La même approche fondée sur une caméra peut être utilisée en intérieur, en extérieur et sur différentes plateformes sans nécessiter de changements matériels.
Bien que l’estimation monoculaire de la profondeur présente des avantages évidents, voici quelques limites à prendre en compte :
- Moins précise que les capteurs actifs : Bien qu’elle progresse rapidement, l’estimation monoculaire de la profondeur ne peut généralement pas égaler la précision absolue du LiDAR ou des capteurs à lumière structurée dans des conditions contrôlées.
- Sensibilité aux conditions d’éclairage : Les performances peuvent se dégrader dans les environnements peu éclairés, en présence d’ombres marquées ou d’éblouissements, ou dans les scènes à faible texture.
- Difficultés de généralisation : Un modèle entraîné dans un environnement donné ne se transpose pas toujours de manière fiable à des domaines inconnus sans adaptation ou ajustement fin.
Quand ne pas se fier à l’estimation monoculaire de la profondeur#
L’estimation monoculaire de la profondeur est un domaine de recherche intéressant, mais il est important de comprendre où elle peut être utilisée en pratique et où elle ne le peut pas. Les distances qu’elle fournit sont des estimations basées sur ce que le modèle voit dans une image, et non des mesures exactes du monde réel.
Par conséquent, la qualité des résultats peut varier en fonction de facteurs comme l’éclairage, la complexité de la scène et sa ressemblance avec les données d’entraînement du modèle. L’estimation monoculaire de la profondeur permet généralement de déterminer ce qui est proche et ce qui est éloigné, mais elle n’est pas fiable lorsqu’il faut connaître des distances exactes.
Dans les situations où la précision est essentielle, comme pour les systèmes critiques pour la sécurité, l’inspection industrielle ou les robots qui doivent interagir très précisément avec des objets, la profondeur doit être mesurée directement. Des capteurs comme le LiDAR, le radar, les caméras stéréo ou les systèmes à lumière structurée sont conçus à cette fin et fournissent des informations de distance beaucoup plus fiables.
L’estimation monoculaire de la profondeur peut aussi rencontrer des difficultés dans des conditions visuelles complexes. Un éclairage faible, des ombres marquées, des surfaces réfléchissantes ou transparentes, le brouillard, la fumée ou les scènes offrant très peu de texture visuelle peuvent rendre les estimations de profondeur moins fiables. L’estimation de la profondeur à longue distance est un autre cas où les capteurs dédiés sont généralement plus performants.
Pour les applications concrètes, l’estimation monoculaire de la profondeur fonctionne mieux comme outil complémentaire que comme solution autonome. Elle peut apporter un contexte spatial utile, aider à combler les lacunes lorsque les autres capteurs sont limités et améliorer la compréhension globale de la scène. Cependant, elle ne devrait pas être l’unique source d’informations sur la profondeur lorsque la précision, la sécurité ou des exigences strictes de fiabilité sont importantes.
Points clés à retenir#
L’estimation monoculaire de la profondeur est une technique de vision par ordinateur qui permet aux machines d’estimer la distance des objets à partir d’une seule image prise par une caméra. En apprenant à repérer des indices visuels comme la perspective, la taille des objets, la texture et les ombres, ces modèles d’IA peuvent inférer la structure 3D d’une scène sans dépendre de capteurs comme le LiDAR ou les caméras stéréo. L’estimation monoculaire de la profondeur constitue ainsi une approche évolutive et économique pour des applications telles que la conduite autonome, la robotique et la compréhension des scènes 3D.
Pour en savoir plus sur l’IA visuelle, consulte notre dépôt GitHub et rejoins notre communauté. Consulte nos pages de solutions pour découvrir l’IA en robotique et la vision par ordinateur dans l’industrie manufacturière. Découvre nos options de licence pour te lancer dès aujourd’hui dans la vision par ordinateur !
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









