Guide sur l’architecture U-Net et ses applications
Découvre l’architecture U-Net, son rôle dans la segmentation d’images, ses applications et son importance dans l’évolution de la vision par ordinateur.
La vision par ordinateur est une branche de l’intelligence artificielle (AI) qui se concentre sur l’analyse des données visuelles. Elle a ouvert la voie à de nombreux systèmes de pointe, comme l’automatisation de l’inspection des produits en usine et l’aide à la navigation des véhicules autonomes sur les routes.
La détection d’objets est l’une des tâches de vision par ordinateur les plus connues. Elle permet aux modèles de localiser et d’identifier des objets dans une image à l’aide de boîtes englobantes. Si les boîtes englobantes sont utiles pour diverses applications, elles ne fournissent qu’une estimation approximative de la position d’un objet.
Cependant, dans des domaines comme les soins de santé, où la précision est essentielle, les applications de l’IA visuelle ne se limitent pas à l’identification d’un objet. Elles nécessitent souvent aussi des informations sur sa forme et sa position exactes.
C’est précisément ce que permet la segmentation, une tâche de vision par ordinateur. Au lieu d’utiliser des boîtes englobantes, les modèles de segmentation détectent les objets au niveau du pixel. Au fil des ans, les chercheurs ont développé des modèles de vision par ordinateur spécialisés dans la segmentation.
U-Net est l’un de ces modèles. Bien que des modèles plus récents et plus avancés aient surpassé ses performances, U-Net occupe une place importante dans l’histoire de la vision par ordinateur. Dans cet article, nous allons examiner de plus près l’architecture U-Net, son fonctionnement, ses applications et sa comparaison avec les modèles de segmentation plus modernes disponibles aujourd’hui.
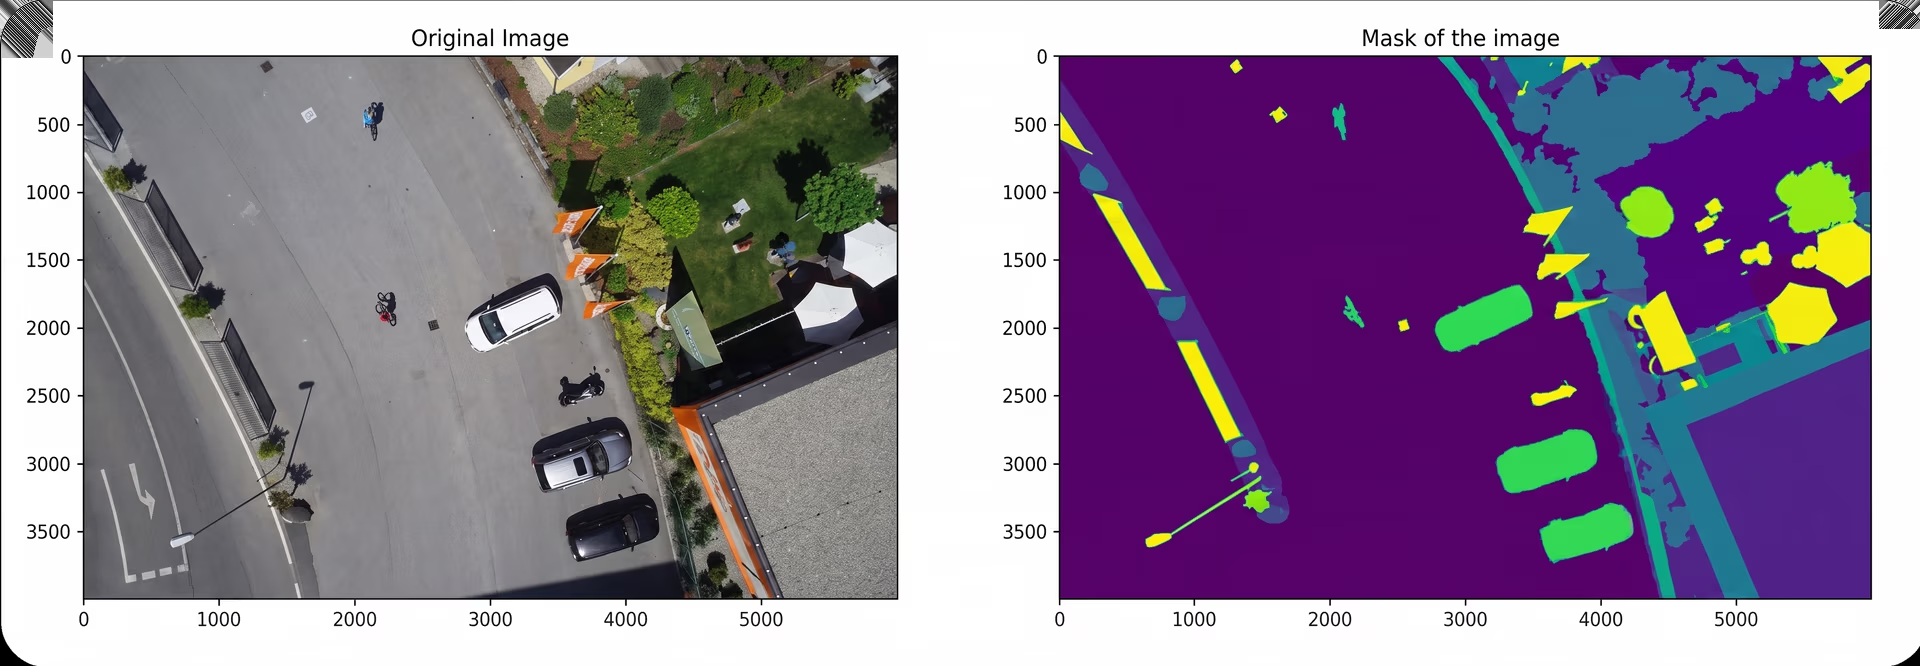
Fig. 1. Exemple de segmentation à l’aide du modèle d’apprentissage profond U-Net. (Source)
L’histoire de la segmentation d’images#
Avant de nous pencher sur U-Net, voyons d’abord comment les modèles de segmentation d’images ont évolué.
Au départ, la vision par ordinateur reposait sur des techniques classiques comme la détection de contours, le seuillage ou la croissance de régions pour séparer les objets dans une image. Ces techniques servaient à détecter les limites des objets à partir des contours, à séparer les régions selon l’intensité des pixels et à regrouper les pixels similaires. Elles fonctionnaient dans les cas simples, mais échouaient souvent lorsque les images étaient bruitées, comportaient des formes qui se chevauchaient ou présentaient des contours flous.
Après l’essor de l’apprentissage profond en 2012, les chercheurs ont introduit en 2014 le concept de réseaux entièrement convolutifs (FCNs) pour des tâches comme la segmentation sémantique. Ces modèles remplaçaient certaines parties d’un réseau convolutif pour permettre à l’ordinateur d’examiner une image entière à la fois, au lieu de la découper en petits morceaux. Le modèle pouvait ainsi créer des cartes détaillées qui montrent plus clairement le contenu d’une image.
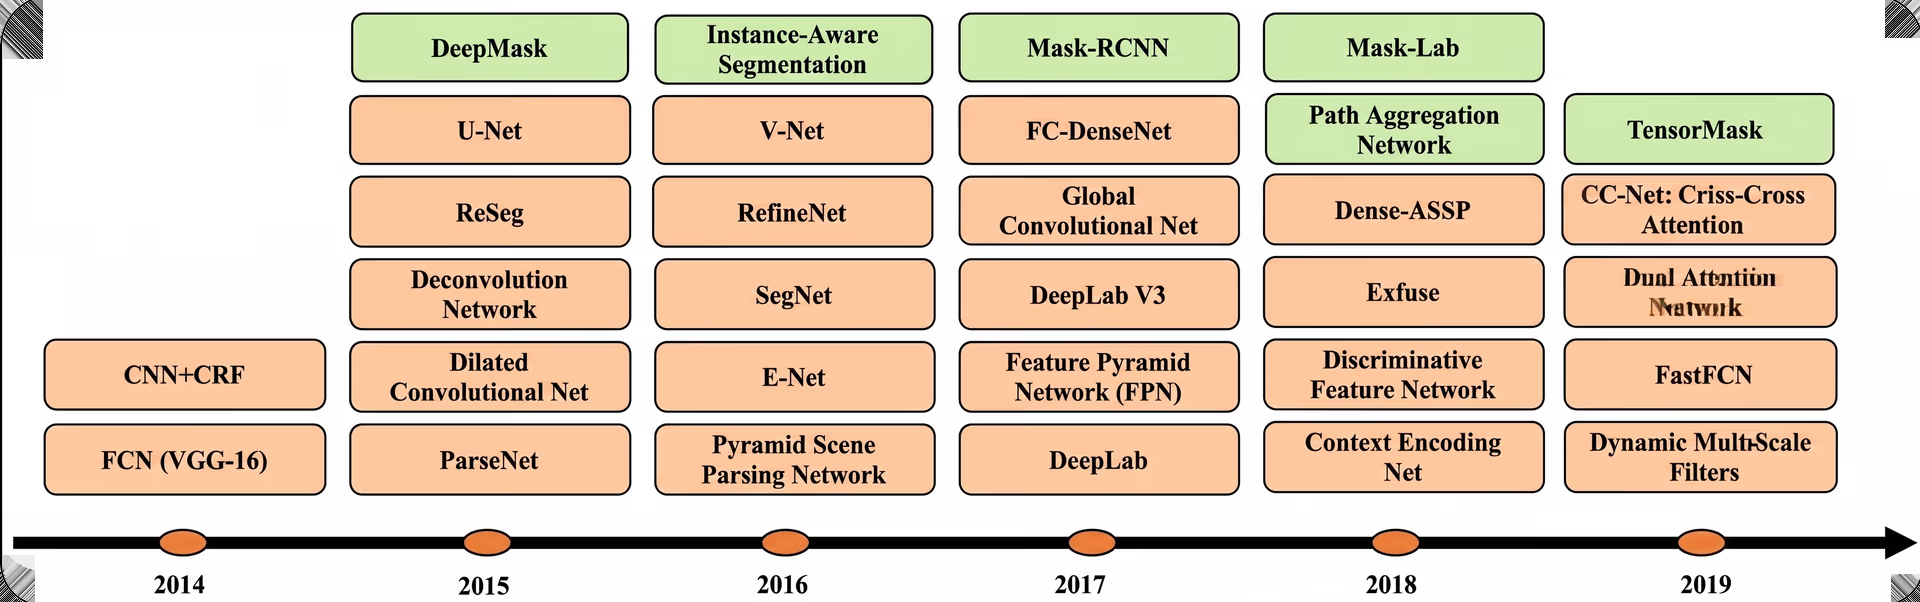
Fig. 2. Évolution des algorithmes de segmentation fondés sur l’apprentissage profond. (Source)
Dans le prolongement des FCNs, U-Net a été présenté en 2015 par des chercheurs de l’université de Fribourg. Il a été conçu à l’origine pour la segmentation d’images biomédicales. U-Net a notamment été pensé pour donner de bons résultats lorsque les données annotées sont limitées.
Entre-temps, des versions ultérieures comme UNet++ et TransUNet ont apporté des améliorations, notamment des couches d’attention et une meilleure extraction des caractéristiques. Les couches d’attention aident le modèle à se concentrer sur les régions importantes, tandis que l’extraction des caractéristiques améliorée permet de capturer des informations plus détaillées.
Qu’est-ce qu’U-Net et comment les caractéristiques circulent-elles dans le modèle ?#
U-Net est un modèle d’apprentissage profond conçu spécifiquement pour la segmentation d’images. Il prend une image en entrée et produit un masque de segmentation qui classe chaque pixel selon l’objet ou la région auquel il appartient.
Le modèle doit son nom à son architecture en forme de U. Il comprend deux parties principales : un encodeur qui compresse l’image et apprend ses caractéristiques, et un décodeur qui la ramène à sa taille d’origine. Cette conception crée une forme symétrique en U, qui aide le modèle à comprendre à la fois la structure générale d’une image et ses détails les plus fins.
L’utilisation de connexions de saut est l’une des caractéristiques essentielles d’U-Net : elles permettent de transmettre directement au décodeur les informations provenant de l’encodeur. Le modèle peut ainsi préserver des détails importants qui risqueraient d’être perdus lors de la compression de l’image.
Aperçu de l’architecture U-Net#
Voici un aperçu du fonctionnement de l’architecture U-Net :
- Image d’entrée : U-Net commence par une image 2D, comme une image médicale ou une photo satellite. L’objectif est d’attribuer une étiquette de classe à chaque pixel de l’image.
- Sous-échantillonnage : L’image traverse des couches convolutives qui apprennent des caractéristiques visuelles importantes. À mesure qu’elle passe par les différentes couches, sa résolution diminue et le modèle repère des motifs plus généraux.
- Couche goulot d’étranglement : Au centre du réseau, les cartes de caractéristiques atteignent leur résolution spatiale la plus faible tout en capturant des caractéristiques sémantiques de haut niveau. En termes simples, cette représentation compressée des cartes de caractéristiques constitue le contexte global de l’entrée.
- Suréchantillonnage : Le réseau reconstruit ensuite l’image en augmentant progressivement sa résolution. Les convolutions transposées contribuent à ramener les cartes de caractéristiques vers leur taille d’origine.
- Connexions de saut : Les cartes de caractéristiques du chemin de sous-échantillonnage sont concaténées avec celles du chemin de suréchantillonnage. Cela permet de préserver les détails spatiaux fins tout en intégrant les informations contextuelles de haut niveau.
- La sortie est une carte de segmentation : La sortie finale est un masque de segmentation pixel par pixel, de la même taille que l’entrée. Chaque pixel est classé dans une catégorie comme objet, arrière-plan ou région d’intérêt.
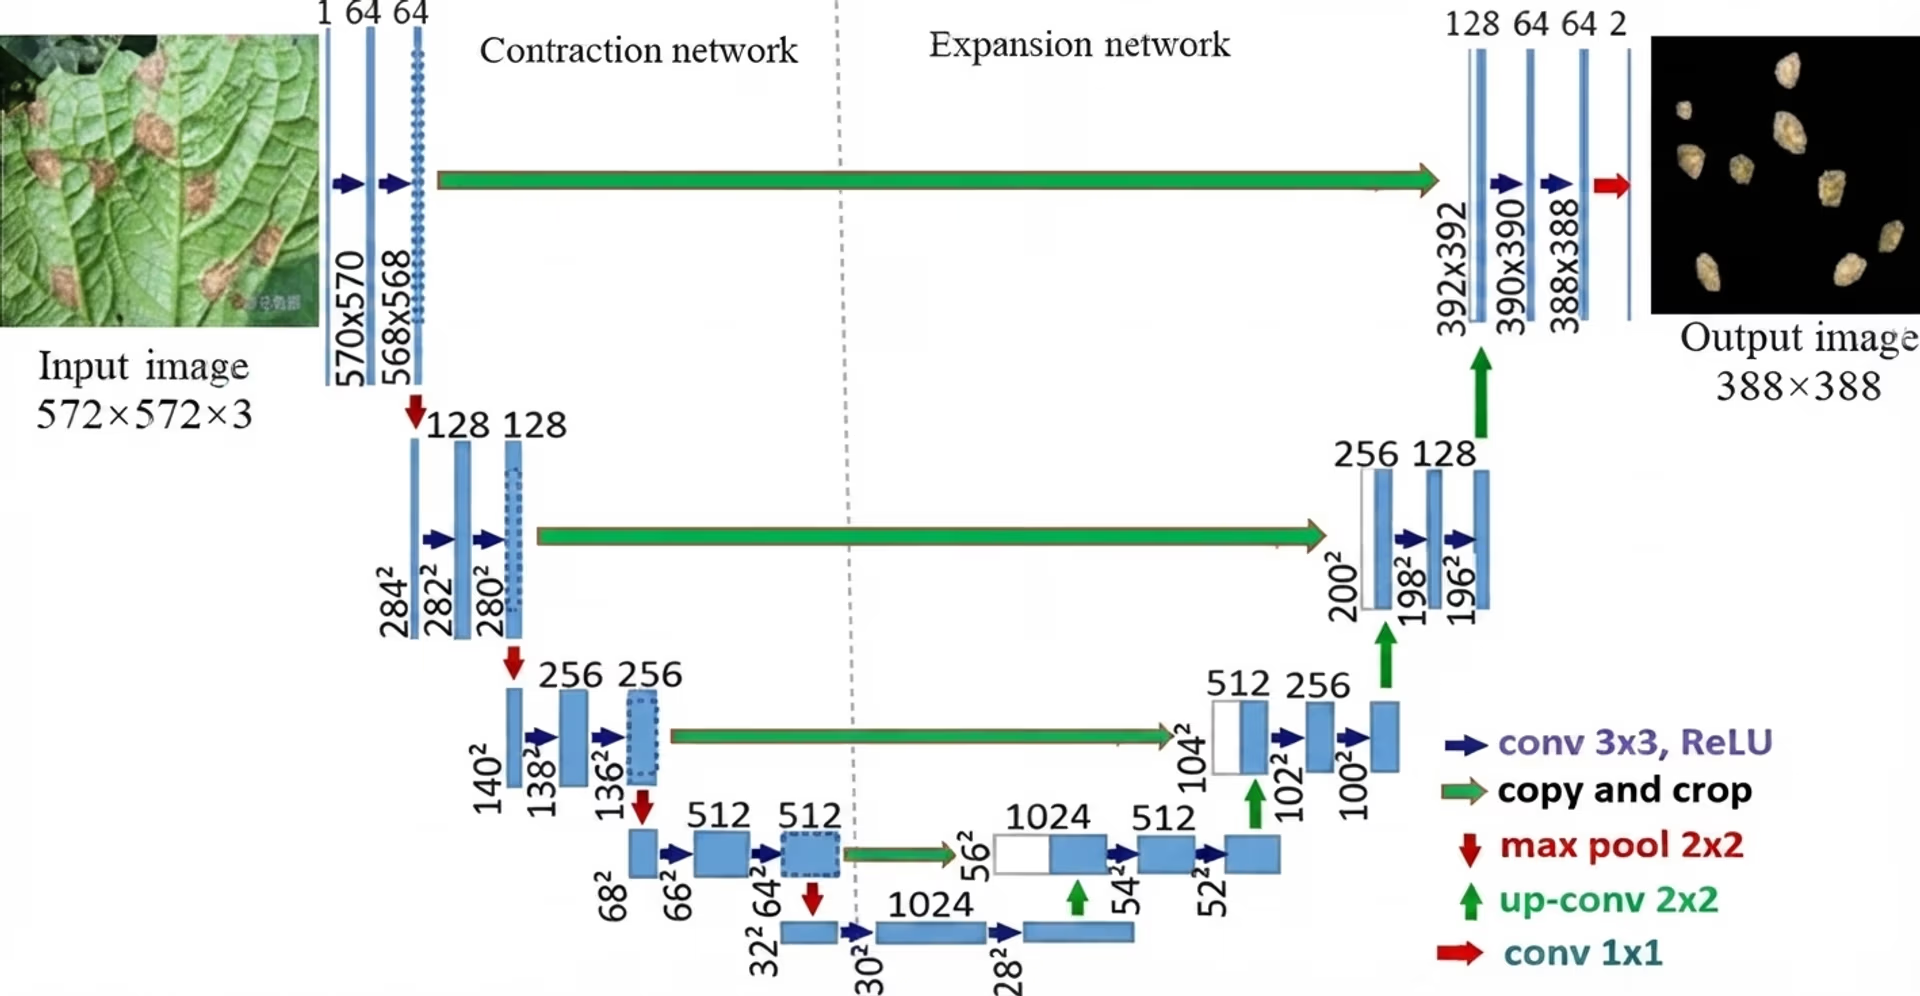
Fig. 3. Schéma de l’architecture U-Net. (Source)
Comprendre la différence entre ViT et U-Net#
En découvrant U-Net, tu te demandes peut-être en quoi il diffère d’autres modèles d’apprentissage profond, comme le Transformer de vision (ViT), qui peut également effectuer des tâches de segmentation. Les deux modèles peuvent accomplir des tâches similaires, mais leur conception et leur manière de traiter la segmentation diffèrent.
U-Net traite les images au niveau du pixel à l’aide de couches convolutives organisées en une structure encodeur-décodeur. Il est souvent utilisé pour des tâches qui exigent une segmentation précise, comme l’analyse d’images médicales ou de scènes de conduite autonome.
De son côté, le Transformer de vision (ViT) découpe les images en fragments et les traite simultanément à l’aide de mécanismes d’attention. Il utilise l’auto-attention (un mécanisme qui permet au modèle de pondérer l’importance relative des différentes parties de l’image) pour saisir les relations entre ces parties, contrairement à l’approche convolutive d’U-Net.
Une autre différence importante : ViT a généralement besoin de davantage de données pour bien fonctionner, mais il excelle dans la détection de motifs complexes. U-Net, lui, donne de bons résultats avec des jeux de données plus petits, s’entraîne plus rapidement et nécessite souvent moins de temps d’entraînement.
Applications du modèle U-Net#
Maintenant que nous comprenons mieux ce qu’est U-Net et comment il fonctionne, voyons comment il est utilisé dans différents domaines.
Segmentation des hémorragies cérébrales en imagerie médicale#
U-Net est devenu une méthode fiable pour la segmentation au niveau du pixel d’images médicales complexes, notamment à l’apogée de son utilisation dans la recherche. Les chercheurs s’en sont servis pour mettre en évidence des zones importantes sur des examens médicaux, comme les tumeurs et les signes d’hémorragie interne sur des images de tomodensitométrie et d’IRM. Cette approche a considérablement amélioré la précision des diagnostics et simplifié l’analyse de données médicales complexes dans les contextes de recherche.
L’utilisation d’U-Net pour détecter les AVC et les hémorragies cérébrales sur des examens médicaux illustre son impact sur la recherche en santé. Les chercheurs pouvaient utiliser U-Net pour analyser des images du crâne et mettre en évidence les zones préoccupantes, afin d’identifier plus rapidement les cas nécessitant une prise en charge immédiate.
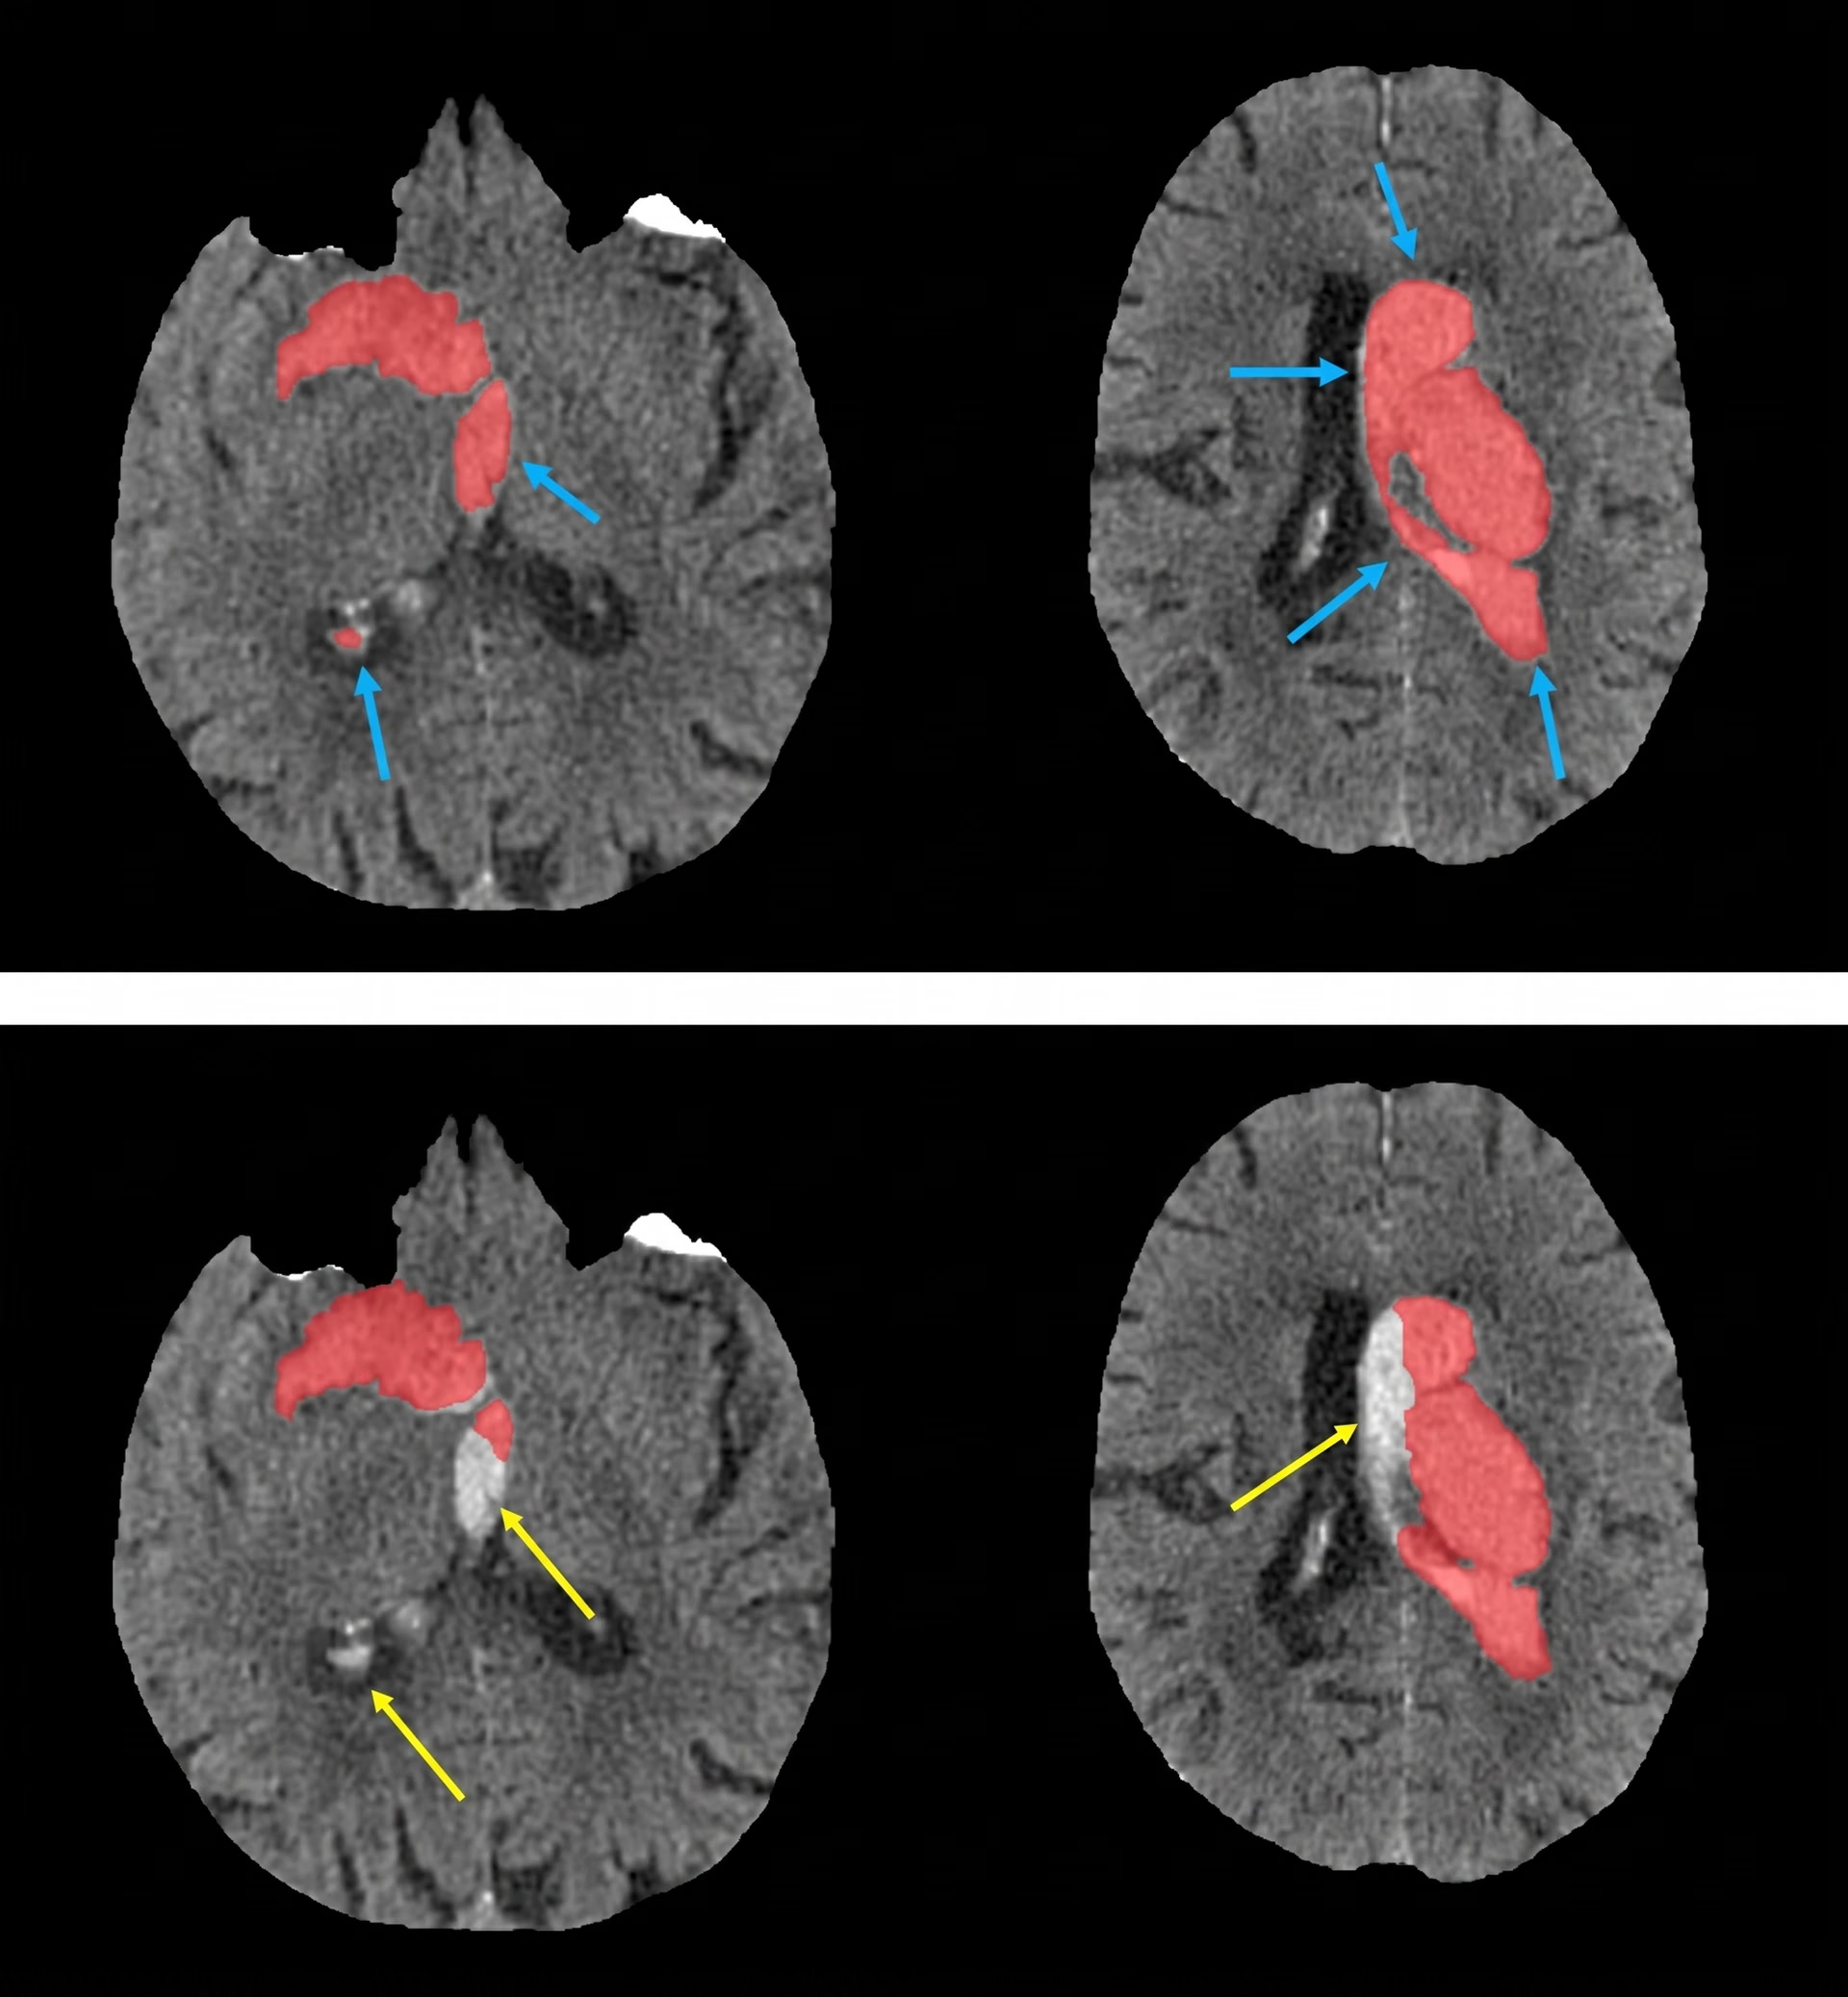
Fig. 4. Segmentation de lésions d’AVC hémorragique à l’aide de 3D U-Net. (Source)
Segmentation des cultures agricoles#
L’agriculture est un autre domaine où les chercheurs ont utilisé U-Net, en particulier pour segmenter les cultures, les mauvaises herbes et le sol. Le modèle aide les agriculteurs à surveiller la santé des plantes, à estimer les rendements et à prendre de meilleures décisions dans les grandes exploitations. Par exemple, U-Net peut distinguer les cultures des mauvaises herbes, ce qui améliore l’efficacité de l’application des herbicides et réduit le gaspillage.
Pour relever des défis comme le flou de mouvement dans les images de drone, les chercheurs ont amélioré U-Net à l’aide de techniques de défloutage d’images. Cela garantit une segmentation plus nette, même lorsque les données sont recueillies en mouvement, par exemple lors de relevés aériens.
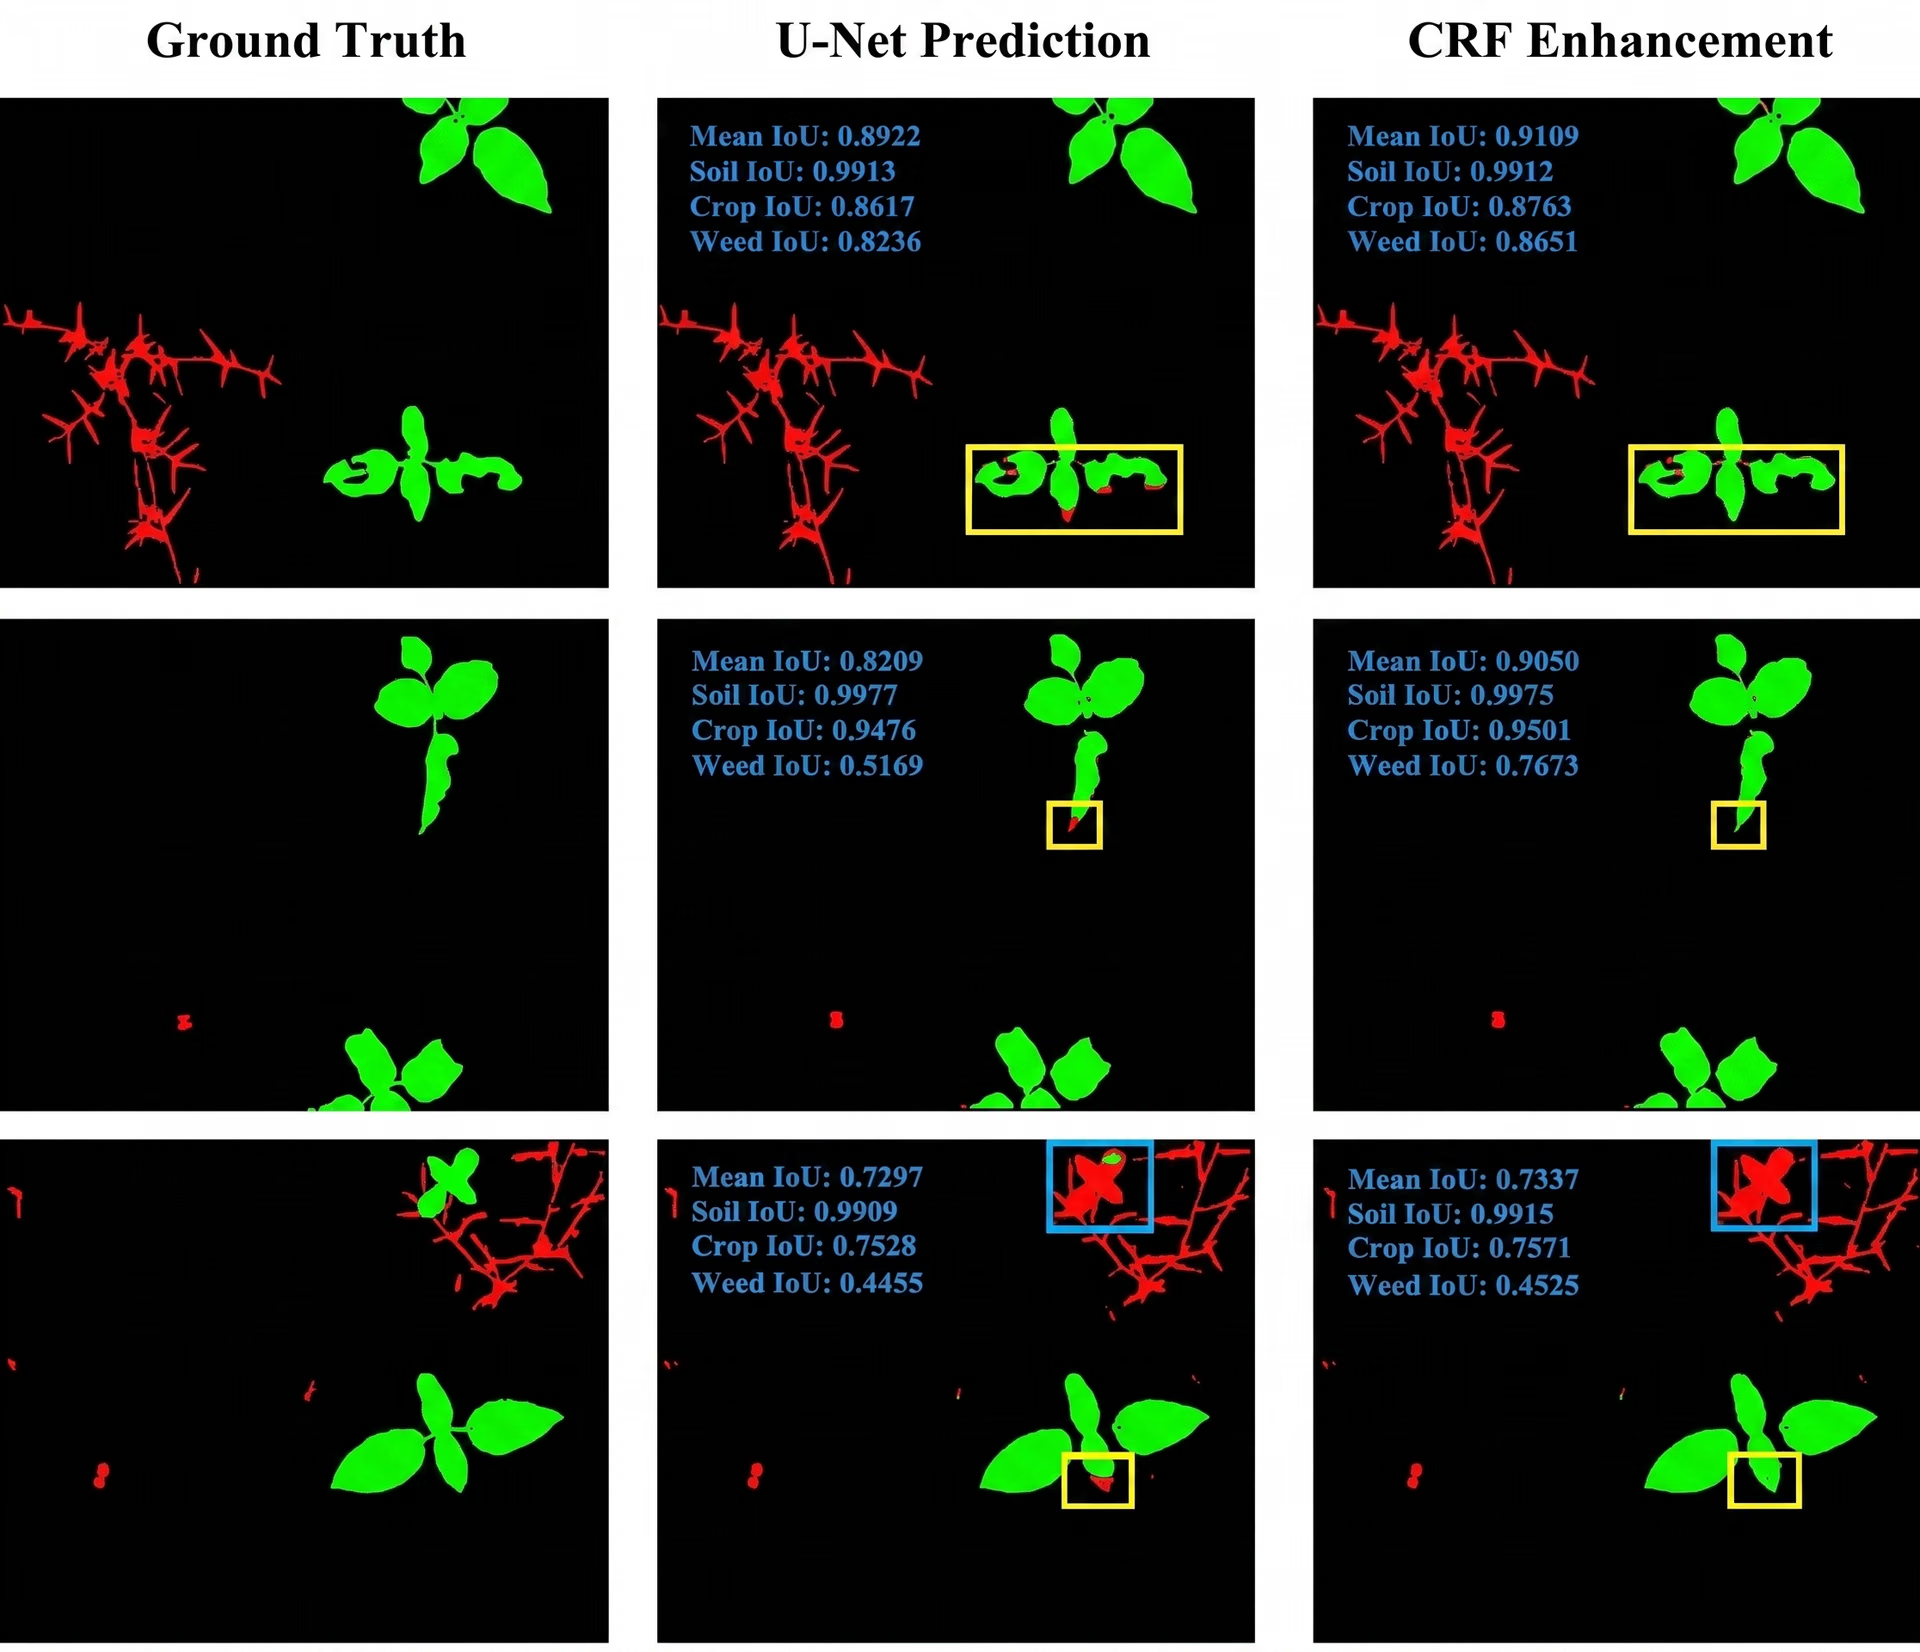
Fig. 5. Distinction entre les cultures et les mauvaises herbes dans des champs agricoles avec U-Net. (Source)
Conduite autonome#
Avant l’apparition de modèles d’IA plus avancés, U-Net a joué un rôle essentiel dans l’étude de la manière dont la segmentation pouvait améliorer la conduite autonome. Dans les véhicules autonomes, la segmentation sémantique d’U-Net peut servir à classer chaque pixel d’une image dans des catégories comme la route, les véhicules, les piétons et les marquages au sol. La voiture dispose ainsi d’une vision claire de son environnement, ce qui favorise une navigation sûre et une prise de décision efficace.
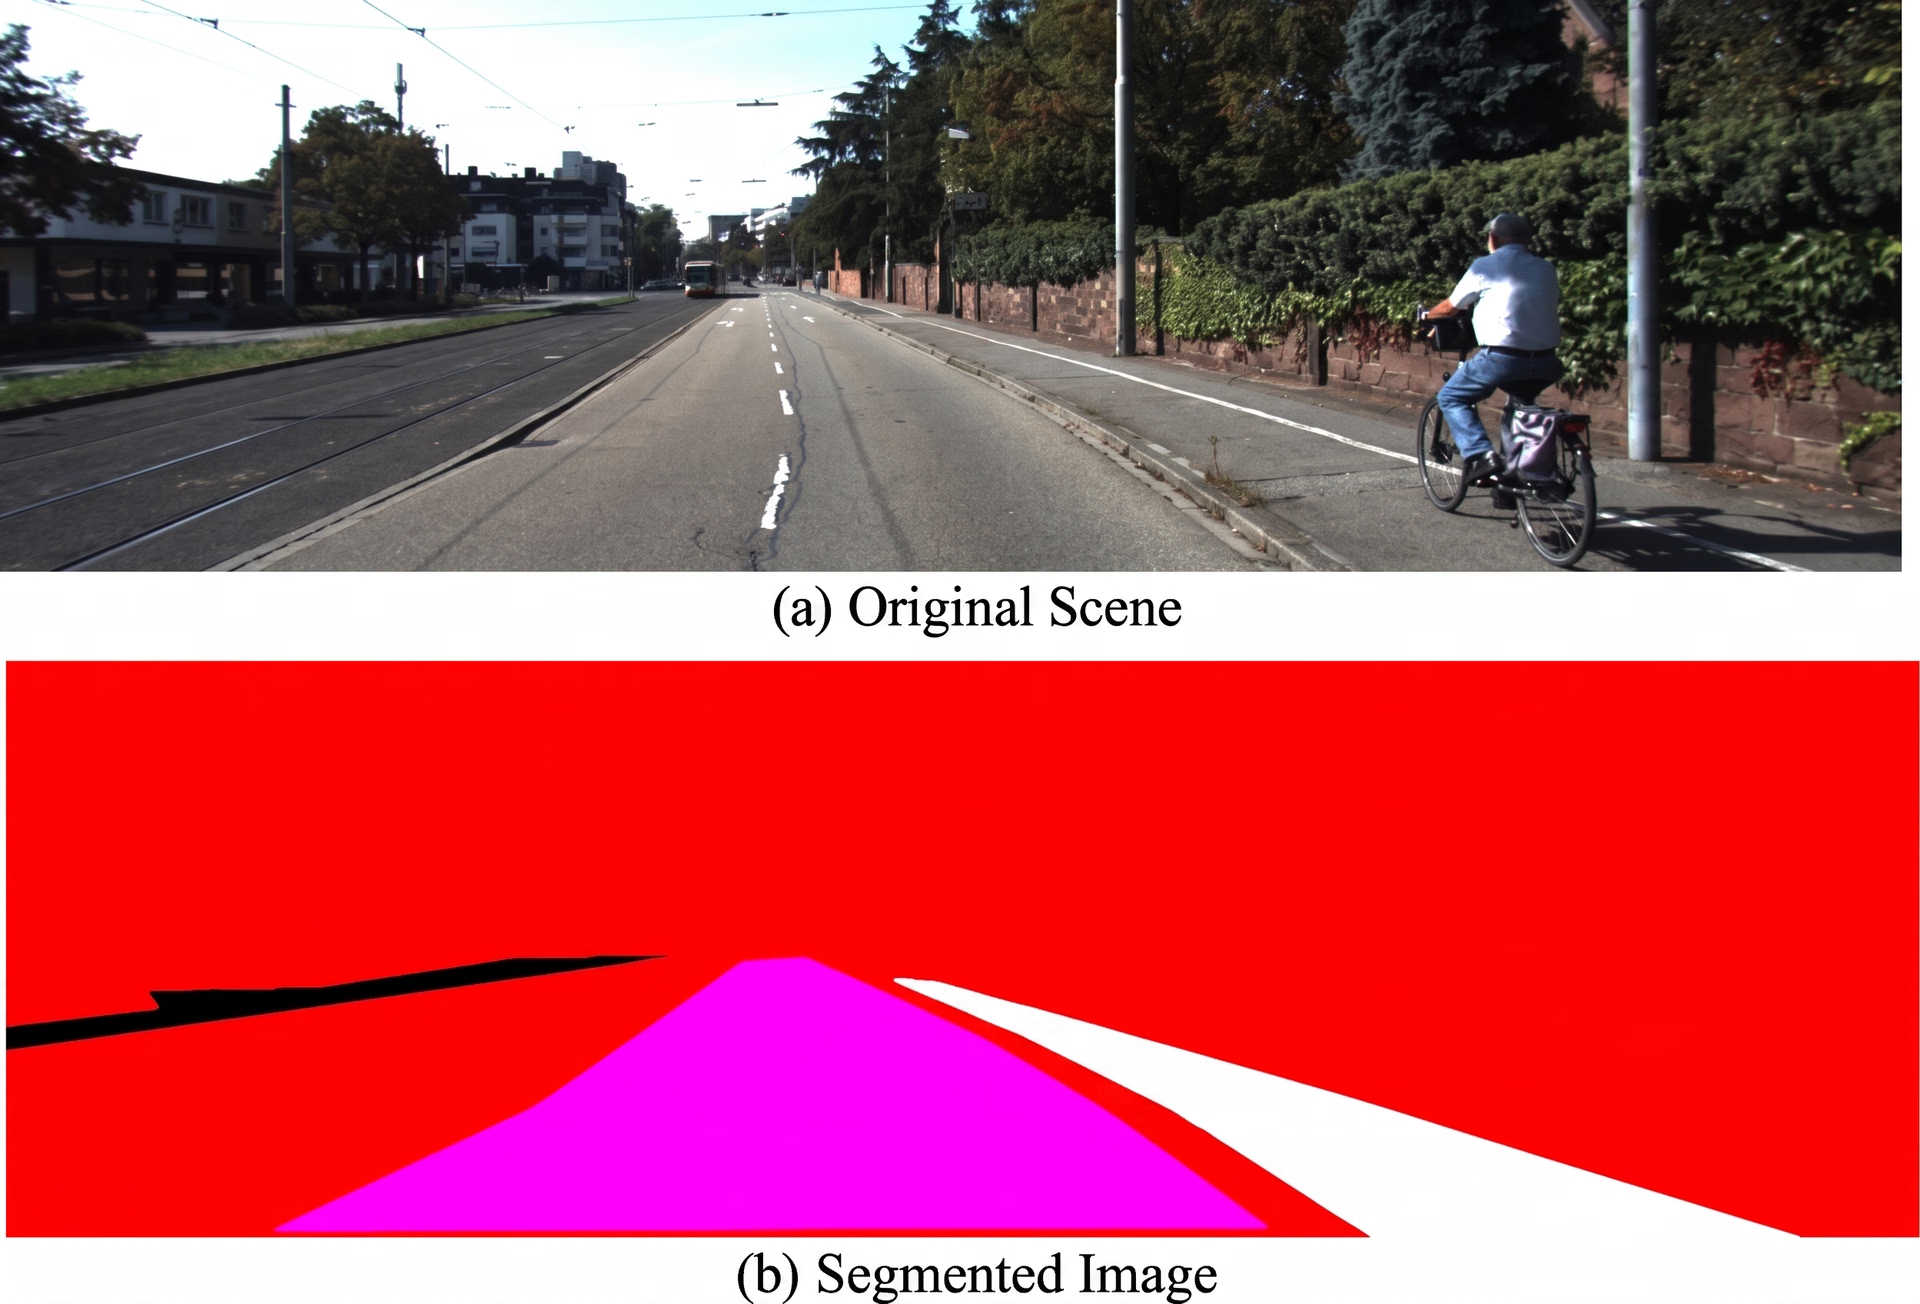
Fig. 6. Scène de route où la zone carrossable est segmentée à l’aide d’U-Net. (Source)
Avantages et inconvénients d’U-Net#
Aujourd’hui encore, U-Net reste un bon choix pour la segmentation d’images chez les chercheurs, grâce à son équilibre entre simplicité, précision et adaptabilité. Voici quelques-uns de ses principaux avantages :
- Adaptable à différentes modalités : U-Net a été adapté à divers types de données, notamment les images médicales 3D, les images satellite et même les images vidéo.
- Inférence rapide après optimisation : Correctement ajusté, U-Net peut fonctionner efficacement et convient aux applications en temps réel ou quasi réel.
- Open source et communauté : U-Net est disponible dans les principales bibliothèques d’apprentissage profond et bénéficie du soutien d’une vaste communauté de développeurs et de chercheurs.
U-Net présente de nombreux atouts, mais quelques limites sont également à prendre en compte. Voici certains facteurs à considérer :
- Sensibilité à la qualité des données : Les performances d’U-Net peuvent être affectées par des données de mauvaise qualité, comme des images bruitées ou de faible résolution.
- Risque de surapprentissage avec de petits jeux de données : Bien qu’U-Net fonctionne bien avec peu de données, il risque tout de même de surapprendre s’il n’est pas correctement régularisé, en particulier lorsque le jeu de données est trop petit ou manque de diversité.
- Ressources de calcul : U-Net peut être coûteux en calcul, en particulier avec de grands jeux de données, et nécessite d’importantes ressources matérielles pour l’entraînement.
Points clés à retenir#
U-Net a marqué une étape importante dans l’évolution de la segmentation d’images. Il a démontré que les modèles d’apprentissage profond pouvaient fournir des résultats précis à partir de jeux de données plus petits, notamment dans des domaines comme l’imagerie médicale.
Cette avancée a ouvert la voie à des applications plus évoluées dans divers domaines. Alors que la vision par ordinateur continue d’évoluer, les modèles de segmentation comme U-Net restent fondamentaux pour permettre aux machines de comprendre et d’interpréter les données visuelles avec une grande précision.
Tu souhaites créer tes propres projets de vision par ordinateur ? Explore notre dépôt GitHub pour approfondir tes connaissances en IA et découvre nos options de licence. Découvre comment la vision par ordinateur dans le secteur de la santé améliore l’efficacité et explore l’impact de l’IA dans le commerce de détail en consultant nos pages de solutions ! Rejoins dès maintenant notre communauté en pleine expansion !









