Les 5 meilleurs conseils pour déployer efficacement YOLO26 en périphérie et dans le cloud
Découvre les 5 meilleurs conseils pratiques pour déployer efficacement Ultralytics YOLO26 en périphérie et dans le cloud, du choix du flux de travail et du format d’exportation à la quantification.
Le mois dernier, Ultralytics a officiellement lancé Ultralytics YOLO26, établissant une nouvelle référence en matière d’IA visuelle, une branche de l’intelligence artificielle qui permet aux machines d’interpréter et de comprendre les informations visuelles issues d’images et de vidéos. Au lieu de simplement capturer des images, les modèles de vision par ordinateur comme les modèles Ultralytics YOLO prennent en charge des tâches de vision telles que la détection d’objets, la segmentation d’instances, l’estimation de pose et la classification d’images.
Conçu pour fonctionner là où la vision par ordinateur est réellement utilisée — sur des appareils, des caméras, des robots et des systèmes de production —, Ultralytics YOLO26 est un modèle de pointe qui offre une inférence plus rapide sur l’unité centrale (CPU), un déploiement simplifié et des performances efficaces de bout en bout dans des environnements réels. Les modèles YOLO26 ont également été conçus pour faciliter le passage des solutions de vision par ordinateur de l’expérimentation à la production.
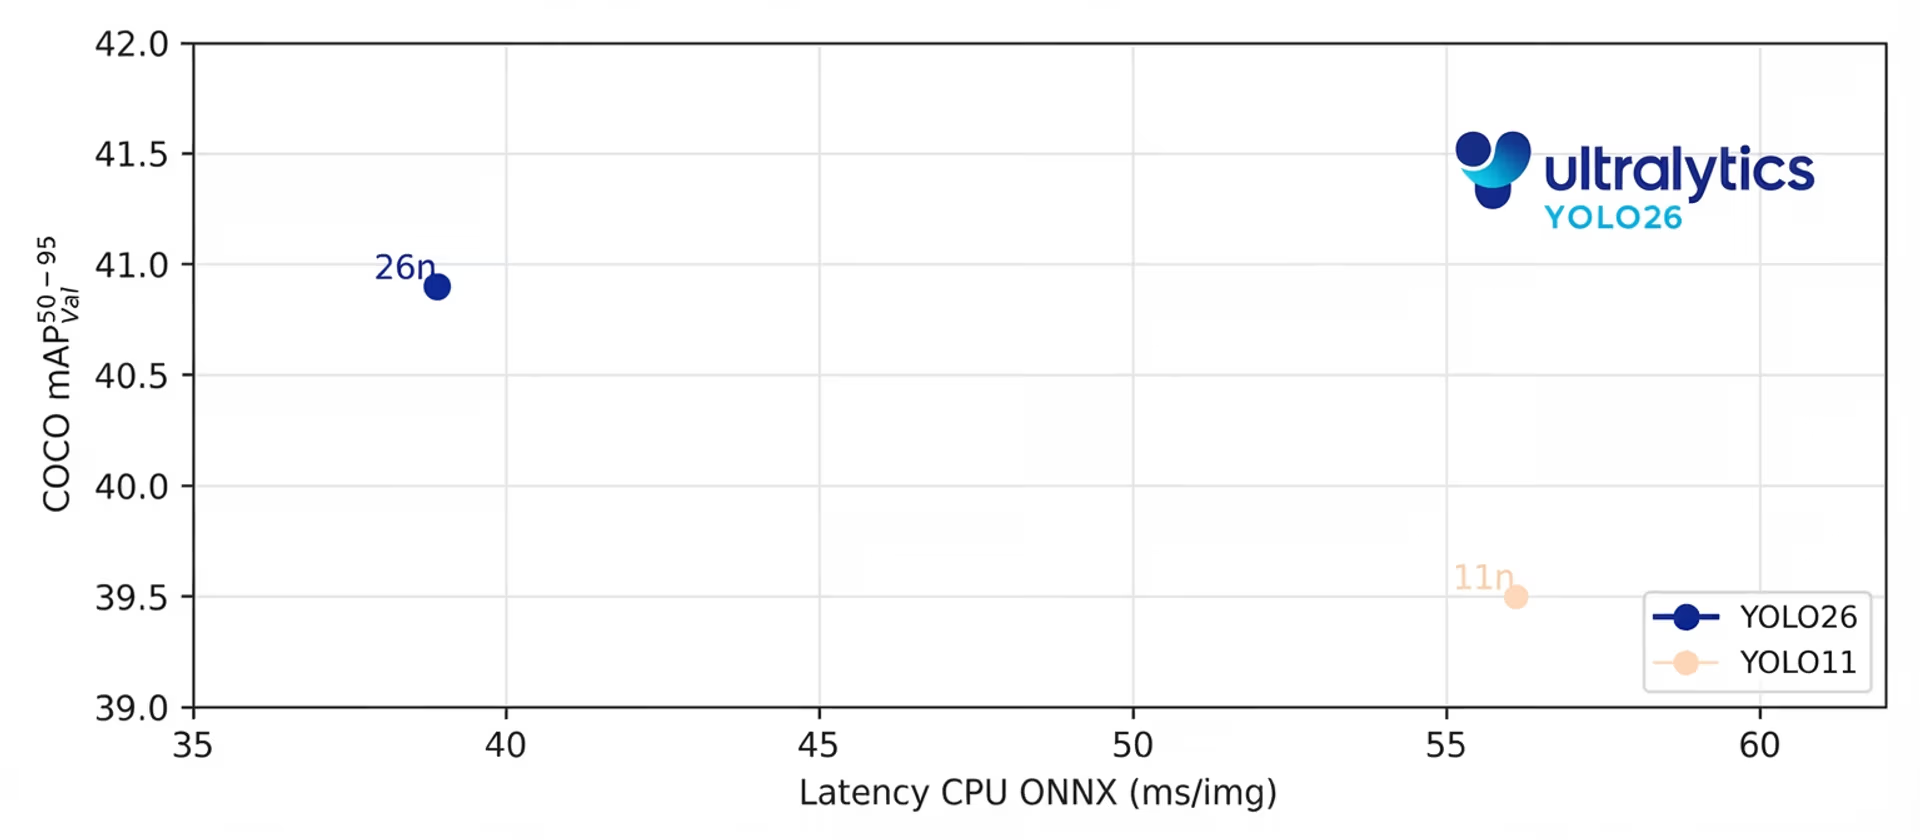
Fig. 1. Le modèle nano YOLO26 offre une inférence sur CPU jusqu’à 43 % plus rapide que YOLO11. (Source)
Le déploiement d’un modèle nécessite généralement de prendre plusieurs éléments en compte : choisir le matériel adapté, sélectionner un format d’exportation approprié, optimiser les performances et valider les résultats en conditions réelles. Grâce au package Python Ultralytics, qui simplifie l’entraînement, l’inférence et l’exportation des modèles vers plusieurs plateformes de déploiement, le déploiement de YOLO26 se fait facilement.
Cependant, même avec des processus simplifiés, il est essentiel de prendre les bonnes décisions en matière de déploiement. Dans cet article, nous allons passer en revue cinq conseils pratiques pour t’aider à déployer efficacement Ultralytics YOLO26 dans des environnements en périphérie et dans le cloud, afin de garantir des performances d’IA visuelle fiables et évolutives en production. C’est parti !
Qu’est-ce que le déploiement de modèles en vision par ordinateur ?#
Avant d’aborder les stratégies de déploiement d’Ultralytics YOLO26, prenons un peu de recul pour comprendre ce que signifie le déploiement de modèles en vision par ordinateur.
Le déploiement de modèles consiste à transférer un modèle d’apprentissage profond entraîné depuis un environnement de développement vers une application réelle, où il peut traiter de nouvelles images ou des flux vidéo et générer des prédictions en continu. Au lieu de lancer des expériences sur des jeux de données statiques, le modèle fait alors partie d’un système opérationnel.
En vision par ordinateur, cela signifie souvent intégrer le modèle à des caméras, des appareils d’IA en périphérie, des API ou une infrastructure cloud. Le modèle doit fonctionner dans les limites du matériel, respecter les exigences de latence et maintenir des performances constantes malgré les conditions changeantes du monde réel.
Il est essentiel de comprendre ce passage de l’expérimentation à la production, car les décisions de déploiement ont une incidence directe sur les performances du modèle en dehors d’un laboratoire ou d’un environnement expérimental.
Comprendre les processus de déploiement d’Ultralytics YOLO26#
Voyons maintenant en quoi consiste concrètement un processus de déploiement d’Ultralytics YOLO26. En bref, il s’agit de la suite d’étapes qui transforme une image capturée en prédiction après son analyse.
Dans une configuration classique, une caméra capture une image ou une image vidéo. Ces données sont ensuite prétraitées, par exemple en les redimensionnant ou en les mettant au bon format, avant d’être transmises à Ultralytics YOLO26 pour l’inférence.
Le modèle analyse l’entrée et produit des résultats tels que des boîtes englobantes, des masques de segmentation ou des points clés. Ces résultats peuvent ensuite déclencher des actions, comme l’envoi d’alertes, la mise à jour d’un tableau de bord ou le pilotage d’un système robotique.
L’emplacement d’exécution de ce processus dépend de ta stratégie de déploiement. Par exemple, dans un déploiement en périphérie, l’inférence s’effectue directement sur l’appareil ou à proximité de la caméra, ce qui contribue à réduire la latence et à améliorer la confidentialité des données.
À l’inverse, dans un déploiement cloud, les images ou les trames vidéo sont envoyées à des serveurs distants pour y être traitées, ce qui améliore l’évolutivité et permet une gestion centralisée. Certains systèmes adoptent une approche hybride, avec un traitement léger en périphérie et des charges de travail plus importantes dans le cloud.
Découvrir les variantes du modèle Ultralytics YOLO26#
Pour prendre des décisions éclairées en matière de déploiement, il est également important de savoir qu’il existe différentes variantes du modèle Ultralytics YOLO26.
Prêts à l’emploi, les modèles Ultralytics YOLO sont disponibles en plusieurs tailles, ce qui facilite le choix d’une version adaptée à ton matériel et à tes besoins en matière de performances. YOLO26 existe en cinq variantes : Nano (n), Small (s), Medium (m), Large (l) et Extra Large (x).
Les modèles plus petits, comme YOLO26n, sont optimisés pour l’efficacité et conviennent parfaitement aux appareils en périphérie, aux appareils de l’Internet des objets (IoT), aux systèmes embarqués et aux systèmes reposant sur un CPU, où une faible latence et une consommation d’énergie réduite sont importantes. Ils offrent de solides performances tout en utilisant un minimum de ressources.
Les modèles plus grands, comme YOLO26l et YOLO26x, sont conçus pour offrir une meilleure précision et traiter des scènes plus complexes. Ces variantes donnent généralement les meilleurs résultats sur les systèmes équipés d’unités de traitement graphique (GPUs) ou dans des environnements cloud disposant de davantage de ressources de calcul.
Le choix de la taille du modèle dépend de tes objectifs de déploiement. Si la vitesse et l’efficacité sur du matériel aux ressources limitées sont tes priorités absolues, une variante plus petite peut être idéale. Si ton application exige une précision maximale et que tu disposes d’un matériel plus puissant, un modèle plus grand peut être le meilleur choix.
Conseils pour déployer Ultralytics YOLO26 efficacement#
Maintenant que nous comprenons mieux les variantes du modèle Ultralytics YOLO26 et les processus de déploiement, découvrons quelques conseils pratiques pour déployer YOLO26 efficacement dans des environnements en périphérie et dans le cloud.
Conseil 1 : examine tes options de déploiement du modèle#
L’une des premières décisions à prendre lors du déploiement d’Ultralytics YOLO26 concerne l’environnement d’exécution du modèle. Ton environnement de déploiement influe directement sur les performances, la latence, la confidentialité et l’évolutivité.
Commence par évaluer ton processus. Ton application nécessite-t-elle une faible latence, c’est-à-dire que les prédictions doivent être générées presque instantanément après la capture d’une image ?
Par exemple, en robotique ou dans les systèmes de sécurité, même de petits retards peuvent nuire aux performances. Dans ces cas, un déploiement en périphérie est souvent la meilleure option. L’exécution de l’inférence directement sur un appareil ou à proximité de la caméra réduit le temps de traitement des données et évite l’envoi des images sur Internet, ce qui peut également améliorer la confidentialité.
En revanche, le déploiement cloud offre une meilleure évolutivité et davantage de puissance de calcul. Les serveurs cloud peuvent traiter de grands volumes d’images, gérer plusieurs flux vidéo et prendre en charge un débit plus élevé.
Par exemple, en agriculture, un agriculteur peut recueillir des milliers d’images de feuilles et les analyser par lots afin de déterminer si les cultures présentent des signes de maladie. Dans ce type de scénario, il n’est pas forcément nécessaire d’obtenir des résultats immédiats en temps réel, ce qui fait du traitement cloud une solution pratique et évolutive.
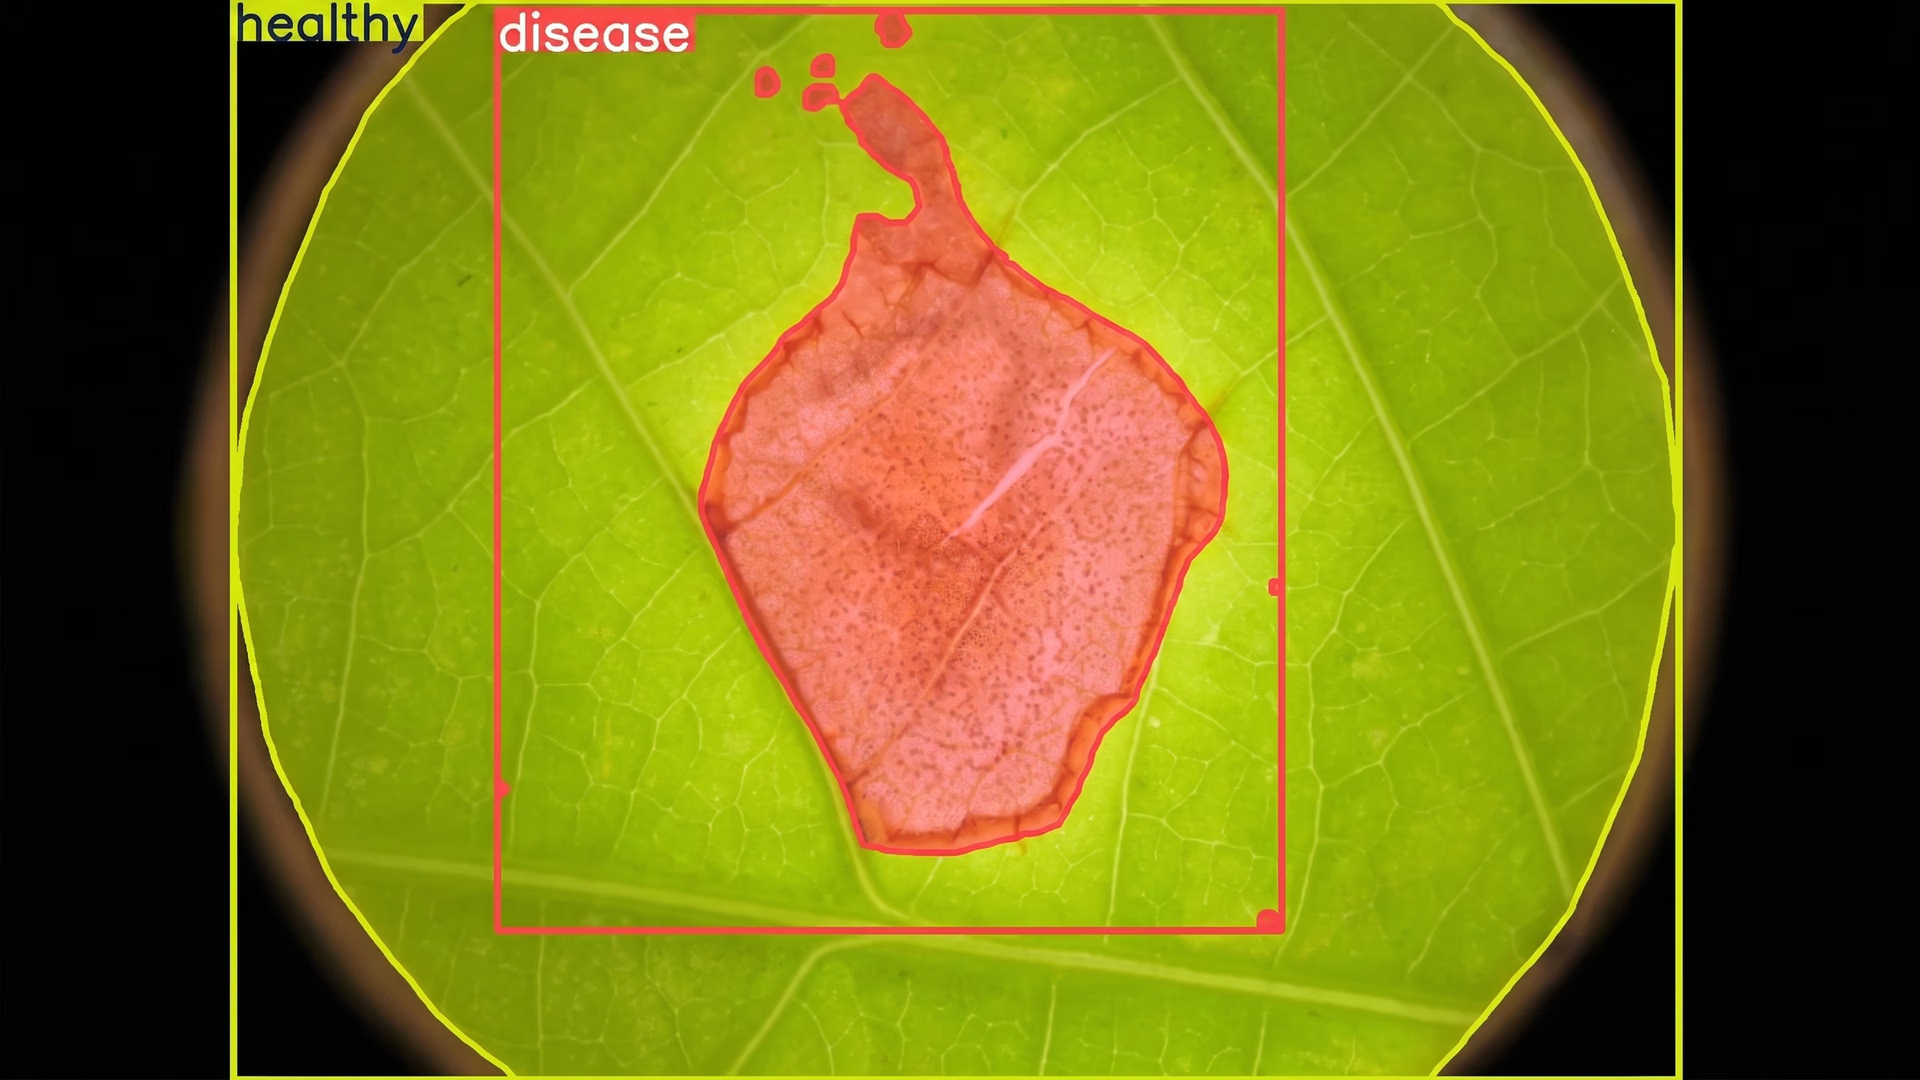
Fig. 2. Exemple d’utilisation d’Ultralytics YOLO26 pour analyser des images de feuilles
Cependant, l’envoi de données à des serveurs distants entraîne une latence réseau, c’est-à-dire un retard lié à la transmission des images sur Internet et à la réception des prédictions en retour. Ce compromis peut être acceptable pour les applications qui ne sont pas sensibles au facteur temps.
Il existe également des options entre une solution entièrement en périphérie et une solution entièrement dans le cloud. Certaines entreprises utilisent une infrastructure sur site, située à proximité du lieu de génération des données. D’autres mettent en place des pipelines hybrides : elles effectuent un filtrage léger en périphérie et envoient les données sélectionnées vers le cloud pour une analyse plus approfondie.
Le choix de la bonne option de déploiement dépend des exigences de ton application. En définissant clairement tes besoins en matière de vitesse, de confidentialité et d’évolutivité, tu peux sélectionner une stratégie qui garantit le bon fonctionnement d’Ultralytics YOLO26 dans des conditions réelles.
Conseil 2 : choisis le format d’exportation adapté à ton matériel#
Une fois que tu as décidé où ton modèle sera exécuté, l’étape suivante consiste à choisir le bon format d’exportation. Exporter un modèle consiste à le convertir depuis le format utilisé pendant l’entraînement vers un format optimisé pour le déploiement.
Les modèles Ultralytics YOLO26 sont conçus et entraînés nativement avec PyTorch, mais les environnements de production s’appuient souvent sur des moteurs d’exécution spécialisés, mieux adaptés à des matériels spécifiques. Ces moteurs sont conçus pour accélérer l’inférence, réduire l’utilisation de la mémoire et garantir la compatibilité avec l’appareil cible.
Convertir YOLO26 au format approprié lui permet de fonctionner efficacement en dehors de l’environnement d’entraînement. Le package Python Ultralytics simplifie ce processus. Il prend en charge un large éventail d’intégrations pour créer et déployer des projets de vision par ordinateur.
Si tu souhaites explorer ces intégrations plus en détail, consulte la documentation officielle d’Ultralytics. Elle comprend des tutoriels étape par étape, des conseils adaptés à différents matériels et des exemples pratiques pour t’aider à passer du développement à la production en toute confiance.
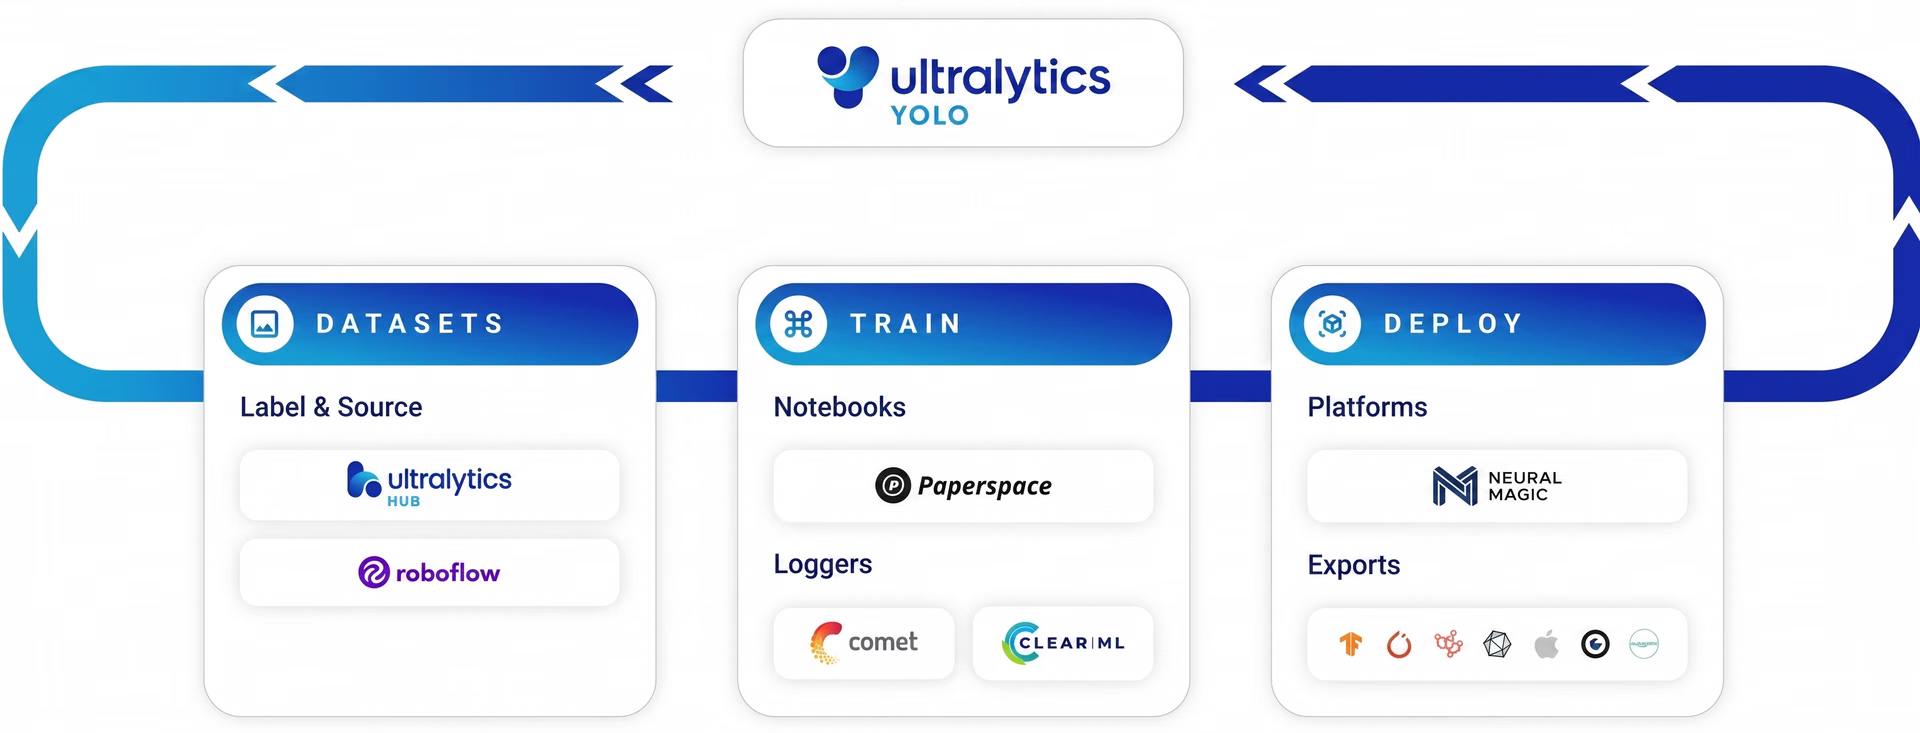
Fig. 3. Ultralytics prend en charge différentes intégrations (Source)
En particulier, le package Python Ultralytics permet d’exporter Ultralytics YOLO26 vers plusieurs formats adaptés à différentes plateformes matérielles. Par exemple, le format d’exportation ONNX assure la compatibilité multiplateforme, le format TensorRT est optimisé pour les GPU NVIDIA et les appareils périphériques NVIDIA Jetson, et le format OpenVINO est conçu pour le matériel Intel.
Certains appareils prennent en charge plusieurs formats d’exportation, mais les performances peuvent varier selon celui que tu choisis. Au lieu de sélectionner un format par défaut, demande-toi : quelle option est la plus efficace pour ton appareil ?
Un format peut accélérer l’inférence, tandis qu’un autre peut mieux gérer la mémoire ou s’intégrer plus facilement à ton pipeline existant. Il est donc important d’adapter le format d’exportation à ton matériel et à ton environnement de déploiement spécifiques.
Prendre le temps de tester différents formats d’exportation sur ton appareil cible peut faire une différence notable en conditions réelles. Un format d’exportation bien adapté contribue à garantir qu’Ultralytics YOLO26 fonctionne efficacement, de manière fiable et à la vitesse requise par ton application.
Conseil 3 : demande-toi si ton modèle doit être quantifié#
Après avoir sélectionné un format d’exportation, il est également judicieux de déterminer si ton modèle doit être quantifié.
La quantification de modèle réduit la précision numérique des poids et des calculs d’un modèle, généralement en les convertissant du format à virgule flottante 32 bits vers des formats de précision inférieure, comme 16 bits ou 8 bits. Cela permet de réduire la taille du modèle et l’utilisation de la mémoire, tout en accélérant l’inférence, en particulier sur les appareils en périphérie ou les systèmes équipés d’un CPU.
Selon ton matériel, ton format d’exportation et tes dépendances d’exécution, la quantification peut améliorer sensiblement les performances. Certains environnements d’exécution sont optimisés pour les modèles de précision réduite, ce qui leur permet de s’exécuter plus rapidement et plus efficacement.
Cependant, la quantification peut légèrement réduire la précision si elle n’est pas appliquée avec soin. Lors d’une quantification après entraînement, veille à fournir les images de validation. Ces images sont utilisées pendant l’étalonnage pour aider le modèle à s’adapter à une précision réduite et à maintenir des prédictions stables.
Conseil 4 : tiens compte de la dérive des données#
Même le modèle le mieux entraîné peut perdre en performances au fil du temps à cause de la dérive des données. La dérive des données se produit lorsque les données que ton modèle voit en production diffèrent de celles sur lesquelles il a été entraîné.
Autrement dit, le monde réel change, mais pas ton modèle. Par conséquent, sa précision peut diminuer progressivement.
Par exemple, tu peux entraîner ton modèle Ultralytics YOLO26 à partir d’images prises de jour. Si ce même modèle est ensuite utilisé la nuit, dans des conditions d’éclairage différentes, ses performances peuvent baisser. Le même problème peut se produire en cas de changement d’angle de caméra, de conditions météorologiques, d’arrière-plan ou d’apparence des objets.
La dérive des données est fréquente dans les systèmes d’IA visuelle utilisés dans le monde réel. Les environnements sont rarement statiques, et de petits changements peuvent affecter la précision de détection. Pour réduire l’impact de cette dérive, tu peux veiller à ce que ton jeu de données d’entraînement reflète au mieux les conditions réelles.
Inclue des images prises à différents moments de la journée, dans des conditions d’éclairage variées et dans divers environnements. Après le déploiement, tu peux continuer à surveiller les performances et à mettre à jour le modèle ou à l’ajuster au besoin.
Conseil 5 : évalue les performances dans des conditions réelles#
Avant de déployer complètement ton modèle, tu peux évaluer ses performances dans des conditions réelles.
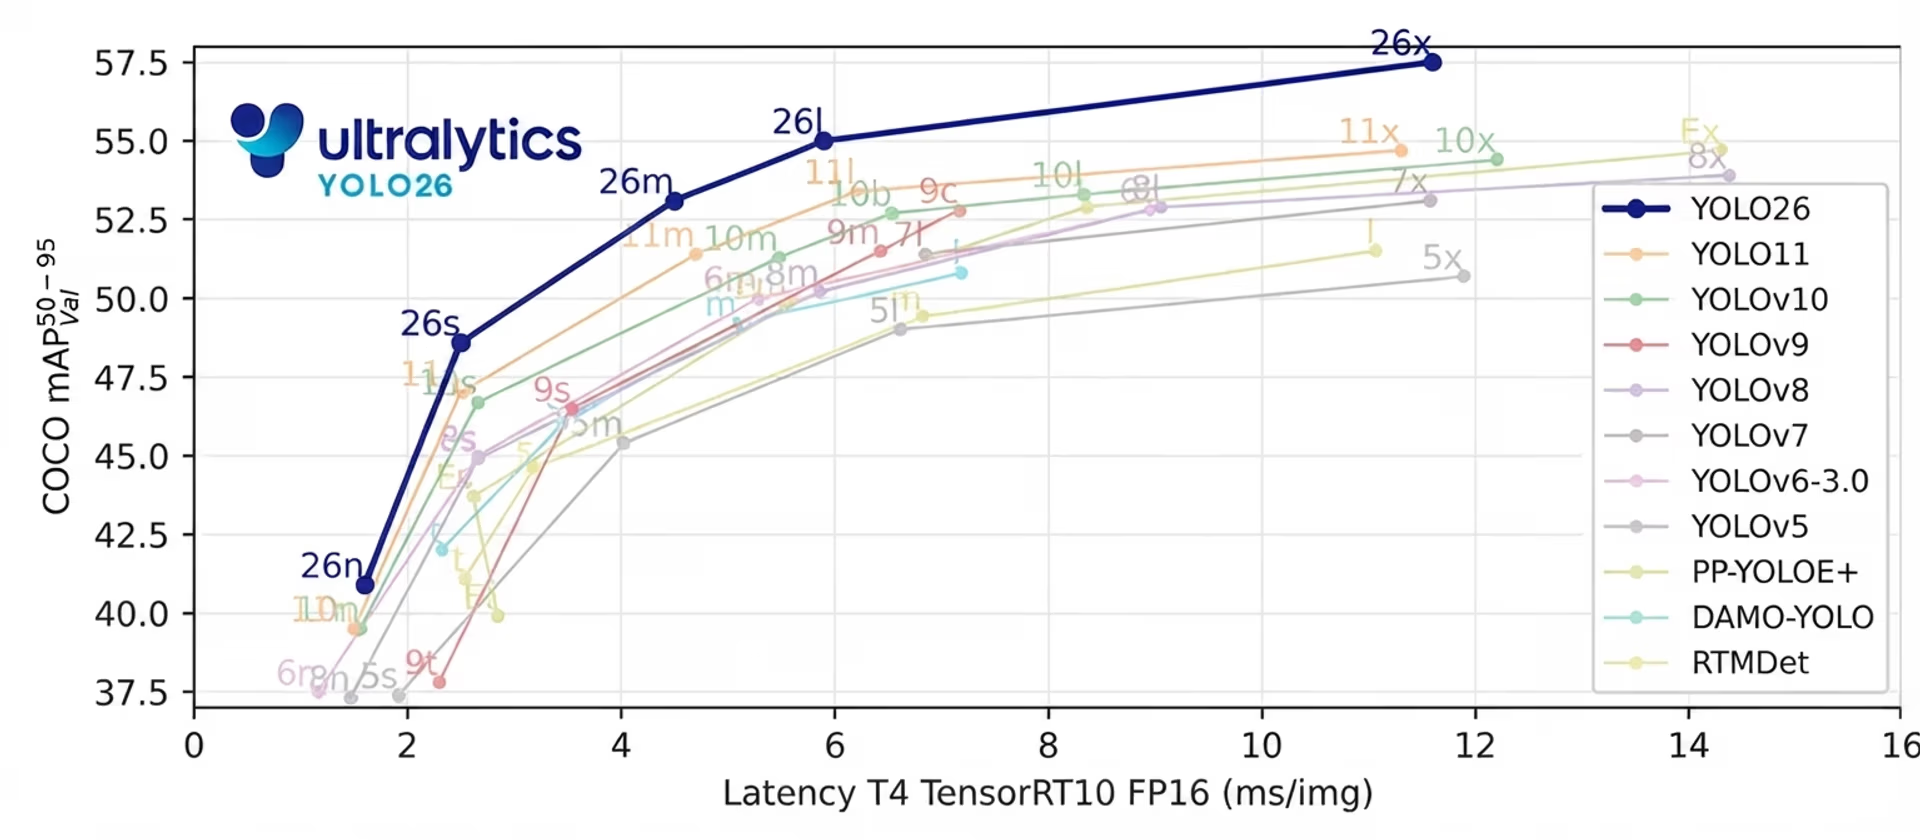
Fig. 4. Évaluation comparative de YOLO26 par rapport à d’autres modèles (Source)
Il est courant de tester les performances dans des environnements contrôlés, à l’aide d’images échantillons ou de petits jeux de données. Cependant, les systèmes en conditions réelles se comportent souvent différemment. Les limites matérielles, les délais réseau, les flux vidéo multiples et les entrées continues peuvent tous affecter les performances.
L’évaluation comparative consiste à mesurer les performances de ton modèle sur l’appareil et la configuration réels où il sera exécuté. Cela comprend la vérification de la vitesse d’inférence, de la latence globale, de l’utilisation de la mémoire et de la stabilité du système. Il est important de tester non seulement le modèle lui-même, mais aussi l’ensemble du pipeline, y compris le prétraitement et les étapes de post-traitement.
Un modèle peut bien fonctionner lors d’un test sur une seule image, mais peiner lorsqu’il traite un flux vidéo en direct de manière continue. De même, les performances sur une machine de développement puissante ne reflètent pas forcément le comportement du modèle sur un appareil en périphérie à faible consommation.
En évaluant les performances dans des conditions réalistes, tu peux repérer les goulots d’étranglement tôt et apporter des ajustements avant la mise en production. Tester dans le même environnement que celui où Ultralytics YOLO26 fonctionnera permet de garantir des performances fiables, stables et constantes en production.
Autres éléments clés à prendre en compte pour le déploiement d’un modèle#
Voici quelques facteurs supplémentaires à garder à l’esprit lors du déploiement d’Ultralytics YOLO26 :
- Surveillance et journalisation : configure des outils de surveillance pour suivre des métriques telles que la latence, la précision et l’état du système après le déploiement.
- Sécurité et confidentialité : mets en place des mesures de protection pour sécuriser les données visuelles sensibles, en particulier si tu utilises une infrastructure cloud ou distante.
- Optimisation des goulots d’étranglement du pipeline : évalue l’ensemble du pipeline, y compris les modules de prétraitement, d’inférence, de post-traitement et de transfert de données, car des retards peuvent survenir en dehors du modèle lui-même.
- Planification de la scalabilité : anticipe la croissance en veillant à ce que ton système puisse gérer une augmentation du trafic, des caméras supplémentaires ou une charge de travail accrue.
Points clés à retenir#
Pour déployer YOLO26 efficacement, commence par comprendre où ton modèle sera exécuté et ce dont ton application a réellement besoin. En choisissant la bonne approche de déploiement, en adaptant le format d’exportation à ton matériel et en testant les performances dans des conditions réelles, tu peux créer des systèmes d’IA visuelle fiables et réactifs. Avec une configuration adaptée, Ultralytics YOLO26 facilite le déploiement de la vision par ordinateur rapide et prête pour la production, en périphérie comme dans le cloud.
Rejoins notre communauté et explore notre dépôt GitHub. Consulte nos pages de solutions pour découvrir diverses applications, comme l’IA dans l’agriculture et la vision par ordinateur dans le secteur de la santé. Découvre nos options de licence et lance-toi dès aujourd’hui dans l’IA visuelle !








