Qu’est-ce que la distillation de jeux de données ? Présentation rapide
Découvre comment la distillation de jeux de données accélère l’entraînement des modèles et réduit les coûts de calcul en remplaçant les grands jeux de données par un petit ensemble optimisé d’échantillons synthétiques.
 Abirami Vina18 min de lecture
L’entraînement des modèles peut sembler être la tâche la plus chronophage du travail d’un spécialiste des données. Pourtant, la majeure partie de son temps, souvent entre 60 et 80 %, est consacrée à la préparation des données : les collecter, les nettoyer et les organiser pour la modélisation. À mesure que les jeux de données grossissent, le temps de préparation augmente également, ce qui ralentit les expériences et complique les itérations.
Pour remédier à ce problème, les chercheurs cherchent depuis des années des moyens de rationaliser l’entraînement. Des approches comme les données synthétiques, la compression des jeux de données et de meilleures méthodes d’optimisation visent toutes à réduire le coût et les difficultés liés à l’utilisation de jeux de données à grande échelle, et à accélérer les workflows d’apprentissage automatique.
Une question essentielle se pose alors : peut-on réduire considérablement la taille d’un jeu de données tout en obtenant les mêmes performances qu’en entraînant un modèle sur l’ensemble des données ? La distillation de jeux de données est une piste prometteuse.
Elle crée une version compacte d’un grand jeu de données d’entraînement tout en préservant les motifs essentiels dont le modèle a besoin pour apprendre efficacement. Cette approche permet d’accélérer l’entraînement, de réduire les besoins en calcul et de mener des expérimentations plus efficacement. On peut la comparer à une fiche de révision pour le modèle : un petit ensemble d’exemples de données synthétiques conçus pour lui enseigner les mêmes motifs fondamentaux que le jeu de données complet.
Dans cet article, nous verrons comment fonctionne la distillation de jeux de données et comment elle favorise l’apprentissage automatique et l’apprentissage profond à grande échelle dans des applications réelles.
Comprendre la distillation de jeux de données#
La distillation de jeux de données consiste à condenser un grand jeu de données d’entraînement en un ensemble beaucoup plus petit, qui transmet au modèle presque autant d’informations que le jeu de données d’origine. De nombreux chercheurs parlent également de condensation de jeux de données, car l’objectif est de capturer les motifs essentiels présents dans l’ensemble du jeu de données.
Un jeu de données distillé diffère des données synthétiques générées aléatoirement ou d’un simple sous-ensemble d’images réelles. Il ne s’agit ni d’un jeu de données artificiel aléatoire ni d’une copie tronquée de l’original.
Il est plutôt optimisé délibérément pour capturer les motifs les plus importants. Au cours du processus, chaque pixel et chaque caractéristique sont ajustés et optimisés afin qu’un réseau neuronal entraîné sur les données distillées apprenne presque comme s’il avait été entraîné sur l’ensemble du jeu de données.
Cette idée est apparue pour la première fois dans un article publié sur arXiv en 2018 par Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba et Alexei A. Efros. Les premiers tests ont utilisé des jeux de données simples comme MNIST et CIFAR-10, ce qui a permis de montrer facilement que quelques exemples distillés pouvaient remplacer des milliers d’images réelles.
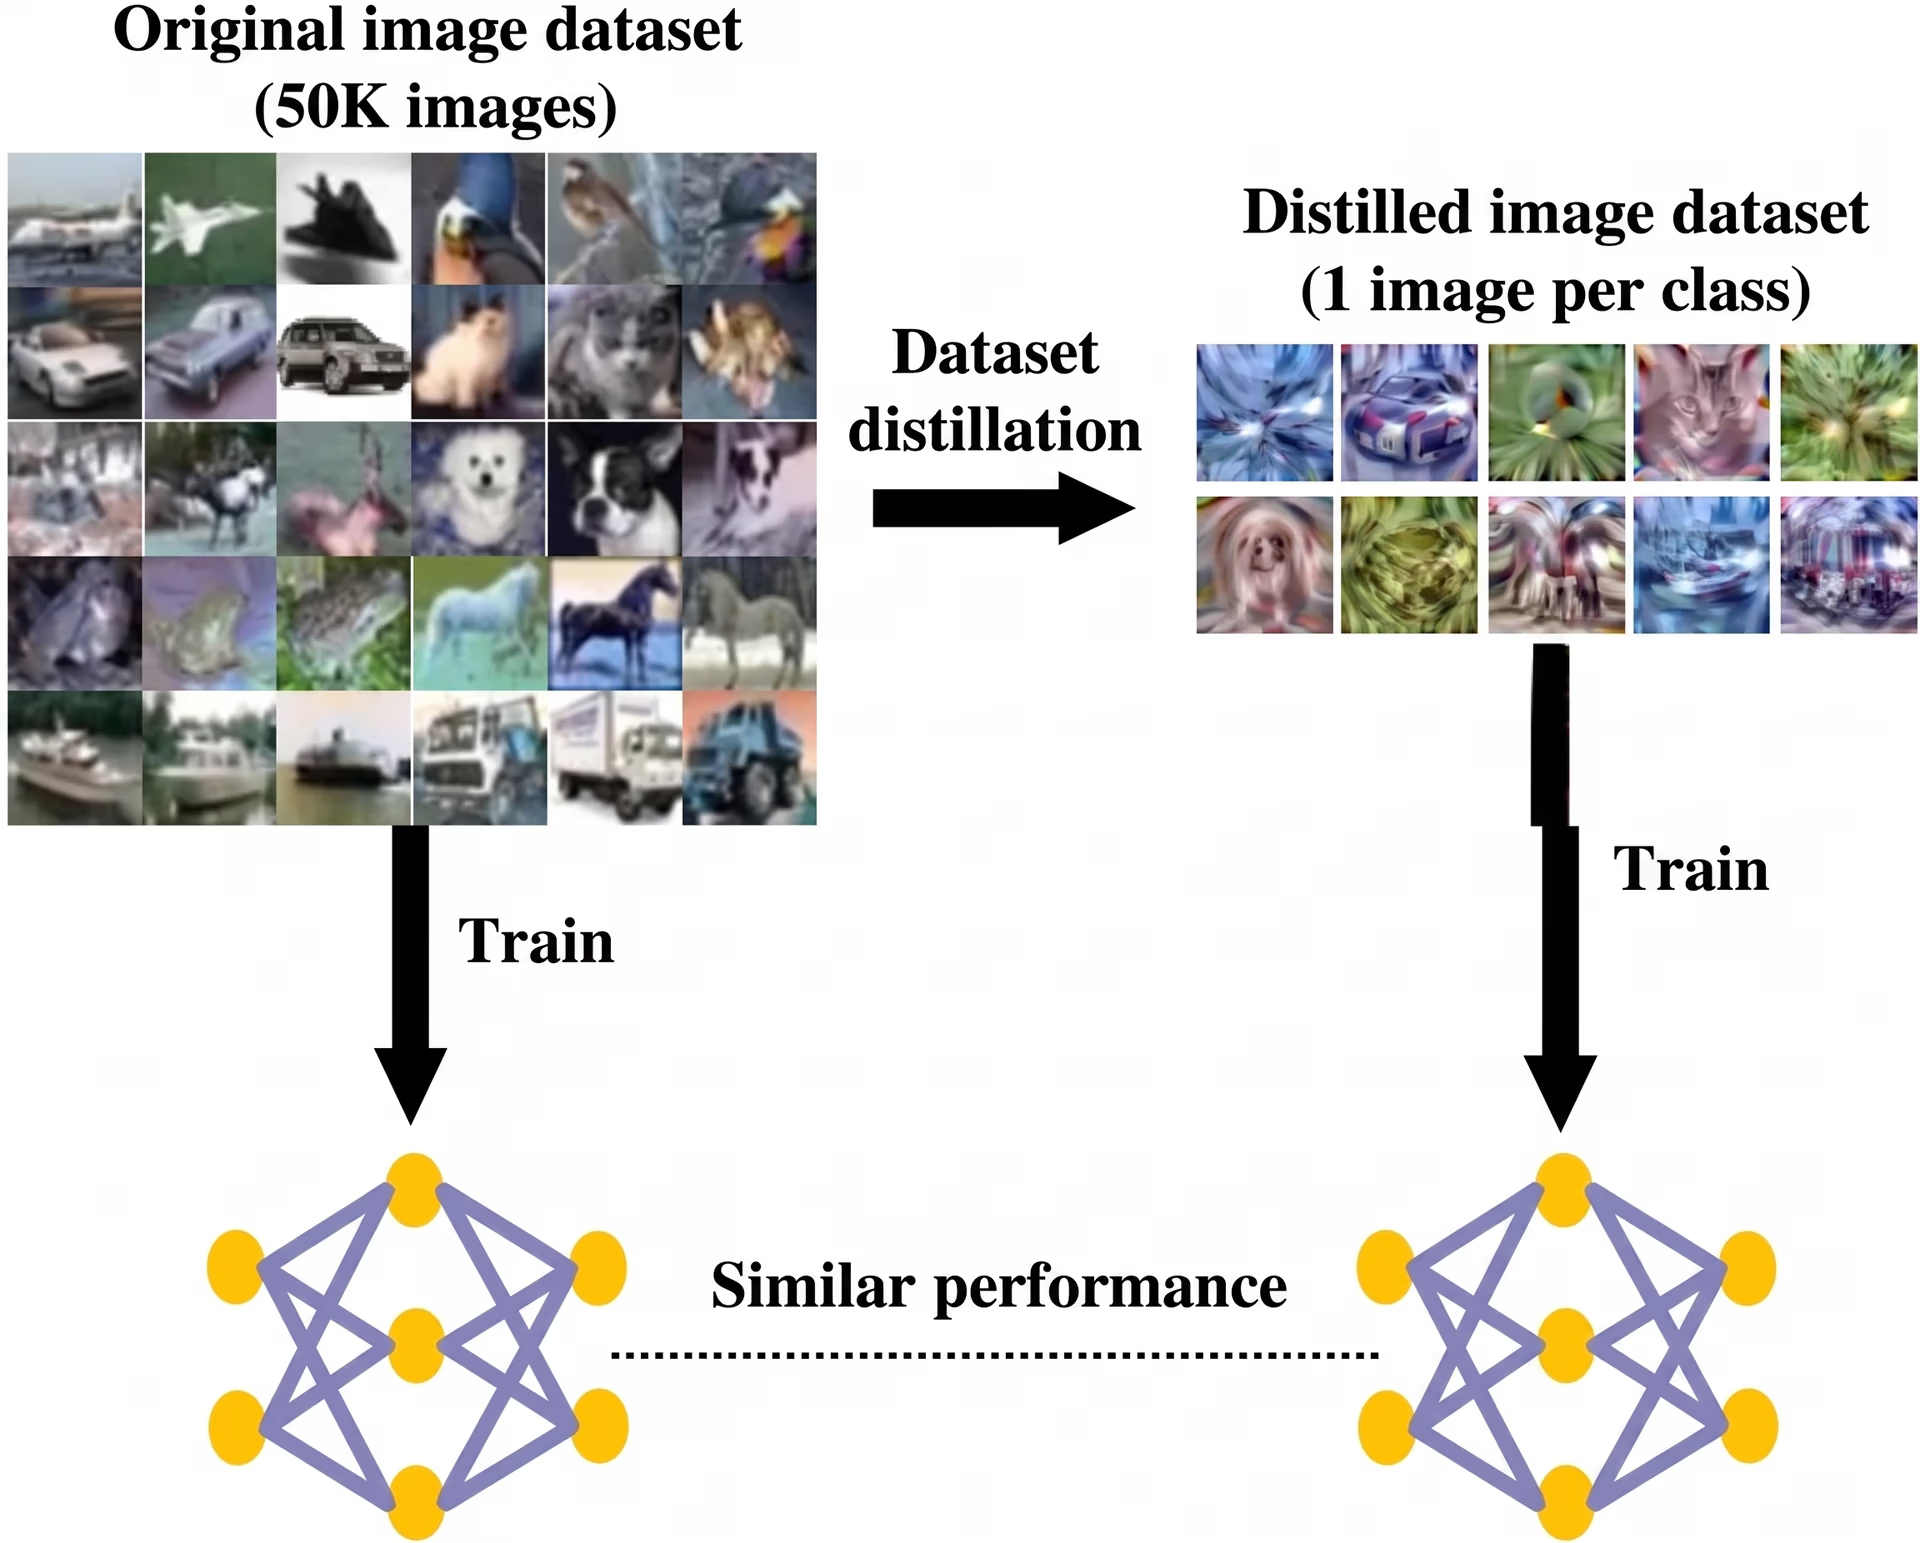
Fig. 1. Utiliser la distillation de jeux de données pour les données d’images (Source)
Depuis, des travaux ultérieurs ont approfondi la distillation de jeux de données, notamment des méthodes publiées à ICML et ICLR qui rendent la condensation plus efficace et plus évolutive.
L’importance de la distillation de jeux de données#
La distillation de jeux de données améliore l’efficacité de l’entraînement et accélère les cycles de développement. En réduisant la quantité de données dont un modèle a besoin pour apprendre, elle diminue les besoins en calcul.
Cette méthode est particulièrement utile pour l’apprentissage continu, où les modèles sont mis à jour au fil du temps ; pour la recherche d’architectures neuronales, qui consiste à tester de nombreux modèles ; et pour l’entraînement en périphérie, où les modèles fonctionnent sur de petits appareils aux ressources mémoire et énergétiques limitées. Dans l’ensemble, ces avantages font de la distillation de jeux de données une excellente option pour l’initialisation rapide, le réglage fin express et la création de premiers prototypes dans de nombreux workflows d’apprentissage automatique.
Présentation du fonctionnement de la distillation de jeux de données#
La distillation de jeux de données crée des échantillons d’entraînement synthétiques, c’est-à-dire générés artificiellement. Ces échantillons aident le modèle à apprendre d’une manière qui se rapproche de l’entraînement sur des données réelles. La méthode suit trois facteurs clés pendant l’entraînement habituel.
Le premier est la fonction de perte, qui représente le score d’erreur du modèle et indique à quel point ses prédictions sont incorrectes. Le deuxième est constitué des paramètres du modèle, c’est-à-dire les poids internes du réseau qui sont mis à jour au cours de l’apprentissage.
Le troisième est la trajectoire d’entraînement, qui décrit l’évolution de l’erreur et des poids étape par étape au fil du temps. Les échantillons synthétiques sont ensuite optimisés afin que, lorsqu’un modèle est entraîné à partir de ces échantillons, son erreur diminue et ses poids évoluent comme ils le feraient avec le jeu de données complet.
La distillation de jeux de données, étape par étape#
Examinons de plus près le fonctionnement de la distillation de jeux de données :
- Étape 1 - Initialiser les pixels synthétiques : Le processus commence par des images synthétiques qui servent d’entrées apprenables. Au départ, ces images ont peu de structure et ressemblent à des pages blanches. Avec le temps, elles sont optimisées pour devenir des exemples informatifs.
- Étape 2 - Optimiser avec l’appariement des gradients et la rétropropagation : Lorsque le modèle est entraîné sur ces images synthétiques, il produit des gradients qui indiquent comment chaque pixel doit changer pour mieux reproduire le comportement d’entraînement des données réelles. La rétropropagation est la méthode qui permet au réseau d’apprendre de ses erreurs. Elle propage l’erreur à rebours dans le modèle afin de déterminer quels pixels et quels poids en sont responsables, puis les ajuste légèrement. À l’aide de ces gradients, la rétropropagation modifie les images synthétiques étape par étape pour les rendre plus informatives lors de l’entraînement.
- Étape 3 - Apparier le comportement au fil des étapes d’entraînement : La méthode apparie également les trajectoires d’entraînement, c’est-à-dire les changements successifs que subit le modèle pendant son apprentissage. Cela garantit que le jeu de données distillé guide le modèle sur un parcours d’apprentissage semblable à celui qu’il suivrait avec le jeu de données complet.
- Étape 4 - Validation et généralisation : Enfin, le jeu de données distillé est évalué sur des données de validation réelles afin de déterminer les performances du modèle entraîné sur de nouveaux exemples. Cette étape permet de vérifier que les données synthétiques enseignent des motifs généraux et fonctionnels, au lieu d’amener le modèle à mémoriser des exemples précis.
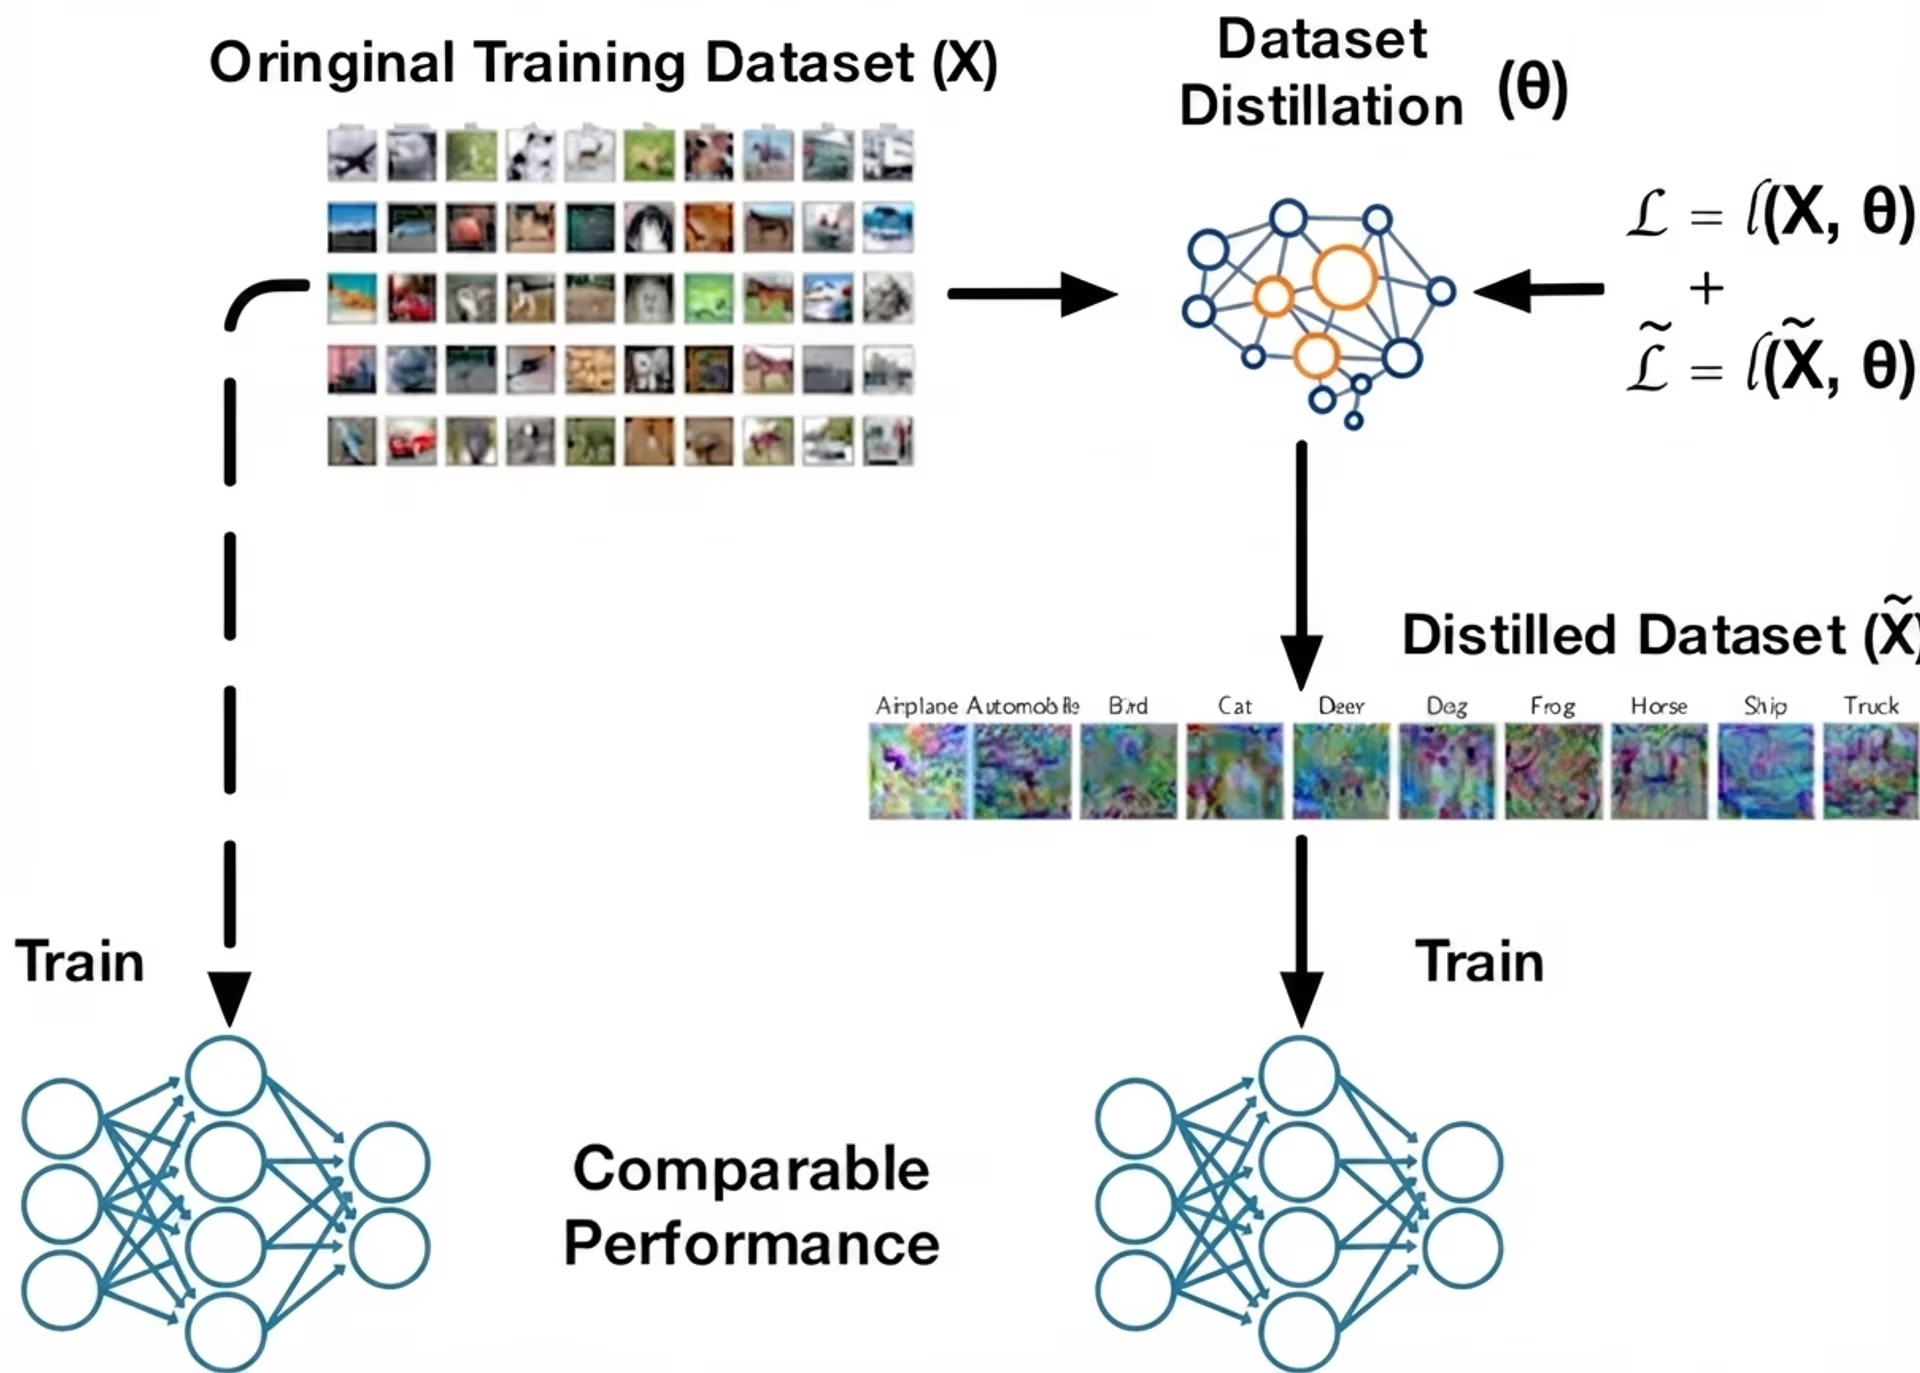
Fig. 2. Aperçu de la distillation de jeux de données (Source)
Principales méthodes de distillation de jeux de données#
Toutes les méthodes de distillation de jeux de données reposent sur la même idée fondamentale, même si elles utilisent des algorithmes différents. La plupart des approches se répartissent en trois catégories : l’appariement des performances, l’appariement des distributions et l’appariement des paramètres.
Examinons maintenant chacune de ces méthodes et leur fonctionnement.
Appariement des performances#
Dans la distillation de jeux de données, l’appariement des performances consiste à créer un minuscule jeu d’entraînement optimisé qui permet au modèle d’atteindre une précision presque identique à celle qu’il obtiendrait en étant entraîné sur le jeu de données d’origine complet. Au lieu de sélectionner un sous-ensemble aléatoire, les échantillons distillés sont optimisés pour qu’un modèle entraîné à partir de ces données obtienne des prédictions similaires, présente un comportement de perte similaire pendant l’entraînement ou atteigne une précision finale comparable à celle d’un modèle entraîné sur le jeu de données d’origine.
L’apprentissage méta est une méthode couramment utilisée pour améliorer ce processus. Le jeu de données distillé est mis à jour au cours d’épisodes d’entraînement répétés afin de devenir efficace dans de nombreuses situations possibles.
Au cours de ces épisodes, la méthode simule l’apprentissage d’un modèle étudiant à partir des échantillons distillés actuels, évalue ses performances sur des données réelles, puis ajuste les échantillons distillés pour qu’ils deviennent de meilleurs enseignants. Au fil du temps, le jeu distillé apprend à favoriser un apprentissage rapide et une forte capacité de généralisation, même si le modèle étudiant part de poids initiaux différents ou utilise une autre architecture. Le jeu de données distillé devient ainsi plus fiable et ne dépend pas d’un seul cycle d’entraînement.
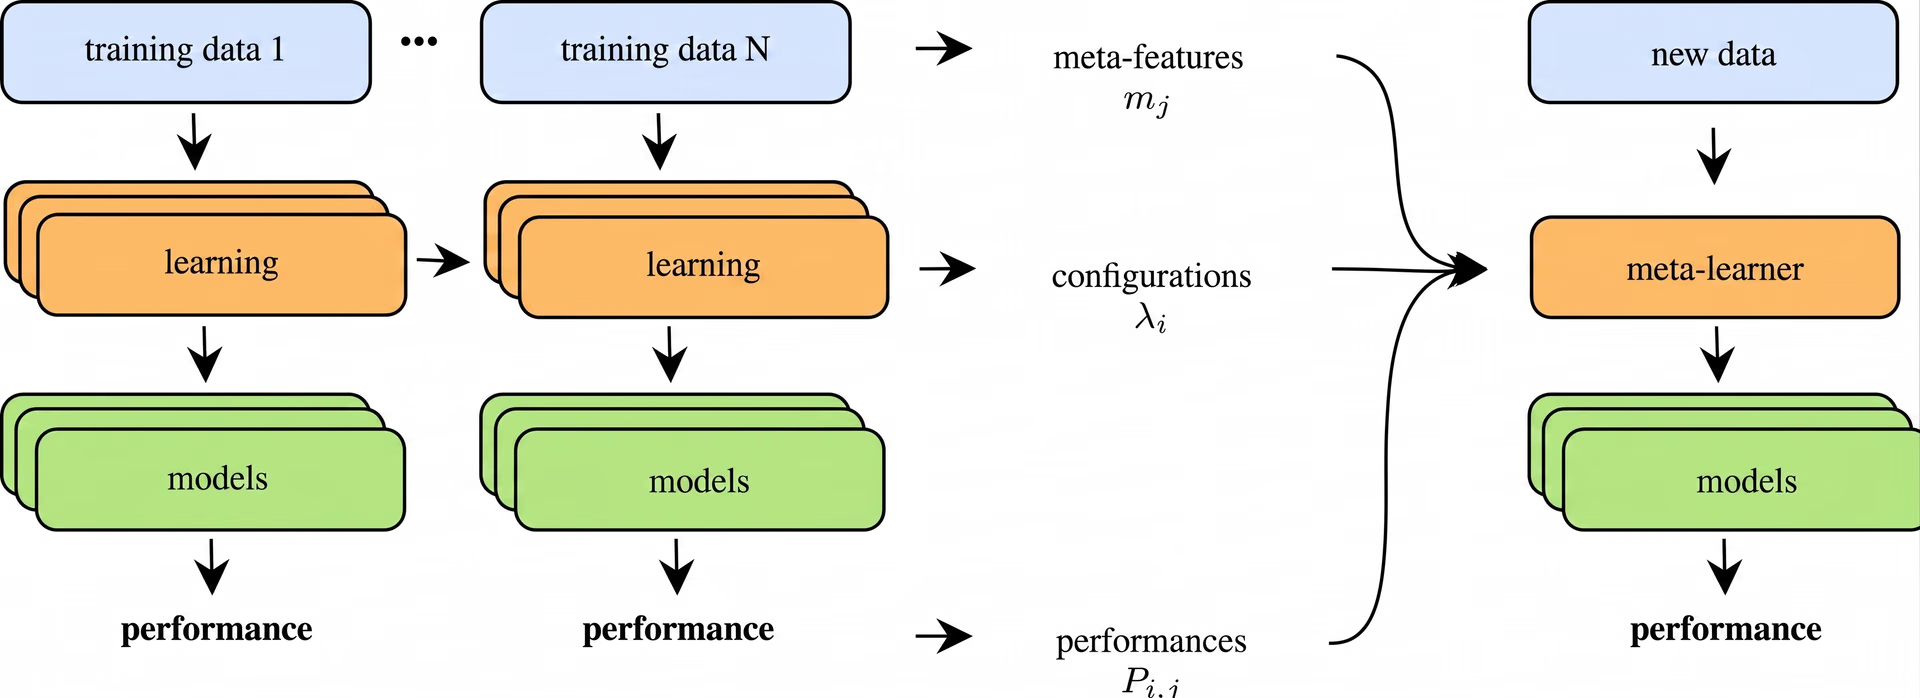
Fig. 3. Le processus d’apprentissage méta (Source)
Techniques d’appariement des distributions#
L’appariement des distributions génère des données synthétiques qui reproduisent les motifs statistiques du jeu de données réel. Au lieu de se concentrer uniquement sur la précision finale du modèle, cette approche s’intéresse aux caractéristiques internes produites par le réseau neuronal pendant l’apprentissage.
Examinons maintenant les deux techniques qui permettent l’appariement des distributions.
Appariement de distributions sur une seule couche#
L’appariement de distributions sur une seule couche se concentre sur une couche unique d’un réseau neuronal et compare les caractéristiques qu’elle produit pour les données réelles et synthétiques. Ces caractéristiques, également appelées activations, reflètent ce que le modèle a appris à ce stade du réseau.
En faisant produire aux données synthétiques des activations similaires, cette méthode incite le jeu de données distillé à reproduire les mêmes motifs importants que le jeu de données d’origine. En pratique, les échantillons synthétiques sont actualisés à plusieurs reprises jusqu’à ce que les activations de la couche choisie correspondent étroitement à celles des images réelles.
Cette approche est relativement simple, car elle n’aligne qu’un seul niveau de représentation à la fois. Elle peut être particulièrement efficace sur des jeux de données plus petits ou pour des tâches qui ne nécessitent pas d’apparier des hiérarchies de caractéristiques profondes et à plusieurs étapes. En alignant clairement un espace de caractéristiques, l’appariement sur une seule couche fournit un signal stable et pertinent pour l’apprentissage à partir du jeu de données distillé.
Appariement de distributions sur plusieurs couches#
L’appariement de distributions sur plusieurs couches reprend l’idée de comparer les données réelles et synthétiques, mais à plusieurs couches d’un réseau neuronal plutôt qu’à une seule. Les différentes couches saisissent différents types d’informations, des contours et textures simples des premières couches aux formes et motifs plus complexes des couches profondes.
En appariant les caractéristiques de ces couches, on amène le jeu de données distillé à refléter ce que le modèle apprend à plusieurs niveaux. Comme cette approche aligne les caractéristiques dans tout le réseau, elle aide les données synthétiques à préserver des signaux plus riches, sur lesquels le modèle s’appuie pour distinguer les classes.
C’est particulièrement utile en vision par ordinateur, c’est-à-dire pour les tâches où les modèles apprennent à interpréter des images et des vidéos, car les motifs utiles sont répartis sur de nombreuses couches. Lorsque les distributions de caractéristiques correspondent bien à plusieurs profondeurs, le jeu de données distillé constitue un substitut plus robuste et plus fiable aux données d’entraînement d’origine.
Méthodes d’appariement des paramètres#
L’appariement des paramètres constitue une autre catégorie importante de la distillation de jeux de données. Au lieu d’apparier la précision ou les distributions de caractéristiques, cette méthode apparie la façon dont les poids d’un modèle évoluent pendant l’entraînement. En faisant en sorte que l’entraînement sur le jeu de données distillé produise des mises à jour des paramètres similaires à celles obtenues avec les données réelles, le modèle suit un parcours d’apprentissage presque identique.
Nous allons maintenant passer en revue les deux principales méthodes d’appariement des paramètres.
Appariement en une étape#
L’appariement en une étape compare l’évolution des poids d’un modèle après une seule étape d’entraînement sur des données réelles. Le jeu de données distillé est ensuite ajusté afin qu’un modèle entraîné dessus pendant une étape produise une mise à jour des poids très similaire. Comme cette méthode se concentre uniquement sur cette mise à jour, elle est simple et rapide à exécuter.
L’inconvénient, c’est qu’une seule étape ne reflète pas l’ensemble du processus d’apprentissage, surtout pour les tâches difficiles où le modèle a besoin de nombreuses mises à jour pour construire des caractéristiques plus riches. L’appariement en une étape convient donc surtout aux problèmes plus simples ou aux jeux de données plus petits, où les motifs utiles peuvent être appris rapidement.
Appariement des paramètres sur plusieurs étapes#
À l’inverse, l’appariement des paramètres sur plusieurs étapes examine l’évolution des poids d’un modèle au fil de plusieurs étapes d’entraînement, et non d’une seule. Cette séquence de mises à jour constitue la trajectoire d’entraînement du modèle.
Le jeu de données distillé est conçu de sorte que, lorsqu’un modèle s’entraîne sur les échantillons synthétiques, sa trajectoire suive de près celle qu’il aurait suivie avec des données réelles. En faisant correspondre une plus longue phase d’apprentissage, le jeu distillé restitue davantage la structure du processus d’entraînement d’origine.
Comme cette méthode reflète le déroulement de l’apprentissage au fil du temps, l’appariement sur plusieurs étapes fonctionne généralement mieux avec des jeux de données plus grands ou plus complexes, pour lesquels les modèles ont besoin de nombreuses mises à jour afin d’apprendre des motifs utiles. Elle nécessite davantage de calculs, car elle doit suivre plusieurs étapes, mais elle produit souvent des jeux de données distillés qui généralisent mieux et offrent de meilleures performances que l’appariement en une étape.
Fonctionnement de la génération et de l’optimisation des jeux de données synthétiques#
Maintenant que nous comprenons mieux les principales approches de distillation, nous pouvons examiner la création des données synthétiques. Dans la distillation de jeux de données, les échantillons synthétiques sont optimisés pour conserver les signaux d’apprentissage les plus importants, afin qu’un petit ensemble puisse remplacer un jeu de données beaucoup plus grand.
Nous allons maintenant voir comment ces données distillées sont générées et évaluées.
Créer et évaluer des images distillées#
Pendant la distillation d’un jeu de données, les pixels synthétiques sont mis à jour au fil de nombreuses étapes d’entraînement. Le réseau neuronal apprend à partir des images synthétiques actuelles et renvoie des indications fondées sur le gradient, qui montrent comment chaque pixel doit changer pour mieux correspondre aux motifs du jeu de données réel.
Cela fonctionne parce que le processus est différentiable (c’est-à-dire que chaque étape est régulière et possède des gradients bien définis, de sorte que de petites modifications des pixels entraînent des changements prévisibles de la perte), ce qui permet au modèle d’ajuster progressivement les données synthétiques pendant la descente de gradient.
Au fil de l’optimisation, les images synthétiques commencent à prendre une structure pertinente, notamment des formes et des textures reconnues par le modèle. Ces images synthétiques affinées sont souvent utilisées pour des tâches de classification d’images, car elles capturent les principaux indices visuels qu’un classificateur doit apprendre.
Pour évaluer les jeux de données distillés, on entraîne des modèles avec ceux-ci et on compare les résultats à ceux de modèles entraînés sur des données réelles. Les chercheurs mesurent la précision sur l’ensemble de validation et vérifient si le jeu synthétique préserve les caractéristiques discriminantes (les motifs ou signaux sur lesquels le modèle s’appuie pour distinguer les classes) nécessaires à la séparation des classes. Ils testent également la stabilité et la capacité de généralisation lors de différents entraînements ou configurations de modèles, afin de s’assurer que les données distillées ne provoquent pas de surapprentissage.
Applications de la distillation de données dans le monde réel#
Nous allons maintenant examiner des exemples montrant comment les jeux de données distillés accélèrent l’entraînement et réduisent les coûts de calcul tout en maintenant de bonnes performances, même lorsque les données sont limitées ou très spécialisées.
Utiliser la distillation de jeux de données pour les applications de vision par ordinateur#
En vision par ordinateur, l’objectif est d’entraîner des modèles à interpréter des données visuelles comme les images et les vidéos. Ces modèles apprennent des motifs tels que les contours, les textures, les formes et les objets, puis les exploitent pour des tâches comme la classification d’images, la détection d’objets ou la segmentation. Comme les problèmes de vision présentent souvent de grandes variations d’éclairage, d’arrière-plans et de points de vue, les systèmes de vision par ordinateur ont généralement besoin de vastes jeux de données pour bien généraliser, ce qui rend l’entraînement coûteux et lent.
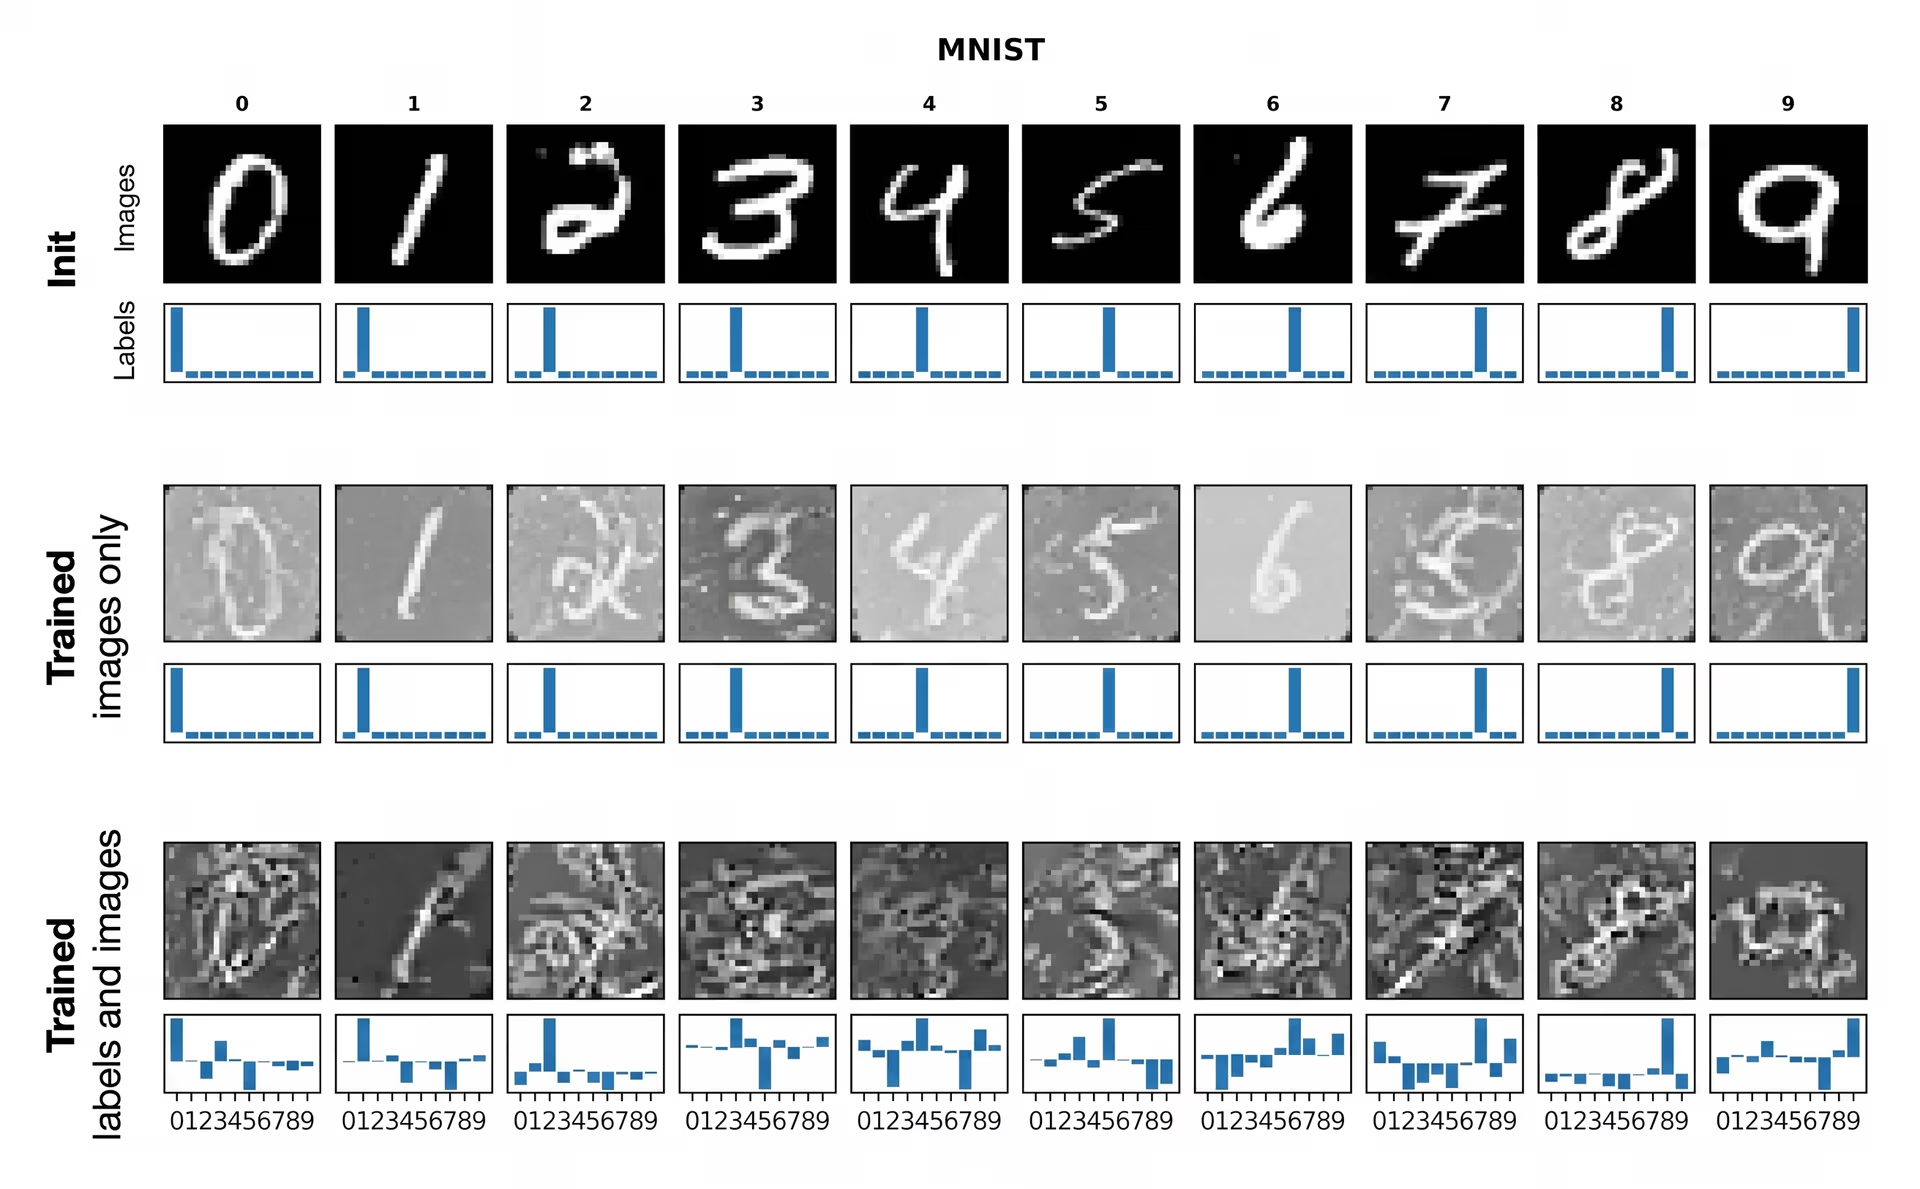
Fig. 4. Un exemple de distillation de jeu de données (Source)
Pour des cas d’utilisation de la classification d’images comme l’analyse d’imagerie médicale, le suivi de la faune ou la détection de défauts en usine, les modèles doivent souvent trouver un difficile équilibre entre précision et coût d’entraînement. Ces tâches impliquent généralement des jeux de données massifs.
La distillation de jeux de données peut compresser le jeu d’entraînement d’origine en un petit nombre d’images synthétiques qui conservent les indices visuels les plus importants pour le classificateur. Sur de grands jeux de référence comme ImageNet, il a été démontré que des jeux distillés utilisant seulement environ 4,2 % des images d’origine maintiennent une bonne précision de classification. Un minuscule jeu synthétique de substitution peut ainsi remplacer des millions d’échantillons réels en nécessitant beaucoup moins de calculs.
Recherche d’architectures neuronales#
La recherche d’architecture neuronale, ou NAS, est une technique qui explore automatiquement de nombreuses architectures de réseaux neuronaux possibles afin de trouver celle qui convient le mieux à une tâche. Comme la NAS doit entraîner et évaluer un grand nombre de modèles candidats, l’exécuter sur des jeux de données complets peut être lent et très exigeant en calcul.
La distillation de jeux de données aide en créant un minuscule jeu d’entraînement synthétique qui conserve le principal signal d’apprentissage des données d’origine, afin que chaque architecture candidate puisse être testée beaucoup plus rapidement. La NAS peut ainsi comparer efficacement les architectures tout en conservant une fiabilité raisonnable du classement des bonnes et des mauvaises architectures, ce qui réduit le coût de la recherche sans trop nuire à la qualité finale du modèle.
Apprentissage continu et déploiement en périphérie#
Les systèmes d’apprentissage continu, c’est-à-dire les modèles qui continuent d’évoluer à mesure que de nouvelles données arrivent au lieu d’être entraînés une seule fois, ont besoin de mises à jour rapides et économes en mémoire. Les appareils en périphérie, comme les caméras, les téléphones et les capteurs, sont soumis à des contraintes similaires en raison de leurs ressources de calcul et de stockage limitées.
La distillation de jeux de données est utile dans les deux cas : elle compresse un grand jeu d’entraînement en un minuscule jeu synthétique, ce qui permet aux modèles de s’adapter ou de se réentraîner à l’aide d’un petit ensemble de rejeu plutôt que du jeu de données complet. Par exemple, des travaux sur le méta-apprentissage à noyaux ont montré que seulement 10 échantillons distillés peuvent atteindre une précision supérieure à 64 % sur CIFAR-10, un jeu de référence standard pour la classification d’images. Grâce à la compacité de l’ensemble de rejeu, les mises à jour sont beaucoup plus rapides et pratiques, surtout lorsque les modèles doivent être actualisés fréquemment.
La distillation de jeux de données peut également être associée à la distillation de connaissances pour les grands modèles de langage. Un petit jeu de données distillé peut conserver les signaux de tâche les plus importants du modèle enseignant, afin d’entraîner ou de mettre à jour plus efficacement un modèle étudiant compressé sans trop perdre en performances. Ces jeux de données étant minuscules, ils sont particulièrement utiles pour les appareils en périphérie ou les usages locaux, où le stockage et la puissance de calcul sont limités, mais où tu souhaites que le modèle reste précis après les mises à jour.
Avantages et inconvénients de la distillation de données#
Voici quelques avantages de la distillation de jeux de données :
- Idéale pour les expérimentations rapides. Tu peux tester de nouvelles architectures, fonctions de perte ou hyperparamètres sans réentraîner un modèle sur un énorme jeu de données à chaque fois.
- Avantage potentiel pour la confidentialité. Partager des échantillons synthétiques distillés peut être plus sûr que partager de véritables données utilisateur, puisque les exemples bruts ne sont pas directement exposés.
- Souvent plus efficace qu’une simple sélection de sous-ensemble. Au lieu de sélectionner uniquement des exemples, la distillation les optimise activement pour maximiser leur pouvoir informatif.
Bien que la distillation de jeux de données présente plusieurs avantages, voici quelques limites à garder à l’esprit :
- Surapprentissage. Les données distillées donnent souvent les meilleurs résultats avec l’architecture utilisée lors de la distillation et peuvent mal se transférer à des modèles très différents.
- Sensibilité aux hyperparamètres. Les résultats peuvent beaucoup dépendre de facteurs comme le taux d’apprentissage, l’initialisation ou le nombre d’étapes de distillation.
- Difficulté à passer à l’échelle de la complexité du monde réel. Les méthodes qui fonctionnent bien sur des jeux de référence peuvent perdre en précision sur des jeux de données volumineux, hétérogènes ou à haute résolution.
Points clés à retenir#
La distillation de jeux de données permet à un petit ensemble d’échantillons synthétiques d’apprendre à un modèle presque aussi efficacement qu’un jeu de données complet. L’apprentissage automatique devient ainsi plus rapide, plus efficace et plus facile à mettre à l’échelle. À mesure que les modèles grandissent et nécessitent davantage de données, les jeux de données distillés offrent un moyen pratique de réduire les coûts de calcul sans sacrifier la précision.
Rejoins notre communauté et consulte notre dépôt GitHub pour en savoir plus sur l’IA. Si tu souhaites créer ton propre projet d’IA visuelle, consulte nos options de licence. Découvre des applications comme l’IA dans le secteur de la santé et l’IA visuelle dans le commerce de détail en consultant nos pages de solutions.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









