RAGとコンピュータービジョンによるAIアプリケーションの強化
検索拡張生成(RAG)とコンピュータービジョンの組み合わせが、AIシステムによる文書、ビジュアル情報、複雑な実世界のコンテンツの解釈にどのように役立つかをご紹介します。
ChatGPTやGeminiなどのAIツールを使って情報を探すことが、急速に一般的になっています。メッセージの下書き、文書の要約、質問への回答など、こうしたツールはより速く簡単な解決策を提供することがよくあります。
しかし、大規模言語モデル(LLMs)を何度か使ったことがあれば、その限界に気づいたことでしょう。非常に具体的な質問や、最新情報が必要な質問をすると、誤った回答を自信ありげに返すことがあります。
これは、単独のLLMがトレーニングに使われたデータだけに依存しているためです。そのデータセットを超える最新情報や専門知識にはアクセスできません。その結果、回答が古かったり、不正確だったりすることがあります。
この問題の解決に向けて、研究者たちは検索拡張生成(RAG)という手法を開発しました。RAGは、質問への回答時に信頼できる情報源から新しく関連性の高い情報を取得できるようにすることで、言語モデルの機能を強化します。
この記事では、RAGの仕組みと、関連性の高い最新情報を取得することでAIツールをどのように強化するかを解説します。また、視覚データの解釈に重点を置く人工知能の分野であるコンピュータービジョンとRAGを組み合わせ、システムがテキストだけでなく、画像、レイアウト、視覚的に複雑な文書も理解できるようにする方法も紹介します。
検索拡張生成(RAG)を理解する#
AIチャットボットに質問するとき、私たちは単に聞こえのよい回答以上のものを期待します。理想的な回答は、明確で正確であり、本当に役立つものです。そのためには、AIモデルには言語能力だけでなく、適切な情報へのアクセスも必要です。特に、具体的な話題や最新情報が求められる話題では重要です。
RAGは、このギャップを埋める手法です。言語モデルのテキストを理解して生成する能力と、外部ソースから関連情報を取得する機能を組み合わせます。モデルはトレーニングデータだけに依存するのではなく、回答を作成する際に、信頼できるナレッジベースから補足情報を積極的に取得します。
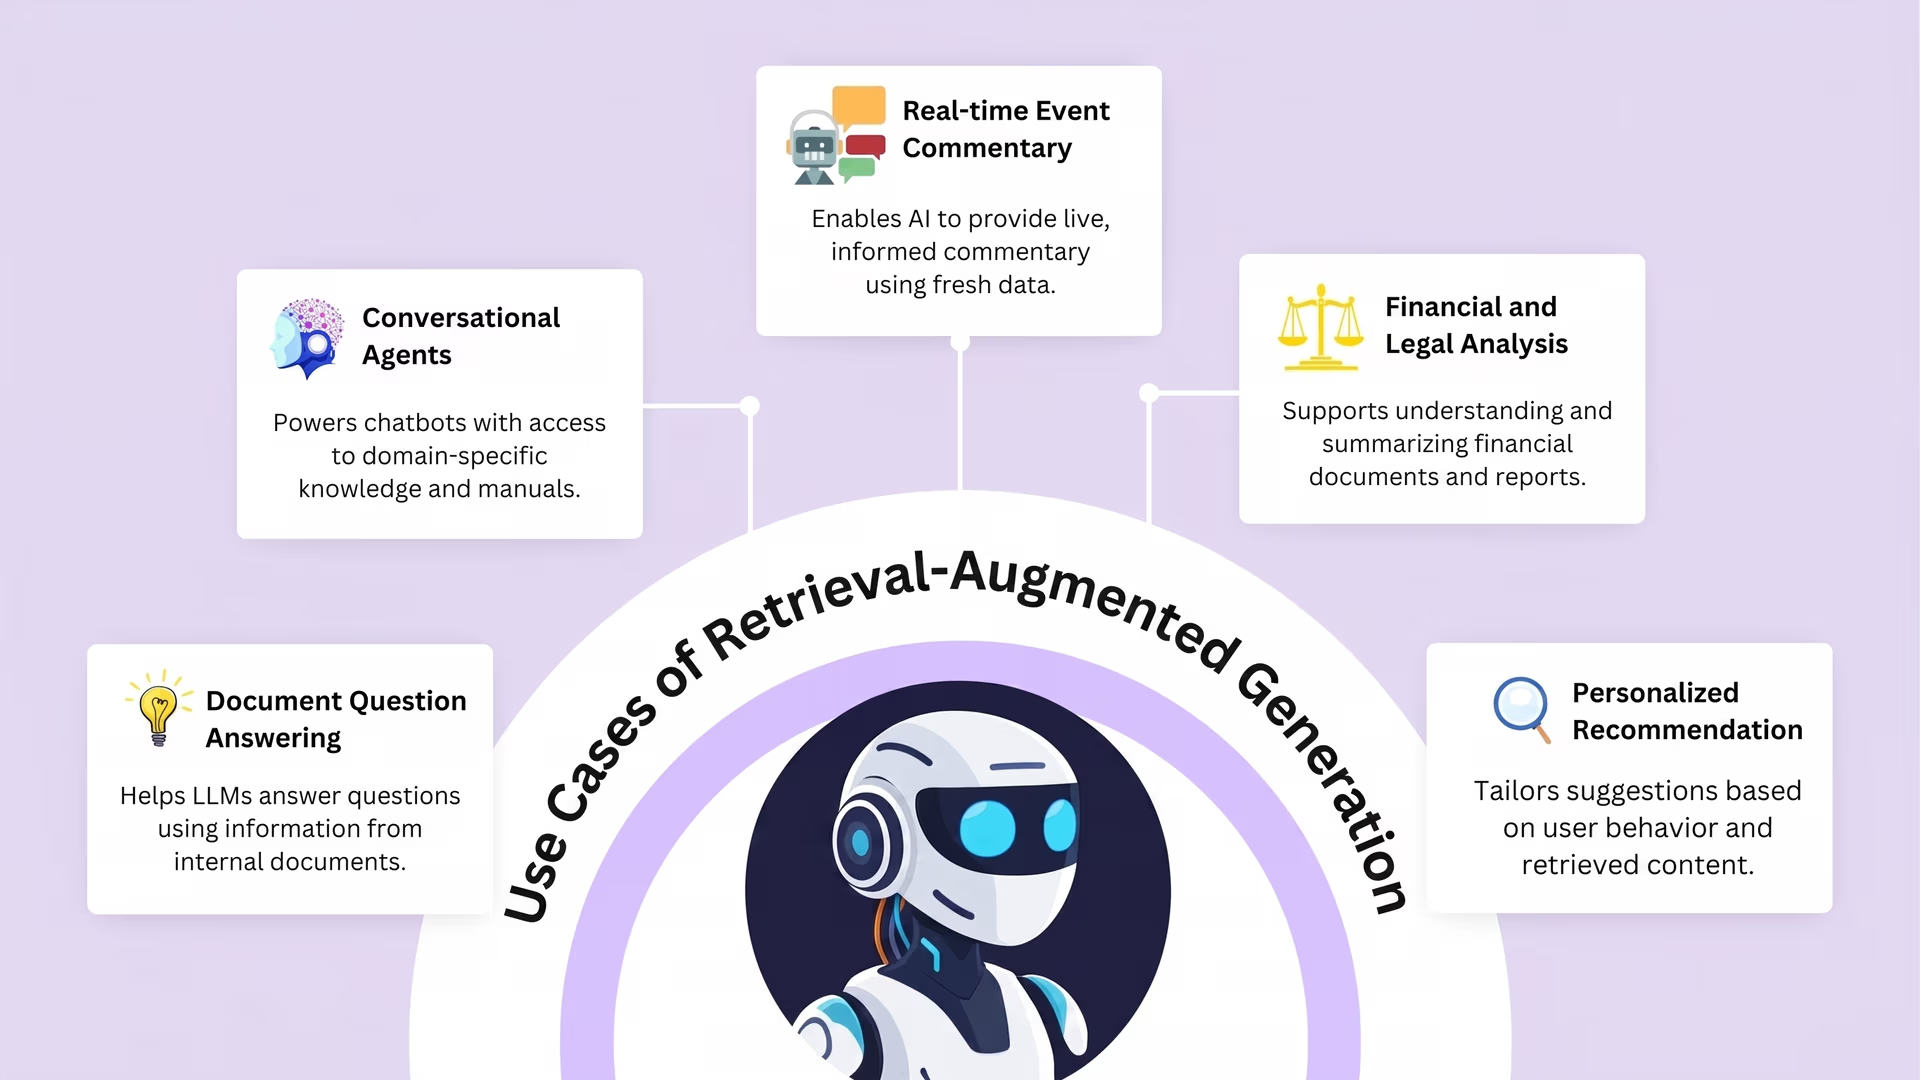
図1. RAGの主なユースケース。画像:著者。
質問を受けた人が、回答する前に信頼できる資料を確認する場面を想像するとよいでしょう。その人は自分の言葉で回答しますが、最も関連性が高く最新の情報に基づいています。
このアプローチにより、LLMはユーザーの質問に合わせた、より完全で正確な回答を返せるようになります。正確さが本当に重要となる実環境のアプリケーションで、LLMの信頼性が大幅に高まります。
RAGの仕組みを見る#
RAGは、検索と生成という2つの重要なステップを導入することで、大規模言語モデルの回答方法を強化します。まず、外部のナレッジベースから関連情報を検索します。次に、その情報を使って、適切に構成された文脈に沿った回答を生成します。
このプロセスの仕組みを理解するため、簡単な例を見てみましょう。AIアシスタントを使って個人の家計を管理しており、今月の支出が目標の範囲内だったかを確認したいとします。
「今月は予算を守れましたか?」といった質問をアシスタントにすると、プロセスが始まります。システムはトレーニング中に学習した内容だけに頼るのではなく、検索機能を使って直近の家計記録(銀行明細や取引の概要など)を調べます。質問の意図を理解し、最も関連性の高い情報を収集します。
情報が検索されると、言語モデルが処理を引き継ぎます。質問と記録から取得したデータの両方を処理し、明確で役立つ回答を生成します。生の詳細を列挙するのではなく、支出を要約して、目標を達成できたかどうかを確認し、主な支出項目を指摘するなど、直接的で意味のある洞察を提供します。
このアプローチにより、LLMは正確な回答を返すだけでなく、実際の最新情報に基づいた回答を提供できます。そのため、静的なトレーニングデータだけを使うモデルよりも、はるかに有用な体験を実現できます。
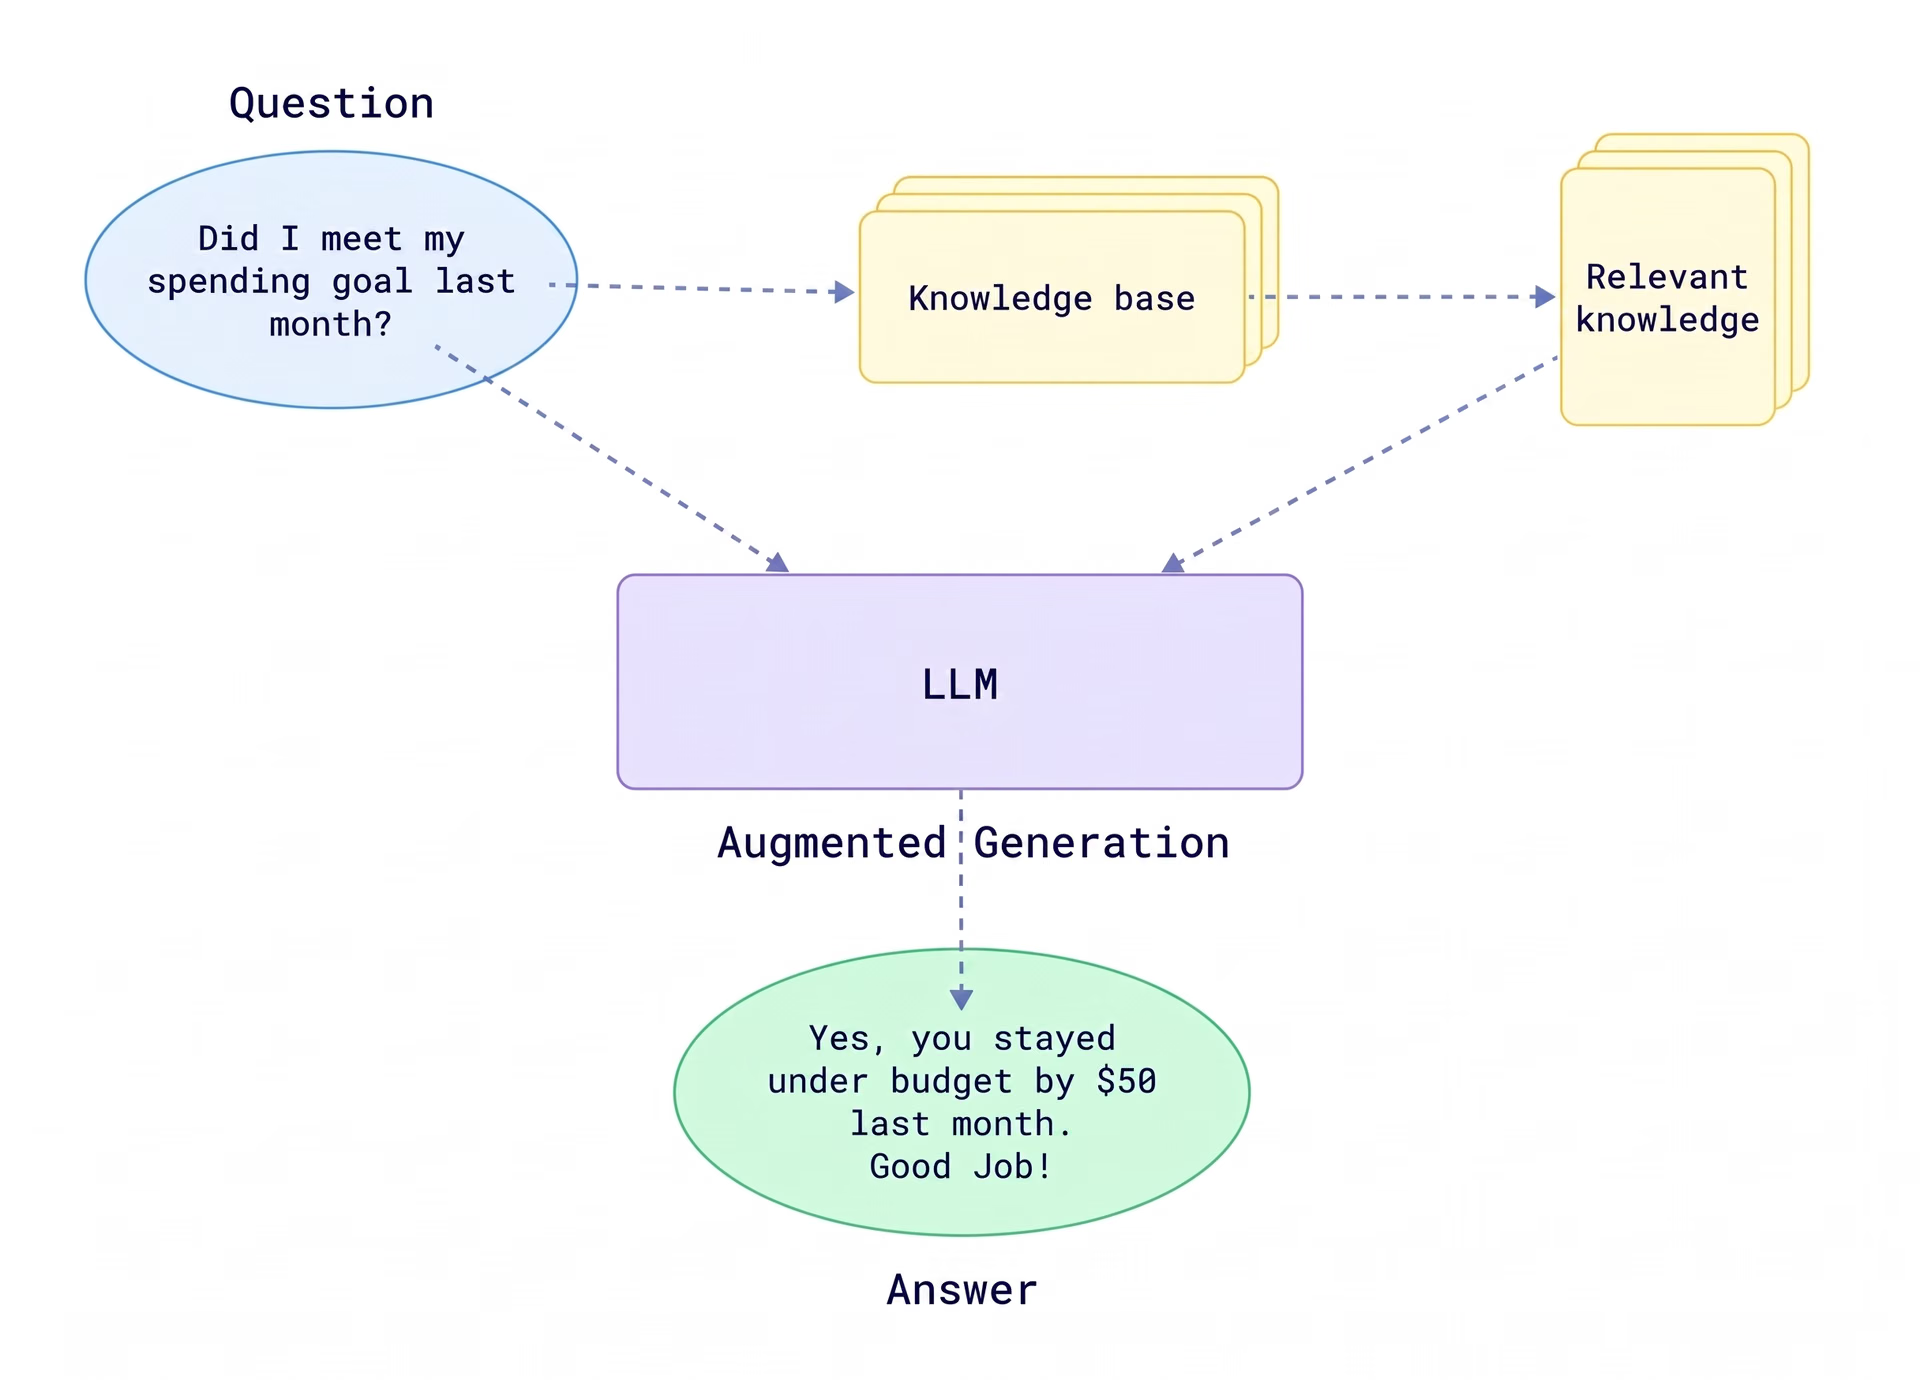
図2. RAGの仕組みを理解する。
マルチモーダルRAGシステムの必要性#
情報は必ずしもプレーンテキストで共有されるとは限りません。医療画像や図から、プレゼンテーションスライドやスキャン文書まで、視覚情報には重要な詳細が含まれていることがよくあります。主にテキストの読み取りと理解を目的に構築された従来のLLMは、この種のコンテンツの処理が苦手な場合があります。
しかし、RAGをコンピュータービジョンと組み合わせることで、このギャップを埋められます。この2つを組み合わせたものは、マルチモーダルRAGシステムと呼ばれ、テキストと視覚情報の両方を処理できるため、AIチャットボットがより正確で完全な回答を提供できるようになります。
このアプローチの中核となるのは、両方の種類の入力を処理し、推論するように設計された視覚言語モデル(VLMs)です。この構成では、RAGが大規模なデータソースから最も関連性の高い情報を検索し、コンピュータービジョンを活用するVLMが画像、レイアウト、図を解釈します。
これは、スキャンされたフォーム、医療レポート、プレゼンテーションスライドなど、重要な詳細がテキストと視覚情報の両方に含まれる実際の文書で特に役立ちます。たとえば、画像と表、段落を含む文書を分析する場合、マルチモーダルシステムは視覚要素を抽出し、その内容の要約を生成して、周囲のテキストと組み合わせることで、より完全で役立つ回答を提供できます。
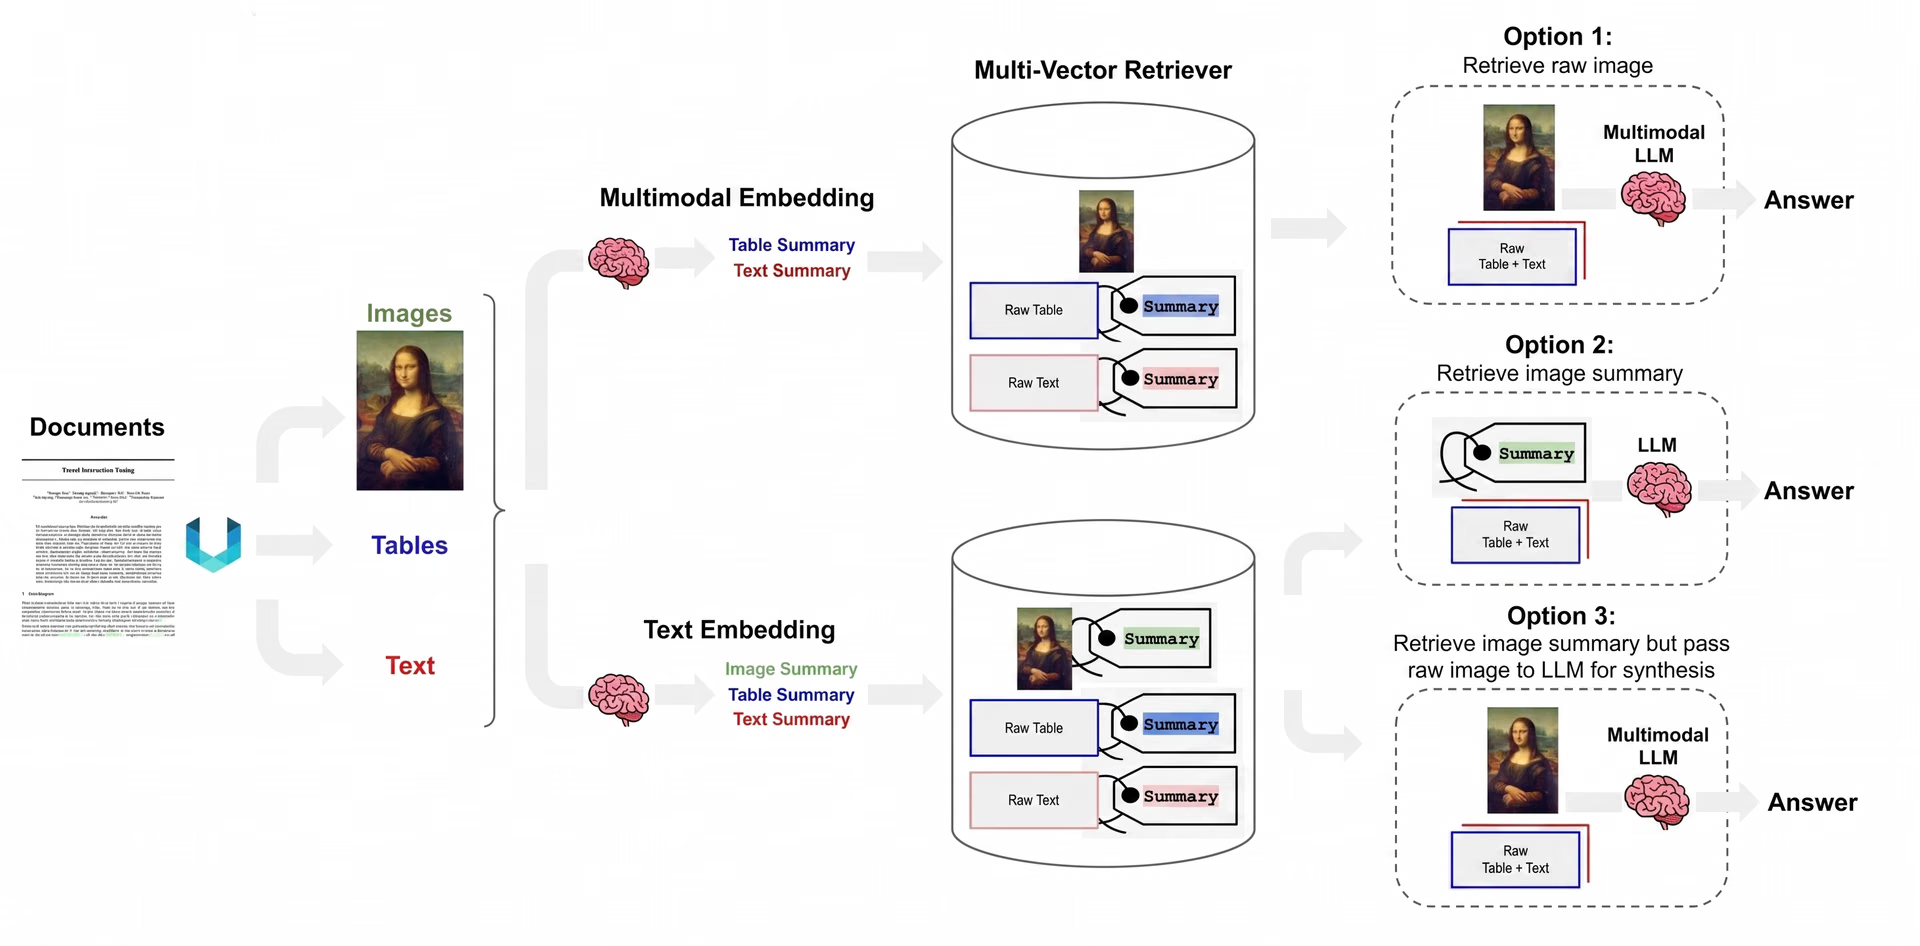
図3. マルチモーダルRAGは画像とテキストを使って、より良い回答を提供します。
視覚データに対するRAGの活用例#
RAGとは何か、コンピュータービジョンとどのように連携するかを説明したところで、このアプローチの活用例を示す実世界の事例や研究プロジェクトを見てみましょう。
VisRAGで視覚的な文書を理解する#
財務レポートやスキャンされた法的文書から洞察を得ようとしているとします。こうしたファイルにはテキストだけでなく、情報の説明に役立つ表、グラフ、レイアウトが含まれていることがよくあります。一般的な言語モデルでは、こうした視覚要素が見落とされたり、誤って解釈されたりして、不完全または不正確な回答につながる可能性があります。
VisRAGは、この課題に対処するために研究者によって開発されました。テキストだけを処理するのではなく、各ページを画像として扱うVLMベースのRAGパイプラインです。これにより、システムはコンテンツと視覚的な構造の両方を理解できます。その結果、最も関連性の高い部分を見つけ、文書全体の文脈に基づいた、より明確で正確な回答を提供できます。
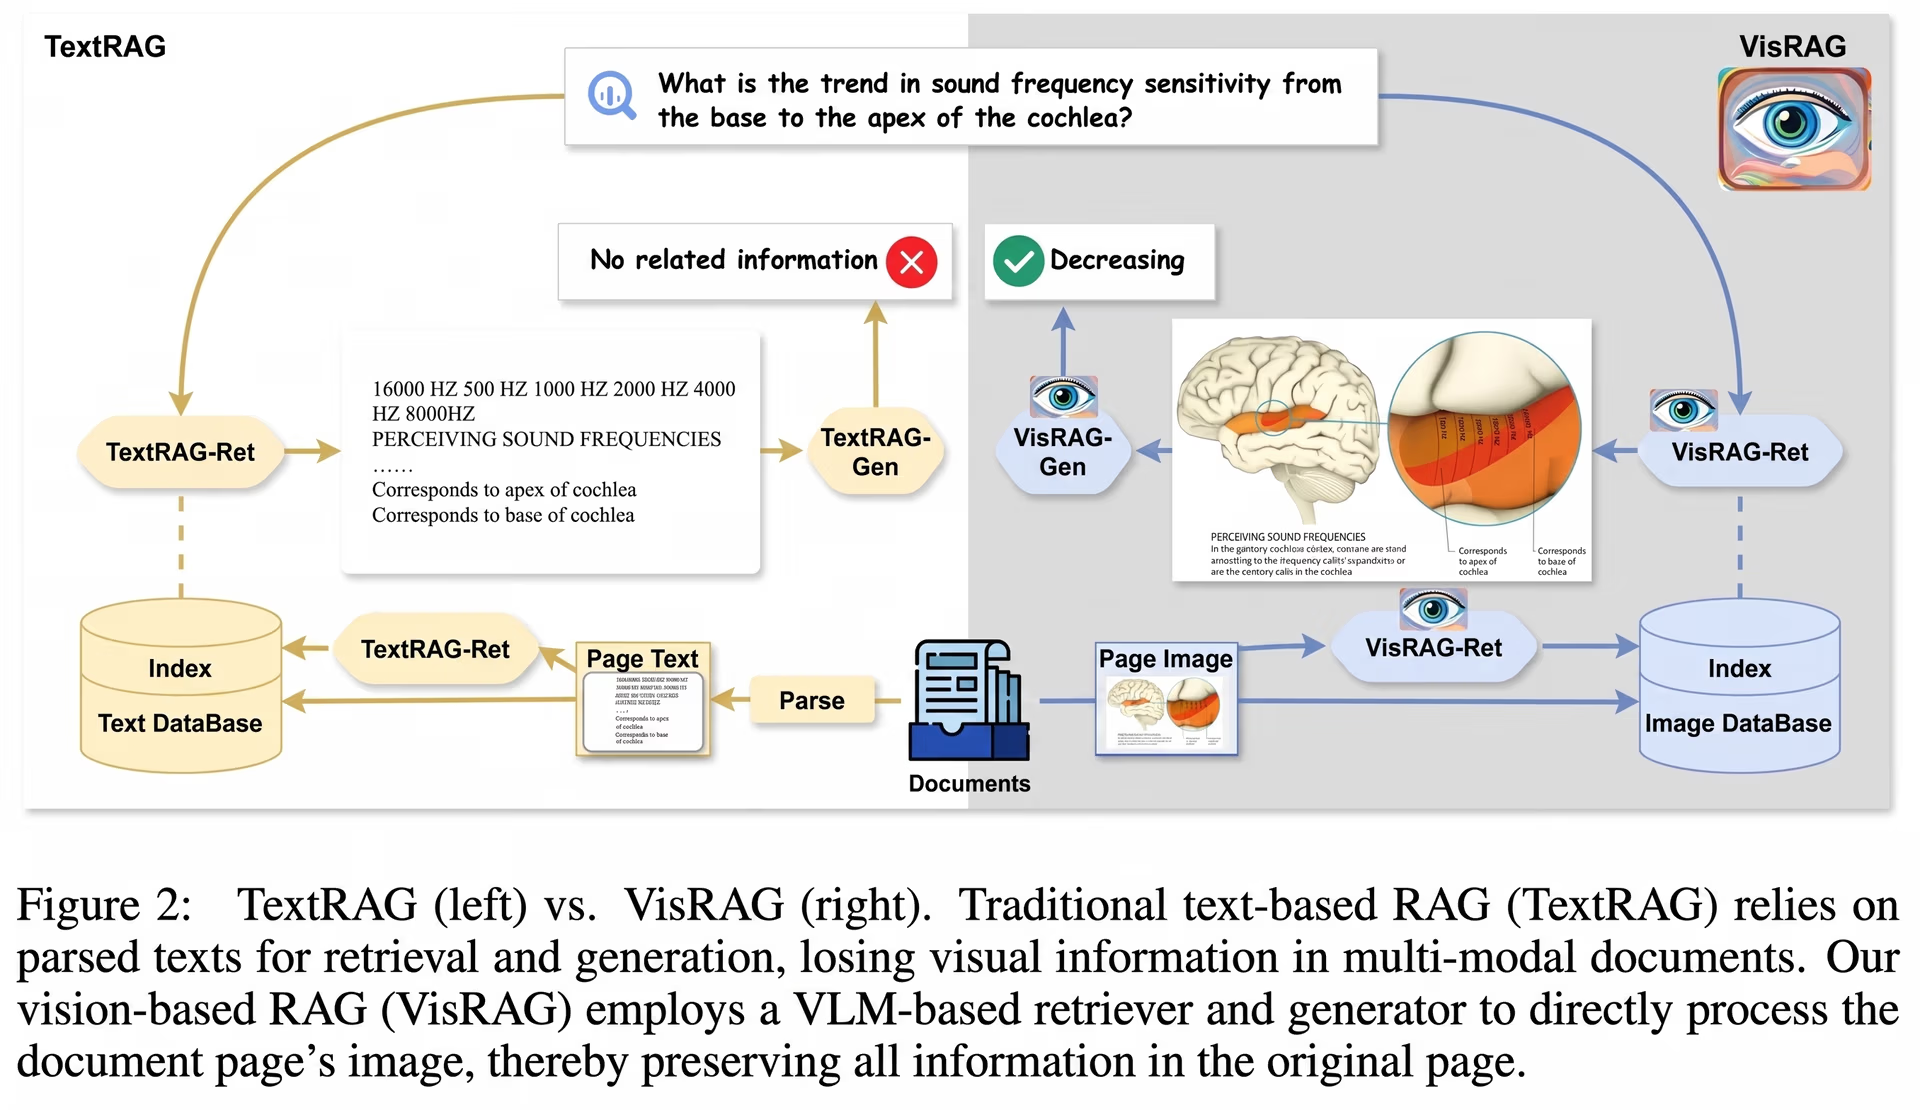
図4. VisRAGは文書を画像として読み取り、テキストコンテンツとレイアウトを捉えられます。
RAGを使った視覚的な質問応答#
視覚的な質問応答(VQA)は、AIシステムが画像に関する質問に回答するタスクです。既存のVQAシステムの多くは、追加情報を検索する必要がない、単一の文書に関する質問への回答に重点を置いています。これはクローズド設定と呼ばれます。
VDocRAGは、より現実的なアプローチを採用したRAGフレームワークです。VQAに、まず関連文書を検索する機能を統合しています。ユーザーの質問が複数ある文書のいずれかに関係し、回答前に適切な文書を見つける必要がある実世界の状況で役立ちます。そのために、VDocRAGはVLMを使って文書を画像として分析し、テキストと視覚的な構造の両方を保持します。
このため、VDocRAGはエンタープライズ検索、文書の自動化、カスタマーサポートなどのアプリケーションで特に効果を発揮します。レイアウトの理解が文章の読み取りと同じくらい重要となるマニュアルやポリシー文書など、視覚的に複雑な文書から、チームがすばやく回答を抽出できるよう支援します。
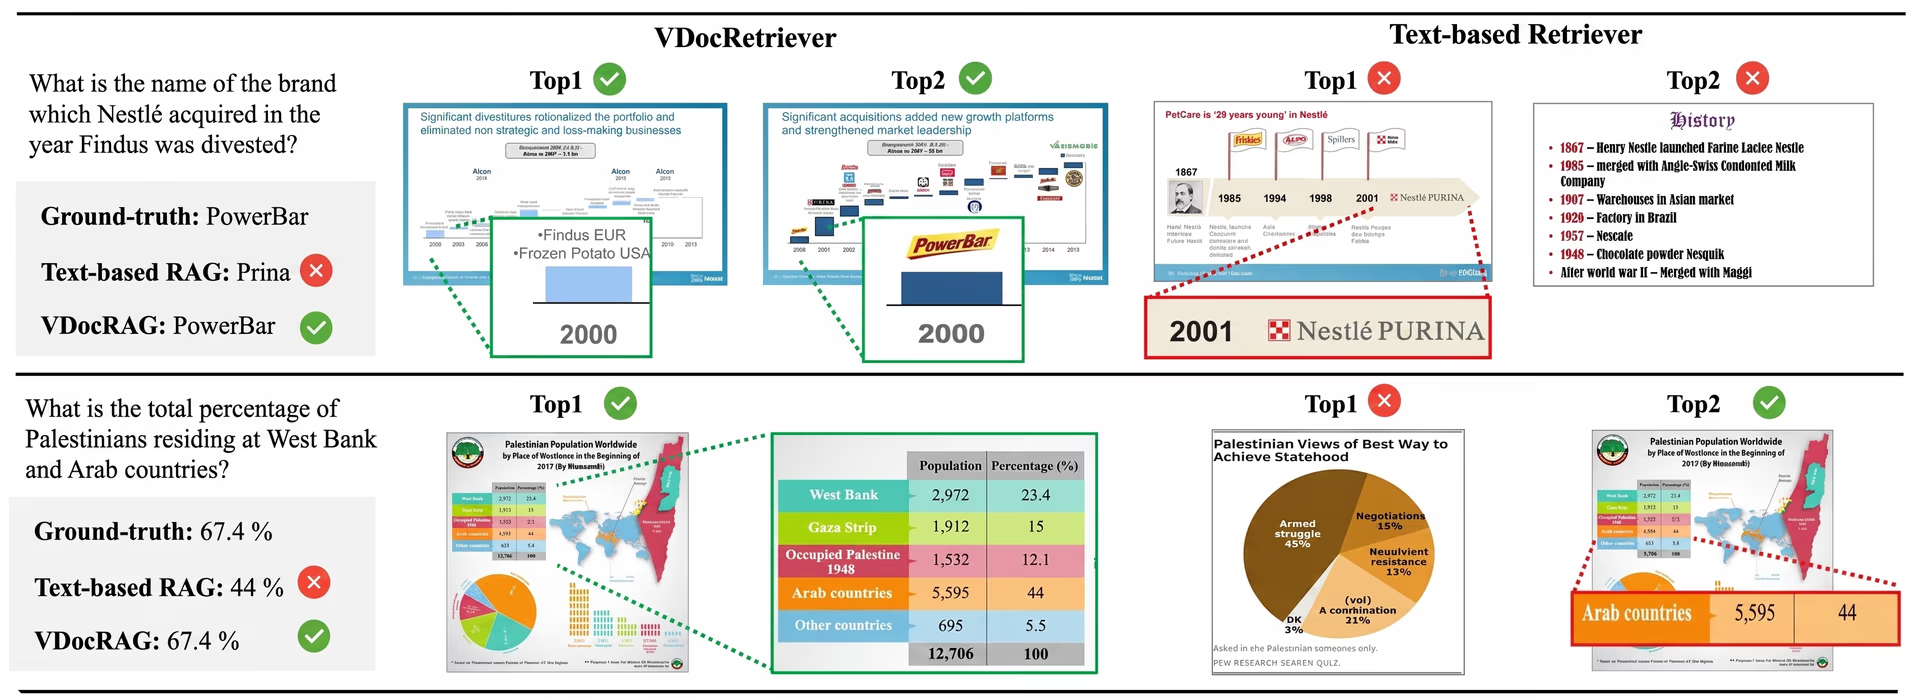
図5. VDocRAGとLLMベースのソリューションの違い。
RAGによる画像キャプション生成の改善#
画像キャプション生成では、画像内で起きていることを文章で説明します。オンラインコンテンツのアクセシビリティ向上から、画像検索の実現、コンテンツモデレーションやレコメンデーションシステムの支援まで、幅広い用途で使われています。
しかし、AIモデルが常に正確なキャプションを生成できるとは限りません。特に、画像にモデルのトレーニング時とは異なるものが写っている場合は困難です。多くのキャプション生成システムはトレーニングデータに大きく依存しているため、見慣れないシーンに直面すると、曖昧または不正確なキャプションを生成することがあります。
この課題に対処するため、研究者たちは検索拡張生成(RAG)を画像キャプション生成に取り入れた手法であるRe-ViLMを開発しました。Re-ViLMはキャプションをゼロから生成するのではなく、データベースから類似した画像とテキストのペアを検索し、そのペアをキャプション生成の指針として使います。
この検索ベースのアプローチは、関連する例に基づいた説明をモデルが生成できるようにし、精度と流暢さの両方を向上させます。初期の結果では、実際の例を使うことでRe-ViLMがより自然で文脈に沿ったキャプションを生成し、曖昧または不正確な説明を減らせることが示されています。
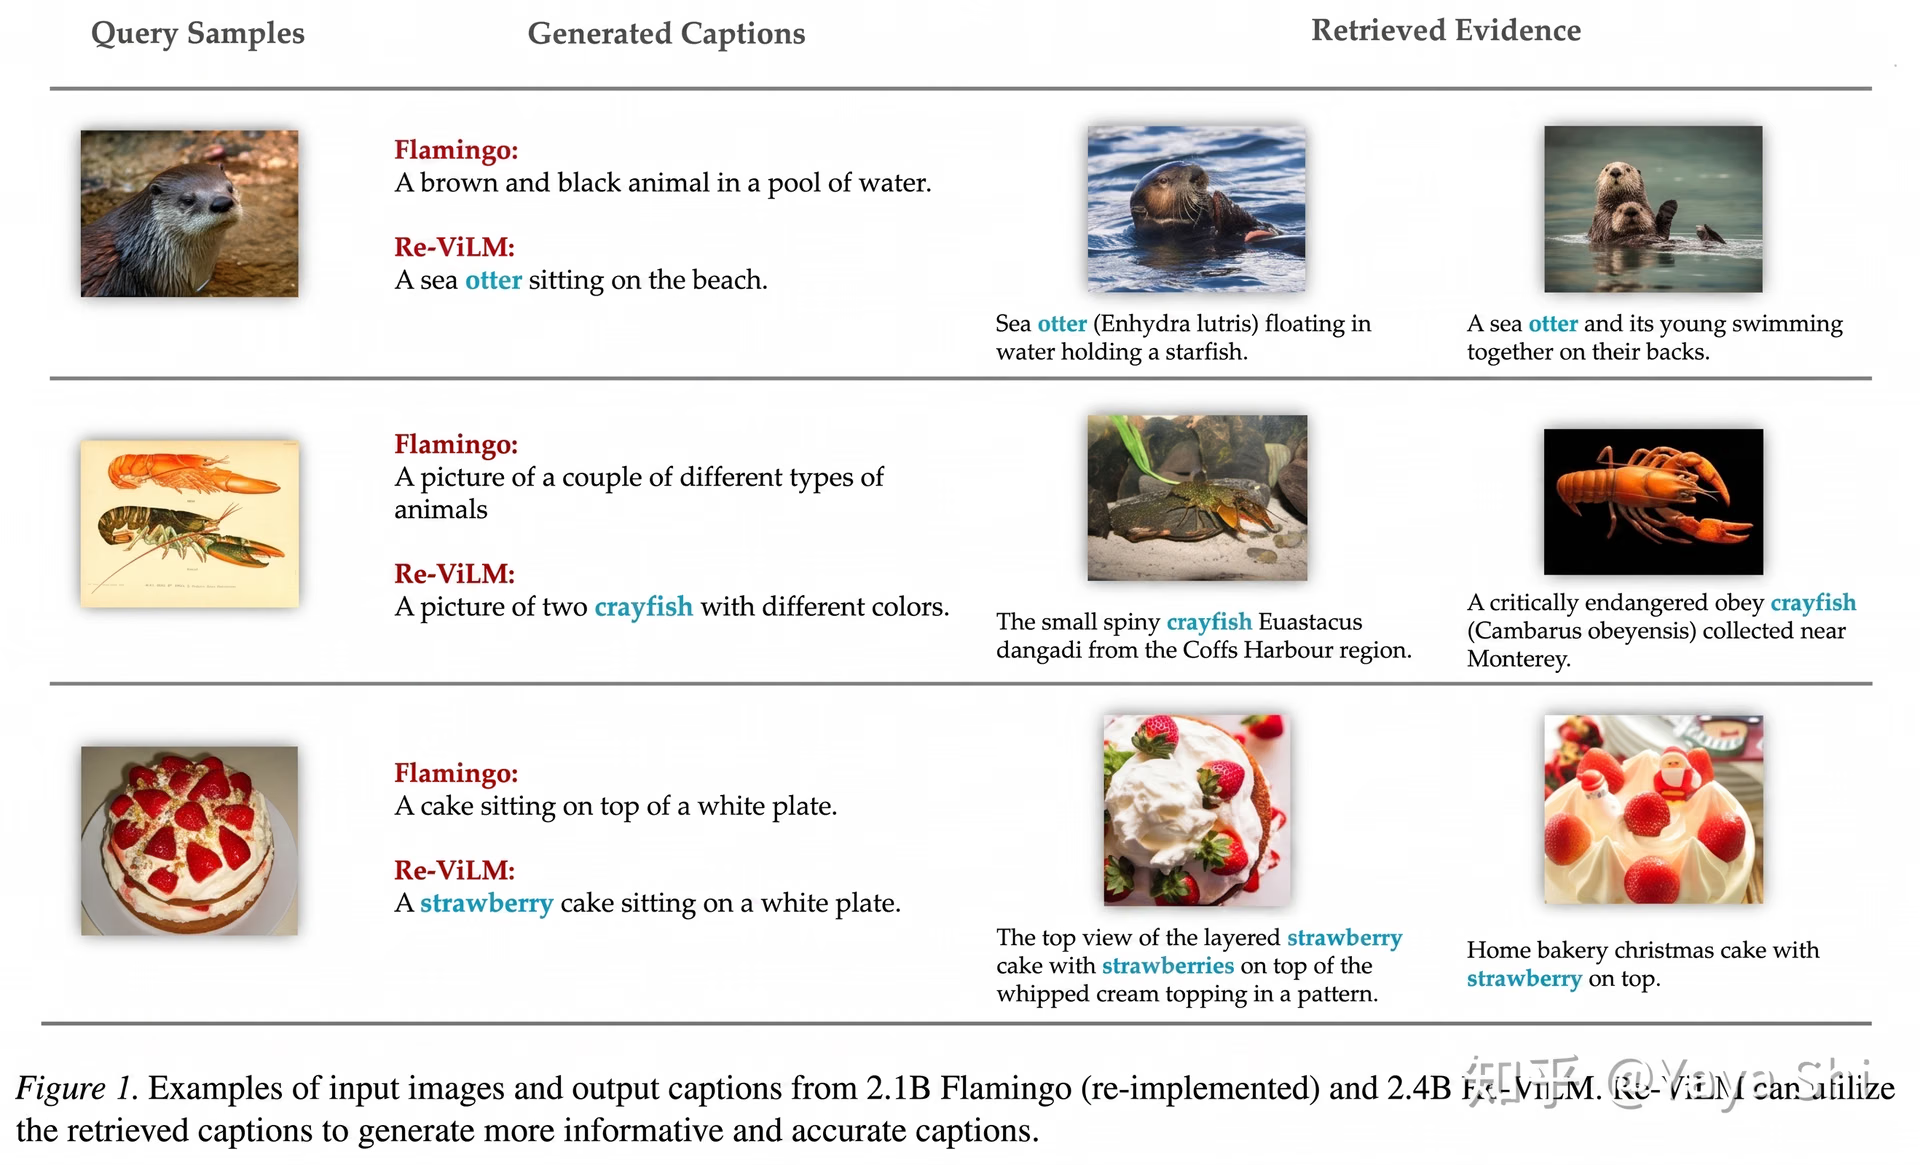
図6. Re-ViLMは視覚と言語の例を検索して、画像キャプションを改善します。
視覚データの理解にRAGを使うメリットとデメリット#
視覚情報を検索して活用する検索拡張生成の手法には、次のような利点があります。
- 要約機能の強化:要約には、テキストだけでなく、グラフの傾向やインフォグラフィックの要素など、視覚情報から得られる洞察も取り入れられます。
- 検索と取得の堅牢性向上:検索ステップでは、画像ベースの理解を使うことで、テキストにキーワードが含まれていなくても関連する視覚的なページを特定できます。
- スキャン文書、手書き文書、画像ベースの文書への対応:VLMを活用するRAGパイプラインは、テキストのみを扱うモデルでは読み取れないコンテンツを処理できます。
こうした利点がある一方で、視覚データを扱う際にRAGを使用するには、いくつかの制約も考慮する必要があります。主なものを紹介します。
- 高い計算要件:画像とテキストの両方を分析するには、より多くのメモリと処理能力が必要となるため、パフォーマンスが低下したり、コストが増加したりする可能性があります。
- データプライバシーとセキュリティ上の懸念:視覚的な文書には、特に医療や金融などの分野で機密情報が含まれている可能性があり、検索や処理のワークフローが複雑になります。
- 推論時間の増加:視覚処理によって複雑さが増すため、テキストのみのシステムと比較して回答の生成に時間がかかることがあります。
重要なポイント#
検索拡張生成は、大規模言語モデルが外部ソースから関連性の高い最新情報を取得できるようにすることで、質問への回答方法を改善しています。コンピュータービジョンと組み合わせると、こうしたシステムはテキストだけでなく、グラフ、表、画像、スキャン文書などの視覚的なコンテンツも処理できるため、より正確でバランスの取れた回答が可能になります。
このアプローチにより、複雑な文書を扱う実世界のタスクにLLMをより適したものにできます。検索と視覚理解を組み合わせることで、さまざまな形式をより効果的に解釈し、日常の実用的な場面でさらに役立つ洞察を提供できます。
成長を続けるコミュニティに参加しましょう!GitHubリポジトリでAIについてさらに詳しくご覧ください。独自のコンピュータービジョンプロジェクトを始めませんか?ライセンスオプションをご確認ください。ソリューションページでは、医療分野のAIや小売業におけるコンピュータービジョンについて詳しく紹介しています!








