Ultralytics Platformによるコンピュータービジョンのスマートなデータセット管理
Ultralytics Platformを活用して、コンピュータービジョンプロジェクトのデータセット管理を改善する方法をご紹介します。データセットの追跡、比較、改善を簡単に行えます。
 Abirami Vina17 分で読めます
ビジョンAI、すなわちコンピュータービジョンは、初期の段階から大きく進歩し、実験的な研究から実環境のアプリケーションを支える主要なテクノロジーへと進化しました。現在では、AIに関心のある人々が、使いやすいツールやフレームワークを利用して、物体検出やインスタンスセグメンテーションなどのタスクに対応する強力なモデルを構築できます。
しかし、こうしたアプリケーションが実験から本番環境に移行する際、データセット管理は依然として重要でありながら、見過ごされがちな課題です。コンピュータービジョンデータセットの規模と複雑さが増すにつれ、チームはアノテーションの一貫性を維持し、バージョン間の変更を追跡し、データ全体の品質を確保することに苦労することがよくあります。
高度なモデルであっても、トレーニングに使ったデータが不完全、不均衡、または適切に管理されていない場合、実環境では十分な性能を発揮できないことがあります。開発時の性能と実環境での信頼性の間に広がるこのギャップが、より体系的なデータセット管理を必要とする理由です。
もう一つのよくある課題は、データ収集、アノテーション、トレーニングが別々のツールで行われることです。ワークフローが分断されると、データセットを効率的に管理しにくくなり、一貫性が損なわれるリスクが高まり、反復開発も遅くなります。
データセット管理や分断されたワークフローなど、ビジョンAIのボトルネックを解消するため、最近Ultralytics Platformをリリースしました。これは、データセット管理、アノテーション、トレーニング、デプロイ、モニタリングを単一の統合ワークフローにまとめた、エンドツーエンドのワークスペースです。
コンピュータービジョンのライフサイクルの各段階をつなぐことで、データセットの変更を追跡し、バージョン間の性能を比較し、より良い結果を得るためにデータを継続的に改善しやすくなります。
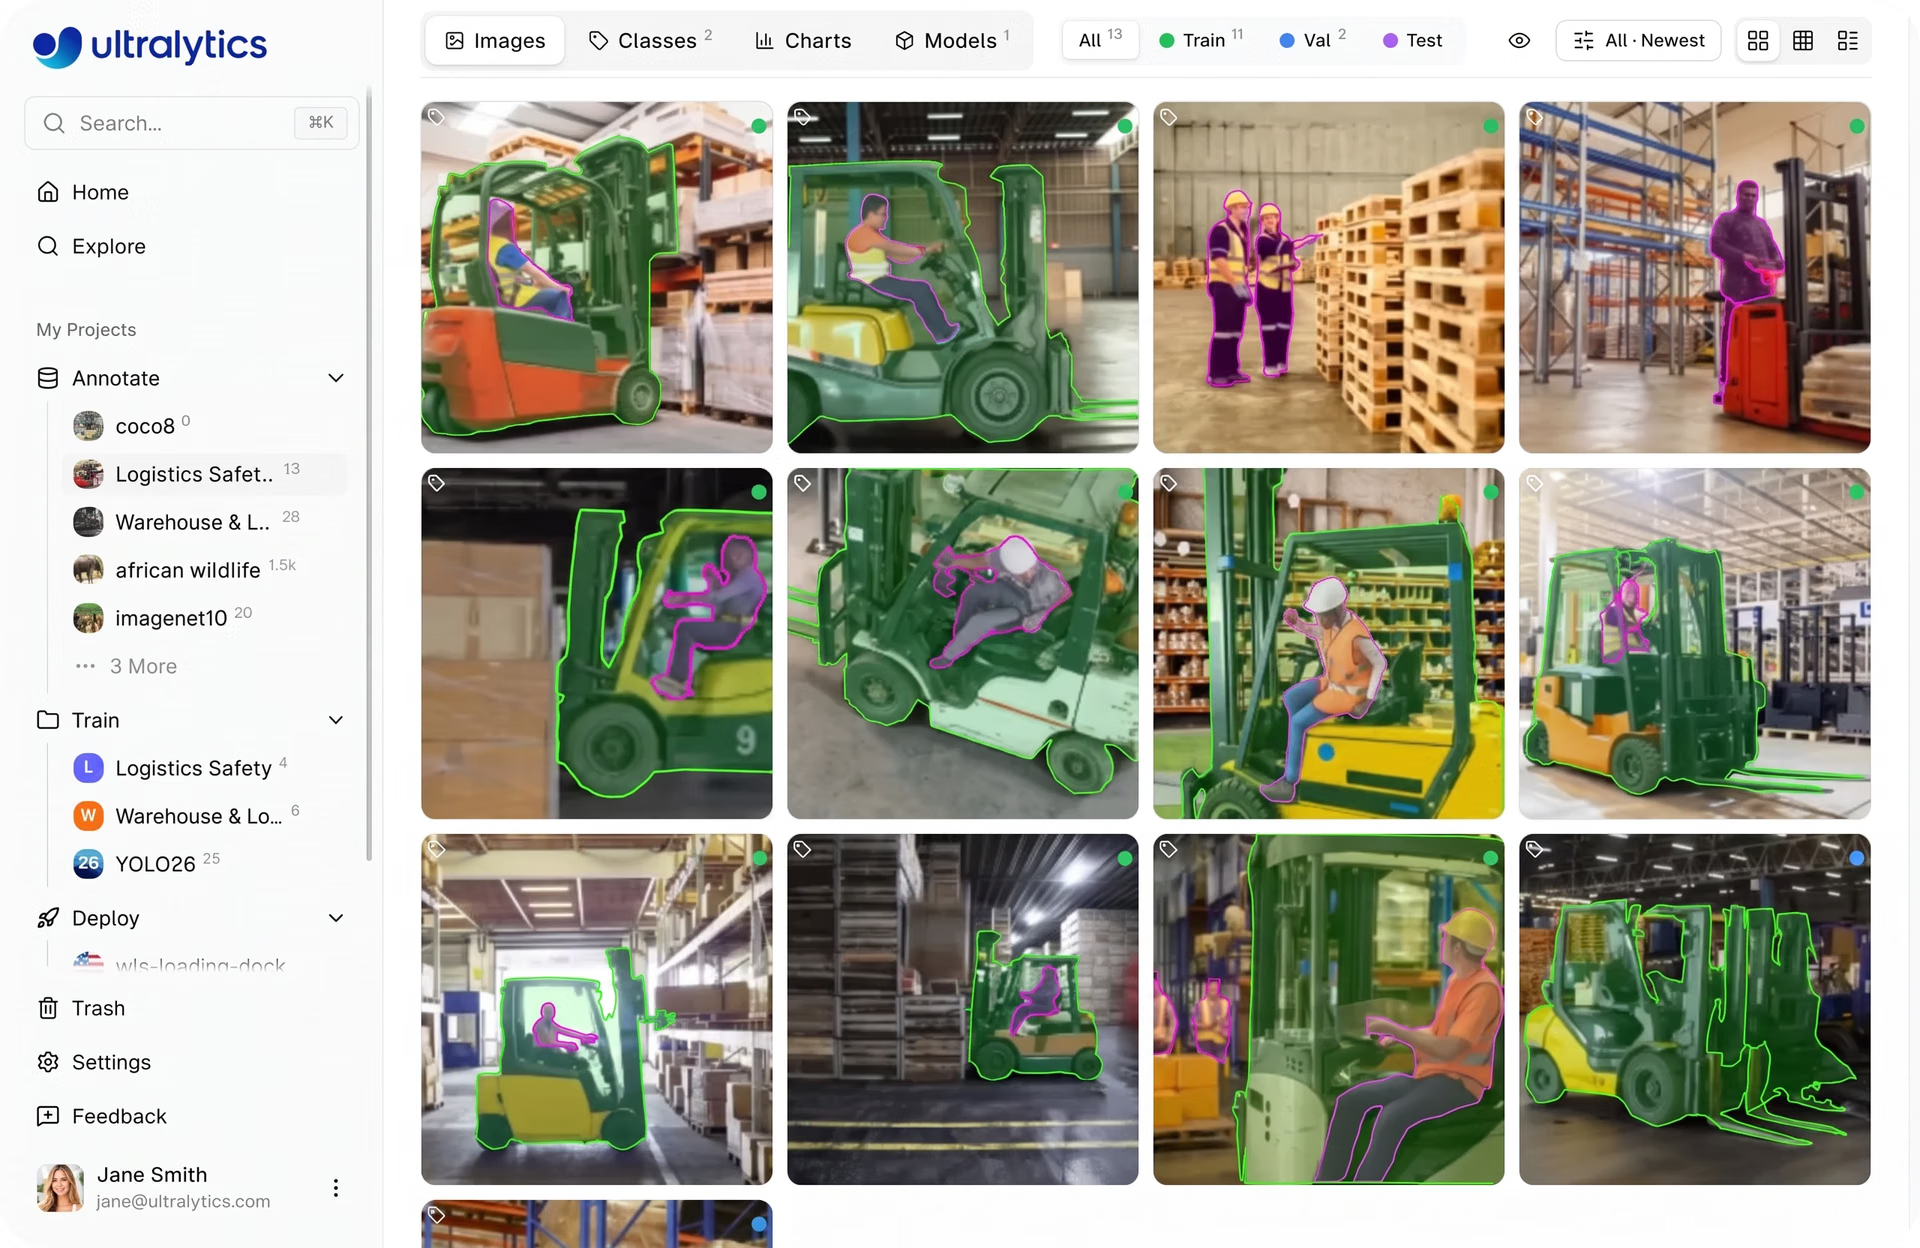
図1. Ultralytics Platformでデータセット画像を表示する例(出典)
この記事では、Ultralytics Platformを活用してデータセットを追跡、比較、改善し、より信頼性の高いコンピュータービジョンモデルを構築する方法を詳しく解説します。
コンピュータービジョンにおけるデータセット管理の重要性#
コンピュータービジョンモデルの性能は、学習に使用するデータと密接に結び付いています。予測がどの程度正しいかを示すモデルの精度は、アルゴリズムだけでなく、データセットが実環境の状況をどれだけ適切に表しているかにも左右されます。
簡単に言えば、モデルはデータから直接パターンを学習するため、データセット内の不足、偏り、一貫性の欠如が予測に影響することがあります。つまり、データ品質の低さ、不正確なアノテーション、あるいは照明条件、物体の角度、背景、オクルージョンの度合いなど、画像における実環境の変化を十分に網羅できていないことは、モデルアーキテクチャ自体が優れていても、精度を大幅に低下させる可能性があります。
これはファインチューニングにも当てはまります。ファインチューニングでは、特定のユースケースや環境により適応させるため、事前学習済みモデルを新しいデータや更新されたデータでさらに学習させます。モデルの精度はデータに大きく依存するため、データを適切に管理することが不可欠です。
データセット管理には、データを整理、ラベル付けし、正確で関連性の高い状態を保つために継続的に更新する作業が含まれます。これにより、特に新しいデータでモデルを再トレーニングまたはファインチューニングする際に、時間の経過とともに性能を改善しやすくなります。
データセットの品質が実環境での信頼性に与える影響#
セキュリティ監視システムなどのコンピュータービジョンのユースケースは、適切なデータ管理が不可欠である理由をよく示しています。こうしたシステムは、さまざまな照明環境、カメラアングル、混雑度、部分的なオクルージョンなど、幅広い実環境の状況で確実に動作する必要があります。
学習データがこうした変化を網羅していなかったり、さまざまなシーンや状況における物体の見え方に多様性がなかったりすると、モデルは物体を正確に検出するのが難しくなる可能性があります。たとえば、明るく整理されたシーンを中心に学習したモデルは、暗い環境や混雑した状況では性能が低下することがあります。セキュリティシステムでは、これがイベントの見逃しや誤警報につながる可能性があります。
これを避けるには、データセットをクリーンで正確にラベル付けするだけでなく、バランスの取れた状態に保ち、継続的に更新することが重要です。つまり、データの不足を特定し、状況の変化に応じて新しいサンプルを追加し、さまざまなクラスや環境が均等に含まれていることを確認する必要があります。
より完全で体系的なデータセットを用意することで、モデルは実環境の変動にうまく対応し、より信頼性の高い予測を生成できるようになります。
データセット管理の主な要素#
では、データセット管理とは具体的にどのようなものでしょうか。モデル開発プロセス全体でデータを効果的に活用できるよう、データを整理し、ラベル付けし、維持する作業です。
たとえば、データの整理には、データセットの構造化やトレーニングセット、検証セット、テストセットへの分割が含まれます。トレーニングセットはモデルの学習に使用し、検証セットは開発中のパフォーマンスを監視して調整の指針とするために使用します。テストセットは、最終モデルがまったく未見のデータに対してどの程度の性能を発揮するか評価するために使用します。
一方、ラベル付けでは、クラスラベル、バウンディングボックス、セグメンテーションマスクなどの詳細情報を画像にアノテーションします。モデルはこれらのアノテーションから学習するため、意味のあるパターンを学習し、信頼性の高い予測を行えるようにするには、正確さと一貫性が重要です。
さらに、データセットの維持には、時間の経過に応じたデータの確認と更新が含まれます。これには、アノテーションの誤りの修正、品質の低いデータや重複データの削除、未対応のケースや変化する状況を網羅する新しいサンプルの追加などがあります。
より広い視点では、データセット管理は継続的なプロセスです。モデルの評価や新しいデータの収集に応じて、実環境の状況やエッジケースを反映するようデータセットを更新する必要があります。こうした更新を追跡し、異なるバージョンを比較することで、何が性能を向上させているのか、さらなる変更が必要なのはどこかをチームが把握しやすくなります。
Ultralytics Platformでのデータセット管理#
Ultralytics Platformは、データ準備からエクスポートまでを網羅した、単一の環境でデータセットを管理するための体系的なワークフローを提供します。個人の開発者とチームの両方を支援するよう設計されており、単独で作業する場合も、複数のプロジェクトで共同作業する場合も、一貫したデータセット管理を容易にします。
各段階は、モデル開発のライフサイクル全体でデータセットを整理、処理、活用する方法を簡素化するよう設計されています。これらの手順を一か所にまとめることで、プラットフォームはワークフローの分断を減らし、ワークフロー全体の一貫性をより簡単に維持できるようにします。
次に、主な手順と、それぞれをプラットフォームがどのように支援するかを見ていきましょう。
Ultralytics Platformへのデータセットのアップロード#
プラットフォームでデータセットを使い始める方法は柔軟で、データを取り込んだり再利用したりする複数の方法があります。独自のデータをアップロードすることも、プラットフォームから利用できる公開データセットを使ってすぐに開始することもできます。また、コミュニティで共有されている既存のデータセットを複製し、それを基に構築することも可能です。
プラットフォームのコミュニティ機能を使うと、既存の成果を簡単に見つけて再利用できます。数百万枚の画像とアノテーションを含む、他のユーザーが作成したデータセットを利用できるため、すべてを自分で収集してラベル付けすることなく、すぐに開始できます。データセットを複製するとワークスペース内にコピーが作成され、元のデータセットを保持したまま変更や拡張を行えます。
アップロードでは、個々の画像や動画のほか、ZIP、TAR、GZファイルなどのデータセットアーカイブにも対応しています。また、YOLOやCOCOなど広く使われているデータセット形式にも対応しているため、既存のデータセットやアノテーションを追加変換なしで簡単にインポートできます。さらに、プラットフォームからエクスポートしたNDJSONファイルを使ってデータセットをアップロードできるため、プロジェクト間でデータセットを簡単に再作成したり再利用したりできます。
データをアップロードすると、プラットフォームは体系的なパイプラインを通じてデータを処理します。これには、ファイル形式とサイズの検証、必要に応じた画像のリサイズ、アノテーションの解析、データセット統計の生成が含まれます。
たとえば、動画はトレーニングに使えるようフレームに変換され、画像は閲覧や分析が容易になるよう最適化および準備されます。処理後のデータセットは、プラットフォーム内でのアノテーション、分析、モデルのトレーニングに利用できます。
Ultralytics Platformでのデータアノテーション#
アップロードしたデータセットは、プラットフォーム上で直接レビューおよびアノテーションできます。プラットフォームには、物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、画像分類、姿勢推定、回転バウンディングボックス(OBB)検出など、幅広いコンピュータービジョンタスクに対応する組み込みの画像アノテーションツールが用意されています。
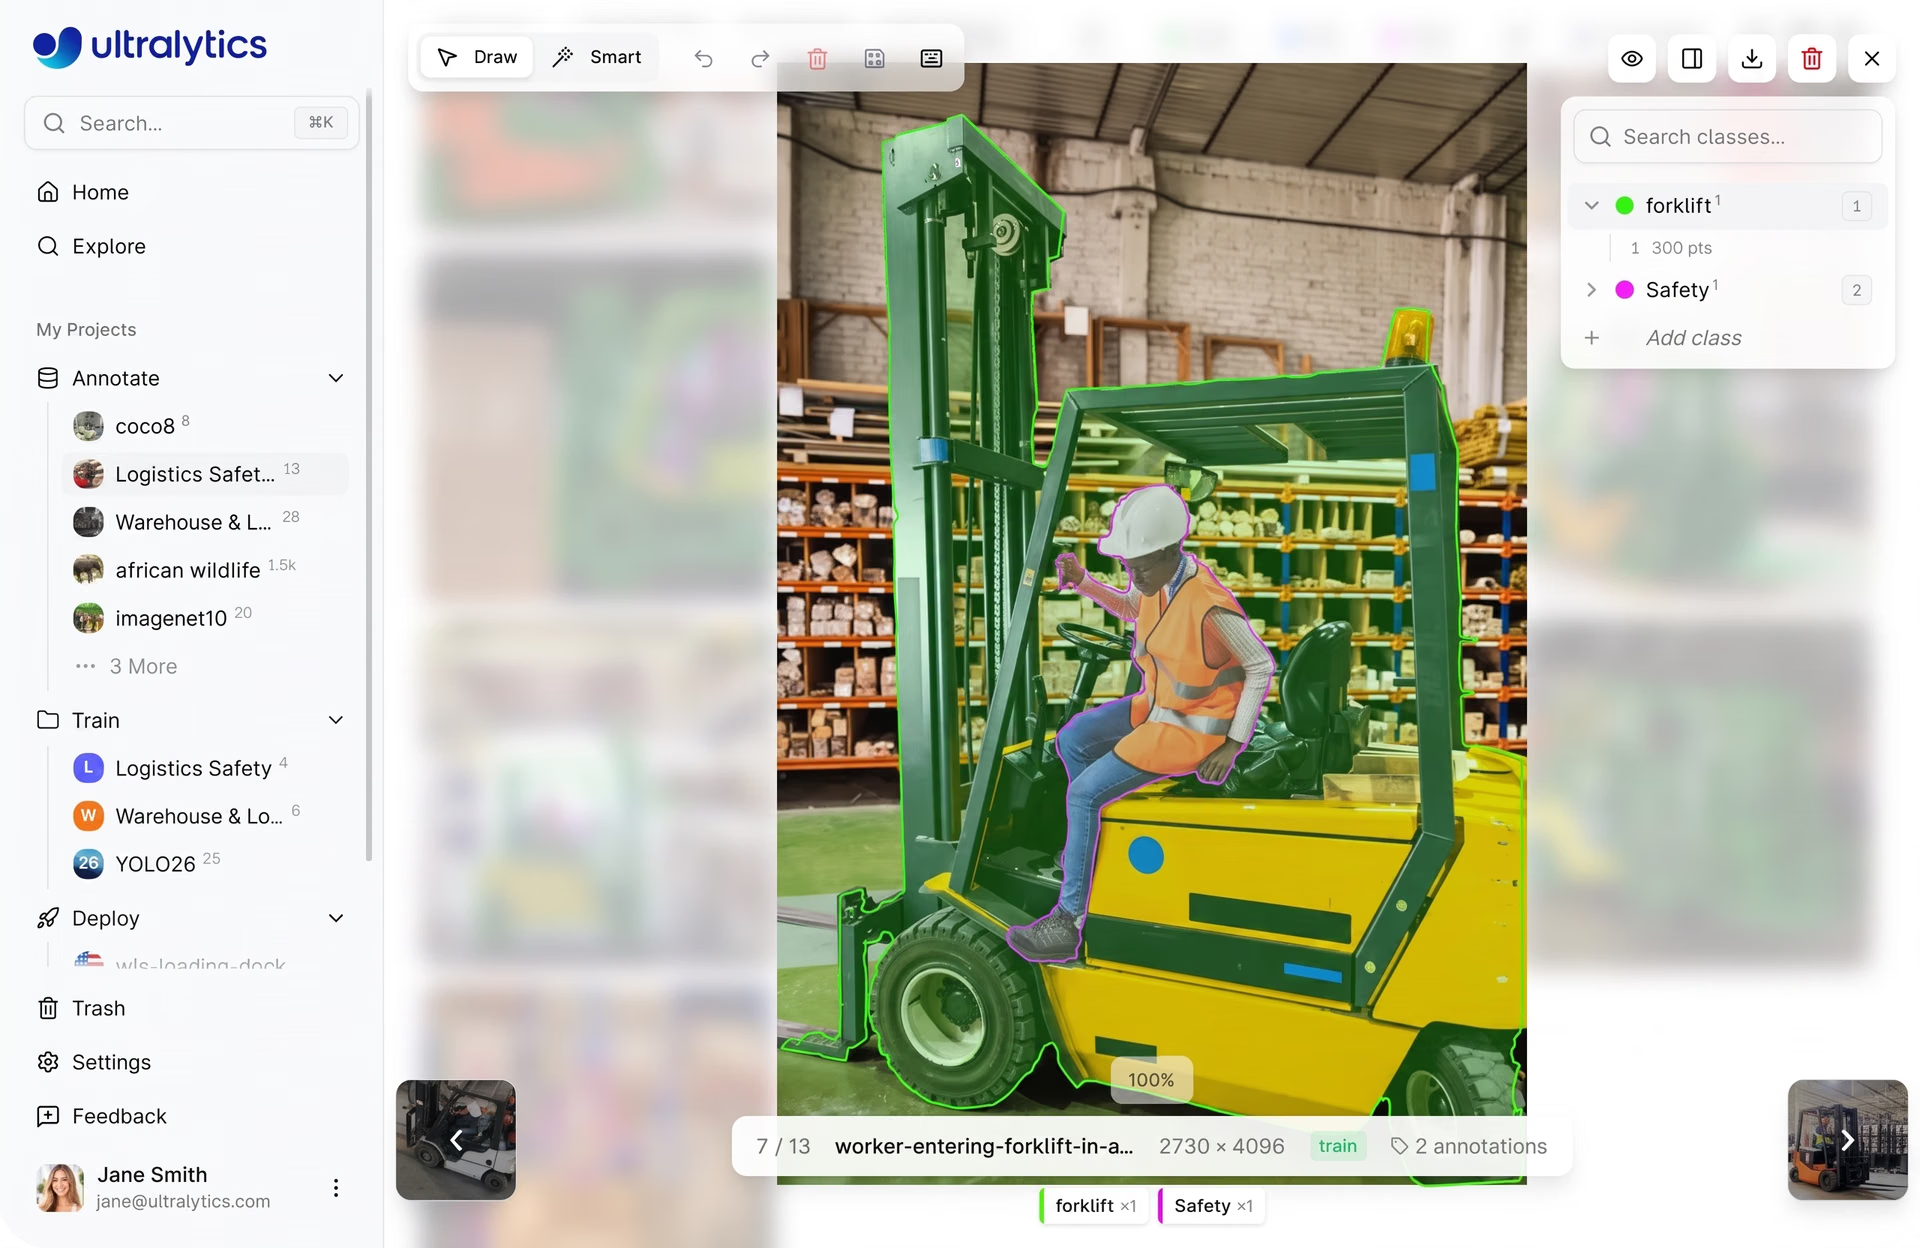
図2. Ultralytics Platformを使用したデータのラベリング(出典)
これらのツールを使って手動でアノテーションを作成することも、SAMを活用したスマートアノテーションなどのAI支援機能で作業を効率化することもできます。SAMを使うと、画像上で操作することでマスク、バウンディングボックス、方向付きボックスを生成できるため、精度を維持しながらラベリングを迅速化できます。
Ultralytics Platformによるデータセット品質の分析#
データの準備やアノテーションに加えて、信頼性の高いコンピュータービジョンモデルを構築するには、データセットの品質を理解することが不可欠です。クラス分布、アノテーションの品質、データセットの分割、さまざまな状況でのデータの構成などを明確に把握できなければ、モデルの性能に影響する問題を見つけるのが難しくなります。
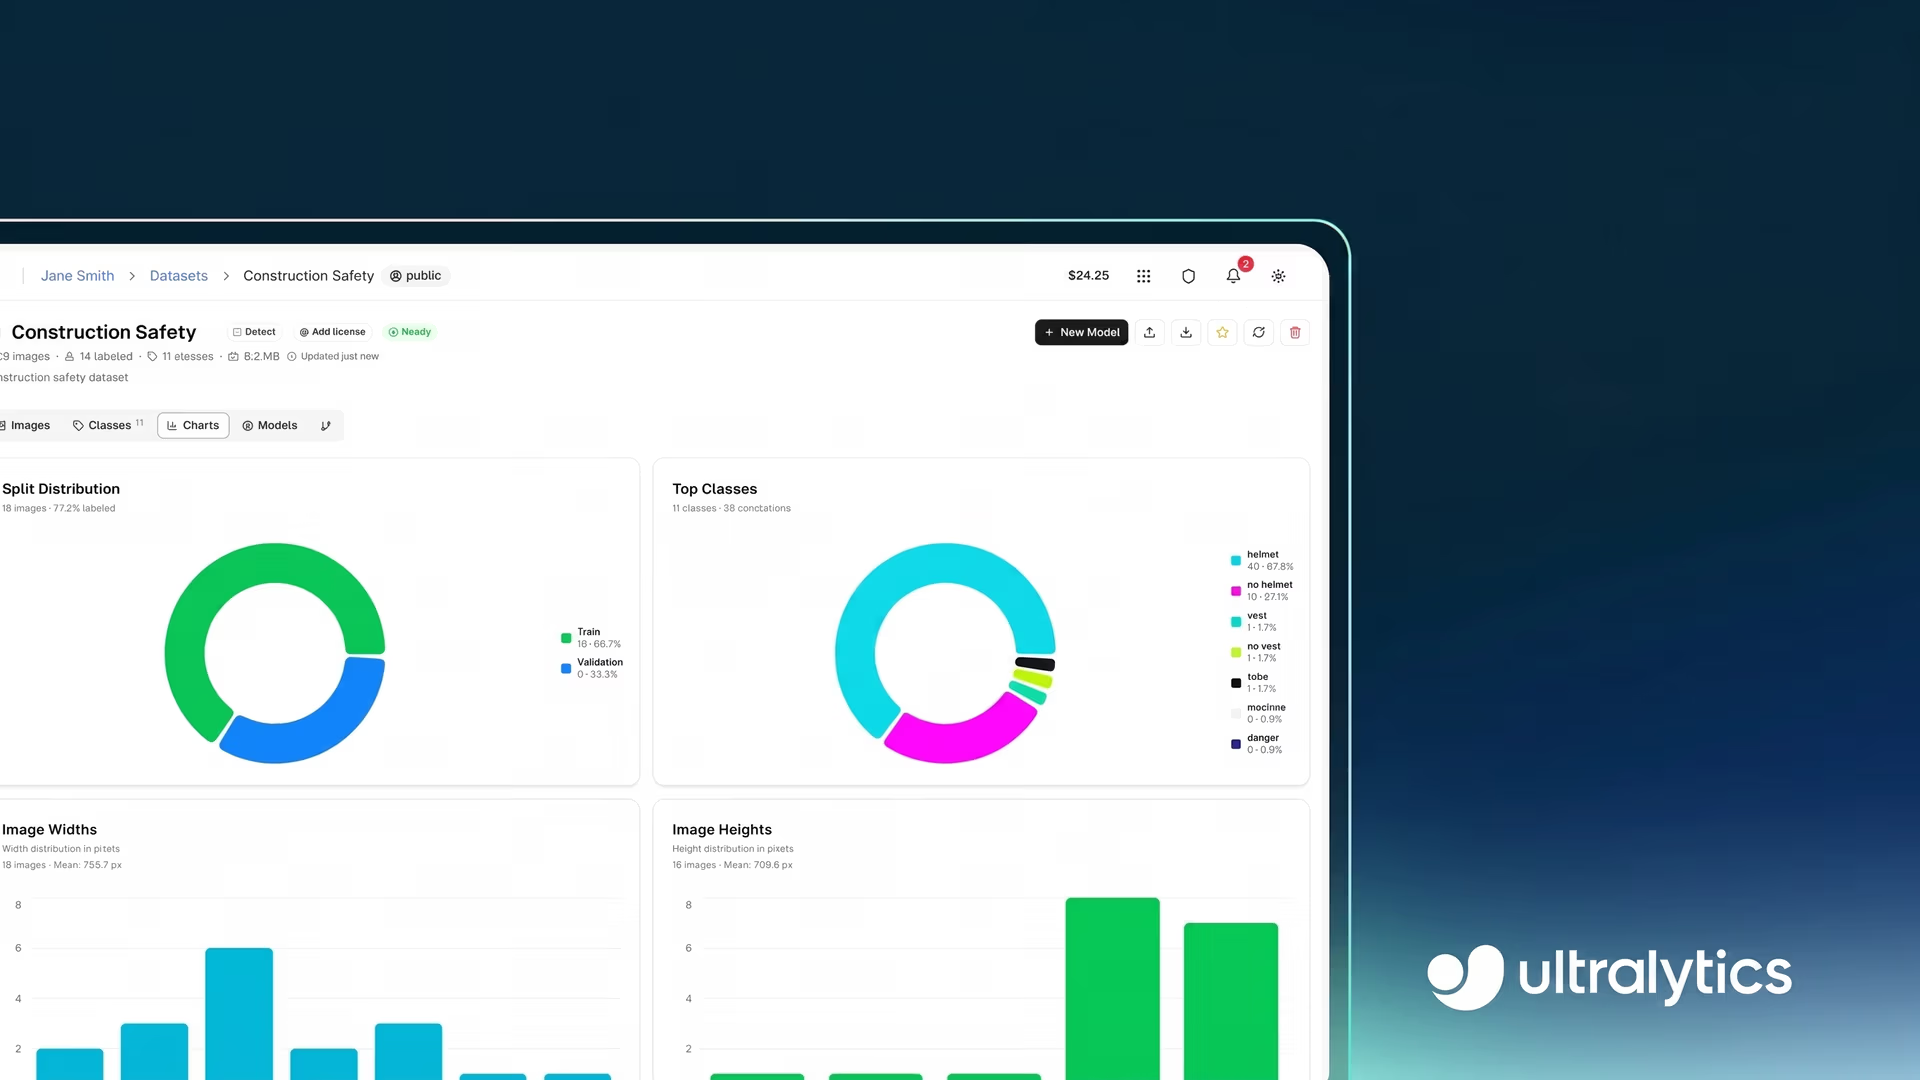
Ultralytics Platformには、データセットをより効果的に分析するための組み込み機能があります。こうしたインサイトは、Images、Classes、Chartsなどのタブを通じて、データセットのインターフェース内で直接確認できます。
Chartsタブでは、トレーニング、検証、テストの分割分布、クラス頻度、画像内の物体の位置を示すアノテーションヒートマップなど、データセット全体の統計を確認できます。
Classesタブではクラスごとのアノテーション数を確認できるため、クラスの不均衡を見つけやすくなります。一方、Imagesタブでは、画像の寸法、アノテーション数、個々の画像におけるラベルの分布など、画像ごとの詳細を確認できます。
こうしたインサイトにより、クラスの不均衡、シナリオの不足、データ分布の偏りなどの問題を特定しやすくなります。たとえば、特定のクラスのサンプルが非常に少ないことや、アノテーションの大半が画像内の特定領域に集中していることに気付く場合があります。
データ分析に加えて、プラットフォームはデータセットのキュレーションと拡張にも対応しています。これは、問題のあるデータを修正または削除してデータセットを改善し、既存データのバリエーションを作成してモデルの性能を高めることを意味します。分析結果に基づいてアノテーションを更新したり、新しいデータを追加したり、データセットの分割を再編成したりすることで、プラットフォーム内で直接改善できます。
Ultralytics Platformからのデータセットのエクスポート#
データセットの準備と検証が完了したら、さまざまな環境で使用できるようエクスポートできます。これにより、ローカル、クラウド、その他のツールやワークフローでのモデルのトレーニングなど、希望する場所でコンピュータービジョンデータを柔軟に利用できます。
Ultralytics Platformは、Ultralytics NDJSONファイルとしてデータセットをエクスポートします。この形式はUltralytics Pythonパッケージで直接トレーニングに使用でき、プラットフォームに再インポートすることもできるため、さまざまなトレーニングワークフローやツールにデータセットを簡単に統合できます。
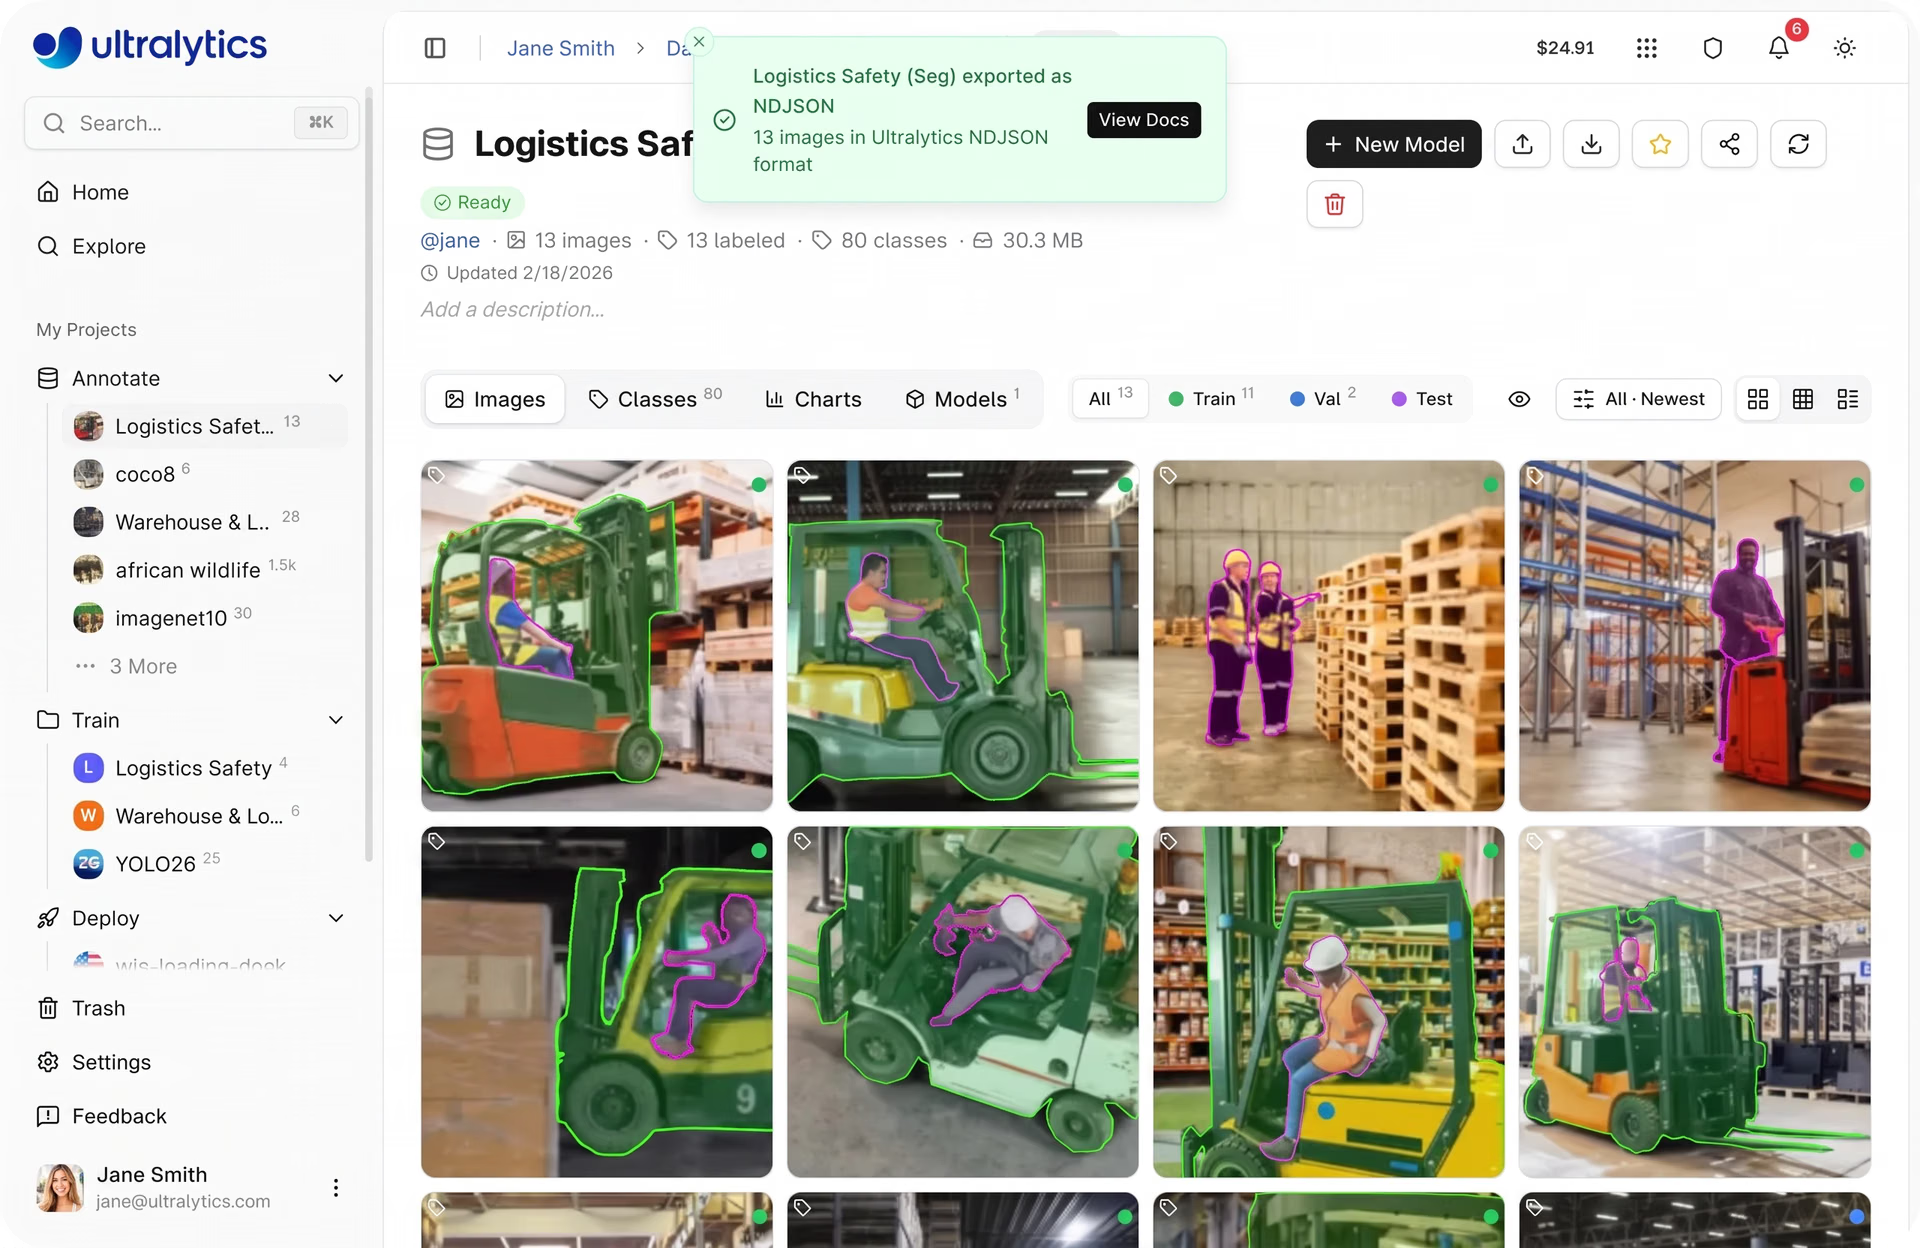
図3. Ultralytics Platformからのデータセットのエクスポート(出典)
データセットをエクスポートすると、画像、アノテーション、構造を含む、その時点のデータの固定スナップショットが作成されます。新しいデータの追加、アノテーションの更新、分割の調整に伴って、データセットは頻繁に変更されるため、これは便利です。スナップショットをエクスポートすることで、特定のトレーニング実行に使用したデータセットの正確なバージョンを保存できます。
これにより、後から同じデータ設定でモデルを再トレーニングし、異なるデータセットバージョン間で性能を比較できるため、結果を簡単に再現できます。たとえば、何が変わったのかを推測するのではなく、新しい画像の追加やアノテーションの修正によってモデルの精度が実際に向上したかを評価できます。
エクスポートしたデータセットはダウンロードし、ローカル、クラウド、オフラインのトレーニング環境で使用できます。
Ultralytics Platformでの反復によるデータセット品質の改善#
機械学習やディープラーニングのワークフローでは、実環境のデータがトレーニングに使ったデータと異なることが多いため、デプロイ後もデータセット管理は続きます。
モデルが新しい入力に遭遇すると、暗い環境、異なるカメラアングル、オクルージョン、混雑したシーンなどの状況の不足や、アノテーションの誤りといったデータセットの問題がより明らかになり、時間をかけてデータを改善する必要が生じます。
データセットを改善する方法はいくつかあります。暗い環境、異なるカメラアングル、オクルージョン、混雑したシーンなど、欠けている状況を網羅する新しい画像や動画を追加すると、データの死角を減らすことができます。
同時に、物体に正しいラベルを付け、正確なバウンディングボックスやマスクを設定するなど、アノテーションの正確さと一貫性を確保することで、モデルはより信頼性の高いパターンを学習できます。
通常は、モデルをトレーニングし、結果を評価し、エラーを特定し、データセットを改善して再トレーニングするというシンプルなサイクルで進めます。各ステップを通じて、不正確なアノテーション、データの不足、サンプルが少ないケースなどの問題を明らかにできます。
店舗の商品を検出するリアルタイムの小売棚監視システムに取り組んでいるとします。データセットの初期バージョンには、特定の商品タイプ、照明条件、商品が密集した棚の配置が含まれていない場合があります。評価時に、こうした状況でモデルの検出が難しくなることに気付くかもしれません。
性能を改善するには、不足しているシナリオを網羅する新しい画像を収集し、必要に応じてアノテーションを更新できます。このプロセスを繰り返すことで、時間の経過とともにモデルの精度と実環境での信頼性を高められます。
Ultralytics Platformは、データセットの更新をトレーニングや評価と連携させ、このワークフローを支援します。組み込みの実験追跡機能と性能指標により、進捗を監視し、時間の経過に応じてデータセットを継続的に改善しやすくなります。
Ultralytics Platformを使ったデータセットの変更追跡#
モデル開発プロセスの一環として、データセットが時間の経過とともにどのように変化するかについて簡単に説明しました。新しいデータが追加され、アノテーションが改善され、クラスが更新されるにつれて、こうした変更を追跡することが、データ品質を維持し、一貫したモデル性能を確保するうえで重要になります。
データセットの追跡とバージョン管理を支援する、Ultralytics Platformの主な機能を紹介します。
- データセットのバージョン管理: NDJSONスナップショットとして固定のデータセットバージョンを作成できます。各バージョンには、特定の時点における画像数、クラス数、アノテーション数、データセットサイズなどの重要な詳細が記録されます。これらのバージョンは保存され、後からダウンロードできるため、実験の再現や異なる状態のデータセット間での結果の比較が容易になります。
- Versionsタブ: すべてのデータセットバージョンはVersionsタブに整理されており、バージョン履歴の確認、変更内容の説明の追加、時間の経過に伴うデータセットの変化の追跡ができます。
- モデルとの紐付け: Modelsタブには、データセットでトレーニングされたすべてのモデルが、mAPなどの指標やトレーニングの詳細とともに表示されます。データセットのバージョンはトレーニング実行に紐付けられるため、データの変更がモデルの性能に与える影響を把握できます。
- Errorsタブ: Errorsタブには、処理中に失敗したファイルとエラーの詳細、提案が表示されます。これにより、トレーニング前に破損ファイルや未対応形式などの問題を特定し、修正できます。
- データセットインターフェース(ImagesタブとClassesタブ): これらのビューでは、画像の閲覧、アノテーションの確認、クラスラベルの管理、クラス分布の分析ができます。フィルタリング、並べ替え、未アノテーション画像の特定などの機能により、時間の経過に伴うデータセット品質の監視が容易になります。
- 統計とグラフ: 分割分布、クラス頻度、アノテーションヒートマップなどの組み込みデータ可視化機能を使うと、データセットの変化に応じてデータ分布の変化を追跡し、不均衡を特定できます。
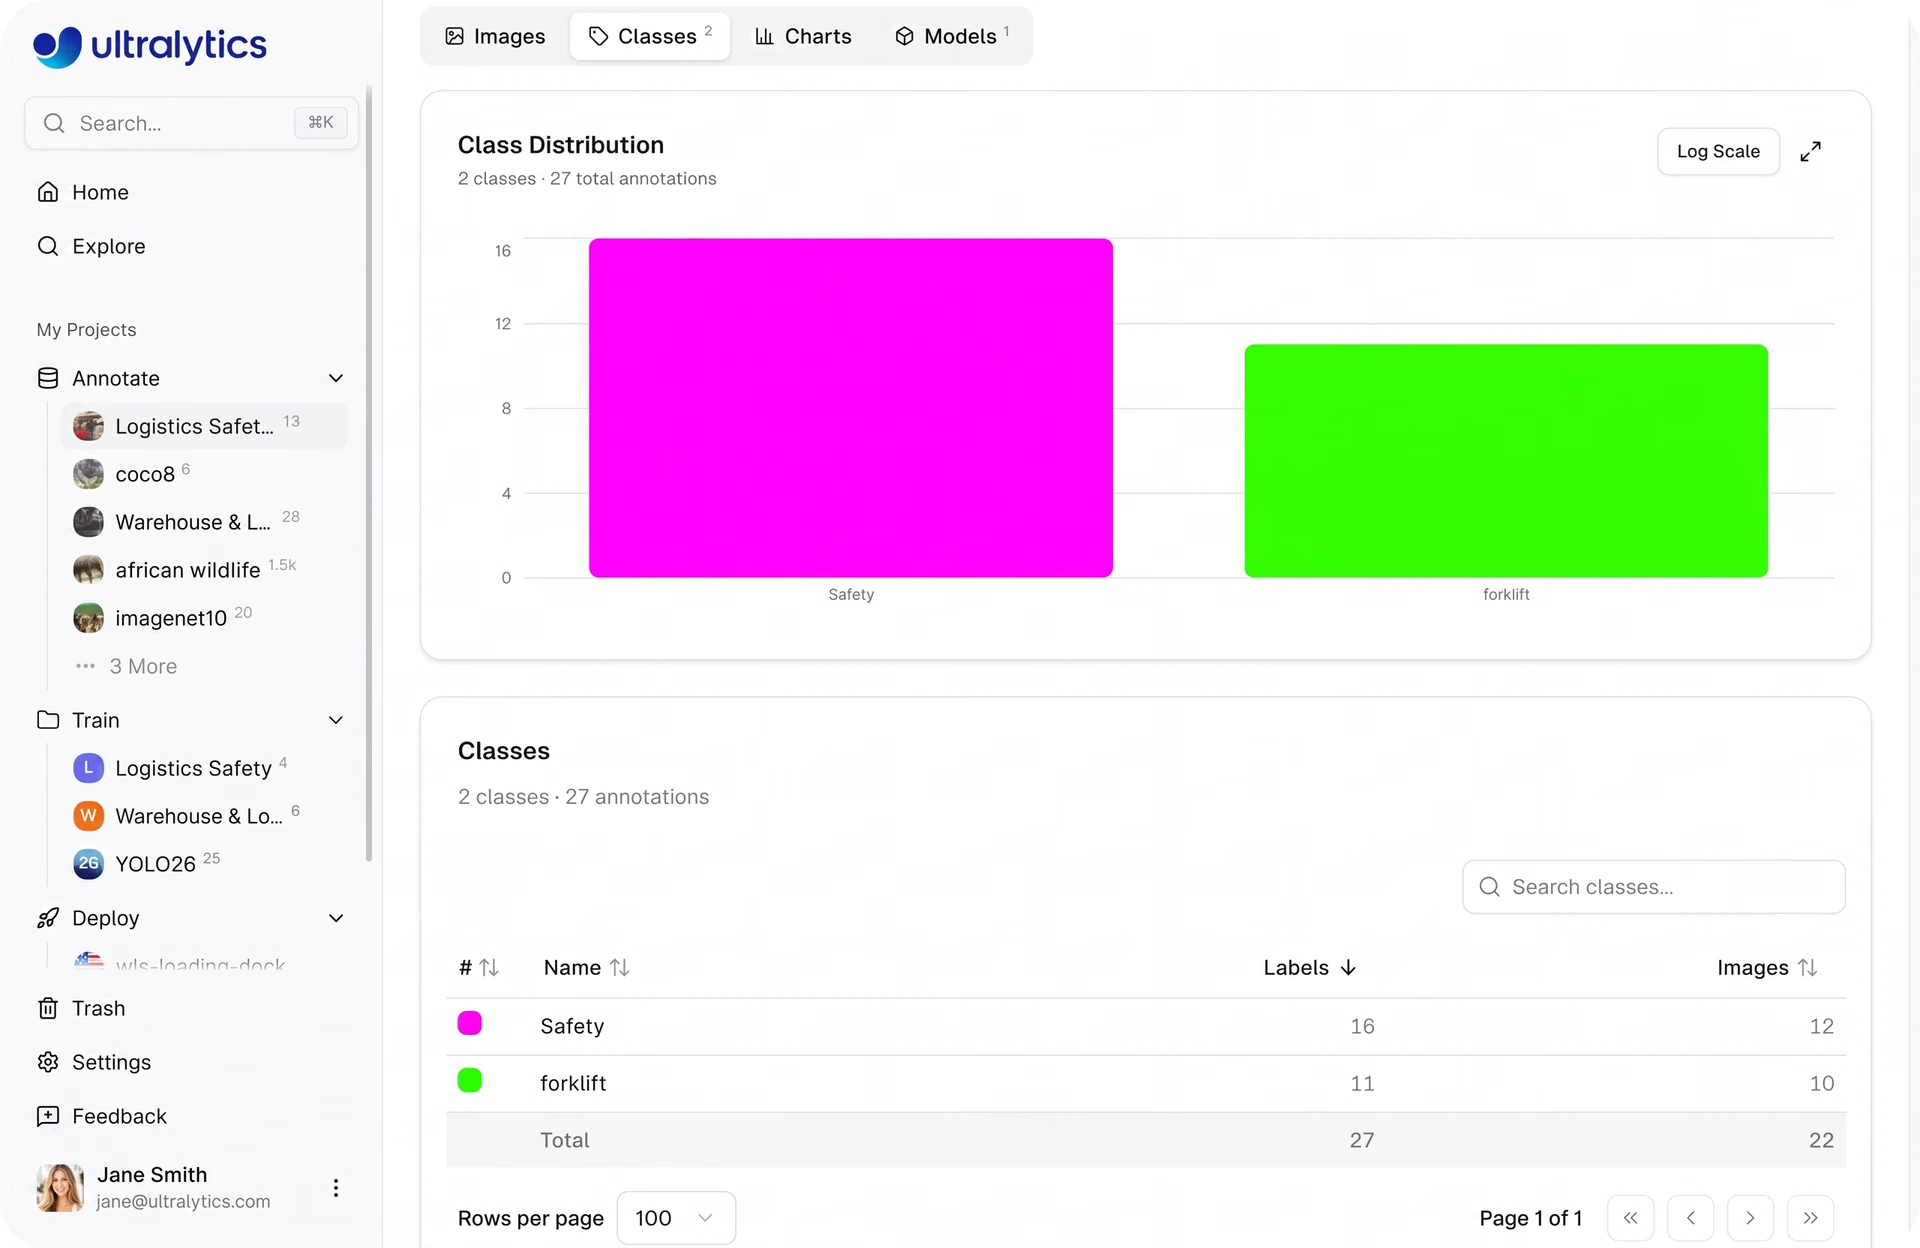
図4. Ultralytics Platformでのデータセットのクラス分布の分析例(出典)
Ultralytics Platform内でのデータセットとトレーニングおよびデプロイの連携#
Ultralytics Platformは、AIモデル開発のさまざまな段階を単一のパイプラインにつなぎます。これにより、生データから本番環境に対応したビジョンAIアプリケーションへと進むプロセスが効率化されます。
データセットの準備とアノテーションが完了すると、プラットフォーム内でUltralytics YOLO26などのコンピュータービジョンモデルを直接トレーニングできます。トレーニング中は、組み込みダッシュボードを使って性能指標を監視し、実験を追跡し、モデルの学習状況を評価できます。
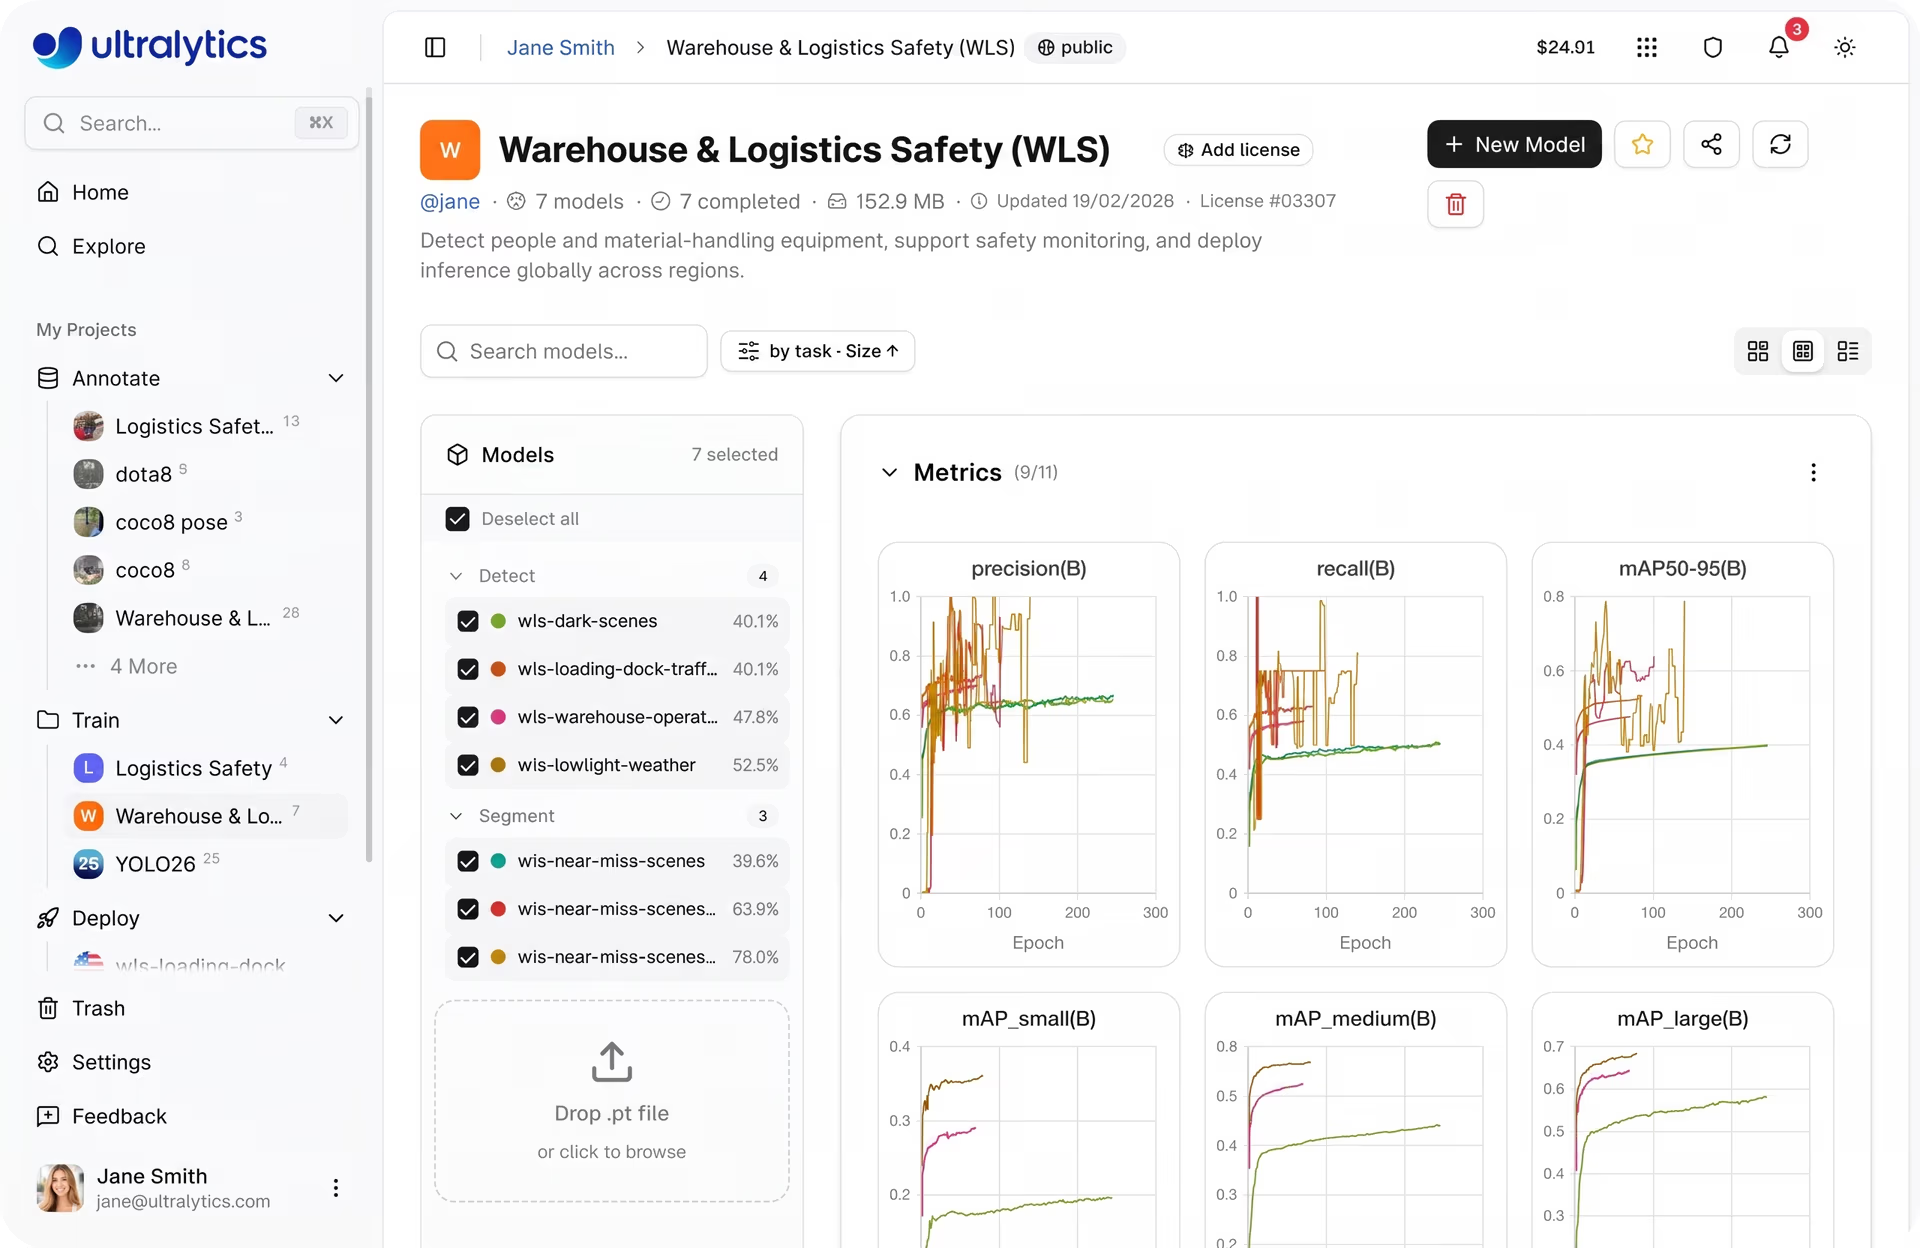
図5. Ultralytics Platformでモデルのトレーニング指標を表示する画面(出典)
トレーニング後は、デプロイ前にブラウザー上で新しい画像を使ってモデルをテストし、予測を評価して改善点を特定できます。モデルが十分な性能を発揮したら、本番環境にデプロイできます。
プラットフォームでは、モデルを複数の形式にエクスポートしたり、推論サービスや専用エンドポイントを通じてデプロイしたりできるため、さまざまな環境で実行できます。
デプロイ後は、組み込みのモニタリングツールを使って、使用状況やモデルの動作に関する指標など、システムの性能を時間の経過に応じて追跡できます。これにより、実環境のアプリケーションでビジョンAIシステムをより簡単に維持、改善できます。
Ultralytics Platformでのデータセット管理のベストプラクティス#
Ultralytics Platformでデータセットを管理する際に留意すべき主なポイントを紹介します。
- フィルターで不足を特定: フィルターツールを使って、ラベルのないデータやデータが不足している領域を特定し、アノテーションの補完とデータカバレッジの改善を容易にします。
- エラーを早期に修正する: 品質管理には「Errors」タブを使用し、トレーニング前にアップロードの失敗、ファイルの破損、未対応の形式を検出します。
- データセットを継続的に更新する: 新しいデータを追加し、アノテーションを修正し、発生したエッジケースを取り入れます。これにより、カバレッジが向上し、実環境でもモデルが安定して動作するようになります。
- データセットの分割を慎重に管理する: トレーニング、検証、テストの各セットのバランスを適切に保ちます。必要に応じて、分割を手動で再編成することも、自動再分配を利用することもできます。
Ultralytics Platformについて詳しくは、公式のUltralytics Platformドキュメントをご覧ください。
重要なポイント#
コンピュータービジョンプロジェクトが拡大するにつれて、データセットを効果的に管理することは、モデル開発と同じくらい重要になります。データセット管理に体系的なアプローチを取り入れると、データ品質の向上、ワークフローの効率化、長期的なモデル性能の改善につながります。
Ultralytics Platformは、データセット管理、トレーニング、デプロイを単一のワークフローにまとめ、このプロセスを簡素化します。データセット管理に体系的なアプローチを取り入れることで、チームは複雑さを軽減し、効率を高め、よりスケーラブルで信頼性の高いコンピュータービジョンシステムを構築できます。
成長を続けるコミュニティに参加し、AI関連のリソースについてはGitHubリポジトリをご覧ください。今すぐビジョンAIを活用して開発するには、ライセンスオプションをご確認ください。農業分野のAIが農業をどのように変革し、医療分野のビジョンAIがどのように未来を形作っているか、ソリューションページでご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









