Ultralytics PlatformでYOLOモデルをより速くトレーニング
データからデプロイまでの工程を加速するエンドツーエンド環境、Ultralytics Platformを使ってYOLOモデルをより速くトレーニングする方法をご紹介します。
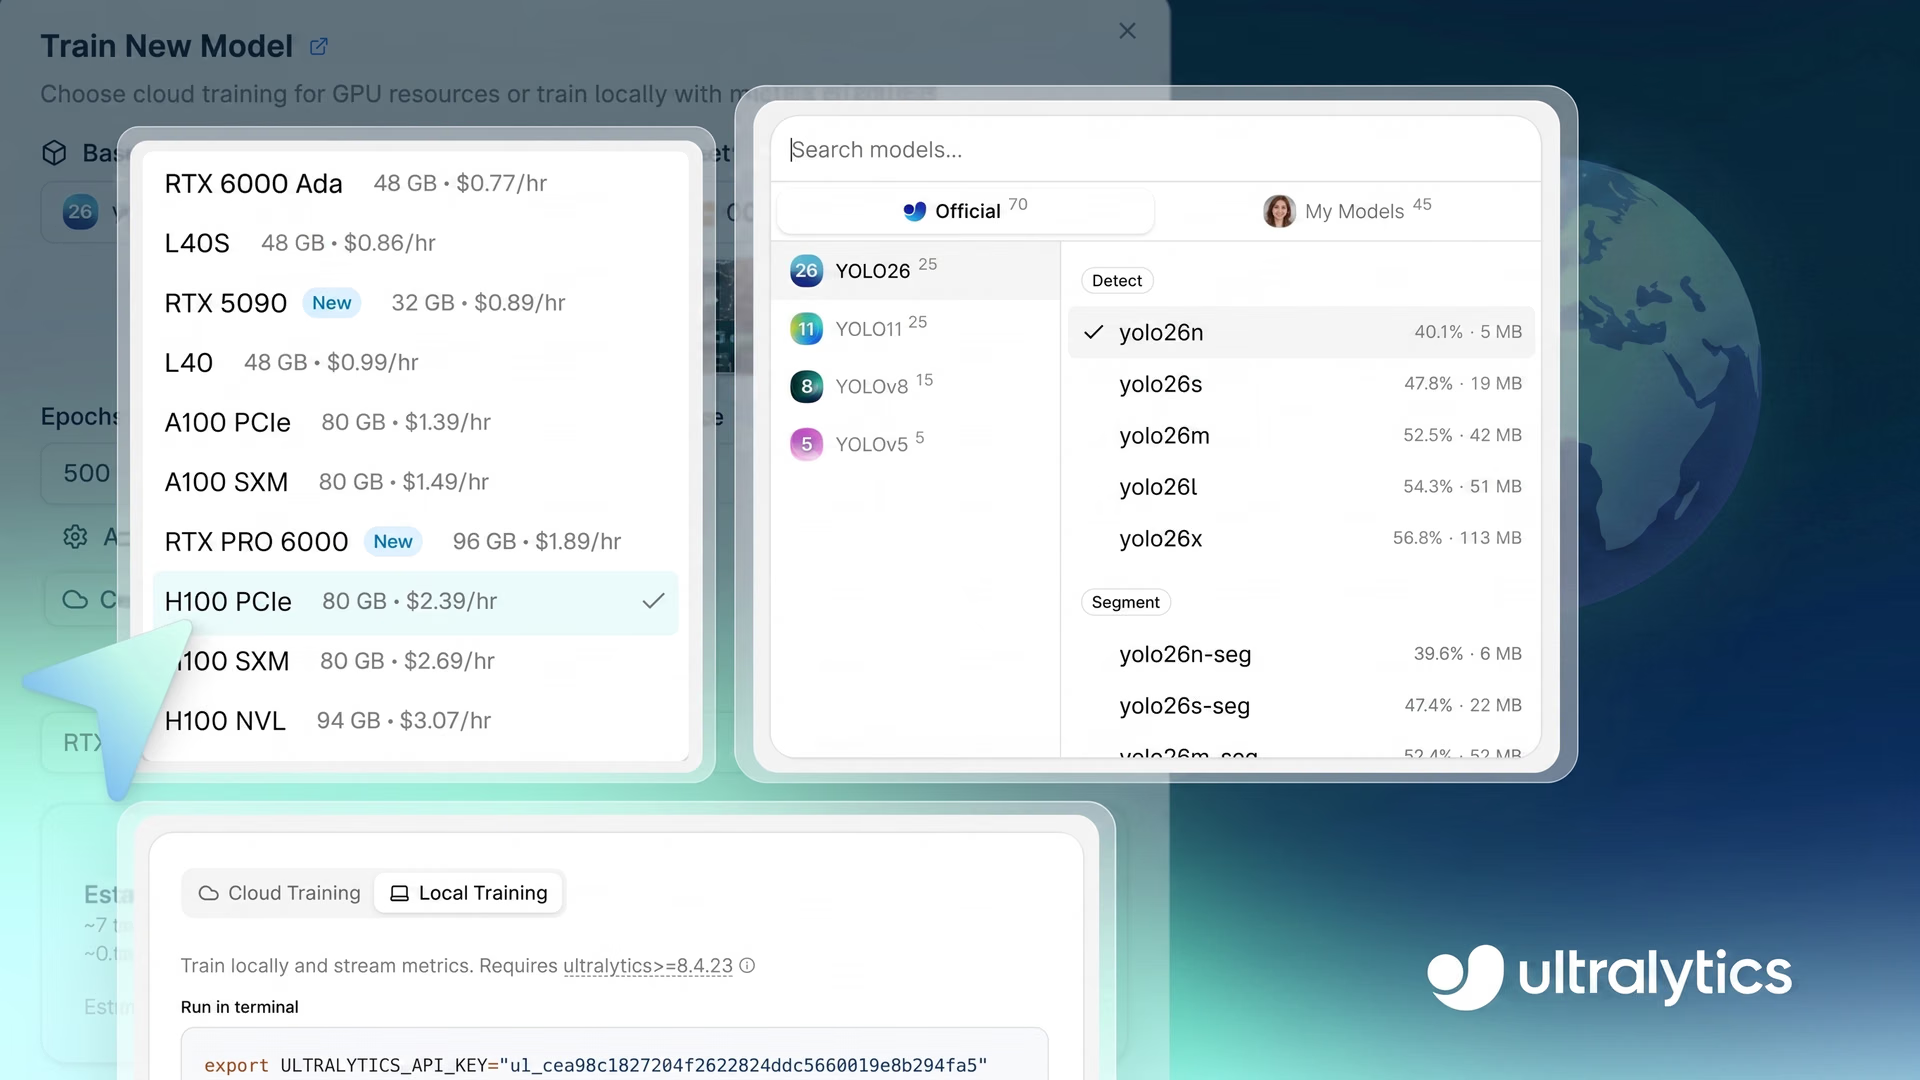
先週、Ultralyticsは、チームによるコンピュータービジョンモデルの構築、トレーニング、デプロイを簡素化するために設計された統合ワークスペース、Ultralytics Platformを発表しました。複数のツールを使い分ける必要はなく、プラットフォームですべてを一元管理できます。ビジョンAIモデルのアイデアをデプロイにつなげるプロセスが簡単になります。
コンピュータービジョンがさまざまな業界の中核を急速に担うようになっているため、これは非常に重要です。コンピュータービジョンは、製造業の検査、小売分析、自律型ナビゲーションなどのアプリケーションを支えています。
こうしたビジョン対応アプリケーションを信頼性の高いシステムにするには、モデルをどれだけ適切にトレーニングできるかが重要です。モデルのトレーニングでは、ラベル付きデータから学習させ、モデルがパターンを認識して正確な予測を行えるようにします。一般に、十分にトレーニングされたモデルは、モデルのパフォーマンス向上と実環境での信頼性の高い結果につながります。
ただし、コンピュータービジョンモデルのトレーニングは、必ずしも簡単ではありません。環境のセットアップ、適切なコンピューティングリソースの選択、ハイパーパラメーターの調整、複数のトレーニング実験の追跡など、さまざまな作業が含まれます。これらの手順が複数のツールやシステムに分散していると、トレーニングのワークフローはすぐに複雑になり、管理が難しくなります。
Ultralytics Platformは、トレーニングプロセス全体を単一の統合ダッシュボードに集約することで、この課題を解決します。クラウド、ローカル環境、Google Colabのいずれで作業する場合でも、1か所でトレーニングジョブを設定、実行、監視できます。
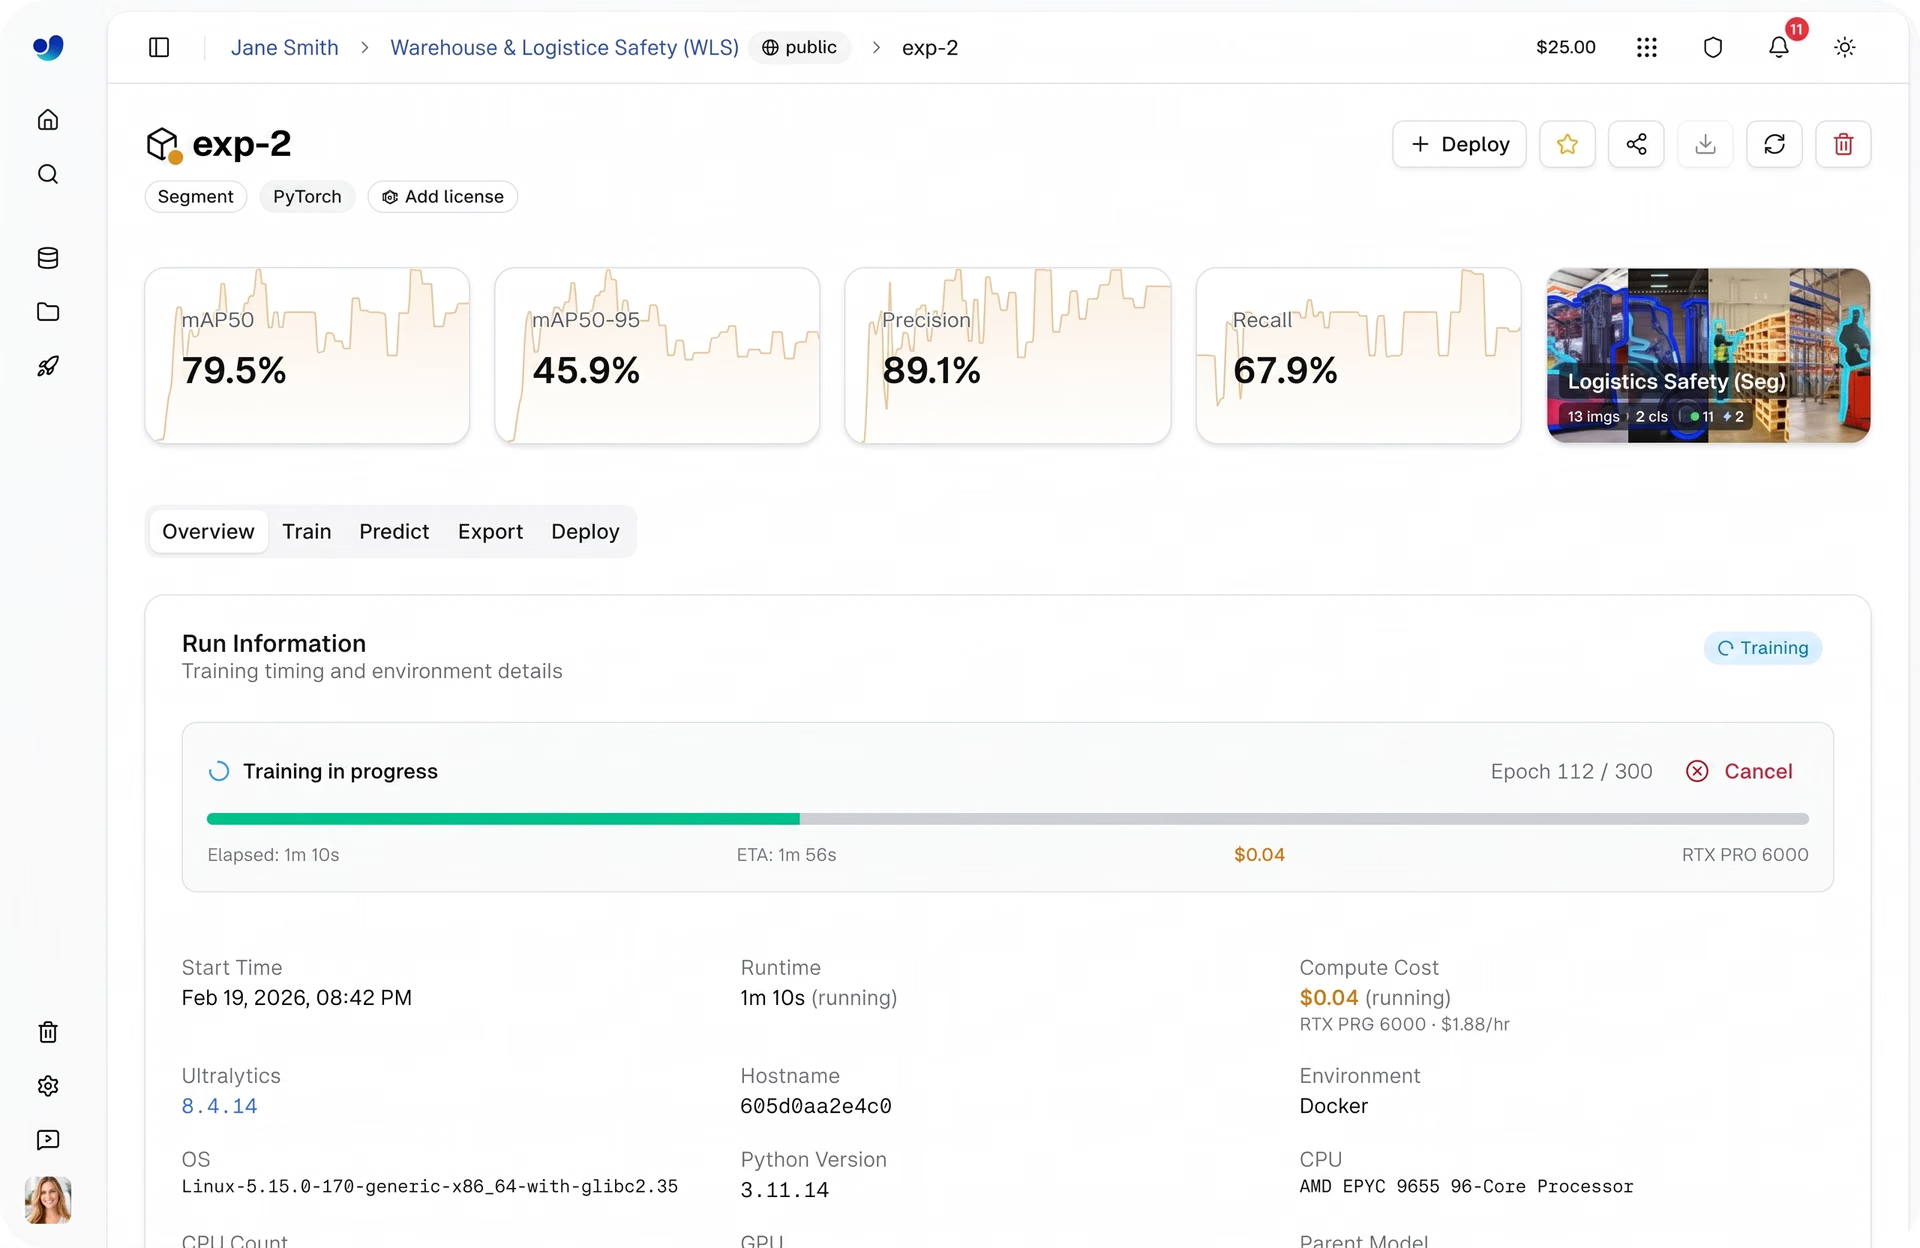
図1。Ultralytics Platformでのモデルのトレーニングの様子(出典)
この記事では、Ultralytics Platformがモデルのトレーニングをどのように効率化するのか、またビジョンAIプロジェクトでどのような優位性をもたらすのかを紹介します。さっそく見ていきましょう。
コンピュータービジョンモデルはトレーニングを通じてデータから学習します#
Ultralytics Platformでのモデルのトレーニング方法を詳しく見る前に、まず一歩引いて、モデルのトレーニングとは何か、どのような要素が含まれるのかを確認しましょう。
モデルのトレーニングとは、コンピュータービジョンモデルが視覚データを解釈できるよう学習するプロセスです。画像や動画を分析し、内部パラメーターを段階的に調整することで、物体検出、画像分類、インスタンスセグメンテーションなどのビジョンタスクを正確に実行します。モデルは時間をかけて、入力されたデータから直接パターンを学習し、性能を向上させます。
トレーニングの品質は、データセットに大きく左右されます。データセットは、教師が生徒を教えるために使う単語カードのようなものです。それぞれの例が、モデルに何に注目すべきかを学習させます。
一般的なコンピュータービジョンのデータセットには、通常JPGやPNGなどの形式の画像と、各画像に何が写っているかを示すアノテーションが含まれます。多くの場合JSONまたはTXTファイルとして保存されるこれらのアノテーションは、モデルが効果的に学習するために必要なラベルとコンテキストを提供します。
しかし、トレーニングはモデルにデータを入力するだけではありません。データセットの準備から、適切なモデルの選択、トレーニングプロセスの設定まで、いくつかの重要な手順が含まれます。次に、こうした手順をいくつか詳しく見ていきましょう。
データセットの準備方法#
データセットを用意すればすぐにモデルのトレーニングを開始できるように思えるかもしれませんが、その前にデータセットの分割など、いくつかの手順が必要です。
一般に、データセットはトレーニングセット、検証セット、テストセットの3つに分割します。トレーニング画像はデータ内のパターンをモデルに学習させるために使い、検証セットはトレーニング中の性能の監視と微調整に役立ちます。
テストセットは、モデルがまったく新しい未見のデータに対してどの程度の性能を発揮するかを、最後に評価するために使います。この構成により、モデルがデータを単に暗記するのではなく、実環境の状況に汎化できるようにします。
トレーニングに適したモデルの選択#
トレーニング前のもう1つの重要な手順は、使用するモデルを選ぶことです。多くの場合、事前トレーニング済みモデルを選択します。Ultralytics YOLOモデルのようなモデルは、大規模なデータセットですでにトレーニングされ、一般的な視覚パターンを学習しているため、優れた出発点となります。
こうしたモデルを使うのは、既存の知識を活用して特定のタスクに合わせてモデルを適応させる転移学習の一例です。この方法はトレーニングの高速化と結果の改善に役立ち、特にデータが限られている場合に効果的です。
これらのモデルには異なるサイズがあり、それぞれ速度と精度のバランスが異なります。小型モデルは高速で効率的である一方、大型モデルは一般に精度が高くなりますが、より多くのコンピューティングリソースが必要です。
ビジョンモデルのトレーニングパラメーターの設定#
データセットを準備し、モデルを選択したら、次はモデルの学習方法を設定します。
コンピュータービジョンモデルは、データの処理方法、重みの更新方法、時間の経過に伴う改善方法を決める一連のパラメーターを使ってトレーニングされます。これらの設定はトレーニング速度と最終的な精度の両方に直接影響するため、高い成果を得るうえで重要です。
よく使われるトレーニングパラメーターをいくつか紹介します。
- エポック数:トレーニング中にモデルがデータセット全体を何回処理するかを表します。エポック数を増やすと、モデルがデータからパターンを学習する機会が増えます。
- バッチサイズ:1回のトレーニングステップでまとめて処理する画像の数です。バッチサイズを大きくするとトレーニングを高速化できる場合がありますが、より多くのメモリが必要です。
- 画像サイズ:トレーニングで使用する入力画像の解像度を指定します。解像度を高くすると検出精度が向上する可能性がありますが、計算コストも増加します。
- 学習率:トレーニング中にモデルが内部パラメーターを更新する速度です。値が高すぎても低すぎても、トレーニングが不安定になる可能性があります。
- オプティマイザー:各トレーニングイテレーションで算出された誤差に基づいて、モデルのパラメーターを更新するアルゴリズムです。
Ultralytics YOLOベースのワークフローでは、通常、これらの設定をYAMLファイルで定義します。このファイルには、データセットのパス、クラス名、データの分割方法を指定します。データセットをモデルがどのように解釈するかを指示する、中心的な設定ファイルとして機能します。
分断されたワークフローから、Ultralytics Platformによる統合された体験へ#
ここまで、データセットの準備からモデルの選択、トレーニングパラメーターの設定まで、コンピュータービジョンモデルのトレーニングに含まれる重要な手順をいくつか見てきました。実際には、実験の追跡、複数のトレーニング実行の比較、時間をかけた継続的なモデルの改良など、さらに多くの作業が必要になる場合があります。
こうした手順が1か所で処理されることはほとんどありません。データセットの準備はあるツールで行い、トレーニングは別の環境で実行し、実験の追跡はさらに別の場所で管理する場合があります。プロジェクトが拡大すると、こうした分断によって複雑さが増し、反復作業が遅くなり、すべてを整理しておくことも難しくなります。
Ultralytics Platformは、トレーニングのワークフロー全体を1つの環境に集約することで、この複雑さを解消します。ツールを切り替えることなく、データセットの管理、トレーニングの設定、実験の実行、結果の監視をすべて1か所で行えます。
次に、Ultralytics Platformがモデルのトレーニングをどのように効率化するのかを詳しく見ていきましょう。
Ultralytics Platformがサポートするトレーニング方法#
実環境でコンピュータービジョンモデルをトレーニングするには、柔軟な環境が必要になることがよくあります。データセットのサイズ、モデルの複雑さ、利用可能なハードウェアに応じて、クラウド、ローカルマシン、外部のノートブック環境でトレーニングを実行できます。
Ultralytics Platformは、こうしたニーズに対応するため、以下のトレーニング方法をサポートしています。
- クラウドトレーニング:Ultralyticsが管理するクラウドのGPUでトレーニングを実行します。大規模なデータセットや、多くのコンピューティングリソースを必要とする複雑なモデルに適しています。
- ローカルトレーニング:お使いのマシンで利用できるハードウェアを使用します。簡単な実験、設定のテスト、小規模なデータセットでの作業に適しています。より大規模なワークロードの場合は、AWSやGCPなどの独自のクラウド環境でもトレーニングを実行できます。
- Google Colab:Ultralytics Platformを使うと、Google Colabのホスト型ノートブック環境でトレーニングを実行できます。ローカルマシンを設定することなく、柔軟なブラウザベースのワークフローを利用できます。
Ultralytics Platformのクラウドトレーニングを詳しく見る#
コンピュータービジョンプロジェクトでは、ローカル環境やノートブック環境でモデルをトレーニングするのが常に簡単とは限りません。
たとえば、ローカルトレーニングの性能はハードウェアに完全に依存するため、コンピューティング能力が制限され、実験が遅くなる可能性があります。効率的なトレーニングにはGPUが不可欠ですが、どの環境でも安定して利用できるとは限りません。
Google Colabなどのノートブック環境は、クラウドGPUを提供する代替手段になりますが、セッションは一時的なことが多く、長時間のトレーニングが中断される可能性があります。データセットが大きくなり、ワークフローが複雑になると、こうした制約がすぐにボトルネックとなり、トレーニングの速度と信頼性が低下するおそれがあります。
Ultralytics Platformは、クラウドトレーニング機能でこうした課題に対応します。Pythonの依存関係やPyTorchなどのフレームワークが事前設定された、すぐに使える環境を提供するため、追加のセットアップなしでトレーニングを開始できます。
1つのダッシュボードからトレーニングジョブを開始し、進捗をリアルタイムで監視できます。インフラストラクチャの管理ではなく、モデルの改善に集中しやすくなります。
それでは、Ultralytics Platformでクラウドトレーニングを始める方法を見ていきましょう。
ステップ1:ベースモデルを選択する#
最初のステップは、トレーニング実行に使用するベースモデルの選択です。事前トレーニング済みのUltralytics YOLOモデルを選択するか、コミュニティモデルを複製するか、独自の事前トレーニング済み重みをアップロードして、独自の要件に対応できます。
プラットフォームは、Ultralytics YOLO26、Ultralytics YOLO11、Ultralytics YOLOv8、Ultralytics YOLOv5を含む、すべてのUltralytics YOLOモデルをサポートしています。各モデルには、nano(n)、small(s)、medium(m)、large(l)、extra-large(x)など、異なるサイズのバリエーションがあります。モデルのバリエーションごとに速度と精度のバランスが異なるため、性能やコンピューティング要件に合ったモデルを選択できます。
これらのモデルは、物体検出、インスタンスセグメンテーション、画像分類、回転バウンディングボックス(OBB)検出、姿勢推定など、Ultralytics YOLOユーザーにおなじみのさまざまなコンピュータービジョンタスクをサポートしています。
独自の要件がある場合は、事前トレーニング済みモデルの重みをアップロードすることもできます。これにより、ゼロから始めるのではなく、物体検出器などの既存モデルをプラットフォーム上で継続してトレーニングしたり、ファインチューニングしたりできます。別の場所ですでにモデルをトレーニングしている場合や、より具体的なユースケースに合わせてモデルを調整したい場合に特に便利です。
ステップ2:データセットを選択する#
次のステップでは、トレーニング用のデータセットを選択します。Ultralytics Platformでは、COCOデータセットなどの既存のデータセットを使用したり、コミュニティのデータセットを複製したり、特定の用途に合わせた独自のカスタムデータセットをアップロードしたりできます。
プラットフォームは、Ultralytics YOLOやCOCOなどの一般的なアノテーション形式をサポートしています。また、プラットフォーム上で直接カスタムデータにアノテーションを付ける場合は、未加工の画像も扱えます。
アップロードしたデータセットは、検証、正規化、ラベル解析、統計情報の生成などの処理が自動的に行われます。クラスの分布やデータセットの構造など、データをすぐに確認でき、トレーニングの準備が整っていることを確認しやすくなります。
データセットはトレーニング実行にも自動的に紐付けられるため、各モデルで使用されたデータを追跡し、実験間の一貫性を維持できます。
ステップ3:トレーニングパラメーターを設定する#
データセットを選択したら、モデルの学習方法を制御するトレーニングパラメーターを設定できます。これには、エポック数、バッチサイズ、画像サイズ、トレーニングログの実行名が含まれます。これらのパラメーターの多くは、トレーニング時間とモデルの最終的な性能の両方に影響します。
より細かくトレーニングを制御するため、プラットフォームでは学習率、オプティマイザーの種類、色のデータ拡張設定、その他のトレーニングオプションなど、高度なパラメーターも調整できます。これらの設定でトレーニングプロセスを微調整し、モデルの精度と安定性を向上させられます。
ステップ4:GPUを選択する#
次に、トレーニング実行に使用するGPUの構成を選択できます。適切なGPUは、データセットのサイズ、バッチサイズ、画像の解像度、モデルの複雑さなどの要素によって異なります。最適なバランスを見つけることで、必要以上にコンピューティングリソースを使わず、効率的にトレーニングできます。
Ultralytics Platformは、GPUのVRAM(GPU上のメモリ)容量とコンピューティング能力が異なる22種類のGPUオプションを提供し、小規模なタスクから大規模なワークロードまで対応します。
これを活用すると、軽量モデルのトレーニングから大規模で複雑なデータセットの処理まで、特定のニーズに合わせてハードウェアを選べます。利用可能なGPUの一覧については、UltralyticsのPlatformトレーニングドキュメントページをご覧ください。
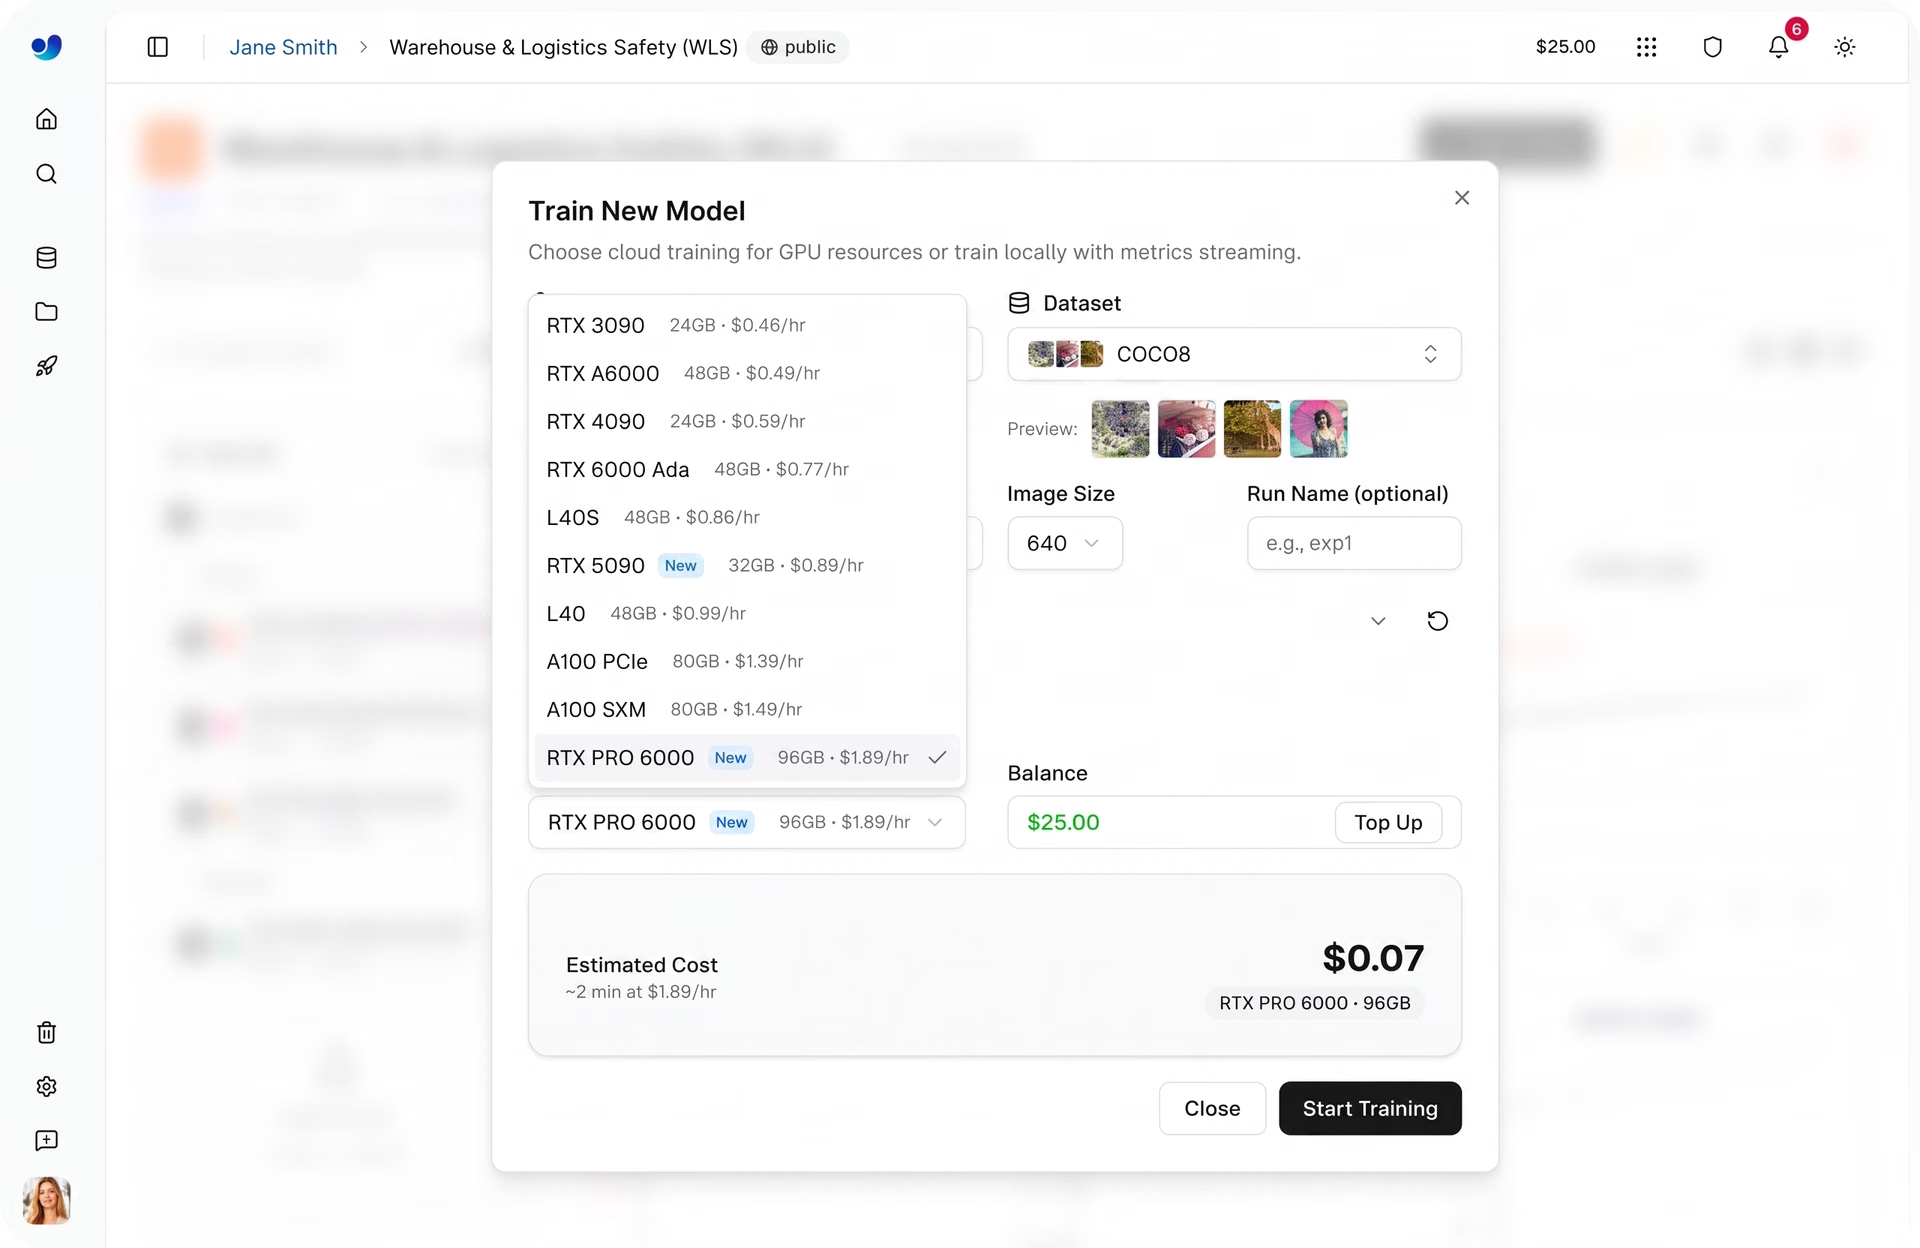
図2。Ultralytics Platformで利用できるGPUオプションの一部(出典)
ステップ5:クラウドトレーニングを開始する#
モデル、データセット、トレーニングパラメーター、コンピューティングオプションを選択すれば、トレーニング実行はすぐに開始できます。ダッシュボードからワンクリックでトレーニングを開始でき、プラットフォームが環境を初期化して、選択したGPUでジョブを実行します。
トレーニングの開始後は、プラットフォーム上で進捗を直接監視できます。Trainタブでは、性能指標、損失曲線、システム使用状況、リアルタイムのトレーニングログなど、主要な指標をリアルタイムで確認できます。
Ultralytics Platformを使ったローカルトレーニングやGoogle Colabでのトレーニングについて詳しく知りたい場合は、Ultralytics公式のPlatformドキュメントに掲載されているチュートリアルをご覧ください。
Ultralytics Platformでのモデルの評価と比較#
トレーニングが完了したら、次はモデルの性能を評価します。Ultralytics Platformでは、プロジェクト内の複数のトレーニング実行を比較できるため、実験ごとの性能を明確に把握できます。
モデル開発では、結果を改善するために、学習率、バッチサイズ、モデルサイズなどの設定を変えて、トレーニングを複数回繰り返すことがよくあります。実行ごとに少しずつ異なるモデルが生成されるため、比較が重要です。
プロジェクトは、モデルと実験をまとめて整理するための中心的な場所です。ツールやビューを切り替えることなく、進捗を追跡し、結果を確認し、作業に集中できます。
この統合ビューでは、適合率、再現率、mAP(平均適合率)などの主要な性能指標を分析し、モデルがさまざまなクラスでどの程度の性能を発揮するかを把握できます。また、トレーニング実行を並べて比較し、最良の結果につながる設定を特定できます。
これらの指標を補完するため、Predictタブを使って、トレーニング済みモデルをサンプル画像やデータで素早くテストできます。これにより、性能を視覚的に検証し、潜在的な問題を見つけやすくなります。
こうした知見をもとに、通常は「best.pt」チェックポイントとして保存される最も高性能なモデルを選択し、さらなる評価、モデルを使った推論、プラットフォーム経由でのモデルのデプロイなど、次の段階に進めます。
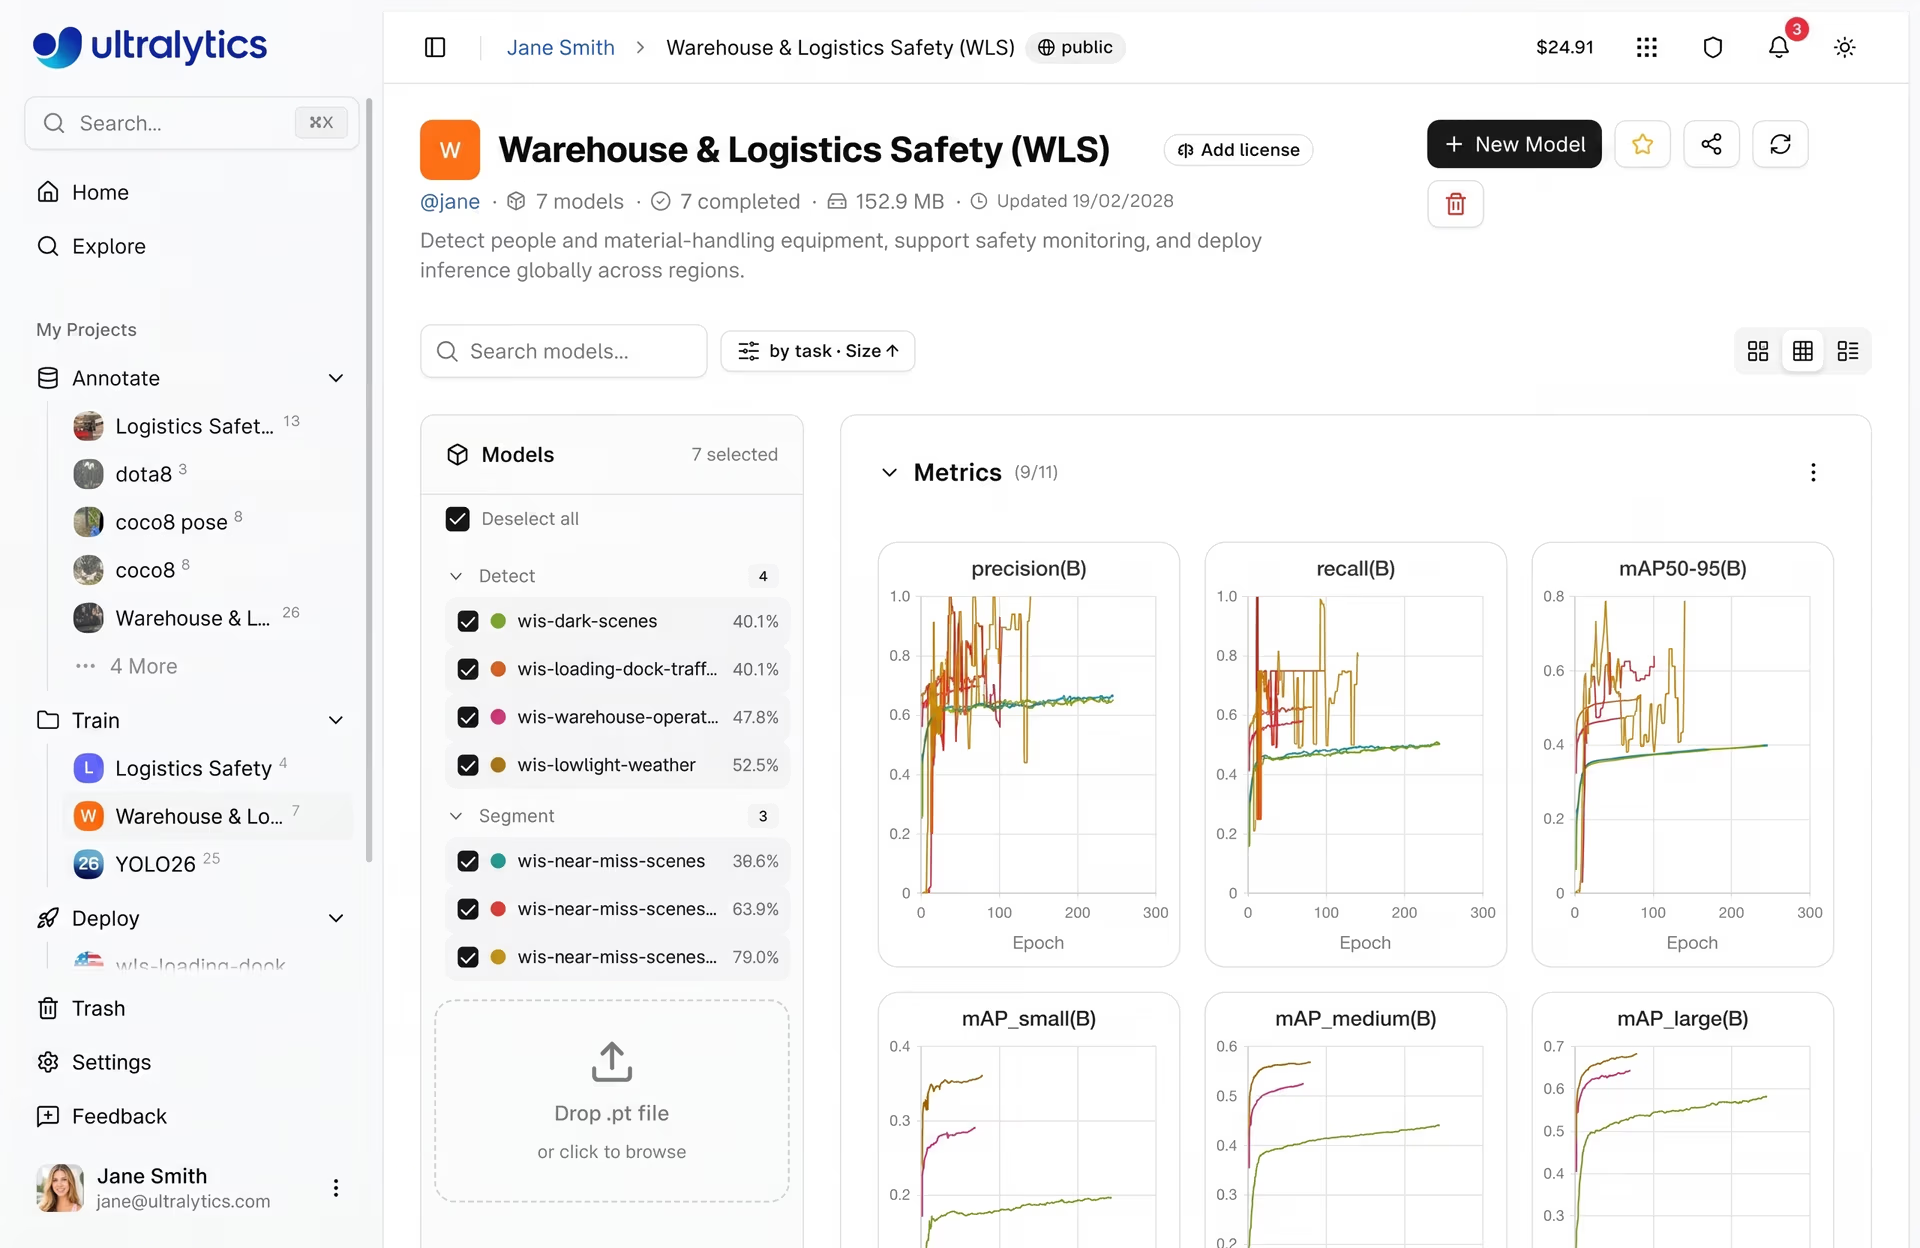
図3. Ultralytics Platformでメトリクスを表示する例(ソース)
Ultralytics Platformでトレーニングコストを見積もる#
クラウドで物体検出モデルをトレーニングすると、特に高性能GPUを利用する場合に、コンピューティングコストが発生します。より便利にご利用いただけるよう、Ultralytics Platformではトレーニング開始前にコストを見積もることができます。
予想される使用量を明確に把握できるため、トレーニングジョブを開始する前に、ワークロードの計画、予算の管理、予期しない出費の回避に役立ちます。トレーニング開始前に推定コストを確認する方法をご紹介します。
トレーニング時間の見積もり方法#
コストを正確に見積もるため、プラットフォームはまず、1エポックのトレーニングにかかる時間を計算します。この時間は、データセットのサイズ、モデルのサイズ、画像解像度、バッチサイズ、選択したGPUの速度などの要因によって変わります。
これらの入力情報をもとに、エポックあたりの推定時間を算出し、トレーニング全体の所要時間を見積もります。全エポックの所要時間に少量の起動オーバーヘッドを加えて、合計時間を計算します。
このオーバーヘッドには、環境の初期化、データセットの読み込み、GPUの準備などのタスクが含まれます。これにより、トレーニングループだけでなく、トレーニングプロセス全体を反映した見積もりになります。
トレーニングコストの計算方法#
トレーニングの合計時間を見積もった後、プラットフォームは選択したGPUの時間単価を使ってコストに換算します。
トレーニング時間とGPUの料金を組み合わせることで、実行開始前にトレーニングのコストを明確に見積もることができます。
事前にコストを把握できるため、トレーニングパラメーターの調整や別のGPUの選択など、設定を簡単に変更でき、パフォーマンスとコストのバランスをより効果的に取れます。
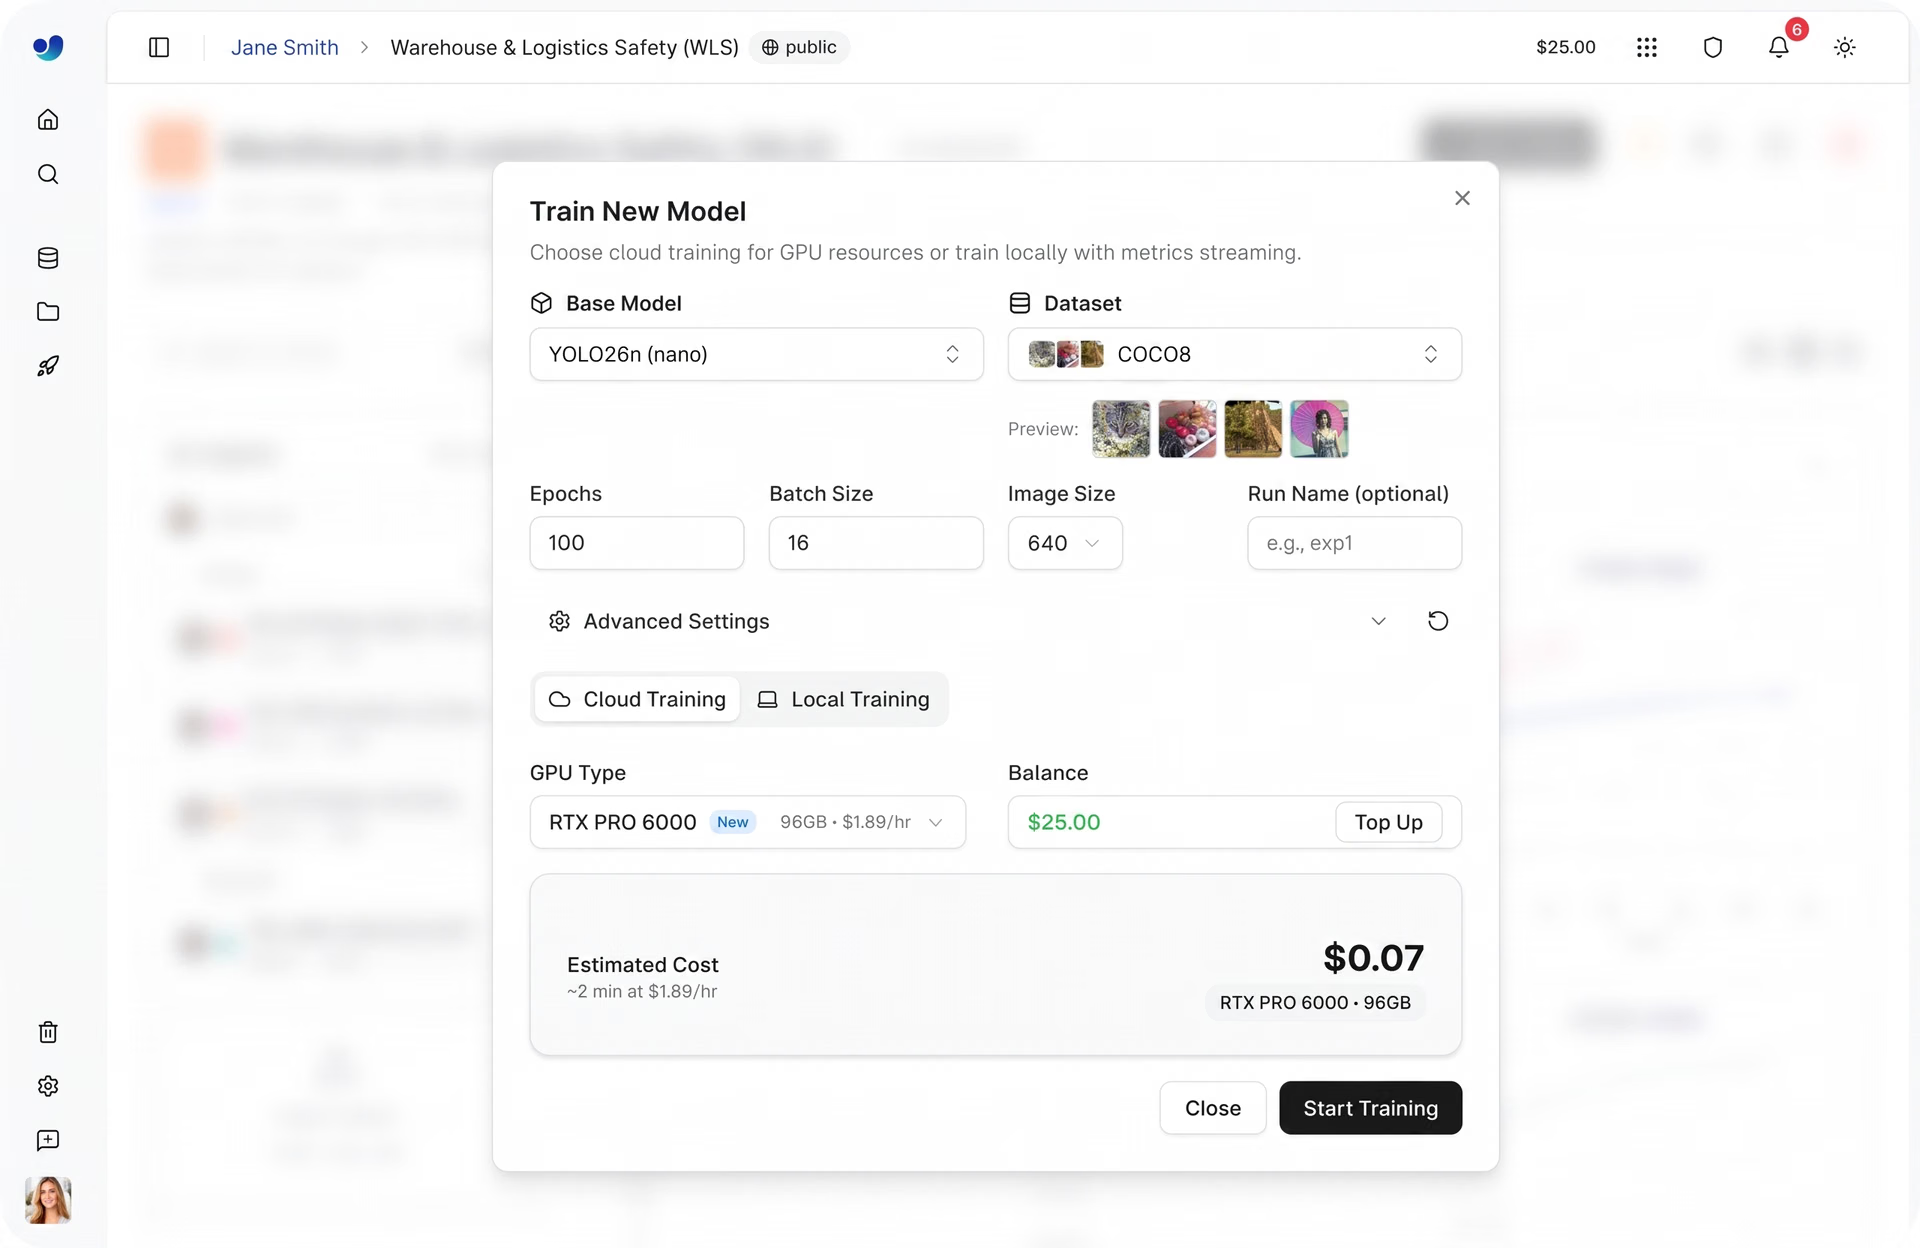
図4. Ultralytics Platformでのモデルのトレーニング設定とコスト見積もり(ソース)
Ultralytics Platformでモデルをトレーニングする主なメリット#
ここまで、コンピュータービジョンモデルのトレーニングに必要な主な手順と、Ultralytics Platformで各手順がどのように連携するかを見てきました。
これらの基本機能に加え、トレーニングワークフローを強化する機能も備わっています。Ultralytics Platformでモデルをトレーニングする主なメリットをご紹介します。
- 実験の再現性を標準搭載: すべてのトレーニング実行は、モデル、データセット、パラメーター、コンピューティング環境など、完全な構成とともに自動的に記録されます。これにより、実験を簡単に再確認し、結果を確実に再現できます。
- トレーニング中のインサイト: 最終結果を確認するだけでなく、エポックごとのパフォーマンスの変化を追跡できるため、トレーニング中のモデルの挙動をより深く理解できます。
- 運用オーバーヘッドの削減: 環境設定、依存関係の管理、インフラストラクチャをバックグラウンドで処理するため、プラットフォームを使うことで、設定作業に費やす時間を減らし、モデル開発に集中できます。
- 実験を一元管理: プロジェクトを、モデル、データセット、トレーニング実行を管理する場所として活用できます。ワークフローが複雑になっても、実験を整理された状態に保つのに役立ちます。
重要なポイント#
トレーニングは、機械学習モデルのライフサイクルにおいて最も重要な段階の一つです。モデルが視覚データをどれだけ正確に認識し、解釈できるかを決定します。
トレーニングデータの設定、モニタリング、実験の比較、コスト見積もりを一つの環境に統合することで、Ultralytics Platformは高性能なコンピュータービジョンモデルの構築からデプロイ準備までのプロセスを効率化します。
コンピュータービジョンについて詳しく知るには、活発なコミュニティとGitHubリポジトリをご覧ください。ビジョンソリューションの構築をお考えの場合は、ライセンスオプションをご確認ください。ソリューションのページでは、製造業におけるコンピュータービジョンと農業におけるAIのメリットについてご紹介しています。









