Ultralytics Platformを使ってUltralytics YOLOモデルをエクスポートする方法
Ultralytics Platformを使えば、ビジョンAIモデルを簡単にエクスポートできます。数回のクリックで、エッジ、モバイル、クラウドへのデプロイに向けてモデルを準備する方法をご紹介します。
先月、コンピュータービジョンのワークフロー全体を簡素化するために設計された統合ワークスペース、Ultralytics Platformをリリースしました。データセット管理、アノテーション、モデルのトレーニング、テスト、デプロイ、モニタリングなど、主要なビジョンAI機能を単一の使いやすいインターフェースに統合しています。
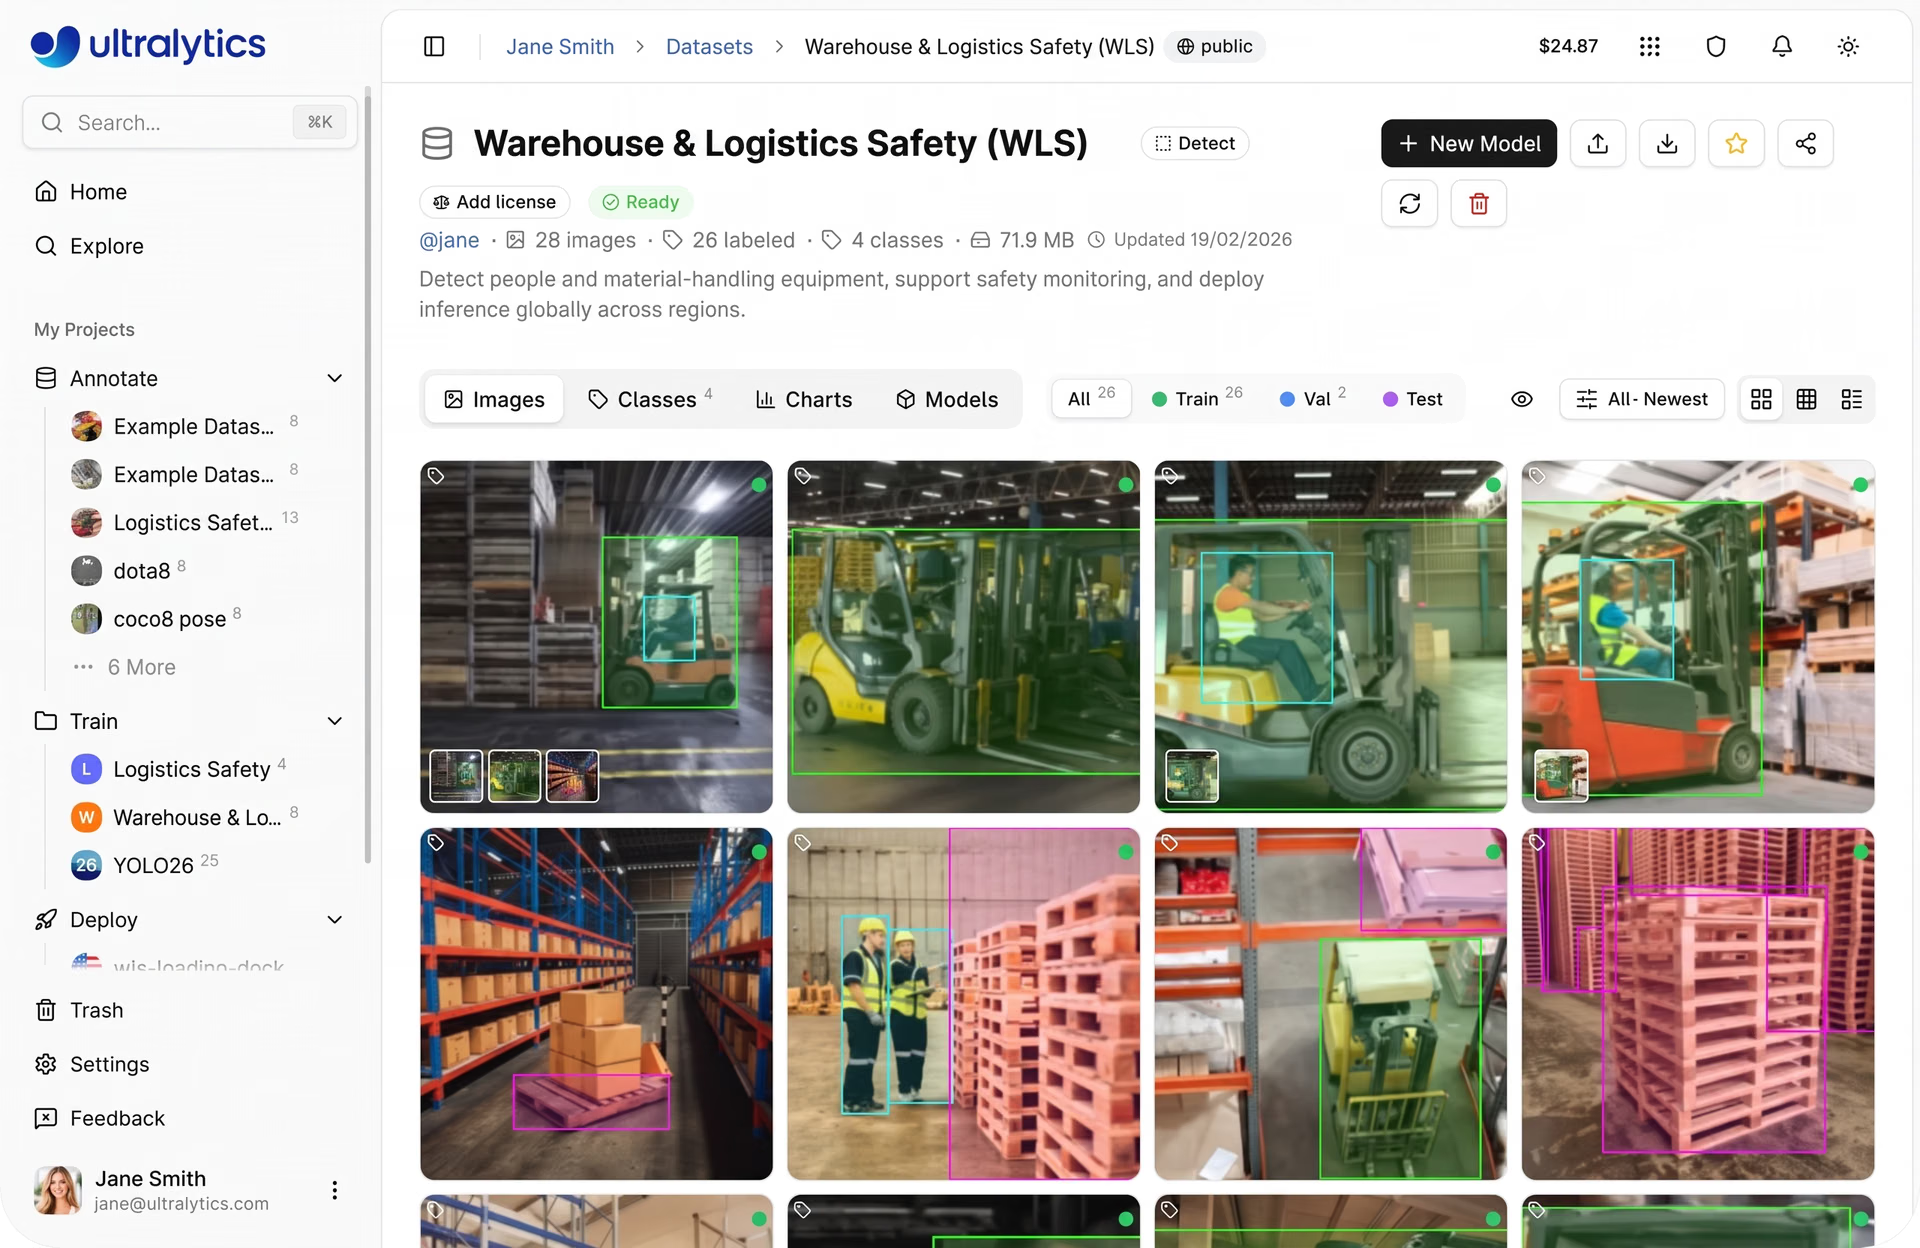
図1. Ultralytics Platformの概要(出典)
エンドツーエンドのワークフローの一環として、デプロイはモデルを実験段階から実環境での利用へ移行するうえで重要な役割を果たします。以前の記事では、APIを介した共有推論、スケーラブルな本番デプロイ向けの専用エンドポイント、エッジデバイスや外部インフラで実行するためのモデルのエクスポートなど、プラットフォームで利用できるさまざまなデプロイオプションを紹介しました。
今回は、モデルのエクスポートと、さまざまな環境へのデプロイをどのように支援するかを詳しく見ていきます。Ultralytics Platformが管理するインフラ内でモデルを実行する共有推論と専用エンドポイントとは異なり、モデルのエクスポートを使うと、エッジデバイス、モバイルアプリ、カスタムインフラなどの外部環境にモデルをデプロイして実行できます。
モデルをこれらの環境で実行するには、対象のランタイムがサポートする形式に変換する必要があります。デプロイ構成ごとに要件が異なり、モバイルやエッジデバイス向けの軽量形式から、クラウドやGPUベースのシステム向けの高性能形式まで多岐にわたります。
従来、このプロセスにはスクリプトや依存関係、複数のツールが必要で、時間がかかることがあります。Ultralytics Platformを使えば、エクスポートが大幅に簡単になります。追加のセットアップなしに、数回クリックするだけでモデルを変換して最適化できます。
この記事では、モデルのエクスポートの意味、Ultralytics Platformがサポートする形式、ユースケースに適した形式の選び方を解説します。さっそく始めましょう。
モデルのエクスポートの概要#
モデルのエクスポートとは、事前学習済みモデルまたはカスタム学習済みモデルを、元のフレームワーク外で使用できる形式に変換することです。Ultralytics YOLOモデルはPyTorchを使って構築され、ネイティブ形式で保存されます。この形式は、PyTorchエコシステム内でのトレーニング、評価、実験に適しています。
ただし、デプロイ環境では、異なるランタイムやハードウェア要件が使われることがよくあります。そのため、トレーニング時に使用した形式が、必ずしもデプロイに適しているとは限りません。
たとえば、モバイルアプリには低消費電力向けに最適化された軽量形式が必要な場合があります。一方、ブラウザベースのアプリには、Web環境で効率よく動作する形式が必要です。
カメラや組み込みシステムなどのエッジデバイスでは、コンパクトで高速なモデルが役立ちます。一方、クラウドシステムは高性能な推論を目的に設計されています。こうしたさまざまなシナリオに対応するには、モデルを互換性のある形式にエクスポートする必要があります。
モデルのエクスポートがこれまで以上に重要な理由#
現在、コンピュータービジョンモデルは、データが生成される場所に近い環境、特にエッジデバイスにデプロイされています。スマートフォンではリアルタイムのビジョンアプリケーションが動作し、CCTVカメラはデバイス上で監視を行い、自律システムは即時の意思決定に依存しています。
ただし、こうした環境へのデプロイには独自の課題があります。エッジデバイスは計算能力が限られており、厳しいレイテンシ要件や、メモリとエネルギー消費の制約があります。十分なリソースを使ってトレーニング中に高い性能を発揮するモデルでも、こうした制限下では効率よく動作しない場合があります。
モデルを適切な形式にエクスポートすると、こうした課題への対応に役立ちます。モデルを適切に変換することで、速度を最適化し、サイズを小さくして、特定のハードウェアとの互換性を確保できます。
同時に、エクスポートによって柔軟性も得られます。特定の要件に合わせて複数の形式に変換すれば、同じモデルをさまざまなデプロイ環境に適応させることができます。
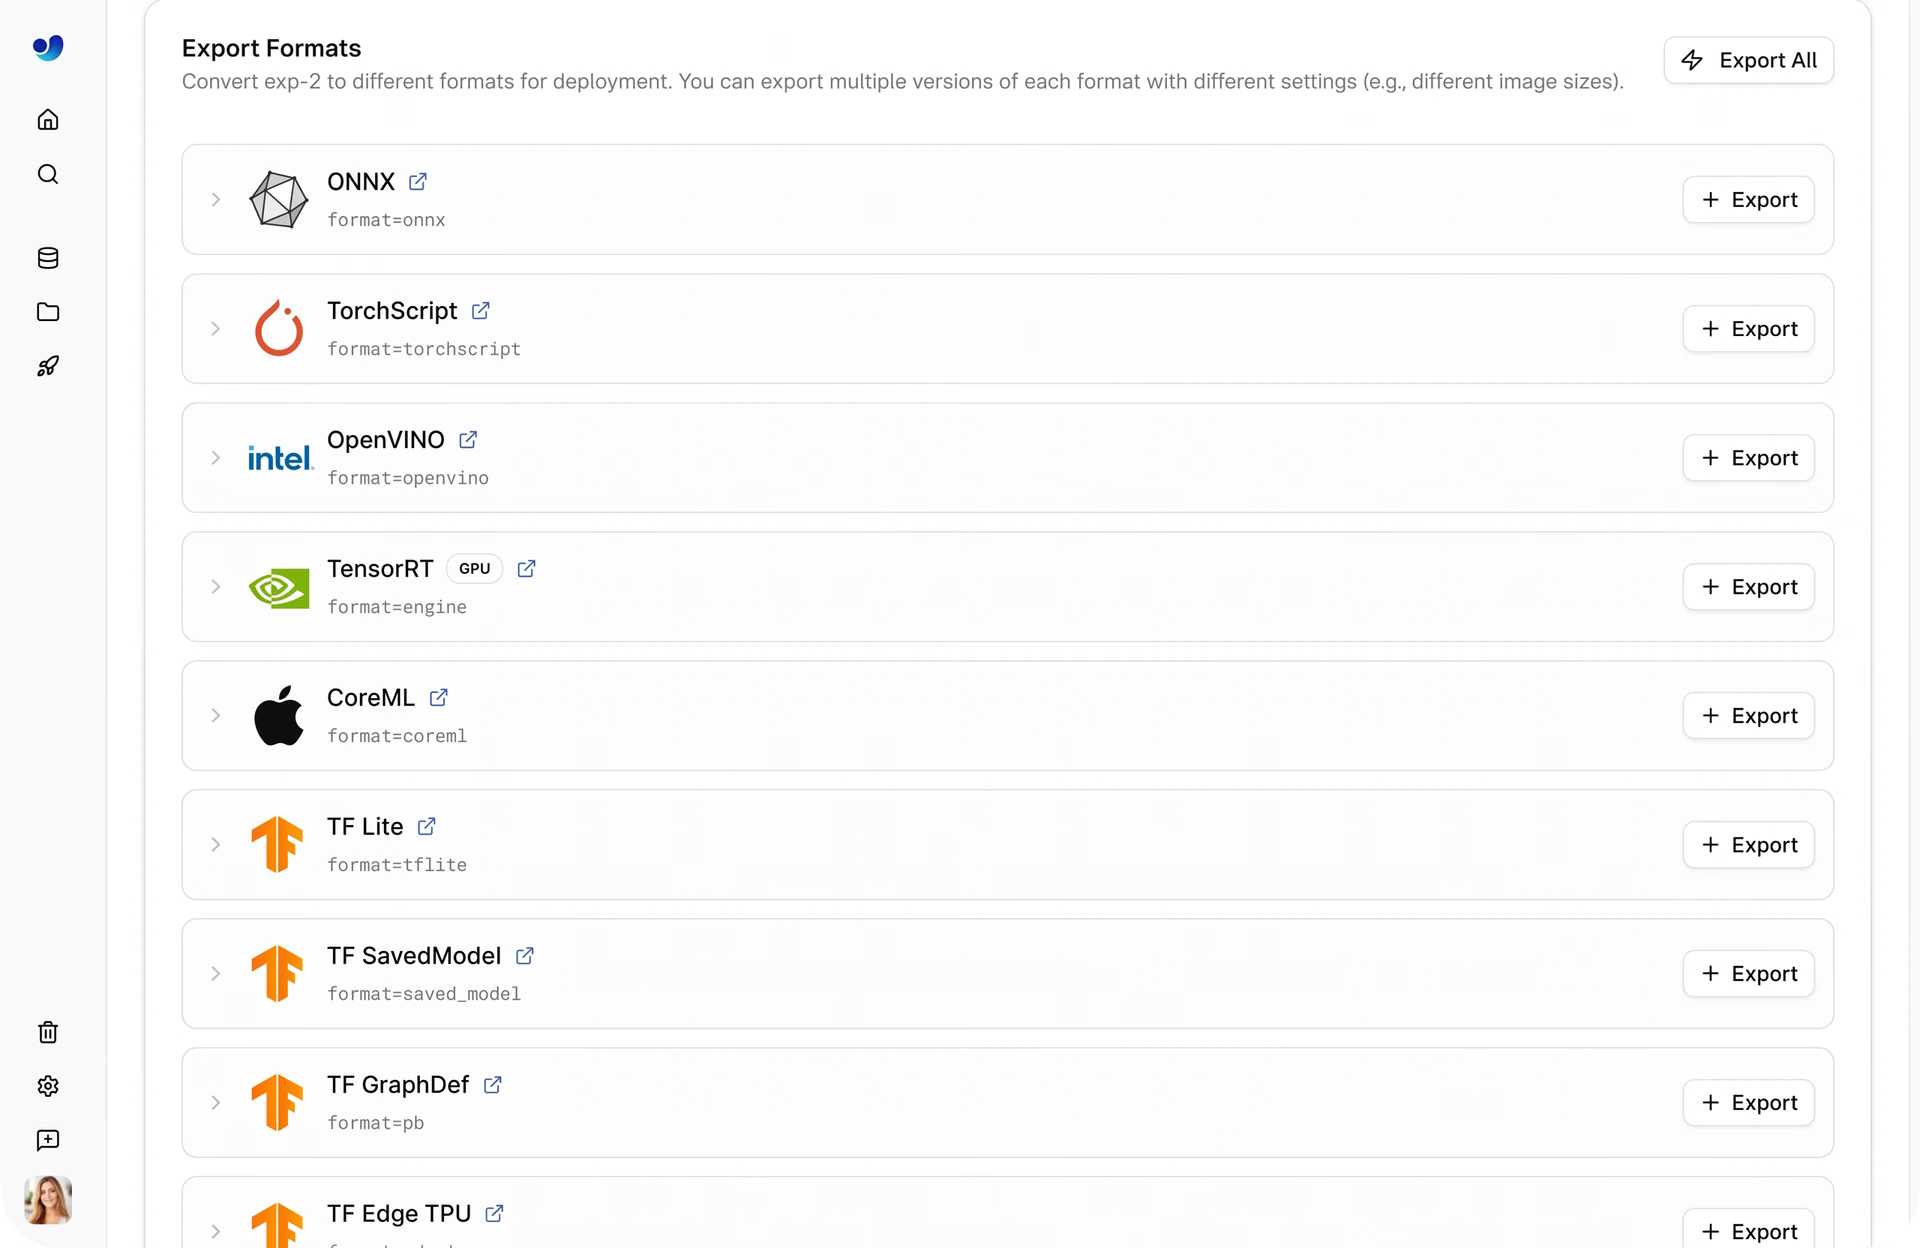
図2. Ultralytics Platformで利用できるエクスポート形式の一部(出典)
たとえば、NCNNモデル形式は、リソース使用量を抑えながらモバイルやエッジデバイスで動作するように最適化されています。一方、OpenVINO形式はIntelハードウェア向けに最適化されており、中央処理装置(CPUs)、グラフィックス処理装置(GPUs)、ニューラル処理装置(NPUs)で優れた性能を発揮します。
多くの場合、このような柔軟性を実現するには、手動変換や依存関係の管理、複数のツールへの対応が必要で、プロセスが複雑になり時間もかかっていました。Ultralytics Platformはモデルのエクスポートをより利用しやすく、管理しやすくすることで、このワークフローを効率化します。
Ultralytics Platformがモデルのエクスポートを簡素化する方法#
通常、モデルのエクスポートは、コンピュータービジョンのワークフローにおける独立した複雑なステップとして扱われます。Ultralytics Platformでは、トレーニングからデプロイまでを網羅する単一のワークスペースにモデルのエクスポート機能を直接統合しています。
主な利点の一つは、コード不要でエクスポートできることです。スクリプトの作成や環境の管理、フレームワーク固有のコマンドの使用は必要ありません。わかりやすいインターフェースから、数回クリックするだけでモデルをエクスポートできます。
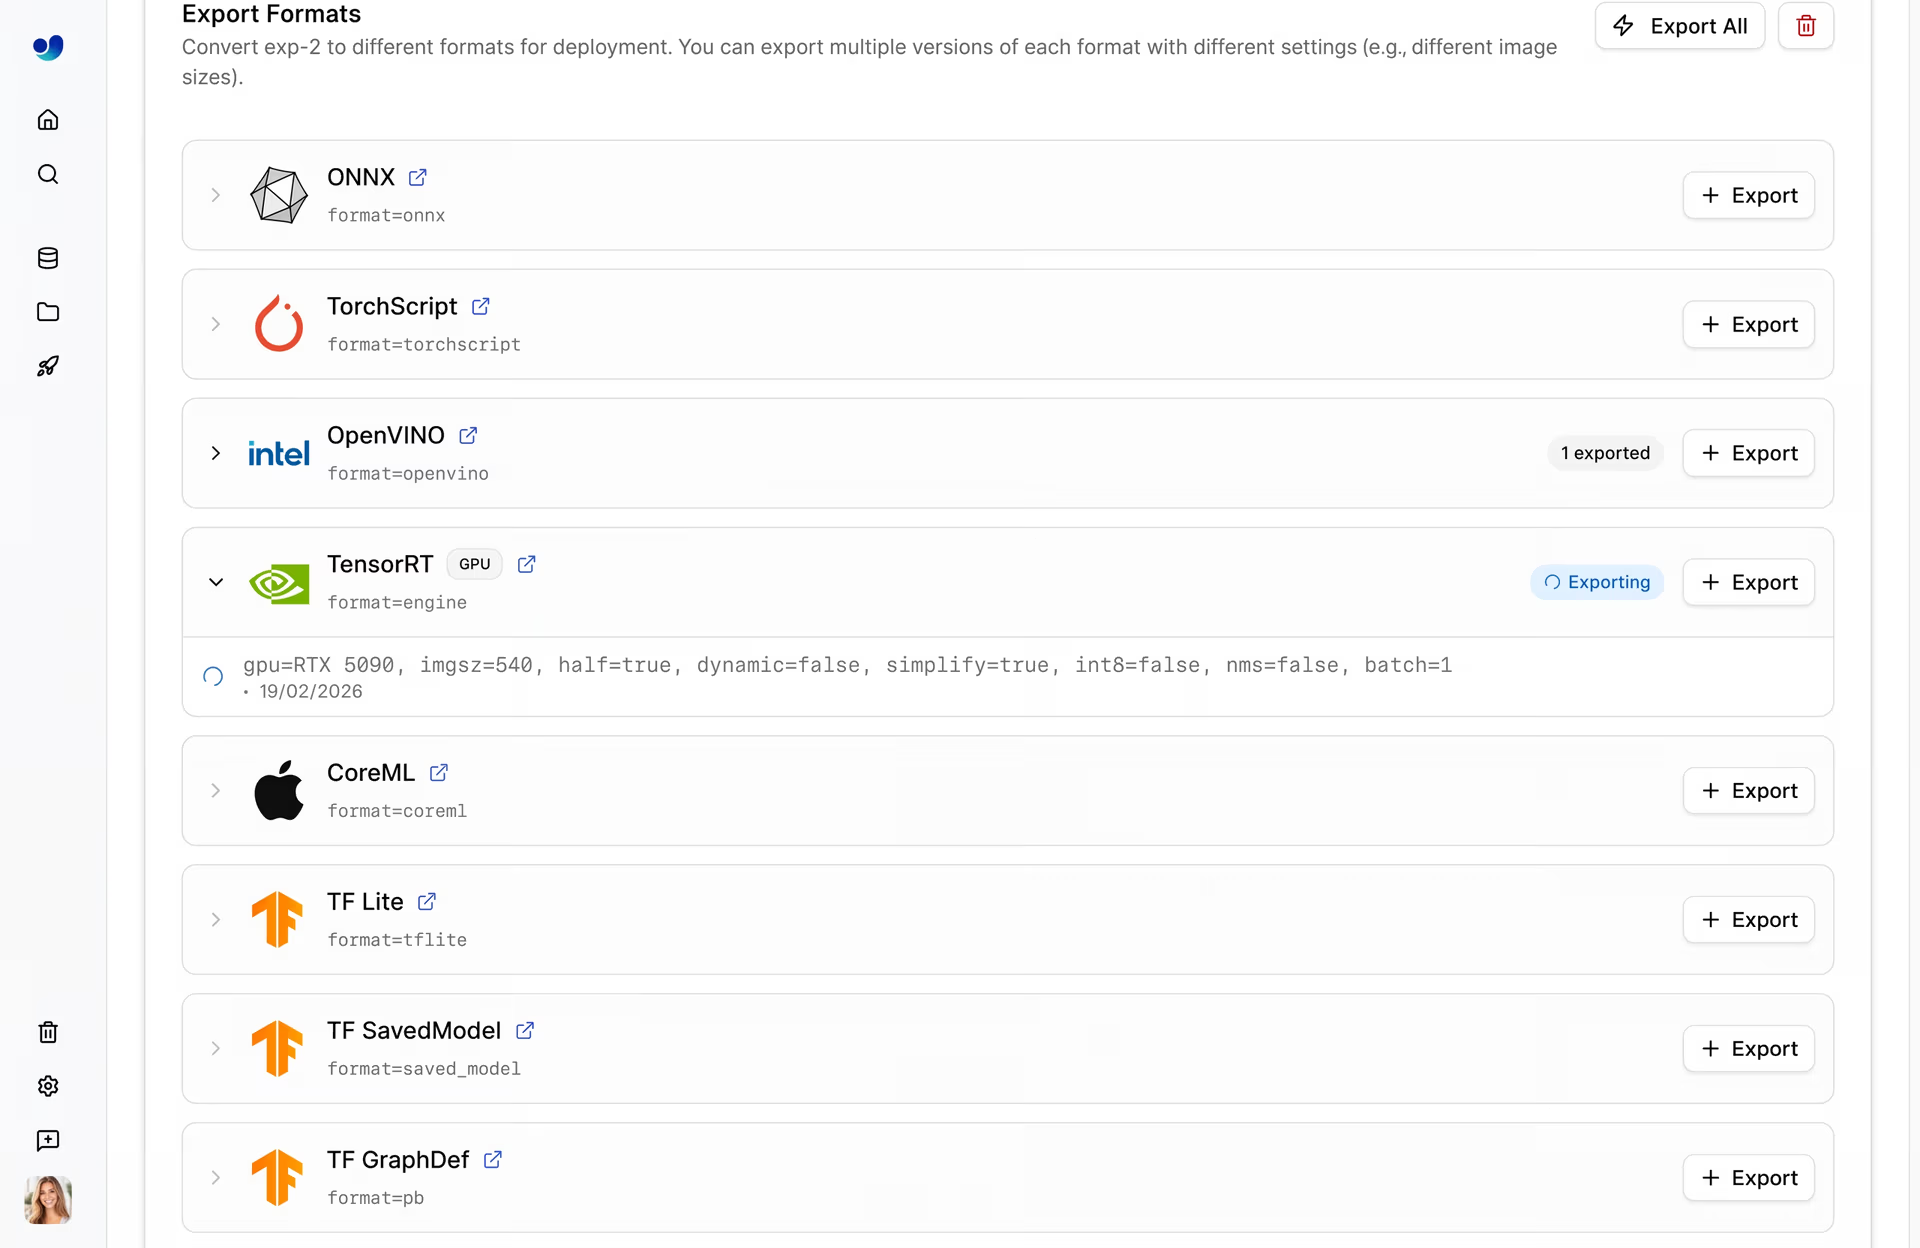
図3. Ultralytics Platformからモデルをエクスポートする例(出典)
プラットフォームが複雑な処理をバックグラウンドで担います。通常は複数のツールと手動セットアップが必要なタスクが、単一のプロセスにまとめられています。追加の依存関係をインストールしたり、互換性の問題に対処したりする必要がないため、学習済みモデルを本番環境ですぐに使えるソリューションへと簡単に移行できます。
Ultralytics Platformがサポートするモデルのエクスポート形式#
Ultralytics Platformは21種類のエクスポート形式をサポートしており、複雑さを増すことなく、幅広いデプロイ環境に向けてモデルを簡単に準備できます。
ここでは、よく使われるエクスポート形式をいくつか紹介します。
- クロスプラットフォームと相互運用性: ONNXとTorchScriptは、さまざまなフレームワークや環境でモデルを実行するために広く使われています。ONNXはエコシステム間の橋渡しとなり、ツール間でモデルを移行しやすくします。一方、TorchScriptを使うと、Pythonランタイムを必要とせずに本番環境でPyTorchモデルを実行できます。
- GPUでの高性能推論: TensorRTはNVIDIA GPU向けに設計されており、低レイテンシと高スループットを実現するモデルの最適化に重点を置いています。精度の削減やレイヤーの融合などの手法に対応して推論を高速化するため、リアルタイムアプリケーションや大規模な本番環境に適しています。
- モバイルとエッジへのデプロイ: CoreML、LiteRT(TensorFlow Lite)、NCNNは、計算能力とメモリが限られたデバイス向けに最適化されています。これらの形式はモデルサイズを小さくし、効率を高めることで、スマートフォン、組み込みシステム、エッジハードウェアでの円滑な動作を可能にします。CoreMLは通常Appleのエコシステムで使用され、LiteRTはAndroidで広く使われています。
- ハードウェアに最適化された実行: OpenVINOは、CPU、GPU、VPUなどのIntelハードウェア向けに最適化されており、これらのデバイスでの推論速度と効率の向上に役立ちます。このようなハードウェア固有の形式は、特定のシステムで最高の性能を引き出す必要がある場合に有用です。
- フレームワーク固有のランタイムと特化型ランタイム: PaddlePaddleやExecuTorchなどの形式は、特定のエコシステムやデプロイのニーズに対応しています。エッジデバイス上でモデルを効率よく実行したり、特定のディープラーニングスタックと統合したりする用途が含まれます。
Ultralytics Platformでモデルをエクスポートする方法#
Ultralytics Platformでのモデルのエクスポートは、UIを使ったシンプルなプロセスです。スクリプトやコマンドラインツールを使わずに、インターフェースからワークフロー全体を実行できます。
プラットフォームを使ってモデルをエクスポートする手順は次のとおりです。
- ログインしてモデルを選択: プロジェクトに移動し、エクスポートする学習済みモデルを開きます。
- Exportタブに移動: モデルのダッシュボードでExportタブをクリックし、利用可能なエクスポートオプションを表示します。
- エクスポート形式を選択: デプロイの要件に応じて、ONNX、TensorRT、CoreMLなどの形式を選択します。
- エクスポート設定を構成(任意): 画像サイズ、精度、バッチサイズなどのパラメーターを調整して、性能を最適化します。
- エクスポートを開始: 「Start Export」をクリックして処理を開始します。プラットフォームが自動的に変換を行います。
- エクスポートしたモデルをダウンロード: エクスポートが完了したら、モデルをダウンロードしてデプロイパイプラインで使用できます。
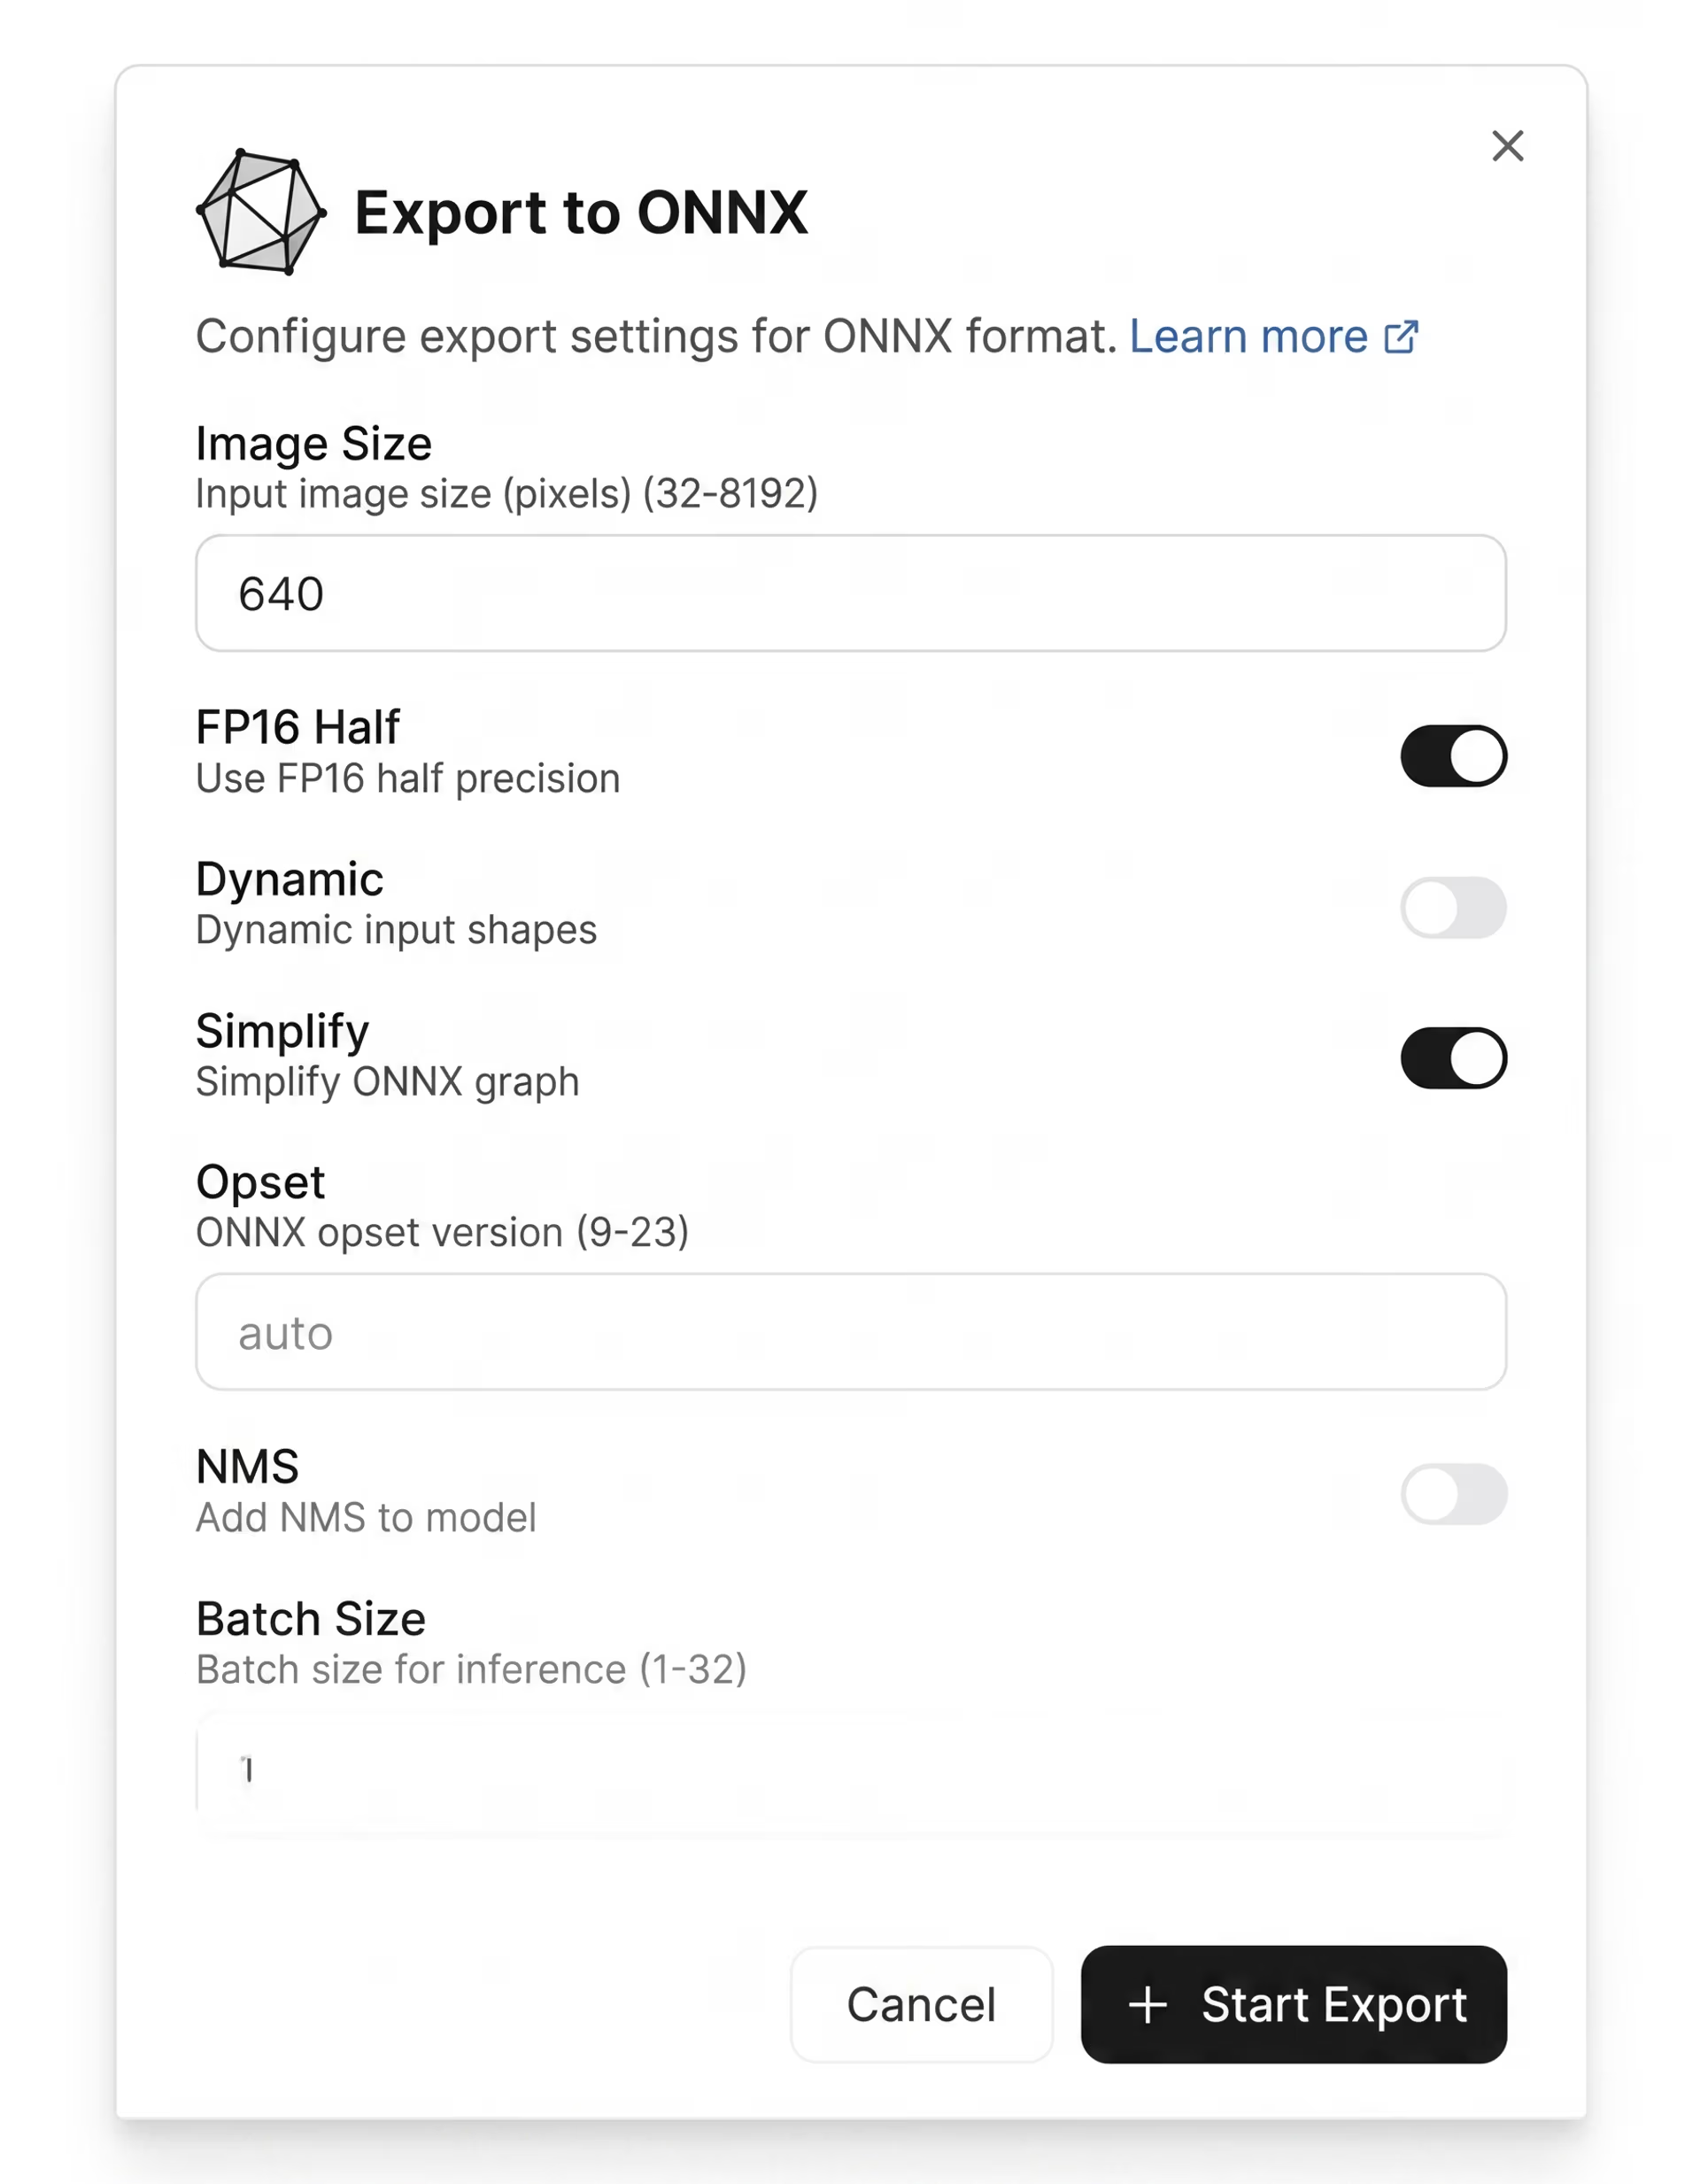
図4. Ultralytics Platformでエクスポート設定を構成する画面
適切なエクスポート形式の選び方#
Ultralytics Platformがサポートするさまざまなエクスポート形式を見ていくと、どれを選べばよいか迷うかもしれません。選択は、モデルをどこでどのように使う予定かによって異なります。
考慮すべき要素をいくつか紹介します。
- レイテンシ要件: 動画分析や自律システムなどのリアルタイムアプリケーションでは、低レイテンシが不可欠です。TensorRTのような高性能推論向けに最適化された形式が、適していることがよくあります。
- ハードウェアの制約: 携帯電話や組み込みシステムなど、メモリや処理能力が限られたデバイスには、LiteRTやNCNNのような軽量形式が必要です。
- モデルサイズと消費電力: エッジデバイスを使用する場合は、モデルサイズと消費電力が重要になります。最適化された小型モデルは、リソースを使い果たすことなく安定した性能を確保するのに役立ちます。
- デプロイ環境: モデルを複数のプラットフォームで実行する必要がある場合、ONNXのような形式が柔軟性をもたらします。iOSアプリなどプラットフォーム固有の用途には、CoreMLが適していることがよくあります。
あらゆる用途に最適な単一の形式はありません。性能、互換性、対象環境の制約のバランスをどう取るかが重要です。Ultralytics Platformでは、余計な手間をかけずにさまざまな形式を試して比較できるため、選択が容易になります。
重要なポイント#
エクスポートは、さまざまな環境でモデルを実際に使用できるように準備するうえで重要なステップです。Ultralytics Platformを使えば、追加のセットアップや複雑な作業をせずにモデルを変換して最適化できるため、このプロセスが大幅に簡単になります。ユースケースに適した形式を選ぶことで、デプロイ先を問わずモデルを効率よく実行できます。
成長を続けるコミュニティに参加し、GitHubリポジトリでコンピュータービジョンについてさらに学びましょう。ロボティクスにおけるAIや物流におけるコンピュータービジョンなどのアプリケーションについて、ソリューションページをご覧ください。ライセンスオプションを確認して、ビジョンAIを使った開発を始めましょう。









