LiteRT에서 Ultralytics YOLO 내보내기
새로운 LiteRT 내보내기 통합으로 단일 통합 형식에서 Ultralytics YOLO 추론을 모바일, 임베디드, 엣지, 브라우저 환경에 적용하는 방법을 알아보세요.
Ultralytics는 클라우드 연결에 의존하는 대신, 필요한 기기에서 직접 컴퓨터 비전 모델을 실행하는 흐름이 점차 확산되는 것을 확인하고 있습니다. 모바일 앱, 임베디드 시스템, IoT 센서, 브라우저 기반 도구는 점점 더 로컬에서 추론을 실행해야 하며, 전력 및 연산 리소스가 제한된 하드웨어에서 실행해야 하는 경우가 많습니다. 이에 Ultralytics YOLO 모델을 이제 LiteRT로 직접 내보낼 수 있게 되었음을 기쁜 마음으로 알려드립니다.
이러한 요구를 충족하려면 개발자가 환경마다 별도의 내보내기 파이프라인을 유지할 필요 없이 이 모든 환경에서 사용할 수 있는 모델 형식이 필요합니다.
이 기능은 이전에도 비공식 타사 패키지를 통해 제공되었지만, 이번 통합은 Google과의 공식 협업을 통해 이루어졌습니다. Ultralytics YOLO 모델을 LiteRT를 통해 TFLite로 내보내는 엔드투엔드 파이프라인을 구축하기 위해 LiteRT 팀과 긴밀히 협력했습니다. 이번 통합을 통해 한 번 내보낸 Ultralytics YOLO 모델을 모바일, 임베디드, 엣지 및 브라우저 환경 전반에 배포할 수 있습니다. 이전에 별도로 처리되던 TFLite 및 TF.js 내보내기 형식을 하나의 간소화된 형식으로 통합합니다.
LiteRT란 무엇인가요?#
LiteRT(Lite Runtime의 약칭)는 기기 내 AI를 위한 Google의 고성능 런타임입니다. TensorFlow Lite(TFLite)의 차세대 버전이자 새 이름이며, 개발자에게 익숙한 기존 .tflite 모델 형식을 그대로 실행합니다.
LiteRT는 기기 내 추론, 즉 엣지 컴퓨팅을 위해 특별히 설계된 오픈 소스 프레임워크입니다. 개발자가 학습된 모델을 모바일, 임베디드 및 IoT 기기, 기존 컴퓨터에서 실행할 수 있도록 도구를 제공하며, LiteRT.js를 사용하면 웹 브라우저와 Node.js에서도 직접 실행할 수 있습니다. LiteRT 내보내기 형식은 객체 탐지, 세그멘테이션, 포즈 추정, 분류와 같은 작업에 맞게 모델을 최적화하여 다양한 기기에서 빠르게 오프라인으로 실행할 수 있도록 합니다.
Ultralytics YOLO 모델을 LiteRT로 내보내는 이유는 무엇인가요?#
이제 하나의 모델 형식으로 모든 배포 대상을 지원합니다:
• 모바일 및 임베디드. Android, iOS, 데스크톱, 임베디드 Linux 및 마이크로컨트롤러(MCU).
• 엣지 가속기. 추가 가속을 위해 Coral Edge TPU와 호환됩니다.
• 브라우저 및 Node.js. LiteRT.js는 WebGPU/WASM 가속을 통해 웹에서 동일한 .tflite 모델을 실행하므로 별도의 TensorFlow.js 내보내기가 필요하지 않습니다.
• 데스크톱
이러한 통합은 실제 프로덕션 배포에서 발생하는 마찰 요인을 줄여준다는 점에서 중요합니다. 모바일용 내보내기 파이프라인, 브라우저용 파이프라인, 엣지 가속기용 파이프라인을 각각 유지하는 대신, 이제 한 번 내보내면 LiteRT가 실행되는 모든 곳에 배포할 수 있습니다.
LiteRT 모델의 주요 기능#
• 기기 내 최적화. 데이터를 로컬에서 처리해 지연 시간을 줄이고, 개인 데이터를 전송하지 않아 개인정보 보호를 강화하며, 모델 크기를 최소화해 저장 공간을 절약합니다.
• 다양한 플랫폼 지원. Android, iOS, 임베디드 Linux, 마이크로컨트롤러 및 최신 웹 브라우저에서 실행됩니다.
• 하드웨어 가속. CPU에서는 XNNPACK을 활용하고, GPU 가속에는 OpenCL, Metal 및 WebGPU를 사용합니다. GPU 가속은 추가적인 속도 향상을 위해 기본적으로 FP16으로 실행됩니다.
• 양자화. FP32, 정적 INT8, 정적 INT16-activation 및 동적 INT8을 지원하여 정확도 손실을 최소화하면서 모델을 압축하고 추론 속도를 높입니다.
• 다양한 언어 지원. Java/Kotlin, Swift, Objective-C, C++, Python 및 JavaScript와 호환됩니다.
LiteRT 내보내기 시작하기#
Ultralytics Python 패키지와 Ultralytics Platform은 5가지 컴퓨터 비전 작업 전반에서 YOLO 모델을 학습, 평가 및 배포할 수 있는 완전하고 통합된 환경을 제공합니다. LiteRT 내보내기 형식은 내보내기, 예측 및 검증 모드를 지원하므로, 모델을 내보낸 직후 로컬에서 추론을 수행하거나 정확도를 검증할 수 있습니다.
명령 하나로 모델을 내보낼 수 있습니다:
from ultralytics import YOLO

# YOLO26 모델 로드
model = YOLO("yolo26n.pt")

# LiteRT 형식으로 모델 내보내기
model.export(format="litert") # 'yolo26n.tflite' 생성
리소스가 제한된 하드웨어에 배포하는 팀을 위해 LiteRT는 양자화 내보내기도 지원하므로, 정확도 손실을 최소화하면서 모델을 압축해 추론 속도를 높일 수 있습니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 동적 INT8: int8 가중치, FP32 활성화 - 보정 데이터가 필요하지 않음
model.export(format="litert", quantize="w8a32")

# 정적 INT8: int8 가중치 + int8 활성화 - 보정 데이터 필요
model.export(format="litert", quantize=8, data="coco8.yaml")
내보낸 모델은 바로 로드하여 추론에 사용할 수 있습니다:
from ultralytics import YOLO

# 내보낸 LiteRT 모델 로드
model = YOLO("yolo26n.tflite")

# 추론 실행
results = model("https://ultralytics.com/images/bus.jpg")
LiteRT 내보내기는 현재 Linux x86_64 및 macOS에서 지원됩니다. 내보낸 .tflite 모델 자체는 모바일, 임베디드, 엣지 및 브라우저를 포함해 LiteRT가 지원하는 모든 플랫폼에서 실행됩니다.
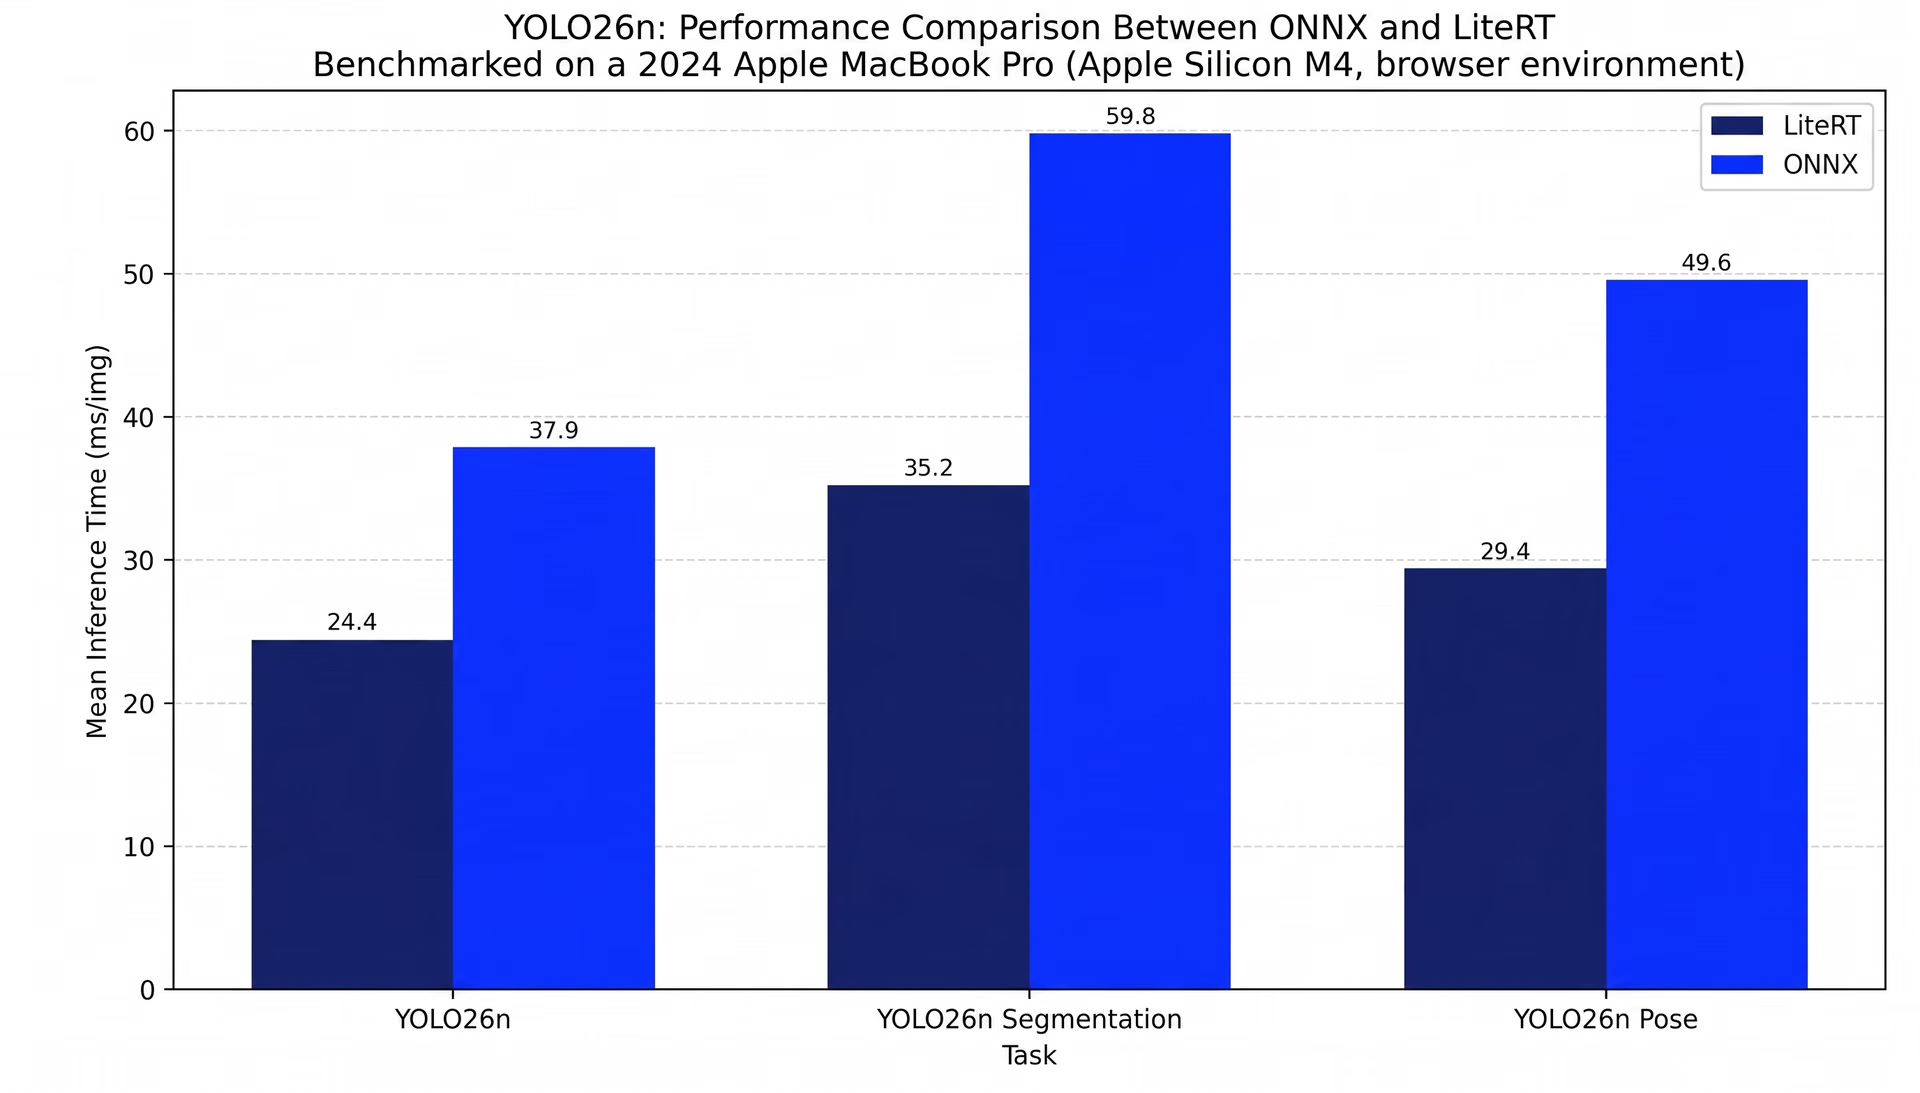 그림 1. ONNX와 LiteRT의 성능 비교.
위 이미지는 ONNX Runtime Web을 통한 WebGPU/WASM 기반 클라이언트 측 추론용 Ultralytics npm 패키지인 @ultralytics/yolo을 사용해 브라우저에서 실행한 YOLO26n의 탐지, 세그멘테이션 및 포즈 추정 평균 추론 시간을 비교합니다. 통제된 브라우저 환경에서 2024년형 Apple MacBook Pro(Apple Silicon M4)를 사용해 벤치마크를 진행했습니다.
Ultralytics YOLO를 엣지 환경으로 확장#
LiteRT를 사용하면 모바일, 임베디드, 엣지 및 브라우저 환경 전반에 Ultralytics YOLO 모델을 배포할 때 대상별로 별도의 내보내기 파이프라인을 유지할 필요가 없습니다. 하나의 내보내기, 하나의 모델 형식, 그리고 추론이 필요한 모든 환경에서 학습부터 프로덕션까지 일관된 경로를 제공합니다.
비전 AI에 관심이 있으신가요? 프로젝트에 컴퓨터 비전을 도입할 수 있는 라이선스 옵션을 확인해 보세요. GitHub 저장소에서 다양한 Ultralytics 내보내기 통합을 살펴보고, Ultralytics Platform에서 엔드투엔드 비전 AI 워크플로 구축을 시작해 보세요.









