Train model YOLO nhanh hơn với Ultralytics Platform
Tìm hiểu cách train model YOLO nhanh hơn với Ultralytics Platform, một môi trường end-to-end được xây dựng để tăng tốc lộ trình từ dữ liệu đến triển khai.
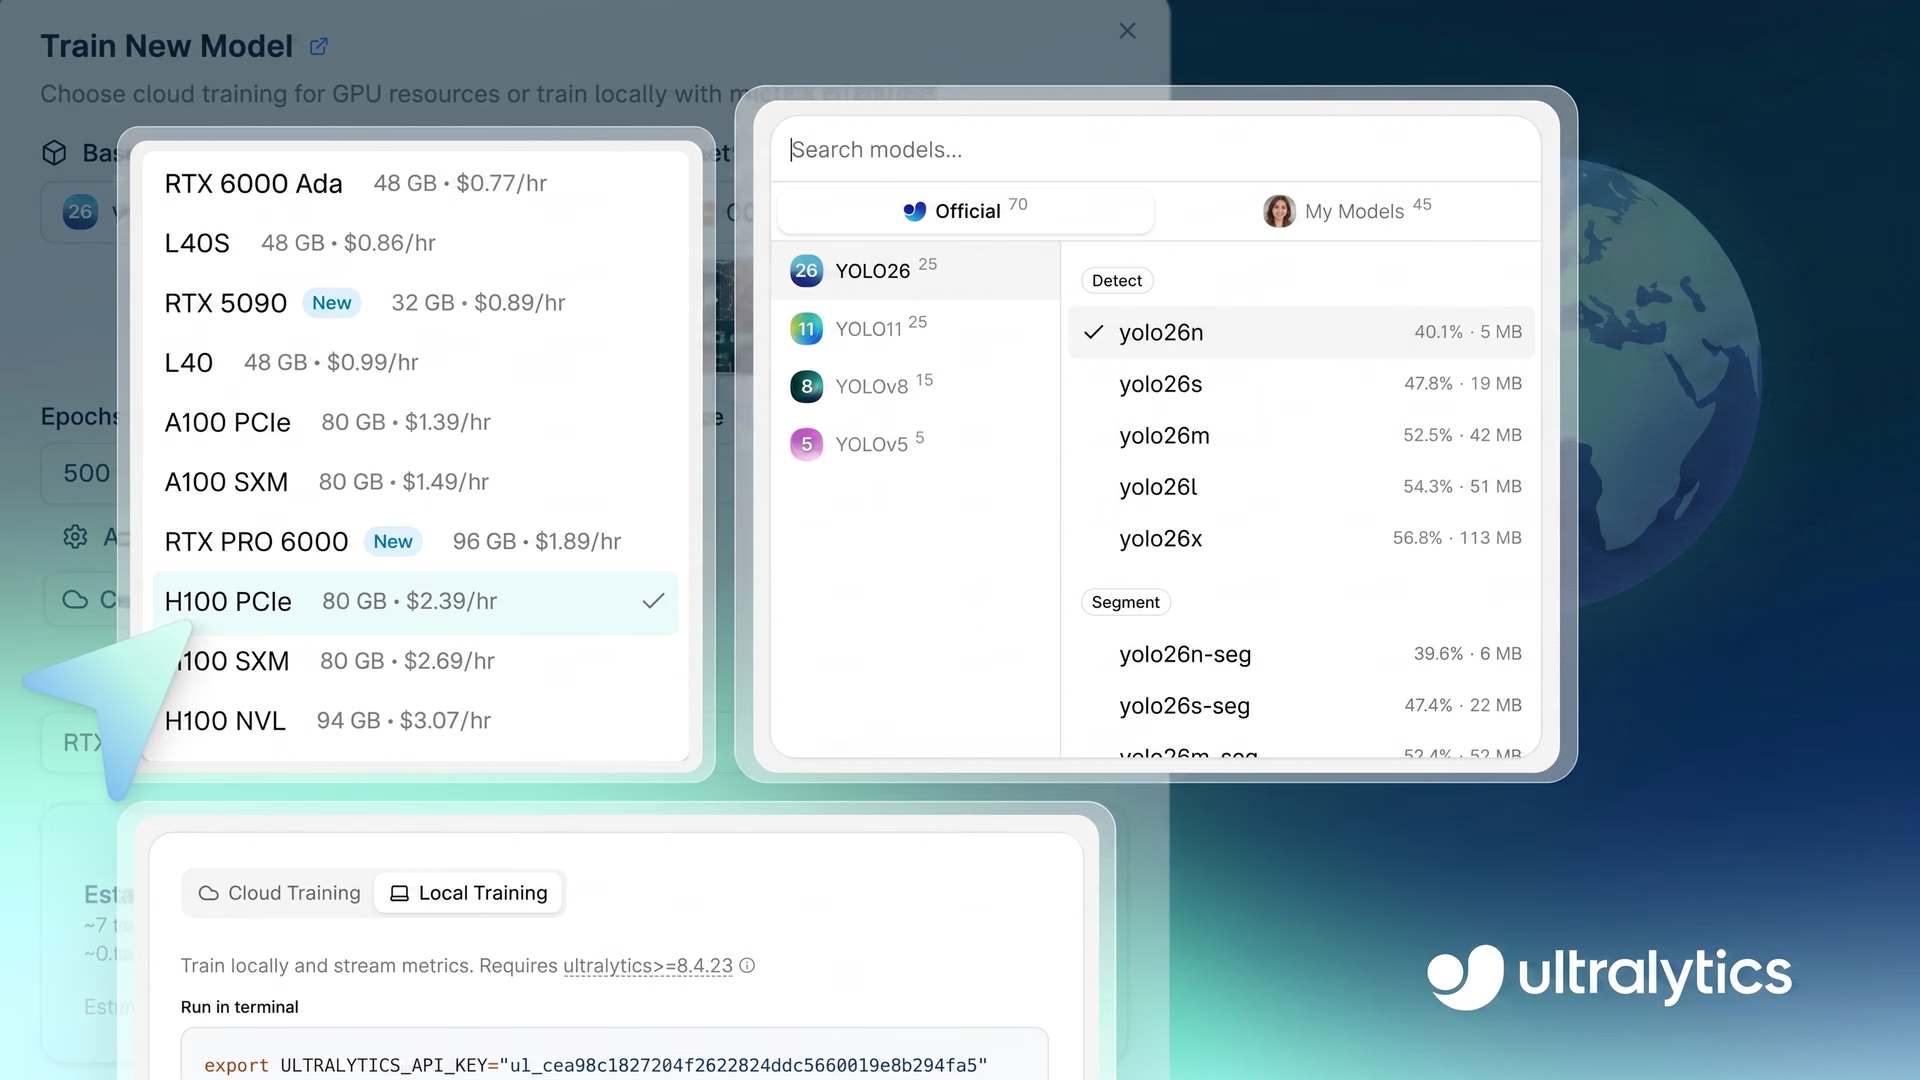
Tuần trước, Ultralytics đã giới thiệu Ultralytics Platform, một workspace hợp nhất được thiết kế để đơn giản hóa cách các nhóm xây dựng, huấn luyện và triển khai model computer vision. Thay vì phải quản lý nhiều công cụ, platform tập hợp mọi thứ vào một nơi. Việc chuyển từ ý tưởng đến triển khai các model vision AI trở nên dễ dàng hơn.
Điều này rất quan trọng vì computer vision đang nhanh chóng trở thành một phần cốt lõi của nhiều ngành công nghiệp. Công nghệ này hỗ trợ các ứng dụng như kiểm tra trong sản xuất, phân tích bán lẻ và điều hướng tự hành.
Việc biến các ứng dụng tích hợp vision thành những hệ thống đáng tin cậy phụ thuộc vào chất lượng huấn luyện model. Huấn luyện model bao gồm việc học từ dữ liệu đã gắn nhãn để model có thể nhận diện các mẫu và đưa ra dự đoán chính xác. Nhìn chung, model được huấn luyện tốt sẽ cho hiệu năng tốt hơn và kết quả đáng tin cậy hơn trong các ứng dụng thực tế.
Tuy nhiên, huấn luyện một model computer vision không phải lúc nào cũng đơn giản. Quy trình này bao gồm nhiều khía cạnh như thiết lập môi trường, lựa chọn tài nguyên tính toán phù hợp, tinh chỉnh hyperparameter và theo dõi nhiều thí nghiệm huấn luyện. Khi các bước này được phân tán trên nhiều công cụ và hệ thống, workflow huấn luyện nhanh chóng trở nên phức tạp và khó quản lý.
Ultralytics Platform giải quyết vấn đề này bằng cách đưa toàn bộ quy trình huấn luyện vào một dashboard hợp nhất duy nhất. Bạn có thể cấu hình, chạy và theo dõi các training job tại một nơi, dù đang làm việc trên cloud, máy cục bộ hay Google Colab.
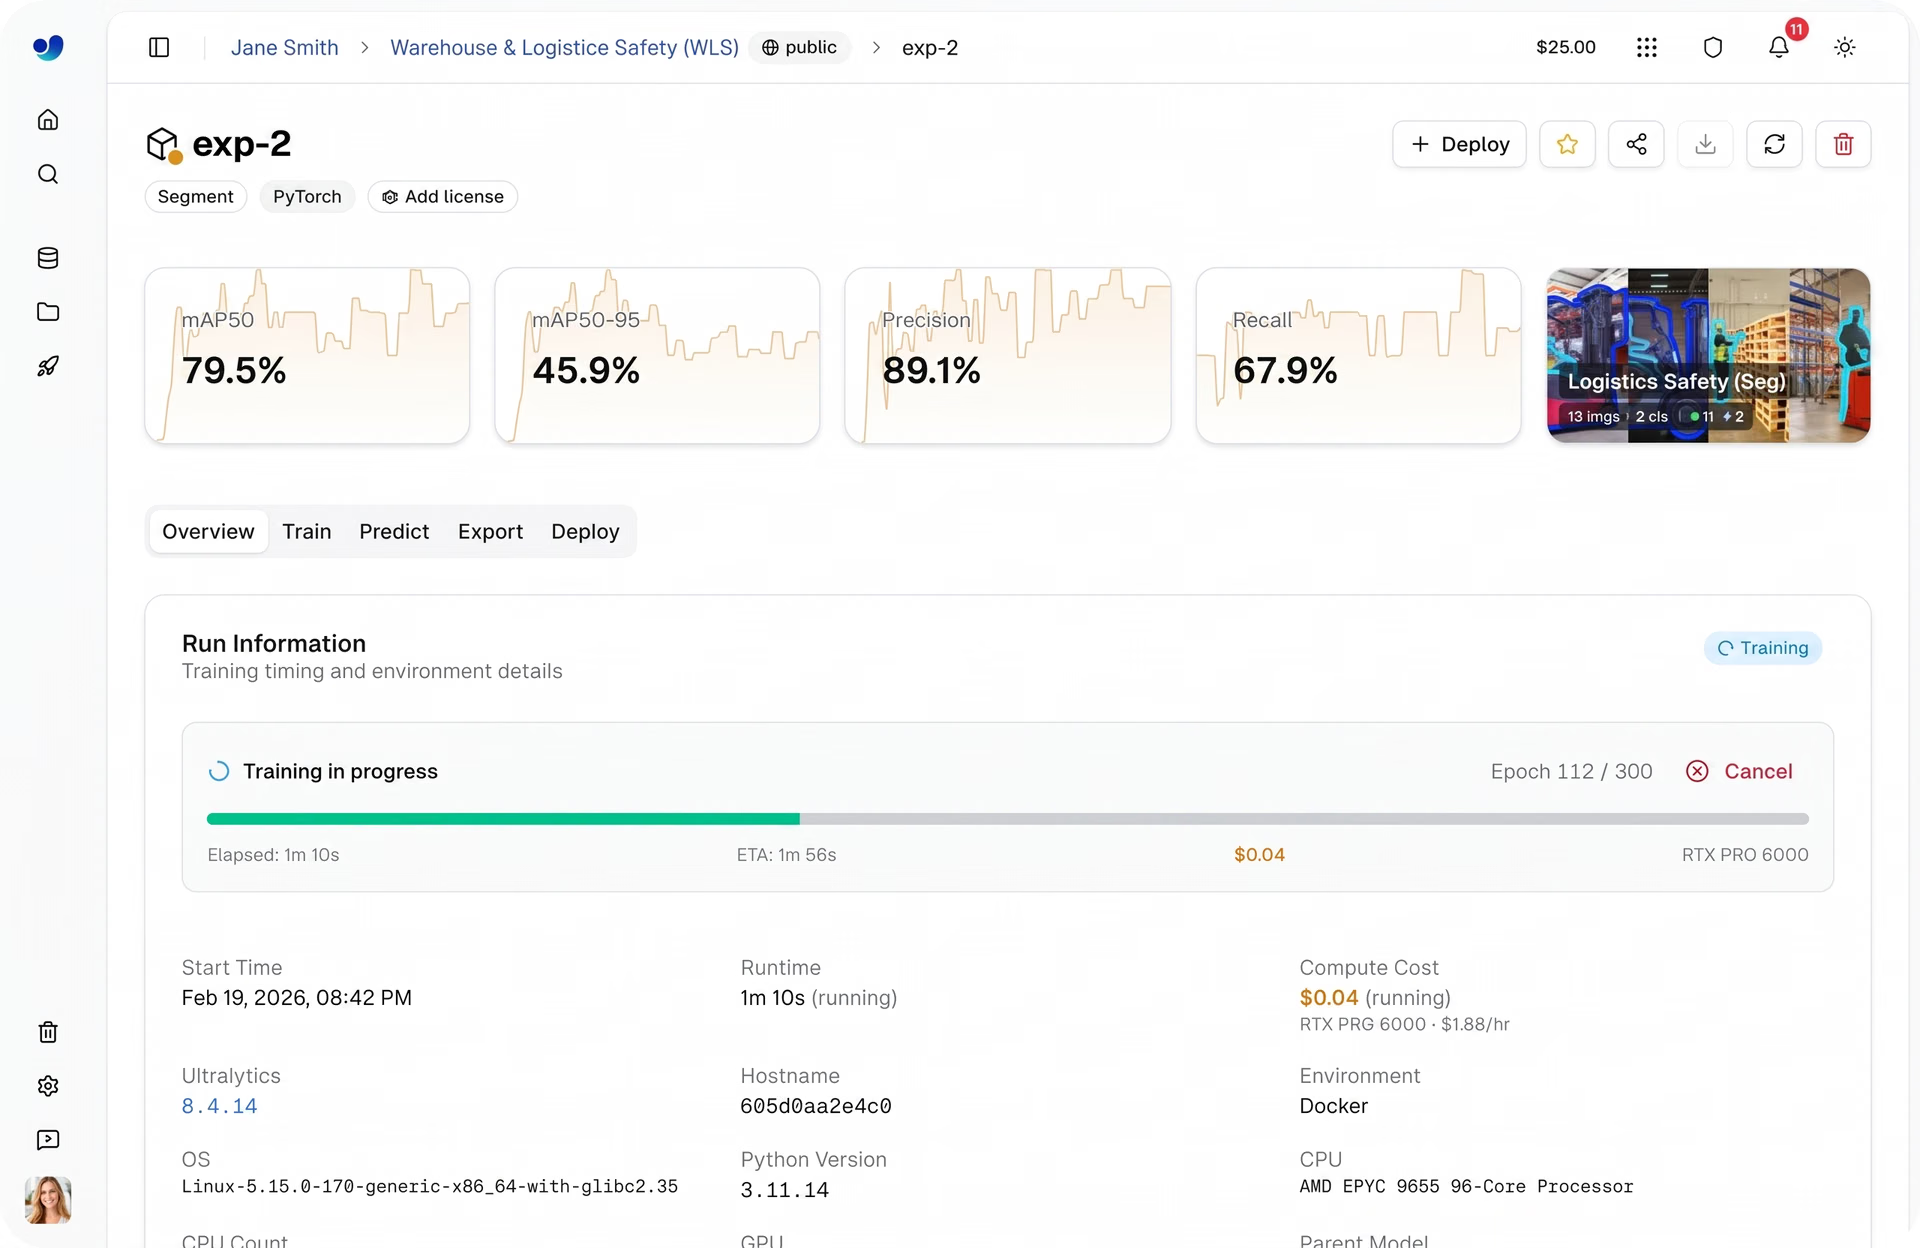
Hình 1. Khái quát về việc huấn luyện model trong Ultralytics Platform (Nguồn)
Trong bài viết này, chúng ta sẽ tìm hiểu cách Ultralytics Platform tinh gọn quy trình huấn luyện model và lý do platform có thể tạo lợi thế cho các dự án vision AI của bạn. Hãy bắt đầu!
Model computer vision học từ dữ liệu thông qua quá trình huấn luyện model#
Trước khi tìm hiểu cách huấn luyện model trên Ultralytics Platform, hãy cùng lùi lại một bước để xem huấn luyện model là gì và quy trình này bao gồm những gì.
Huấn luyện model là quá trình một model computer vision học cách diễn giải dữ liệu hình ảnh. Model phân tích hình ảnh hoặc video và dần điều chỉnh các parameter nội bộ để thực hiện chính xác các vision task như phát hiện đối tượng, phân loại hình ảnh và phân đoạn instance. Theo thời gian, model được cải thiện bằng cách học trực tiếp các mẫu từ dữ liệu mà nó quan sát.
Chất lượng huấn luyện phụ thuộc rất nhiều vào dataset. Bạn có thể hình dung dataset giống như một bộ flashcard mà giáo viên dùng để dạy học sinh, trong đó mỗi ví dụ giúp model học được những gì cần tìm kiếm.
Một dataset computer vision điển hình bao gồm hình ảnh, thường ở các định dạng như JPG hoặc PNG, cùng các annotation mô tả nội dung của từng hình ảnh. Các annotation này, thường được lưu trong file JSON hoặc TXT, cung cấp nhãn và ngữ cảnh cần thiết để model học hiệu quả.
Nhưng huấn luyện không chỉ là đưa dữ liệu vào model. Quy trình này bao gồm nhiều bước quan trọng, từ chuẩn bị dataset đến lựa chọn model phù hợp và cấu hình quá trình huấn luyện. Tiếp theo, hãy xem xét kỹ hơn một vài bước trong số đó.
Tìm hiểu cách chuẩn bị dataset#
Có thể bạn nghĩ rằng chỉ cần có dataset là có thể bắt đầu huấn luyện model ngay, nhưng trước tiên vẫn cần thực hiện một vài bước, chẳng hạn như chia dataset.
Nhìn chung, một dataset được chia thành ba phần: training set, validation set và testing set. Các hình ảnh trong training set được dùng để dạy model các mẫu trong dữ liệu, trong khi validation set giúp theo dõi và tinh chỉnh hiệu năng trong quá trình huấn luyện.
Testing set được sử dụng ở cuối để đánh giá mức độ hiệu quả của model trên dữ liệu hoàn toàn mới mà model chưa từng thấy. Cách thiết lập này giúp đảm bảo model không chỉ ghi nhớ dữ liệu mà còn có thể tổng quát hóa cho các tình huống thực tế.
Lựa chọn model phù hợp để huấn luyện#
Một bước quan trọng khác trước khi huấn luyện là chọn model bạn muốn sử dụng. Trong nhiều trường hợp, điều này đồng nghĩa với việc lựa chọn một model pretrained. Các model như model Ultralytics YOLO đã được huấn luyện trên những dataset lớn và học được các mẫu hình ảnh tổng quát, vì vậy chúng là điểm khởi đầu tốt.
Việc sử dụng các model này là một ví dụ về transfer learning, trong đó bạn tận dụng kiến thức hiện có và điều chỉnh model cho tác vụ cụ thể. Cách tiếp cận này giúp tăng tốc quá trình huấn luyện và cải thiện kết quả, đặc biệt khi làm việc với lượng dữ liệu hạn chế.
Các model này cũng có nhiều kích thước khác nhau, mỗi kích thước mang đến sự đánh đổi giữa tốc độ và độ chính xác. Model nhỏ hơn nhanh và hiệu quả hơn, trong khi model lớn hơn thường cho độ chính xác cao hơn nhưng yêu cầu nhiều năng lực tính toán hơn.
Cấu hình parameter huấn luyện cho model vision#
Sau khi đã chuẩn bị dataset và chọn model, bước tiếp theo là cấu hình cách model học.
Một model computer vision được huấn luyện bằng một tập hợp các parameter quyết định cách model xử lý dữ liệu, cập nhật weight và cải thiện theo thời gian. Các thiết lập này tác động trực tiếp đến cả tốc độ huấn luyện lẫn độ chính xác cuối cùng, vì vậy chúng rất quan trọng để đạt được kết quả tốt.
Dưới đây là một số parameter huấn luyện được sử dụng phổ biến nhất:
- Epoch: Đại diện cho số lần model đi qua toàn bộ dataset trong quá trình huấn luyện. Việc tăng số epoch mang đến cho model nhiều cơ hội hơn để học các mẫu từ dữ liệu.
- Batch size: Là số lượng hình ảnh được xử lý cùng nhau trong một bước huấn luyện. Batch size lớn hơn có thể tăng tốc huấn luyện nhưng yêu cầu nhiều memory hơn.
- Image size: Xác định độ phân giải của hình ảnh đầu vào được sử dụng trong quá trình huấn luyện. Độ phân giải cao hơn có thể cải thiện độ chính xác phát hiện nhưng làm tăng chi phí tính toán.
- Learning rate: Là tốc độ model cập nhật các parameter nội bộ trong quá trình huấn luyện. Giá trị quá cao hoặc quá thấp có thể khiến quá trình huấn luyện không ổn định.
- Optimizer: Là thuật toán chịu trách nhiệm cập nhật các parameter của model dựa trên lỗi được tính trong mỗi iteration huấn luyện.
Trong các workflow dựa trên Ultralytics YOLO, những cấu hình này thường được định nghĩa trong file YAML. File này chỉ định đường dẫn dataset, tên class và cách chia dữ liệu. Nó đóng vai trò là cấu hình trung tâm, cho model biết cách diễn giải dataset.
Từ workflow phân mảnh đến trải nghiệm hợp nhất với Ultralytics Platform#
Chúng ta vừa thảo luận một số bước quan trọng trong quá trình huấn luyện model computer vision, từ chuẩn bị dataset đến lựa chọn model và cấu hình parameter huấn luyện. Trên thực tế, quy trình thường còn mở rộng hơn, bao gồm theo dõi thí nghiệm, so sánh nhiều lần chạy huấn luyện và liên tục tinh chỉnh model theo thời gian.
Các bước này hiếm khi được xử lý tại một nơi duy nhất. Dataset có thể được chuẩn bị bằng một công cụ, các lần chạy huấn luyện được thực hiện trong một môi trường khác, còn việc theo dõi thí nghiệm được quản lý riêng. Khi dự án phát triển, sự phân mảnh này làm tăng độ phức tạp, làm chậm quá trình iteration và khiến việc tổ chức mọi thứ trở nên khó khăn hơn.
Ultralytics Platform loại bỏ sự phức tạp này bằng cách đưa toàn bộ workflow huấn luyện vào một môi trường duy nhất. Thay vì chuyển đổi giữa các công cụ, bạn có thể quản lý dataset, cấu hình huấn luyện, chạy thí nghiệm và theo dõi kết quả tại cùng một nơi.
Tiếp theo, hãy tìm hiểu cách Ultralytics Platform giúp việc huấn luyện model trở nên thông minh hơn.
Các tùy chọn huấn luyện được Ultralytics Platform hỗ trợ#
Trong các ứng dụng thực tế, việc huấn luyện model computer vision thường đòi hỏi môi trường linh hoạt. Tùy thuộc vào kích thước dataset, độ phức tạp của model và phần cứng sẵn có, bạn có thể chọn huấn luyện trên cloud, máy cục bộ hoặc thông qua các môi trường notebook bên ngoài.
Ultralytics Platform hỗ trợ các tùy chọn huấn luyện sau để đáp ứng những nhu cầu này:
- Huấn luyện trên cloud: Quá trình huấn luyện chạy trên các bộ xử lý đồ họa (GPUs) cloud do Ultralytics quản lý. Tùy chọn này phù hợp với các dataset lớn hoặc model phức tạp cần nhiều tài nguyên tính toán.
- Huấn luyện cục bộ: Tùy chọn này sử dụng phần cứng có trên máy của bạn và phù hợp cho các thí nghiệm nhanh, kiểm thử cấu hình hoặc làm việc với dataset nhỏ hơn. Đối với workload có khả năng mở rộng cao hơn, bạn cũng có thể chạy huấn luyện trong môi trường cloud riêng, chẳng hạn như AWS hoặc GCP.
- Google Colab: Với Ultralytics Platform, bạn có thể chạy huấn luyện trong môi trường notebook được lưu trữ của Google Colab, cho phép workflow linh hoạt trên trình duyệt mà không cần cấu hình máy cục bộ.
Khám phá tính năng huấn luyện trên cloud của Ultralytics Platform#
Đối với các dự án computer vision, huấn luyện model cục bộ hoặc thông qua môi trường notebook không phải lúc nào cũng dễ dàng.
Ví dụ, khi huấn luyện cục bộ, hiệu năng phụ thuộc hoàn toàn vào phần cứng của bạn, điều này có thể giới hạn năng lực tính toán và làm chậm quá trình thử nghiệm. GPU rất cần thiết để huấn luyện hiệu quả, nhưng không phải mọi thiết lập đều có quyền truy cập ổn định vào GPU.
Mặc dù các môi trường notebook như Google Colab cung cấp một lựa chọn thay thế bằng cách cung cấp GPU trên cloud, các phiên thường chỉ tồn tại tạm thời và có thể làm gián đoạn những lần chạy huấn luyện dài. Khi dataset phát triển và workflow trở nên phức tạp hơn, những hạn chế này có thể nhanh chóng trở thành bottleneck, khiến quá trình huấn luyện chậm hơn và kém tin cậy hơn.
Ultralytics Platform giải quyết vấn đề này bằng tùy chọn huấn luyện trên cloud. Platform cung cấp một môi trường sẵn sàng sử dụng, trong đó các dependency Python và framework như PyTorch đã được cấu hình trước, cho phép bạn bắt đầu huấn luyện mà không cần thiết lập thêm.
Từ một dashboard duy nhất, bạn có thể khởi chạy training job và theo dõi tiến độ theo thời gian thực. Điều này giúp bạn tập trung hơn vào việc cải thiện model thay vì quản lý infrastructure.
Bây giờ, hãy xem cách bắt đầu huấn luyện trên cloud với Ultralytics Platform.
Bước 1: Chọn model cơ sở#
Bước đầu tiên là chọn model cơ sở cho lần chạy huấn luyện. Bạn có thể chọn một model Ultralytics YOLO pretrained, clone một model cộng đồng hoặc upload weight pretrained của riêng mình để đáp ứng các yêu cầu tùy chỉnh.
Platform hỗ trợ tất cả model Ultralytics YOLO, bao gồm Ultralytics YOLO26, Ultralytics YOLO11, Ultralytics YOLOv8 và Ultralytics YOLOv5, mỗi model có các biến thể kích thước như nano (n), small (s), medium (m), large (l) và extra-large (x). Vì các biến thể model khác nhau mang đến sự đánh đổi giữa tốc độ và độ chính xác, bạn có thể chọn model phù hợp với yêu cầu về hiệu năng và năng lực tính toán.
Các model này hỗ trợ nhiều computer vision task mà người dùng Ultralytics YOLO đã quen thuộc, bao gồm phát hiện đối tượng, phân đoạn instance, phân loại hình ảnh, phát hiện hộp giới hạn định hướng (OBB) và ước lượng pose.
Nếu có yêu cầu tùy chỉnh, bạn cũng có thể upload weight model pretrained của riêng mình. Điều này cho phép bạn tiếp tục huấn luyện hoặc fine-tune một model hiện có, chẳng hạn như object detector, ngay trong platform thay vì bắt đầu từ đầu. Tính năng này đặc biệt hữu ích nếu bạn đã huấn luyện model ở nơi khác hoặc muốn điều chỉnh model cho một use case cụ thể hơn.
Bước 2: Chọn dataset#
Bước tiếp theo là chọn dataset để huấn luyện. Trên Ultralytics Platform, bạn có thể sử dụng các dataset có sẵn như dataset COCO, clone dataset từ cộng đồng hoặc upload dataset tùy chỉnh của riêng mình được thiết kế cho ứng dụng cụ thể.
Platform hỗ trợ các định dạng annotation phổ biến như Ultralytics YOLO và COCO, đồng thời có thể xử lý hình ảnh thô được upload nếu bạn dự định gắn nhãn dữ liệu tùy chỉnh trực tiếp trên platform.
Sau khi được upload, dataset sẽ tự động được xử lý, bao gồm validation, normalization, phân tích label và tạo statistics. Điều này giúp bạn ngay lập tức nắm được thông tin về dữ liệu, bao gồm phân phối class và cấu trúc dataset, đồng thời giúp đảm bảo mọi thứ đã sẵn sàng cho quá trình huấn luyện.
Dataset cũng được tự động liên kết với các lần chạy huấn luyện, cho phép bạn theo dõi dữ liệu đã được sử dụng cho từng model và duy trì tính nhất quán giữa các thí nghiệm.
Bước 3: Cấu hình parameter huấn luyện#
Sau khi chọn dataset, bạn có thể cấu hình các parameter huấn luyện kiểm soát cách model học. Các parameter này bao gồm epoch, batch size, image size và tên run cho training log. Nhiều parameter trong số này ảnh hưởng đến cả thời lượng huấn luyện và hiệu năng cuối cùng của model.
Để kiểm soát quá trình huấn luyện tốt hơn, platform cũng cho phép bạn điều chỉnh các parameter nâng cao như learning rate, loại optimizer, thiết lập color augmentation và các tùy chọn huấn luyện khác. Những thiết lập này có thể tinh chỉnh quá trình huấn luyện để cải thiện độ chính xác và độ ổn định của model.
Bước 4: Chọn GPU#
Tiếp theo, bạn có thể chọn cấu hình GPU cho lần chạy huấn luyện. Việc chọn GPU phù hợp phụ thuộc vào các yếu tố như kích thước dataset, batch size, độ phân giải hình ảnh và độ phức tạp của model. Tìm được sự cân bằng phù hợp giúp quá trình huấn luyện hiệu quả mà không sử dụng nhiều năng lực tính toán hơn cần thiết.
Ultralytics Platform cung cấp 22 tùy chọn GPU với các mức VRAM (memory trên GPU) và năng lực tính toán khác nhau, hỗ trợ từ các tác vụ nhỏ đến workload quy mô lớn.
Nhờ đó, bạn có thể ghép phần cứng với nhu cầu cụ thể, dù đang huấn luyện model nhẹ hay làm việc với dataset lớn và phức tạp. Để tìm hiểu thêm, hãy xem danh sách GPU khả dụng trên trang tài liệu huấn luyện Platform của Ultralytics.
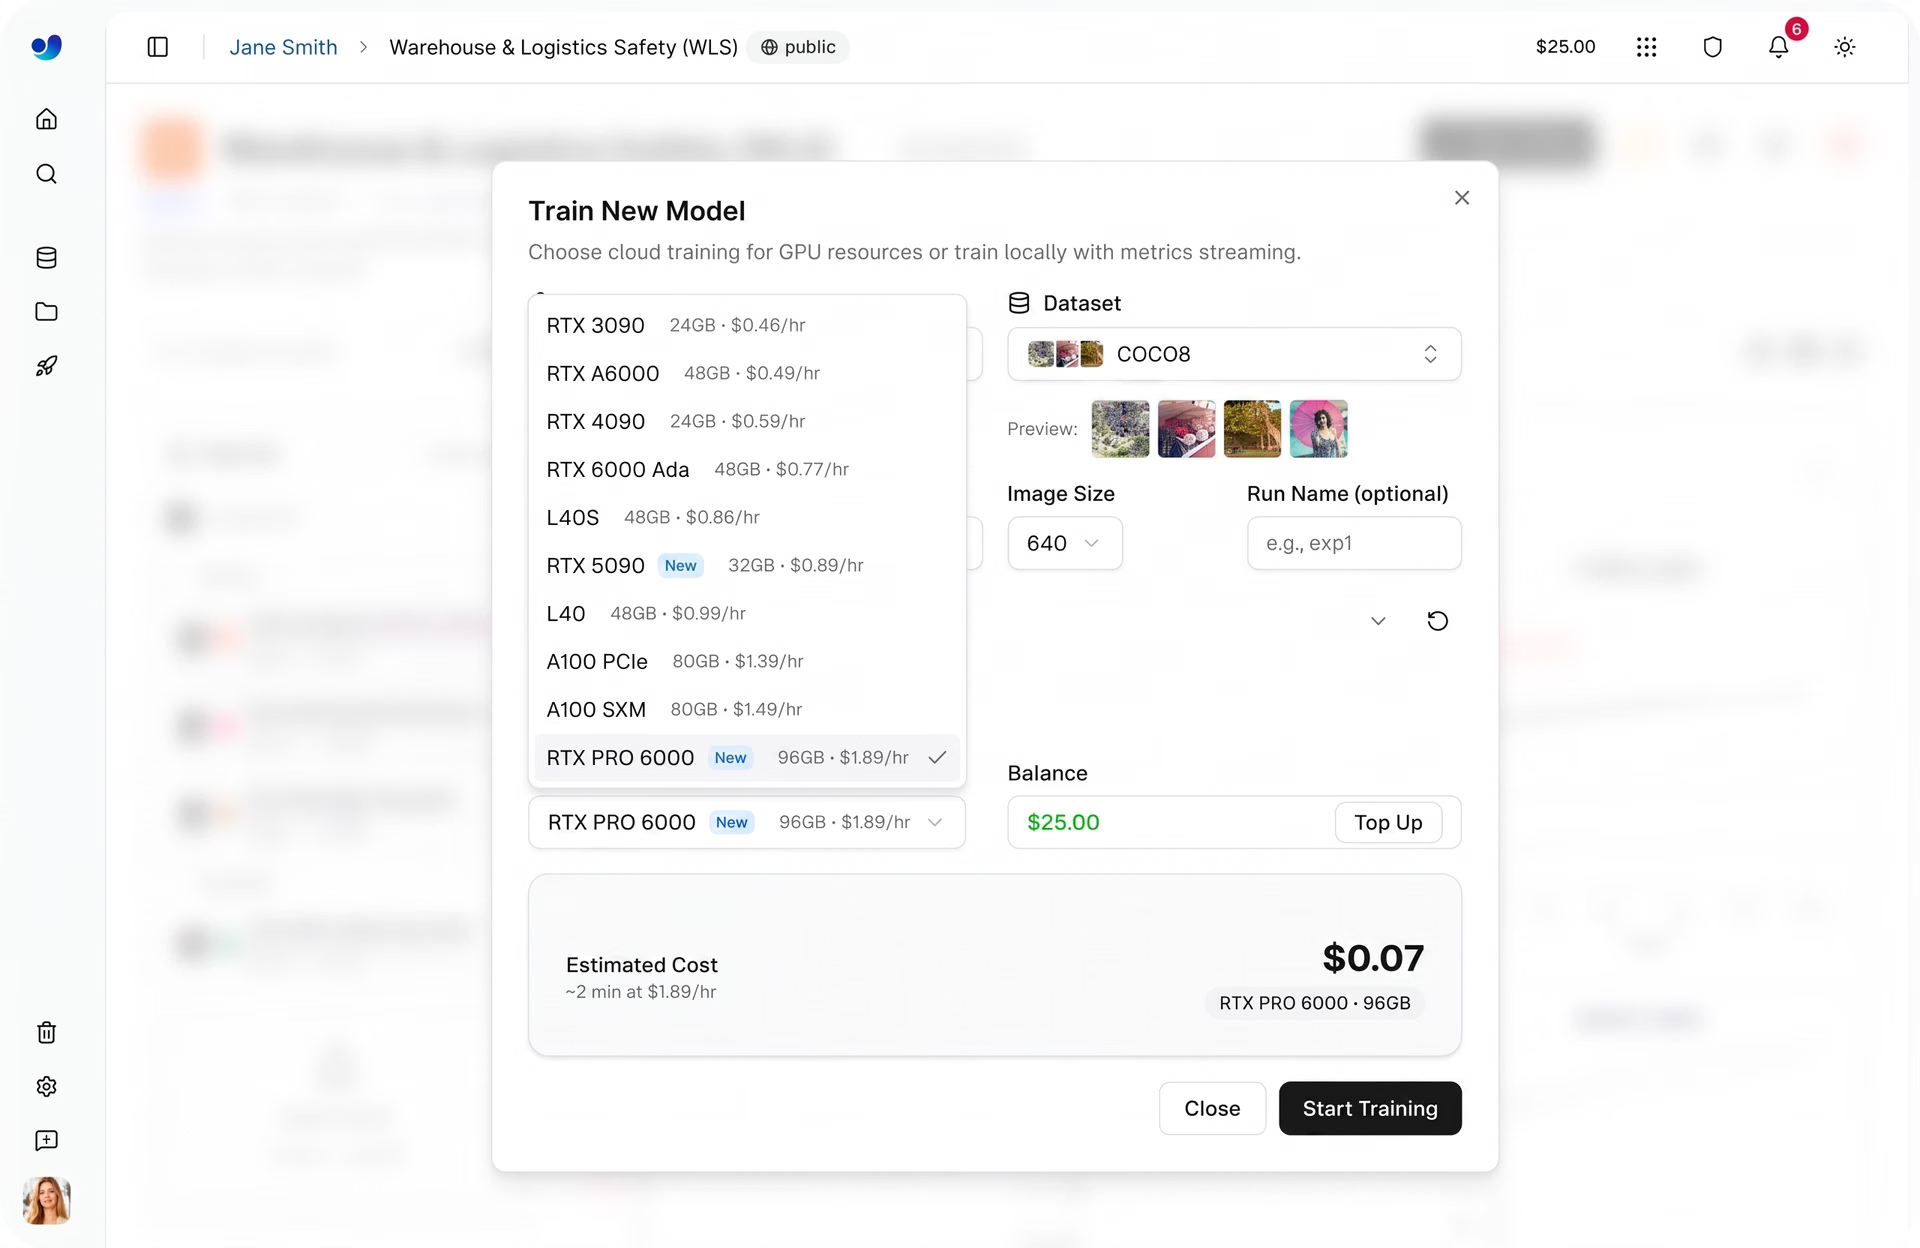
Hình 2. Một số tùy chọn GPU được hỗ trợ thông qua Ultralytics Platform (Nguồn)
Bước 5: Bắt đầu huấn luyện trên cloud#
Sau khi chọn model, dataset, parameter huấn luyện và tùy chọn tính toán, bạn có thể nhanh chóng bắt đầu một lần chạy huấn luyện. Từ dashboard, bạn có thể khởi chạy huấn luyện chỉ bằng một lần nhấp, platform sẽ xử lý phần còn lại bằng cách khởi tạo môi trường và chạy job trên GPU đã chọn.
Khi quá trình huấn luyện bắt đầu, bạn có thể theo dõi tiến độ trực tiếp trong platform. Tab Train cung cấp khả năng quan sát theo thời gian thực đối với các metric chính, bao gồm metric hiệu năng, đường cong loss, mức sử dụng hệ thống và training log trực tiếp.
Để tìm hiểu thêm về việc huấn luyện cục bộ hoặc sử dụng Google Colab với Ultralytics Platform, bạn có thể xem thêm các tutorial trong tài liệu Platform chính thức của Ultralytics.
Đánh giá và so sánh model trên Ultralytics Platform#
Sau khi hoàn tất huấn luyện, bước tiếp theo là đánh giá mức độ hiệu quả của model. Trên Ultralytics Platform, bạn có thể so sánh nhiều lần chạy huấn luyện trong cùng một project, giúp bạn hiểu rõ hiệu năng của các thí nghiệm khác nhau.
Khi phát triển model, quá trình huấn luyện thường được lặp lại nhiều lần với các thiết lập khác nhau, chẳng hạn như thay đổi learning rate, batch size hoặc kích thước model, để cải thiện kết quả. Mỗi lần chạy tạo ra một model hơi khác nhau, đó là lý do việc so sánh chúng rất quan trọng.
Project đóng vai trò là hub trung tâm, nơi các model và thí nghiệm được tổ chức cùng nhau. Bạn có thể theo dõi tiến độ, xem xét kết quả và duy trì sự tập trung mà không cần chuyển đổi giữa các công cụ hoặc chế độ xem khác nhau.
Từ chế độ xem hợp nhất này, bạn cũng có thể phân tích các metric hiệu năng chính như precision, recall và mAP (độ chính xác trung bình) để hiểu model hoạt động như thế nào trên các class khác nhau. Bạn cũng có thể so sánh các lần chạy huấn luyện cạnh nhau để xác định cấu hình nào mang lại kết quả tốt nhất.
Để bổ trợ cho các metric này, bạn có thể sử dụng tab Predict để nhanh chóng kiểm thử model đã huấn luyện trên hình ảnh mẫu hoặc dữ liệu, giúp xác thực hiệu năng bằng mắt và phát hiện các vấn đề tiềm ẩn.
Với những thông tin này, bạn có thể chọn model có hiệu năng cao nhất, thường được lưu dưới dạng checkpoint “best.pt”, rồi chuyển sang giai đoạn tiếp theo, चाहे đó là đánh giá thêm, sử dụng model để chạy inference hoặc triển khai model thông qua platform.
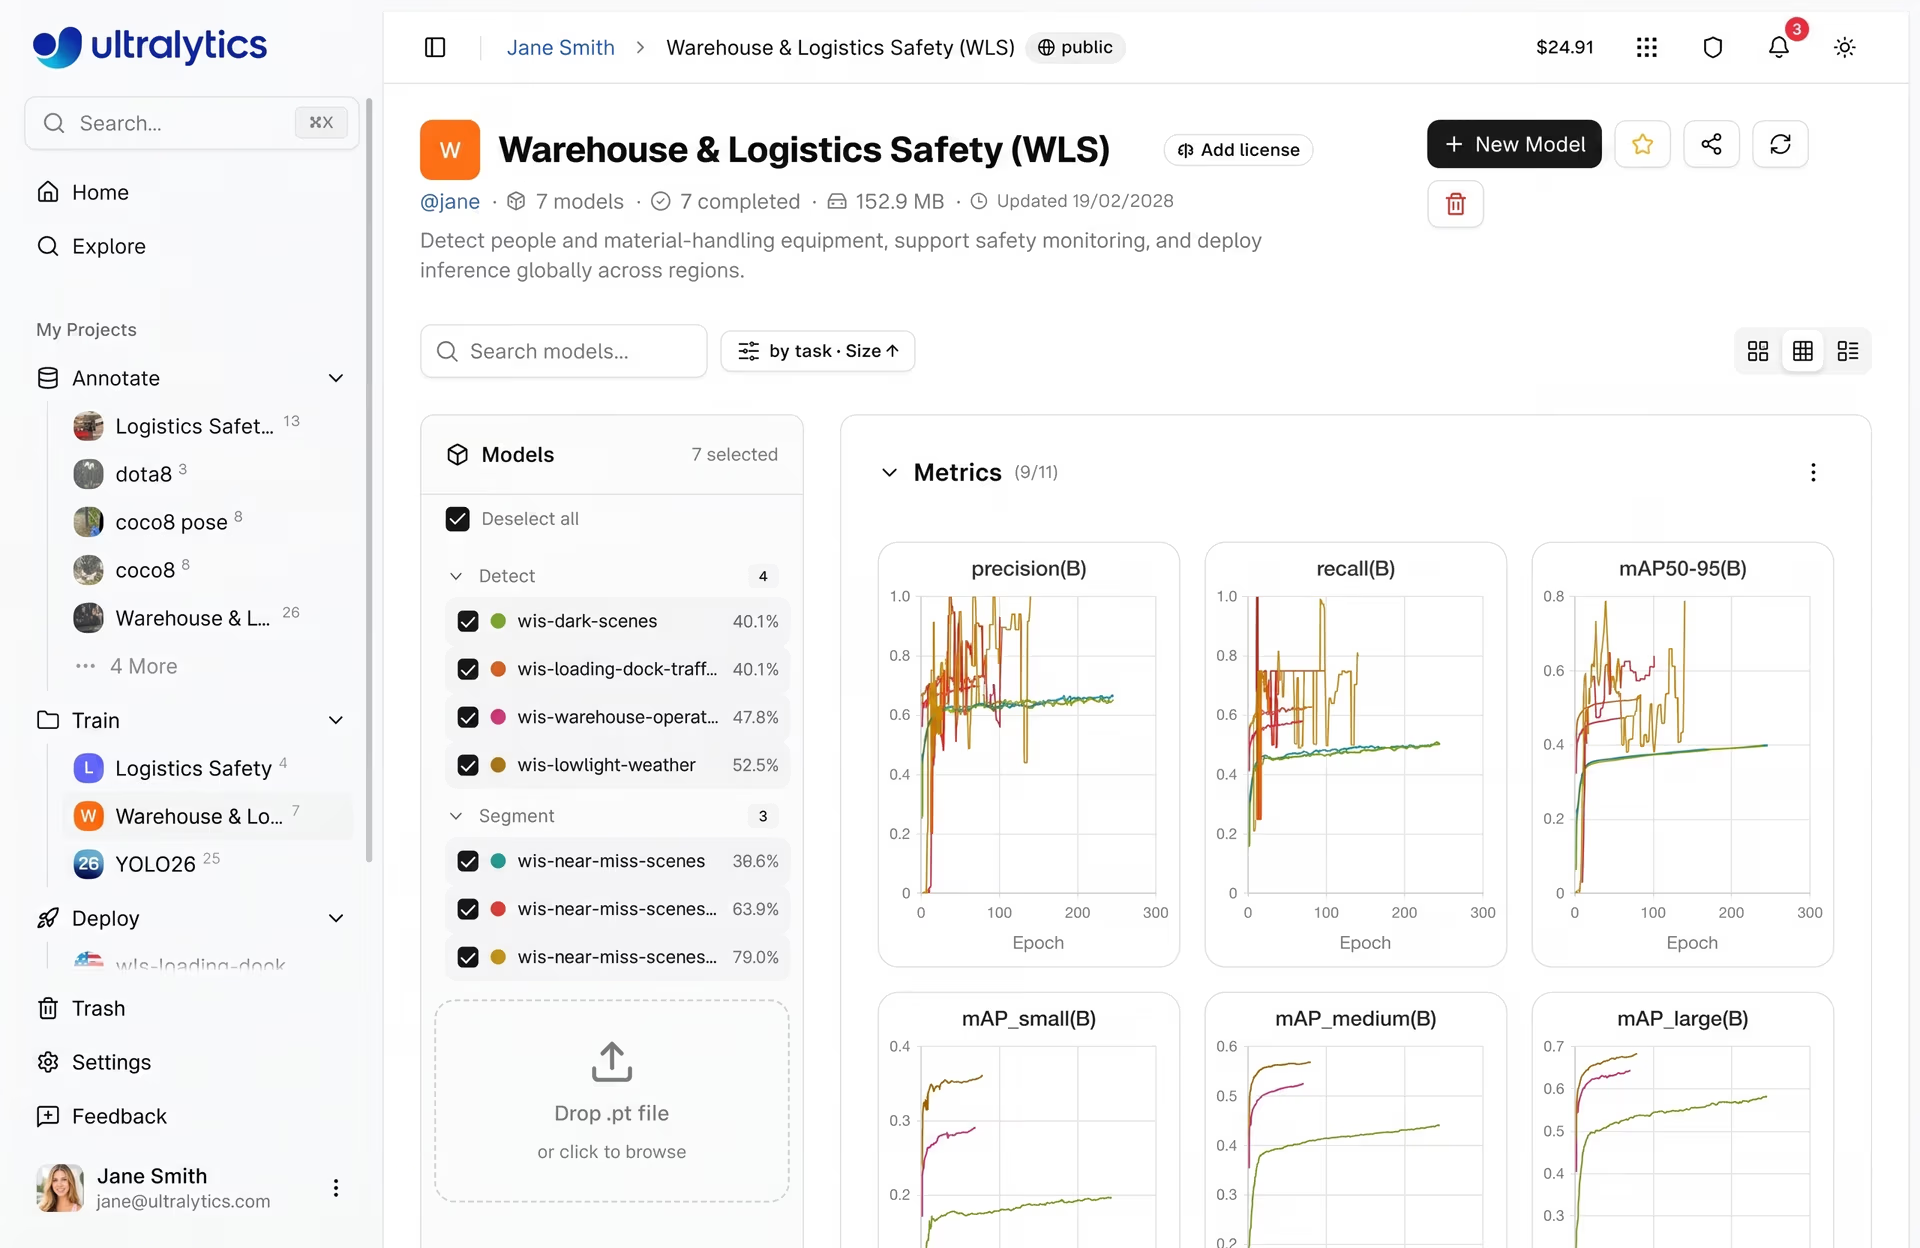
Hình 3. Ví dụ về việc xem metric trên Ultralytics Platform (Nguồn)
Ước tính chi phí huấn luyện trong Ultralytics Platform#
Huấn luyện model phát hiện đối tượng trên cloud phát sinh chi phí tính toán, đặc biệt khi bạn sử dụng GPU hiệu năng cao. Để thuận tiện hơn, Ultralytics Platform cung cấp ước tính chi phí trước khi bắt đầu huấn luyện.
Tính năng này cung cấp thông tin rõ ràng về mức sử dụng dự kiến, giúp bạn lập kế hoạch workload, quản lý ngân sách và tránh các khoản chi bất ngờ trước khi khởi chạy training job. Dưới đây là cách kiểm tra chi phí ước tính trước khi bắt đầu huấn luyện.
Cách ước tính thời gian huấn luyện#
Để ước tính chi phí chính xác, trước tiên platform tính toán thời gian cần thiết cho một epoch huấn luyện. Thời gian này phụ thuộc vào các yếu tố như kích thước dataset, kích thước model, độ phân giải hình ảnh, batch size và tốc độ của GPU đã chọn.
Dựa trên các thông tin đầu vào này, platform xác định thời gian ước tính cho mỗi epoch rồi tính theo toàn bộ lần chạy huấn luyện. Tổng thời lượng được tính bằng cách cộng thời gian của tất cả epoch với một phần overhead khởi động nhỏ.
Overhead bao gồm các tác vụ như khởi tạo môi trường, tải dataset và chuẩn bị GPU, đảm bảo ước tính phản ánh toàn bộ quy trình huấn luyện chứ không chỉ training loop.
Cách tính chi phí huấn luyện#
Sau khi ước tính tổng thời gian huấn luyện, platform quy đổi thời gian này thành chi phí bằng mức giá theo giờ của GPU đã chọn.
Bằng cách kết hợp thời lượng huấn luyện với mức giá GPU, chúng ta có thể ước tính rõ ràng chi phí của lần chạy trước cả khi lần chạy bắt đầu.
Việc biết trước chi phí giúp bạn dễ dàng điều chỉnh thiết lập, chẳng hạn như tinh chỉnh parameter huấn luyện hoặc chọn GPU khác, để cân bằng hiệu năng và chi phí hiệu quả hơn.
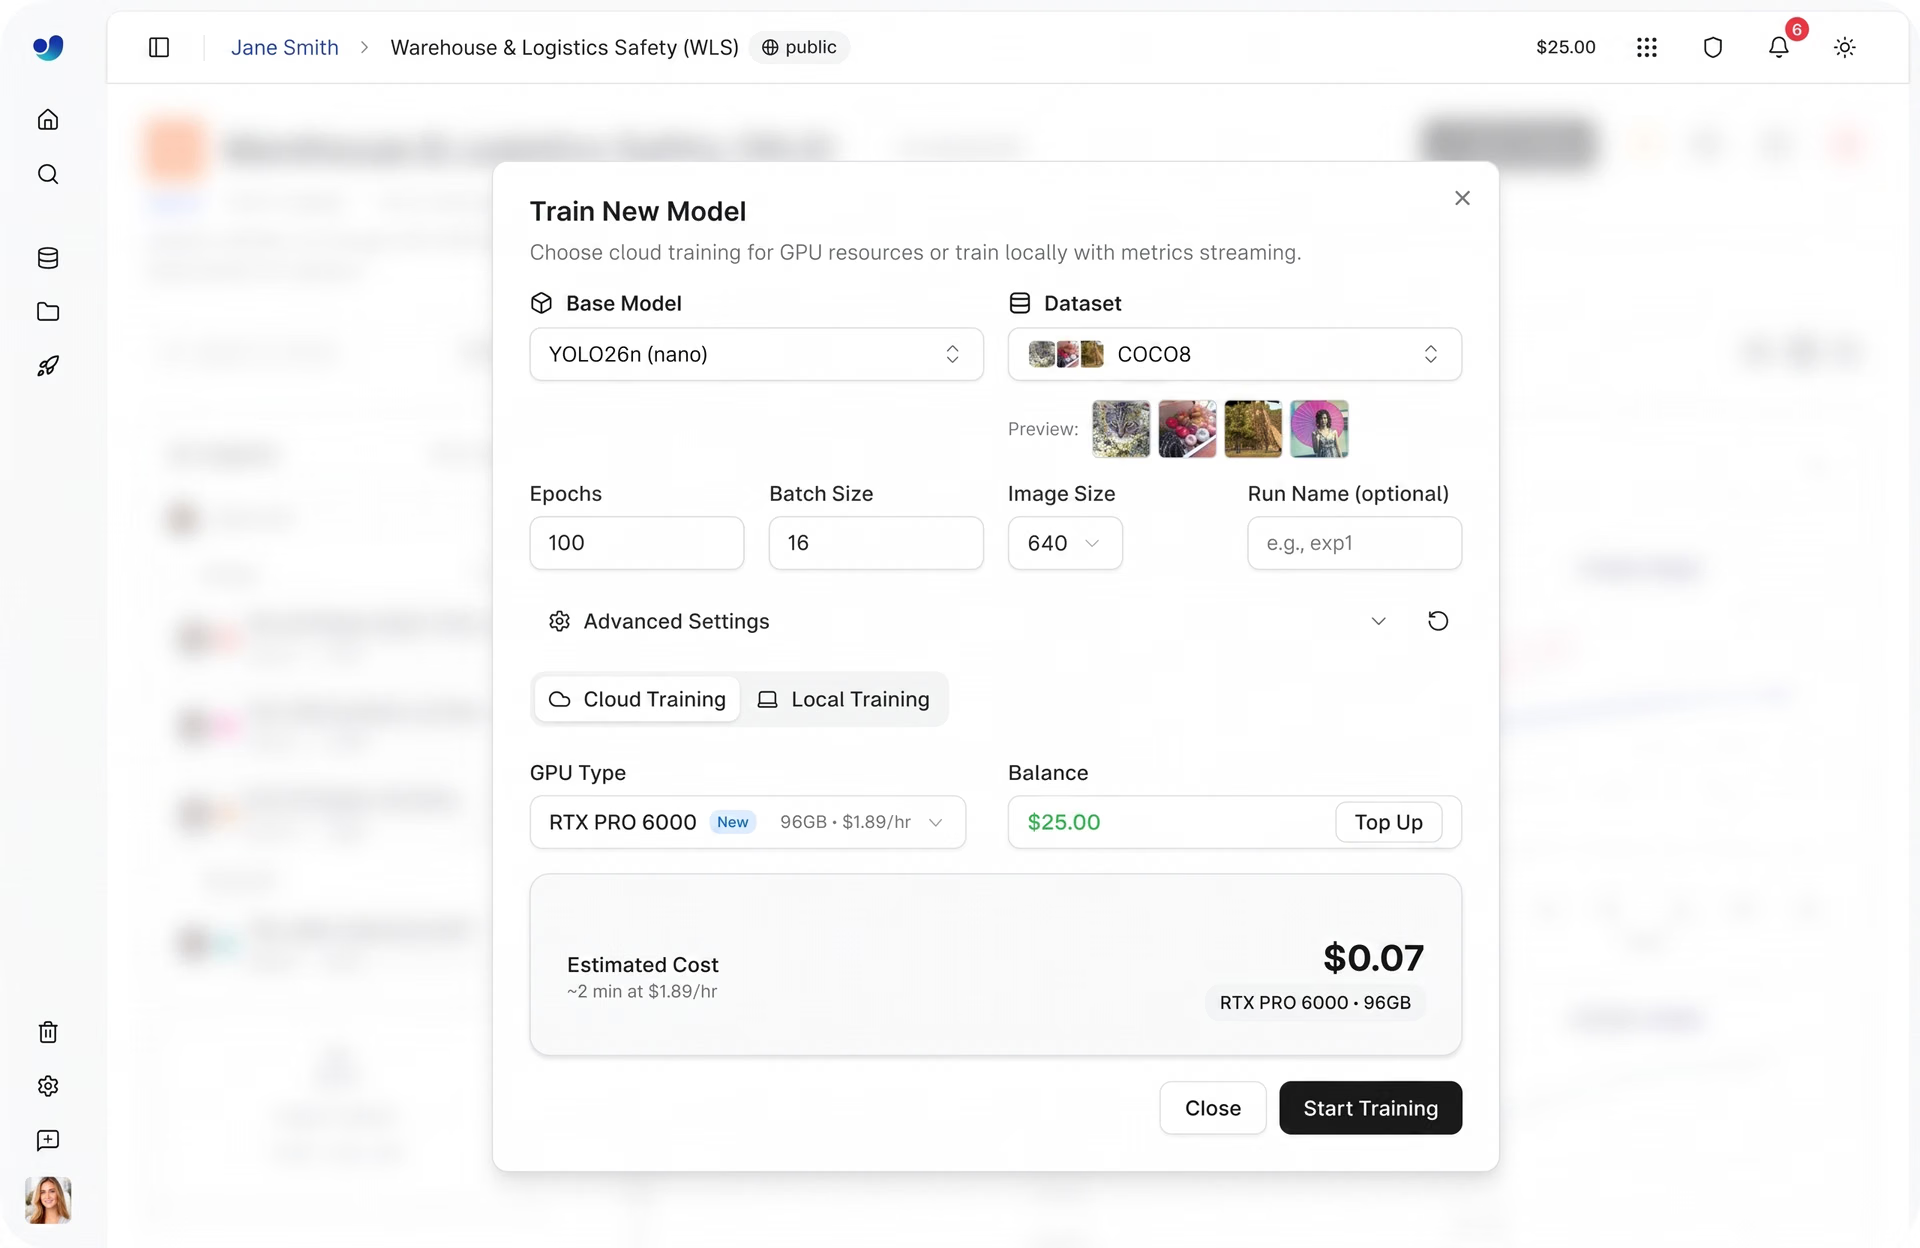
Hình 4. Thiết lập huấn luyện model và ước tính chi phí trong Ultralytics Platform (Nguồn)
Các lợi ích chính khi sử dụng Ultralytics Platform để huấn luyện model#
Đến đây, chúng ta đã đi qua các bước chính trong quá trình huấn luyện model computer vision và cách chúng kết hợp với nhau trên Ultralytics Platform.
Ngoài các tính năng cốt lõi này, còn có những khả năng bổ sung giúp nâng cao workflow huấn luyện. Dưới đây là tổng quan về một số lợi ích chính khi sử dụng Ultralytics Platform để huấn luyện model:
- Khả năng tái lập thí nghiệm tích hợp sẵn: Mọi lần chạy huấn luyện đều được tự động ghi log cùng toàn bộ cấu hình, bao gồm model, dataset, parameter và thiết lập tính toán. Điều này giúp bạn dễ dàng xem lại các thí nghiệm và tái lập kết quả một cách đáng tin cậy.
- Thông tin chuyên sâu về quá trình huấn luyện theo thời gian: Thay vì chỉ xem kết quả cuối cùng, bạn có thể theo dõi hiệu suất thay đổi qua từng epoch, giúp hiểu rõ hơn về hành vi của model trong quá trình huấn luyện.
- Giảm chi phí vận hành: Bằng cách xử lý việc thiết lập môi trường, quản lý dependency và hạ tầng ở chế độ nền, platform cho phép bạn tập trung nhiều hơn vào việc phát triển model và giảm thời gian dành cho khâu thiết lập.
- Tổ chức experiment tập trung: Các project đóng vai trò là nơi duy nhất để quản lý model, dataset và các lượt chạy huấn luyện, giúp duy trì cấu trúc cho experiment khi workflow ngày càng phức tạp.
Những điểm chính#
Huấn luyện là một trong những giai đoạn quan trọng nhất trong vòng đời của model machine learning. Giai đoạn này quyết định mức độ chính xác mà model có thể nhận diện và diễn giải dữ liệu hình ảnh.
Bằng cách kết hợp việc cấu hình dữ liệu huấn luyện, giám sát, so sánh experiment và ước tính chi phí trong cùng một môi trường, Ultralytics Platform tinh gọn quy trình xây dựng các model computer vision có hiệu suất cao và chuẩn bị chúng cho việc triển khai.
Hãy ghé thăm cộng đồng đang phát triển và repository GitHub của chúng tôi để tìm hiểu thêm về thị giác máy tính. Nếu bạn muốn xây dựng các giải pháp thị giác, hãy xem các tùy chọn cấp phép của chúng tôi. Khám phá các trang giải pháp để tìm hiểu thêm về lợi ích của thị giác máy tính trong sản xuất và AI trong nông nghiệp.








