Gemini 4 Carbon 自动标注:我们的 VLM 排行榜新领跑者
Gemini 4 Carbon 在我们的 36 个数据集目标检测基准测试中击败了 45 款 VLM:mAP50 达到 0.584,精确率和召回率均为最高。GPT-6.1 Terra 何时更划算。
 Glenn Jocher10 分钟阅读
在 2026 年 11 月 11 日的 Ultralytics VLM 排行榜快照中,Gemini 4 Carbon 在我们的 36 个数据集目标检测基准测试 UL37 的 45 款自动标注模型中排名第一。它的 mAP50 为 0.584,mAP50-95 为 0.371;如今,它在精确率和召回率两项上也都位居榜首,而在我们 10 月的结果中,这两项分别由两款不同的模型领跑。此前的领跑者 GPT-6.1 Terra 以 0.560 的 mAP50 排在第二位,每张图像的服务商费用约为 Carbon 的三分之一。
因此,对任何需要标注数据集的人来说,问题不是哪款模型的总分最高,而是 Carbon 何时值得多花三倍的钱。下面将介绍 Carbon 创下新高的领域、Terra 仍占优势的领域、Google 12 月调价前后的费用,以及如何在你自己的数据上通过 Ultralytics Platform运行 Carbon。
Gemini 4 Carbon 现已向所有付费开发者开放#
Google 最初于 10 月底向一小群网络安全防御人员发布了 Carbon。2026 年 11 月 10 日,Google 向所有付费开发者和企业开放了这款模型,并开始向 Google AI Ultra 订阅用户逐步推出。Google 的开放公告称,Carbon 可通过 API 在 Google AI Studio 和 Gemini for business 中使用;Ultra 订阅用户还可在 Gemini 应用、AI Mode 和 Antigravity 中使用。防御人员仍可通过 Google 的 Fairwind Program 获得专属访问权限。
Google 称 Carbon 是其最强大的模型,面向网络安全和长时程智能体任务。Gemini 4 Carbon 模型卡称,它基于 Gemini 4 Argon,并且比 Argon 使用更多思考 token,“以全面探索假设、深入推理并运行长时间验证循环”。它可以读取文本、图像、音频和视频,上下文窗口最高可达 1M token,并以文本形式作答。
Google 的发布宣传中完全没有把 Carbon 描述为检测器。对于数据标注,关键在于额外的推理能力会如何影响边界框,而这正是 UL37 衡量的内容。你可以在 Gemini 4 Carbon 模型页面查看每项结果。
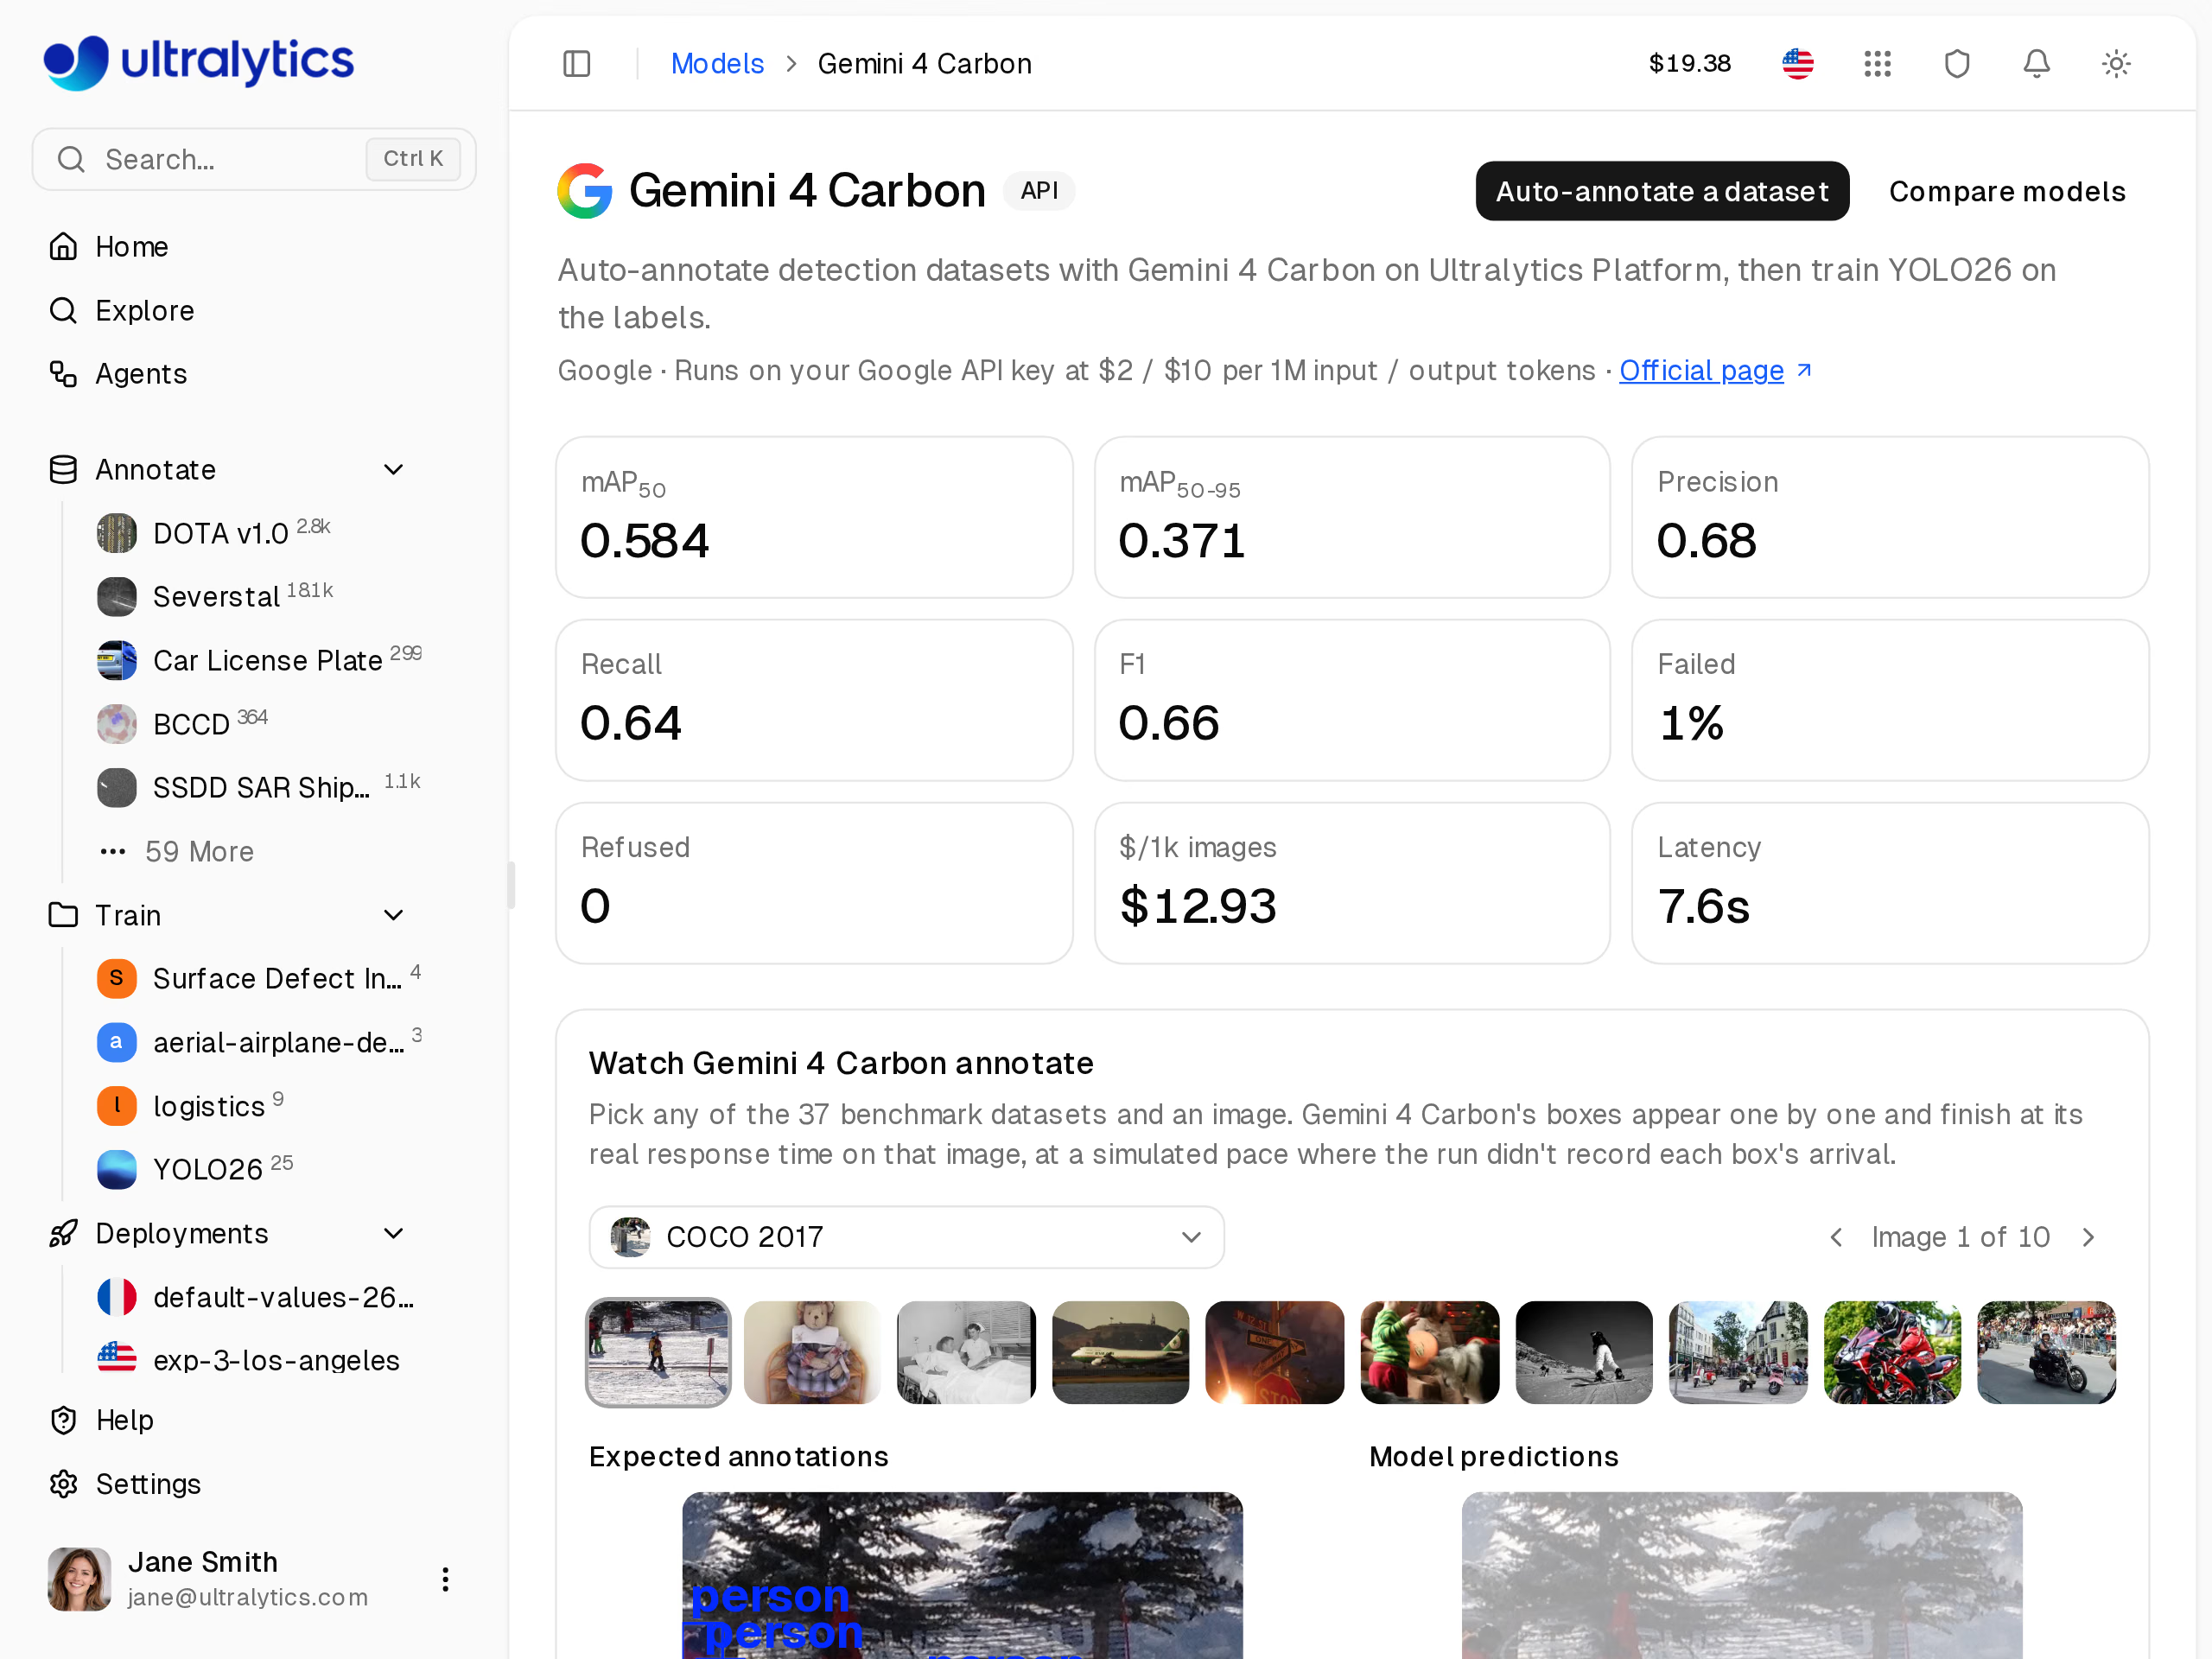
Ultralytics Platform 上的 Gemini 4 Carbon 模型页面,展示其 UL37 分数以及自动标注数据集的链接。
Gemini 4 Carbon 目标检测:所有准确率指标均排名第一#
UL37 会在 360 张图像上评估模型的检测框与各数据集参考标注的吻合程度:从 36 个真实目标检测数据集中各取 10 张,涵盖医学扫描、航拍和热成像、零售货架、体育、文档、电路板等。每张图像都经过 Platform 用户使用的同一套生产流程,并使用数据集自身的类别名称;与用户使用时一样,SAM 3.1 会优化除 SAM 3 之外所有模型的检测框。每个数据集的权重相同;详见 UL37 基准测试方法。
下面看看 Carbon 与排名紧随其后的四款模型相比表现如何:
Carbon 的 mAP50 比 GPT-6.1 Terra 高 0.024。更严格的 mAP50-95 会奖励紧贴物体边缘的检测框,差距也相近:Carbon 为 0.371,而先前最佳的 Claude Fable 5.2 为 0.347,Terra 为 0.345。
Carbon 的表现也优于其基础模型。Gemini 4 Argon 的 mAP50 为 0.537,mAP50-95 为 0.343,因此在相同基准测试和标注流程下,Carbon 分别提高了 0.047 和 0.028。
Gemini 4 Carbon 在 UL37 上的精确率和召回率均为最高#
正如我们关于如何根据精确率和召回率选择 VLM的指南所述,在我们 10 月的结果中,排行榜顶尖模型分成了两派。Gemini 4 Argon 的精确率最高,为 0.667:它的检测框中有较高比例与标注吻合,但漏掉了一些已标注物体。GPT-6 Astra 的召回率最高,为 0.627:它匹配到了更多已标注物体,但其检测框的正确比例较低。
在 2026 年 11 月 11 日的排行榜快照中,Carbon 的精确率为 0.685,召回率为 0.642,均为 45 款模型中的最高平均值,分别超过 Argon 的精确率和 Astra 的召回率。
对审核人员来说,这是基准测试能显示的最佳组合。精确率越高,初步生成的检测框中正确的比例就越大;召回率越高,已有检测框的真实物体比例就越大。精确率低意味着需要删除检测框,召回率低意味着需要补画物体,因此 Carbon 的初步结果需要在这两方面进行的修正都更少。
SKU110K体现了这项指标在拥挤图像中的重要性。该数据集的超市货架在 10 张基准测试图像中共有 1,666 件已标注商品,且全部属于同一个类别。Carbon 在该数据集上的 mAP50 为 0.671,是所有模型中的最佳成绩,超过 Terra 先前创下的 0.619。在这样的货架图像中,审核人员必须在几十个正确检测框中找出每一个多余的框。
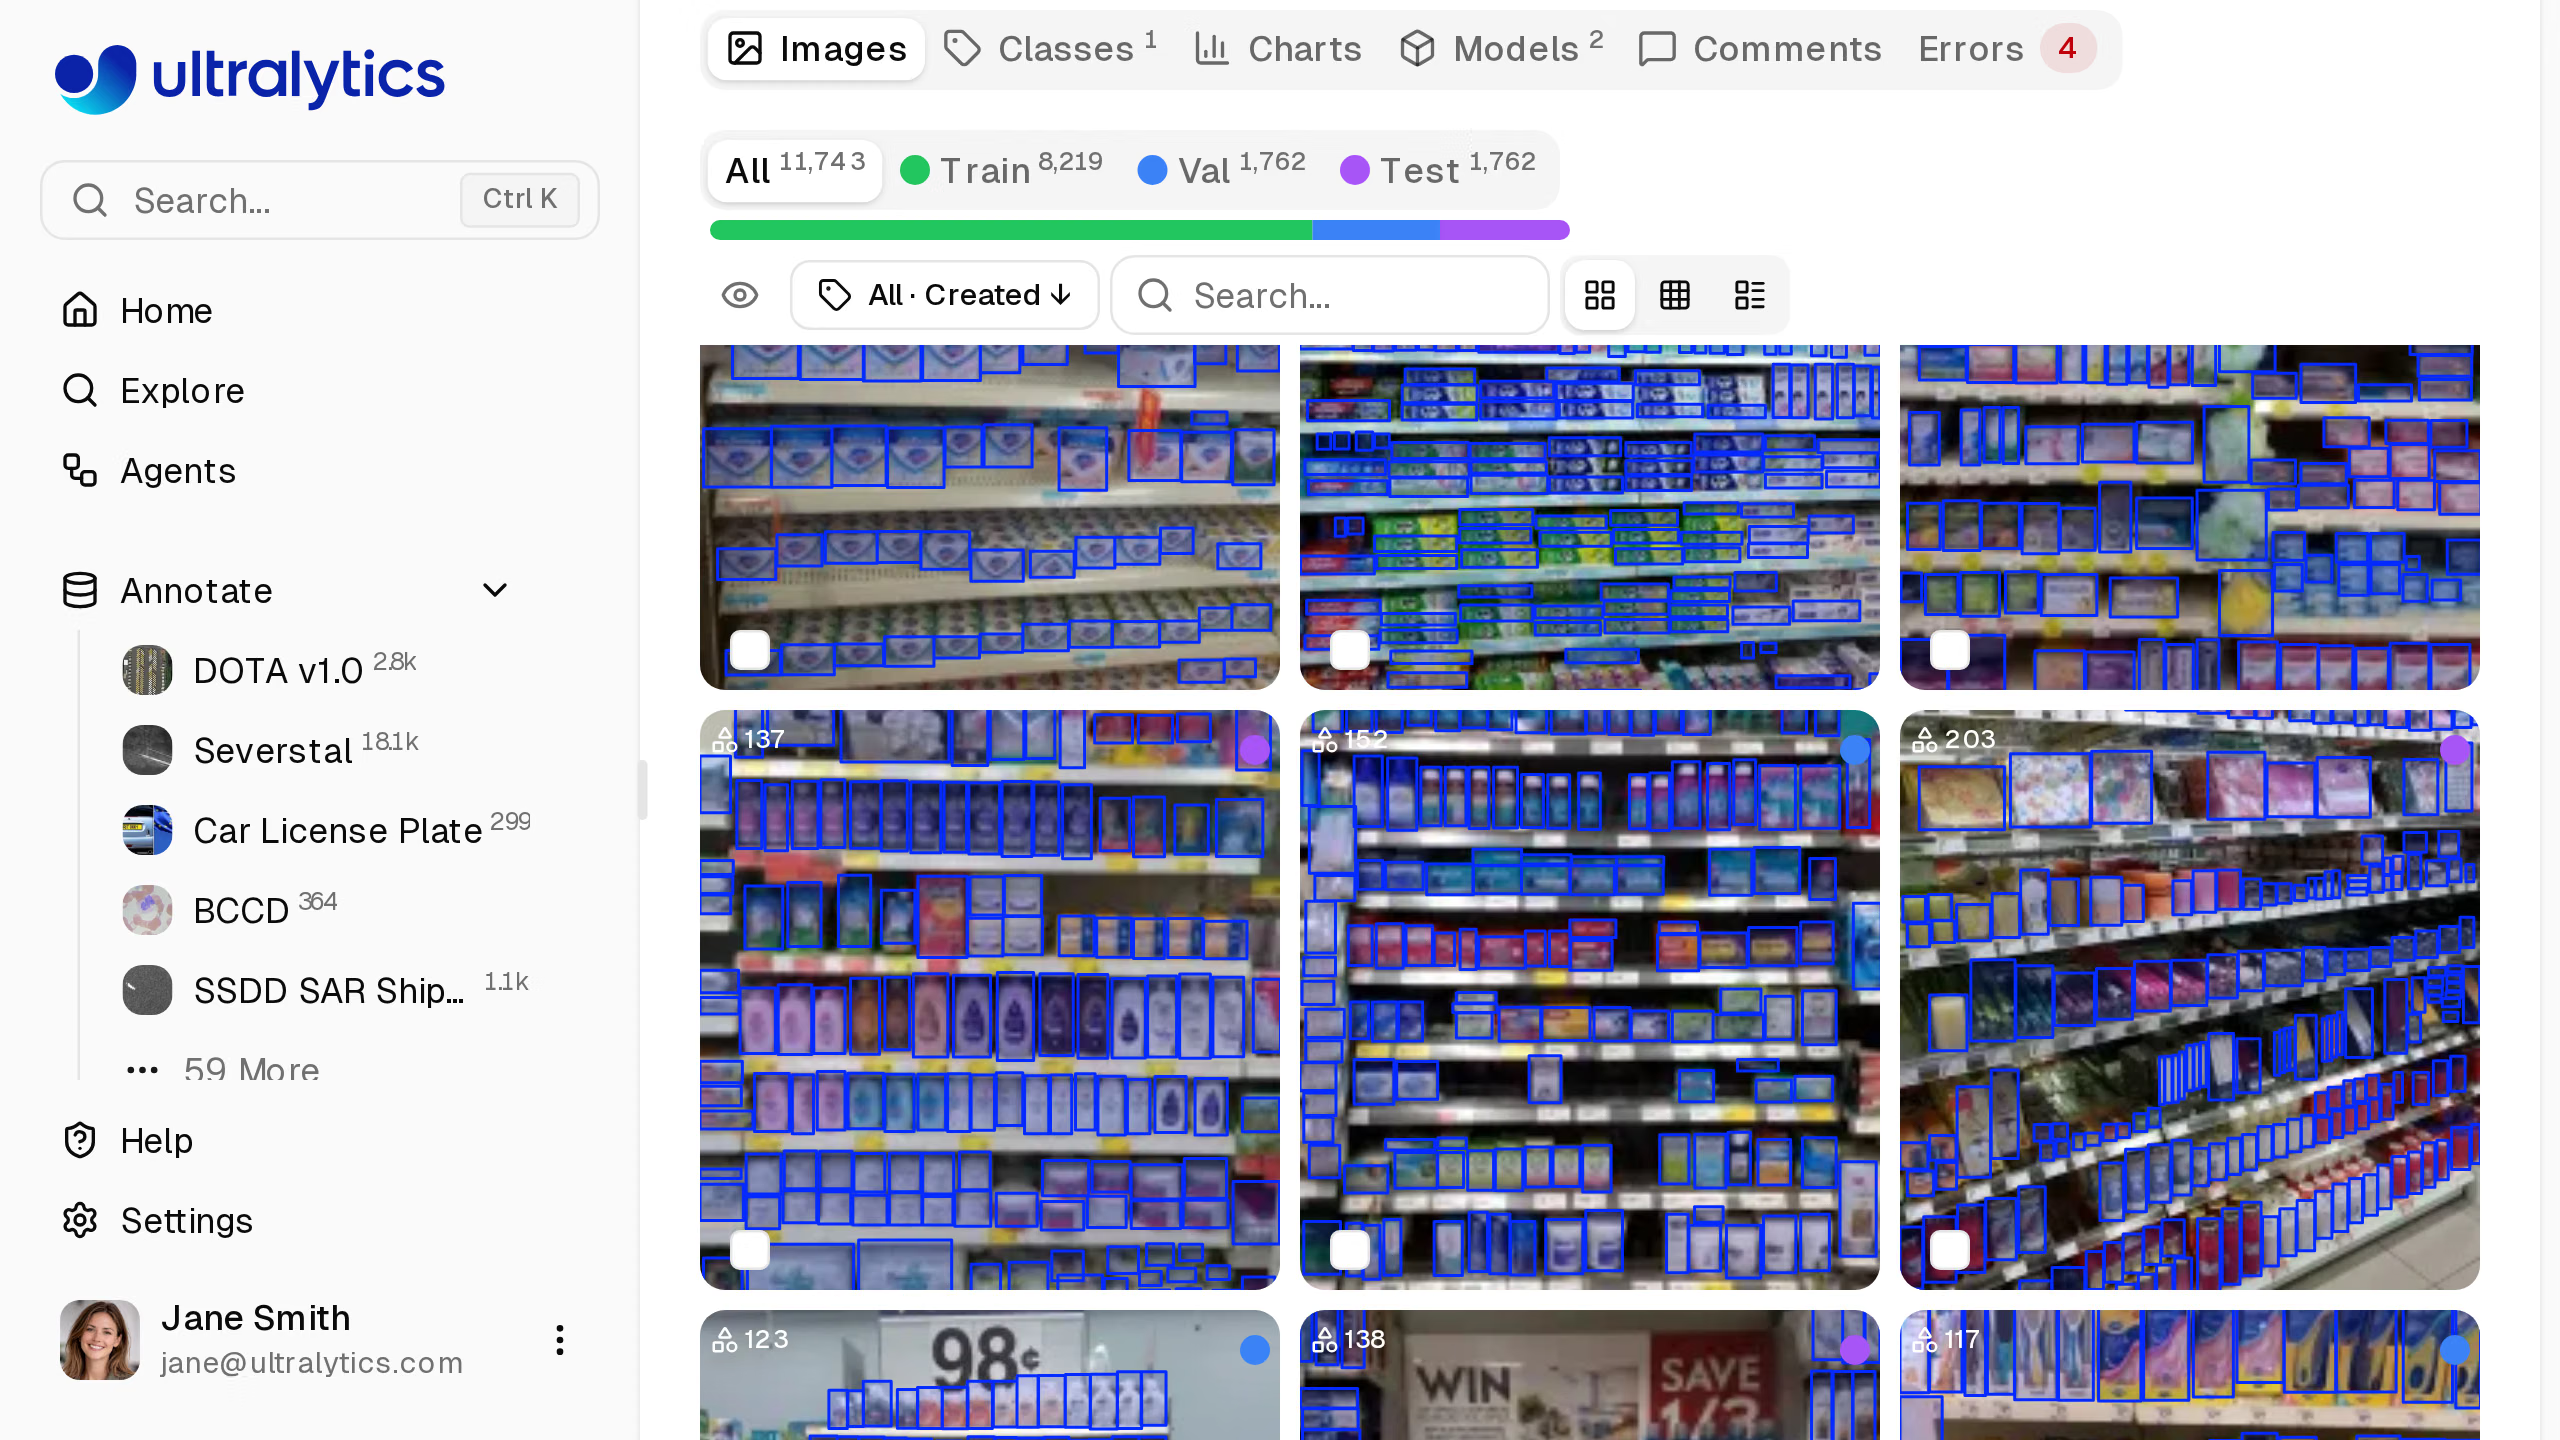
Ultralytics Platform 上的 SKU110K Dense Retail Shelf Detection 2 数据集,Carbon 在此取得 UL37 最佳成绩,mAP50 为 0.671。
Gemini 4 Carbon 在九个领域取得最高分#
根据 Platform 模型页面上的分数据集结果,Carbon 现在在一长串 UL37 数据集上取得了所有模型中的最佳成绩。以下是这些成绩与此前最高分的对比:
| 数据集 | 领域 | Gemini 4 Carbon mAP50 | 此前最佳 mAP50 |
|---|---|---|---|
| LLVIP 红外 | 热成像 / 弱光 | 0.955 | Gemini 4 Argon,0.915 |
| Cheng Brain Tumor MRI | 医学 | 0.942 | GPT-6.1 Terra,0.904 |
| RPC Retail Checkout | 零售 | 0.935 | GPT-6 Astra,0.935(并列) |
| CeyMo Road Markings | 道路 / 交通 | 0.905 | Gemini 4 Argon,0.905(并列) |
| Basketball and Hoop | 体育 | 0.882 | Claude Fable 5.2,0.849 |
| FloorPlanCAD 2 | 文档 / UI / CAD | 0.821 | GPT-6 Astra,0.726 |
| RUOD Underwater | 水下 | 0.788 | Gemini 4 Argon,0.757 |
| HIT-UAV 热成像无人机 | 航拍 / 遥感 | 0.689 | Gemini 4 Argon,0.582 |
| SKU110K 货架 | 零售 | 0.671 | GPT-6.1 Terra,0.619 |
| PlantDoc | 自然 / 农业 | 0.594 | Claude Fable 5.2,0.521 |
| Airbus Oil Storage | 航拍 / 遥感 | 0.381 | Gemini 4 Argon,0.347 |
| DDR 视网膜病变 | 医学 | 0.133 | Claude Opus 5.5,0.132 |
有三点值得关注。Carbon 保留了 Argon 在热成像、航拍和水下图像方面的优势,并进一步提升,其中 HIT-UAV 热成像无人机画面的提升最大。它在平面图上的表现几乎比 GPT-6 Astra 高 0.1。对于脑肿瘤 MRI 数据集(类别包括脑膜瘤、胶质瘤和垂体瘤),它也略胜 Terra。
每个数据集仅包含 10 张图像,因此单个分数只能作为进一步调查的信号,而不能视作定论。Carbon 在 RPC 和 CeyMo 上追平现有纪录,在 DDR 上仅领先 0.001;这些差距不足以区分模型。
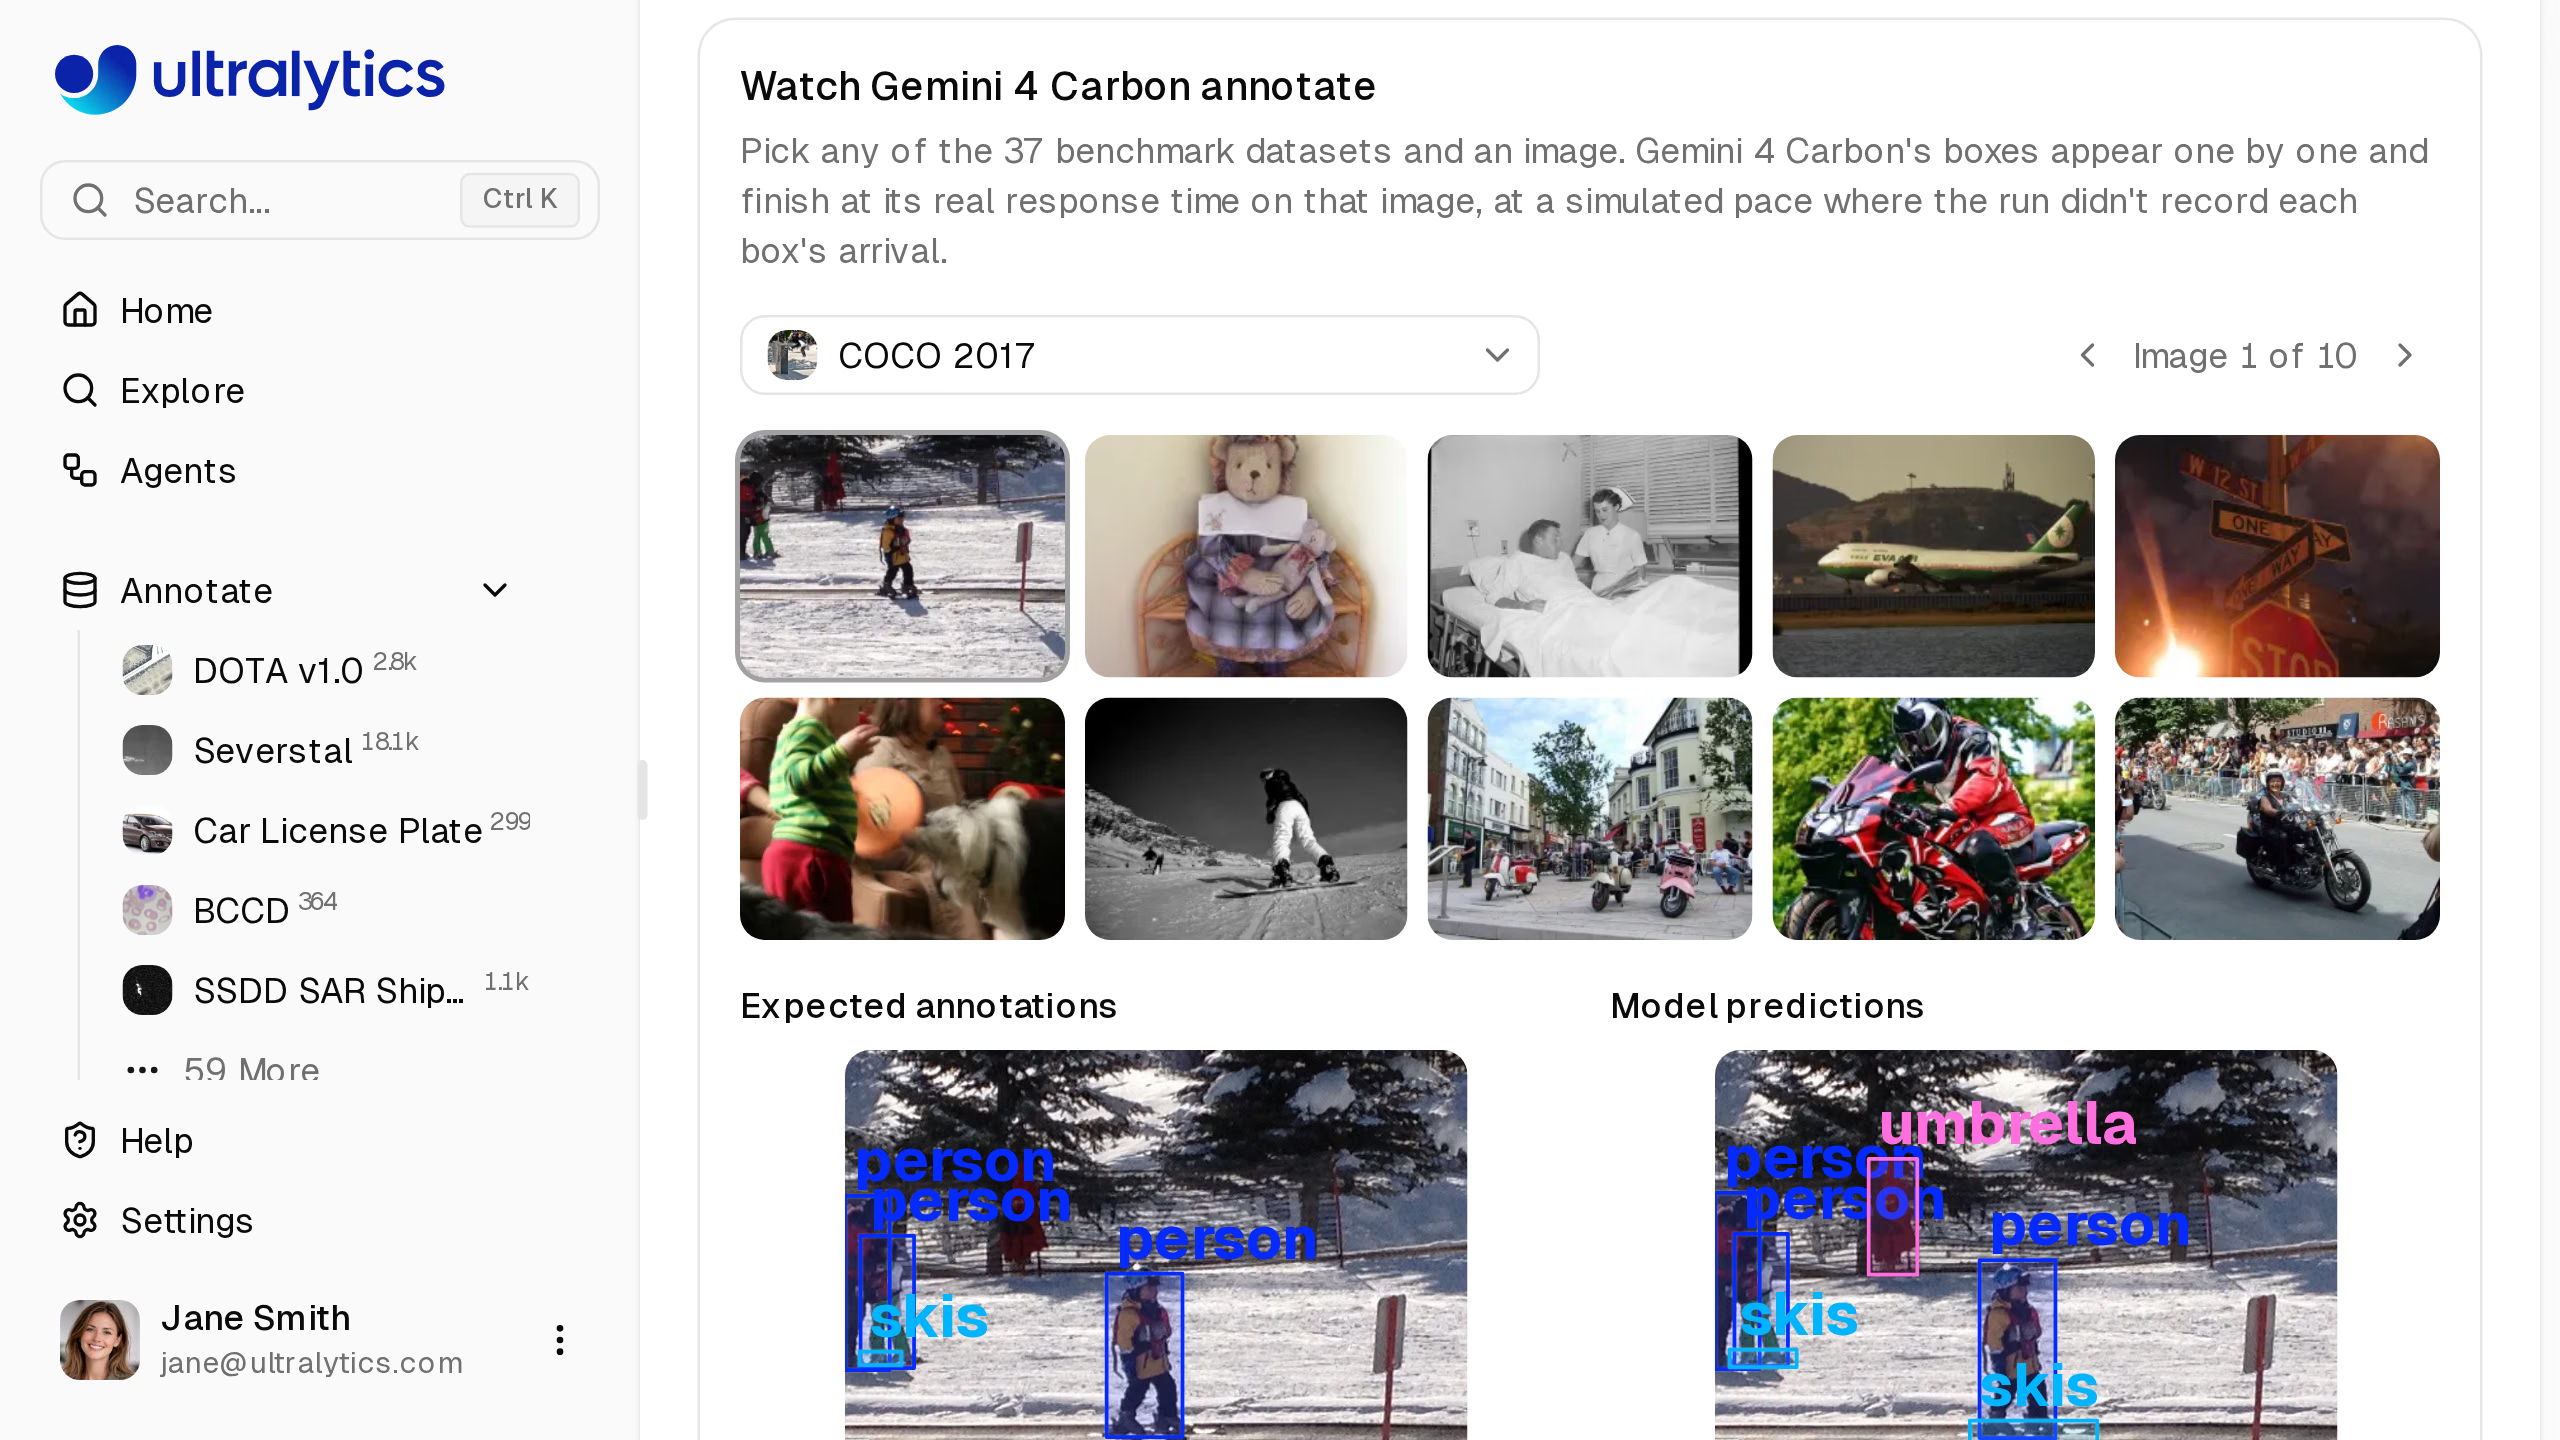
模型页面会逐个回放所有基准测试数据集和 COCO 中 Carbon 记录的 UL37 检测框,并与预期标注并排展示。
Gemini 4 Carbon 与 GPT-6.1 Terra 对比:Terra 仍占优势的领域#
Terra 在两个医学数据集上仍保持最高分。排行榜的数据集表仍将其列为甲状腺超声数据集 TN5000 的最佳模型,得分为 0.935;也将其列为血细胞显微成像数据集 TXL-PBC 的最佳模型,得分为 0.889。如果你的数据与这两个数据集中的任意一个相似,请在做出选择前,比较两个模型页面上的对应数据行。
Terra 更大的优势在于价格。下面是它与 Carbon 在 UL37 上的正面对比:
| UL37 结果 | Gemini 4 Carbon | GPT-6.1 Terra |
|---|---|---|
| mAP50 | 0.584 | 0.560 |
| mAP50-95 | 0.371 | 0.345 |
| 提供商每 1,000 张图像的费用 | $12.93 | $4.36 |
| 每张图像的中位耗时 | 7.6 s | 5.1 秒 |
| 请求失败数 | 1% | 0% |
成本根据服务商报告的 token 用量估算,按每 1,000 张成功完成标注的基准测试图像及公开标价计算。Terra 的 mAP50 约为 Carbon 的 96%,成本约为 Carbon 的三分之一,响应更快,而且没有请求失败。这两款模型都位于排行榜的“性价比最佳”线上;这条线连接的是在成本和准确率两方面都没有对手的模型。
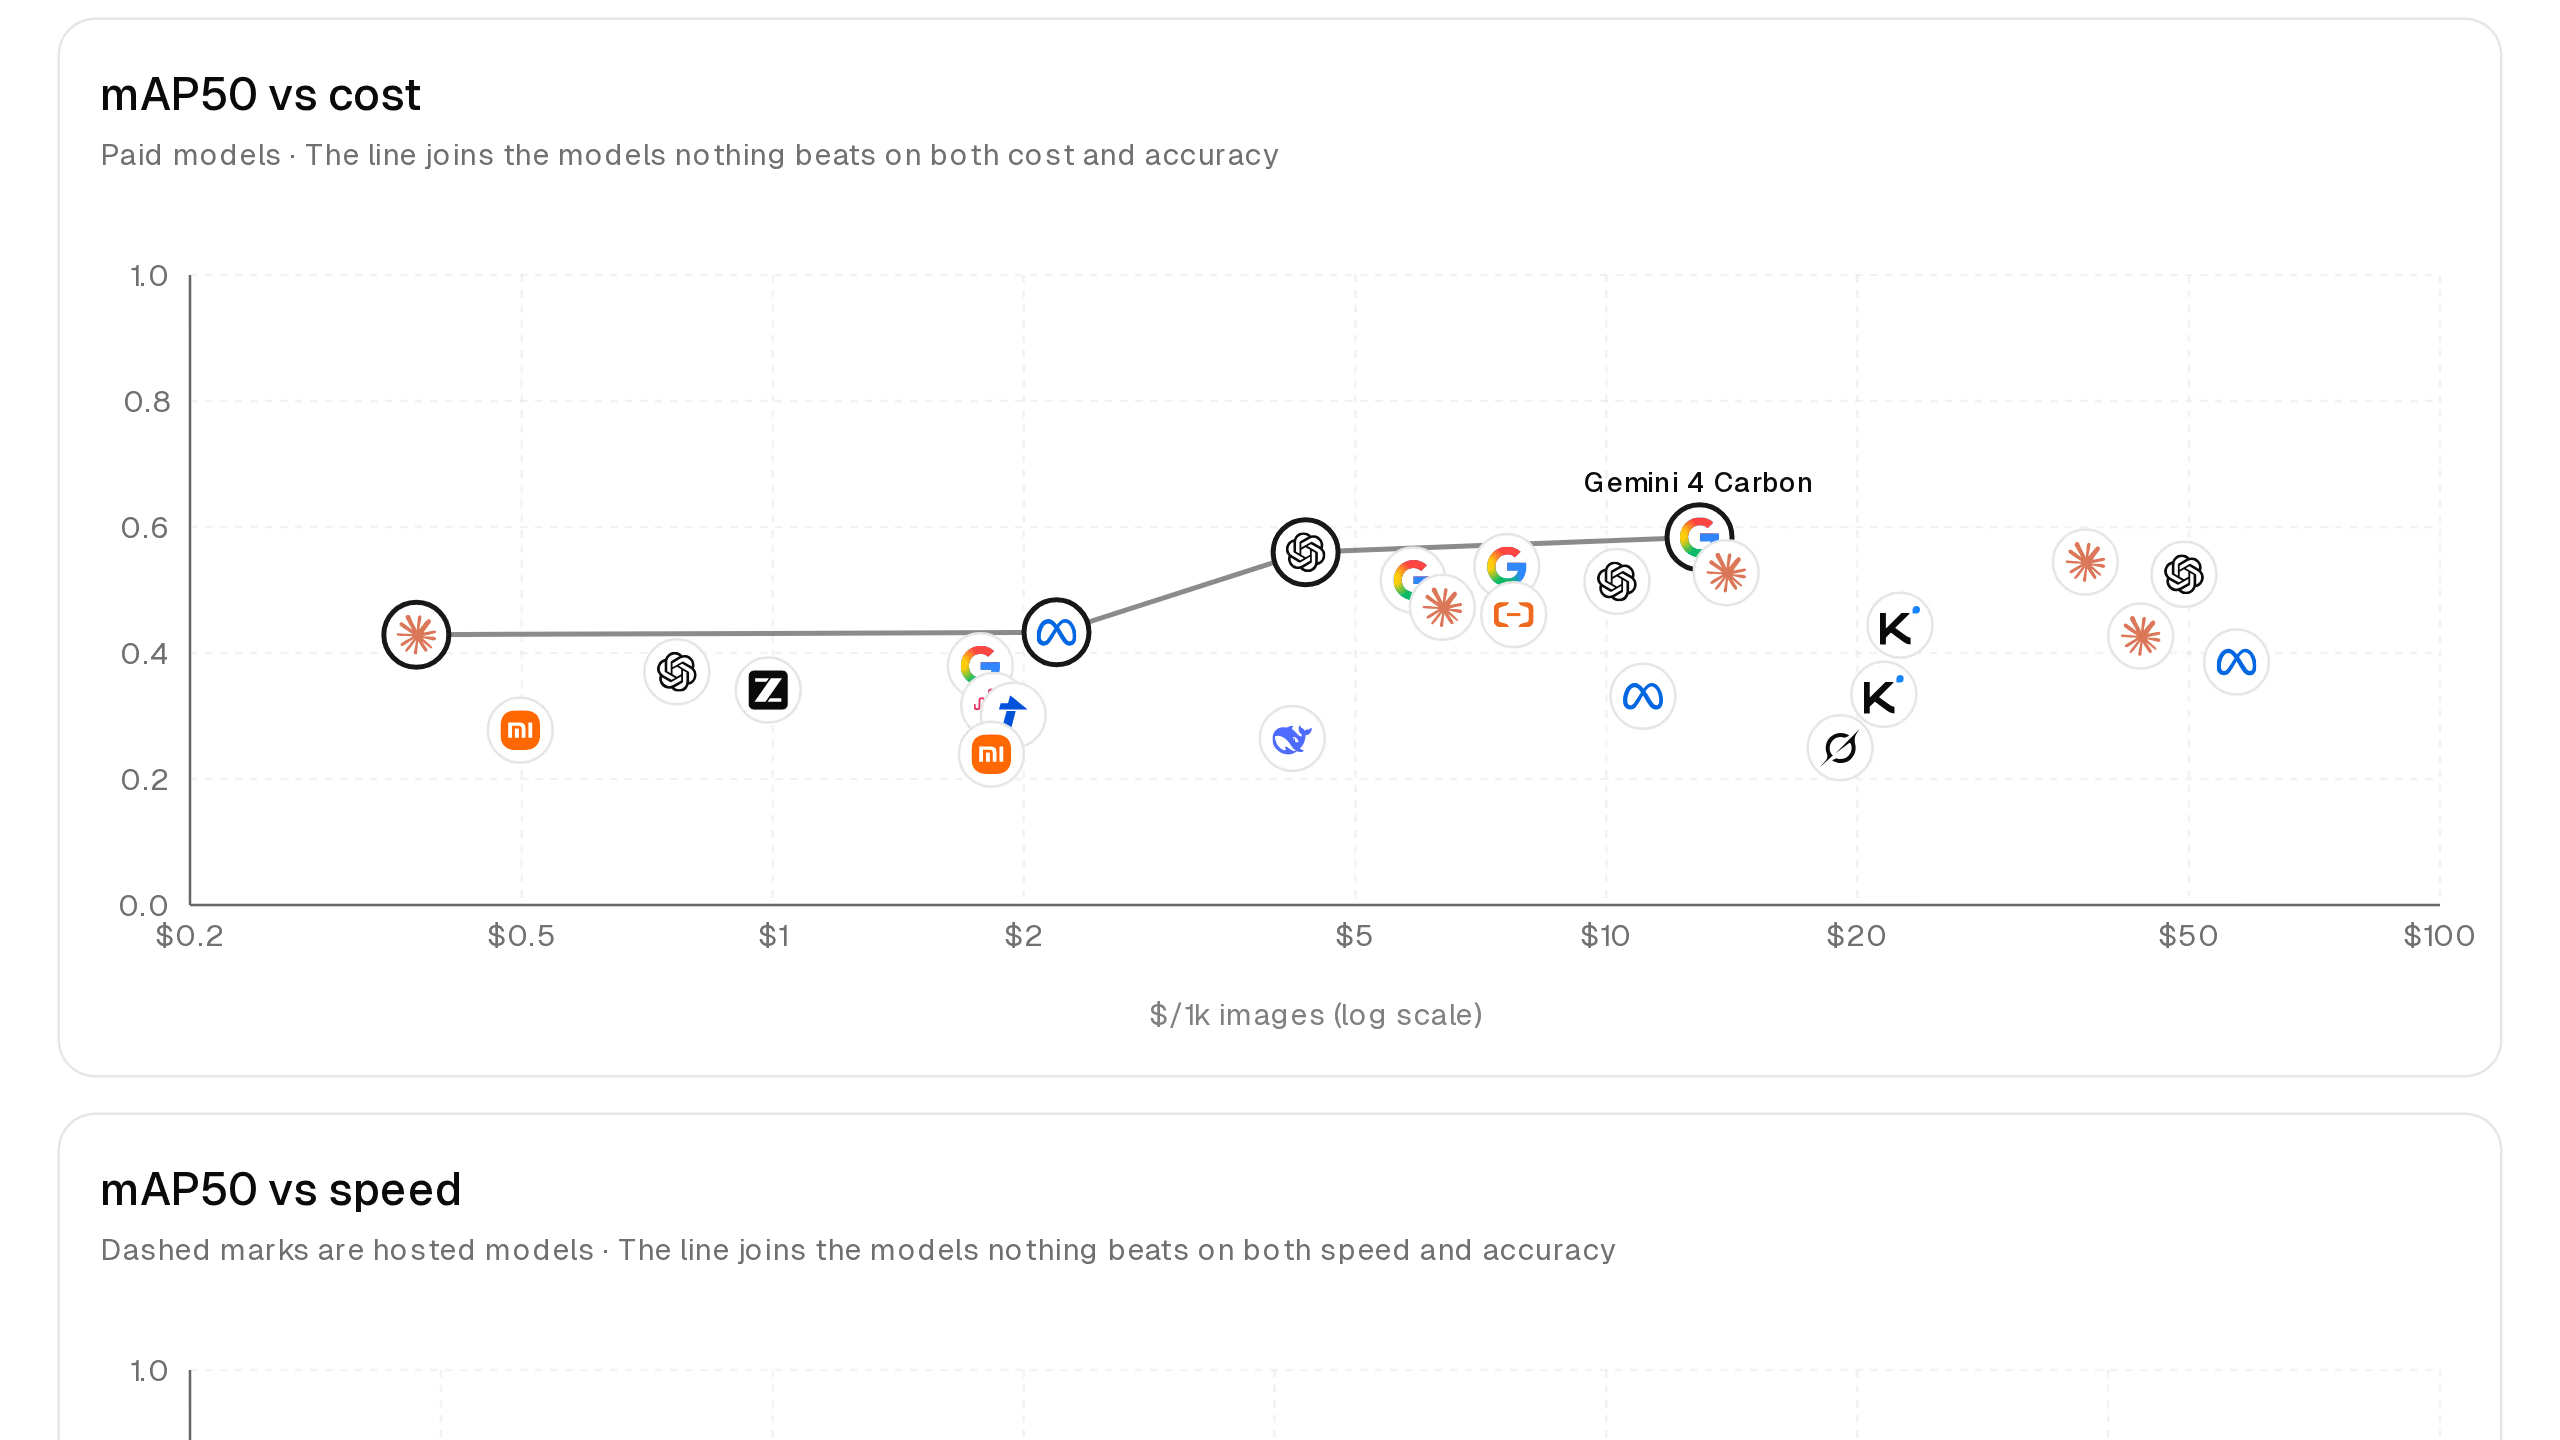
排行榜上的 UL37 付费模型 mAP50 与成本对比图,采用当前公开标价。
价格差距还会扩大。根据 Google 的开放公告,Carbon 在 2026 年 11 月 30 日前的入门价为每百万输入 token 2 美元、每百万输出 token 10 美元,之后将分别涨至 4 美元和 20 美元。在 token 用量相同的情况下,Carbon 每 1,000 张图像 12.93 美元的成本将在 12 月 1 日升至约 26 美元。
实际选择可以这样考虑:
- 为 Carbon 付费:当标签质量值得这笔费用时使用,例如零售货架等拥挤场景、热成像和航拍图像、平面图和 CAD 图纸,以及模型页面显示 Carbon 明显领先的任何数据集。
- 选择 Terra:处理大型通用批次且预算比 0.024 mAP50 的差距更重要时,或处理 TN5000 甲状腺超声和 TXL-PBC 血细胞数据集等数据时。
- 如果计划使用 Carbon,请在 12 月 1 日前运行大型任务,以享受入门价。
无论你选择哪款,批量标注都会收取 Ultralytics Platform 的处理费:每处理 1,000 张图像 1.00 美元,每次运行最低 0.01 美元;服务商则会直接向你收取使用你自己的密钥产生的费用。Ultralytics 不会对 token 加价。更全面的费用分析请参阅我们的图像标注软件成本指南。如果想选更便宜的付费模型,Claude Haiku 5.5 每 1,000 张图像收费 0.37 美元,得分为 0.429;而 Qwen3.8 27B 和 SAM 3.1 Text 等托管模型完全不需要密钥。
如何在你的数据集上运行 Gemini 4 Carbon 自动标注#
Carbon 是一款通过类别提示词工作的模型,适用于包含 1 到 200 个类别的检测数据集。它会根据你数据集自身的类别名称返回边界框;Platform 会以 Gemini 的 y-first 格式发起请求,并使用 SAM 3.1 优化结果。
- 在 Google AI Studio 中创建 Gemini API 密钥。Carbon 使用付费 API 层级,因此密钥必须启用结算功能。
- 在拥有你数据集的 Platform 工作区中,前往设置 > API 密钥添加密钥。详情请参阅服务商密钥文档。
- 在标注编辑器中打开一张图像,切换到 Smart 模式,然后在模型选择器的 Google 分类下选择 Gemini 4 Carbon。
- 按下 Predict,或输入
P,为当前图像添加标签。在扩大处理规模前,先尝试几张能代表你数据的图像。 - 在数据集页面中,选择 更多操作 > 批量标注,一次性标注所有未标注图像。Platform 会先保存一个数据集版本,因此你可以回滚。
- 审核并修正检测框,编辑器会自动保存;然后在同一工作区中,用处理结果训练 Ultralytics YOLO26 模型。
开发者也可以在代码中调用 Carbon:Platform SDK v0.1.109 版本新增了图像预测模型 gemini-4-carbon。如需了解全貌,请参阅 Ultralytics Platform 如何利用 AI 自动化标注,以及人工参与审核为何仍是工作流程的一部分。对于医学图像分析,应将任何模型生成的检测框视为草稿,由临床专家检查并批准,绝不能将其作为诊断结果。
谁适合使用 Gemini 4 Carbon#
当标签质量比服务商费用更重要时,使用 Gemini 4 Carbon。它是我们基准测试过的准确度最高的自动标注模型,目前在精确率和召回率两项上都排名第一,并在热成像、航拍、水下、零售货架、平面图和脑 MRI 数据集上取得最高分。
已经在使用 Argon 的团队可以获得更高的总分,并在 Argon 本身最擅长的领域创下新高;入门 token 价格相同,但按该价格计算,Carbon 的单张图像成本更高。预算有限、需要标注大量通用批次的团队,应继续将 GPT-6.1 Terra 作为默认选择,并在模型页面显示明显领先的数据集上改用 Carbon。关于 Argon 的表现,请参阅我们的 Gemini 4 Argon 自动标注结果。
常见问题
在我们的 UL37 基准测试中,它的 mAP50 为 0.584,mAP50-95 为 0.371,在 Ultralytics VLM 排行榜的 45 款模型中排名第一,而且平均精确率和平均召回率均为最高。它在热成像、航拍、水下、零售货架、平面图和脑 MRI 数据集上取得了所有模型中的最佳成绩。
总体而言,Carbon 更准确:mAP50 为 0.584,高于 Terra 的 0.560;mAP50-95 为 0.371,高于 Terra 的 0.345。Terra 每 1,000 张图像收费 4.36 美元,而 Carbon 收费 12.93 美元;Terra 响应更快,并且仍是 TN5000 甲状腺超声和 TXL-PBC 血细胞数据集上的排行榜最佳模型。在拥挤货架和热成像等 Carbon 优势明显的场景中,再为 Carbon 付费。
就 UL37 总体表现而言,是的。Carbon 基于 Argon 构建,mAP50 高出 0.047(0.584 对比 0.537),并超过 Argon 此前在 LLVIP 红外、HIT-UAV 热成像无人机、RUOD 水下和 Airbus Oil Storage 图像数据集上的最高分。两者的入门 token 价格相同,不过 Carbon 每次请求会使用更多思考 token。
Google 列出的优惠价格为每百万输入 token 2 美元、每百万输出 token 10 美元,优惠期截至 2026 年 11 月 30 日,之后价格分别为 4 美元和 20 美元。在我们的基准测试中,按优惠价格计算,Carbon 的供应商费用为每 1,000 张图像 12.93 美元;从 12 月 1 日起,按相同用量计算约为 26 美元。Ultralytics Platform 的批量标注费用为每处理 1,000 张图像 1.00 美元。
自 2026 年 11 月 10 日起,付费开发者和企业可以通过 Google AI Studio 中的 Gemini API 以及面向企业的 Gemini 调用 Carbon;该功能也正在向 Gemini 应用中的 Google AI Ultra 订阅用户推出。网络安全防御人员仍可通过 Google 的 Fairwind Program 获得专门访问权限。在 Ultralytics Platform 中,你需要使用自己的付费 Gemini API 密钥。
需要。即使是顶级模型,在 UL37 上的平均 mAP50 也只有 0.584;在最难的数据集上,得分要低得多,例如在 Airbus Oil Storage 数据集的 10 张基准图像上只有 0.381。请检查每张图像;对于医疗数据,还要由临床专家审核并批准边界框。
作者
评论
提出问题、分享你的结果,或帮助其他人。









