如何使用精确率和召回率选择自动标注 VLM
根据精确率和召回率选择用于自动标注的 VLM:哪些模型产生的多余框更少、漏检的目标更少,以及如何在自己的数据上进行测试。
 Sergiu Waxmann12 分钟阅读
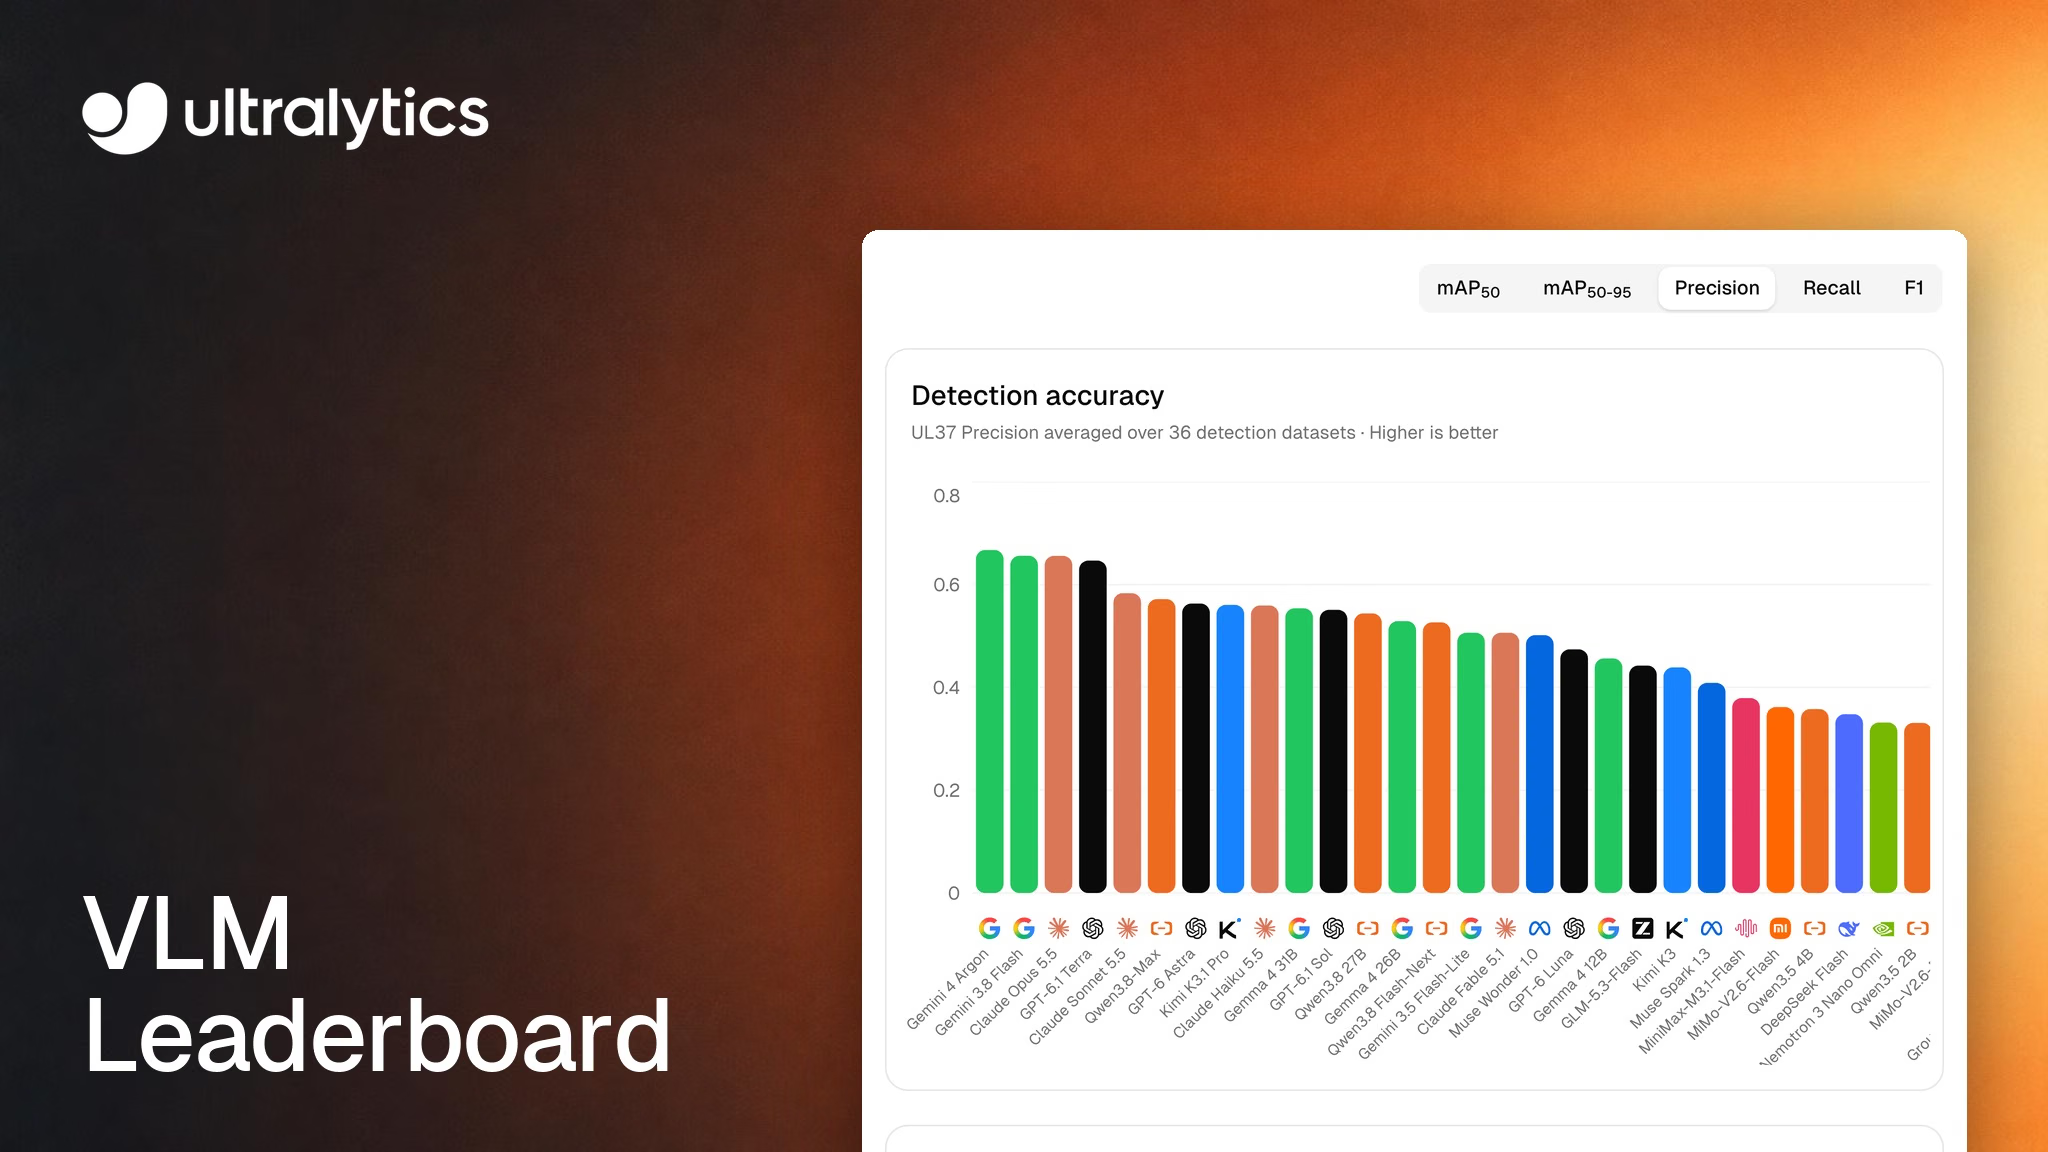
选择用于自动标注数据集的模型,归根结底取决于审核人员更愿意做哪种清理工作:删除多余的框,还是补上模型漏掉的框。Ultralytics VLM Leaderboard现在展示了每个模型在这两者之间的权衡,并列出精确率(模型预测框中正确框所占的比例)和召回率(模型找到的已标注对象所占的比例);数据来自 2026 年 10 月 28 日发布的基准测试结果。
要获得最干净的初稿,先试试 Gemini 4 Argon。要尽可能少漏掉对象,先试试 GPT-6 Astra。要兼顾两者,并选择六个得分最高的模型中成本最低的一个,就选 GPT-6.1 Terra。如果你没有自己的 AI 提供商 API 密钥,可以先试用托管版 Qwen3.8 27B;对于你宁愿事后删减的拥挤场景,也可以试试 SAM 3.1 Text。
本指南将说明如何解读这些数字、各个模型适用于哪些场景,以及如何用你自己的图像验证选择。每次运行后,排名和价格都会变化,因此请将这里的数据视为 2026 年 10 月的示例,并查看排行榜了解当前结果。
类别提示模型没有置信度滑块,因此模型选择就是你的阈值#
在标注编辑器中使用 Ultralytics YOLO 模型时,你可以自行调整这种取舍。提高置信度阈值,误检框会减少,但漏检会增加;降低阈值则相反。视觉语言模型(VLMs)的工作方式不同。标注编辑器文档中解释了,它们会使用各自特定的阈值检测数据集中的类别,并且不会返回置信度分数,因此选择这类模型时,Ultralytics Platform 会隐藏置信度和 IoU 设置。
这会影响排行榜中的精确率和召回率所代表的含义。根据基准测试方法,计算精确率和召回率时,会统计模型在 IoU 为 0.5 时返回的所有框,不存在隐藏的工作点。这些指标反映的是审核人员实际收到的框。
排行榜背后的基准测试为 UL37 v2:来自 Platform 上 36 个真实目标检测数据集的图像,每个数据集取 10 张;另有 10 张 COCO 2017 参考图像单独评分,共计 370 张图像和 7,268 个框。每张图像都使用与 Smart 和 Batch Annotation 相同的生产流程进行处理,并采用数据集自身的类别名称;SAM 3.1 会优化除 SAM 3 自身之外所有模型的框。评分使用 Ultralytics 软件包自带的检测指标,也就是用于验证 YOLO 模型的代码,并且每个数据集在平均分中的权重相同。
精确率反映未匹配的框,召回率反映未匹配的目标#
精确率是模型预测框中与正确类别的已标注目标匹配、且 IoU 为 0.5 的比例。召回率是模型匹配到的已标注目标所占的比例。从审核角度看:
- 精确率低意味着有更多框需要删除、重新标注或调整大小,直到它们与目标匹配。
- 召回率低意味着有更多已标注目标需要补框、调整框的大小或重新标注。
- F1 是精确率和召回率的调和平均值,计算公式为 2 x P x R / (P + R),用一个数字概括两者。它不衡量审核需要多长时间。
- mAP50 和 mAP50-95 根据各类别的平均精度对模型进行排名,分别采用 IoU 0.5,以及从 0.50 到 0.95 的更严格阈值。排行榜按 mAP50 排序。
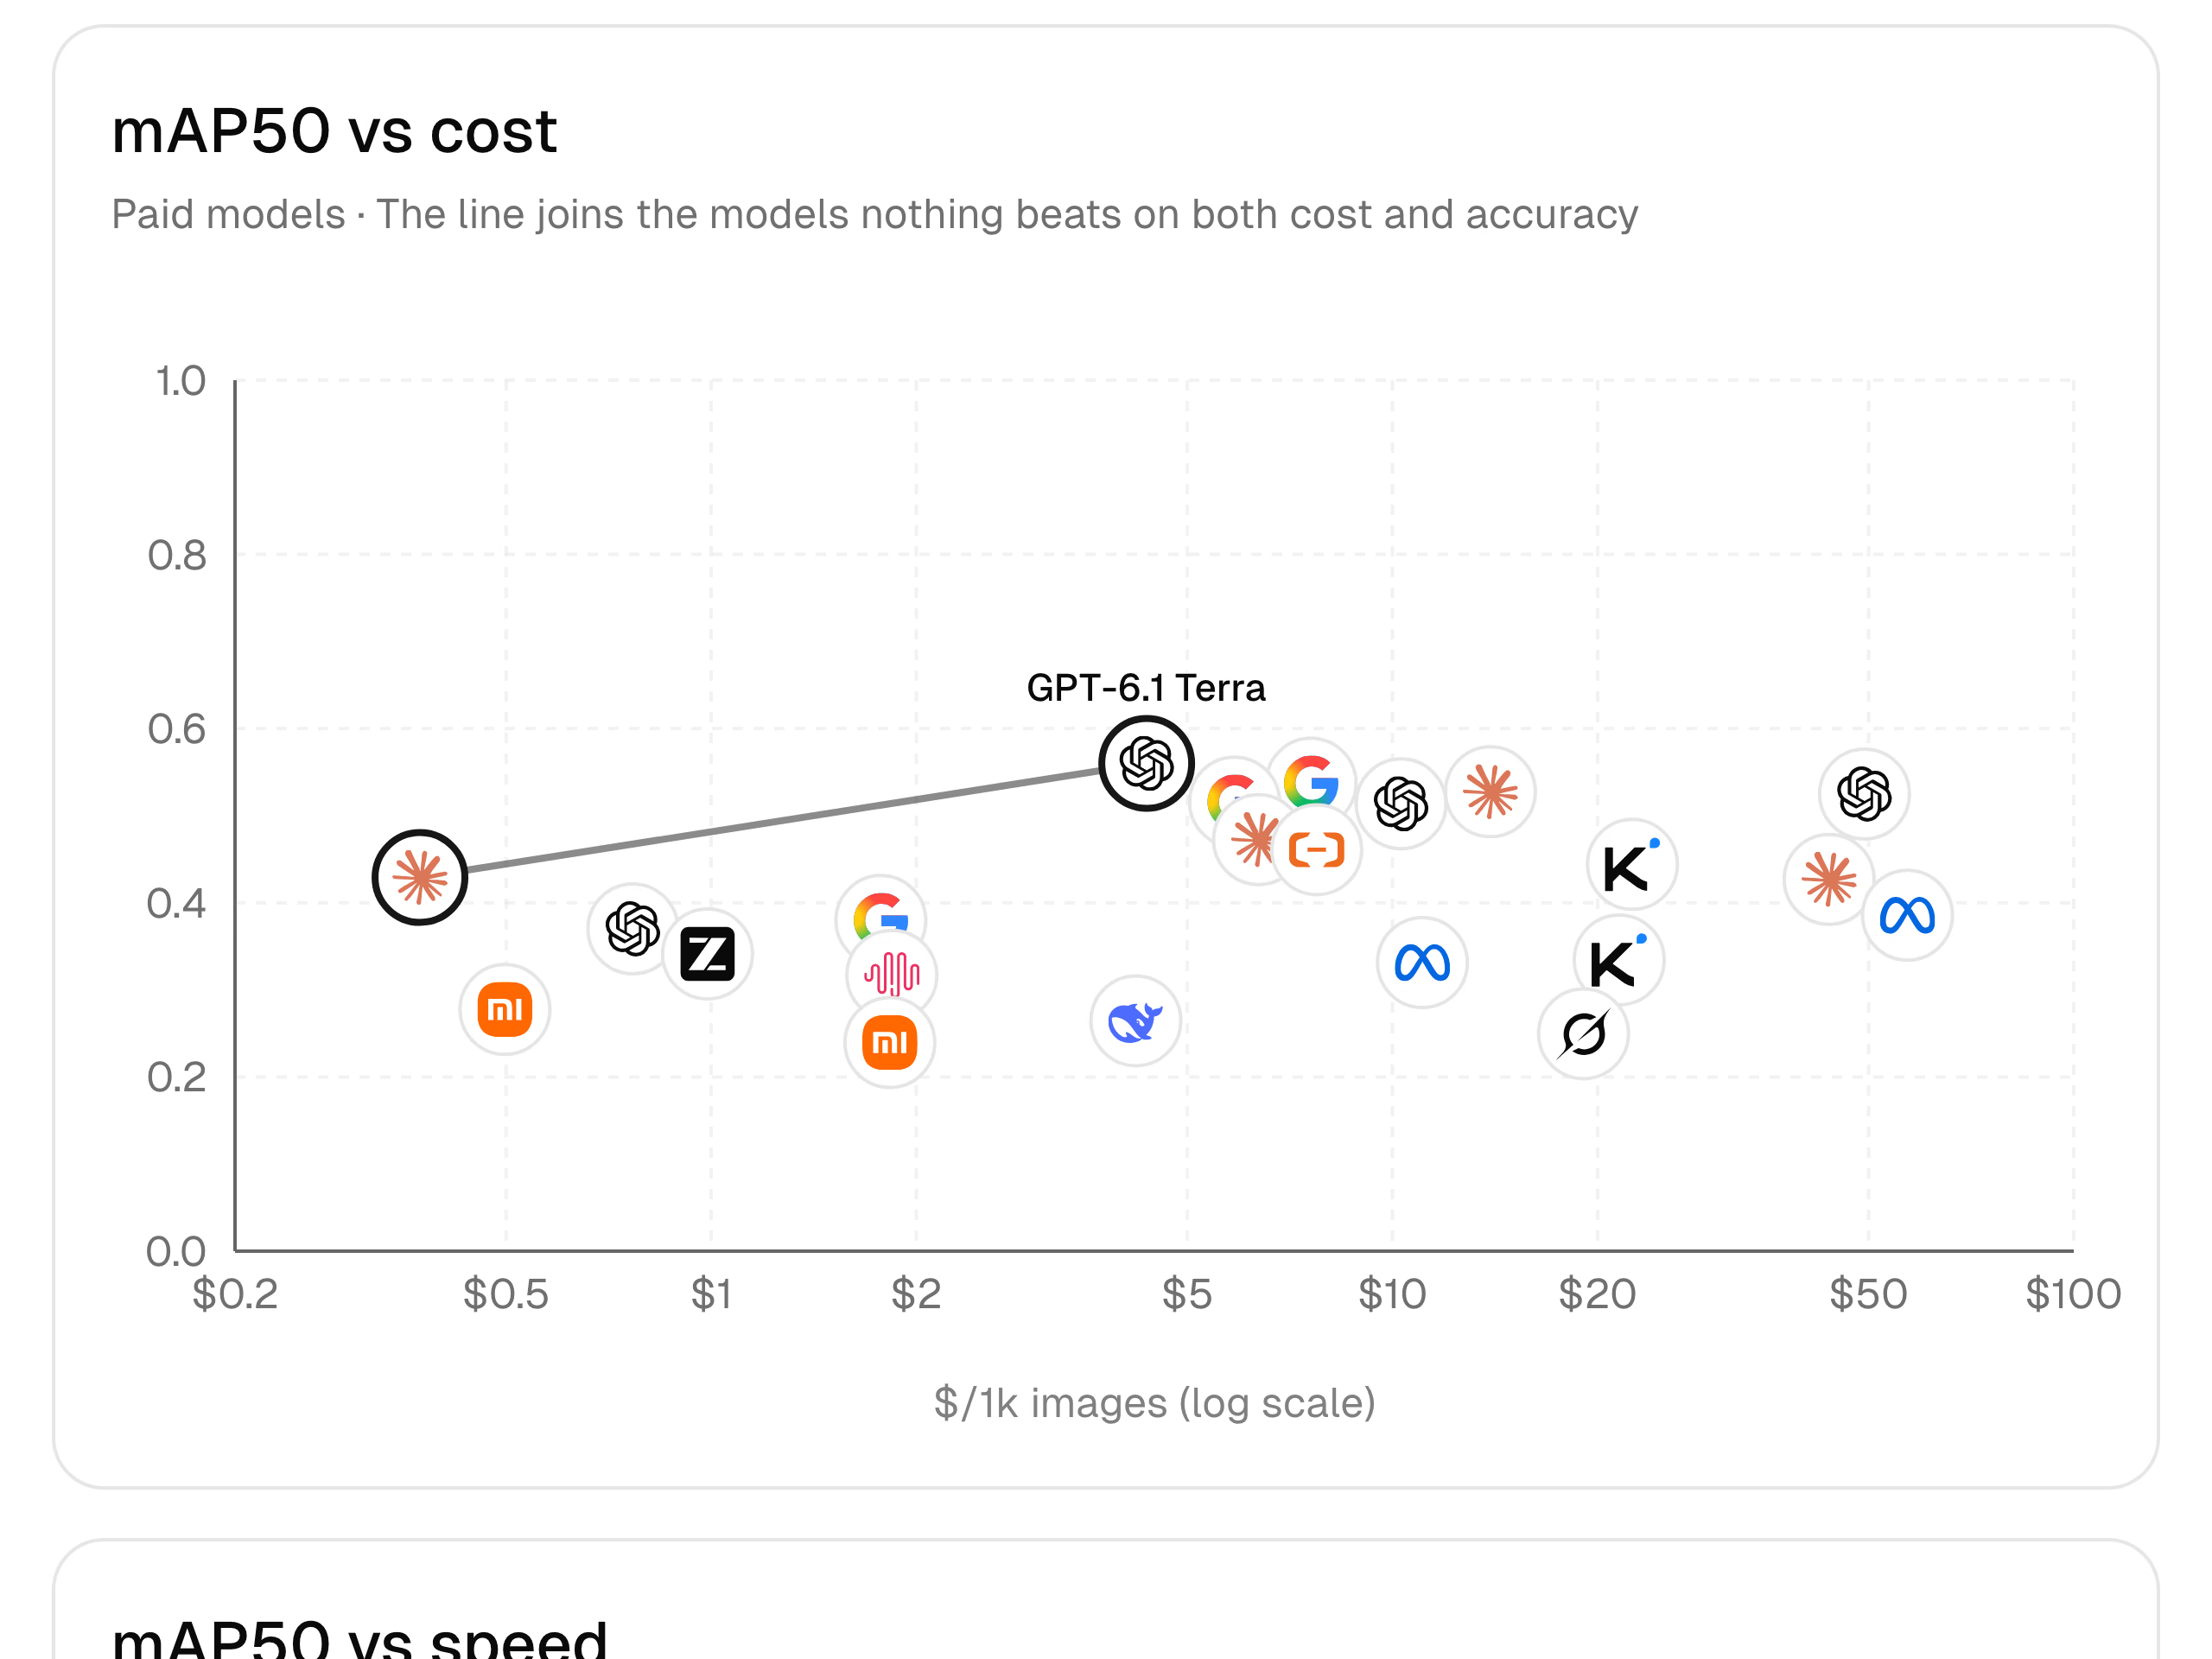
以下是 mAP50 高于 0.51 的六个模型。成本根据服务提供商报告的用量估算,单位为每成功标注 1,000 张基准测试图像所需费用;延迟为请求时间的中位数:
| 模型 | mAP50 | mAP50-95 | 精确率 | 召回率 | F1 | 服务提供商成本 / 1,000 张图像(基准测试用量) | 延迟 |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Gemini 4 Argon 的估算采用 Google 的入门定价,该价格持续到 2026 年 11 月 30 日。从 12 月 1 日起,Google 的标准费率将翻倍;按相同用量计算,每 1,000 张图像约需 15 美元。对于任何模型(包括托管模型),Ultralytics Platform 的 Batch Annotation 都会对处理的每 1,000 张图像额外收取 1.00 美元。
这六个模型分为两类。Argon、Opus 5.5 和 Gemini 3.8 Flash 的精确率为 0.66 到 0.67,召回率低于 0.60:它们预测的框中匹配正确的比例较高,但匹配到的已标注目标较少。Astra 和 Sol 的召回率达到 0.62 到 0.63,精确率为 0.55 到 0.56:它们匹配到更多已标注目标,但预测框中匹配正确的比例较低。Terra 处于两类模型之间,并在 mAP50 和 F1 上领先。
多余框修正成本高时,优先考虑精确率#
在 40 个基准测试模型中,Gemini 4 Argon 的整体精确率最高,达到 0.667。代价是其平均召回率为 0.585,低于召回率领先的模型。
当未匹配的框难以发现时,精确率最为重要。在拥挤的图像中,审核人员必须在许多正确框中找出错误框,才能修正它。密集零售货架图像集 SKU110K 展示了这类图像上的精确率差异可能有多大:在我们的 GPT-6.1 Terra 测试结果中,Terra 在该数据集上的精确率为 0.79、召回率为 0.73;而 GPT-6.1 Sol 分别为 0.49 和 0.77。
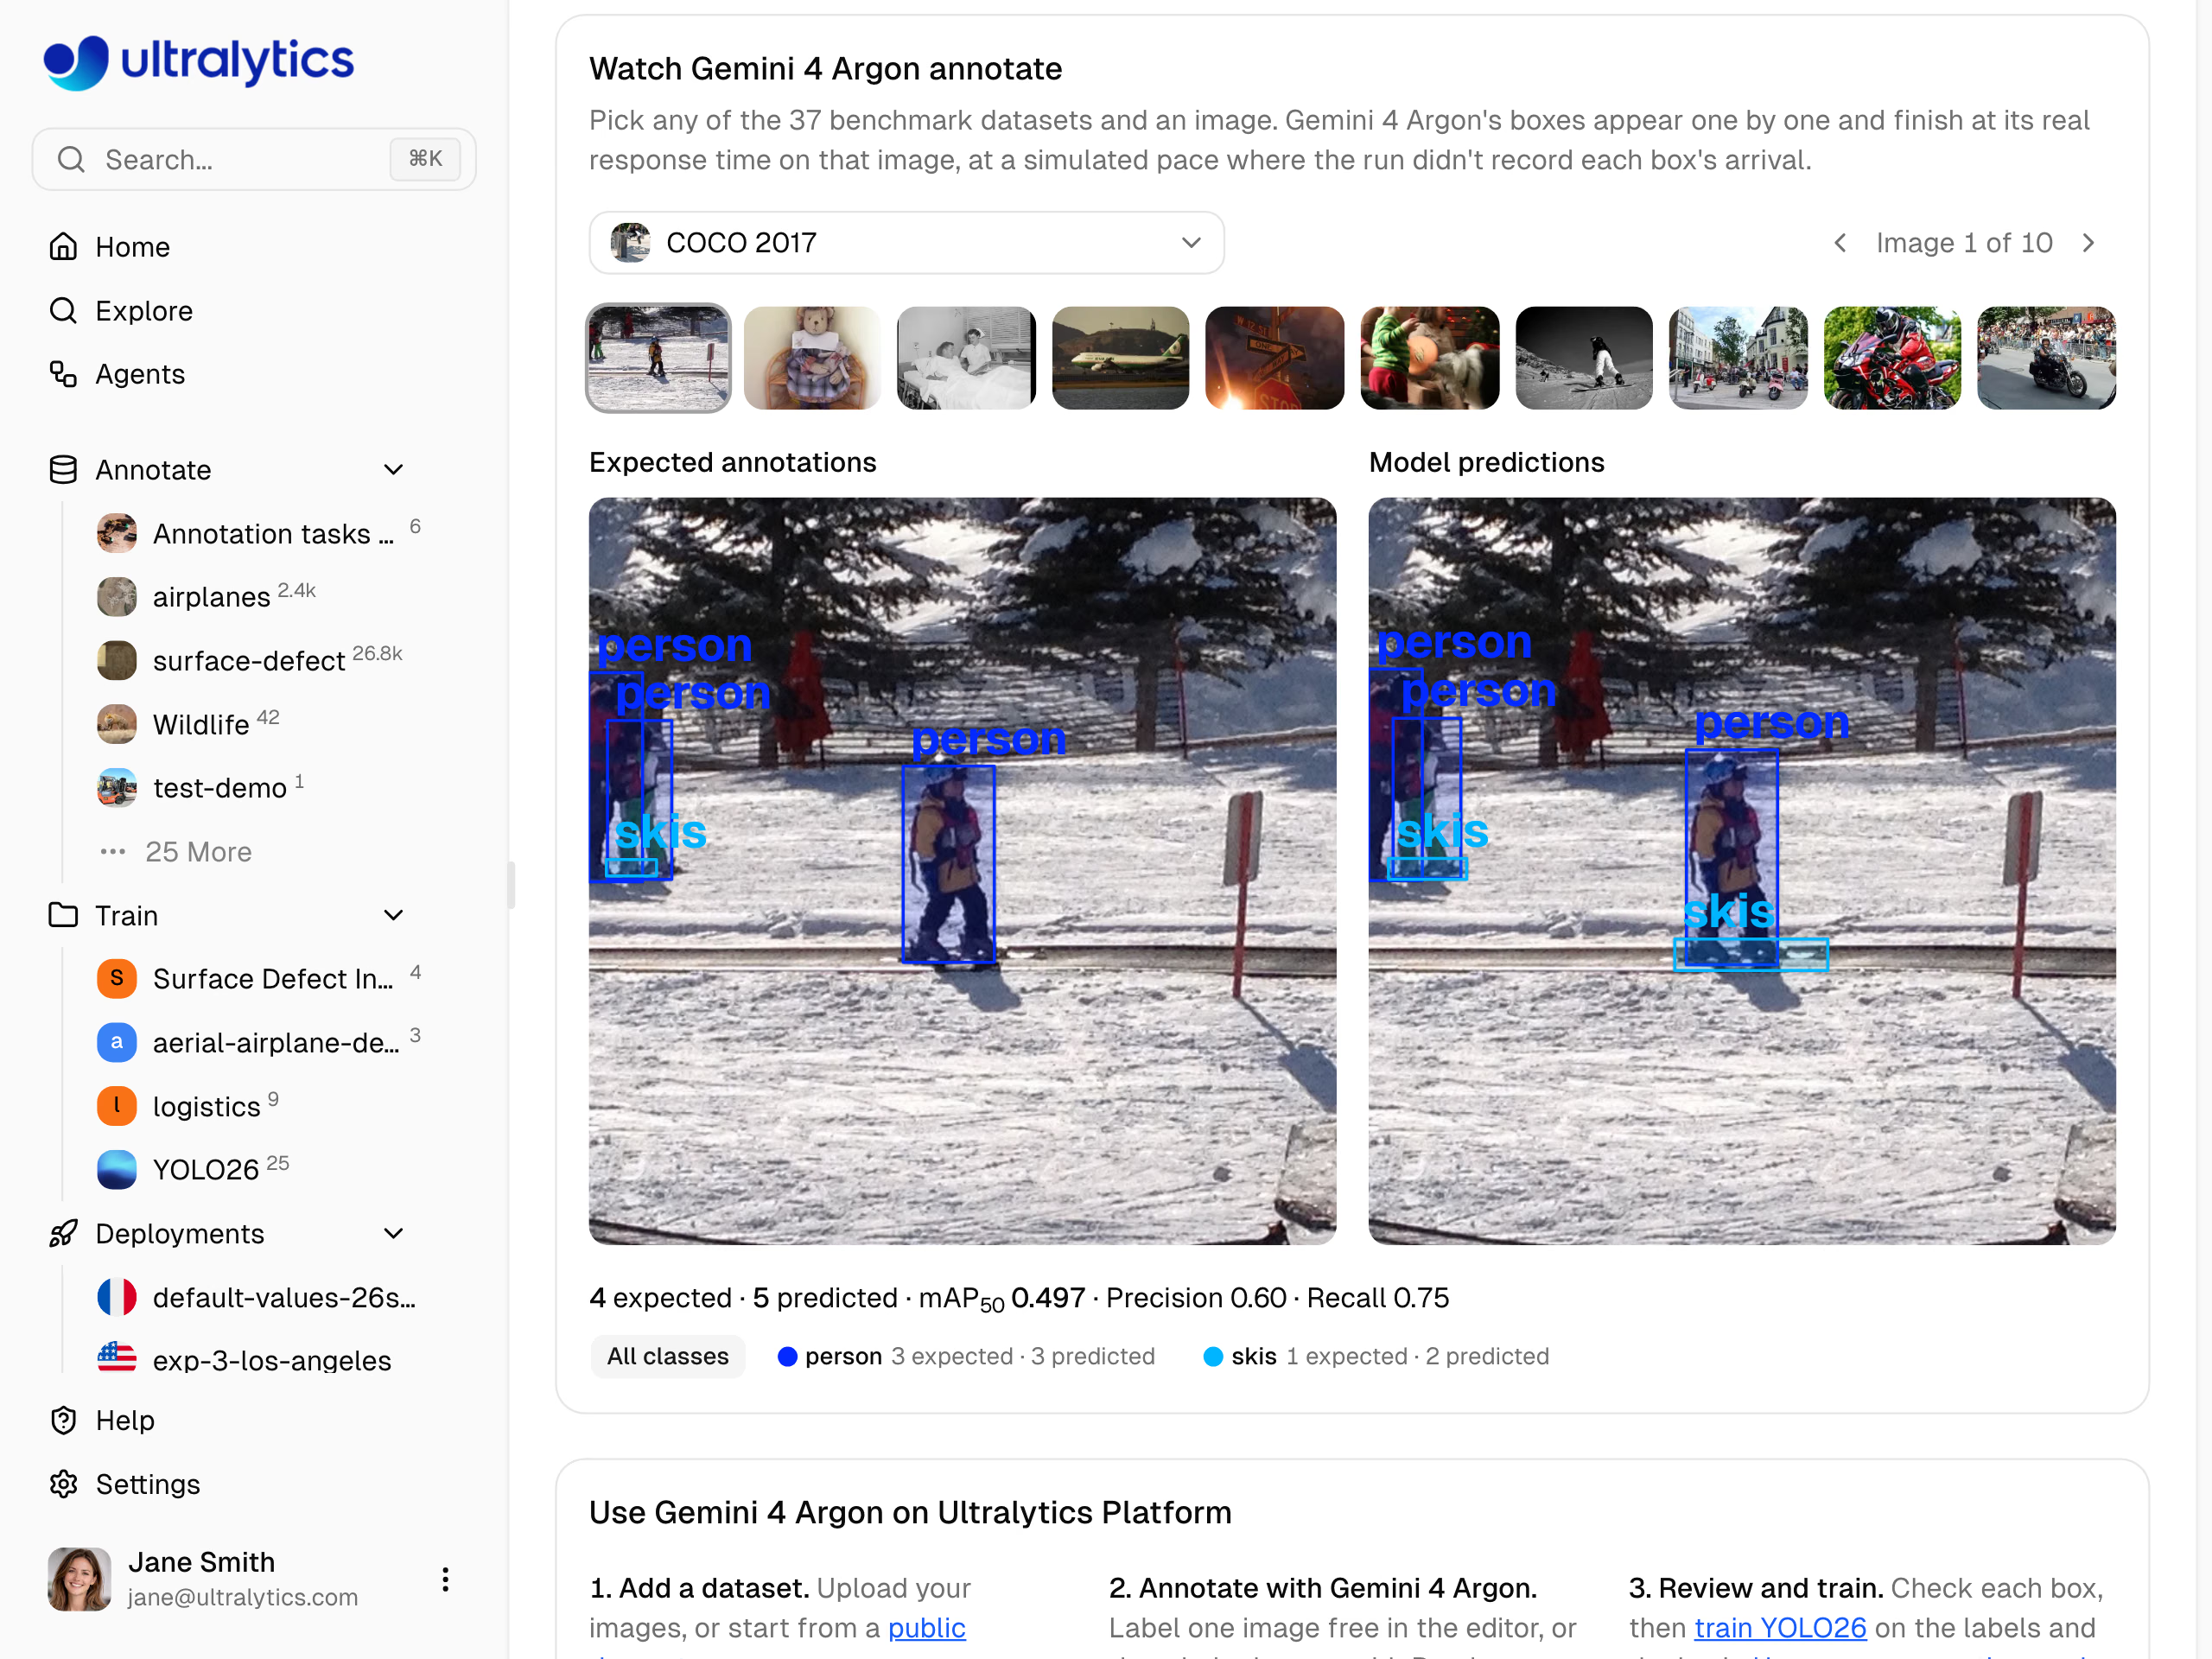
Gemini 4 Argon:为 4 个已标注目标预测了 5 个框,精确率 0.60,召回率 0.75。
Argon 在基准测试中也没有请求失败,其 4.6 秒的中位数响应时间是前两名中最快的。如果你的数据与它表现出色的领域相似,就可以选择它:航拍、水下、热成像和安检 X 光图像(它在 IEDXray 安检扫描数据集上的 mAP50 最高,为 0.298)。如果你的团队宁愿补全少数漏掉的对象,也不愿费力寻找多余的框,也可以选择它。
漏掉目标的错误代价高时,优先考虑召回率#
GPT-6 Astra 的平均召回率在排行榜上最高,为 0.627。其代价是精确率只有 0.56。
当漏标对象造成的代价更高时,优先追求召回率是合理的。训练集中漏掉的缺陷或病灶会让检测器把该对象学成背景;而要找出漏掉的框,就得逐张检查图像,寻找未标注的对象。Astra 在 36 个数据集中有 7 个取得最高 mAP50,其中包括 TBX11K 胸部 X 光图像(0.330)、GRAZPEDWRI-DX 儿童腕部 X 光图像(0.354)和 DsPCBSD+ PCB 表面缺陷(0.394);这说明值得在类似数据上测试它,但不能证明它在你的数据上漏检更少。
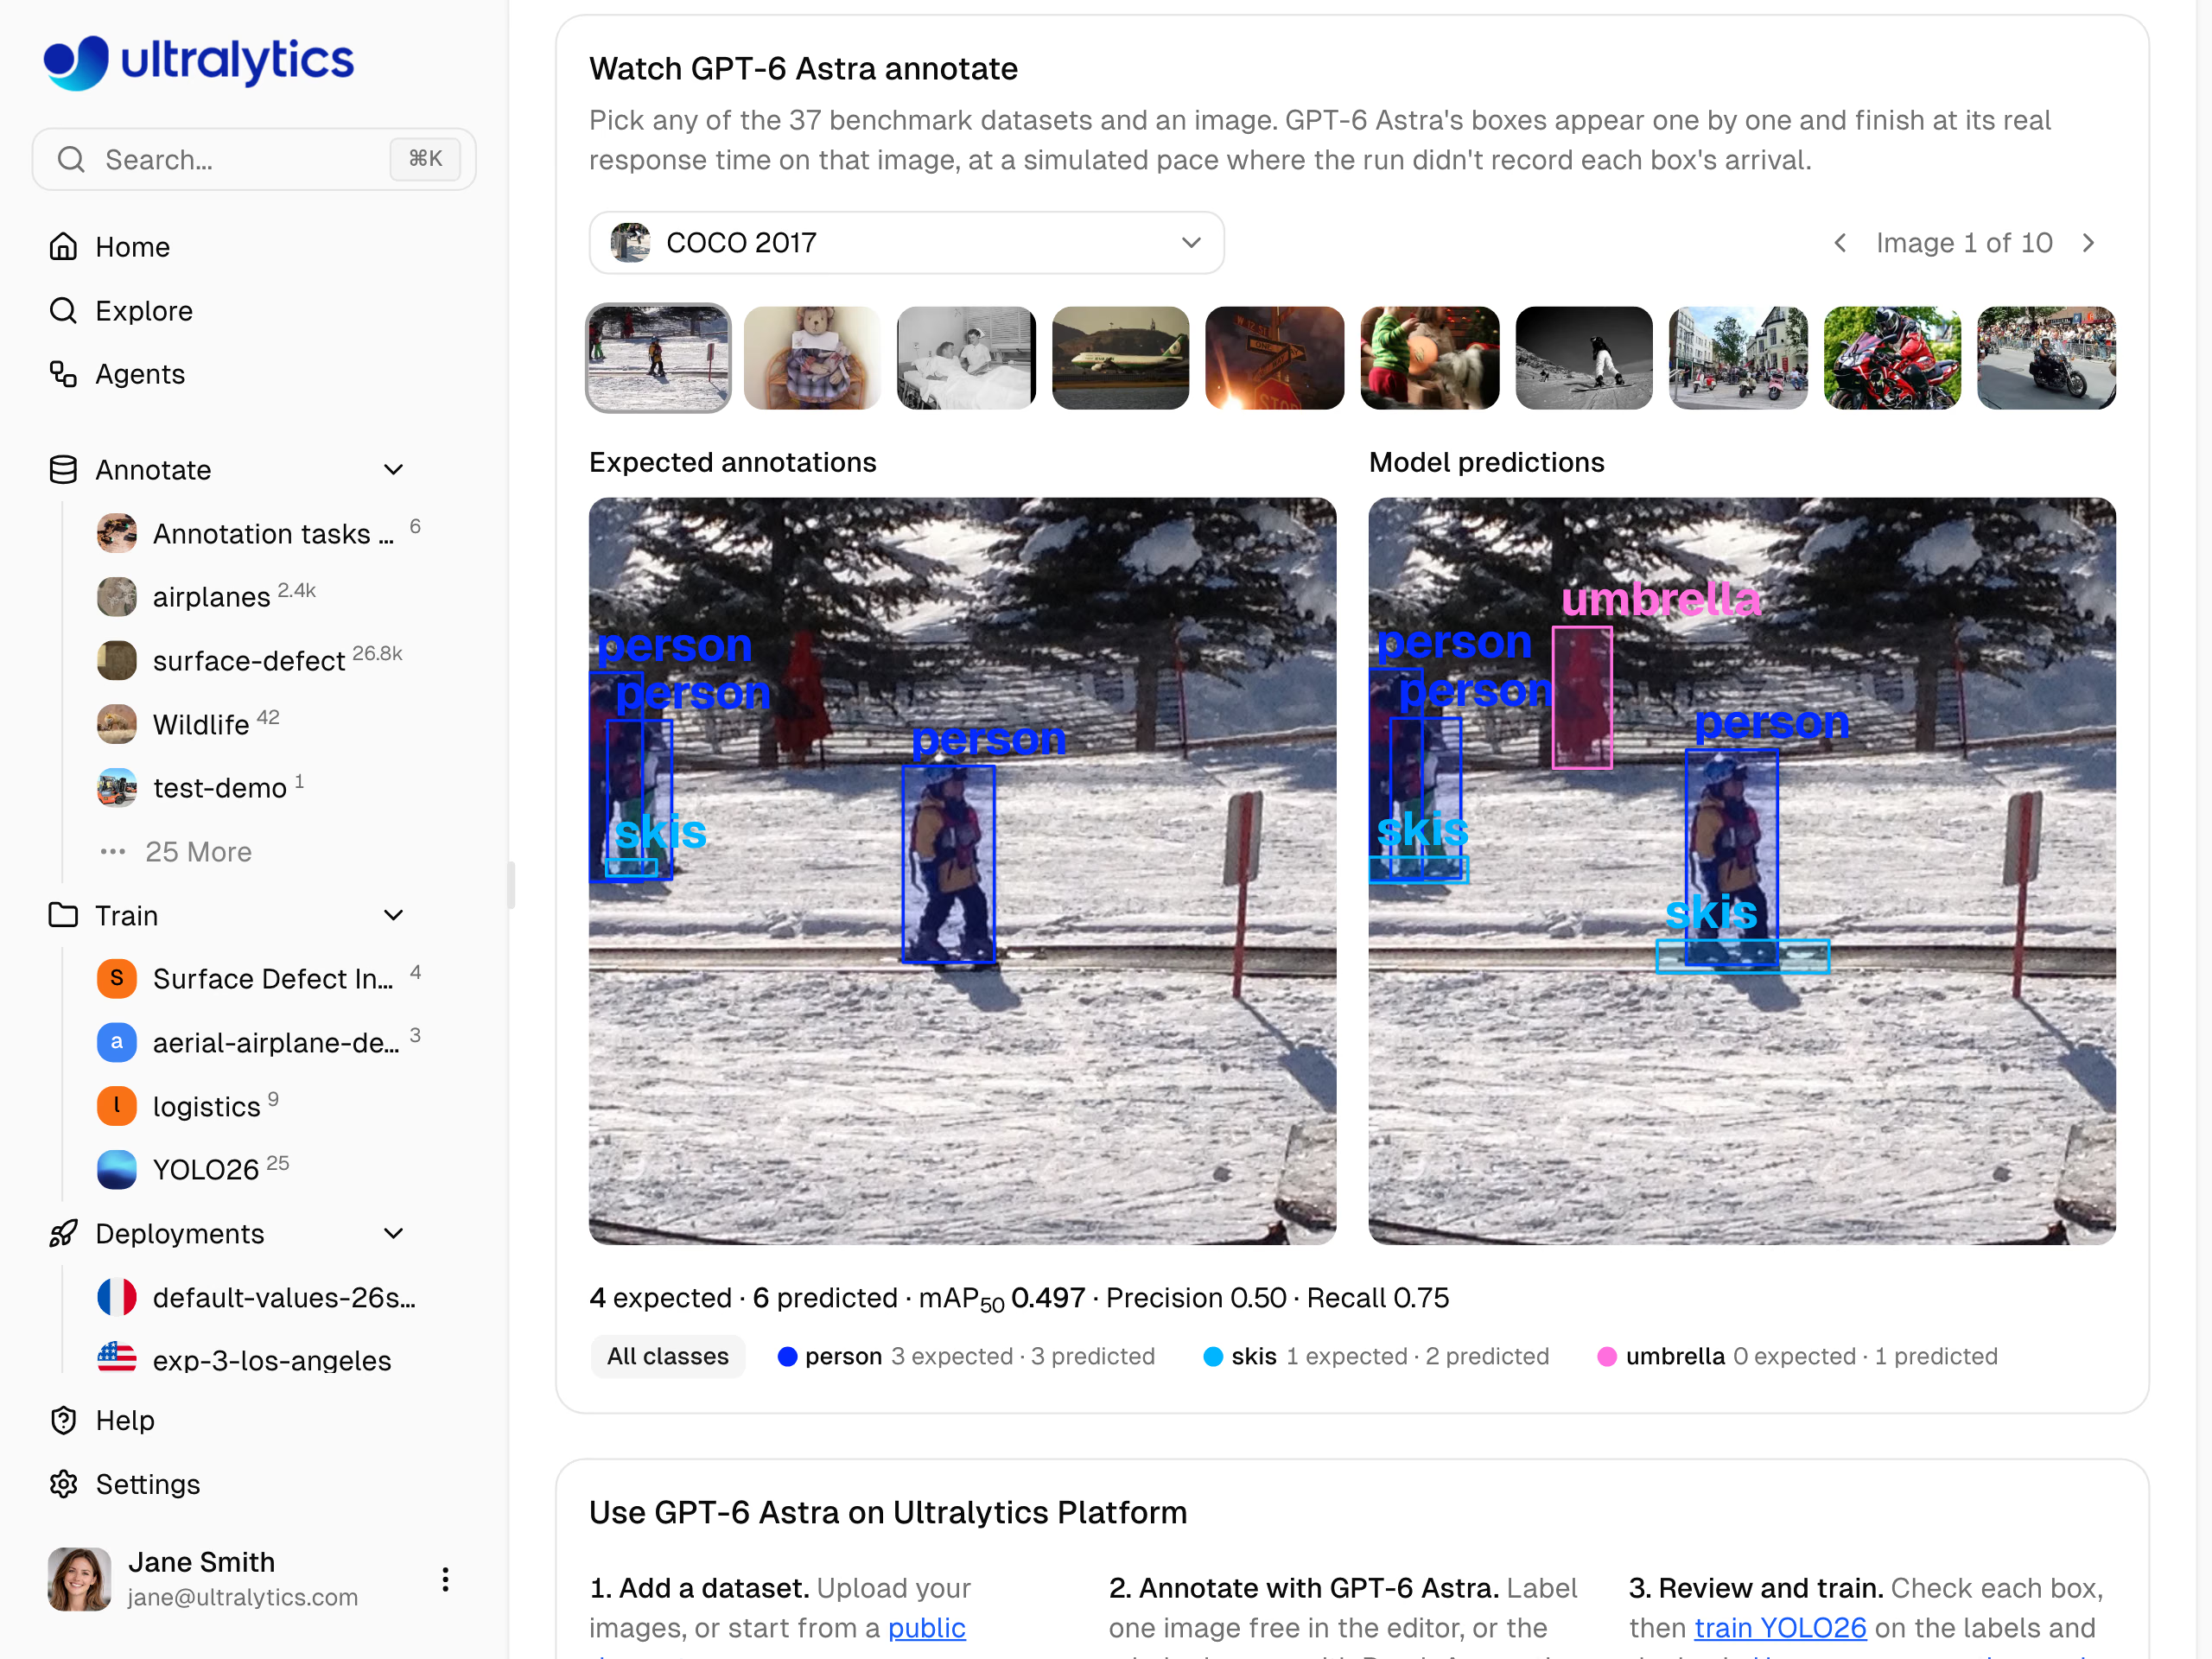
GPT-6 Astra:同样的 4 个对象标出了 6 个框,其中包括 COCO 标签中未标出的雨伞;精确率为 0.50,召回率为 0.75。
在前六名中,Astra 的成本估算最高,每 1,000 张图像为 49.31 美元;中位耗时为 11.6 秒,且 1% 的图像请求失败。另有两个 OpenAI 模型的召回率接近:GPT-6.1 Sol 为 0.62,估算成本为 10.30 美元;GPT-6.1 Terra 为 0.61,估算成本为 4.36 美元。
结合 mAP50-95 和 F1 权衡两种错误#
GPT-6.1 Terra 以 0.560 的 mAP50 和 0.345 的 mAP50-95 位居榜首。它的精确率为 0.646,召回率为 0.613,都与领先模型相差不到几个百分点;其 F1 为 0.63,是六个模型中最高的,略高于 Argon 和 Opus 5.5 的 0.62。F1 差距很小,而且 F1 不反映审核时间,因此可以根据各领域的结果和在你自己的图像上进行的测试来决定。
它在 mAP50-95 上领先,又提供了另一项参考。mAP50-95 会对最高 0.95 的重叠阈值取平均,因此既奖励匹配框贴合紧密的模型,也奖励能找到正确目标的模型;Terra 在这项指标上同样排名第一。它在前六名中的成本估算也最低,且没有请求失败,排行榜将其标记为“性价比最佳”。
没有服务提供商密钥也能标注:托管模型和开放词汇检测器#
并非每个团队都想使用付费服务提供商密钥。Platform 上的托管模型无需密钥即可运行,它们各项指标的表现有所不同:
- SAM 3.1 Text: mAP50 为 0.332,精确率为 0.19,召回率为 0.47,每张图像耗时 0.2 秒。它在全部 40 个模型中,在 VisDrone(mAP50 为 0.479)和 Fisheye8K 交通数据集(0.478)上的表现最佳。
- Qwen3.8 27B: mAP50 为 0.351,精确率为 0.54,召回率为 0.40,耗时 1.5 秒。
- Gemma 4 26B: mAP50 为 0.344,精确率为 0.53,召回率为 0.39,耗时 0.9 秒。
开放词汇检测器也采用托管方式。在这次基准测试中,OWLv2 Large 的 mAP50 为 0.133,Grounding DINO Base 为 0.104,两者每张图像都耗时 0.2 秒;SAM 3.1 Text 的 mAP50 则为 0.332。这些分数衡量的是 Platform 上采用 SAM 3.1 框优化的类别提示流程,并非各模型原始设置下的表现。
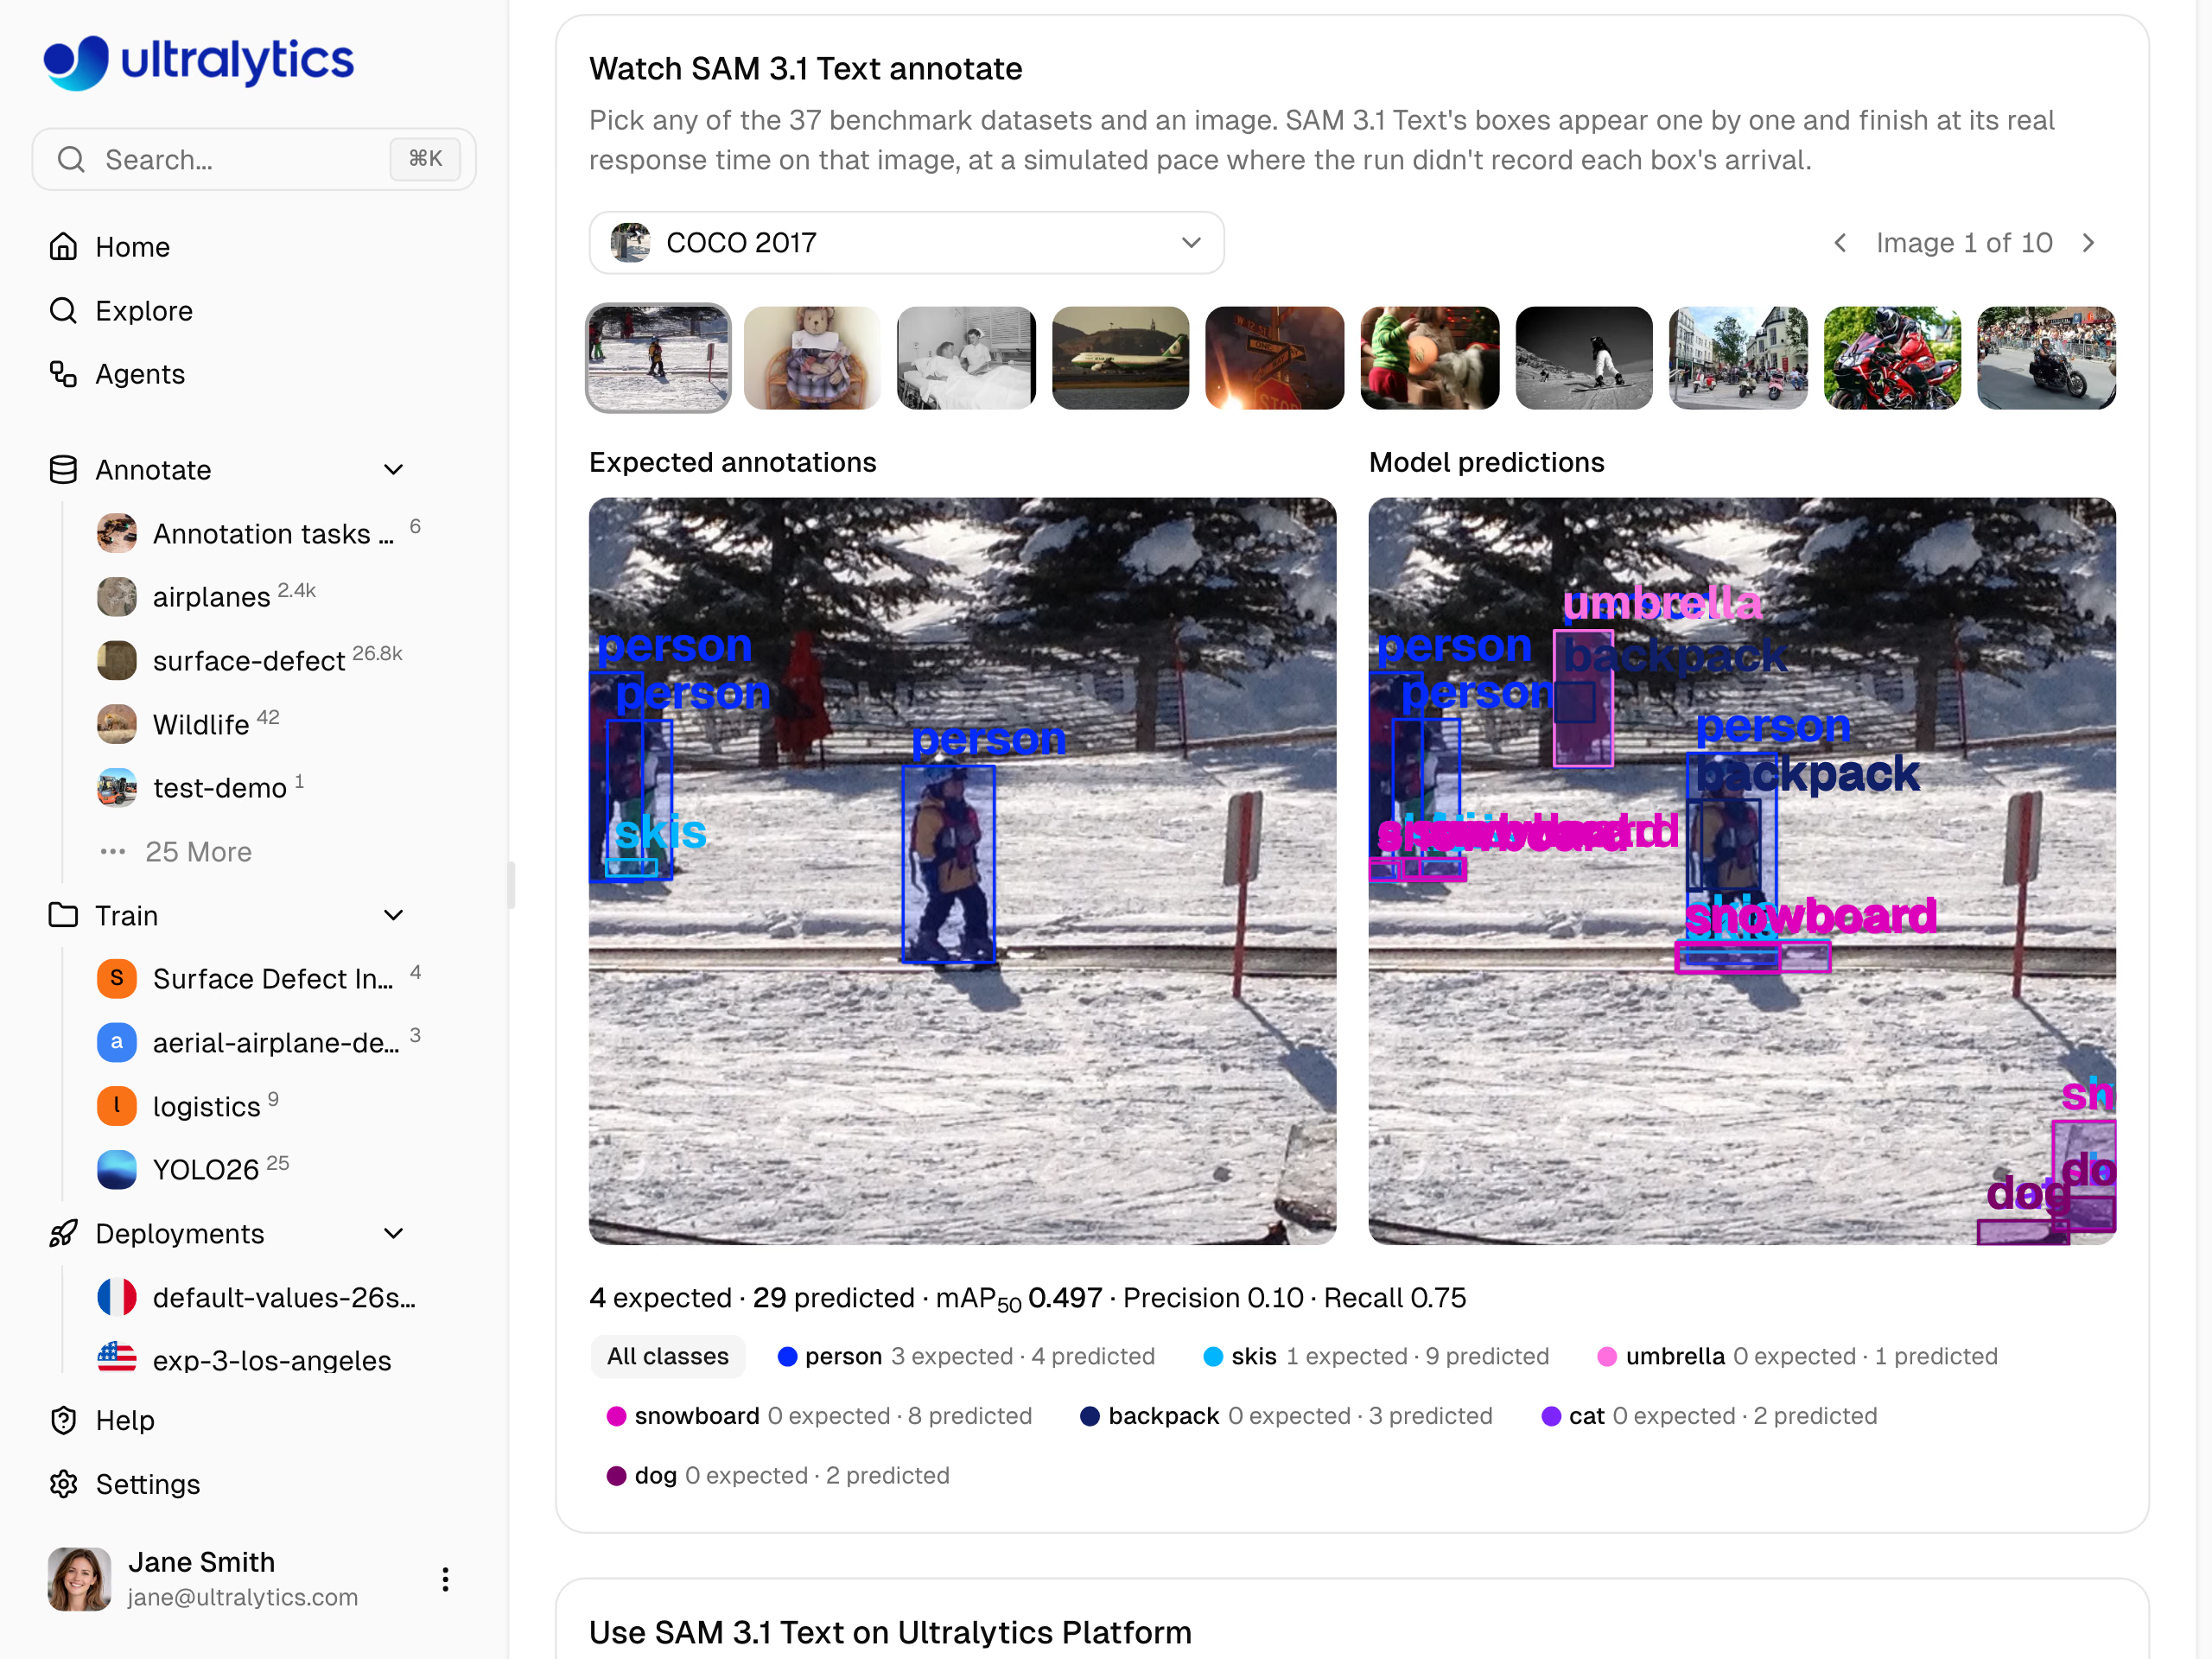
SAM 3.1 Text:为 4 个目标预测了 29 个框,精确率 0.10,召回率 0.75。三次回放都找到了 4 个目标中的 3 个;不同之处在于审核人员需要删除多少个多余框。
在拥挤的航拍和交通场景中,如果审核人员预期初稿会有不少框需要删减,SAM 3.1 Text 就很适合。Qwen3.8 27B 和 Gemma 4 26B 的表现与谨慎型模型类似,但准确率较低。在低成本付费模型中,Claude Haiku 5.5 的 mAP50 为 0.429,精确率为 0.56,召回率为 0.47;估算成本为每 1,000 张图像 0.37 美元,是排行榜上另一个被标记为“性价比最佳”的模型。
整体平均值会掩盖你的数据领域差异,因此请查看数据集表格#
每个模型的精确率和召回率是对 36 个数据集取平均,而你的数据只属于其中一个领域。VLM 排行榜的数据集表格按难度从高到低列出所有数据集在全部 40 个模型上的平均精确率和召回率,并列出每个数据集上的最佳模型。
查看表格,留意可能的问题。在 Airbus Oil Storage Detection 上,10 张图像共标注了 2,267 个储油罐;模型的平均精确率为 0.39,平均召回率为 0.11,最佳 mAP50 是 Gemini 4 Argon 的 0.347。在 DeepPCB 上,平均精确率和召回率分别为 0.03 和 0.04,而 GPT-6.1 Sol 的表现较突出,mAP50 为 0.393。
把这些数字当作筛选参考,而不是最终结论。方法说明指出,每个数据集取 10 张图像足以对模型和数据领域进行排名,但不足以确定单个数据集的分数;重复运行时,个别数字也会有几个百分点的波动。Platform 上每个模型页面都会在基准测试数据集和 COCO 上,将模型记录的框与预期框并列回放,因此你可以在开始运行前检查与你的数据最相似的数据集。
五步将模型与审核流程相匹配#
从你的选择优先级出发,然后在自己的图像上确认选择:
| 你的优先事项 | 候选模型(2026 年 10 月结果) |
|---|---|
| 优先考虑精确率 | Gemini 4 Argon |
| 优先考虑召回率 | GPT-6 Astra 或 GPT-6.1 Sol |
| 兼顾两者 | GPT-6.1 Terra |
| 没有服务提供商密钥 | 托管版:Qwen3.8 27B 或 SAM 3.1 Text |
类别提示标注适用于包含 1 到 200 个类别的检测数据集。
- 在排行榜上筛选候选模型。将目标检测 VLM 排行榜筛选为付费或托管模型(跳过标记为“平台不提供”的模型),查看与你的优先事项对应的列,并检查数据集表中与你所在领域相关的内容。
- 添加服务提供商密钥。 对于付费模型,请在拥有该数据集的工作区中,通过设置 > API 密钥保存你的密钥。服务提供商会直接向你的密钥计费;服务提供商密钥文档介绍了设置方法。
- 在已审核的样本上测试。 选取几张能代表你的数据、且已由你手动标注的图像。打开标注编辑器,切换到 Smart 模式,在模型选择器中选择其服务提供商下的模型,然后点击 Predict(
P)。统计你删除的框、添加的框,以及审核所需的时间。 - 标注数据集。 在数据集页面中,选择 更多操作 > 批量标注。此功能适用于托管在 Platform 上且最多包含三个图像通道的数据集。默认情况下,它会标注未标注的图像,不会更改现有标签,并会先保存一个数据集版本,方便你回滚。开始前,请在对话框中查看预估成本:批量标注每处理 1,000 张图像收费 1.00 美元,另加任何服务提供商费用。
- 审核,然后训练。 根据模型的薄弱之处检查框,保存后,在同一工作区中使用结果训练 Ultralytics YOLO 模型。
如需了解背景信息,请参阅Ultralytics Platform 如何使用 AI 自动化标注,以及人在回路审核为何仍是工作流程的一部分。若想了解不同工具中的自动标注与主动学习有何区别,请阅读我们的自动标注与主动学习对比。
按团队需求筛选候选模型(2026 年 10 月结果)#
- 宁愿补全初稿也不愿清理初稿的审核人员: Gemini 4 Argon,整体精确率最高,在航拍、水下、热成像和安检 X 光数据上表现最强。
- 漏检会污染训练数据的稀有目标: 追求最高召回率选 GPT-6 Astra,或选择表现紧随其后的 GPT-6.1 Sol。
- 没有明显偏好的通用标注需求: GPT-6.1 Terra,在 mAP50、mAP50-95 和 F1 上均排名第一。
- 没有服务提供商密钥的团队: 在拥挤场景中进行偏重召回率的初步标注,可选 SAM 3.1 Text;想要更谨慎的初稿,可选 Qwen3.8 27B。
无论你选择哪个模型,排行榜都能让你在开始审核前预估审核工作量。如需了解这些指标背后的原理,我们的准确率、精确率和召回率指南介绍了基础知识,而 Academy 关于解读检测指标的课程则有更深入的讲解。
常见问题
如果删除错误框更耗时,就优先考虑精确率,例如在拥挤图像中,多余框会混在正确框之间。如果漏掉目标的代价更高,例如稀有缺陷或病灶,就优先考虑召回率,因为漏标目标会让检测器学到该目标属于背景。然后,在你自己的图像中选取一组经人工审核的样本,确认这一选择。
类别提示模型返回的框没有置信度分数,并使用各自特定的阈值,因此选择这类模型时,Platform 会隐藏置信度和 IoU 设置。因此,排行榜中的精确率和召回率会统计模型在 IoU 为 0.5 时返回的所有框。要调整未匹配框与未匹配目标之间的平衡,你需要选择其他模型。
使用 mAP50 查看模型能否找到并标注正确目标;使用 mAP50-95 则可加入更严格的重叠阈值,从而奖励框与目标贴合紧密的模型。两者也都会受到漏检和误检的影响,因此要结合精确率和召回率解读。在 2026 年 10 月的结果中,GPT-6.1 Terra 在这两项指标上都领先,分别为 0.560 和 0.345。
需要。UL37 v2 上排名第一的模型平均 mAP50 为 0.560(2026 年 10 月);而在 PCB 缺陷和胸部 X 光等最难的数据集上,40 个模型的平均值低于 0.05。请审核每张图像,并重点检查模型的薄弱之处:偏重召回率的模型可能会产生多余框,偏重精确率的模型则可能漏掉目标。
费用分为两部分。对于任何模型(包括托管模型),Ultralytics Platform 的 Batch Annotation 每处理 1,000 张图像收费 1.00 美元(最低 0.01 美元);在编辑器中使用托管模型进行单次预测则免费。付费服务提供商模型的费用也会由服务提供商直接计入你自己的 API 密钥。在 2026 年 10 月的基准测试中,本指南所列模型的服务提供商费用估算范围为每 1,000 张图像 0.37 美元(Claude Haiku 5.5)至 49.31 美元(GPT-6 Astra)。停止运行时,已处理图像的费用仍会计入。
可以。SAM 3.1 Text、Qwen3.8 27B 和 Gemma 4 26B 等托管模型,以及你自己的 YOLO 模型,都能在 Ultralytics Platform 上运行,无需服务提供商密钥。批量运行仍按每处理 1,000 张图像收费 1.00 美元,并且每次运行前,对话框都会显示费用估算。
这取决于任务。类别提示 VLM 仅凭类别名称就能为新类别生成标签初稿,但在 2026 年 10 月的基准测试中,得分最高的六个模型每张图像耗时 2.7 到 11.6 秒,并按 token 计费。对于实时检测,一种常见做法是先用 VLM 自动标注,再审核标签,然后训练 Ultralytics YOLO 模型。你已经训练好的 YOLO 模型也可以在同一编辑器中为新图像自动标注。
作者
评论2
提出问题、分享你的结果,或帮助其他人。
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









