Data Curation
تنظيم البيانات هو عملية مستمرة تشمل تنظيم مجموعات البيانات الموثوقة للتحقق منها وتوثيقها وصيانتها لأغراض التعلم الآلي والتقييم.
تنظيم البيانات هو عملية مستمرة لاختيار البيانات وتنظيمها والتحقق منها وتوثيقها وصيانتها كي تظل مفيدة لغرض محدد. في تعلم الآلة، يشكّل تنظيم البيانات الأمثلة التي يتعلم منها النموذج والأدلة المستخدمة لتقييمه. تجمع مجموعة البيانات المنظّمة عينات ذات صلة، وتسميات متسقة للمهام الخاضعة للإشراف، ومعلومات سياقية، وإصدارات قابلة للتتبّع.
تنظيم البيانات وتنظيفها والمعالجة المسبقة#
يشمل تنظيم البيانات دورة حياة مجموعة البيانات. يصحح تنظيف البيانات الأخطاء ويزيل السجلات غير القابلة للاستخدام؛ بينما تحوّل المعالجة المسبقة للبيانات المدخلات عبر عمليات مثل تغيير الحجم أو التطبيع. وتضيف التعليقات التوضيحية للبيانات، التي تُسمى أيضًا تسمية البيانات، الأهداف المستخدمة في التعلم الخاضع للإشراف. وينسّق تنظيم البيانات هذه الأنشطة، مع تحديد العينات التي ينبغي تضمينها، وكيفية تعريف الفئات، وكيفية تغيّر المجموعة بمرور الوقت. وتساعد التعريفات المتسقة للفئات وقواعد التسمية النماذج على تعلّم علاقات موثوقة بين الصور والأهداف.
وهذا يجعل تنظيم البيانات عنصرًا عمليًا من الذكاء الاصطناعي المرتكز على البيانات، الذي يحسّن الأنظمة من خلال تحسين بياناتها.
آلية تنظيم البيانات#
تبدأ العملية بمواصفات مجموعة البيانات: مهمة التنبؤ، والفئات المستهدفة، وظروف التشغيل، ومعايير التضمين. في اكتشاف الأجسام، يشمل ذلك قواعد مربعات الإحاطة والأجسام الظاهرة جزئيًا. وتكشف مراجعة تكرار الفئات وظروف الالتقاط عن تحيز مجموعة البيانات، بما في ذلك الفئات أو البيئات غير الممثلة تمثيلًا كافيًا.
تجمع فحوصات الجودة بين الفحص الآلي والمراجعة البشرية. تكشف فحوصات الملفات الصور التي يتعذر قراءتها؛ وتحدد فحوصات التعليقات التوضيحية الإحداثيات غير الصالحة والفئات غير المتسقة. وتكشف تجزئات الملفات الدقيقة النسخ المتطابقة، بينما تساعد التضمينات—وهي تمثيلات رقمية لمحتوى الصور—على تحديد العينات المتشابهة بصريًا. وتميّز المراجعة الأخطاء القابلة للإصلاح عن السجلات غير القابلة للاستخدام، مع الاحتفاظ بالعينات الصالحة والصعبة التي تمثل المهمة.
يمكن أن يحتفظ تدقيق تجزئات الملفات بمسار واحد لكل ملف فريد. يفحص هذا المثال الصور المضمّنة في الحزمة ultralytics، المثبّتة باستخدام pip install ultralytics:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
تُظهر الأعداد عدد الملفات المتبقية بعد إزالة التكرارات المتطابقة تمامًا؛ وتشير الأعداد المتساوية إلى أن تجزئات جميع الملفات التي أُخذت منها عينات مختلفة.
يحافظ التقسيم على استقلالية بيانات التدريب وبيانات التحقق وبيانات الاختبار. تتشارك إطارات الفيديو المتقاربة محتوى المشهد، لذا فإن توزيعها على أقسام مختلفة يؤدي إلى تسرّب البيانات ويرفع درجات التقييم. ويساعد التجميع حسب جلسة التسجيل أو الكاميرا أو الموقع على جعل التقييم ممثلًا لمهمة التعميم المقصودة. ويحافظ إصدار ثابت من مجموعة البيانات على هذه التعيينات إلى جانب تسمياتها.
تدعم Ultralytics Platform تنظيم البيانات من خلال مخططات توزيع الفئات وتجميع الصور في عناقيد، ما يكشف فجوات التغطية والنسخ المكررة والقيم الشاذة. وتتيح أدوات إدارة مجموعات البيانات للفرق فحص هذه المجموعات وتحديث الصور والتسميات وتعيينات التقسيم.
مهام أمين البيانات#
يحافظ أمين البيانات على معنى المجموعة وقابليتها للاستخدام. وتشمل المسؤوليات توثيق المصادر، وتنسيق إرشادات التعليقات التوضيحية، وحل الخلافات حول التسميات، وتسجيل التغييرات. وتلتقط البيانات الوصفية—أي المعلومات التي تصف العينات—وقت الالتقاط والمستشعر والموقع وحالة التعليقات التوضيحية. ويشمل الحفاظ على بيانات قابلة لإعادة الاستخدام صون الأوصاف والوثائق الداعمة.
يسجل مصدر البيانات أصول العينات والتحويلات التي خضعت لها. ويساعد ربط إصدارات مجموعة البيانات بـتتبّع التجارب على إعادة إنتاج مقارنات النماذج. وبعد النشر، يعطي التعلّم النشط الأولوية للعينات الغنية بالمعلومات لمراجعتها؛ ويرصد الرصد انجراف البيانات، الذي قد يستدعي جمع بيانات جديدة.
أمثلة في الرؤية الحاسوبية#
في الإدراك للمركبات، تضم مجموعة BDD100K الأصلية 100,000 مقطع فيديو للقيادة من مواقع مختلفة في الولايات المتحدة، وفي ظروف جوية متنوعة، نهارًا وليلًا. وتدعم سماتها البيئية التقييم عبر ظروف الالتقاط المختلفة. أما إصدار Platform فيضم 99,996 صورة إطار مفتاحي للكشف.
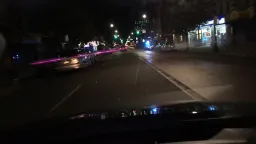 معاينة 1 لـ BDD100K
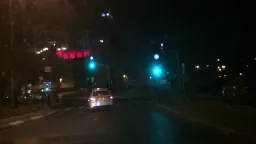 معاينة 2 لـ BDD100K
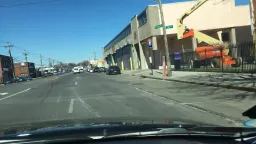 معاينة 3 لـ BDD100K
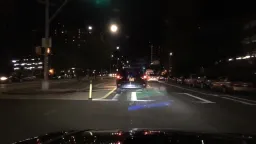 معاينة 4 لـ BDD100K
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
في تصنيف الصور، استبدل تصحيح ciFAIR الصور شبه المكررة في مجموعتي الاختبار الأصليتين لـCIFAR-10 وCIFAR-100. وشكّلت المطابقات مع صور التدريب أو صور الاختبار الأخرى 3.25% و10% من مجموعتي الاختبار الأصليتين على التوالي. ومع إبقاء التدريب دون تغيير، ارتفع خطأ تصنيف ResNeXt-29 (8x64d) من 3.56% على CIFAR-10 إلى 3.95% على ciFAIR-10.









