Die besten Objekterkennungsmodelle
Entdecke die besten Objekterkennungsmodelle 2026 – von Ultralytics YOLO bis RT-DETR – und vergleiche Architekturen, Leistungskompromisse und Faktoren für die Bereitstellung.
 Abirami Vina11 Min. Lesezeit
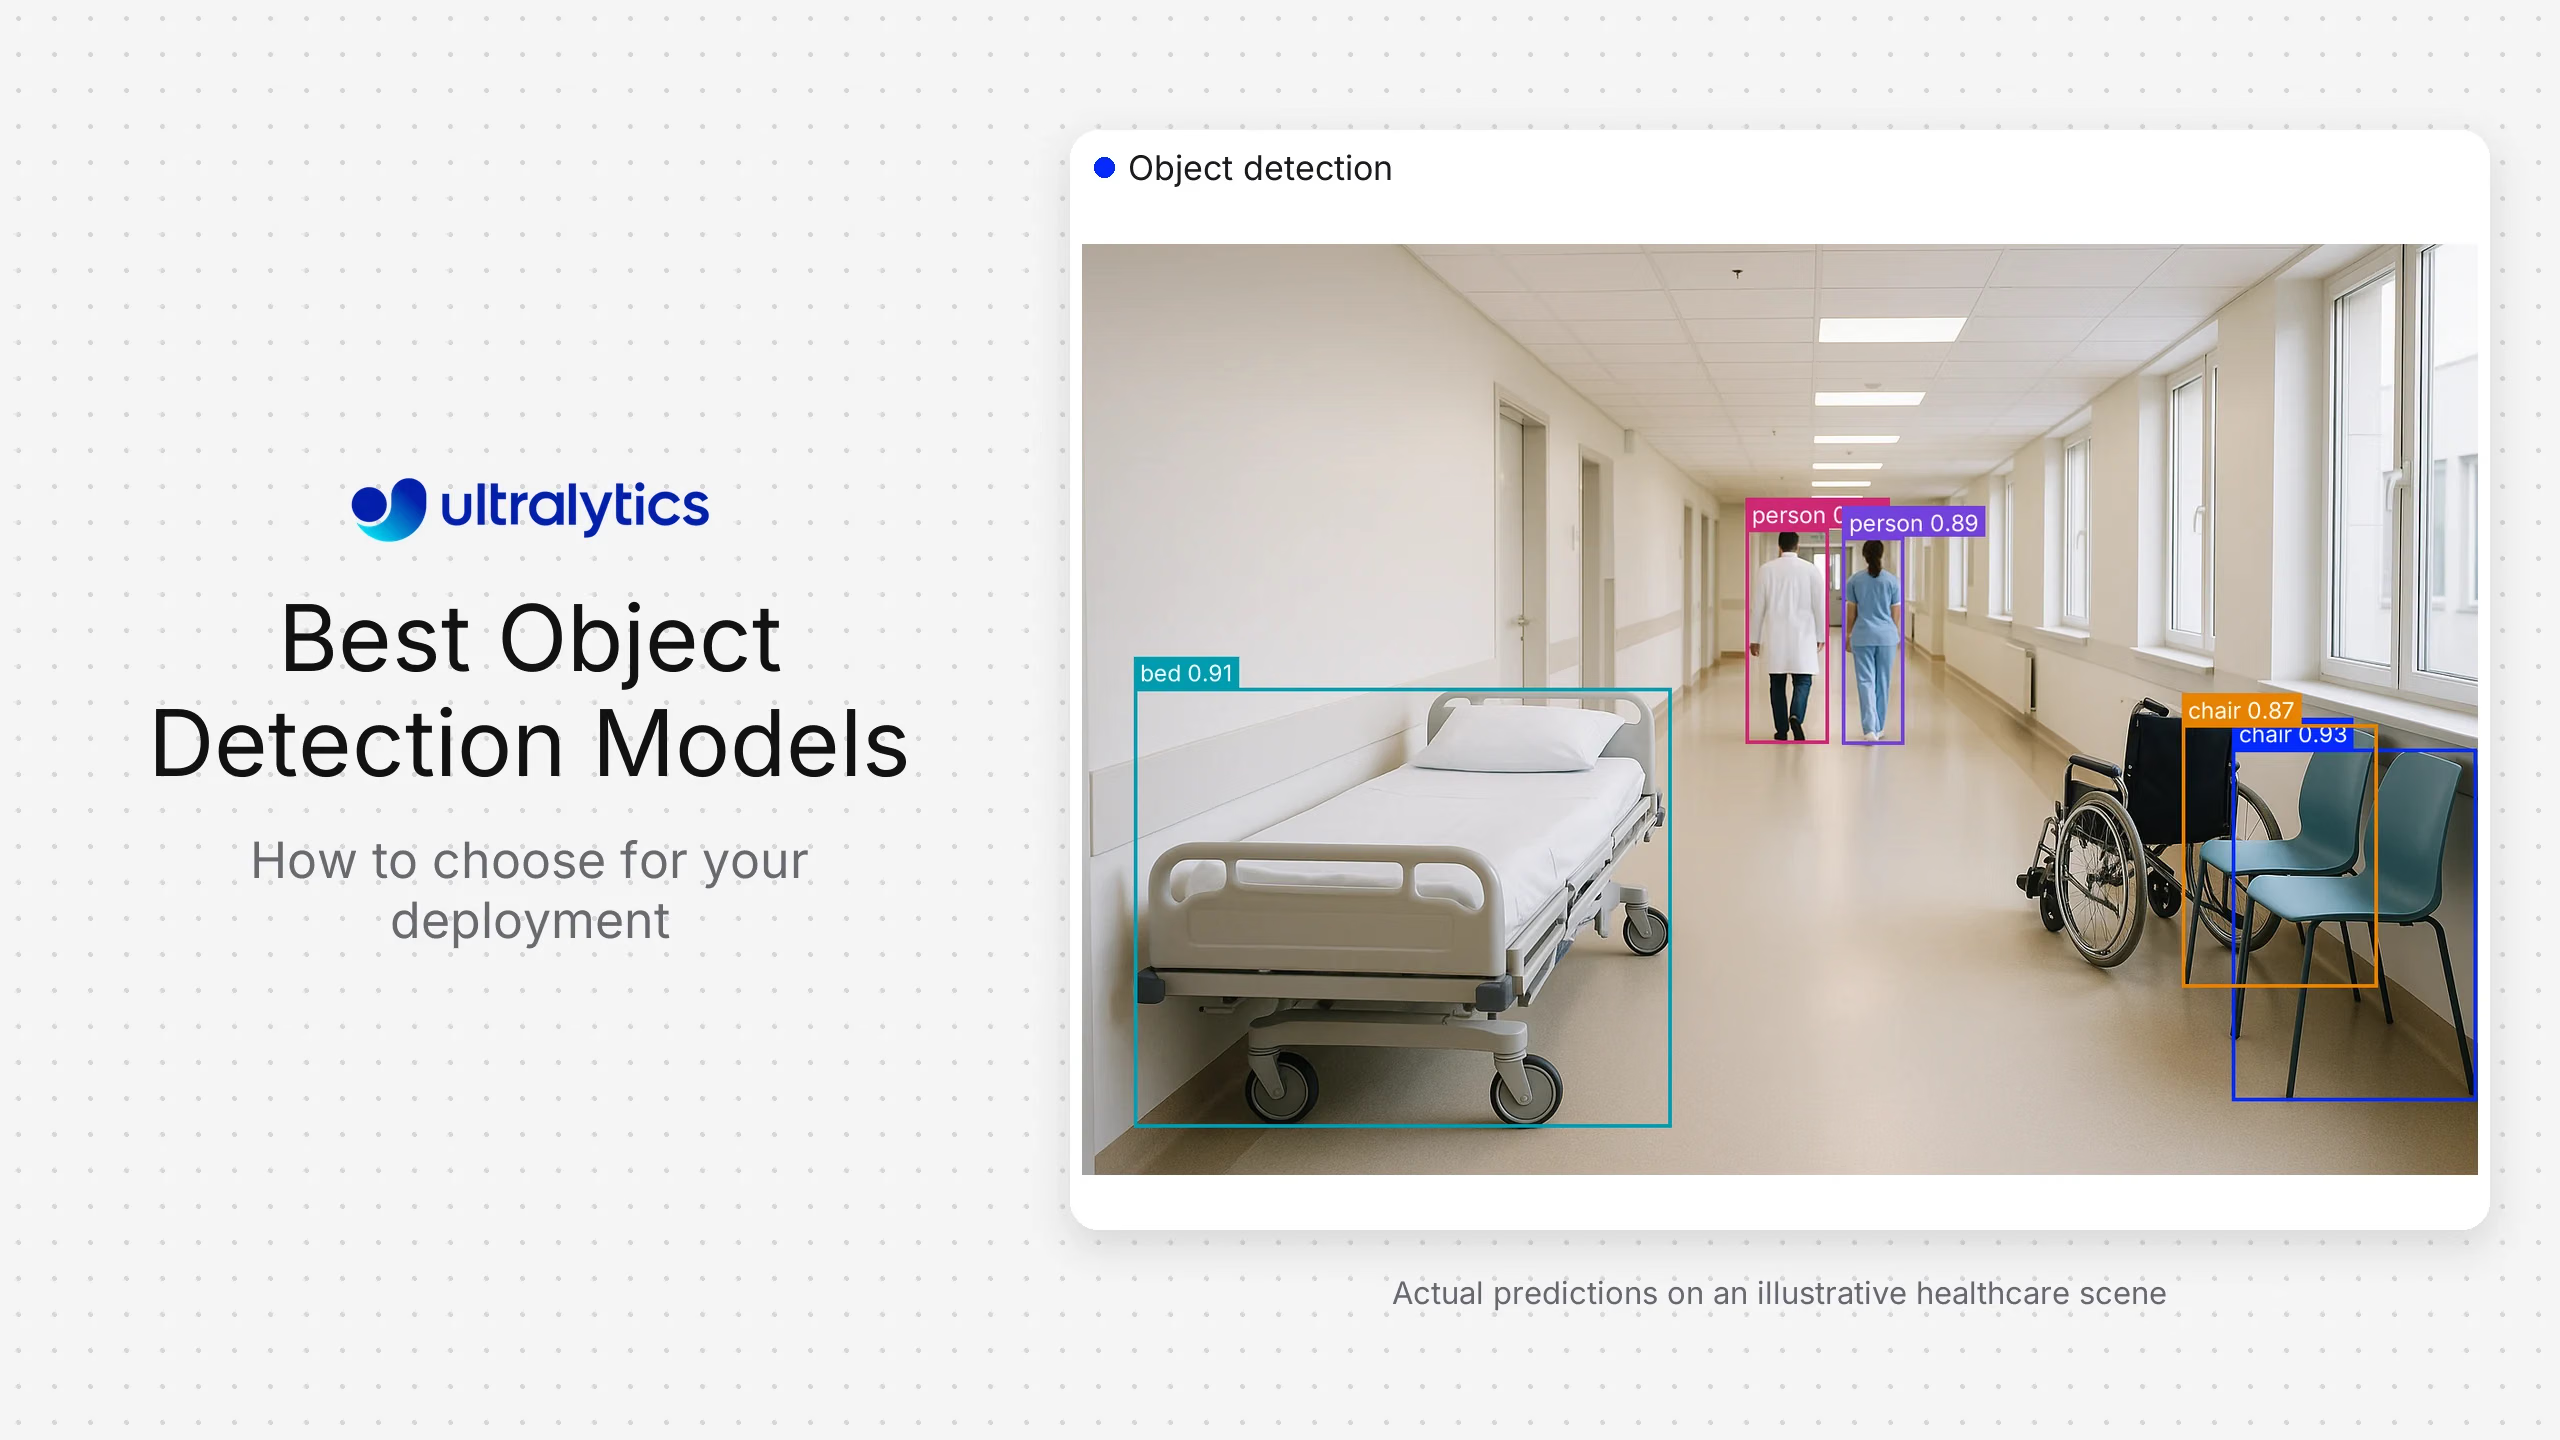
Anfang dieses Jahres stellte Andrew Ng, ein Pionier auf dem Gebiet der KI und des maschinellen Lernens, das Konzept der agentischen Objekterkennung vor. Bei diesem Ansatz erkennt ein Schlussfolgerungsagent Objekte anhand einer Textanweisung, ohne dass dafür große Mengen an Trainingsdaten erforderlich sind.
Objekte in Bildern und Videos ohne riesige annotierte Datensätze erkennen zu können, ist ein Schritt hin zu intelligenteren und flexibleren Computer-Vision-Systemen. Vision-KI mit agentischem Ansatz steckt jedoch noch in den Anfängen.
Zwar kann sie allgemeine Aufgaben bewältigen, etwa Personen oder Verkehrsschilder in einem Bild erkennen, doch präzisere Computer-Vision-Anwendungen beruhen weiterhin auf herkömmlichen Objekterkennungsmodellen. Diese Modelle werden mit großen, sorgfältig annotierten Datensätzen trainiert, damit sie genau lernen, wonach sie suchen und wo sich Objekte befinden.
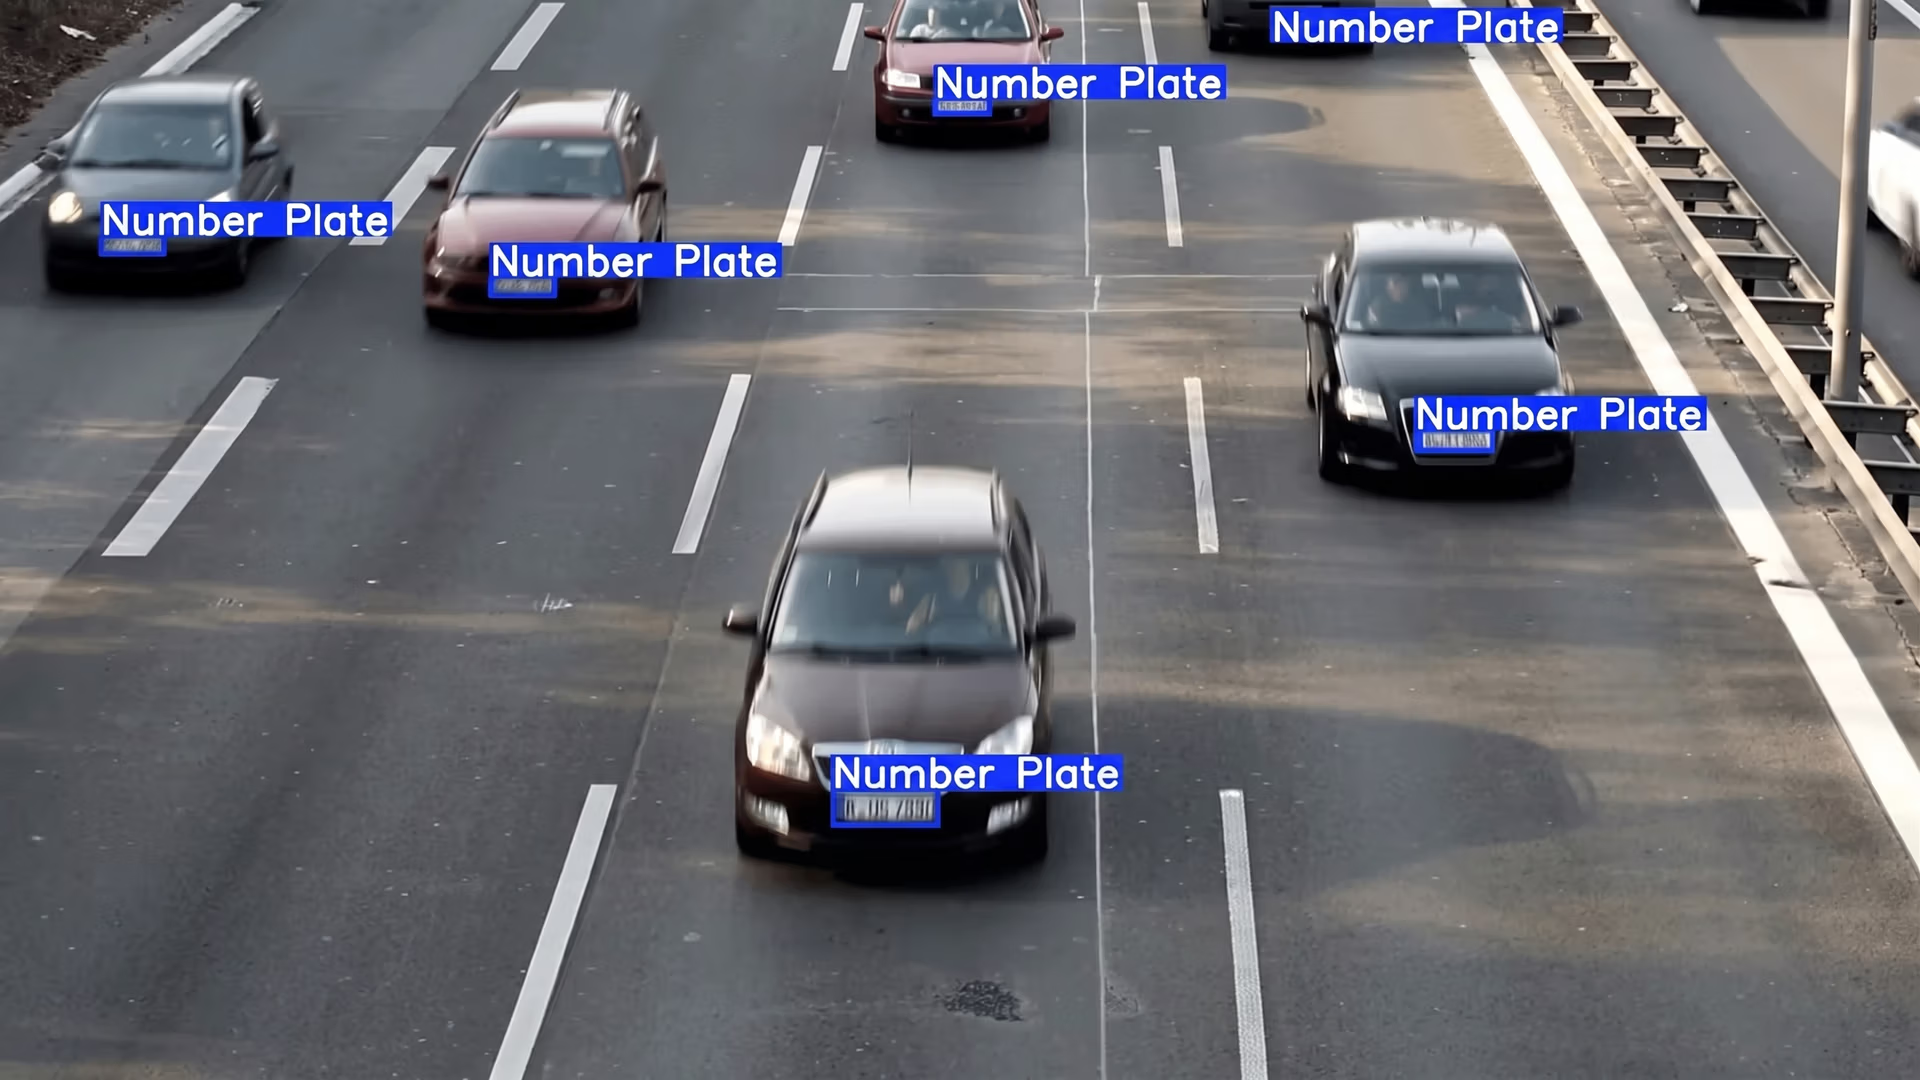
Abb. 1. Beispiel für Objekterkennung. (Quelle)
Die herkömmliche Objekterkennung ist unverzichtbar, weil sie sowohl die Erkennung ermöglicht – also feststellt, um welches Objekt es sich handelt – als auch dessen Lokalisierung, also die genaue Bestimmung seiner Position im Bild. Diese Kombination ermöglicht es Maschinen, komplexe Aufgaben in der Praxis zuverlässig zu bewältigen, vom autonomen Fahren über die industrielle Automatisierung bis hin zur medizinischen Diagnostik.
Objekterkennungsmodelle werden kontinuierlich verbessert: Sie werden schneller und genauer und eignen sich immer besser für den Einsatz in der Praxis. In diesem Artikel stellen wir einige der besten derzeit verfügbaren Objekterkennungsmodelle vor.
Warum Objekterkennung gebraucht wird#
Computer-Vision-Aufgaben wie die Bildklassifizierung können feststellen, ob ein Bild ein Auto, eine Person oder ein anderes Objekt enthält. Sie können jedoch nicht bestimmen, wo sich das Objekt im Bild befindet.
Hier kommt die Objekterkennung ins Spiel. Objekterkennungsmodelle erkennen, welche Objekte vorhanden sind, und bestimmen außerdem deren genaue Position. Dieses als Lokalisierung bekannte Verfahren ermöglicht es Maschinen, Szenen genauer zu verstehen und angemessen darauf zu reagieren – etwa ein selbstfahrendes Auto anzuhalten, einen Roboterarm zu steuern oder einen Bereich in medizinischen Bildaufnahmen hervorzuheben.
Der Aufstieg des Deep Learning hat die Objekterkennung grundlegend verändert. Statt sich auf von Hand programmierte Regeln zu stützen, lernen moderne Modelle Muster direkt aus Annotationen und visuellen Daten. Diese Datensätze bringen den Modellen bei, wie Objekte aussehen, wo sie üblicherweise vorkommen und wie sie mit Herausforderungen wie kleinen Objekten, unübersichtlichen Szenen oder wechselnden Lichtverhältnissen umgehen.
Tatsächlich können modernste Objekterkennungssysteme mehrere Objekte gleichzeitig präzise erkennen. Damit ist die Objekterkennung eine Schlüsseltechnologie für Anwendungen wie autonomes Fahren, Robotik, Gesundheitswesen und industrielle Automatisierung.
So funktionieren Aufgaben der Objekterkennung#
Als Eingabe erhält ein Objekterkennungsmodell ein Bild, das von einer Kamera, aus einem Videobild oder auch aus einer medizinischen Aufnahme stammen kann. Das Eingabebild wird von einem neuronalen Netzwerk verarbeitet, meist einem Faltungsnetzwerk (CNN), das darauf trainiert wurde, Muster in visuellen Daten zu erkennen.
Im Netzwerk wird das Bild in mehreren Schritten analysiert. Anhand der erkannten Merkmale sagt das Modell voraus, welche Objekte vorhanden sind und wo sie sich befinden.
Diese Vorhersagen werden als Begrenzungsrahmen dargestellt, also als Rechtecke um jedes erkannte Objekt. Für jeden Begrenzungsrahmen weist das Modell ein Klassenlabel zu, beispielsweise Auto, Person oder Hund, sowie einen Konfidenzwert, der angibt, wie sicher es sich bei der Vorhersage ist. Der Konfidenzwert lässt sich auch als Wahrscheinlichkeit verstehen.
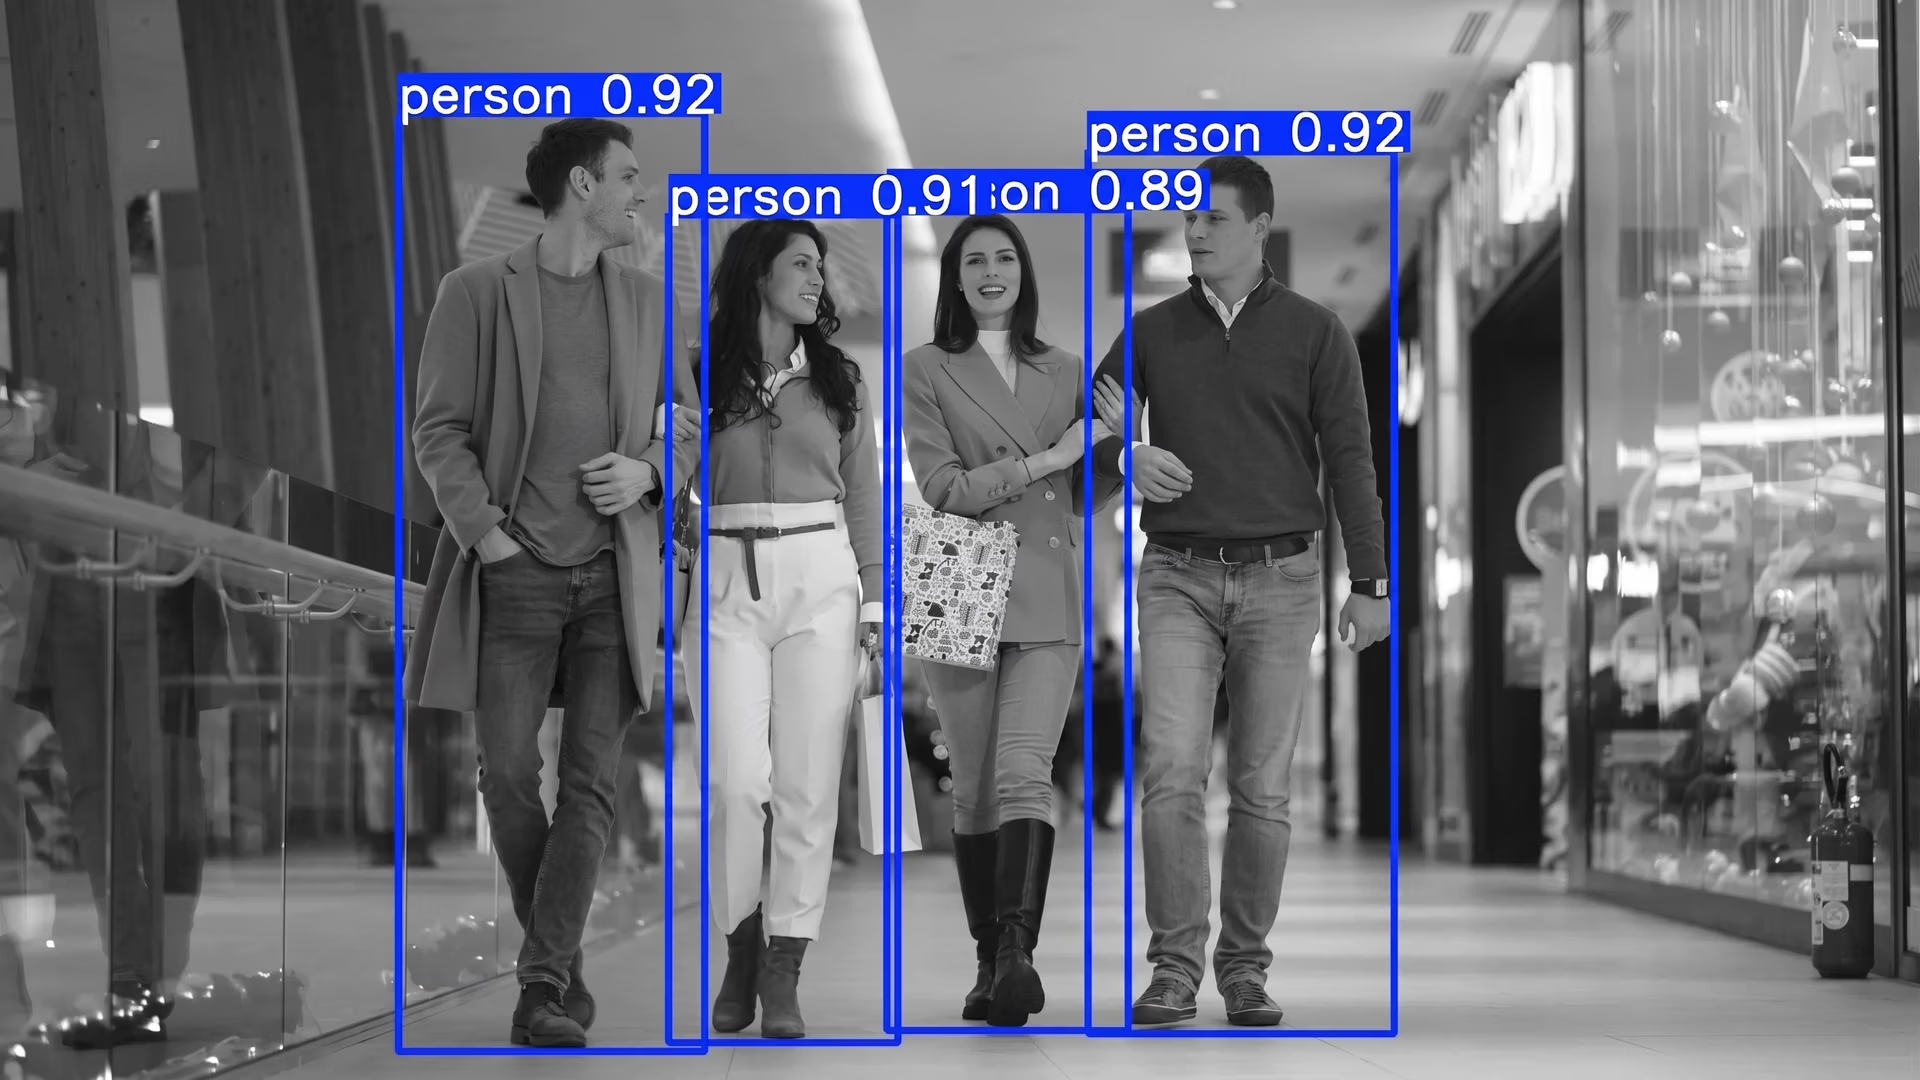
Abb. 2. Vorhersagen der Objekterkennung lassen sich mit Begrenzungsrahmen visualisieren.
Der gesamte Prozess beruht maßgeblich auf der Merkmalsextraktion. Das Modell lernt, nützliche visuelle Muster wie Kanten, Formen, Texturen und andere unterscheidende Eigenschaften zu erkennen. Diese Muster werden in Merkmalskarten codiert, die dem Netzwerk helfen, das Bild auf verschiedenen Detailebenen zu verstehen.
Objekterkennung: zweistufige und einstufige Modelle#
Je nach Modellarchitektur verwenden Objektdetektoren unterschiedliche Strategien zur Lokalisierung von Objekten und wägen dabei Geschwindigkeit, Genauigkeit und Komplexität gegeneinander ab.
Viele Objekterkennungsmodelle, insbesondere zweistufige Detektoren wie Faster R-CNN, konzentrieren sich auf bestimmte Bildbereiche, sogenannte Interessensbereiche (ROIs). Indem das Modell diese Bereiche genauer betrachtet, priorisiert es Regionen, in denen sich wahrscheinlich Objekte befinden, anstatt alle Bildpunkte gleich zu behandeln.
Einstufige Modelle wie frühe YOLO-Modelle wählen dagegen nicht wie zweistufige Modelle bestimmte ROIs aus. Stattdessen teilen sie das Bild in ein Raster auf und nutzen vorgegebene sogenannte Ankerboxen zusammen mit Merkmalskarten, um Objekte im gesamten Bild in einem einzigen Durchlauf vorherzusagen.
Viele moderne Objekterkennungsmodelle, darunter aktuelle Ultralytics YOLO-Modelle, verwenden ankerfreie Ansätze. Anders als herkömmliche einstufige Modelle, die auf vordefinierte Ankerrahmen angewiesen sind, sagen ankerfreie Modelle Positionen und Größen von Objekten direkt anhand von Merkmalskarten voraus. Das kann die Architektur vereinfachen, den Rechenaufwand verringern und die Leistung verbessern – insbesondere bei der Erkennung von Objekten unterschiedlicher Formen und Größen.
Ein Blick auf die besten Objekterkennungsmodelle#
Heute gibt es zahlreiche Objekterkennungsmodelle, die jeweils für bestimmte Ziele entwickelt wurden. Einige sind auf Echtzeitverarbeitung optimiert, andere auf die höchstmögliche Genauigkeit. Welches Modell sich für eine Computer-Vision-Lösung eignet, hängt oft vom konkreten Anwendungsfall und den Leistungsanforderungen ab.
Sehen wir uns als Nächstes einige der besten Objekterkennungsmodelle des Jahres 2026 an.
1. Ultralytics-YOLO-Modelle#
Eine der heute am weitesten verbreiteten Familien von Objekterkennungsmodellen ist die Ultralytics-YOLO-Modellfamilie. YOLO steht für „You Only Look Once“ und ist branchenübergreifend beliebt, weil es eine starke Erkennungsleistung bietet und zugleich schnell, zuverlässig und einfach zu verwenden ist.
Zur Ultralytics-YOLO-Familie gehören Ultralytics YOLOv5, Ultralytics YOLOv8, Ultralytics YOLO11 und das neueste Modell Ultralytics YOLO26. Damit stehen verschiedene Optionen für unterschiedliche Leistungsanforderungen und Anwendungsfälle zur Verfügung. Dank ihres leichtgewichtigen Designs und ihrer Geschwindigkeitsoptimierung eignen sich Ultralytics YOLO-Modelle ideal für die Erkennung in Echtzeit. Sie lassen sich auf Edge-Geräten mit begrenzter Rechenleistung und begrenztem Speicher einsetzen.
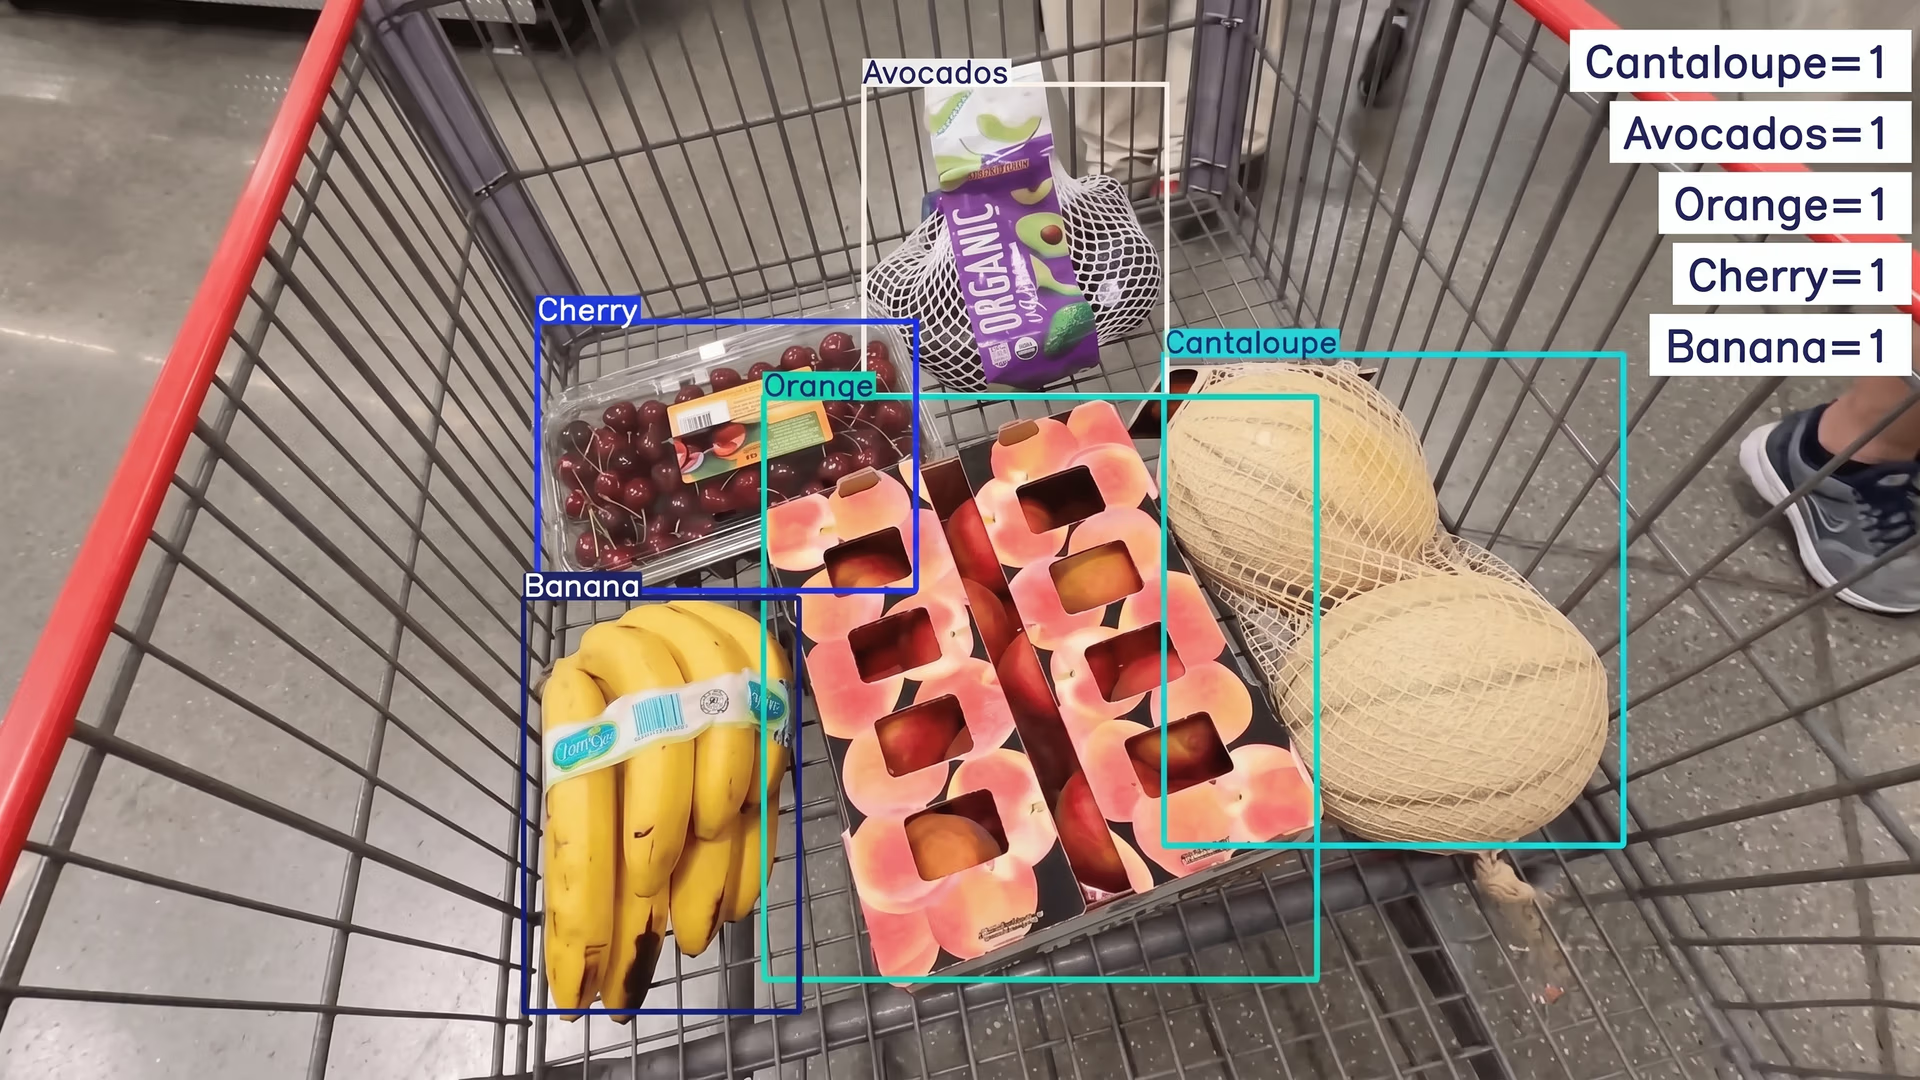
Abb. 3. Objekterkennung mit Ultralytics YOLO11 (Quelle)
Über die grundlegende Objekterkennung hinaus sind diese Modelle äußerst vielseitig. Sie unterstützen auch Aufgaben wie die Instanzsegmentierung, bei der Objekte auf Pixelebene umrissen werden, und die Posenschätzung, bei der wichtige Punkte auf Personen oder Objekten erkannt werden. Diese Flexibilität macht Ultralytics-YOLO-Modelle zu einer beliebten Wahl für vielfältige Anwendungen – von Landwirtschaft und Logistik bis hin zu Einzelhandel und Fertigung.
Ein weiterer wichtiger Grund für die Beliebtheit von Ultralytics YOLO-Modellen ist das Ultralytics-Python-Paket. Es bietet eine einfache und benutzerfreundliche Schnittstelle zum Trainieren, Feinabstimmen und Bereitstellen von Modellen. Entwickler können mit vortrainierten Gewichten beginnen, die Modelle an ihre eigenen Datensätze anpassen und sie mit wenigen Codezeilen bereitstellen.
2. RT-DETR und RT-DETRv2#
RT‑DETR (Echtzeit-Detektions-Transformer) und das neuere RT‑DETRv2 sind Objekterkennungsmodelle für den Echtzeiteinsatz. Anders als viele herkömmliche Modelle können sie ein Bild direkt verarbeiten und die endgültigen Erkennungen ausgeben, ohne Non-Maximum-Suppression (NMS) zu verwenden.
NMS ist ein Schritt, bei dem zusätzliche überlappende Boxen entfernt werden, wenn ein Modell dasselbe Objekt mehrmals vorhersagt. Wird NMS übersprungen, wird der Erkennungsprozess einfacher und schneller.
Diese Modelle kombinieren CNNs mit Transformern. Das CNN erkennt visuelle Details wie Kanten und Formen, während der Transformer eine Art neuronales Netz ist, das das gesamte Bild auf einmal betrachten und erkennen kann, wie verschiedene Bereiche miteinander zusammenhängen. Dieses umfassende Verständnis ermöglicht es dem Modell, nahe beieinanderliegende oder überlappende Objekte zu erkennen.
RT‑DETRv2 verbessert das ursprüngliche Modell durch Funktionen wie die Mehrskalen-Erkennung, mit der sowohl kleine als auch große Objekte gefunden werden können, sowie durch einen besseren Umgang mit komplexen Szenen. Diese Änderungen sorgen für höhere Genauigkeit, ohne das Modell zu verlangsamen.
3. RF-DETR#
RF‑DETR ist ein echtzeitfähiges, transformerbasiertes Modell, das die Genauigkeit von Transformer-Architekturen mit der für praktische Anwendungen erforderlichen Geschwindigkeit verbinden soll. Wie RT‑DETR und RT‑DETRv2 verwendet es einen Transformer zur Analyse des gesamten Bildes und ein CNN, um feine visuelle Merkmale wie Kanten, Formen und Texturen zu extrahieren.
Das Modell sagt Objekte direkt anhand des Eingabebildes voraus und verzichtet dabei auf Ankerboxen und Nicht-Maximum-Unterdrückung. Dadurch wird der Erkennungsprozess vereinfacht und die Inferenz bleibt schnell. RF‑DETR unterstützt außerdem die Instanzsegmentierung und kann so Objekte zusätzlich zu den vorhergesagten Begrenzungsrahmen auf Pixelebene umranden.
4. EfficientDet#
EfficientDet wurde Ende 2019 veröffentlicht und ist ein Objekterkennungsmodell, das auf effiziente Skalierung und hohe Leistung ausgelegt ist. EfficientDet zeichnet sich durch seine zusammengesetzte Skalierung aus: Dabei werden Eingabeauflösung, Netzwerktiefe und Netzwerkbreite gleichzeitig skaliert, statt nur einen Faktor anzupassen. So kann das Modell eine stabile Genauigkeit beibehalten, unabhängig davon, ob es für hohe Leistung vergrößert oder für leichtgewichtige Bereitstellungen verkleinert wird.
Ein weiterer wichtiger Bestandteil von EfficientDet ist sein effizientes Feature-Pyramid-Netzwerk (FPN), mit dem das Modell Bilder auf mehreren Skalen analysieren kann. Diese Mehrskalenanalyse ist entscheidend, um Objekte unterschiedlicher Größe zu erkennen. Dadurch kann EfficientDet kleine und große Objekte im selben Bild zuverlässig identifizieren.
5. PP-YOLOE+#
PP-YOLOE+ wurde 2022 veröffentlicht und ist ein Objekterkennungsmodell im YOLO-Stil. Das bedeutet, dass es Objekte in einem einzigen Durchlauf des Bildes erkennt und klassifiziert. Dadurch ist es schnell und für Echtzeitanwendungen geeignet, ohne Abstriche bei der Genauigkeit zu machen.
Eine der wichtigsten Verbesserungen in PP-YOLOE+ ist das aufgabenangepasste Lernen, durch das die Konfidenzwerte des Modells besser widerspiegeln, wie genau Objekte lokalisiert werden. Das ist besonders nützlich, um kleine oder überlappende Objekte zu erkennen.
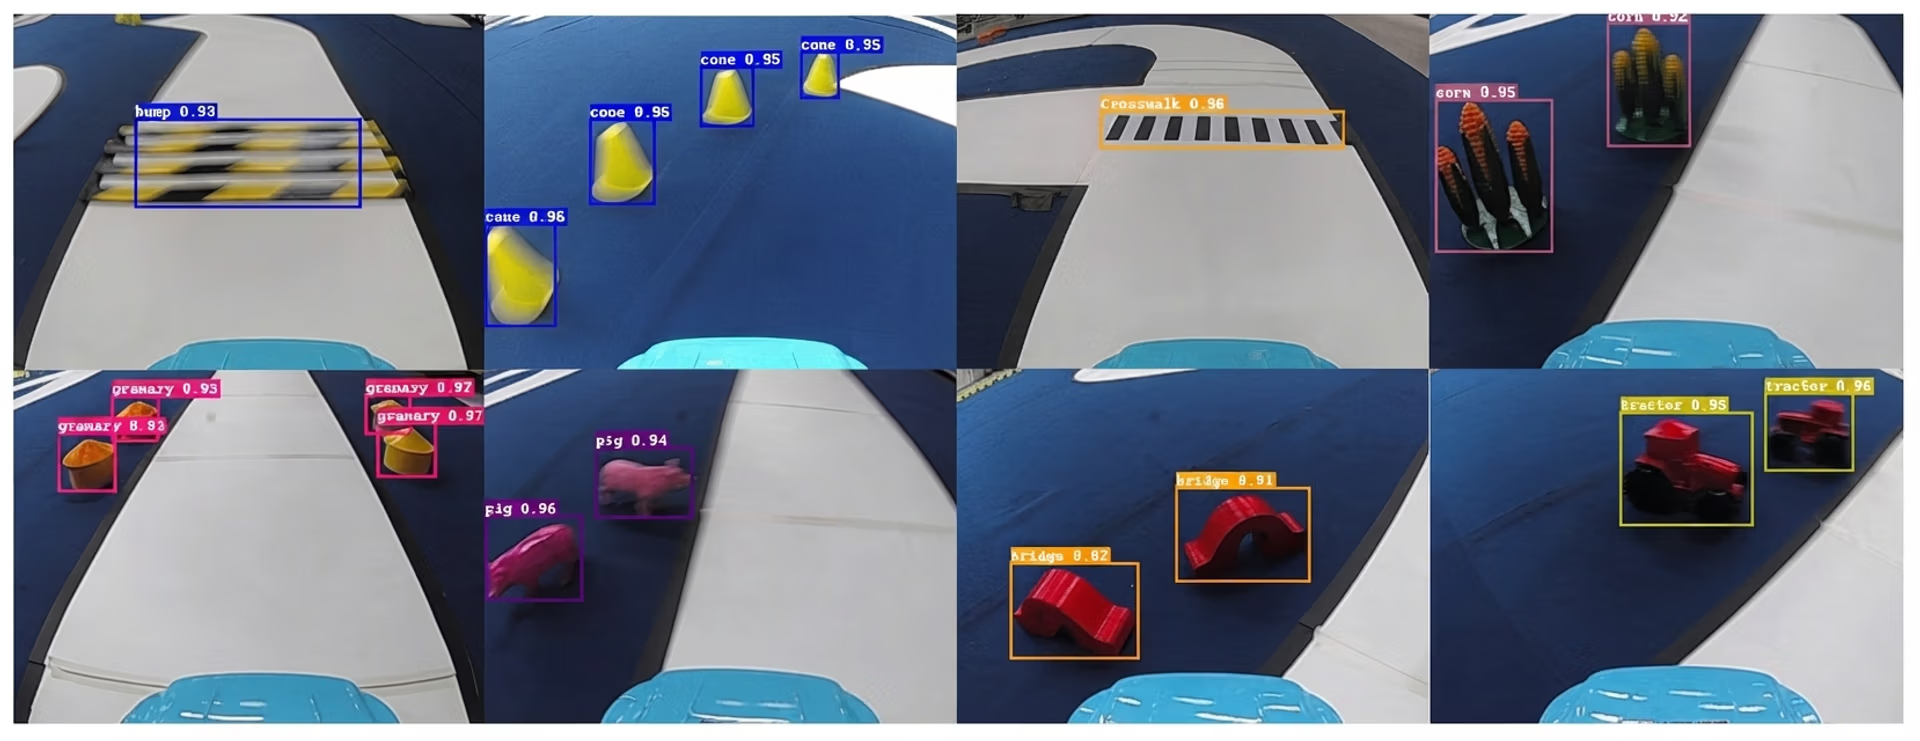
Abb. 4. Objekterkennung mit PP-YOLOE+ (Quelle)
Das Modell verwendet außerdem eine entkoppelte Kopfarchitektur, die die Aufgaben der Vorhersage von Objektpositionen und Klassenbezeichnungen voneinander trennt. So kann es Begrenzungsrahmen präziser zeichnen und Objekte zugleich korrekt klassifizieren.
6. GroundingDINO#
GroundingDINO ist ein Transformer-basiertes Objekterkennungsmodell, das Bildverarbeitung und Sprache kombiniert. Statt sich auf eine feste Kategorienauswahl zu stützen, können Nutzer damit Objekte mithilfe von natürlichsprachlichen Textvorgaben erkennen.
Indem das Modell visuelle Merkmale eines Bildes mit Textbeschreibungen abgleicht, kann es Objekte lokalisieren, auch wenn die entsprechenden Bezeichnungen nicht in den Trainingsdaten enthalten waren. Du kannst das Modell also mit Beschreibungen wie „eine Person mit Helm“ oder „ein rotes Auto neben einem Gebäude“ anleiten. Daraufhin zeichnet es Begrenzungsrahmen um passende Objekte.
Da GroundingDINO auch Zero-Shot-Erkennung unterstützt, muss das Modell für jeden neuen Anwendungsfall seltener neu trainiert oder feinabgestimmt werden. Dadurch ist es für zahlreiche Anwendungen flexibel einsetzbar. Einen Vergleich mit anderen Erkennungsmodellen mit offenem Vokabular und Vision-Language-Modellen auf praxisnahen Datensätzen findest du auf der VLM-Bestenliste.
Gängige Kennzahlen zur Bewertung von Objektdetektoren#
Beim Vergleich verschiedener Objekterkennungsmodelle fragst du dich vielleicht, woran du erkennst, welches tatsächlich am besten abschneidet. Das ist eine gute Frage, denn neben der Modellarchitektur und der Qualität deiner Daten können viele Faktoren die Leistung beeinflussen.
Forschende verwenden häufig gemeinsame Benchmarks und standardisierte Leistungskennzahlen, um Modelle einheitlich zu bewerten, Ergebnisse zu vergleichen und Zielkonflikte zwischen Geschwindigkeit und Genauigkeit zu verstehen. Standardisierte Benchmarks sind besonders wichtig, weil viele Objekterkennungsmodelle anhand derselben Datensätze, etwa des COCO-Datensatzes, bewertet werden.
Erkennungsgenauigkeit und Geschwindigkeit messen#
Hier findest du einen genaueren Überblick über einige gängige Kennzahlen zur Bewertung von Objekterkennungsmodellen:
- Intersection over Union (IoU): Diese Metrik misst, wie stark sich ein vorhergesagter Begrenzungsrahmen mit dem tatsächlichen Objekt in einem Bild überschneidet. Sie vergleicht den vom Modell gezeichneten Rahmen mit dem Referenzrahmen, der die im Datensatz gekennzeichnete Position des Objekts angibt. IoU wird berechnet, indem die Fläche der Überschneidung durch die Fläche der Vereinigung der beiden Rahmen geteilt wird. Ein höherer IoU-Wert bedeutet, dass das Modell den Rahmen genauer platziert, während ein niedrigerer IoU-Wert für eine ungenauere Vorhersage steht. Einfach gesagt zeigt IoU, wie genau die Vorhersagen des Modells mit den tatsächlichen Objektpositionen übereinstimmen.
- Mittlere durchschnittliche Präzision (mAP): Sie ist die wichtigste Kennzahl zur Bewertung der Gesamtleistung bei der Objekterkennung. Dabei berücksichtigt sie sowohl die Anzahl der vom Modell korrekt erkannten Objekte als auch die Genauigkeit dieser Erkennungen über verschiedene Konfidenzschwellen und Objektkategorien hinweg.
- Bilder pro Sekunde (FPS) und Latenz: FPS gibt an, wie viele Bilder oder Videoframes ein Modell pro Sekunde verarbeiten kann. Ein Modell mit 30 FPS kann beispielsweise 30 Frames pro Sekunde verarbeiten. Je höher die FPS-Zahl, desto schneller kann das System reagieren. Das ist wichtig für Anwendungsfälle wie Live-Video, Verkehrsüberwachung oder Robotik. Die Latenz misst dagegen, wie lange das Modell benötigt, um ein einzelnes Bild oder Frame zu verarbeiten – vom Eingang bis zur Bereitstellung des Ergebnisses.
Vor- und Nachteile von Objekterkennungsalgorithmen#
Hier sind einige der wichtigsten Vorteile von Objekterkennungsmodellen in praktischen Anwendungen:
- Branchenübergreifend einsetzbar: Objekterkennung lässt sich für vielfältige Anwendungsfälle nutzen – von Verkehrsüberwachung und Einzelhandelsanalysen bis hin zu Gesundheitswesen, Landwirtschaft und Fertigung.
- Weniger manueller Aufwand: Die Automatisierung visueller Prüf- und Überwachungsaufgaben verringert den Bedarf an ständiger menschlicher Aufsicht und hilft Teams, sich auf wichtigere Aufgaben zu konzentrieren.
- Profitieren von Open-Source-Ökosystemen: Aktive Open-Source-Communitys und Ressourcen auf GitHub erleichtern den Zugriff auf vortrainierte Modelle sowie das Experimentieren und Anpassen von Lösungen.
Trotz dieser Vorteile gibt es praktische Einschränkungen, die sich auf die Leistung von Objekterkennungsmodellen auswirken können. Folgende wichtige Faktoren solltest du berücksichtigen:
- Hohe Anforderungen an die Datenqualität: Objekterkennungsmodelle benötigen große, sorgfältig annotierte Datensätze für das Training. Diese Daten zu erstellen und zu pflegen kann zeitaufwendig, kostspielig und schwer skalierbar sein.
- Hoher Rechenaufwand: Modelle mit höherer Erkennungsgenauigkeit benötigen oft erhebliche Rechenleistung – sowohl beim Training als auch bei der Echtzeitbereitstellung. Dafür kommen üblicherweise leistungsstarke GPUs zum Einsatz, was die Infrastrukturkosten erhöhen kann.
- Empfindlichkeit gegenüber realen Bedingungen: Unterschiede bei Beleuchtung, Kamerawinkeln und Wetter sowie überfüllte Szenen können die Erkennungsleistung beeinträchtigen. Deshalb sind fortlaufende Tests und Anpassungen erforderlich.
Die wichtigsten Erkenntnisse#
Welches Objekterkennungsmodell sich am besten für dein Computer-Vision-Projekt eignet, hängt von deinem Anwendungsfall, deiner Datenkonfiguration, deinen Leistungsanforderungen und den Einschränkungen deiner Hardware ab. Manche Modelle sind auf Geschwindigkeit optimiert, andere auf Genauigkeit, und die meisten praktischen Anwendungen benötigen eine ausgewogene Kombination aus beidem. Dank Open-Source-Frameworks und aktiver Communitys auf GitHub lassen sich diese Modelle immer einfacher bewerten, anpassen und für den praktischen Einsatz bereitstellen.
Weitere Informationen findest du in unserem GitHub-Repository. Werde Teil unserer Community und sieh dir unsere Lösungsseiten an, um mehr über Anwendungen wie KI im Gesundheitswesen und Computer Vision in der Automobilindustrie zu erfahren. Entdecke unsere Lizenzoptionen, um heute mit Vision-KI loszulegen.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









