RTM ist ein in Seoul ansässiges Unternehmen für industrielle KI. Dessen Vision-Einheit entwickelt KI-gestützte Sicherheitsüberwachung für Fertigungsstätten: Kameras, die bereits in der Werkhalle montiert sind, werden rund um die Uhr von Ultralytics YOLO26-Modellen überwacht, die Personen, Stürze, Eindringlinge in Gefahrenzonen sowie Feuer oder Rauch erkennen und auf jedem PC laufen, den der Kunde bereits besitzt, von integrierten Grafikkarten bis hin zu einer dedizierten GPU.
Kameras überwachen, die niemand beobachtet#
Industrieunfälle passieren tendenziell in der Lücke, die niemand abdeckt. Fabriken haben bereits an jeder Linie Kameras, aber niemand kann jeden Feed jederzeit beobachten. RTM hat ein System entwickelt, das dies kontinuierlich tut: Jeder Kamerakanal betreibt zwei Ultralytics YOLO26-Modelle, eines trainiert für Personenerkennung und eines für Feuer und Rauch, die eine deterministische Ereignisschicht speisen, welche Alarme für Stürze von Arbeitern und das Eindringen in Gefahrenzonen auslöst.
In den letzten sechs Monaten wurde die industrielle Sicherheits-KI-Lösung von RTM rund um die Uhr eingesetzt oder befindet sich bei 21 Fertigungsunternehmen aus den Bereichen Stahl, Batterien, Chemie und Kunststoffe, Lebensmittel und Robotikfertigung in der Evaluierung vor Ort. An bestehende Überwachungskameras angeschlossen, erkennt das System, wenn ein Arbeiter eine Gefahrenzone betritt oder stürzt, und löst Warnungen über interne Systeme oder, über eine Speicherprogrammierbare Steuerung-Integration, direkt über angeschlossene Fabrikgeräte aus.
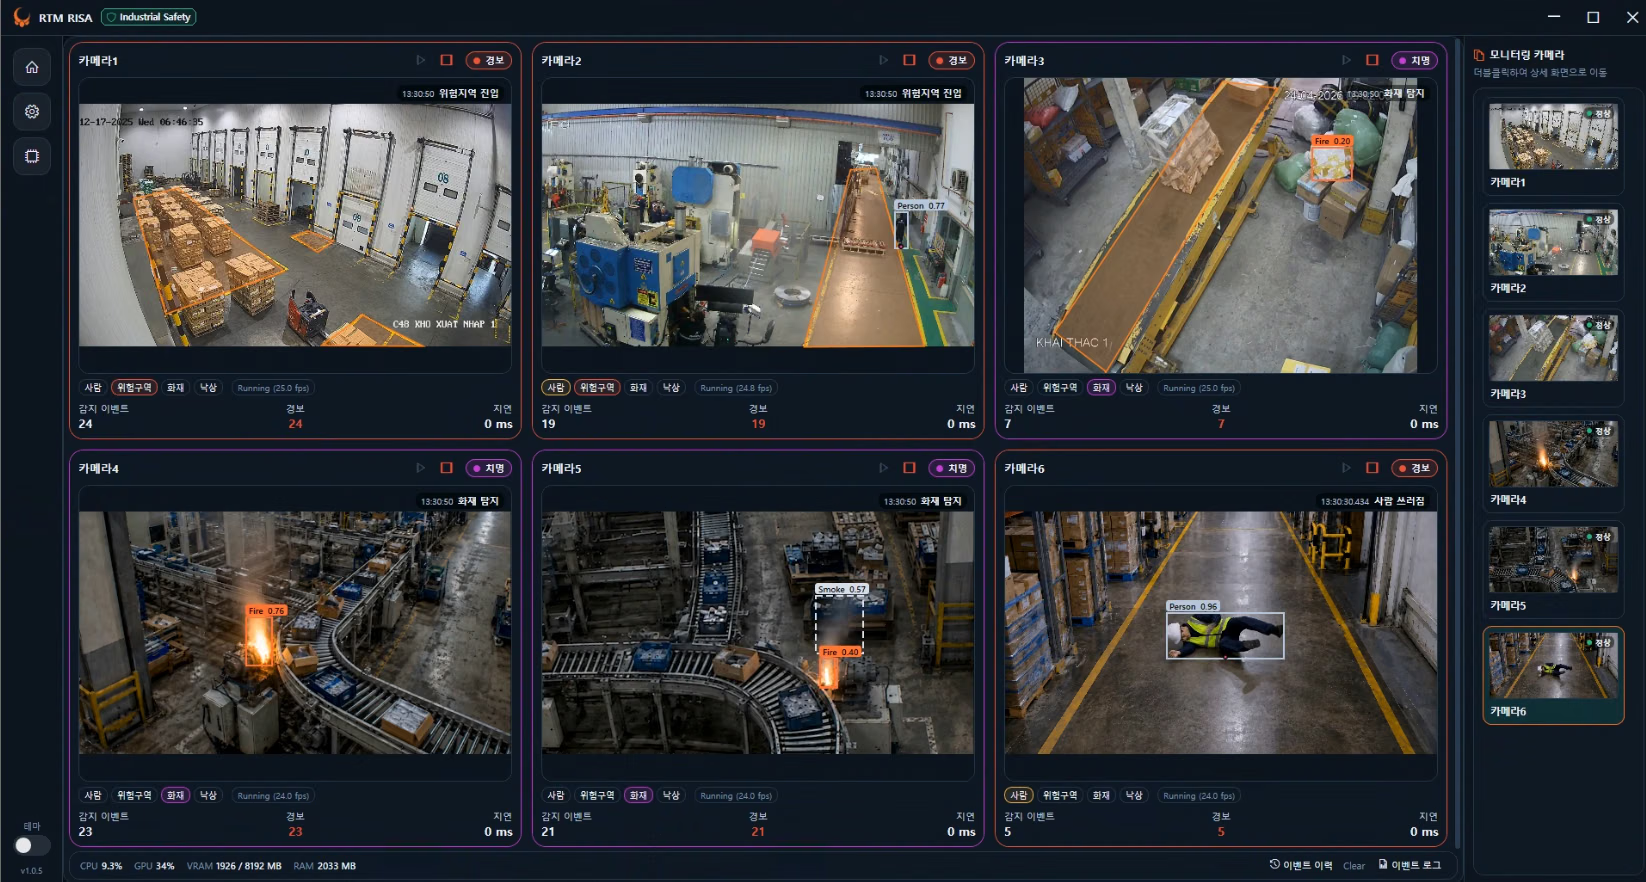 Abb. 1. RTM-Live-Feed zur Sturzerkennung mit Ultralytics YOLO. (Bildquelle: RTM)
Lösungen für Hardware, die niemand kaufen möchte#
Sicherheitsüberwachung konkurriert mit der Option, gar nichts zu installieren. Wenn ein System neue Server-Hardware erfordert, bevor es eine einzige Kamera überwachen kann, stoppt die Evaluierung oft, bevor sie beginnt. Der Status quo für Hersteller war bisher die Wahl zwischen teurer dedizierter Hardware und gar keiner automatisierten Überwachung.
RTM hat sich zum Ziel gesetzt, diesen Kompromiss aufzuheben: eine einzige Bereitstellung, die auf jedem PC läuft, der sich bereits im Kontrollraum befindet, von integrierten Intel-Grafikkarten bis hin zu einer NVIDIA RTX 3090, ganz ohne separates Build pro Standort.
Um dorthin zu gelangen, exportiert RTM beide YOLO26-Modelle in einem festen Format nach ONNX und lässt sie über ONNX Runtime auf fünf Ausführungsprovidern laufen: TensorRT, CUDA, OpenVINO, DirectML und CPU. Beim Start erkennt die Inferenzbibliothek den installierten GPU-Anbieter und wählt automatisch die richtige Anbieterkette aus, sodass dieselbe 36-MB-Datei pro Modell unverändert läuft, unabhängig davon, ob die Zielmaschine gar keine dedizierte GPU oder eine High-End-Karte besitzt. In der bereitgestellten Anwendung gibt es keine Python- oder PyTorch-Abhängigkeit und keinen pro Anbieter zu pflegenden Release-Pfad.
Der End-to-End-Erkennungskopf von YOLO26 machte diesen Ansatz mit einem einzigen Artefakt praktikabel: Da das Modell endgültige Erkennungen direkt ausgibt, benötigt die C++-Inferenzschicht von RTM nur einen Konfidenzschwellenwert und eine Letterbox-Inversdrehung, ohne dass Non-Maximum Suppression neu implementiert werden muss und ohne Paritätslücke zwischen dem Python-Trainingspfad und dem C++-Bereitstellungspfad, die typischerweise immer dann auftritt, wenn ein Detektor Sprachgrenzen überschreitet.
Was eine GPU bringt, gemessen#
RTM hat beide YOLO26-Small-Modelle (Person sowie Feuer und Rauch) bei zwei Eingabeauflösungen auf einer NVIDIA RTX 3090 gebenchmärkt (ONNX Runtime 1.26.0, CUDA-Ausführungsprovider, FP32, Batch 1, nur Forward-Pass). Bei 640×640 läuft das Personenmodell mit 4,20 ms pro Frame und das Feuer-/Rauch-Modell mit 4,34 ms; bei 1280×1280 steigen beide auf etwa 12,5 ms, wobei der GPU-Speicher von 406 MB auf 1.302 MB anwächst. Das macht 640×640 pro Frame etwa 2,9-mal günstiger und 32-mal speicherschonender, während die größere Eingabe die Erkennung kleiner, entfernter Objekte verbessert. RTM liefert 640×640 als Standard aus und hält den 1280×1280-Export für Standorte bereit, die über GPU-Reserven verfügen, um sie für Erkennungstoleranz statt für Kanalanzahl zu nutzen.
Der Wechsel von CUDA mit FP32 zu TensorRT mit FP16 senkte die kombinierten Kosten pro Frame für beide Modelle von 8,68 ms auf 6,26 ms, was einer Reduzierung um 28 % entspricht und etwa 39,9 FPS über vier Kanäle auf einer einzigen GPU anstelle von 28,8 FPS ergibt. RTM hat vor der Auslieferung verifiziert, dass die FP16-Konvertierung keine Einbußen bei der Genauigkeit kostete: Die Rückgaberate blieb über jeden Objektgrößenbereich und auf Ereignisebene für Feuer und Rauch unverändert. In der bereitgestellten Anwendung unterstützt eine Maschine mit empfohlener Spezifikation (ein Intel Core i7 der 16-Core-Klasse oder besser, 32 GB RAM, RTX 5060 8 GB oder höher) 6 gleichzeitige Kanäle, während eine Low-Tier-Maschine mit nur integrierter Grafik immer noch 1 Kanal unterstützt, bei einer Obergrenze des Produkts von 10 Kanälen pro Box.
Warum Ultralytics YOLO26 nutzen?#
RTM trainiert seinen Personendetektor und seinen Feuer-/Rauch-Detektor über dieselbe Ultralytics-Trainingscodebasis, und die beiden teilen sich 352 Zeilen Code ohne jegliche domainspezifische Verzweigung. Das Einzige, was sich zwischen einem Detektor, der nach Personen Ausschau hält, und einem, der nach Feuer sucht, ändert, ist eine Konfigurationsdatei: Eingabegröße, Epochen, Lernrate und Dataset-Zusammensetzung. Das ist ein direktes Produkt davon, wie Ultralytics YOLO aufgebaut ist. Eine einzige, konsistente Architektur und Trainings-API über Erkennungsaufgaben hinweg bedeutet, dass eine neue Erkennungsdomäne eine Konfigurationsänderung und keine neue Pipeline ist, was es einem kleinen Ingenieurteam ermöglichte, zwei produktionstaugliche Modelle bereitzustellen, ohne zwei Codebasen pflegen zu müssen.
Dieselbe Konsistenz machte den Schritt zu YOLO26 selbst risikoarm. RTM übernahm YOLO26 vier Tage nach Projektbeginn im Mai 2026, und die Migration erforderte null Zeilen geänderten bestehenden Trainingscodes, sondern lediglich einen anderen Checkpoint. Da Ultralytics die Trainingsschnittstelle über Modellgenerationen hinweg stabil hält, bedeutete das Upgrade auf die neueste Architektur nicht, dass eine Pipeline neu geschrieben werden musste, die RTM bereits gebaut und getestet hatte.
"Selbst im selben Dataset verändern Eingabegröße und Datenaugmentierung, wie gut das Modell abschneidet. Bei Ultralytics liegt all das in einer einzigen Konfigurationsdatei, sodass wir ein paar Werte ändern, mehrere Varianten nebeneinander ausführen und die beste davon nehmen. Wir berühren dafür zu keinem Zeitpunkt Code, sodass das Aufreihen von zehn Durchläufen ungefähr so viel Arbeit ist wie das Ausführen eines einzigen." - KI-Ingenieur bei RTM
Diese Stabilität machte sich auch bei der Genauigkeit bezahlt. Die Konsolidierung eines sequenziellen Trainingslehrplans aus fünf Phasen in einen einzigen gemeinsamen Lauf verbesserte den Validierungs-mAP50 von 0,672 auf 0,689 bei unverändertem Betriebsschwellenwert – ein Gewinn, den RTM allein durch das erneute Training mit derselben YOLO26-Architektur verbuchen konnte, ohne das Modell neu zu entwerfen. Und da sich YOLO26 sauber in ein ONNX-Artefakt mit fester Form exportieren lässt, bei dem Erkennungsschwellenwerte als Begleitdatei ausgeliefert statt in die Anwendung kompiliert werden, absorbierte das Feld diesen Genauigkeitsgewinn durch den Austausch einer einzigen ONNX-Datei, ganz ohne Änderungen an der Host-Anwendung. Genau das ermöglicht es einem kleinen Ingenieurteam, Modellupdates ohne koordinierten Release an jeden Standort auszuspielen, und es ist die direkte Konsequenz davon, auf YOLO26 statt auf eine maßgeschneiderte Architektur zu bauen.
Was über der Erkennung liegt#
Die Alarme von RTM sind keine rohen Erkennungen: Eine Person im Bild ist noch kein Ereignis, aber eine Person, die gestürzt ist und am Boden bleibt, ist es. Über den beiden YOLO26-Modellen befindet sich eine deterministische Ereignisschicht, die Tracking, Haltungsstatus, Zonenzugehörigkeit und eine Gleitfenster-Abstimmung kombiniert, bevor ein Alarm ausgelöst wird. Die Trennung dieser Logik vom Modell sorgt dafür, dass ein einziges Personen-Erkennungsmodell jeden Standort bedienen kann, obwohl Kamerahöhe, Winkel und Beleuchtung von Fabrik zu Fabrik stark variieren. Das bedeutet auch, dass neue Sicherheitsverhaltensweisen bestehende Erkennungen wiederverwenden können: RTM baut derzeit eine Überwachung der Einhaltung persönlicher Schutzausrüstung auf derselben Personenerkennungsausgabe auf, ohne dass ein neues Modell oder neue Hardware an GPU-ausgestatteten Standorten erforderlich ist.
Die Gesamtauswirkung#
Die Auswirkungen zeigen sich am deutlichsten bei den Kunden von RTM für die Integration kollaborativer Roboter, die Cobots in Fabriken liefern und installieren und lange Zeit mit Arbeitern zu kämpfen hatten, die trotz physischer Schutzzäune oder Laserschutzzäunen mit Robotern kollidierten. Mit dem System von RTM wird das Eindringen in Gefahrenzonen erkannt und löst sofort einen über eine Speicherprogrammierbare Steuerung verbundenen Stopp am Roboter ohne Verzögerung aus, und diese Integratoren haben das System seitdem als Standard-Sicherheitsvorrichtung anstelle von physischen Zäunen übernommen.
Ein Kunde aus der Stahlindustrie berichtete, dass die Fähigkeit von Ultralytics YOLO, Erkennungsszenarien auf verschiedene Standorte anzupassen, es ihm ermöglichte, mehr als 100 Mitarbeiter für die Sicherheitsüberwachung einzusparen, die zuvor die Werkhalle patrouillierten. Allgemeiner ausgedrückt beschreiben Hersteller die Lösung von RTM als die am einfachsten zu installierende und kosteneffektivste unter den evaluierten Optionen zur Sicherheitsüberwachung, wobei die Erkennung von Gefahrenzonen, Stürzen sowie Feuer und Rauch genau das abdeckt, was sie am dringendsten benötigen.
Weiteres Skalieren mit denselben Modellen#
Der nächste Schritt von RTM ist die Erkennung der Einhaltung persönlicher Schutzausrüstung, die vollständig auf der bestehenden Personenerkennungsausgabe aufbaut. Es muss kein neues Modell trainiert werden, und an Standorten mit GPU-Kapazitäten muss keine neue Hardware installiert werden. Während der Rollout an weiteren Fertigungsstandorten und Hardware-Stufen fortgesetzt wird, bewältigt derselbe einzelne ONNX-Export pro Modell weiterhin die Last – vom leistungsschwächsten PC mit integrierter Grafik bis hin zum High-End-GPU-Server in der Halle.
Möchten Sie Ihre eigenen Vision-KI-Lösungen entwickeln? Erkunden Sie unsere Ultralytics YOLO-Modelle, erfahren Sie, wie sie branchenübergreifend eingesetzt werden, einschließlich Computer Vision in der Fertigung, und informieren Sie sich über Lizenzierungsoptionen, um zu beginnen.








