Guía sobre la arquitectura U-Net y sus aplicaciones
Descubre la arquitectura U-Net, cómo permite la segmentación de imágenes, cuáles son sus aplicaciones y por qué es importante en la evolución de la visión artificial.
La visión artificial es una rama de la inteligencia artificial (IA) centrada en el análisis de datos visuales. Ha allanado el camino para muchos sistemas de vanguardia, como la automatización de la inspección de productos en fábricas y la ayuda a los vehículos autónomos para circular por carretera.
Una de las tareas de visión artificial más conocidas es la detección de objetos. Esta tarea permite a los modelos localizar e identificar objetos en una imagen mediante cuadros delimitadores. Aunque los cuadros delimitadores son útiles para diversas aplicaciones, solo ofrecen una estimación aproximada de la ubicación de un objeto.
Sin embargo, en ámbitos como la sanidad, donde la precisión es crucial, las aplicaciones de la IA visual requieren algo más que identificar un objeto. A menudo también necesitan información sobre la forma exacta y la posición de los objetos.
Eso es precisamente lo que hace la segmentación, una tarea de visión artificial. En lugar de utilizar cuadros delimitadores, los modelos de segmentación detectan los objetos a nivel de píxel. A lo largo de los años, los investigadores han desarrollado modelos de visión artificial especializados en segmentación.
Uno de esos modelos es U-Net. Aunque modelos más recientes y avanzados han superado su rendimiento, U-Net ocupa un lugar destacado en la historia de la visión artificial. En este artículo, analizaremos con más detalle la arquitectura U-Net, cómo funciona, dónde se ha utilizado y cómo se compara con los modelos de segmentación más modernos disponibles actualmente.
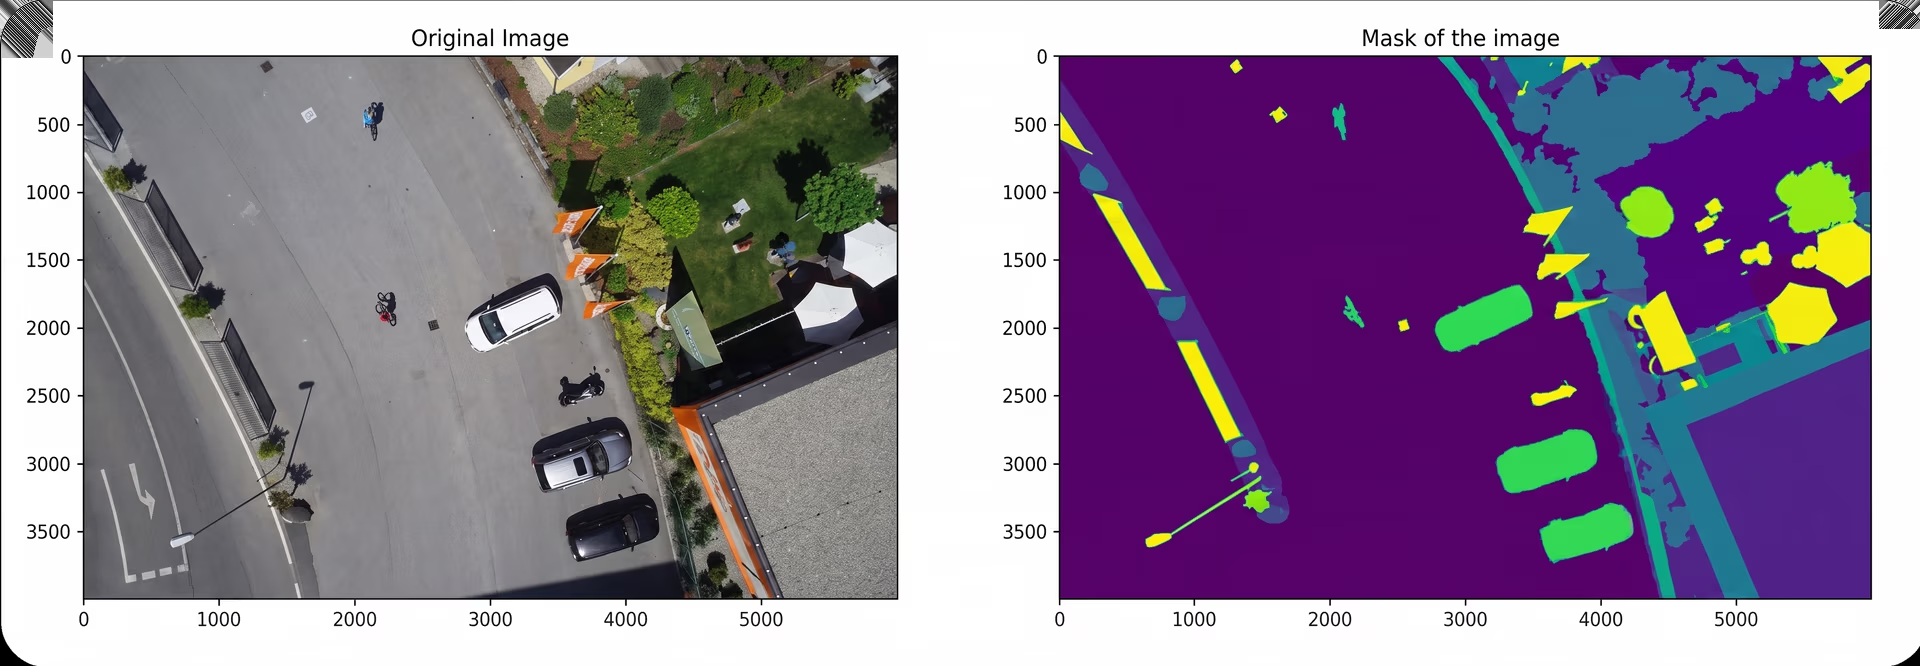
Fig. 1. Ejemplo de segmentación con el modelo de aprendizaje profundo U-Net. (Fuente)
Historia de la segmentación de imágenes#
Antes de profundizar en qué es U-Net, veamos cómo han evolucionado los modelos de segmentación de imágenes.
Al principio, la visión artificial se basaba en técnicas tradicionales como la detección de bordes, la umbralización o el crecimiento de regiones para separar objetos en una imagen. Estas técnicas se utilizaban para detectar los límites de los objetos mediante bordes, separar regiones según la intensidad de los píxeles y agrupar píxeles similares. Funcionaban en casos sencillos, pero a menudo fallaban cuando las imágenes tenían ruido, formas superpuestas o límites poco definidos.
Tras el auge del aprendizaje profundo en 2012, en 2014 los investigadores introdujeron el concepto de redes totalmente convolucionales (FCNs) para tareas como la segmentación semántica. Estos modelos sustituyeron ciertas partes de una red convolucional para que el ordenador pudiera analizar una imagen completa de una vez, en lugar de dividirla en fragmentos más pequeños. Esto permitió al modelo crear mapas detallados que muestran con mayor claridad el contenido de una imagen.
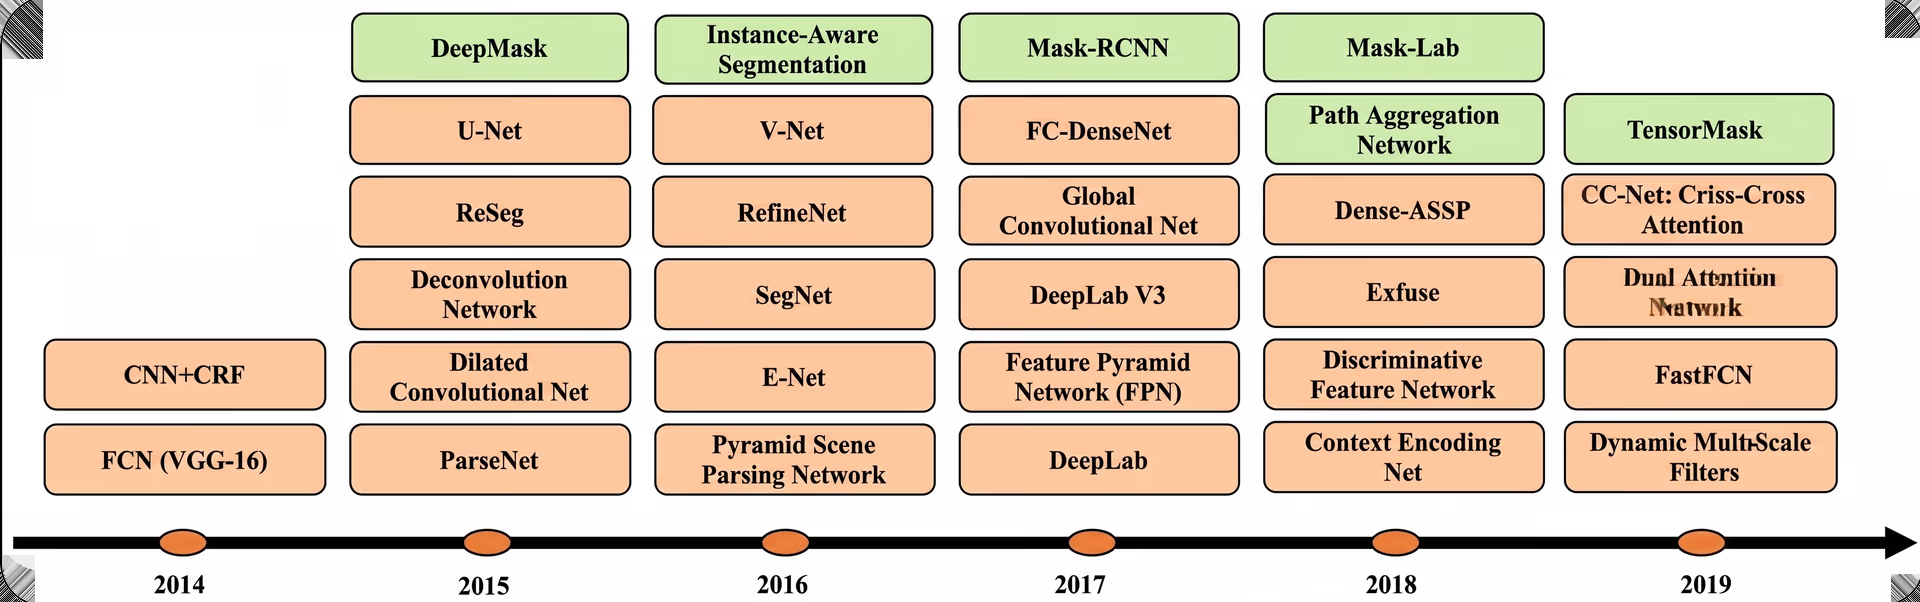
Fig. 2. Evolución de los algoritmos de segmentación basados en aprendizaje profundo. (Fuente)
A partir de las FCNs, investigadores de la Universidad de Friburgo presentaron U-Net en 2015. Se diseñó originalmente para la segmentación de imágenes biomédicas. En concreto, U-Net se concibió para funcionar bien en situaciones con pocos datos anotados.
Mientras tanto, versiones posteriores como UNet++ y TransUNet incorporaron mejoras como capas de atención y una extracción de características más eficaz. Las capas de atención ayudan al modelo a centrarse en regiones clave, mientras que la extracción de características mejorada capta información más detallada.
¿Qué es U-Net y cómo fluyen las características por el modelo?#
U-Net es un modelo de aprendizaje profundo creado específicamente para la segmentación de imágenes. Recibe una imagen como entrada y genera una máscara de segmentación que clasifica cada píxel según el objeto o la región a la que pertenece.
El modelo debe su nombre a su arquitectura en forma de U. Consta de dos partes principales: un codificador que comprime la imagen y aprende sus características, y un decodificador que la amplía hasta recuperar el tamaño original. Este diseño crea una U simétrica que ayuda al modelo a comprender tanto la estructura general de una imagen como sus detalles más precisos.
Una característica esencial de U-Net es el uso de conexiones de salto, que permiten enviar información directamente desde el codificador al decodificador. Así, el modelo puede conservar detalles importantes que podrían perderse al comprimir la imagen.
Descripción general de la arquitectura U-Net#
Así funciona la arquitectura U-Net:
- Imagen de entrada: U-Net parte de una imagen 2D, como una exploración médica o una fotografía por satélite. El objetivo es asignar una etiqueta de clase a cada píxel de la imagen.
- Submuestreo: La imagen pasa por capas convolucionales que aprenden características visuales importantes. A medida que avanza por las distintas capas, su resolución disminuye y el modelo identifica patrones más generales.
- Capa cuello de botella: En el centro de la red, los mapas de características alcanzan su resolución espacial más baja y, al mismo tiempo, capturan características semánticas de alto nivel. En pocas palabras, esta representación comprimida de los mapas de características recoge el contexto global de la entrada.
- Sobremuestreo: A continuación, la red reconstruye la imagen aumentando gradualmente la resolución. Las convoluciones transpuestas ayudan a ampliar los mapas de características hasta aproximarse al tamaño original.
- Conexiones de salto: Los mapas de características de la ruta de submuestreo se concatenan con los de la ruta de sobremuestreo. Esto ayuda a preservar los detalles espaciales más precisos e integrar al mismo tiempo información contextual de alto nivel.
- La salida es un mapa de segmentación: La salida final es una máscara de segmentación a nivel de píxel que coincide con el tamaño de la entrada. Cada píxel se clasifica en una categoría, como objeto, fondo o región de interés.
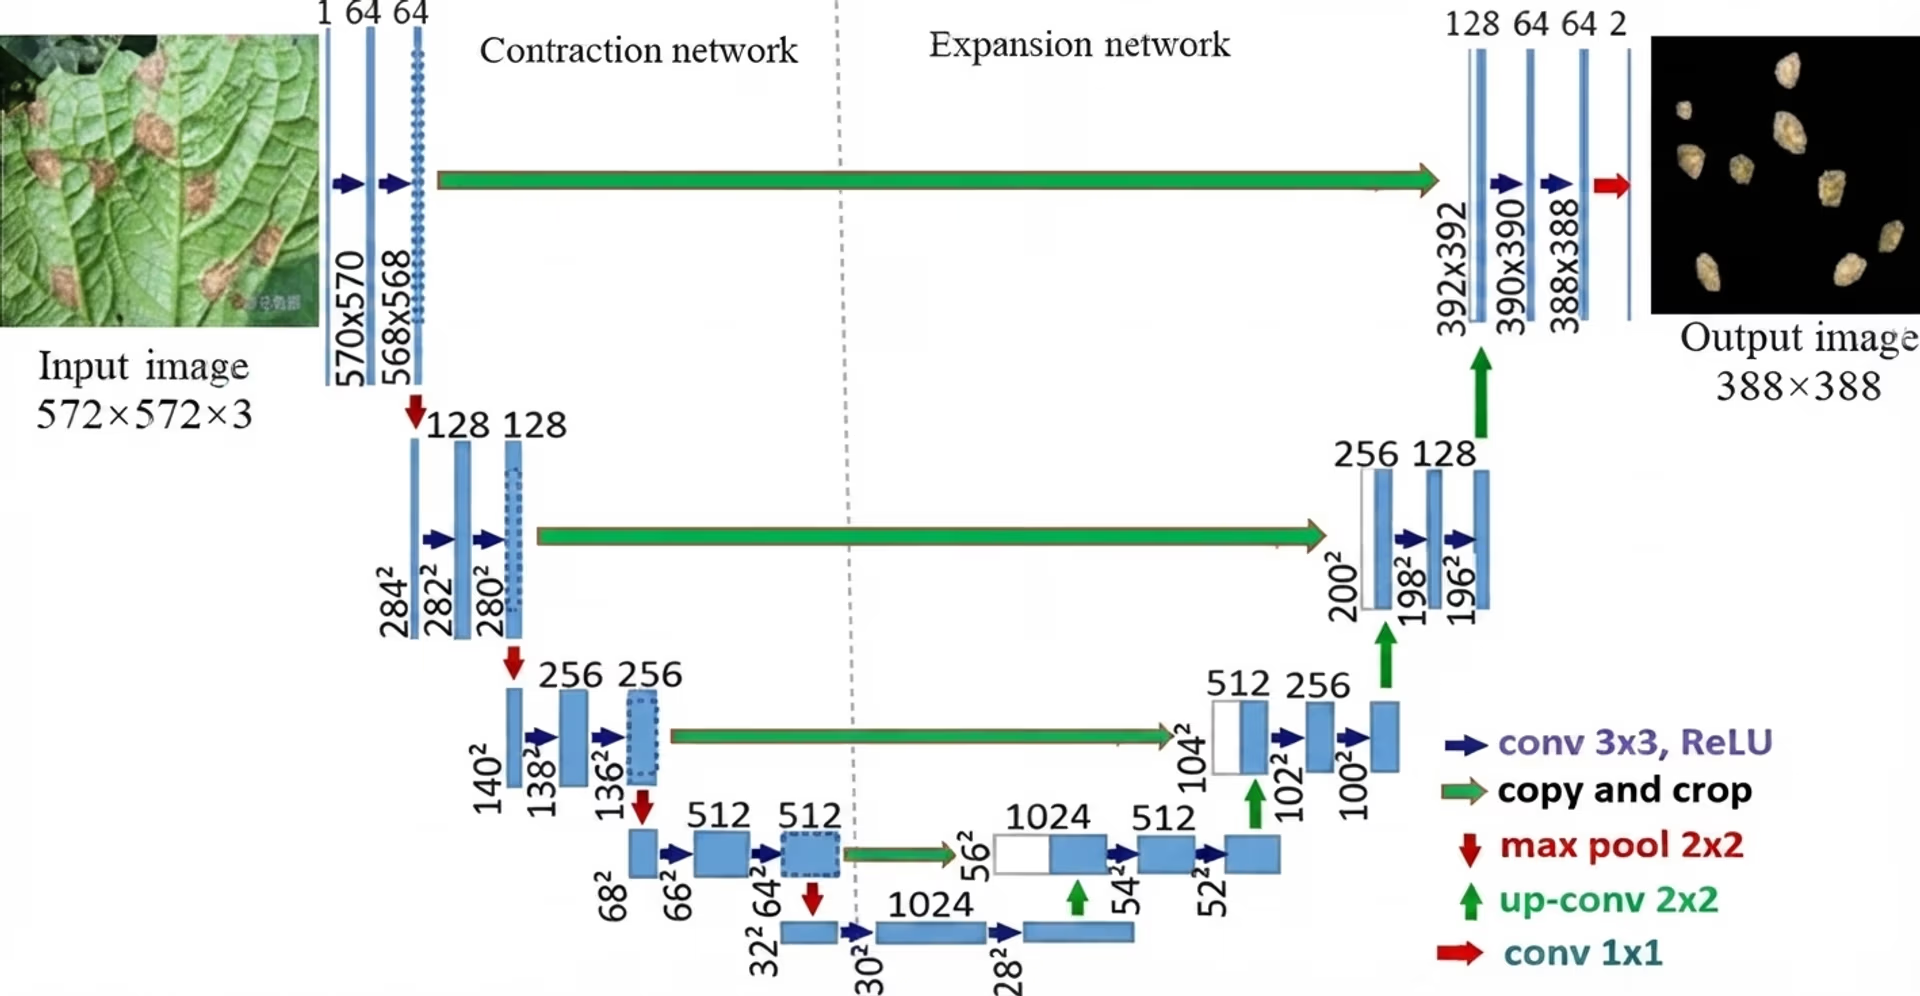
Fig. 3. Diagrama de la arquitectura U-Net. (Fuente)
Diferencias entre ViT y U-Net#
Al explorar U-Net, quizá te preguntes en qué se diferencia de otros modelos de aprendizaje profundo, como el Vision Transformer (ViT), que también puede realizar tareas de segmentación. Aunque ambos modelos pueden llevar a cabo tareas similares, difieren en su diseño y en la forma de abordar la segmentación.
U-Net procesa las imágenes a nivel de píxel mediante capas convolucionales organizadas en una estructura de codificador y decodificador. Se utiliza a menudo en tareas que requieren una segmentación precisa, como el análisis de exploraciones médicas o de escenas de conducción autónoma.
Por otro lado, el Vision Transformer (ViT) divide las imágenes en fragmentos y los procesa simultáneamente mediante mecanismos de atención. Utiliza la autoatención (un mecanismo que permite al modelo ponderar la importancia relativa de distintas partes de la imagen) para captar las relaciones entre las diferentes partes de la imagen, a diferencia del enfoque convolucional de U-Net.
Otra diferencia importante es que ViT suele necesitar más datos para funcionar bien, pero es muy eficaz para detectar patrones complejos. U-Net, en cambio, funciona bien con conjuntos de datos más pequeños, se entrena más rápido y suele requerir menos tiempo de entrenamiento.
Aplicaciones del modelo U-Net#
Ahora que conocemos mejor qué es U-Net y cómo funciona, veamos cómo se ha aplicado en distintos ámbitos.
Segmentación de hemorragias cerebrales en imágenes médicas#
U-Net se convirtió en un método fiable para segmentar a nivel de píxel imágenes médicas complejas, especialmente durante su etapa de mayor relevancia en la investigación. Los investigadores lo utilizaron para destacar zonas clave en exploraciones médicas, como tumores y signos de hemorragia interna en imágenes de TC y RM. Este enfoque mejoró notablemente la precisión de los diagnósticos y agilizó el análisis de datos médicos complejos en entornos de investigación.
Un ejemplo del impacto de U-Net en la investigación sanitaria es su uso para identificar ictus y hemorragias cerebrales en exploraciones médicas. Los investigadores podían utilizar U-Net para analizar exploraciones de la cabeza y destacar las zonas preocupantes, lo que permitía identificar más rápidamente los casos que requerían atención inmediata.
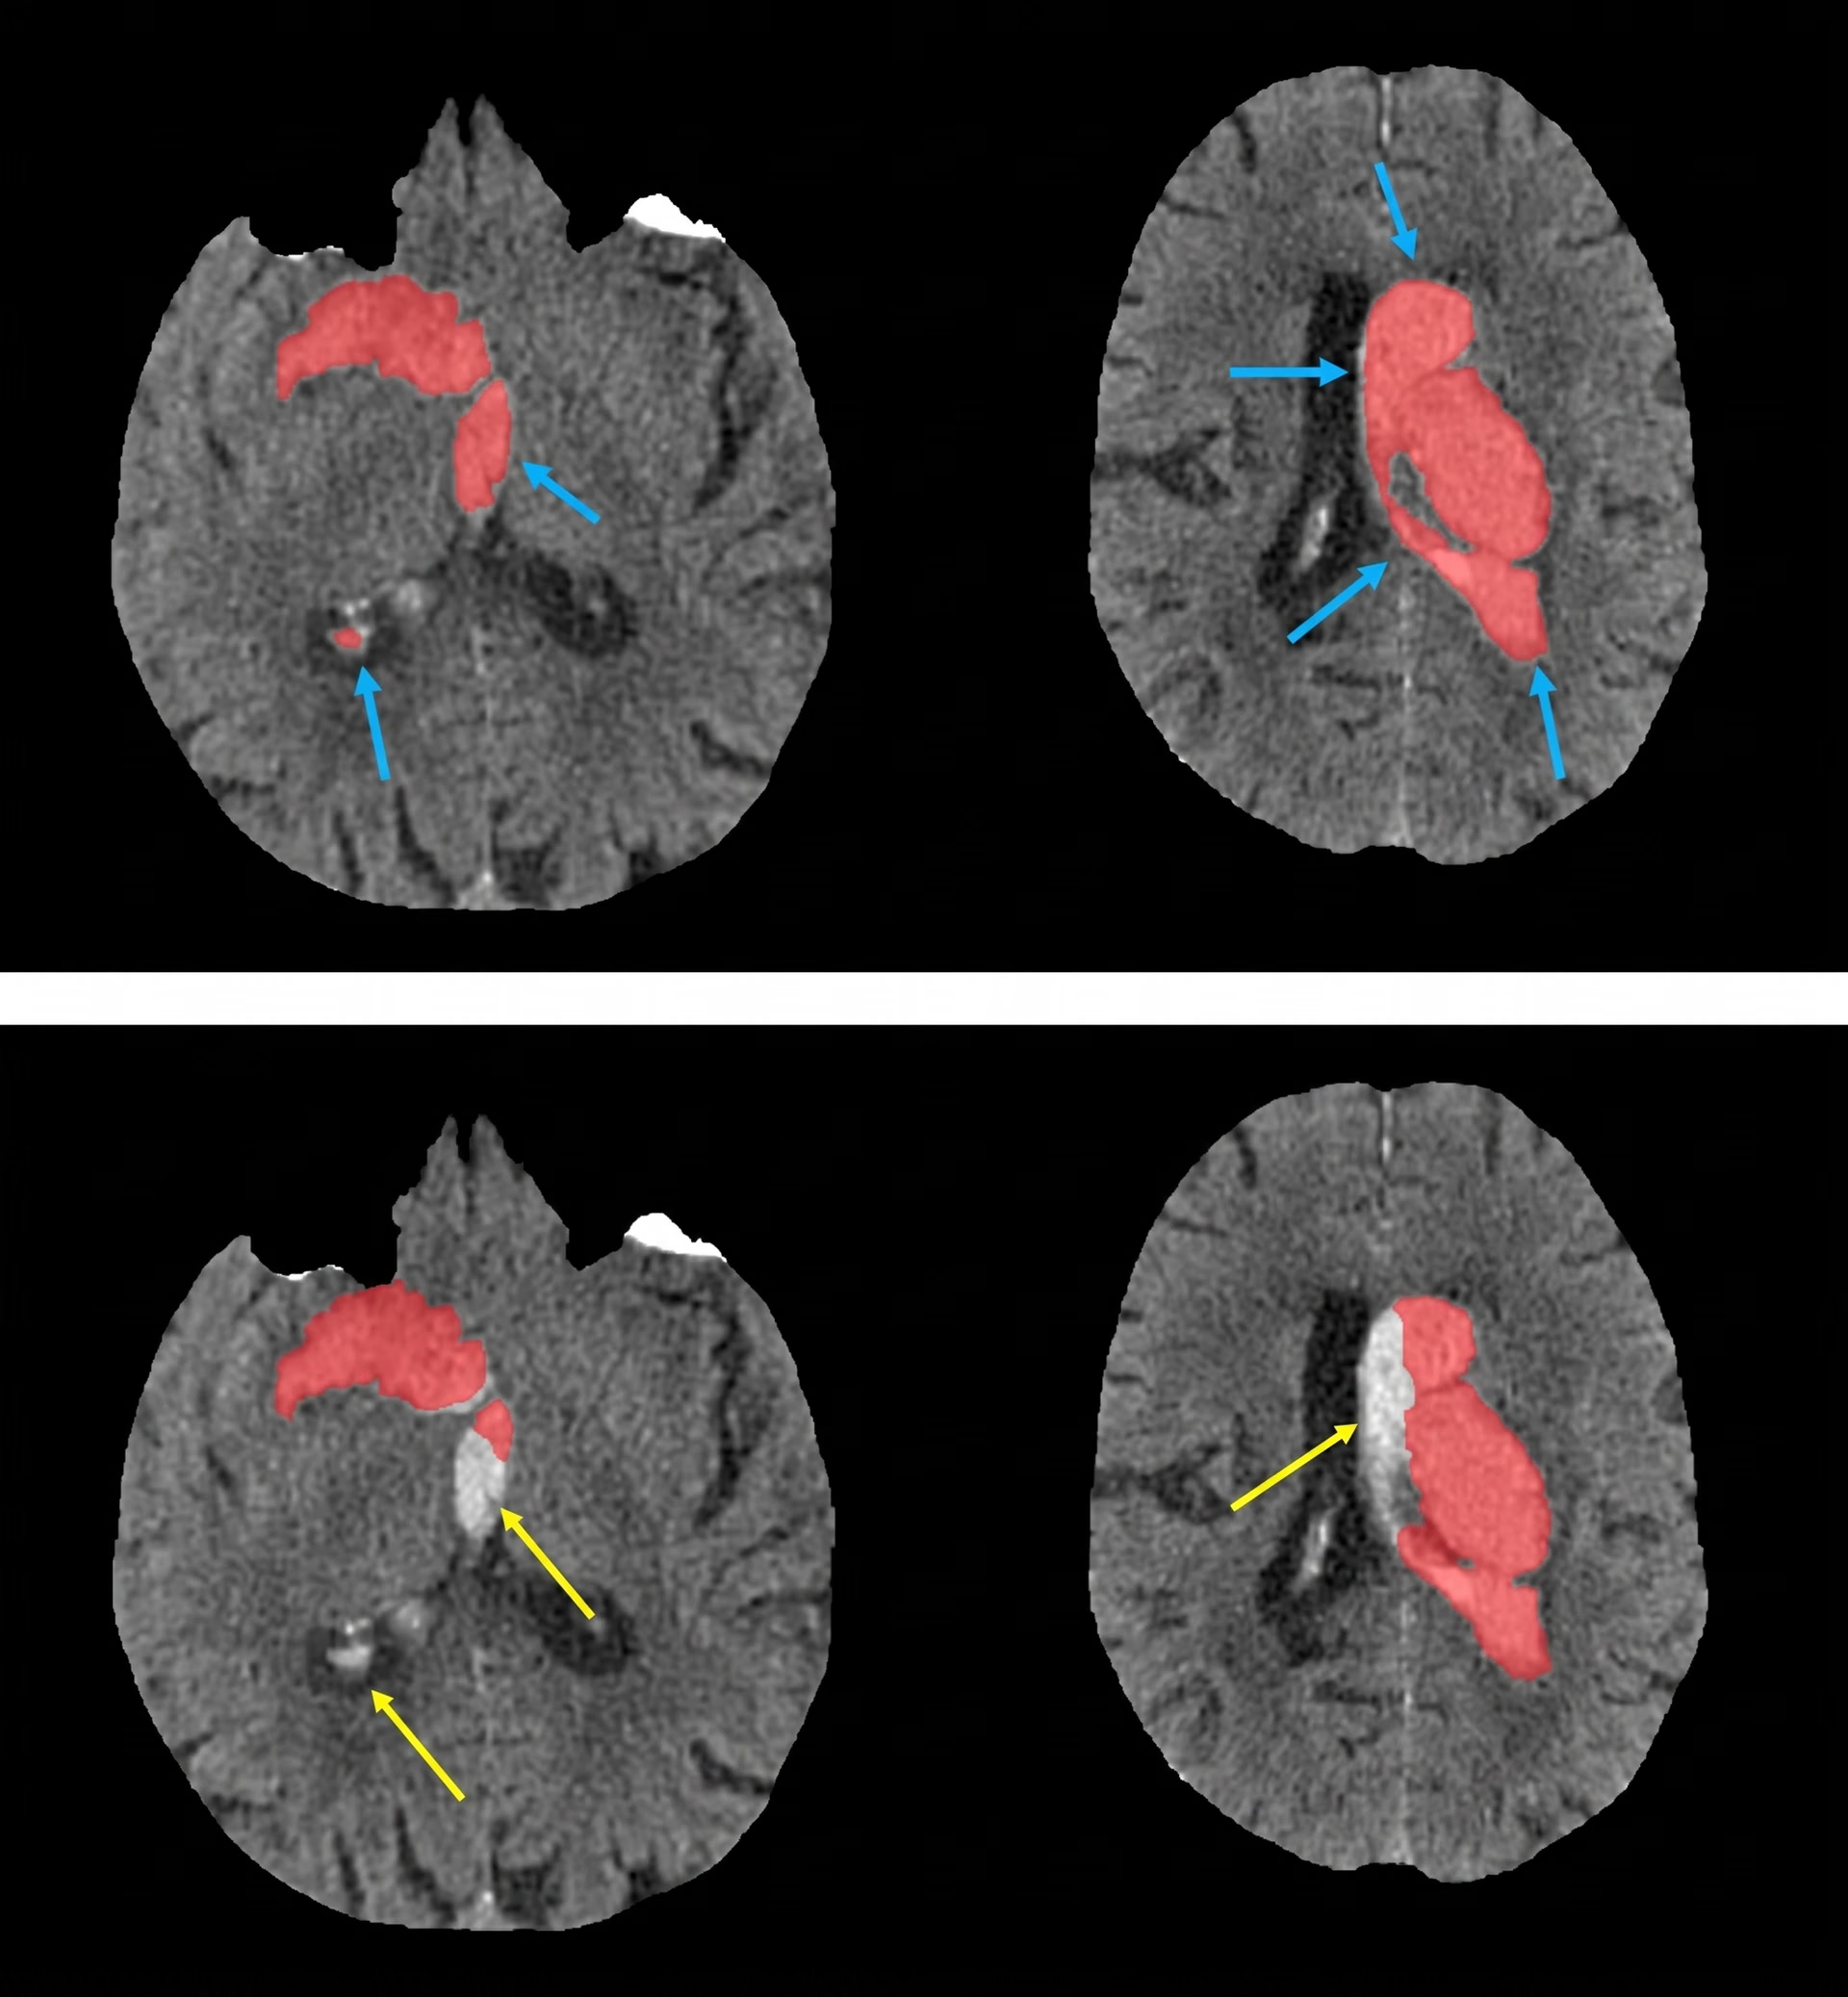
Fig. 4. Segmentación de lesiones por ictus hemorrágico con 3D U-Net. (Fuente)
Segmentación de cultivos en agricultura#
Otro ámbito en el que los investigadores han utilizado U-Net es la agricultura, especialmente para segmentar cultivos, malas hierbas y suelo. Ayuda a los agricultores a supervisar la salud de las plantas, estimar los rendimientos y tomar mejores decisiones en grandes explotaciones. Por ejemplo, U-Net puede separar los cultivos de las malas hierbas, lo que hace más eficiente la aplicación de herbicidas y reduce el desperdicio.
Para abordar problemas como el desenfoque por movimiento en imágenes de drones, los investigadores han mejorado U-Net con técnicas de eliminación del desenfoque de imágenes. Esto permite obtener una segmentación más nítida incluso cuando los datos se recopilan en movimiento, por ejemplo, durante estudios aéreos.
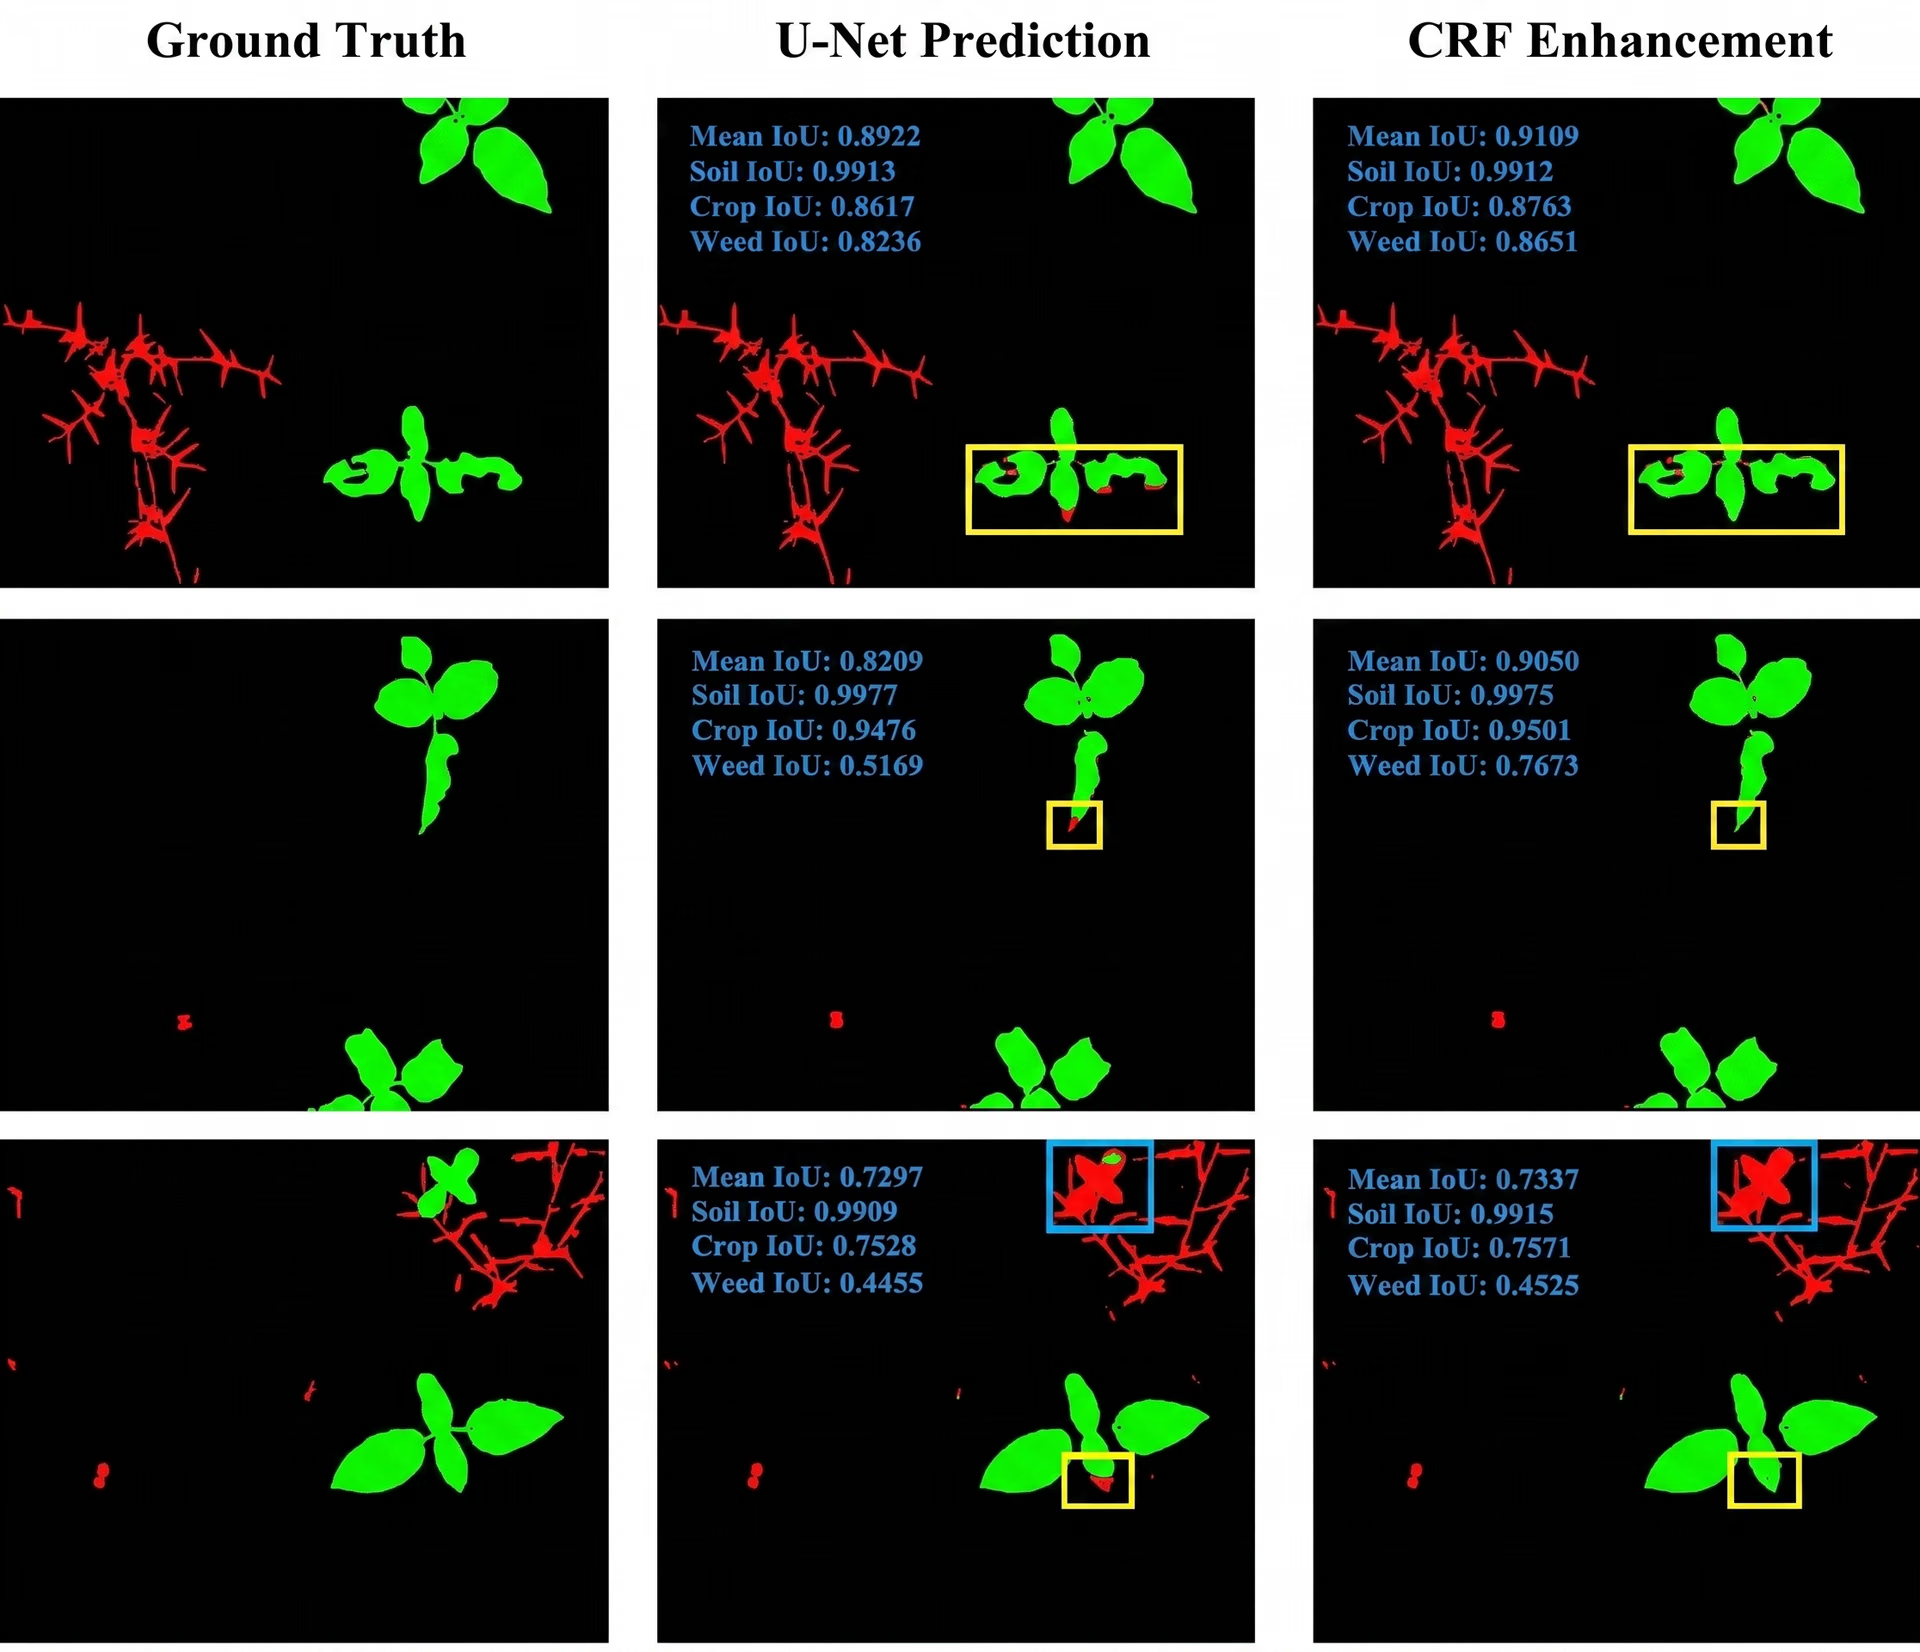
Fig. 5. Separación de cultivos y malas hierbas en campos agrícolas con U-Net. (Fuente)
Conducción autónoma#
Antes de la aparición de modelos de IA más avanzados, U-Net desempeñó un papel fundamental en la investigación de cómo la segmentación podía mejorar la conducción autónoma. En los vehículos autónomos, la segmentación semántica de U-Net puede clasificar cada píxel de una imagen en categorías como carretera, vehículo, peatón y marcas de carril. Esto ofrece al vehículo una visión clara del entorno y facilita una navegación segura y una toma de decisiones eficaz.
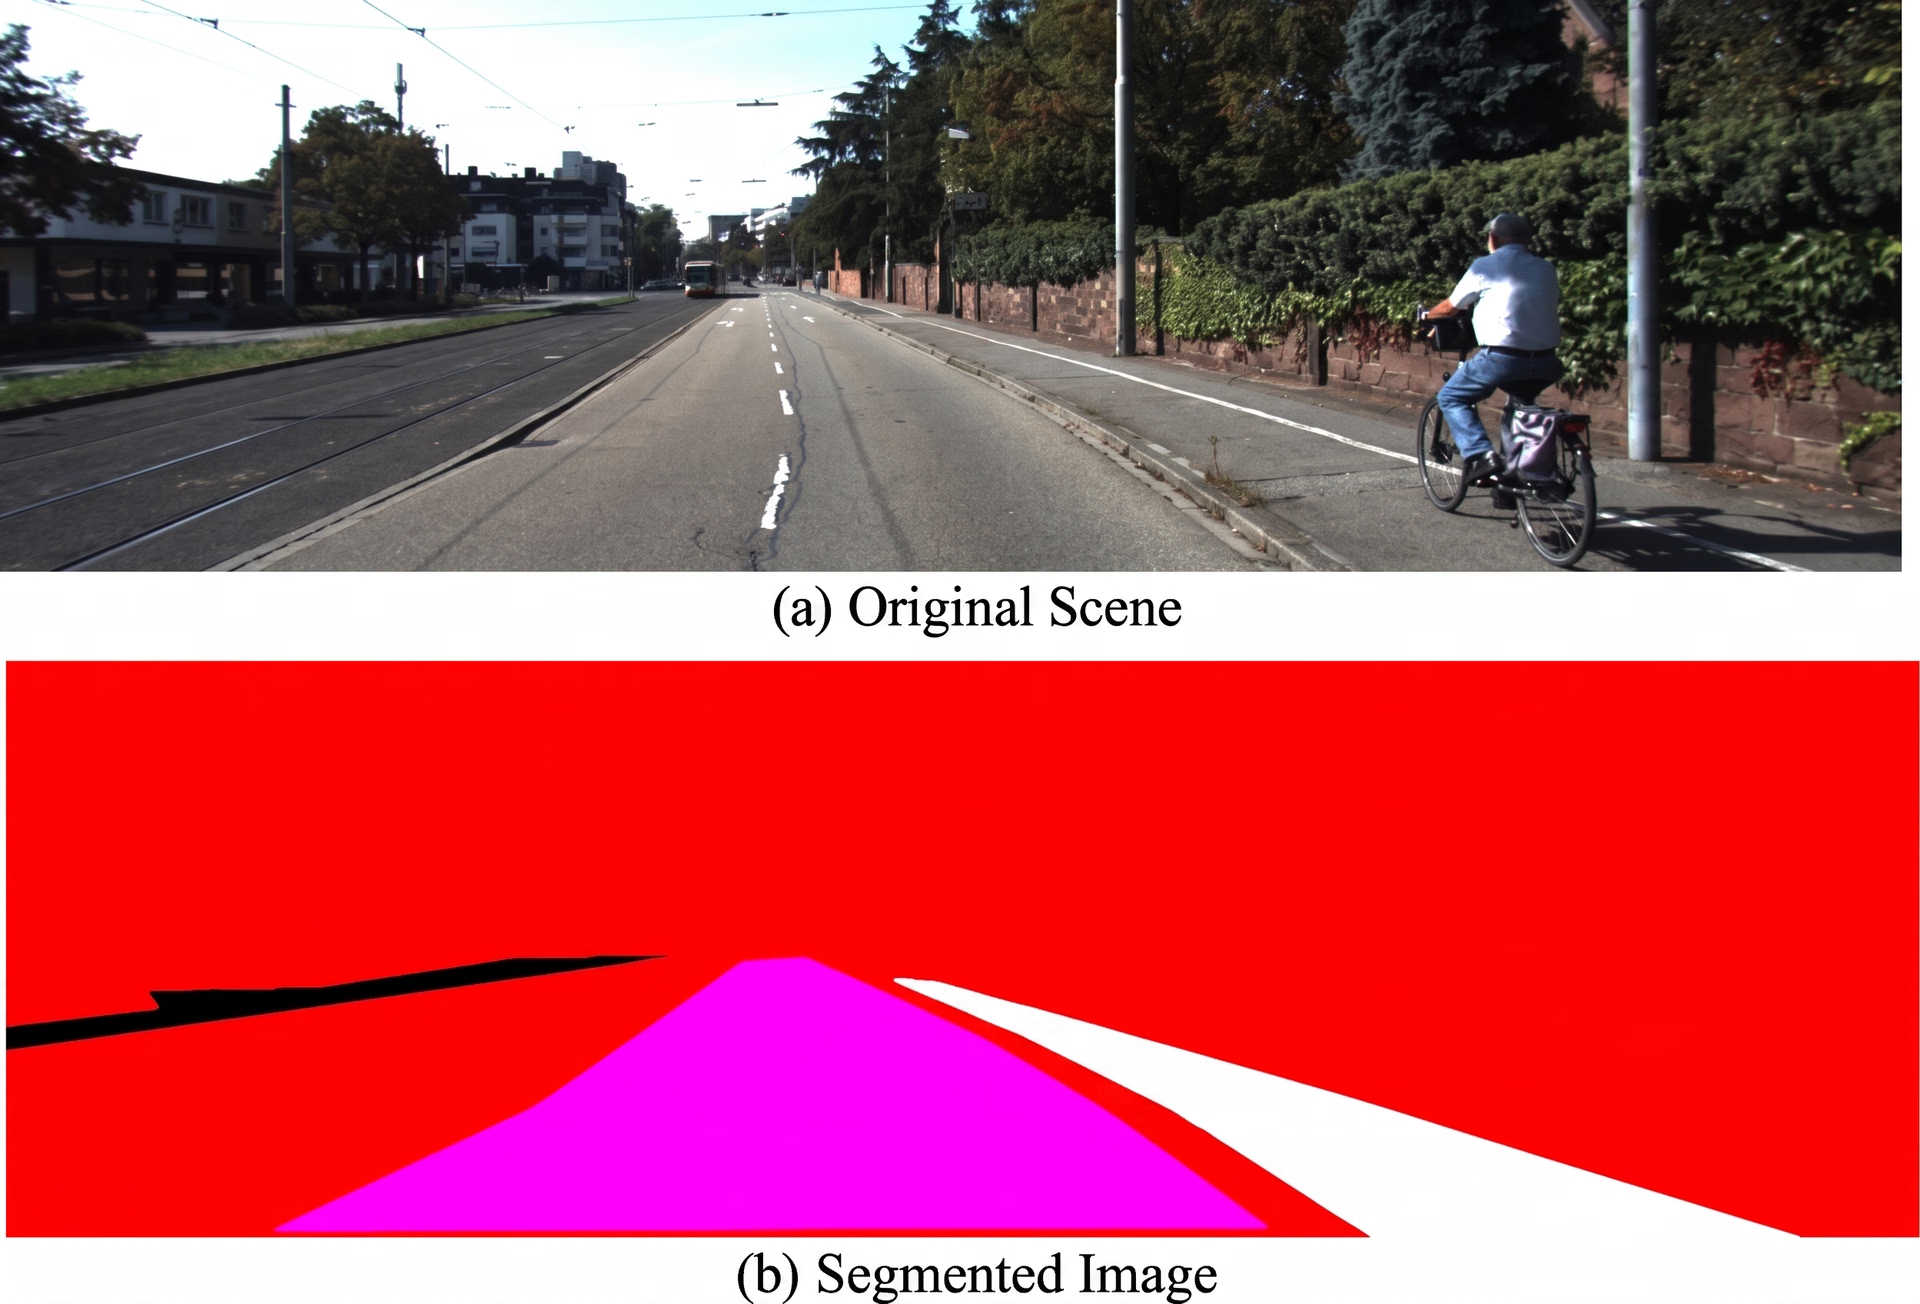
Fig. 6. Escena de carretera en la que U-Net segmenta la zona transitable. (Fuente)
Ventajas e inconvenientes de U-Net#
Incluso hoy, U-Net sigue siendo una buena opción para la segmentación de imágenes entre los investigadores, gracias a su equilibrio entre sencillez, precisión y adaptabilidad. Estas son algunas de las principales ventajas que lo distinguen:
- Adaptable a distintas modalidades: U-Net se ha adaptado a diversos tipos de datos, como exploraciones médicas 3D, imágenes por satélite e incluso fotogramas de vídeo.
- Inferencia rápida si se optimiza: Con los ajustes adecuados, U-Net puede ejecutarse de forma eficiente, por lo que resulta apto para aplicaciones en tiempo real o casi real.
- Código abierto y comunidad: U-Net está disponible en las principales bibliotecas de aprendizaje profundo y cuenta con una amplia comunidad de desarrolladores e investigadores.
Aunque U-Net tiene muchas ventajas, también presenta algunas limitaciones que conviene tener en cuenta. Estos son algunos factores que debes considerar:
- Sensible a la calidad de los datos: El rendimiento de U-Net puede verse afectado negativamente por datos de baja calidad, como imágenes con ruido o de baja resolución.
- Propenso al sobreajuste con conjuntos de datos pequeños: Aunque U-Net funciona bien con pocos datos, sigue existiendo riesgo de sobreajuste si no se regulariza correctamente, sobre todo cuando el conjunto de datos es demasiado pequeño o poco diverso.
- Recursos computacionales: U-Net puede exigir muchos recursos computacionales, especialmente al trabajar con conjuntos de datos grandes, por lo que requiere hardware considerable para el entrenamiento.
Conclusiones clave#
U-Net ha sido un hito clave en la evolución de la segmentación de imágenes. Demostró que los modelos de aprendizaje profundo pueden ofrecer resultados precisos con conjuntos de datos más pequeños, especialmente en ámbitos como el diagnóstico por imagen.
Este avance ha allanado el camino para aplicaciones más avanzadas en diversos campos. A medida que evoluciona la visión artificial, los modelos de segmentación como U-Net siguen siendo fundamentales para que las máquinas comprendan e interpreten datos visuales con gran precisión.
¿Quieres crear tus propios proyectos de visión artificial? Explora nuestro repositorio de GitHub para profundizar en la IA y consulta nuestras opciones de licencia. Descubre cómo la visión artificial en sanidad mejora la eficiencia y conoce el impacto de la IA en el comercio minorista en nuestras páginas de soluciones. ¡Únete ya a nuestra creciente comunidad!









