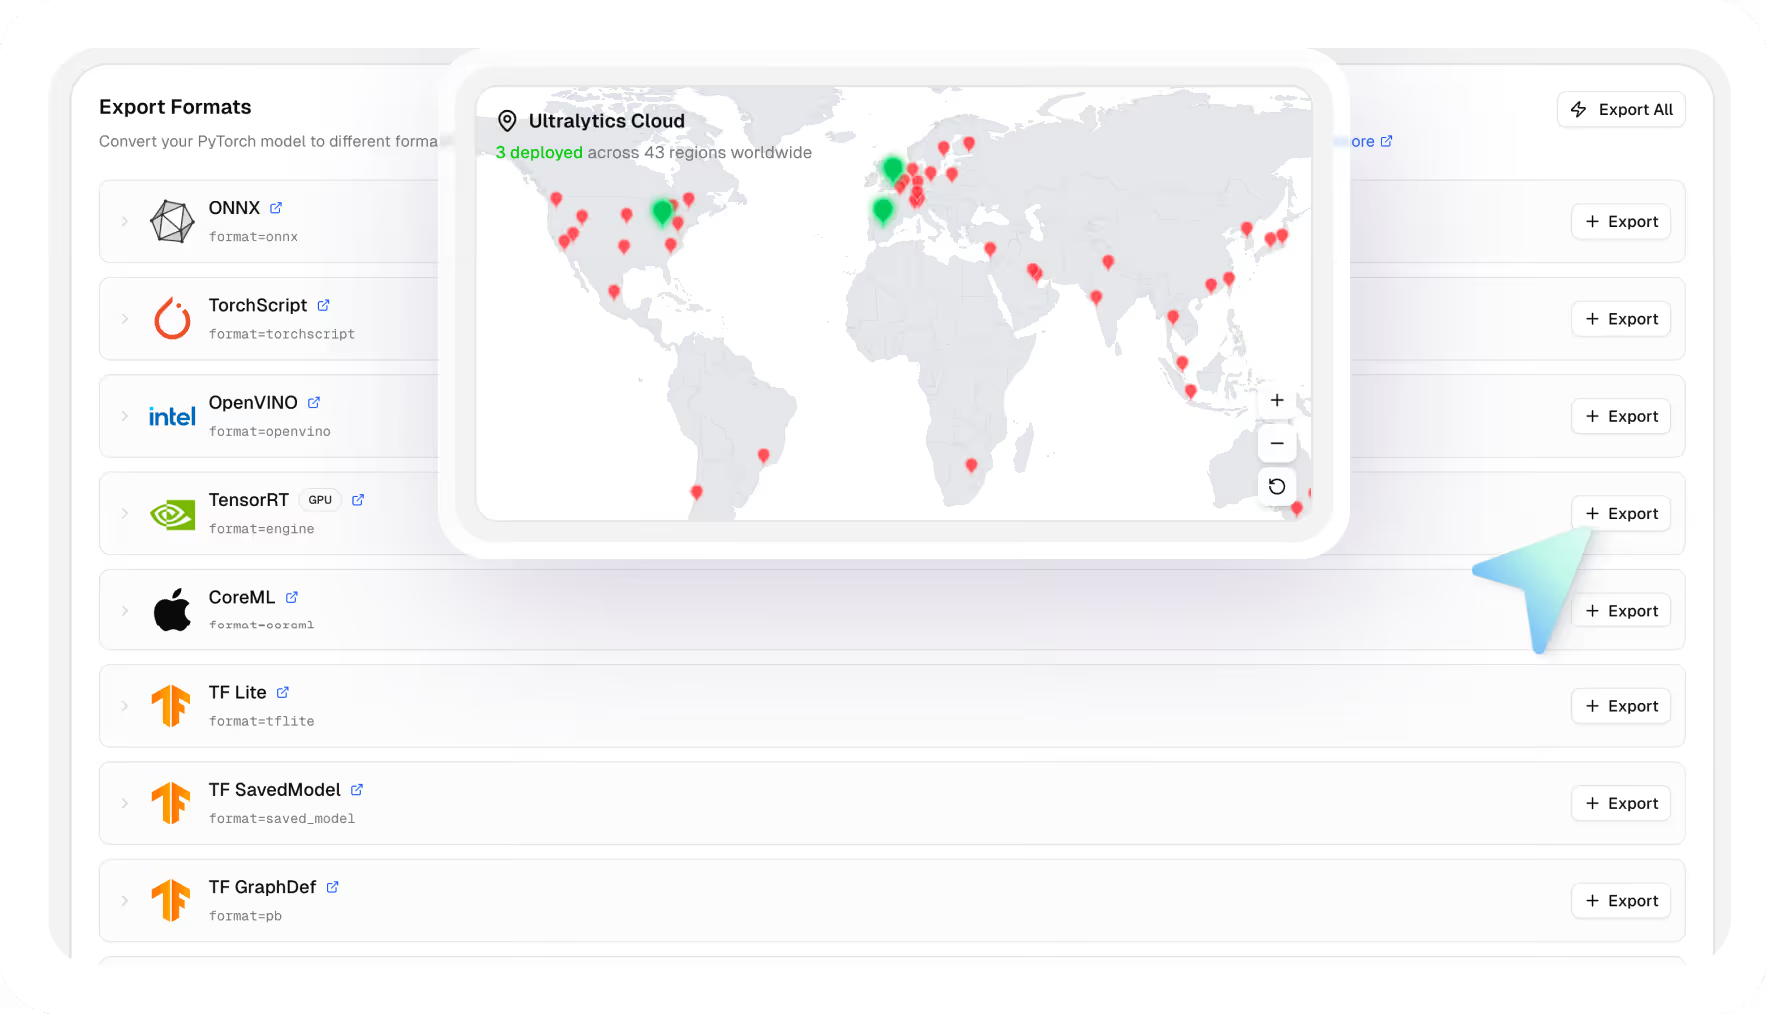
Implementa modelos de visión artificial en 42 regiones de todo el mundo
Pasa los modelos entrenados de las pruebas en el navegador a endpoints de producción en unos pocos clics, con endpoints dedicados, monitorización del despliegue y 22 formatos de exportación.
Despliega a escala de producción mundial
Lleva los modelos entrenados a producción con disponibilidad en todo el mundo, amplia compatibilidad con formatos de exportación y el volumen de uso avalado por el ecosistema de Ultralytics.
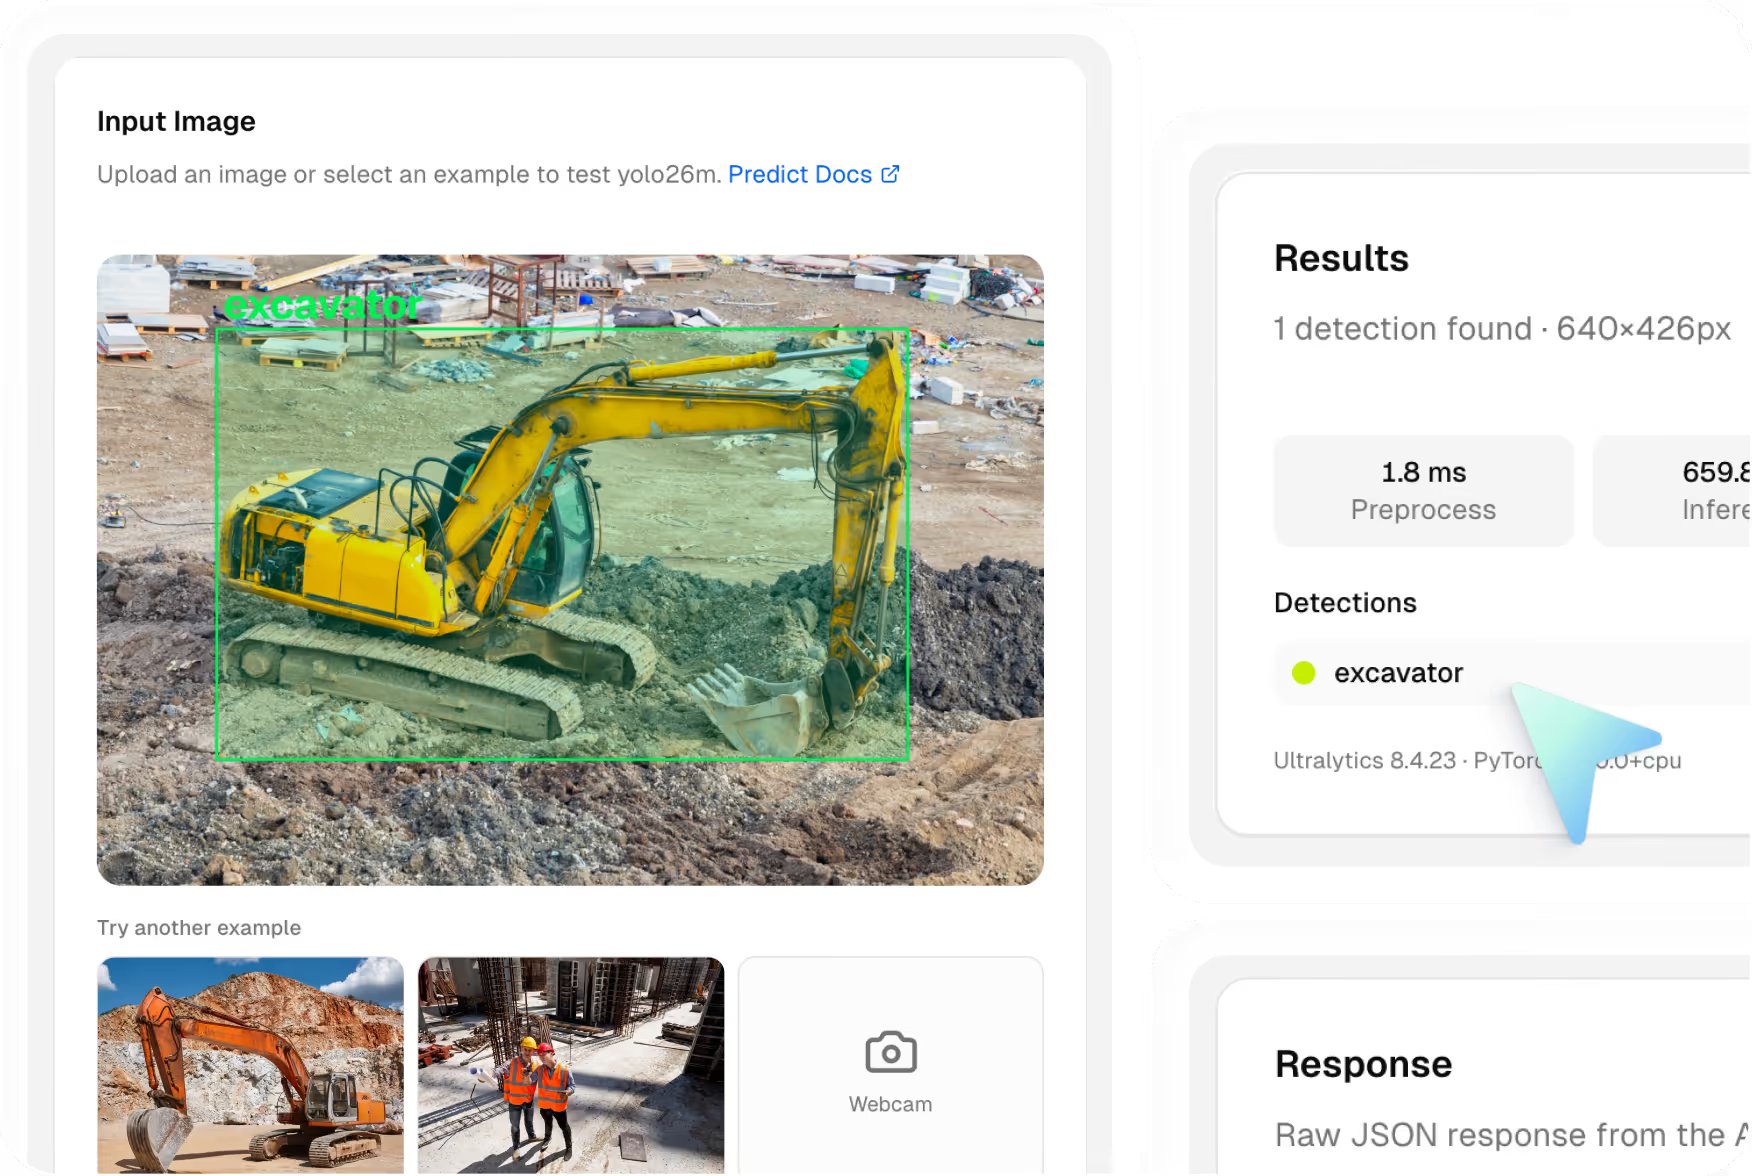
Prueba tu modelo en el navegador
Todos los modelos entrenados incluyen la funcionalidad integrada de la pestaña Predict. Sube una imagen o abre la cámara: los cuadros delimitadores aparecen al instante.
Implementa en 42 regiones de todo el mundo
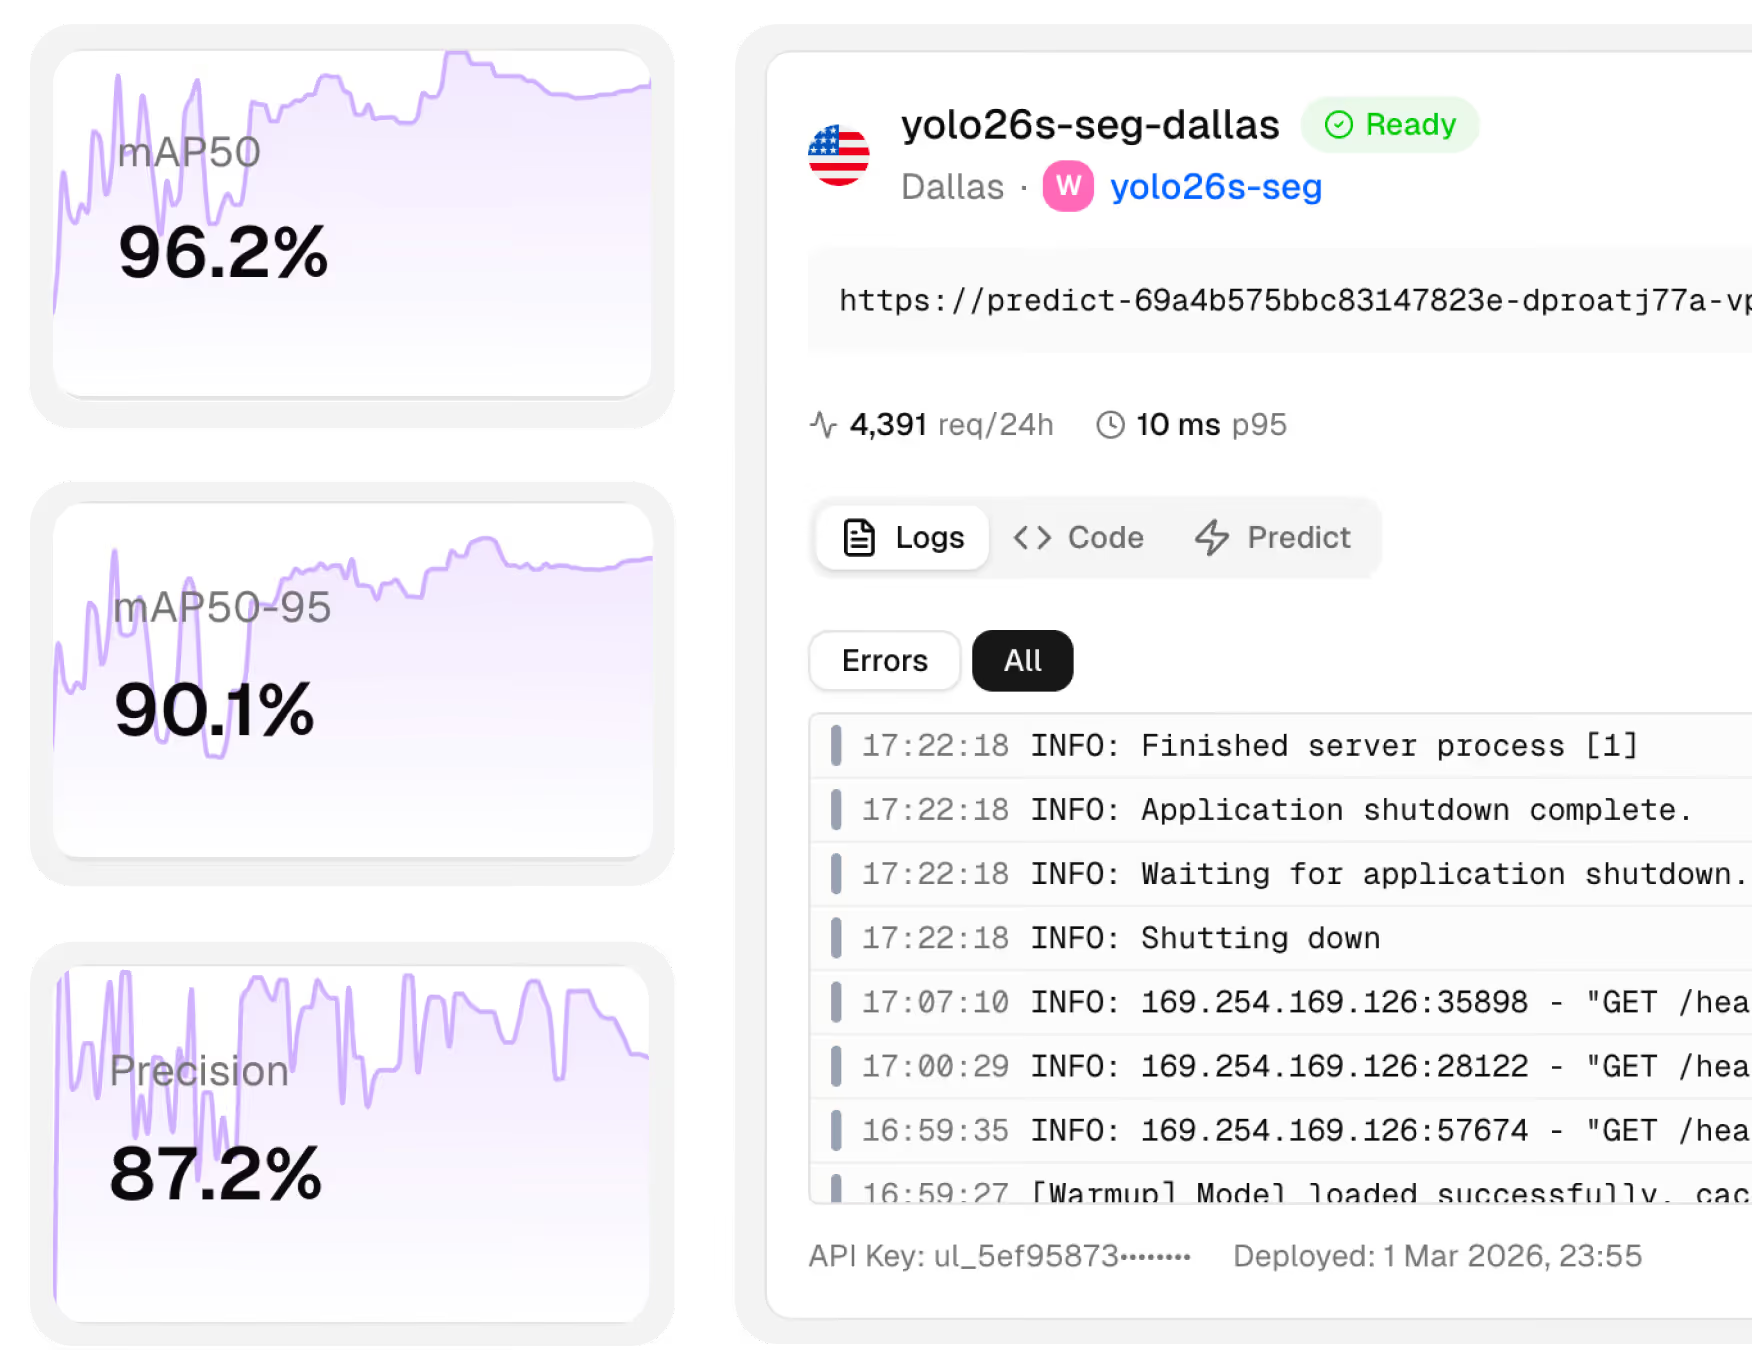
Implementa tus modelos en endpoints específicos de América, Europa, Asia-Pacífico y Oriente Medio. Cada endpoint tiene su propia URL, CPU y memoria configurables, y supervisión de solicitudes, latencia, errores y registros.
Endpoints dimensionados según tu carga de trabajo
Empieza con el tamaño incluido o elige la CPU y la memoria que necesita cada endpoint.
- Escalado a cero de forma predeterminada:El tamaño incluido se escala a cero cuando está inactivo y no tiene ningún coste por tiempo de actividad.
- Sin límite de frecuencia de la API de Platform:Las solicitudes van directamente a tu endpoint, no pasan por el limitador de frecuencia de la API de Platform.
- Recursos configurables:Elige la CPU (1-8 núcleos) y la memoria (2-32 GB) que se ajusten a tu carga de trabajo. Los tamaños personalizados mantienen una instancia activa cuyo tiempo de actividad se factura.
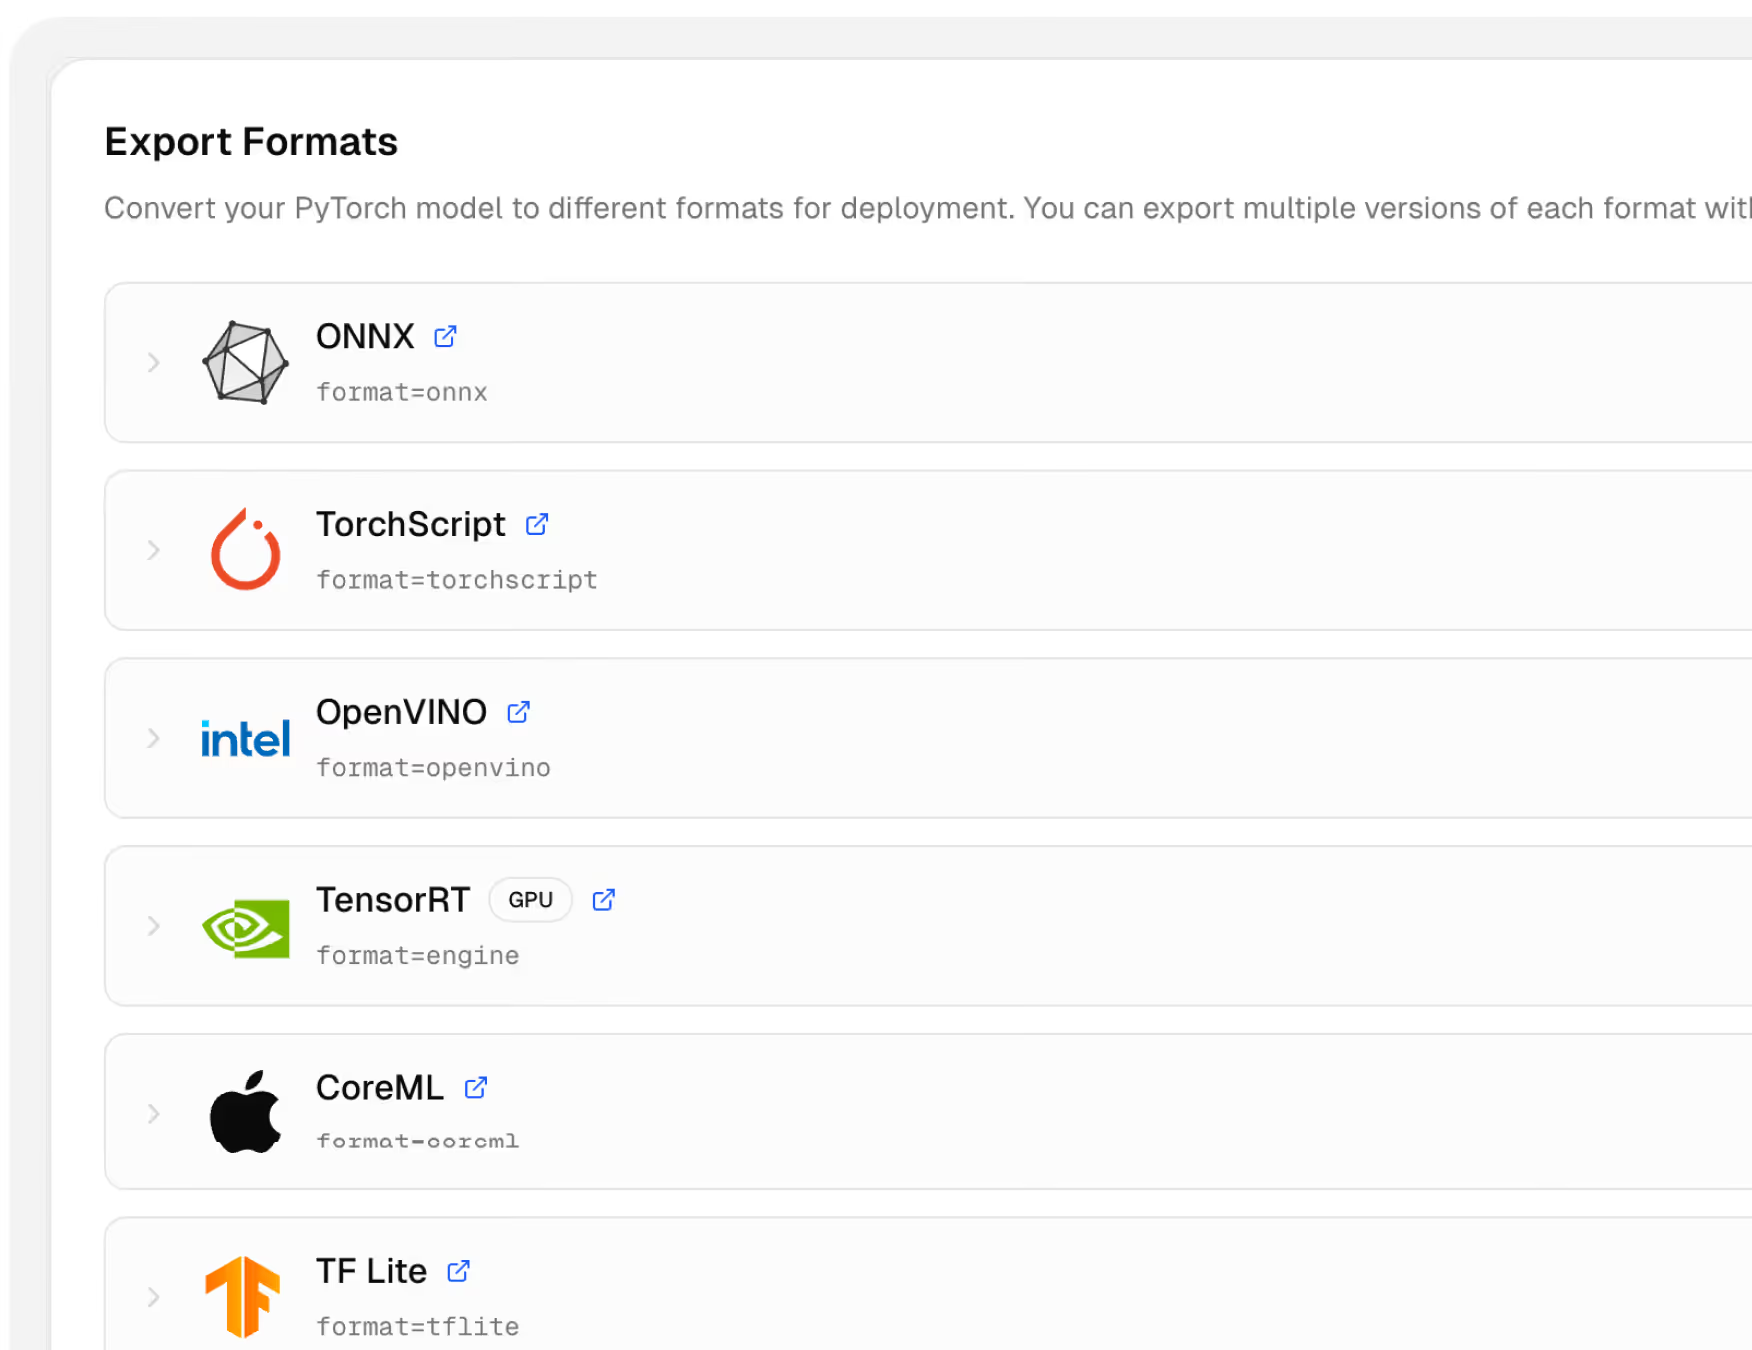
22 formatos de exportación. Tu modelo. Cualquier entorno.
Ultralytics Platform admite la implementación en la nube y en dispositivos perimetrales con un alto rendimiento. Todos los modelos Ultralytics YOLO están optimizados de forma nativa para ejecutarse eficientemente en distintos entornos y ofrecer gran precisión, un rendimiento fiable y compatibilidad incluso en dispositivos perimetrales con recursos de computación limitados.
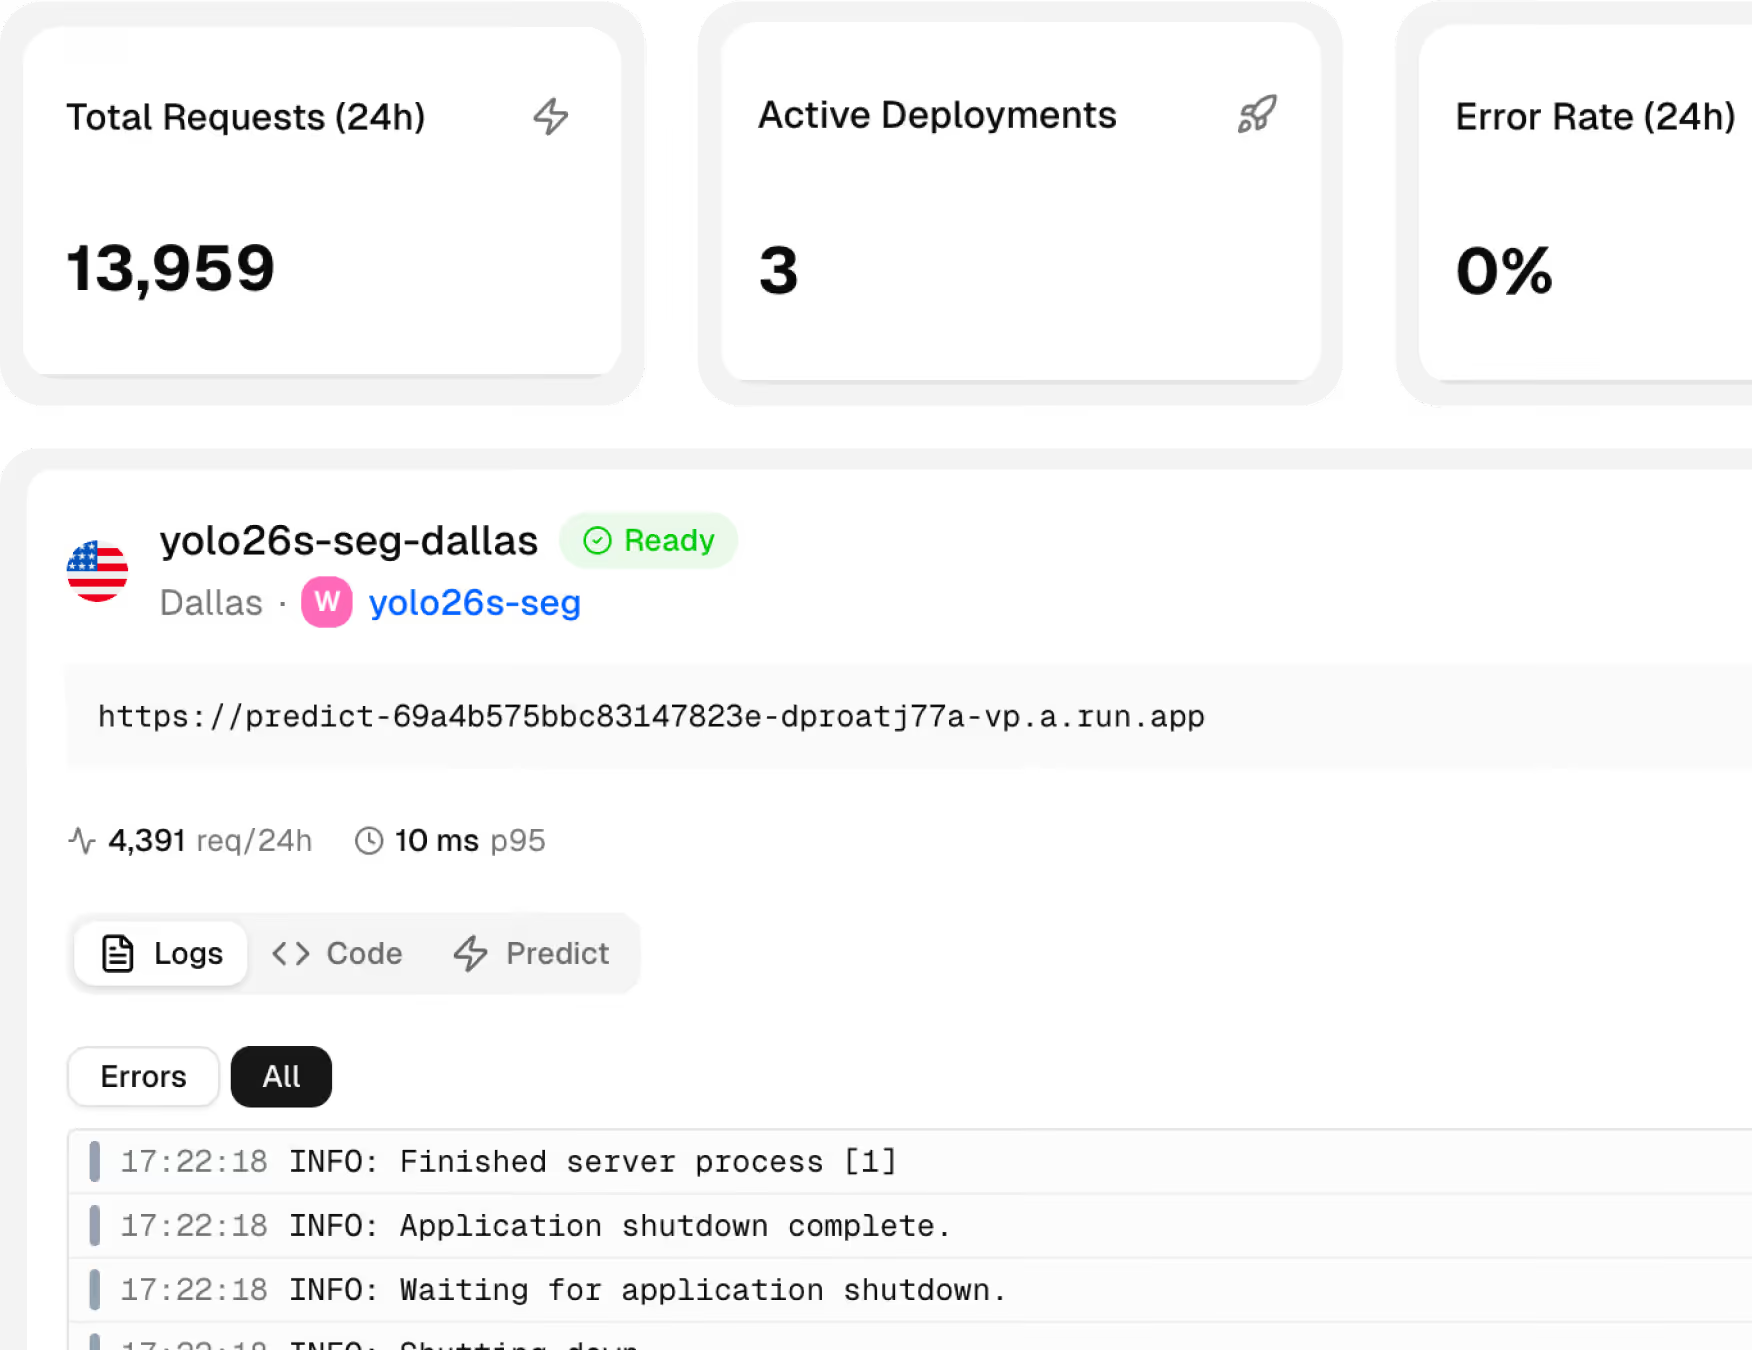
Supervisa todo en producción
Controla las solicitudes, la latencia, los errores y los registros de los endpoints desde el panel de implementaciones. Los endpoints específicos también proporcionan estadísticas de predicción en tiempo real y ejemplos temporales que puedes inspeccionar y guardar en un conjunto de datos.
- Solicitudes, latencia y errores:Volumen HTTP de las últimas 24 horas, latencia P95 ponderada por volumen y alertas cuando la tasa de errores supera el 5 %.
- Comprobaciones de estado y registros:Estado del endpoint en tiempo real con reintentos automáticos, además de registros filtrados por gravedad para diagnosticar problemas rápidamente.
- Ejemplos temporales:Inspecciona predicciones muestreadas en endpoints específicos. Los ejemplos se guardan en la memoria del endpoint; guarda las imágenes útiles en un conjunto de datos para conservarlas.
- Estadísticas de predicción:Recuentos por clase, confianza, tiempo de inferencia y mapas de calor espaciales, si la tarea del modelo lo permite. Las estadísticas se restablecen cuando se sustituye la instancia que presta el servicio.
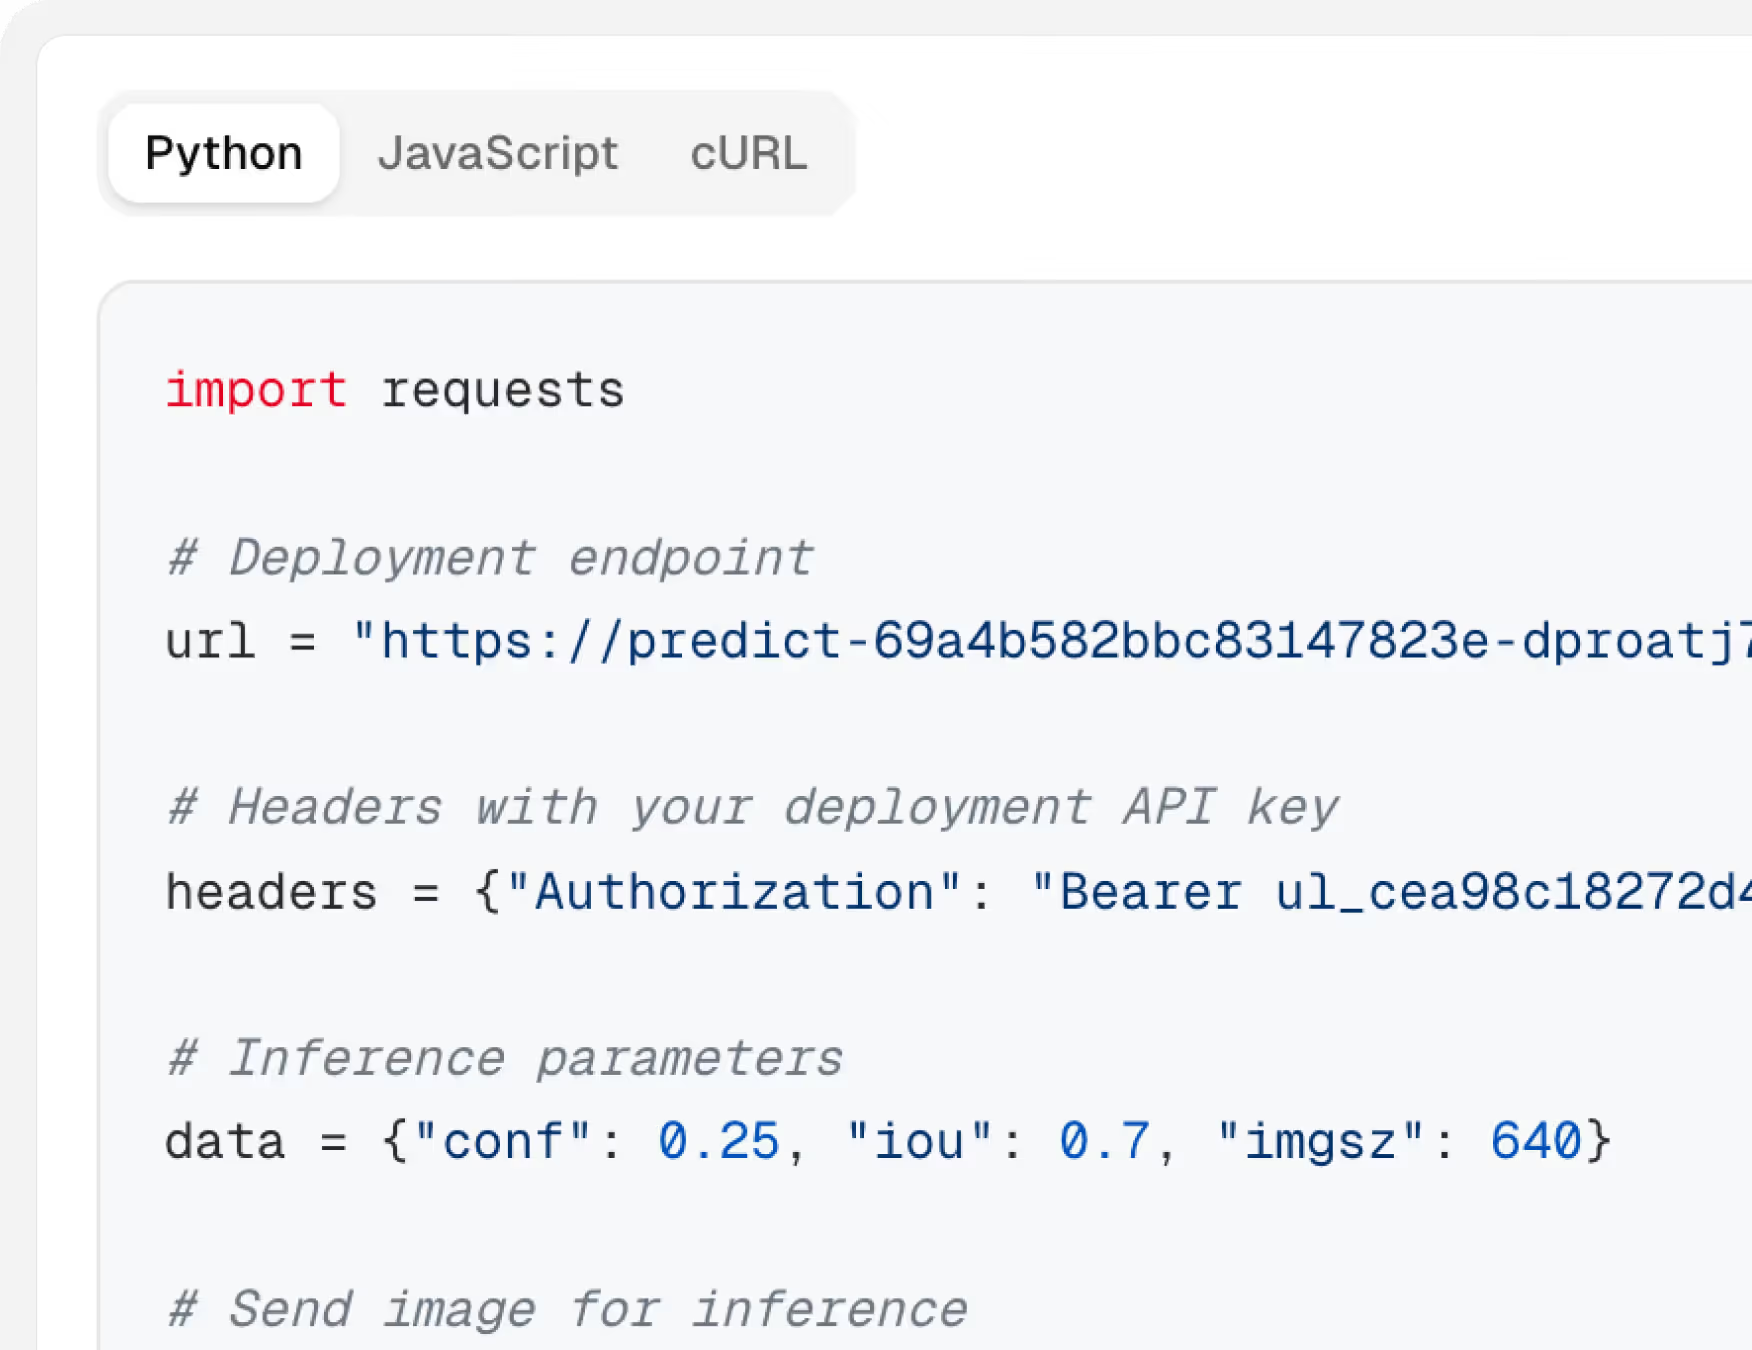
Integra en minutos
Cada endpoint implementado incluye ejemplos de código generados automáticamente en Python, JavaScript y cURL, con la URL real de tu endpoint y tu clave de API ya rellenadas. Copia, pega y empieza a enviar solicitudes de inferencia desde cualquier aplicación.
Prueba la inferencia de YOLO26
Arrastra y suelta una imagen para ver la detección de objetos en tiempo real
¡Descubre cómo implementarlos!
Descubre cómo probar un modelo entrenado, implementarlo en un endpoint global y supervisar las solicitudes, la latencia y las predicciones en tiempo real.
Qué dicen nuestros clientes
Ultralytics Platform ha supuesto un antes y un después para nosotros. Facilita enormemente que nuestros científicos de datos creen conjuntos de datos, entrenen rápidamente modelos nuevos con recursos de computación en la nube, comparen experimentos con distintos ajustes de modelo y, en definitiva, identifiquen el mejor modelo para cada problema. Se ha convertido en nuestro primer recurso para experimentar con detección de objetos, segmentación de instancias y segmentación semántica.
Tyler Biesel, Gerente de ingeniería de software
Los modelos Ultralytics YOLO nos ayudaron a aumentar un 25,2 % la velocidad de implementación de nuestro servicio de IA. Son fáciles de implementar y ofrecen un rendimiento excelente en el mundo real, con más velocidad, precisión y escalabilidad sin comprometer el rendimiento operativo.
Ultralytics YOLO26 funciona a la perfección en la plataforma de Axelera y permite acelerar la implementación de IA en el borde con un esfuerzo de integración mínimo. Este es exactamente el tipo de colaboración entre hardware y software que ayuda a los clientes a pasar del desarrollo a la producción más rápido.
Alexis Crowell, CMO global y director general para América
Con Ultralytics YOLOv8 nano, podemos volver a entrenar en el borde y lanzar un modelo nuevo en horas en lugar de semanas, transfiriendo solo una fracción de los datos. Esa combinación de precisión y tamaño reducido es justo lo que necesitan nuestros entornos.
Con Ultralytics, hemos conseguido mejorar la velocidad y aumentar la precisión en comparación con otros modelos. La compatibilidad con distintos marcos de trabajo —CUDA, TensorRT, ONNX y OpenVINO— nos ha resultado muy útil para ajustar los pesos durante la I+D y optimizarlos después para el hardware que tengamos.
El rendimiento de los modelos Ultralytics YOLO en nuestros microcontroladores STM32 abre nuevos horizontes para la visión artificial en el borde. Gracias a una integración optimizada y a la compatibilidad con múltiples variantes de modelos, los desarrolladores tienen todo lo que necesitan para crear soluciones de visión integradas, escalables y con gran capacidad de respuesta.

Transforman los datos visuales en información útil con una precisión y eficiencia excepcionales. Al combinar Ultralytics YOLOv8 con el sensor IMX500 de SSS (Sony Semiconductor Solutions Corporation), esta colaboración ofrece potentes capacidades de IA en el propio dispositivo que mejoran la toma de decisiones en tiempo real de las empresas que dependen del procesamiento de datos visuales de alto rendimiento.
Wei Tang, Responsable de desarrollo de negocio
Los modelos YOLO de Ultralytics están revolucionando el sector de la IA. Los desarrolladores prefieren YOLOv5 y YOLOv8 por su facilidad de uso, su rendimiento de vanguardia y su precisión. Combinados con OpenVINO, estos modelos ofrecen la posibilidad de obtener el mejor rendimiento desde el primer momento en las CPU modernas.
¿Primero tienes que entrenar un modelo?
Ultralytics Platform conecta la anotación, el entrenamiento y la implementación en una sola plataforma.
Descubre soluciones para tu sector
Descubre cómo los equipos aplican la visión artificial de Ultralytics en entornos de producción.

Visión artificial en el deporte

Visión artificial para imágenes aéreas

Visión artificial en el sector aeroespacial

Visión artificial en seguridad

Visión artificial en robótica

Visión artificial en logística

Visión artificial en el comercio minorista

Visión artificial en el sector sanitario

Visión artificial en la fabricación

Visión artificial en la automoción

Visión artificial en la agricultura
Seguridad y cumplimiento de nivel empresarial
Desarrolla e implementa con confianza. Con certificación ISO 27001, atestación SOC 2 y soporte para el cumplimiento de HIPAA.
SOC 2 Type I
ISO 27001:2022
HIPAA
RGPD y CCPA
Preguntas frecuentes
Sí. Despliega un modelo en tantas de las 42 regiones como permita tu plan: 3 endpoints en Free, 10 en Pro e ilimitados en Enterprise, contabilizados en todo tu espacio de trabajo. Desplegar el modelo más cerca de tus usuarios puede reducir la latencia.
El tamaño predeterminado del endpoint (1 vCPU, 2 GiB) es gratuito, incluso mientras atiende solicitudes, y escala a cero cuando está inactivo. Los tamaños personalizados, de hasta 8 vCPU y 32 GiB, mantienen una instancia activa y consumen créditos por el tiempo de actividad, incluido el tiempo inactivo, a tarifas que dependen del tamaño y la región. La inferencia compartida está incluida en todos los planes.
La inferencia compartida se ejecuta en un servicio multiinquilino en 3 regiones y tiene un límite de 20 solicitudes por minuto y por clave de API o llamante, por lo que resulta adecuada para pruebas. Un endpoint dedicado es un servicio de inquilino único en cualquiera de las 42 regiones, con su propia URL y clave de API. Las solicitudes que se envían directamente no están sujetas a ese límite, pero cada endpoint ejecuta una instancia y puede rechazar solicitudes cuando está ocupado, así que haz pruebas de carga antes de pasar a producción.
Un endpoint nuevo suele estar listo en unos minutos, según el modelo y la región. Los endpoints de tamaño predeterminado escalan a cero cuando están inactivos, por lo que la primera solicitud después de un periodo sin actividad puede tardar hasta aproximadamente un minuto mientras se inicia el endpoint.
El despliegue de modelos pone un modelo entrenado a disposición para realizar predicciones con datos nuevos, como imágenes o fotogramas de vídeo enviados desde una aplicación. En Ultralytics Platform, puedes probar un modelo en el navegador, desplegarlo en un endpoint dedicado en cualquiera de las 42 regiones, llamarlo desde tu aplicación y supervisarlo, todo desde el mismo espacio de trabajo.
Envía imágenes o archivos de vídeo compatibles a la REST API de tu endpoint; los modelos de profundidad solo aceptan imágenes. Cada página de implementación incluye ejemplos en Python, JavaScript y cURL. Los propietarios del espacio de trabajo también pueden ejecutar un endpoint desde una cámara web o una cámara RTSP accesible por Internet en su pestaña Predict (no se admiten direcciones de redes locales), y los endpoints de tamaño personalizado pueden seguir observando una cámara IP en segundo plano.
Sí. Exporta tu modelo para el hardware de destino y ejecútalo en tus propios servidores o dispositivos periféricos, incluso sin conexión. Entre los formatos disponibles se incluyen TensorRT para NVIDIA Jetson, OpenVINO, CoreML, LiteRT, NCNN, RKNN, Hailo y Qualcomm; la disponibilidad depende del modelo y la tarea. Para usarlo en productos propietarios sin las obligaciones de AGPL-3.0, necesitas una licencia Enterprise de Ultralytics.
¡Empieza a desplegar hoy!
Lleva tus modelos entrenados a producción en 42 regiones de todo el mundo con endpoints dedicados y monitorización de despliegues.