Comprendre la segmentation de concepts guidée par des invites
Découvre la segmentation de concepts guidée par des invites, en quoi elle diffère des méthodes traditionnelles et comment des modèles apparentés comme YOLOE-26 permettent la prise en charge d’un vocabulaire ouvert.
 Abirami Vina16 min de lecture
L’IA visuelle progresse rapidement et est largement utilisée pour analyser des images et des vidéos dans des environnements réels. Par exemple, des applications allant des systèmes de gestion du trafic à l’analyse du commerce de détail sont intégrées à des modèles de vision par ordinateur.
Dans bon nombre de ces applications, des modèles de vision, comme les modèles de détection d’objets, sont entraînés à reconnaître un ensemble prédéfini d’objets, notamment des véhicules, des personnes et de l’équipement. Pendant l’entraînement, ces modèles reçoivent de nombreux exemples annotés afin d’apprendre à quoi ressemble chaque objet et à le distinguer des autres dans une scène.
Pour les tâches de segmentation, les modèles vont plus loin en produisant des contours précis de ces objets au niveau du pixel. Les systèmes peuvent ainsi comprendre exactement où se trouve chaque objet dans une image.
Cette méthode fonctionne bien tant que le système doit uniquement reconnaître les objets sur lesquels il a été entraîné. Or, dans les environnements réels, c’est rarement le cas.
Les scènes visuelles sont généralement dynamiques. De nouveaux objets et concepts visuels apparaissent, les conditions changent et les utilisateurs souhaitent souvent segmenter des objets qui ne faisaient pas partie de la configuration d’entraînement initiale.
Ces limites sont particulièrement évidentes en segmentation. À mesure que l’IA visuelle évolue, le besoin de modèles de segmentation plus flexibles, capables de s’adapter à de nouveaux concepts sans réentraînement répété, se fait de plus en plus sentir. C’est pourquoi la segmentation de concepts guidée par des prompts (PCS) suscite un intérêt croissant.
Au lieu de s’appuyer sur une liste fixe de catégories d’objets, les utilisateurs peuvent décrire ce qu’ils veulent segmenter à l’aide de texte, de prompts visuels ou d’images exemples. Les modèles peuvent alors identifier et segmenter toutes les régions correspondant au concept décrit, même si celui-ci n’a pas été explicitement inclus pendant l’entraînement.
Dans cet article, nous verrons comment fonctionne la segmentation de concepts guidée par des prompts, en quoi elle diffère des approches traditionnelles et quelles sont ses applications actuelles.
Qu’est-ce que la segmentation de concepts guidée par des prompts ?#
Dans la plupart des cas, les modèles de segmentation sont entraînés à reconnaître une courte liste de types d’objets. Cette approche fonctionne bien lorsqu’un système d’IA visuelle doit uniquement détecter et segmenter un ensemble précis d’objets.
Dans les applications réelles, cependant, les scènes visuelles sont dynamiques. De nouveaux objets apparaissent, les exigences des tâches changent et les utilisateurs ont souvent besoin de segmenter des concepts qui ne figuraient pas dans l’ensemble d’étiquettes initial. Pour gérer ces situations, il faut généralement collecter de nouvelles données et annotations de haute qualité, puis réentraîner le modèle, ce qui augmente les coûts et ralentit le déploiement.
La segmentation de concepts guidée par des prompts résout ce problème en permettant aux utilisateurs d’indiquer au modèle ce qu’il doit rechercher, au lieu de choisir dans une liste d’étiquettes fixe. Les utilisateurs décrivent l’objet ou l’idée recherchés, et le modèle met en évidence toutes les zones correspondantes dans l’image. Il devient ainsi beaucoup plus facile de faire correspondre l’intention de l’utilisateur aux pixels d’une image.
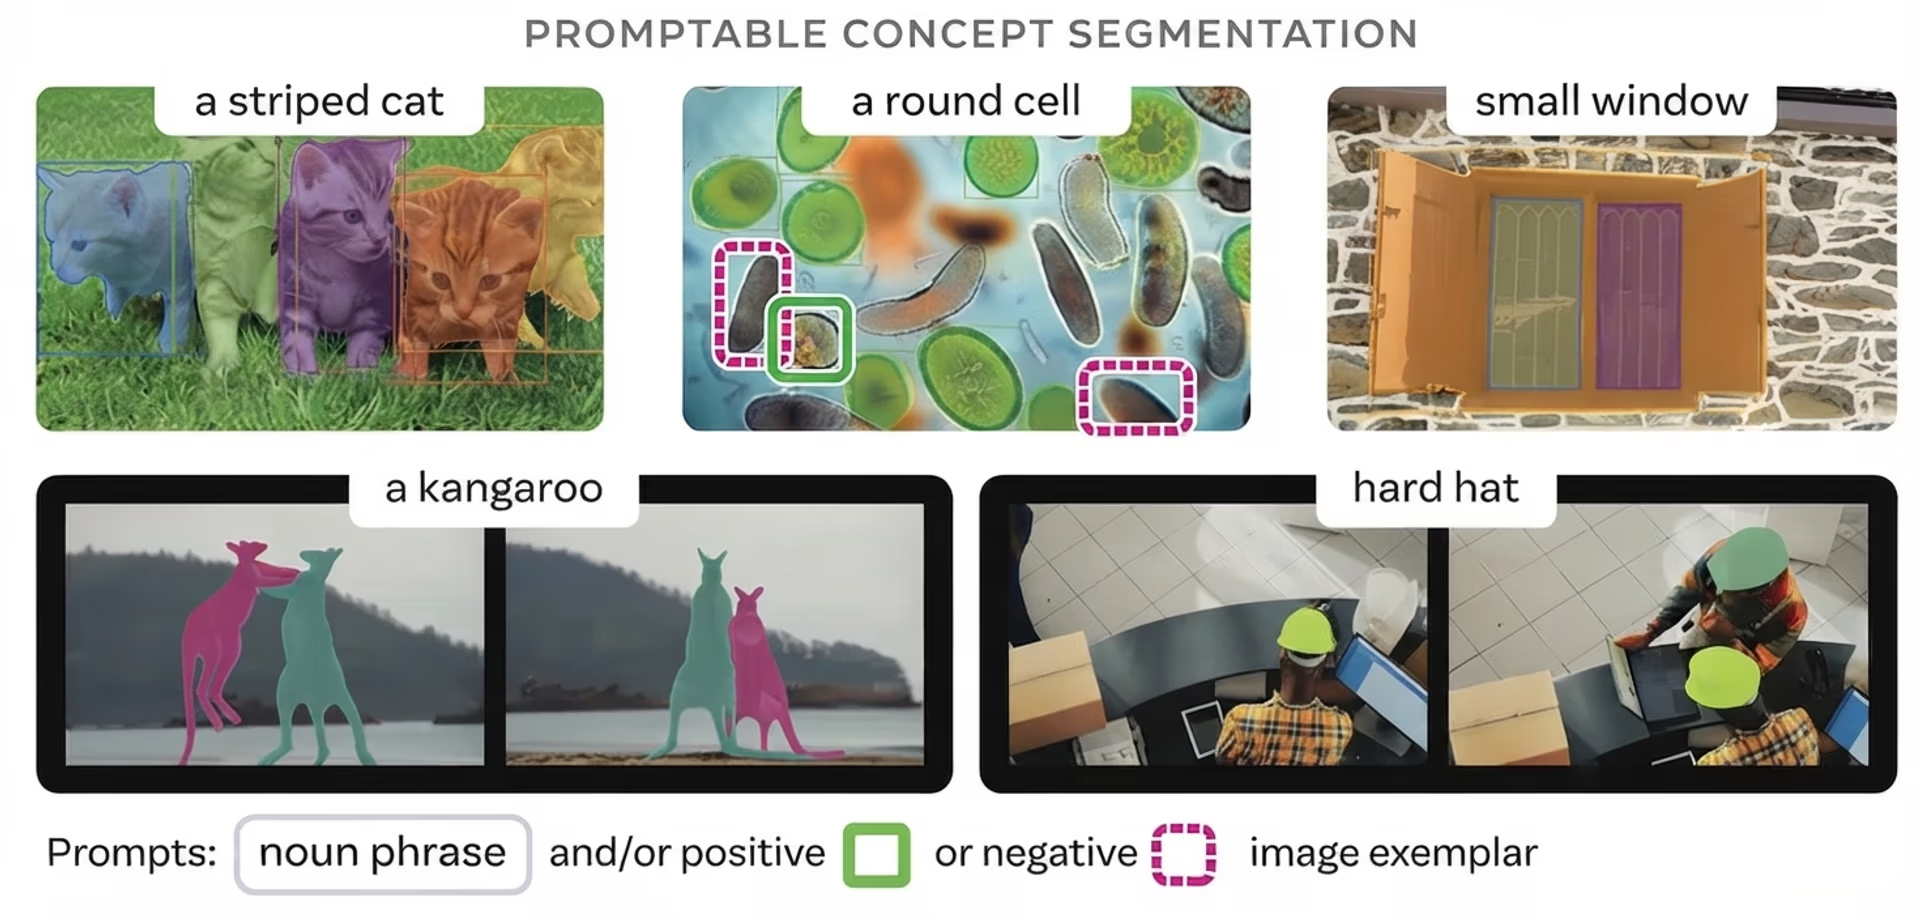
Fig. 1. Exemple d’utilisation de prompts de concept pour la segmentation (Source)
Guider la segmentation à l’aide de différents types de prompts#
Les modèles qui prennent en charge la segmentation de concepts guidée par des prompts sont flexibles, car ils acceptent différents types d’entrées. Autrement dit, il existe plusieurs façons d’indiquer au modèle ce qu’il doit rechercher, par exemple à l’aide de descriptions textuelles, d’indices visuels ou d’images exemples.
Voici un aperçu plus détaillé de chaque approche :
- Prompts textuels : De courtes expressions comme « autobus scolaire » ou « zone tumorale » peuvent décrire le concept à segmenter. Le modèle interprète le sens des mots et repère les régions correspondantes.
- Prompts visuels : Ces prompts utilisent des points, des cadres ou des esquisses approximatives dans l’image comme indices. Ils guident la recherche et aident à définir le contour final.
- Images de référence : Des images de référence ou de petits recadrages représentent le concept recherché. Le modèle recherche les régions visuellement similaires et les segmente en fonction de leur apparence.
Différences entre PCS et la segmentation traditionnelle#
Avant d’examiner le fonctionnement de la segmentation de concepts guidée par des prompts, comparons-la à différentes méthodes traditionnelles de segmentation d’objets.
PCS permet de créer des modèles à vocabulaire ouvert et guidés par des prompts. Ces modèles peuvent traiter de nouvelles notions décrites au moyen de prompts, contrairement à la segmentation traditionnelle. Il existe plusieurs types d’approches traditionnelles de segmentation, chacune reposant sur ses propres hypothèses et présentant ses propres limites.
Voici quelques-uns des principaux types de segmentation traditionnelle :
- Segmentation sémantique : Chaque pixel de l’image est étiqueté comme appartenant à une catégorie telle qu’une route, un bâtiment ou une personne. Tous les pixels portant la même étiquette sont regroupés, de sorte que le modèle ne distingue pas les instances individuelles d’un objet.
- Segmentation d’instances : Le modèle identifie et segmente les objets individuellement, de sorte que deux personnes ou deux voitures sont traitées comme des éléments distincts.
- Segmentation panoptique : Cette technique associe la segmentation sémantique et la segmentation d’instances pour fournir une vue complète de la scène, couvrant à la fois les zones d’arrière-plan et les objets individuels.
Toutes ces approches reposent sur une liste prédéfinie de catégories d’objets. Elles fonctionnent bien dans ce cadre, mais gèrent difficilement les concepts qui en sortent. Lorsqu’il faut segmenter un nouvel objet précis, des données d’entraînement supplémentaires et un ajustement fin du modèle sont généralement nécessaires.
PCS vise à changer cela. Au lieu d’être limité à des catégories prédéfinies, le modèle te permet de décrire ce que tu veux segmenter dans une image au moment de l’inférence.
Évolution des modèles PCS#
Voyons maintenant comment les modèles de segmentation ont évolué vers la segmentation de concepts guidée par des prompts.
Un modèle de fondation populaire qui a marqué un tournant dans la segmentation est SAM, ou le modèle Segment Anything. Présenté en 2023, il permettait aux utilisateurs de guider la segmentation à l’aide de prompts visuels simples, comme des points ou des cadres de délimitation, au lieu de s’appuyer sur des catégories d’objets prédéfinies.
Avec SAM, les utilisateurs n’avaient plus besoin de sélectionner une étiquette. Ils pouvaient simplement indiquer où se trouvait un objet, et le modèle générait un masque pour celui-ci. La segmentation gagnait ainsi en flexibilité, mais les utilisateurs devaient toujours montrer au modèle où chercher.
Sorti en 2024, SAM 2 a développé cette idée en gérant des scènes plus complexes et en étendant la segmentation guidée par des prompts aux vidéos. Il a amélioré la robustesse dans différentes conditions d’éclairage, formes d’objets et situations de mouvement, tout en s’appuyant principalement sur des prompts visuels pour guider la segmentation.
Le modèle SAM 3 constitue la dernière étape de cette évolution. Sorti l’année dernière, il s’agit d’un modèle unifié qui associe compréhension visuelle et instructions en langage naturel, afin d’assurer un comportement cohérent pour les tâches de segmentation d’images et de vidéos.
Avec SAM 3, les utilisateurs ne sont pas limités aux invites par pointage ou par dessin. Ils peuvent plutôt décrire par écrit ce qu’ils veulent segmenter, et le modèle recherche dans l’image ou les images vidéo les régions correspondant à cette description.
La segmentation est guidée par des concepts plutôt que par des catégories d’objets fixes, ce qui permet une utilisation en vocabulaire ouvert dans différentes scènes et au fil du temps. En fait, SAM 3 fonctionne dans un vaste espace de concepts appris, ancré dans une ontologie dérivée de sources telles que Wikidata et enrichie grâce à des données d’entraînement à grande échelle.
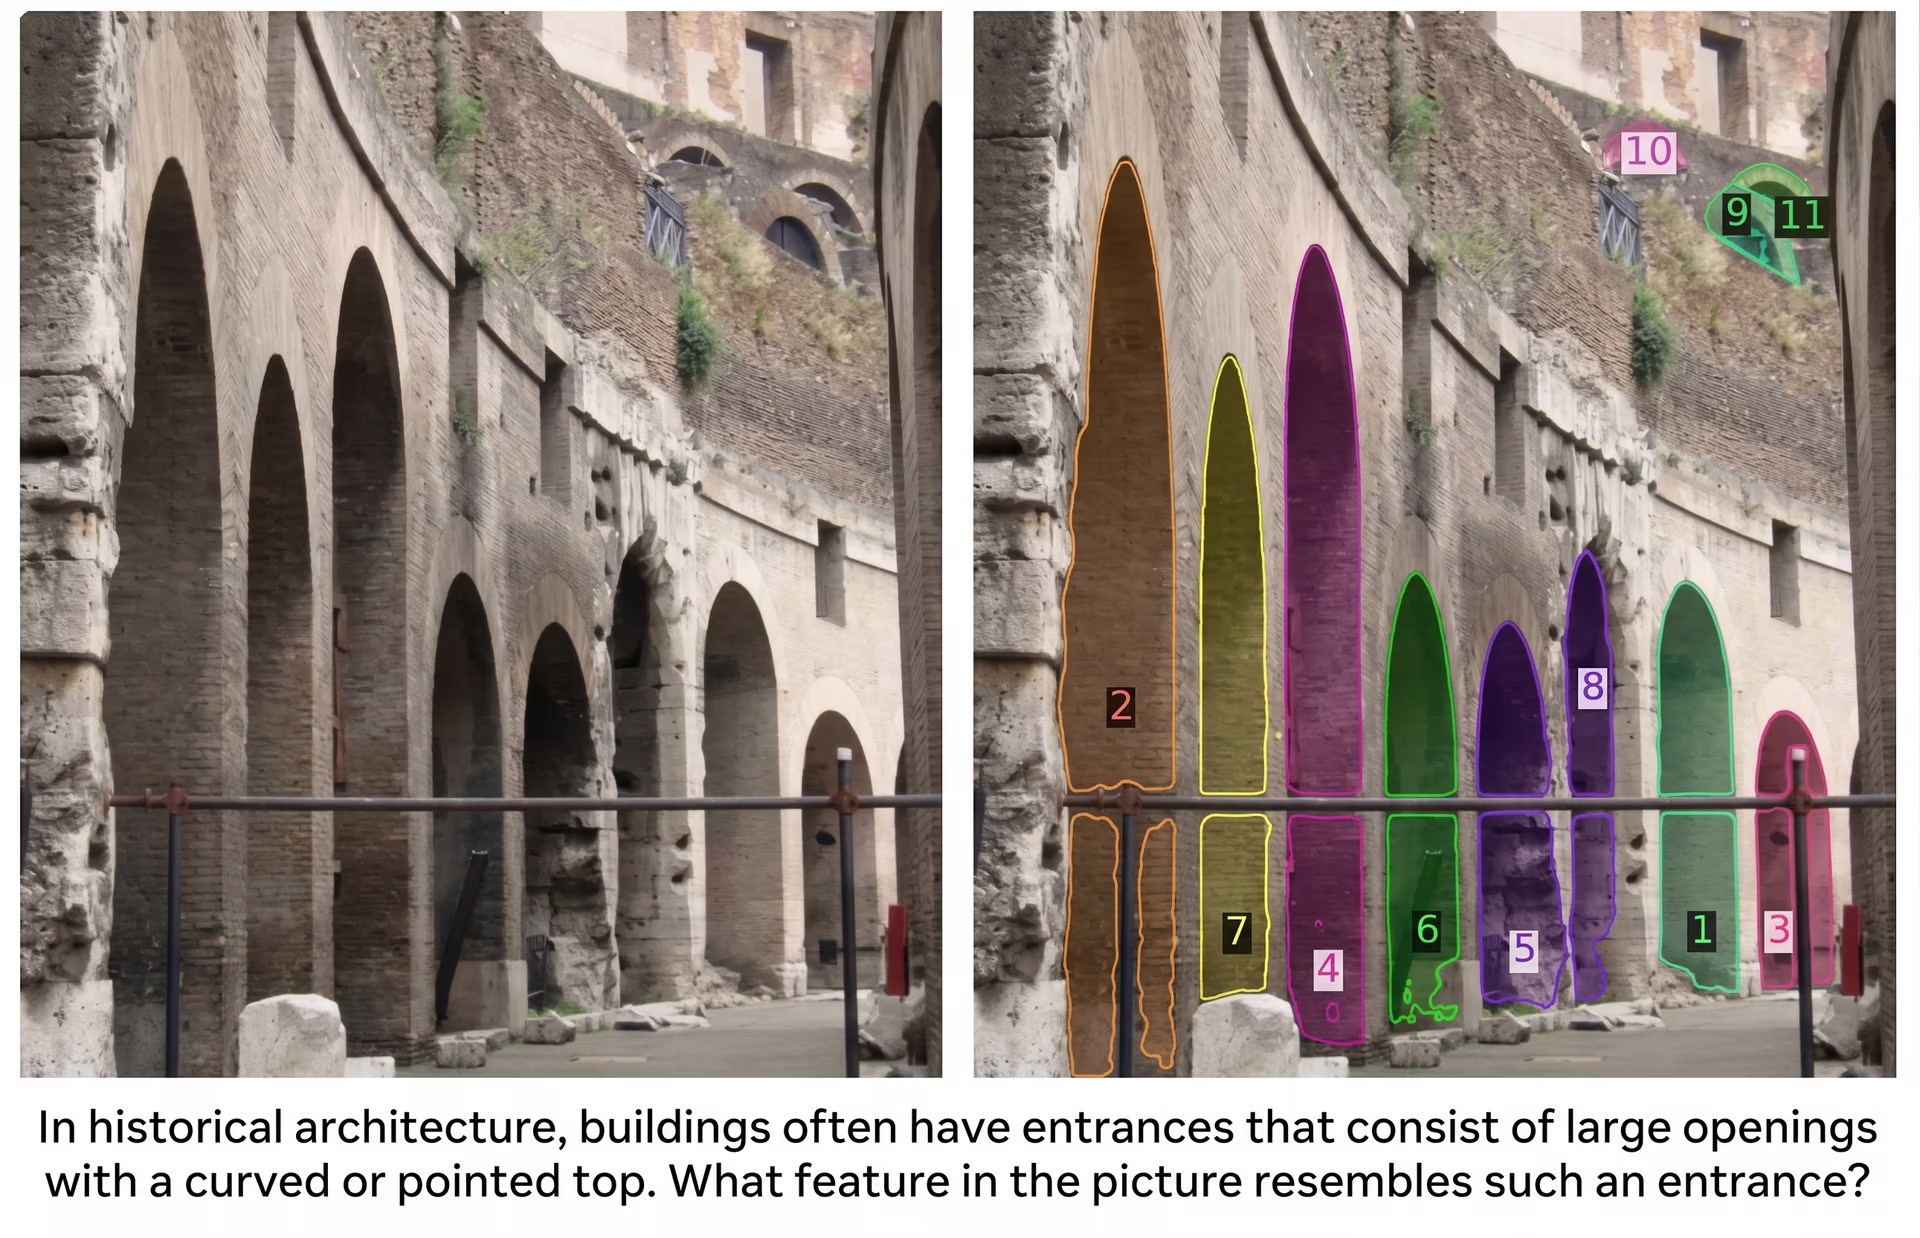
Fig. 2. Exemple d’invite donnée à SAM 3 pour segmenter une seule image (Source)
Par rapport aux versions précédentes, qui reposaient principalement sur des invites géométriques, SAM 3 constitue une avancée vers une segmentation plus souple, guidée par les concepts. Il est ainsi mieux adapté aux applications du monde réel, où les objets ou les idées d’intérêt peuvent changer et ne peuvent pas toujours être définis à l’avance.
Découvrir le fonctionnement de la segmentation de concepts guidée par des invites#
Alors, comment fonctionne la segmentation de concepts guidée par des invites ? Elle s’appuie sur de grands modèles préentraînés de vision et de vision et langage, entraînés sur d’immenses collections d’images et, dans bien des cas, sur des textes associés. Cet entraînement leur permet d’apprendre des motifs visuels généraux et une signification sémantique.
La plupart des modèles PCS utilisent des architectures basées sur des Transformers, qui traitent une image entière à la fois afin de comprendre les relations entre ses différentes régions. Un Transformer de vision extrait les caractéristiques visuelles de l’image, tandis qu’un encodeur de texte convertit les mots en représentations numériques que le modèle peut traiter.
Pendant l’entraînement, ces modèles peuvent apprendre à partir de différents types de supervision, notamment des masques au niveau du pixel qui définissent précisément les contours des objets, des boîtes englobantes qui localisent approximativement les objets et des étiquettes au niveau de l’image qui décrivent ce qu’elle contient. L’entraînement sur différents types de données annotées aide le modèle à saisir à la fois les détails fins et les concepts visuels plus généraux.
Au moment de l’inférence, c’est-à-dire lorsque le modèle est réellement utilisé pour produire des prédictions, la PCS suit un processus guidé par des invites. L’utilisateur fournit des indications sous forme de descriptions textuelles, d’indices visuels comme des points ou des boîtes, ou d’images d’exemple. Le modèle encode l’invite et l’image dans une représentation interne commune, ou embeddings, puis repère les régions qui correspondent au concept décrit.
Un décodeur de masques convertit ensuite cette représentation commune en masques de segmentation précis au niveau du pixel. Comme le modèle associe les caractéristiques visuelles à une signification sémantique, il peut segmenter de nouveaux concepts même s’ils n’ont pas été explicitement inclus pendant l’entraînement.
De plus, il est souvent possible d’affiner le résultat en modifiant l’invite ou en ajoutant des indications, ce qui aide le modèle à traiter les scènes complexes ou ambiguës. Ce processus itératif facilite l’optimisation pratique lors du déploiement.
Les modèles de segmentation de concepts guidée par des invites sont généralement évalués en fonction de leur capacité à segmenter des concepts jamais vus auparavant et de leur robustesse dans différentes scènes. Les benchmarks portent souvent sur la qualité des masques, la généralisation et l’efficacité de calcul, conformément aux exigences du déploiement dans le monde réel.
Cas d’usage de PCS dans le monde réel#
Voyons maintenant où la segmentation de concepts guidée par des invites est déjà utilisée et commence à avoir un réel impact.
Segmentation d’images médicales flexible#
L’imagerie médicale couvre de nombreuses structures biologiques, maladies et modalités d’acquisition, et de nouveaux cas apparaissent chaque jour. Les modèles de segmentation traditionnels peinent à suivre cette diversité.
PCS trouve naturellement sa place dans ce domaine, car elle permet aux cliniciens de décrire ce qu’ils veulent repérer au lieu de choisir parmi une liste courte et rigide. À l’aide de descriptions textuelles ou d’invites visuelles, PCS peut segmenter directement des organes ou des zones préoccupantes, sans réentraîner le modèle pour chaque nouvelle tâche. Elle facilite ainsi la prise en charge de besoins cliniques variés, réduit le recours au dessin manuel des masques et fonctionne avec de nombreux types d’imagerie.
MedSAM-3 en est un excellent exemple : ce modèle adapte l’architecture SAM 3 à PCS en imagerie médicale, guidée par des invites textuelles. Il peut recevoir des invites contenant des termes anatomiques et pathologiques explicites, comme des noms d’organes tels que le foie ou le rein, ou des concepts liés aux lésions comme une tumeur ou une lésion. À partir d’une invite, le modèle segmente directement la région correspondante dans l’image médicale.
MedSAM-3 intègre également de grands modèles de langage multimodaux (MLLM ou LLM multimodaux), capables de raisonner à partir de textes et d’images. Ces modèles fonctionnent dans un dispositif avec un agent dans la boucle, où les résultats sont affinés de manière itérative afin d’améliorer la précision dans les cas plus difficiles.
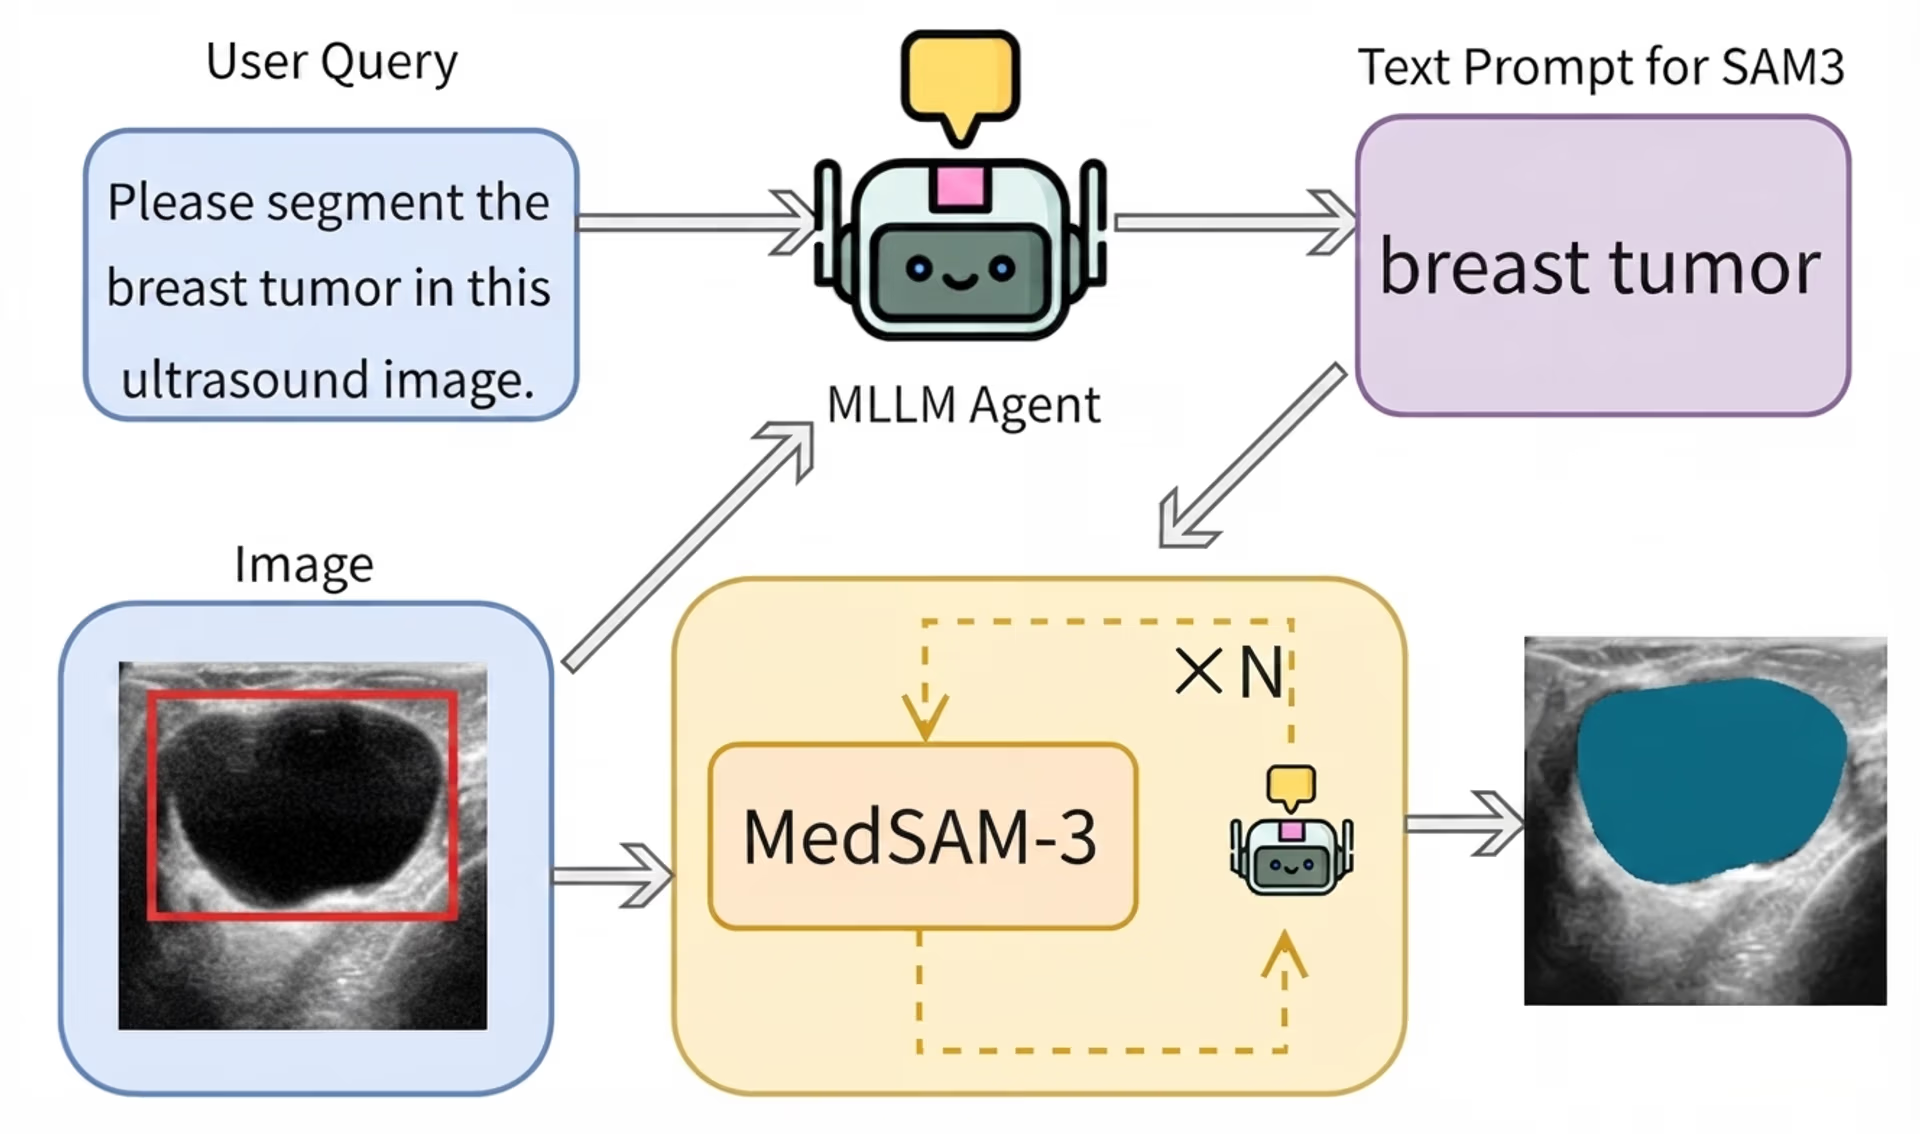
Fig. 3. Pipeline MedSAM-3 pour la segmentation de tumeurs dans des images médicales à partir d’une invite textuelle (Source)
MedSAM-3 donne de bons résultats sur les radiographies, les IRM, les scanners, les échographies et les données vidéo, ce qui montre comment PCS peut rendre les flux de travail d’imagerie médicale plus flexibles et plus efficaces dans les établissements de santé.
Segmentation adaptative pour la chirurgie robotique et l’automatisation#
La chirurgie robotique s’appuie sur des systèmes de vision pour suivre les instruments et comprendre des scènes chirurgicales en évolution rapide. Les instruments se déplacent vite, l’éclairage varie et de nouveaux outils peuvent apparaître à tout moment, ce qui complique la maintenance des systèmes d’étiquettes prédéfinis.
Avec PCS, les robots peuvent suivre les instruments, guider les caméras et suivre les étapes d’une intervention en temps réel. Cela réduit les annotations manuelles et facilite l’adaptation des systèmes à différentes procédures. Les chirurgiens ou les systèmes automatisés peuvent utiliser des invites textuelles telles que « pince », « scalpel » ou « instrument caméra » pour indiquer ce qui doit être segmenté dans une image.
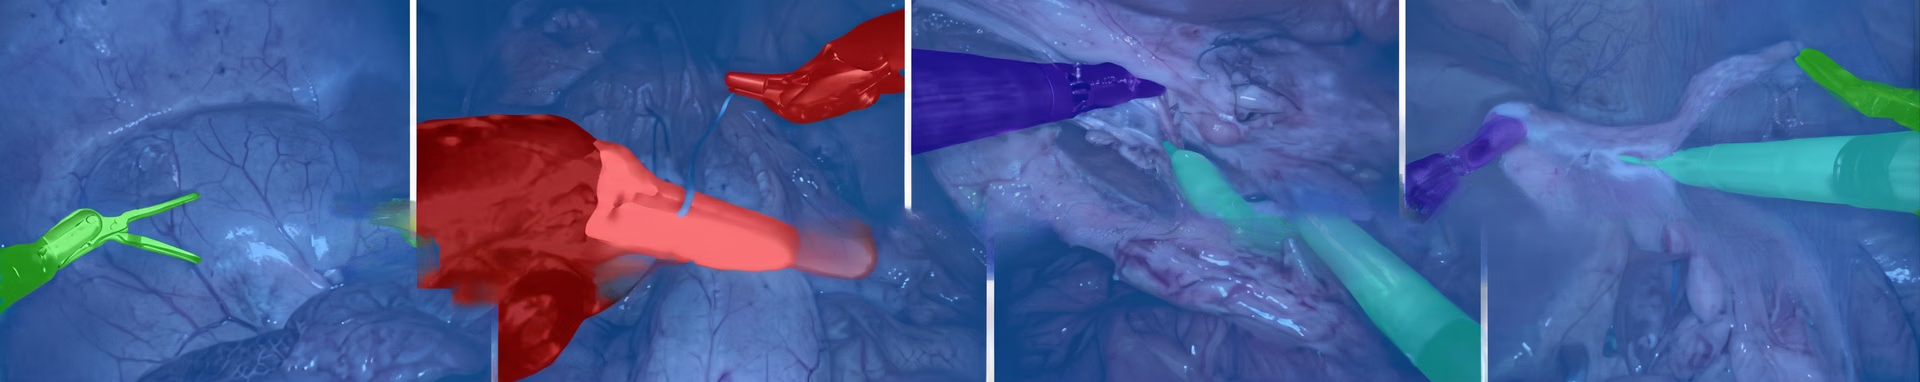
Fig. 4. Segmentation d’instruments chirurgicaux utilisés lors d’une chirurgie robotique (Source)
Segmentation en vocabulaire ouvert avec Ultralytics YOLOE-26#
Un autre modèle de pointe intéressant lié à la segmentation de concepts guidée par des invites est Ultralytics YOLOE-26. Il apporte à la famille de modèles Ultralytics YOLO la segmentation guidée par des invites avec un vocabulaire ouvert.
YOLOE-26 repose sur l’architecture Ultralytics YOLO26 et prend en charge la segmentation d’instances en vocabulaire ouvert. YOLOE-26 permet de guider la segmentation de plusieurs façons.
Il prend en charge les invites textuelles, qui permettent de désigner l’objet cible à l’aide de courtes descriptions ancrées dans le visuel, ainsi que les invites visuelles, qui apportent des indications supplémentaires à partir d’indices présents dans l’image. De plus, YOLOE-26 propose un mode sans invite pour l’inférence zero-shot, dans lequel le modèle détecte et segmente les objets à partir d’un vocabulaire intégré, sans nécessiter d’invites de l’utilisateur.
YOLOE-26 convient parfaitement à des applications comme l’analyse vidéo, la perception robotique et les systèmes en périphérie, où les catégories d’objets peuvent changer, mais où une faible latence et un débit fiable restent essentiels. Il est aussi particulièrement utile pour l’étiquetage des données et la curation de jeux de données, car il simplifie les flux de travail en automatisant une partie du processus d’annotation.
Avantages et inconvénients de la segmentation de concepts guidée par des invites#
Voici quelques-uns des principaux avantages de la segmentation de concepts guidée par des invites :
- Itération et prototypage plus rapides : tu peux tester rapidement de nouvelles tâches de segmentation en modifiant les invites, plutôt qu’en recréant des jeux de données ou en réentraînant les modèles, ce qui accélère l’expérimentation et le développement.
- Adaptabilité entre domaines : le même modèle PCS peut souvent être appliqué à différents domaines, comme l’imagerie médicale, la robotique ou l’analyse vidéo, avec un minimum de modifications du flux de travail.
- Affinage interactif : tu peux modifier les invites de manière itérative ou ajouter des indications pour améliorer les résultats, ce qui facilite le traitement des scènes ambiguës ou des cas limites sans réentraînement.
PCS présente des avantages évidents, mais voici quelques limites à prendre en compte :
- Sensibilité aux invites : de petites différences dans la formulation ou la présentation d’une invite peuvent influer sur le résultat. Des invites trop vagues ou trop précises peuvent produire une segmentation incomplète ou incorrecte.
- Comportement moins prévisible : comme le modèle interprète les invites au lieu de choisir parmi des étiquettes fixes, les résultats peuvent varier davantage selon les scènes et les entrées, ce qui peut poser problème dans des pipelines très contrôlés.
- Interprétation ambiguë des concepts : certains concepts sont subjectifs ou mal définis, ce qui peut entraîner des résultats de segmentation incohérents entre les utilisateurs ou d’une image à l’autre.
- Fiabilité limitée pour les cibles très spécifiques : les modèles guidés par des invites sont généralement moins fiables pour les tâches étroitement définies et propres à chaque instance, comme la détection de défauts, qui exige une identification précise et cohérente de caractéristiques subtiles.
Choisir entre la segmentation guidée par des invites et la segmentation traditionnelle#
En explorant la segmentation guidée par des invites, tu peux te demander quelles applications lui conviennent le mieux et dans quels cas un modèle de vision par ordinateur traditionnel comme Ultralytics YOLO26 répond mieux au problème que tu cherches à résoudre. La segmentation guidée par des invites fonctionne bien pour les objets courants, mais elle ne convient pas aux cas d’usage qui exigent des résultats très précis et cohérents.
La détection de défauts en est un bon exemple. Dans le secteur manufacturier, les défauts sont souvent minuscules et discrets : petites rayures, bosses, défauts d’alignement ou irrégularités de surface. Ils peuvent aussi varier considérablement selon les matériaux, l’éclairage et les conditions de production.
Il est difficile de décrire ces problèmes avec une simple invite, et encore plus difficile pour un modèle généraliste de les détecter de façon fiable. Dans l’ensemble, les modèles guidés par des invites ont tendance à manquer les défauts ou à produire des résultats instables, tandis que les modèles entraînés spécifiquement sur des données de défauts sont beaucoup plus fiables pour les systèmes d’inspection en conditions réelles.
Points clés à retenir#
La segmentation de concepts guidée par des invites facilite l’adaptation des systèmes de vision au monde réel, où de nouveaux objets et de nouvelles idées apparaissent constamment. Au lieu d’être limités à des étiquettes fixes, les utilisateurs peuvent simplement décrire ce qu’ils veulent segmenter et laisser le modèle s’en charger, ce qui fait gagner du temps et réduit le travail manuel. Malgré ses limites, PCS transforme déjà la façon dont la segmentation est utilisée en pratique et devrait devenir un élément central des futurs systèmes de vision.
Pour en savoir plus sur l’IA, consulte notre dépôt GitHub et rejoins notre communauté. Consulte nos pages de solutions pour découvrir l’IA en robotique et la vision par ordinateur dans le secteur manufacturier. Découvre nos options de licence pour te lancer dès aujourd’hui dans l’IA visuelle !
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









