Esportazione di Ultralytics YOLO con LiteRT
Scopri come la nuova integrazione di esportazione LiteRT porta l'inferenza Ultralytics YOLO su dispositivi mobili, sistemi embedded, ambienti edge e browser in un formato unificato.
Noi di Ultralytics stiamo assistendo a un crescente passaggio all'esecuzione dei modelli di computer vision direttamente sui dispositivi su cui servono, anziché fare affidamento su una connessione al cloud. Le app mobile, i sistemi embedded, i sensori IoT e gli strumenti basati su browser hanno sempre più bisogno di eseguire inferenze localmente, spesso su hardware con risorse di calcolo ed energia limitate.Ecco perché siamo entusiasti di annunciare che ora puoi esportare i modelli Ultralytics YOLO direttamente in LiteRT.
Per rispondere a questa esigenza serve un formato di modello compatibile con tutti questi ambienti, senza costringere gli sviluppatori a mantenere pipeline di esportazione separate per ciascuno.
Questa funzionalità era già disponibile tramite un pacchetto di terze parti non ufficiale, ma questa nuova integrazione è il risultato di una collaborazione ufficiale con Google. Abbiamo lavorato a stretto contatto con il team di LiteRT per creare una pipeline end-to-end che esporta i modelli Ultralytics YOLO in TFLite tramite LiteRT. Grazie a questa integrazione, un singolo modello Ultralytics YOLO esportato può essere distribuito in ambienti mobile, embedded, edge e browser, riunendo in un unico formato semplificato le funzionalità che i precedenti formati di esportazione TFLite e TF.js gestivano separatamente.
Che cos'è LiteRT?#
LiteRT (abbreviazione di Lite Runtime) è il runtime ad alte prestazioni di Google per l'IA on-device. È la nuova generazione e il nuovo nome di TensorFlow Lite (TFLite) ed esegue lo stesso formato di modello .tflite che gli sviluppatori già conoscono.
LiteRT è un framework open source progettato specificamente per l'inferenza on-device, nota anche come edge computing. Offre agli sviluppatori gli strumenti per eseguire modelli addestrati su dispositivi mobile, embedded e IoT, sui computer tradizionali e, tramite LiteRT.js, direttamente nei browser web e in Node.js. Il formato di esportazione LiteRT ottimizza i modelli per attività come il rilevamento di oggetti, la segmentazione, la stima della posa e la classificazione, così da eseguirli rapidamente e offline su un'ampia gamma di dispositivi.
Perché esportare i modelli Ultralytics YOLO in LiteRT?#
Ora un unico formato di modello copre tutti i target di deployment:
• Mobile ed embedded. Android, iOS, desktop, Linux embedded e microcontrollori (MCU).
• Acceleratori edge. Compatibile con Coral Edge TPU per un'ulteriore accelerazione.
• Browser e Node.js. LiteRT.js esegue lo stesso modello .tflite sul web con accelerazione WebGPU/WASM, eliminando la necessità di un'esportazione separata in TensorFlow.js.
• Desktop
Questa unificazione è importante perché elimina una reale fonte di attrito nei deployment in produzione. Invece di mantenere una pipeline di esportazione per il mobile, un'altra per il browser e una terza per gli acceleratori edge, ora i team possono esportare una sola volta e distribuire ovunque sia disponibile LiteRT.
Caratteristiche principali dei modelli LiteRT#
• Ottimizzazione on-device. Riduce la latenza elaborando i dati localmente, migliora la privacy evitando la trasmissione di dati personali e riduce al minimo le dimensioni del modello per risparmiare spazio.
• Supporto per più piattaforme. Funziona su Android, iOS, Linux embedded, microcontrollori e browser web moderni.
• Accelerazione hardware. Sfrutta XNNPACK su CPU e l'accelerazione GPU tramite OpenCL, Metal e WebGPU. Per una velocità ancora maggiore, l'accelerazione GPU usa FP16 per impostazione predefinita.
• Quantizzazione. Supporta FP32, INT8 statico, attivazioni INT16 statiche e INT8 dinamico per comprimere i modelli e accelerare l'inferenza con una perdita minima di accuratezza.
• Supporto per diversi linguaggi. Compatibile con Java/Kotlin, Swift, Objective-C, C++, Python e JavaScript.
Inizia a esportare con LiteRT#
Il pacchetto Python Ultralytics e la piattaforma Ultralytics offrono un ambiente completo e unificato per addestrare, valutare e distribuire modelli YOLO per tutte e cinque le attività di computer vision. Il formato di esportazione LiteRT supporta le modalità Esportazione, Predizione e Convalida, così puoi esportare un modello e usarlo subito per l'inferenza o per convalidarne localmente l'accuratezza.
Per esportare un modello basta un solo comando:
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello nel formato LiteRT
model.export(format="litert") # crea 'yolo26n.tflite'
Per i team che distribuiscono modelli su hardware con risorse limitate, LiteRT supporta anche l'esportazione quantizzata, che consente di comprimere i modelli e accelerare l'inferenza con una perdita minima di accuratezza:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# INT8 dinamico: pesi int8, attivazioni FP32 - non servono dati di calibrazione
model.export(format="litert", quantize="w8a32")

# INT8 statico: pesi int8 + attivazioni int8 - servono dati di calibrazione
model.export(format="litert", quantize=8, data="coco8.yaml")
Una volta esportato, puoi caricare il modello ed eseguire direttamente l'inferenza:
from ultralytics import YOLO

# Carica il modello LiteRT esportato
model = YOLO("yolo26n.tflite")

# Esegui l'inferenza
results = model("https://ultralytics.com/images/bus.jpg")
L'esportazione LiteRT è attualmente supportata su Linux x86_64 e macOS. Il modello .tflite esportato può essere eseguito su tutte le piattaforme supportate da LiteRT, incluse quelle mobile, embedded ed edge, oltre al browser.
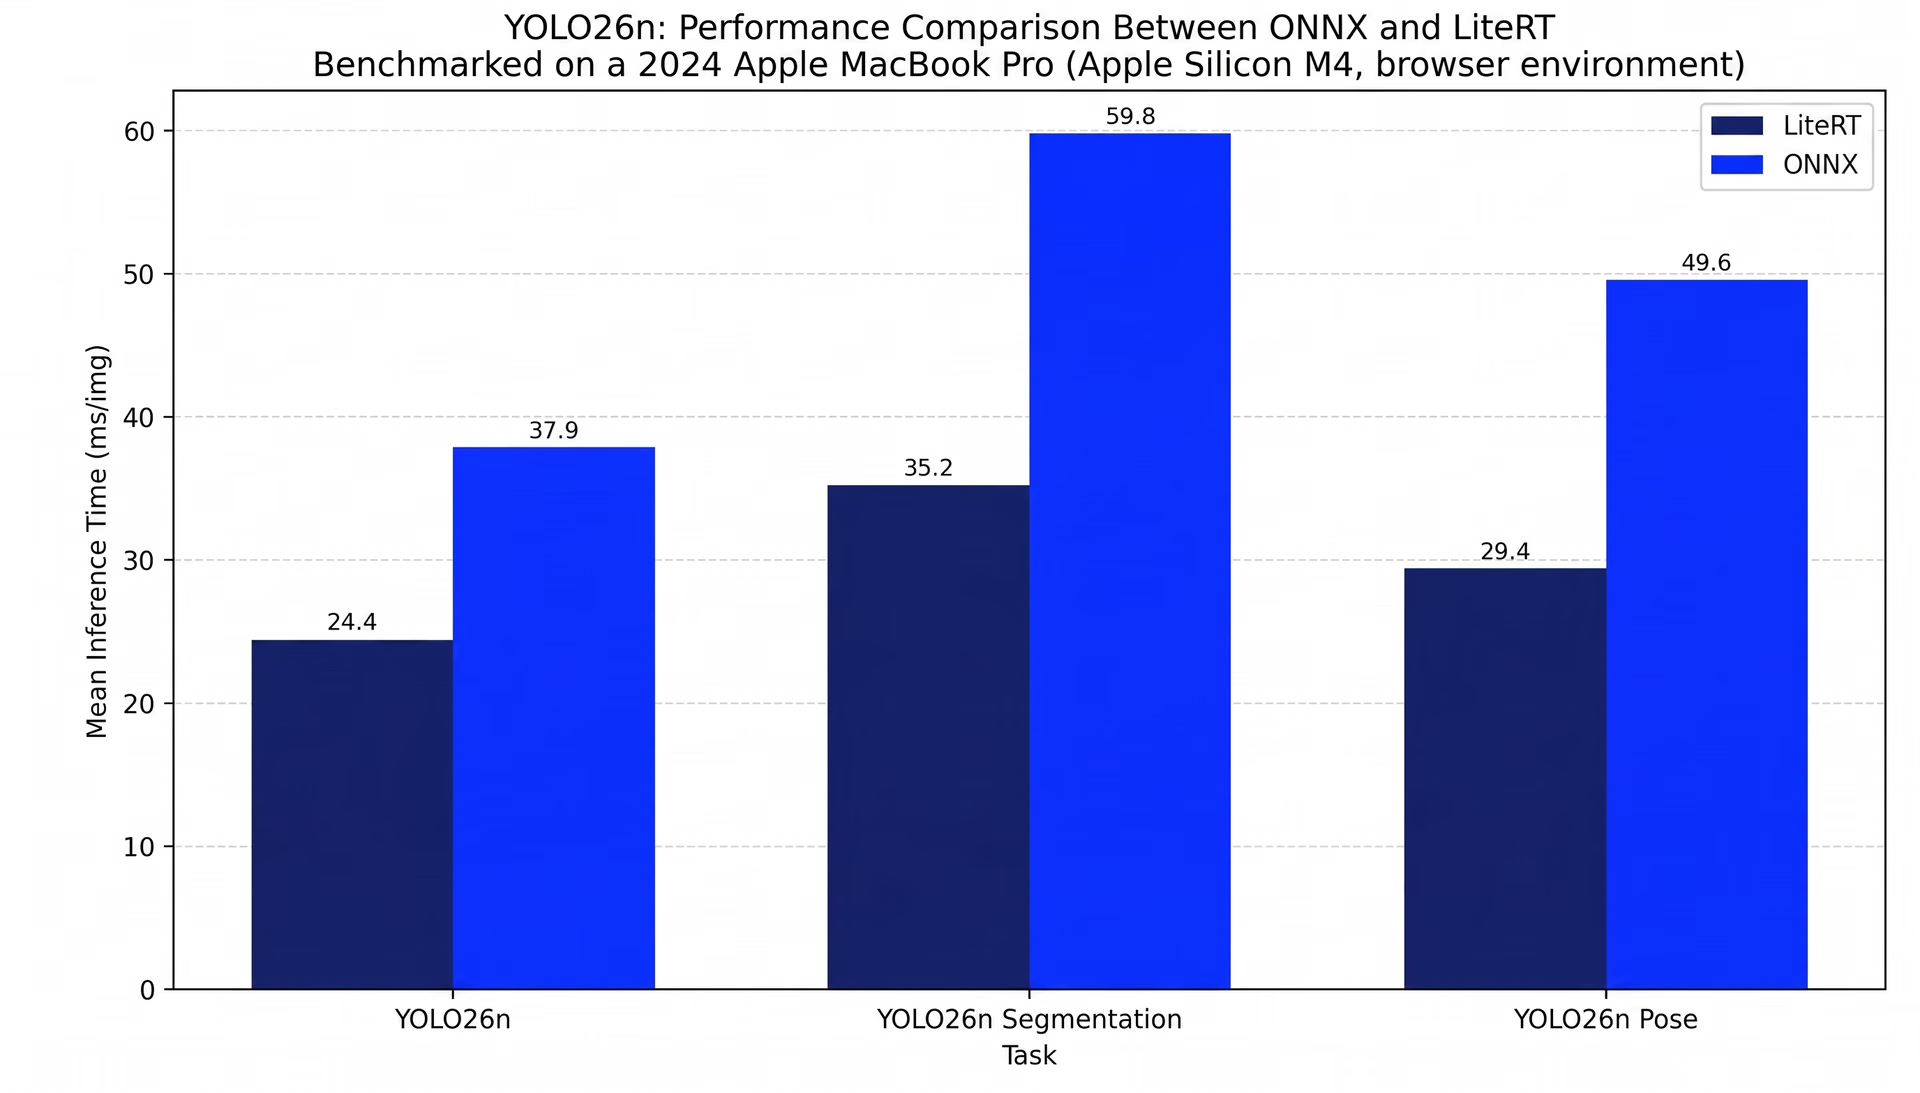 Fig. 1. Confronto delle prestazioni tra ONNX e LiteRT.
L'immagine qui sopra confronta il tempo medio di inferenza per il rilevamento, la segmentazione e la stima della posa su YOLO26n, eseguito nel browser tramite @ultralytics/yolo, il pacchetto npm di Ultralytics per l'inferenza lato client su WebGPU/WASM tramite ONNX Runtime Web. Benchmark eseguito su un Apple MacBook Pro del 2024 (Apple Silicon M4) in un ambiente browser controllato.
Portare Ultralytics YOLO sui dispositivi edge#
Con LiteRT, distribuire i modelli Ultralytics YOLO in ambienti mobile, embedded, edge e browser non richiede più pipeline di esportazione separate per ogni target. Una sola esportazione, un unico formato di modello e un percorso coerente dall'addestramento alla produzione, ovunque debba avvenire l'inferenza.
Ti interessa l'IA per la visione? Scopri le nostre opzioni di licenza per integrare la computer vision nei tuoi progetti. Visita il nostro repository GitHub per esplorare tutte le integrazioni di esportazione Ultralytics e dai un'occhiata alla piattaforma Ultralytics per iniziare a creare i tuoi flussi di lavoro end-to-end per l'IA visiva.









