最良の物体検出モデル
Ultralytics YOLOからRT-DETRまで、2026年の最良の物体検出モデルを取り上げ、アーキテクチャ、性能上のトレードオフ、デプロイメント要因を比較します。
今年初め、AIと機械学習の先駆者であるAndrew Ng氏が、エージェント型物体検出という概念を提唱しました。このアプローチでは、膨大な学習データを必要とせず、テキストプロンプトに基づいて推論エージェントが物体を検出します。
大規模なラベル付きデータセットを必要とせずに画像や動画内の物体を識別できることは、よりスマートで柔軟なコンピュータービジョンシステムに向けた一歩です。ただし、エージェント型ビジョンAIはまだ初期段階にあります。
画像内の人物や道路標識の検出など、一般的なタスクには対応できますが、より精密なコンピュータービジョンアプリケーションでは、依然として従来の物体検出モデルが使用されています。これらのモデルは、大規模で丁寧にラベル付けされたデータセットを使って学習し、何を探すべきか、物体がどこにあるかを正確に学習します。
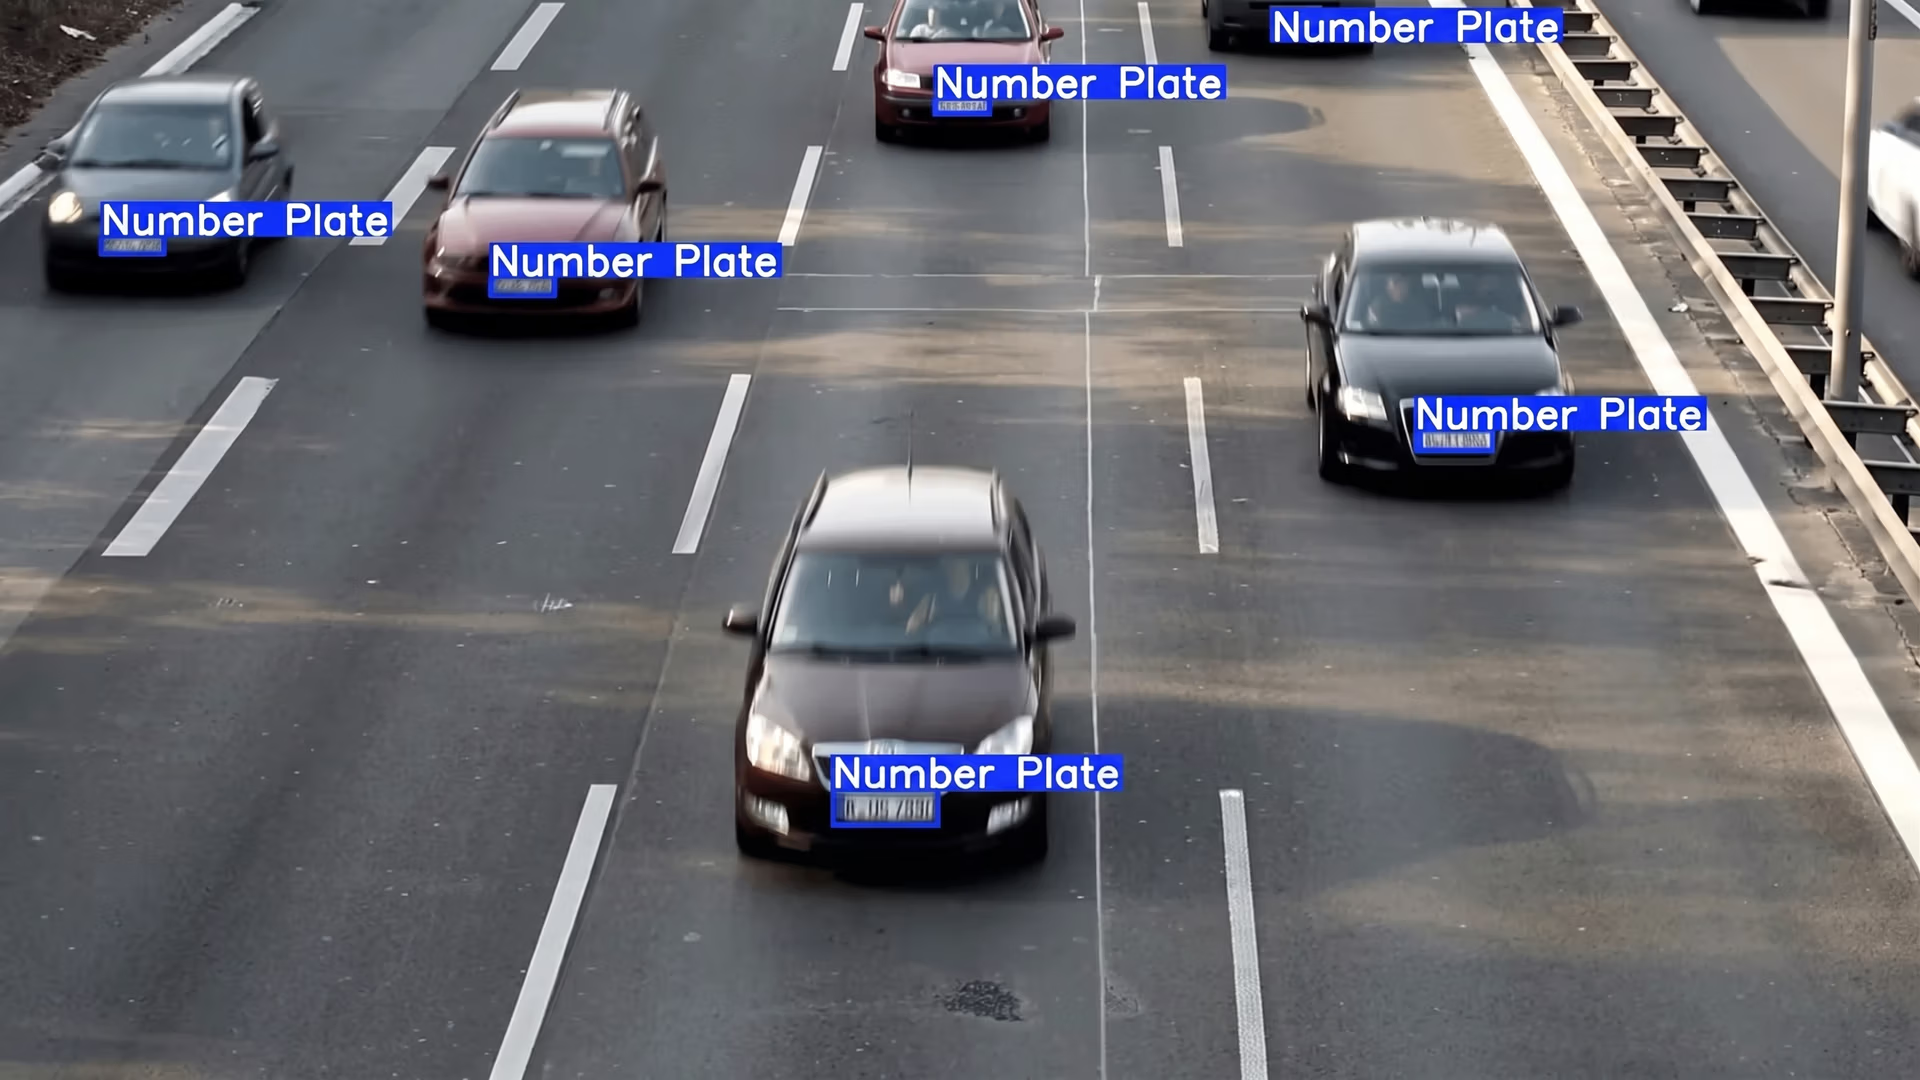
図1. 物体検出の例です(出典)。
従来の物体検出が不可欠なのは、物体が何であるかを識別する認識と、画像内の正確な位置を特定するローカライゼーションの両方を提供するためです。この組み合わせにより、自動運転車から産業オートメーション、医療診断まで、機械は複雑な現実世界のタスクを確実に実行できます。
技術の進歩により、物体検出モデルは継続的に改善され、より高速かつ高精度になり、現実世界の環境に適したものになっています。この記事では、現在利用できる最高の物体検出モデルをいくつか紹介します。さっそく始めましょう。
物体検出の必要性#
画像分類などのコンピュータービジョンタスクを使うと、画像に車、人、その他の物体が含まれているかどうかを判定できます。しかし、画像内の物体がどこにあるかまでは特定できません。
ここで物体検出が役立ちます。物体検出モデルは、存在する物体を識別するだけでなく、その正確な位置も特定できます。このローカライゼーションと呼ばれる処理により、機械はシーンをより正確に理解し、自動運転車を停止させたり、ロボットアームを誘導したり、医用画像内の領域を強調表示したりするなど、適切に対応できます。
ディープラーニングの発展は、物体検出を大きく変革しました。現代のモデルは、手作業でコード化されたルールに依存するのではなく、アノテーションと視覚データから直接パターンを学習します。これらのデータセットによって、モデルは物体の外観、通常現れる場所、小さな物体や複雑なシーン、さまざまな照明条件などの課題への対処方法を学習します。
実際、最先端の物体検出システムは、複数の物体を同時に高精度で検出できます。そのため、物体検出は自動運転、ロボティクス、医療、産業オートメーションなどのアプリケーションで重要な技術となっています。
物体検出タスクの仕組み#
物体検出モデルへの入力は画像であり、カメラ、ビデオフレーム、さらには医療スキャンから取得できます。入力画像はニューラルネットワーク、通常は畳み込みニューラルネットワーク(CNN)を通じて処理されます。このネットワークは、視覚データ内のパターンを認識するように学習されています。
ネットワーク内部では、画像が段階的に分析されます。モデルは検出した特徴に基づいて、どの物体が存在し、どこに現れているかを予測します。
これらの予測は、検出された各物体の周囲に描かれる長方形であるバウンディングボックスを使って表現されます。各バウンディングボックスについて、モデルはクラスラベル(例:車、人、犬)と、予測への確信度を示す信頼度スコアを割り当てます(これは確率と考えることもできます)。
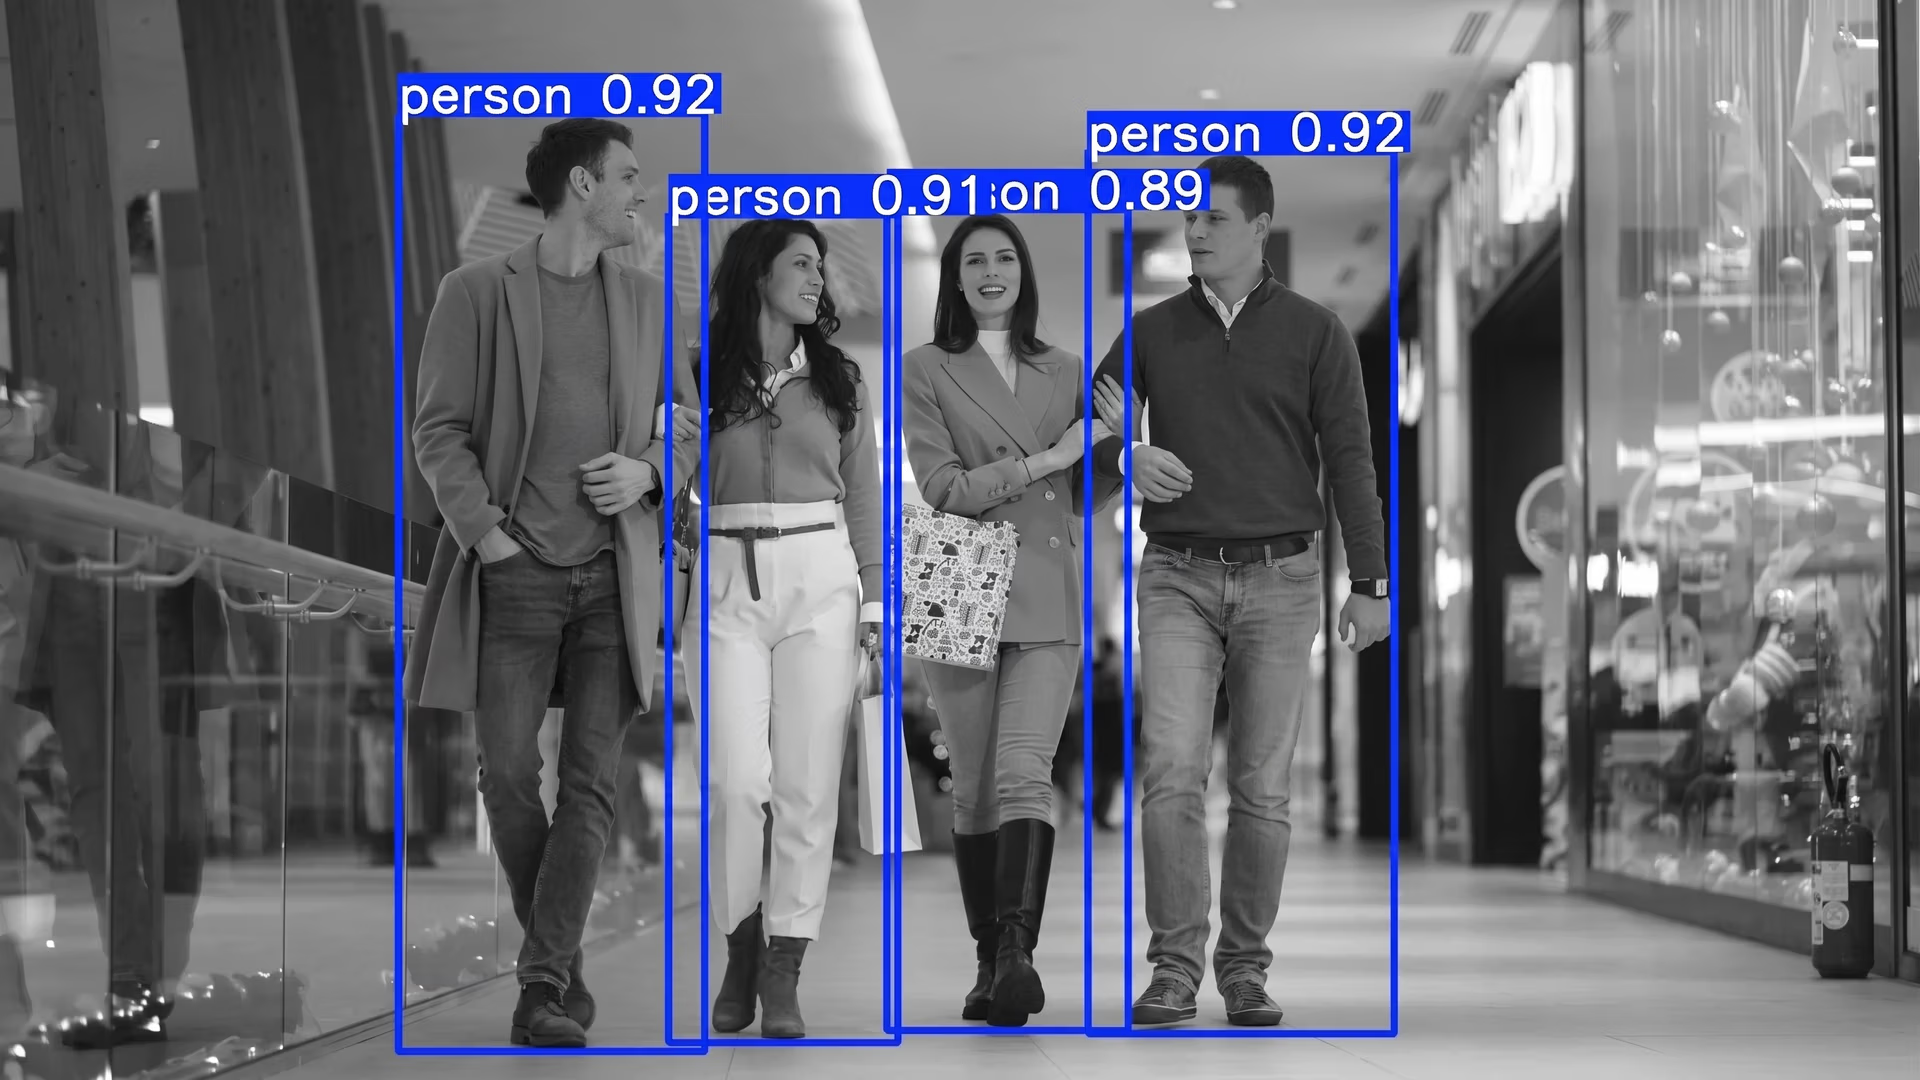
図2. 物体検出の予測は、バウンディングボックスを使って可視化できます。
全体の処理は、特徴抽出に大きく依存しています。モデルは、エッジ、形状、テクスチャ、その他の識別に役立つ特徴など、有用な視覚パターンを識別するように学習します。これらのパターンは特徴マップにエンコードされ、ネットワークが複数の詳細レベルで画像を理解するのに役立ちます。
物体の検出:2段階方式と1段階方式#
モデルアーキテクチャに応じて、物体検出器は物体を特定するために異なる戦略を使用し、速度、精度、複雑さのバランスを取ります。
多くの物体検出モデル、特にFaster R-CNNのような2段階検出器は、関心領域(ROIs)と呼ばれる画像内の特定部分に焦点を当てます。これらの領域に集中することで、モデルはすべてのピクセルを均等に分析するのではなく、物体を含む可能性が高い領域を優先します。
一方、初期のYOLOモデルのような1段階モデルは、2段階モデルのように特定のROIsを選択しません。代わりに、画像をグリッドに分割し、アンカーボックスと呼ばれる事前定義ボックスと特徴マップを使って、画像全体の物体を1回のパスで予測します。
現在、最先端の物体検出モデルでは、アンカーフリーのアプローチが検討されています。事前定義されたアンカーボックスに依存する従来の1段階モデルとは異なり、アンカーフリーモデルは特徴マップから物体の位置とサイズを直接予測します。これにより、アーキテクチャを簡素化し、計算オーバーヘッドを削減し、特に形状やサイズが異なる物体の検出性能を向上させることができます。
最高の物体検出モデルを紹介#
現在、多くの物体検出モデルが存在し、それぞれ特定の目的に合わせて設計されています。リアルタイム性能に最適化されたモデルもあれば、最高精度の達成に重点を置くモデルもあります。コンピュータービジョンソリューションに適したモデルの選択は、多くの場合、具体的なユースケースと性能要件によって決まります。
次に、2026年の最高の物体検出モデルをいくつか見ていきましょう。
1. Ultralytics YOLOモデル#
現在最も広く使用されている物体検出モデルのファミリーの1つが、Ultralytics YOLOモデルファミリーです。YOLOはYou Only Look Onceの略で、優れた検出性能を提供しながら、高速で信頼性が高く、扱いやすいため、さまざまな業界で人気があります。
Ultralytics YOLOファミリーには、Ultralytics YOLOv5、Ultralytics YOLOv8、Ultralytics YOLO11、近日公開予定のUltralytics YOLO26が含まれており、さまざまな性能要件やユースケースに対応する選択肢を提供します。軽量設計と速度最適化により、Ultralytics YOLOモデルはリアルタイム検出に最適で、コンピューティング性能やメモリが限られたエッジデバイスにもデプロイできます。
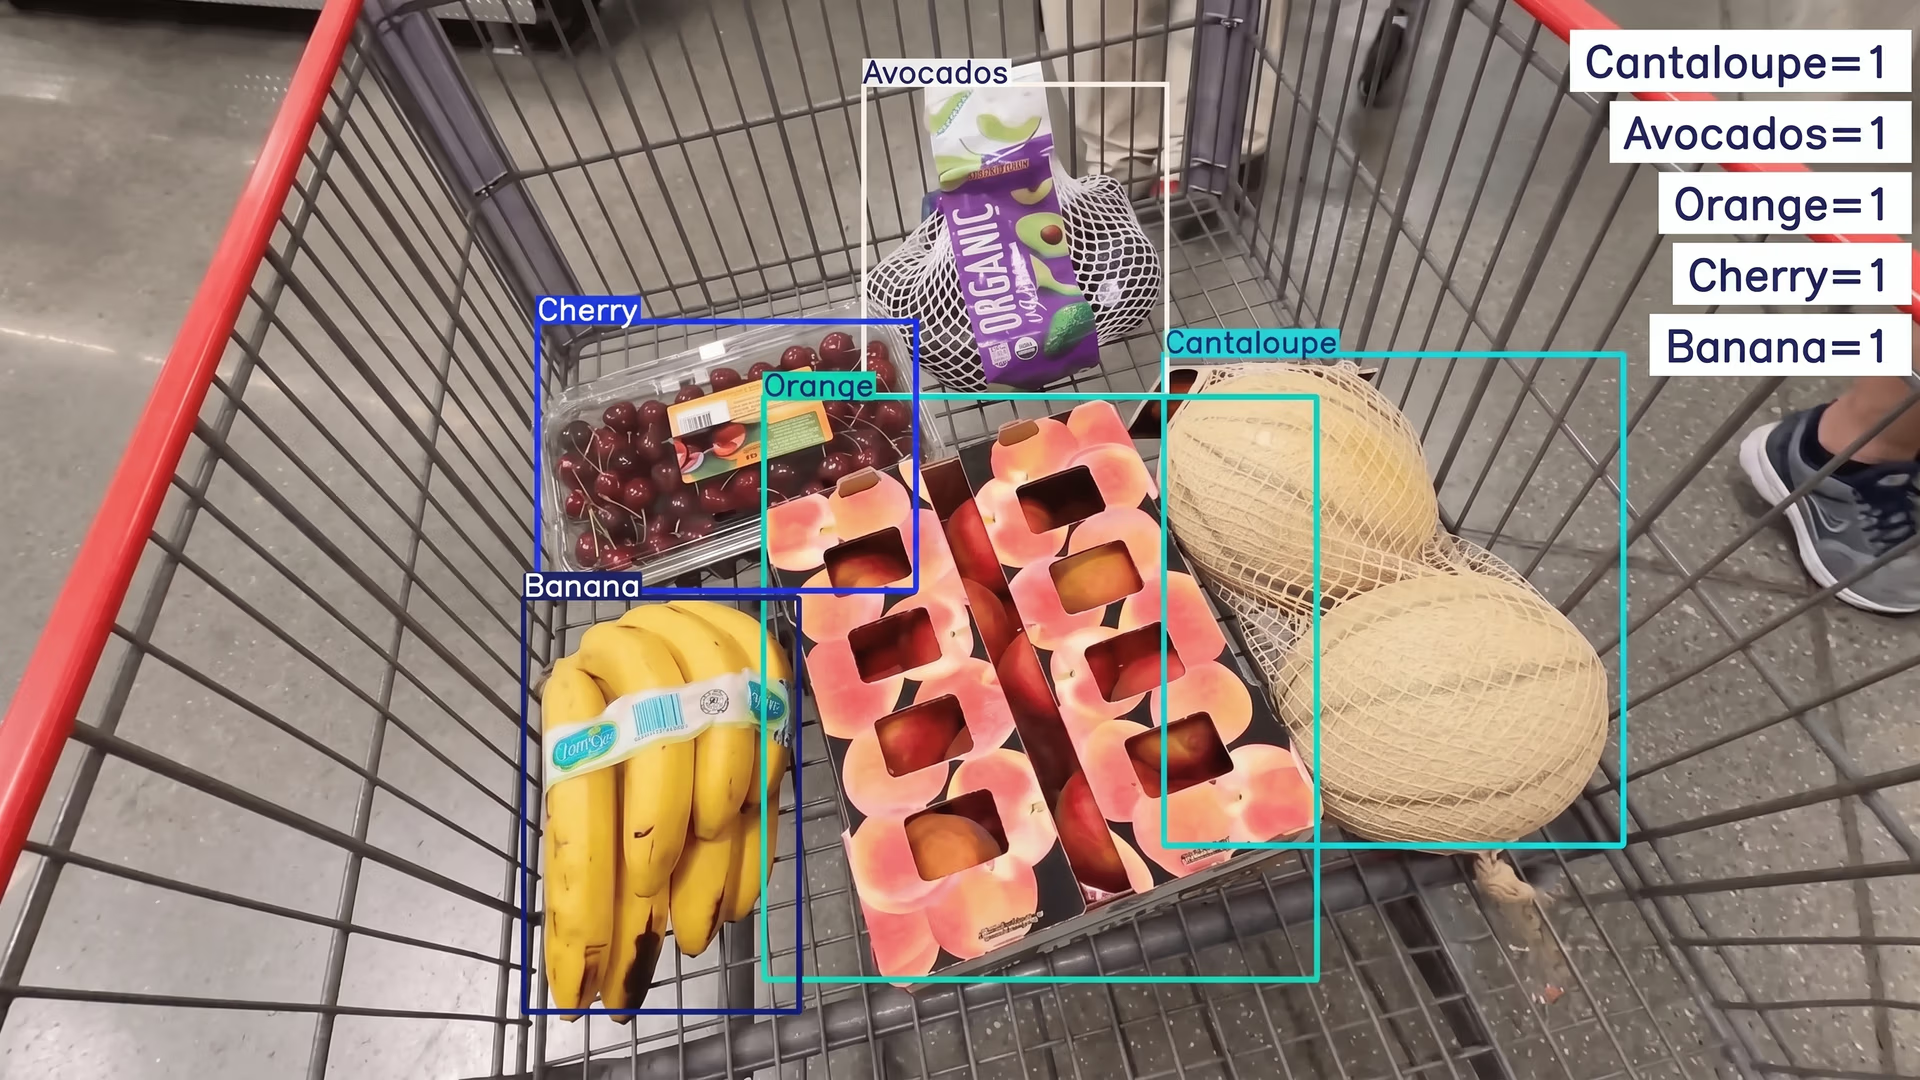
図3. 物体検出にUltralytics YOLO11を使用(出典)
基本的な物体検出にとどまらず、これらのモデルは非常に柔軟です。物体の輪郭をピクセルレベルで描出するインスタンスセグメンテーションや、人や物体上のキーポイントを特定するポーズ推定などのタスクにも対応しています。この柔軟性により、Ultralytics YOLOモデルは、農業や物流から小売、製造まで、幅広いアプリケーションで選ばれる選択肢となっています。
Ultralytics YOLOモデルが人気を集めるもう1つの主な理由は、Ultralytics Pythonパッケージです。これは、モデルの学習、ファインチューニング、デプロイのためのシンプルで使いやすいインターフェースを提供します。開発者は事前学習済みの重みから始め、自分のデータセットに合わせてモデルをカスタマイズし、数行のコードだけでデプロイできます。
2. RT-DETRとRT-DETRv2#
RT-DETR(リアルタイム検出Transformer)と新しいRT-DETRv2は、リアルタイム利用向けに構築された物体検出モデルです。多くの従来モデルとは異なり、非最大抑制(NMS)を使わずに画像を入力し、最終的な検出結果を直接出力できます。
NMSは、モデルが同じ物体を複数回予測した際に、重複する余分なボックスを削除する処理です。NMSを省略することで、検出処理をよりシンプルかつ高速にできます。
これらのモデルはCNNとTransformerを組み合わせています。CNNはエッジや形状などの視覚的な詳細を検出し、Transformerは画像全体を一度に見て、異なる部分同士の関係を理解できるニューラルネットワークの一種です。この包括的な理解により、モデルは互いに近接した物体や重なり合う物体を検出できます。
RT-DETRv2は、大小の物体の検出に役立つマルチスケール検出や、複雑なシーンへの対応強化などの機能により、元のモデルを改良しています。これらの変更により、モデルの速度を維持しながら精度を向上させています。
3. RF-DETR#
RF-DETRは、Transformerアーキテクチャの精度と、現実世界のアプリケーションに必要な速度を組み合わせるように設計された、リアルタイムのTransformerベースモデルです。RT-DETRやRT-DETRv2と同様に、Transformerで画像全体を分析し、CNNでエッジ、形状、テクスチャなどの細かな視覚特徴を抽出します。
このモデルは入力画像から物体を直接予測し、アンカーボックスと非最大抑制を省略することで、検出処理を簡素化し、推論速度を維持します。RF-DETRはインスタンスセグメンテーションにも対応しており、バウンディングボックスの予測に加えて、物体の輪郭をピクセルレベルで描出できます。
4. EfficientDet#
2019年後半にリリースされたEfficientDetは、効率的なスケーリングと高性能を実現するように設計された物体検出モデルです。EfficientDetの特徴は複合スケーリングです。これは、1つの要素だけを調整するのではなく、入力解像度、ネットワークの深さ、ネットワークの幅を同時にスケーリングする手法です。このアプローチにより、高性能タスク向けに拡大する場合でも、軽量デプロイ向けに縮小する場合でも、モデルは安定した精度を維持できます。
EfficientDetのもう1つの主要コンポーネントは、効率的な特徴ピラミッドネットワーク(FPN)です。これにより、モデルは複数のスケールで画像を分析できます。このマルチスケール分析は、サイズの異なる物体を検出するうえで重要であり、同じ画像内の小さな物体と大きな物体の両方をEfficientDetが確実に識別できるようにします。
5. PP-YOLOE+#
2022年にリリースされたPP-YOLOE+は、YOLO形式の物体検出モデルです。つまり、画像を1回通過するだけで物体を検出して分類します。このアプローチにより、高い精度を維持しながら高速な処理を実現し、リアルタイムアプリケーションに適しています。
PP-YOLOE+の主な改良点の1つは、タスク整合型学習です。これにより、モデルの信頼度スコアが物体の位置をどれだけ正確に特定できているかを反映するようになります。これは、小さな物体や重なり合う物体の検出に特に役立ちます。
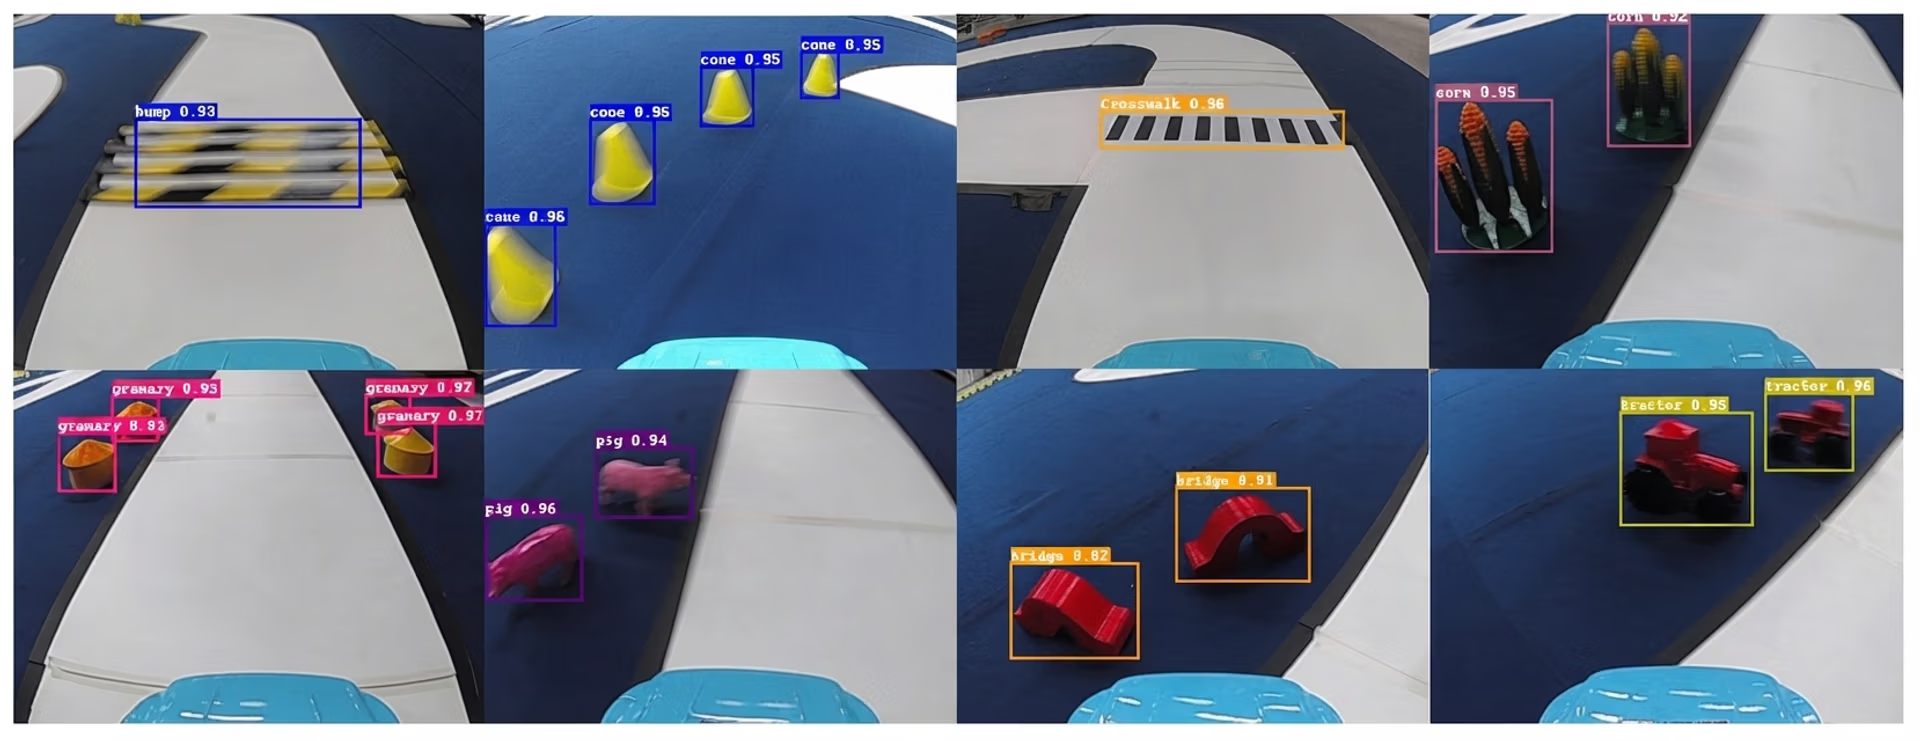
図4. PP-YOLOE+を使った物体検出(出典)
このモデルは、デカップルドヘッドアーキテクチャも使用しています。これは、物体の位置とクラスラベルを予測するタスクを分離するものです。これにより、物体を正しく分類しながら、より正確にバウンディングボックスを描画できます。
6. GroundingDINO#
GroundingDINOは、ビジョンと言語を組み合わせたTransformerベースの物体検出モデルです。固定されたカテゴリーセットに依存するのではなく、自然言語のテキストプロンプトを使って物体を検出できます。
画像から抽出した視覚特徴とテキストの説明を対応付けることで、モデルはその正確なラベルが学習データに含まれていなくても物体を特定できます。つまり、「ヘルメットを着用した人」や「建物の近くにある赤い車」のような説明でモデルにプロンプトを入力すると、該当する物体の周囲に正確なバウンディングボックスを生成します。
さらに、ゼロショット検出に対応することで、GroundingDINOは新しいユースケースごとにモデルを再学習またはファインチューニングする必要性を減らし、幅広いアプリケーションで高い柔軟性を実現します。言語理解と視覚認識のこの組み合わせにより、インタラクティブで適応性の高いAIシステムの新たな可能性が開かれます。
物体検出器の評価に使用される一般的な指標#
さまざまな物体検出モデルを比較する際、実際にどのモデルの性能が最も優れているのかを判断する方法が気になるかもしれません。これは重要な疑問です。モデルアーキテクチャやデータの品質だけでなく、多くの要因が性能に影響する可能性があるためです。
研究者は、モデルを一貫して評価し、結果を比較し、速度と精度のトレードオフを理解するために、共通のベンチマークと標準的な性能指標に頼ることがよくあります。多くの物体検出モデルがCOCOデータセットなど同じデータセットで評価されるため、標準ベンチマークは特に重要です。
検出精度と速度の測定#
ここでは、物体検出モデルの評価に使用される一般的な指標をいくつか詳しく見ていきます。
- Intersection over union(IoU): この指標は、予測されたバウンディングボックスが画像内の実際の物体とどの程度重なっているかを測定します。モデルが描いたボックスと、データセット内でラベル付けされた物体の位置である正解ボックスを比較します。IoUは、2つのボックスの重なり領域を和集合の面積で割って算出します。IoUが高いほど、モデルがより正確にボックスを配置していることを示し、低いほど予測の精度が低いことを意味します。簡単に言えば、IoUはモデルの予測が実際の物体位置とどの程度一致しているかを示します。
- Mean average precision(mAP):物体検出の全体的な性能を評価するために使用される主要な指標です。モデルが正しく検出した物体の数と、さまざまな信頼度レベルおよび物体カテゴリーにおける検出精度の両方を考慮します。
- Frames per second(FPS)とレイテンシ:FPSは、モデルが1秒間に処理できる画像またはビデオフレームの数を示します。たとえば、30 FPSで動作するモデルは、毎秒30フレームを処理できます。FPSが高いほどシステムは迅速に応答できるため、ライブビデオ、交通監視、ロボティクスなどのユースケースで重要です。一方、レイテンシは、画像またはフレームを受信してから結果が準備できるまで、モデルが1つの画像またはフレームを処理するのにかかる時間を測定します。
物体検出アルゴリズムを使用するメリットとデメリット#
現実世界のアプリケーションで物体検出モデルを使用する主なメリットをいくつか紹介します。
- 幅広い業界に適用可能: 物体検出は、交通監視や小売分析から、医療、農業、製造まで、幅広いユースケースに適用できます。
- 手作業を削減: 目視検査や監視タスクを自動化することで、継続的な人による監督の必要性を減らし、チームがより価値の高い業務に集中できるようになります。
- オープンソースエコシステムの恩恵: GitHub上の活発なオープンソースコミュニティとリソースにより、事前学習済みモデルへのアクセス、実験、ソリューションのカスタマイズが容易になります。
これらのメリットがある一方で、物体検出モデルの性能に影響する実際的な制約もあります。考慮すべき重要な要素を以下に示します。
- 高品質なデータ要件: 物体検出モデルは、学習に大規模で適切にアノテーションされたデータセットを必要とします。このデータの作成と維持には時間とコストがかかり、規模の拡大も困難です。
- 計算要件: 高い検出精度を実現するモデルは、学習時とリアルタイムデプロイ時の両方で、大きな処理性能を必要とすることがよくあります。通常は高性能GPUを使用することになり、インフラコストが増加する可能性があります。
- 現実世界の条件への感度: 照明、カメラアングル、天候、混雑したシーンの変化は検出性能に影響する可能性があるため、継続的なテストとチューニングが必要になります。
主なポイント#
コンピュータービジョンプロジェクトに最適な物体検出モデルは、ユースケース、データ構成、性能要件、ハードウェアの制約によって異なります。速度に最適化されたモデルもあれば、精度に重点を置くモデルもあり、現実世界のアプリケーションの多くでは両者のバランスが必要です。オープンソースフレームワークとGitHub上の活発なコミュニティにより、これらのモデルは実用目的でより簡単に評価、適応、デプロイできるようになっています。
詳しくは、GitHubリポジトリをご覧ください。コミュニティに参加し、ソリューションページで医療におけるAIや自動車業界におけるコンピュータービジョンなどのアプリケーションについてお読みください。ライセンスオプションを確認して、今日からビジョンAIを始めましょう。








