コンピュータービジョンプロジェクトで強化学習を活用する
強化学習の仕組みと、倉庫ロボット、自動運転車、手術用ロボットでコンピュータビジョンと組み合わせる方法、さらにそのトレードオフをご紹介します。
 Abirami Vina9 分で読めます
人工知能(AI)を簡潔に説明すると、人間の思考や学習の仕組みを再現することを目指す分野です。AIにおける学習手法という考え方はここから生まれました。学習手法とは、人間と同じように、機械が時間の経過とともに性能を向上させるためのさまざまな方法です。
以前の記事では、教師あり学習、教師なし学習、強化学習、転移学習などの主要なAI学習手法を取り上げ、それぞれがAIモデルによる情報処理と意思決定を支援するうえで重要な役割を果たすことを解説しました。
今日は、強化学習について詳しく見ていきます。強化学習は、環境と相互作用しながら経験を通じてAIシステムに学習させ、フィードバックに基づいて性能を向上させる手法です。特に、機械が周囲の視覚情報を解釈して理解できるようにするシステムである、コンピュータービジョンのアプリケーションに強化学習をどのように適用できるかを解説します。
強化学習とコンピュータービジョンのような概念を組み合わせることで、興味深い新たな可能性が生まれており、活発な研究分野となっています。これにより、AIシステムは見たものを認識し、その視覚情報に基づいて適切な判断を下せるようになります。
強化学習とは何ですか?#
強化学習は機械学習の一分野であり、AIエージェントが行動を起こし、報酬やペナルティの形でフィードバックを受け取ることで学習します。目標は、時間の経過とともに最良の結果につながる行動を見つけることです。
強化学習は、犬のトレーニングにたとえることができます。犬が合図に応じて座ると、おやつを与えます。しばらくすると、犬は座ることでご褒美がもらえると学びます。強化学習では、AIエージェントやモデルが犬の役割を果たし、環境が周囲の世界にあたり、報酬によって正しい行動だったかどうかを理解します。
これは、AIモデルに正解の例を大量に見せる教師あり学習とは異なります。たとえば、犬の写真を見せて「これは犬です」と伝える方法です。
一方、強化学習はラベル付きデータに依存しません。代わりに、さまざまな行動を試して結果から学びます。ゲームをプレイしながら、勝つためにどの動きが役立つかを見つけていくのとよく似ています。
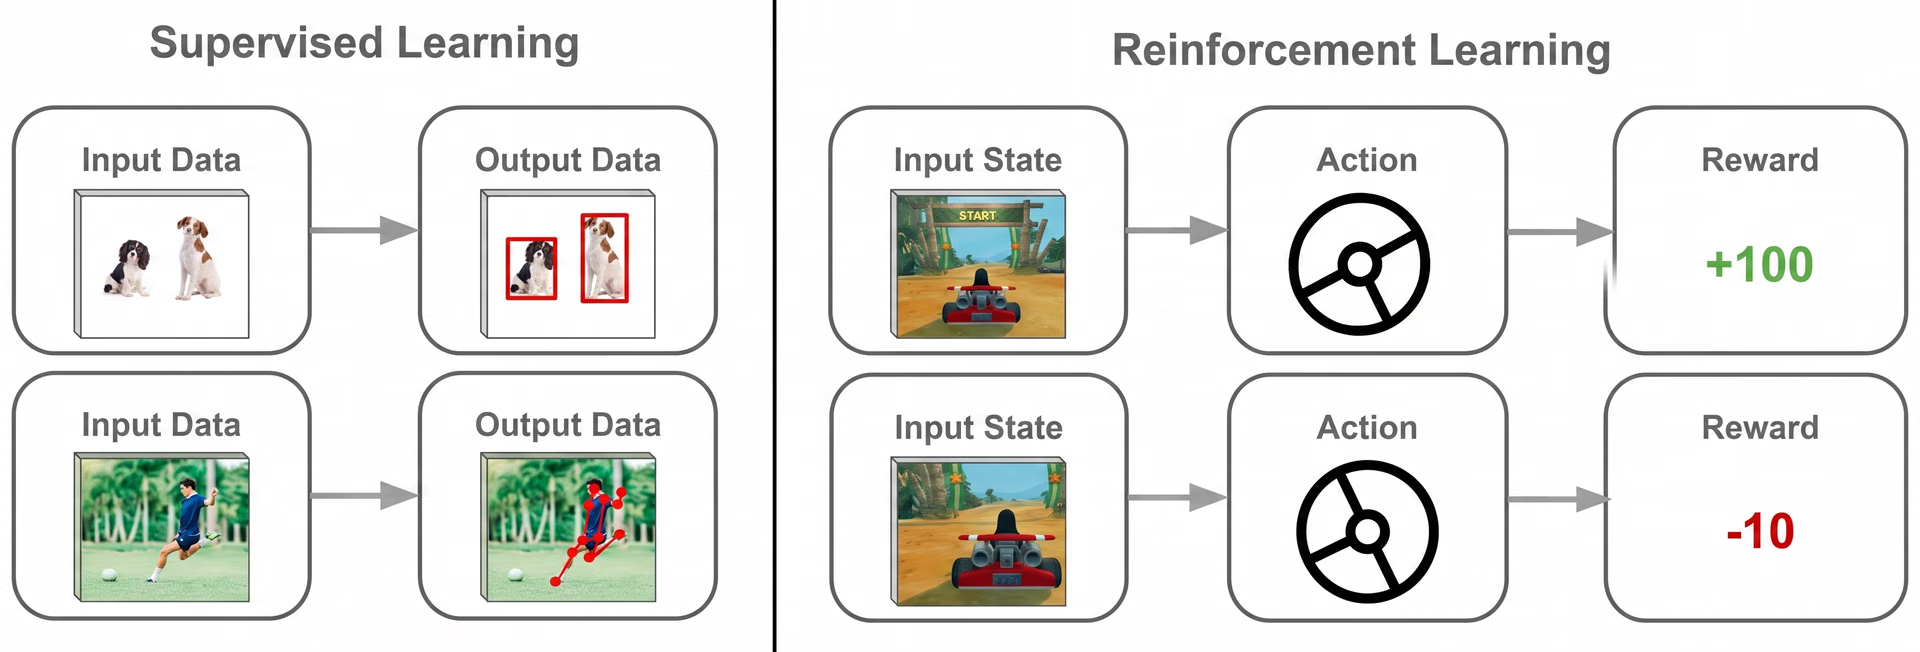
図1。強化学習と教師あり学習の比較。
強化学習は、段階的に意思決定を行い、一つひとつの選択がその後の展開を変えるタスクに欠かせません。この学習手法は、戦略系のビデオゲームで使われ、プレイヤーにとってゲームプレイをより挑戦的で魅力的なものにします。
AIソリューションにおける強化学習の仕組み#
自転車の乗り方を覚える過程を考えてみてください。最初は転ぶかもしれません。しかし、練習を重ねるうちに、バランスを保つ方法がわかってきます。乗る回数が増えるほど、上達します。何をすべきか教えられるだけでなく、実際にやってみることで学ぶのです。
強化学習は、AIでも同様の仕組みで機能します。さまざまな行動を試し、その結果を観察し、時間をかけて適切な選択をする能力を段階的に高めることで、経験から学習します。
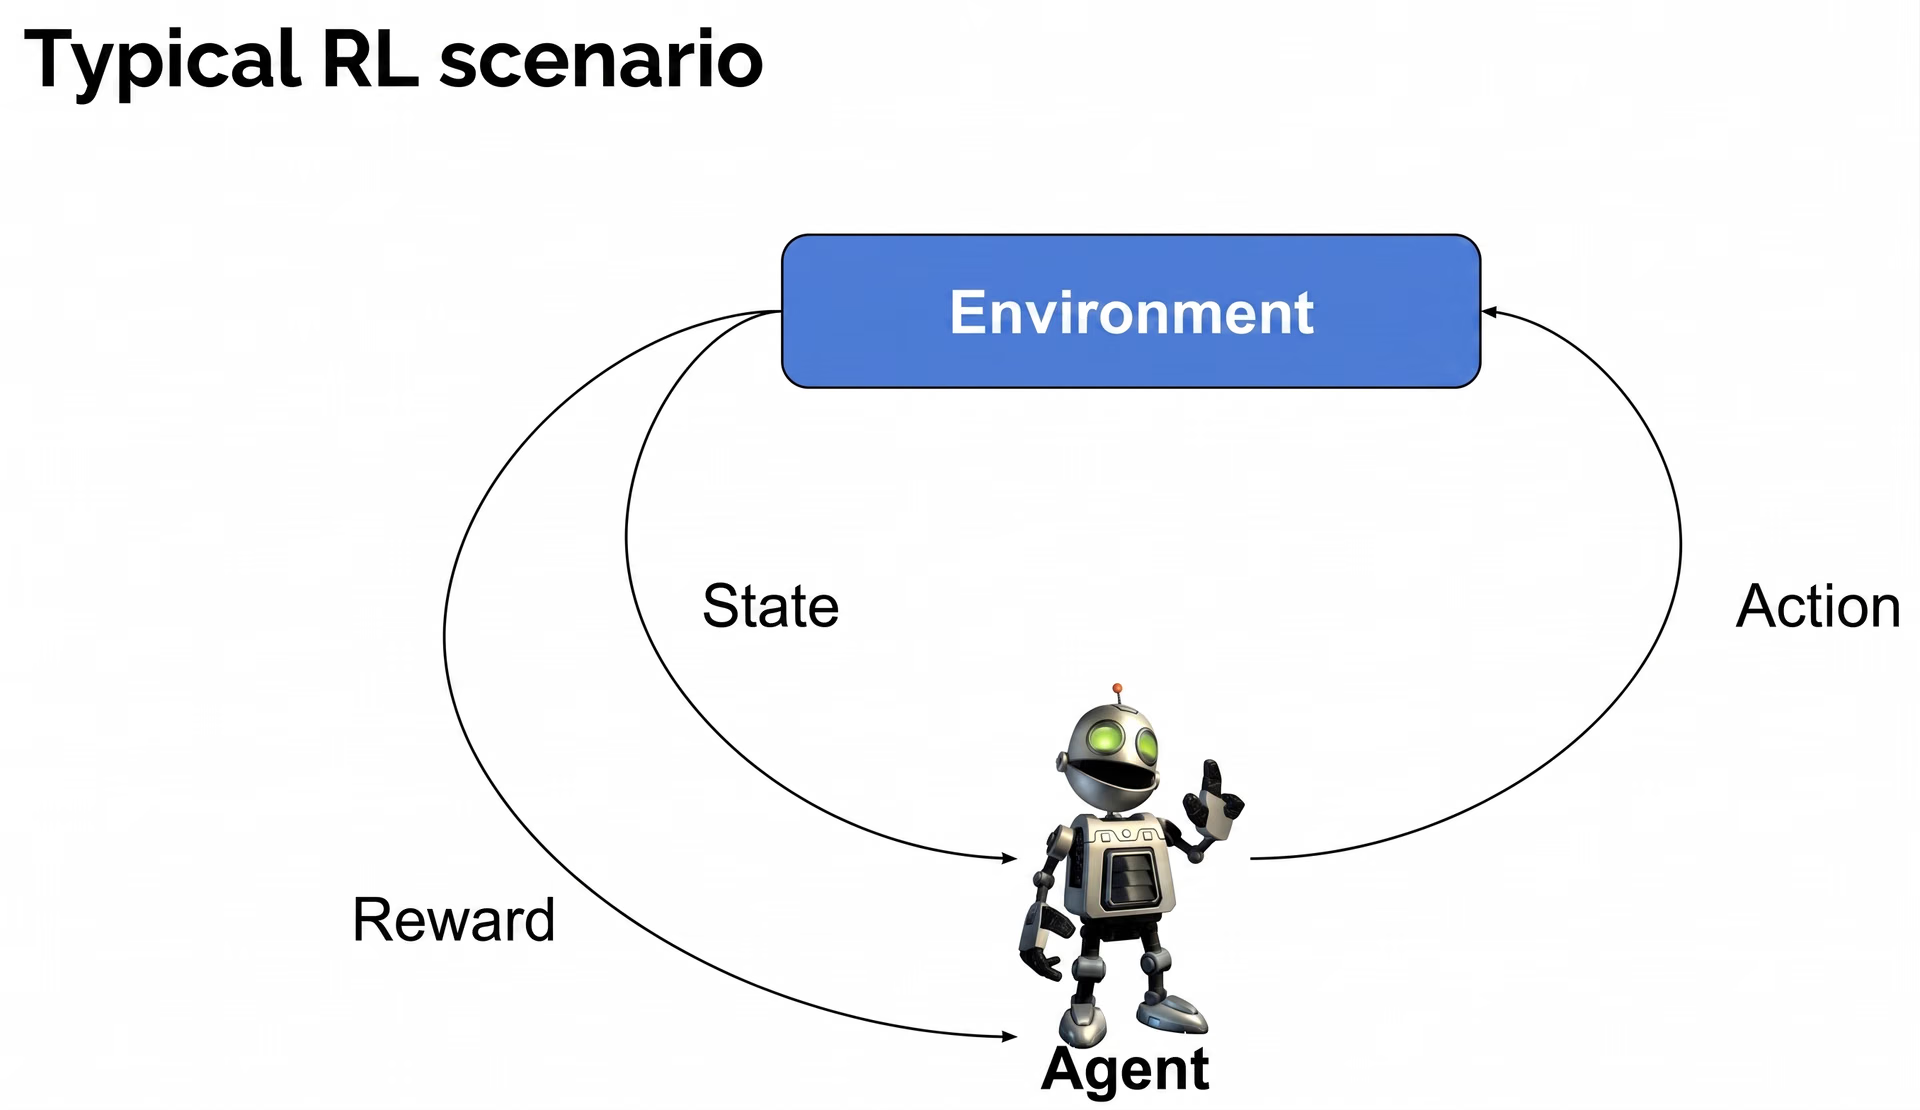
図2。強化学習の仕組みを理解する。
強化学習を構成する主な要素をいくつか見てみましょう。
- エージェント: エージェントは学習者または意思決定者です。行動を取って環境と相互作用し、特定の目標の達成を目指します。
- 環境: 環境には、エージェントが相互作用するすべてのものが含まれます。環境はエージェントの行動に応じて変化し、その結果に基づいてフィードバックを提供します。
- 状態: 状態は、環境の現在の状況を切り取ったものです。エージェントは状態を観察して周囲の状況を把握し、次に取る行動を判断します。
- 行動: 行動とは、環境に影響を与えるエージェントの動きや意思決定です。各行動によって新しい状態が生じ、将来の報酬に影響することがあります。
- 報酬: 報酬とは、エージェントの行動が有益だったかどうかを伝える環境からのフィードバックです。正の報酬は良い行動を繰り返すようエージェントを促し、負の報酬は好ましくない行動を避けるよう促します。
- ポリシー: ポリシーとは、現在の状態に基づいて行動を選択するエージェントの戦略です。エージェントは時間をかけてポリシーを改善し、獲得できる報酬の合計を最大化します。
これらの要素を組み合わせることで、強化学習を使ったAIシステムは、継続的な試行錯誤を通じて効果的な行動を学習できます。試行を重ねるたびに、エージェントはより高い報酬と優れた結果につながる行動を選ぶ能力を高めていきます。
コンピュータービジョンにおける強化学習のイノベーション#
コンピュータービジョンは、画像内の物体検出、画像に何が写っているかの分類、画像の各部分へのセグメンテーションなどのタスクに使われています。Ultralytics YOLO11のようなコンピュータービジョンモデルはこうしたタスクに対応しており、視覚的な知見を収集できる実用的なアプリケーションの構築に活用できます。
しかし、こうしたビジョンAIタスクを強化学習と組み合わせると、見るだけでなく、視覚的なインサイトに基づいて行動する方法も学び、時間とともに性能を高めるAIソリューションが実現します。
コンピュータービジョンのアプリケーションにおける強化学習の興味深い例として、倉庫でのロボットの活用があります。カメラとコンピュータービジョンシステムを搭載したロボットは、周囲を分析し、各商品の位置を検出し、その形状やサイズを識別して、棚の上でどのように置かれているかを把握できます。
ロボットが商品をつかもうとするたびに、正しくつかめた場合は成功、落とした場合は失敗というフィードバックを受け取ります。時間をかけて、さまざまな商品に最適な行動を学習します。固定された手順に従うのではなく、経験を通じて継続的に性能を高めていきます。
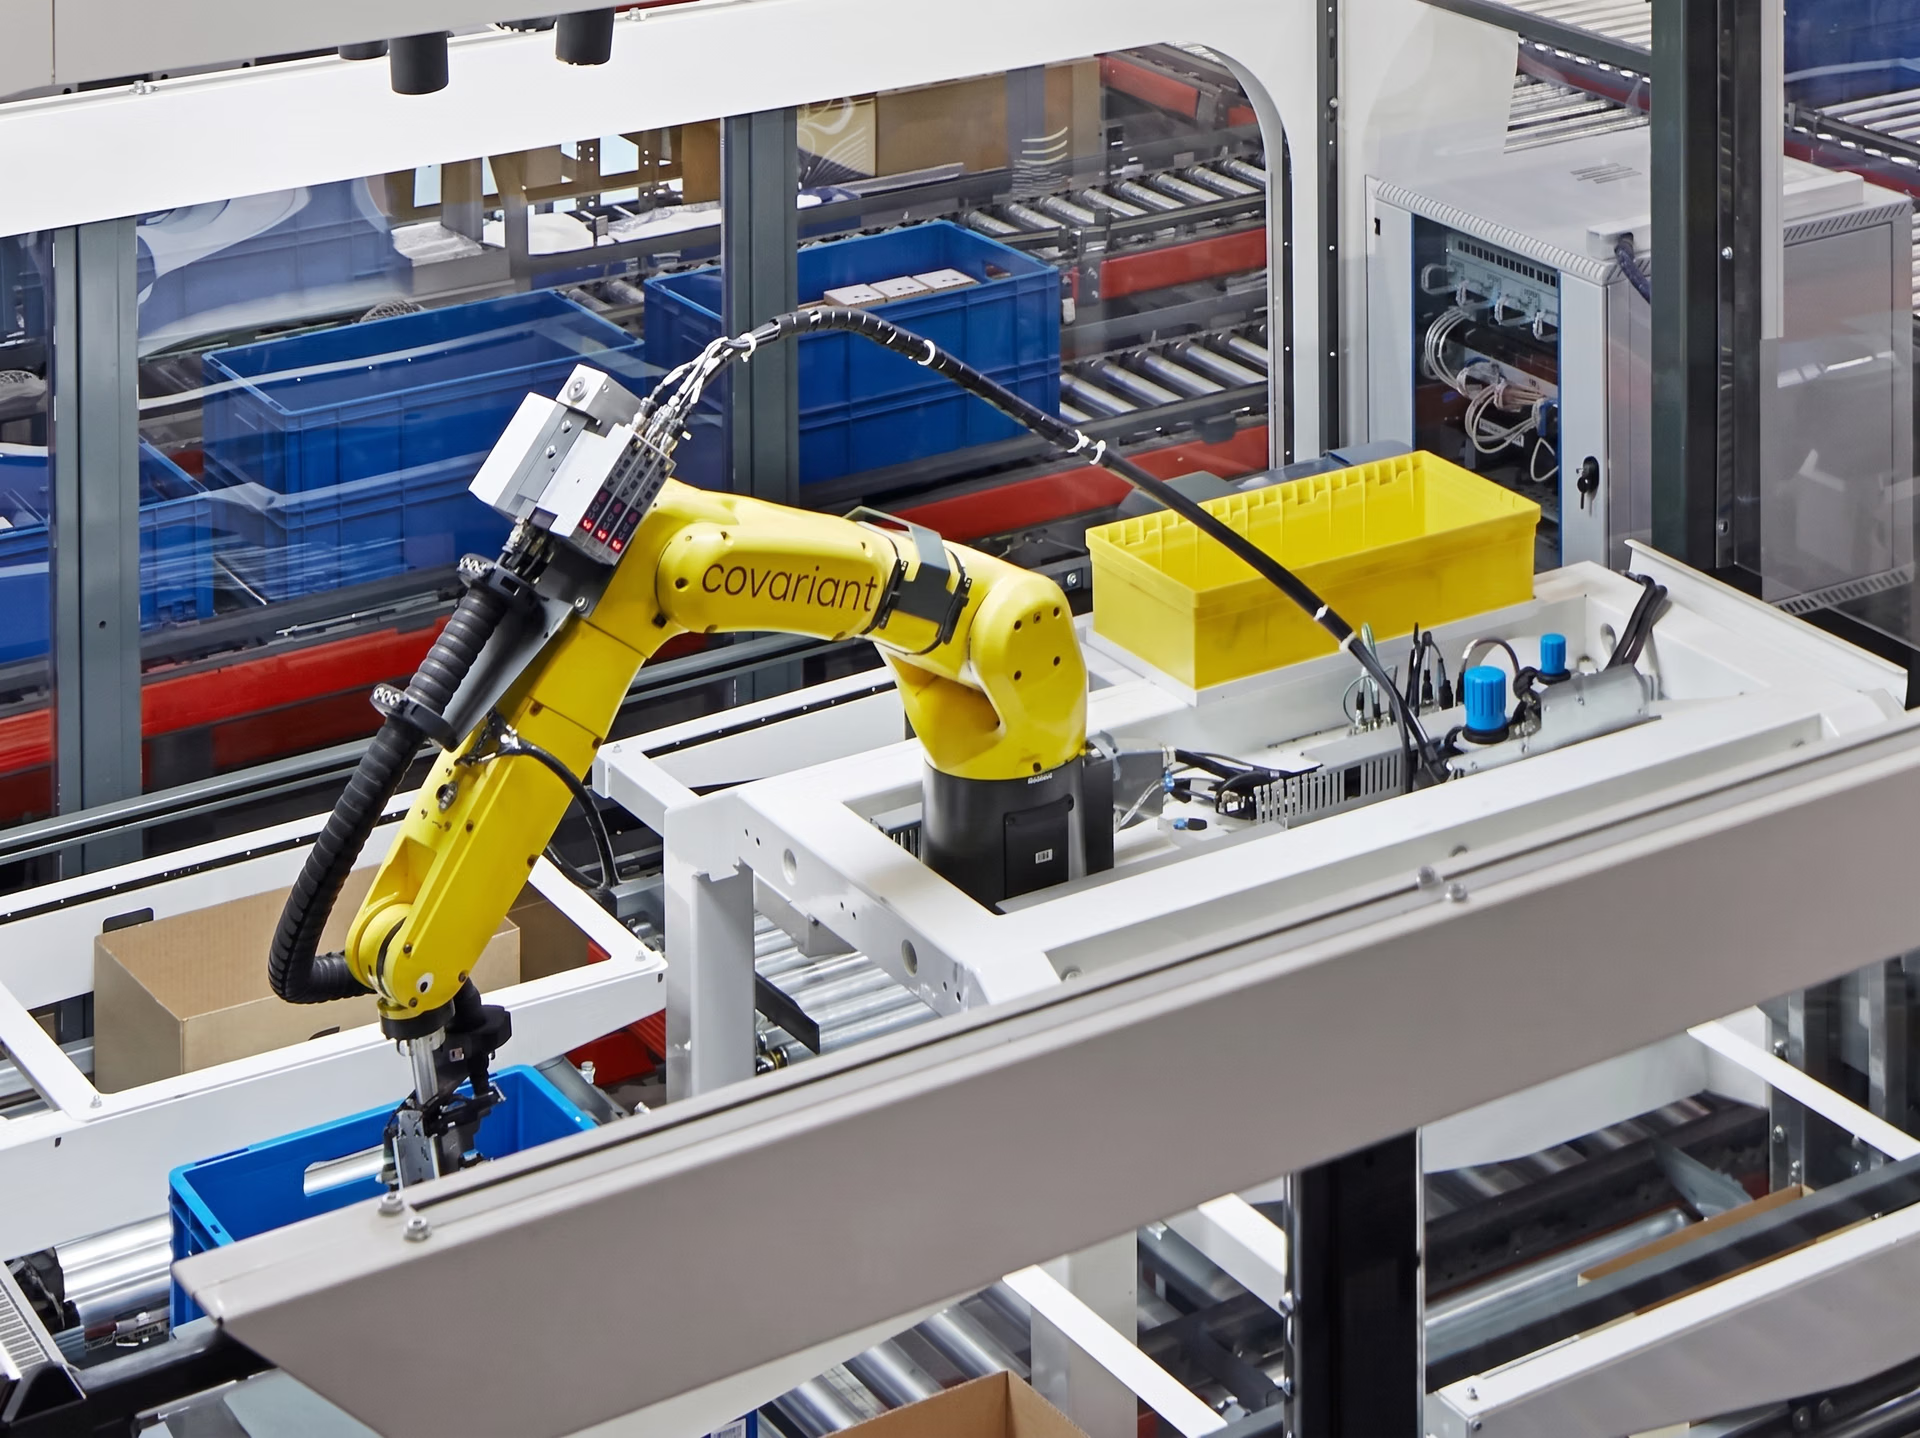
図3. Vision AIと強化学習を使って物体をつかむロボットアーム。
コンピュータービジョンにおける強化学習の応用#
強化学習とは何か、コンピュータービジョンでどのような役割を果たすのかが分かったところで、強化学習とコンピュータービジョンが一緒に使われている事例を詳しく見ていきましょう。
Vision AIと強化学習を統合し、車両をよりスマートにする#
自動運転車は、周囲の状況を理解するためにビジョンAIを、見た情報に基づいて判断するために強化学習を活用できます。その代表例がAWS DeepRacerです。
AWS DeepRacerは、カメラと強化学習を使って運転方法を学ぶ、1/18スケールの完全自律型レーシングカーです。指示を受けるのではなく、試行錯誤を重ね、そこから学ぶことで自ら運転方法を見つけます。
この小型車のカメラは目のように働き、前方のコースを撮影します。見たものに基づいて、車はハンドル操作や速度を学習します。走行を重ねるごとに性能が向上します。たとえば、過去の試行から学び、より大きく曲がったり、急カーブの手前で減速したりする方法を身につけます。
DeepRacerのトレーニングは仮想環境で始まり、そこでモデルは運転スキルを練習して磨きます。一定の性能に達すると、そのスキルが実車で走行する実世界のコースに引き継がれます。
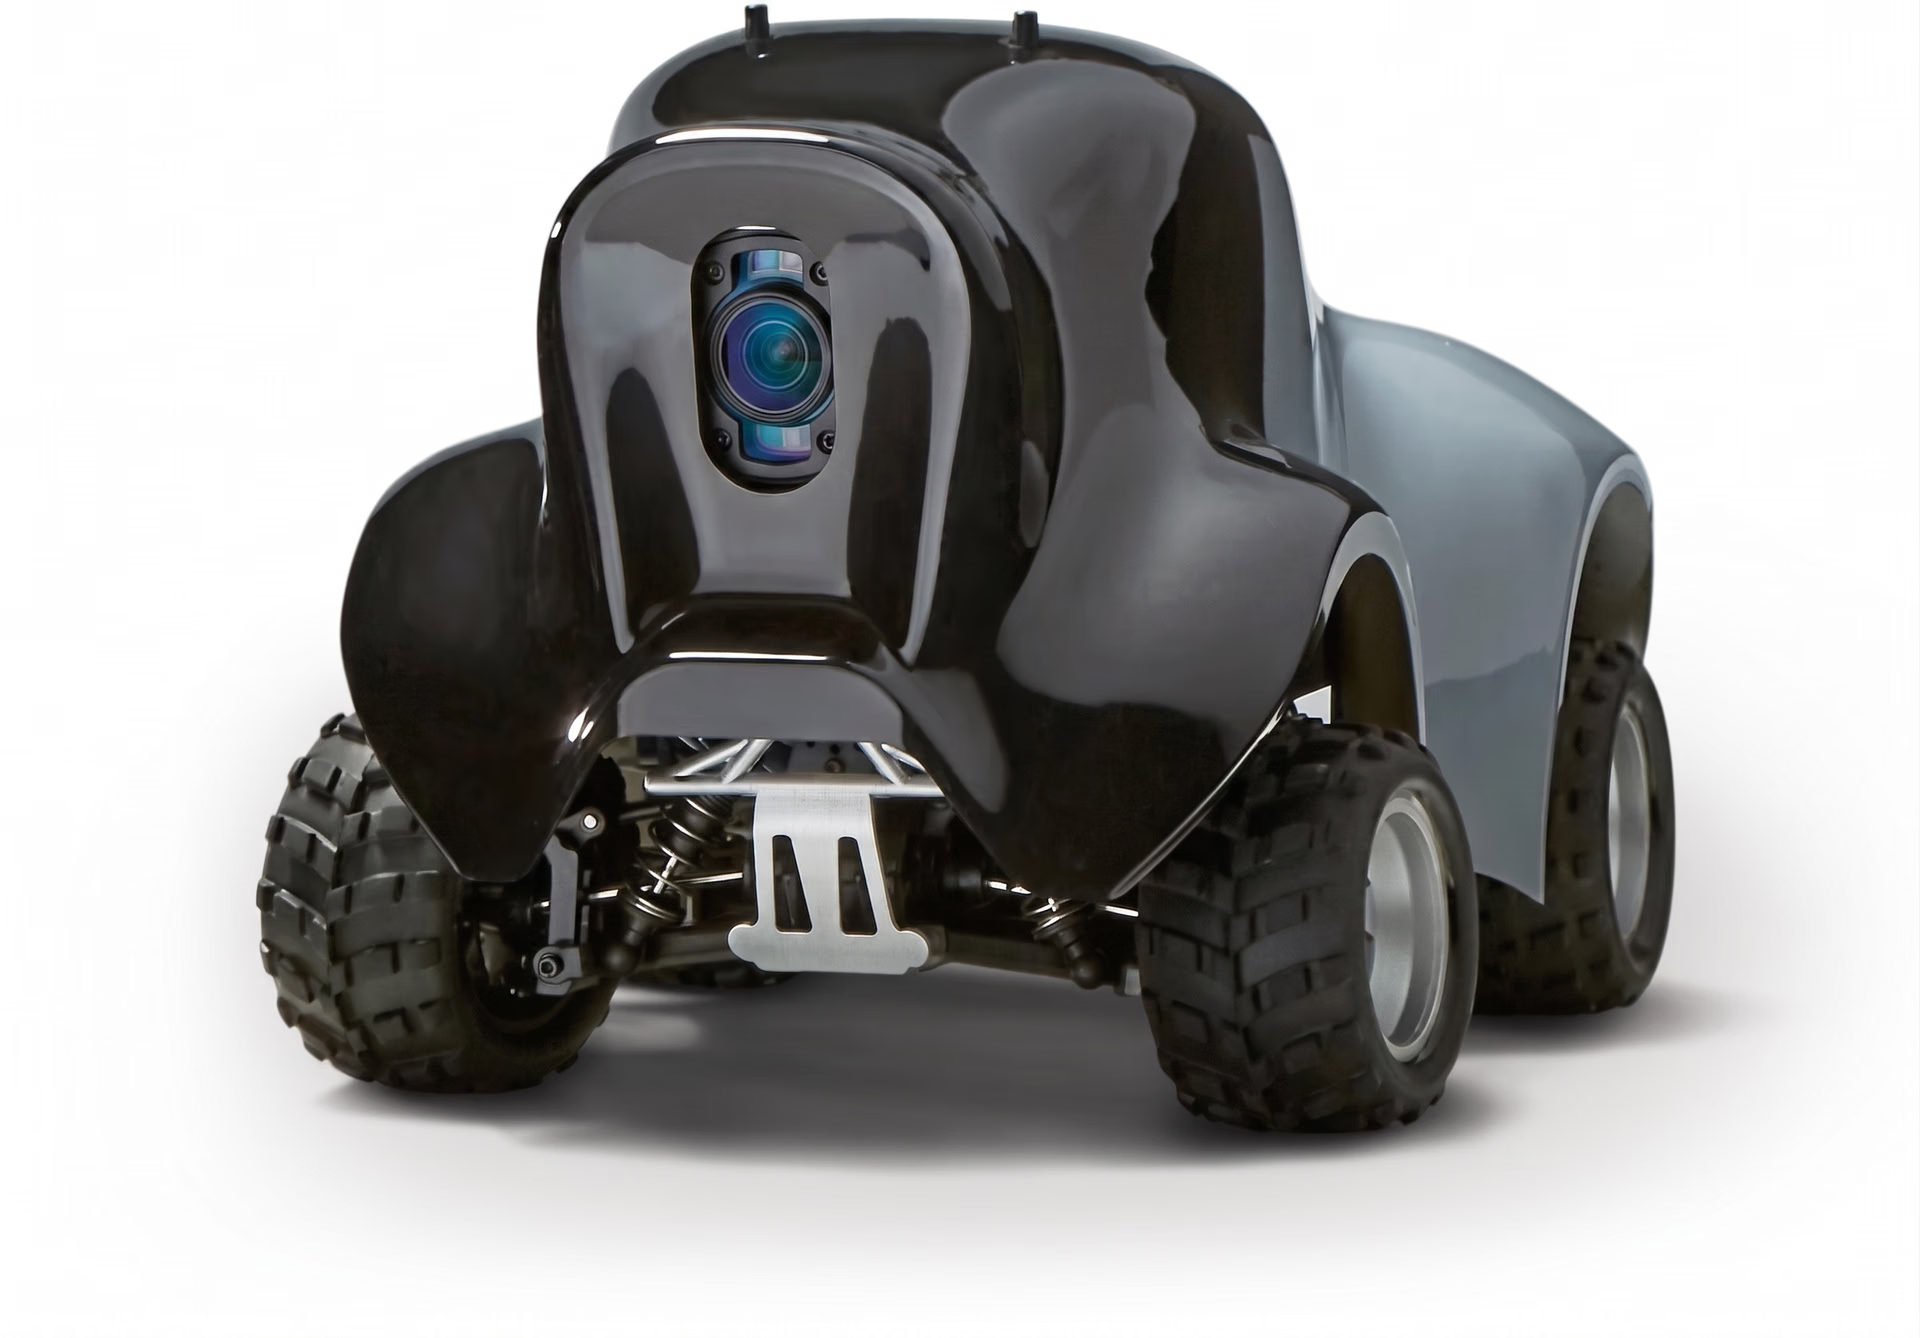
図4. AWS DeepRacerはVisionと強化学習を活用して自律走行します。画像提供: Amazon。
自律型手術ロボットの実現に向けて#
注目を集めている興味深い研究分野の一つに、ビジョンAIと強化学習をロボット手術に統合する取り組みがあります。現時点では、このアプリケーションはまだ主に理論段階にあり、研究者たちは仮想環境でシミュレーションを実施しています。
しかし、初期の実験では有望な結果が示されており、将来的には手術ロボットが複雑で繊細な処置を、より高い精度と適応性で、最小限の人間の介入により実行できる可能性があります。
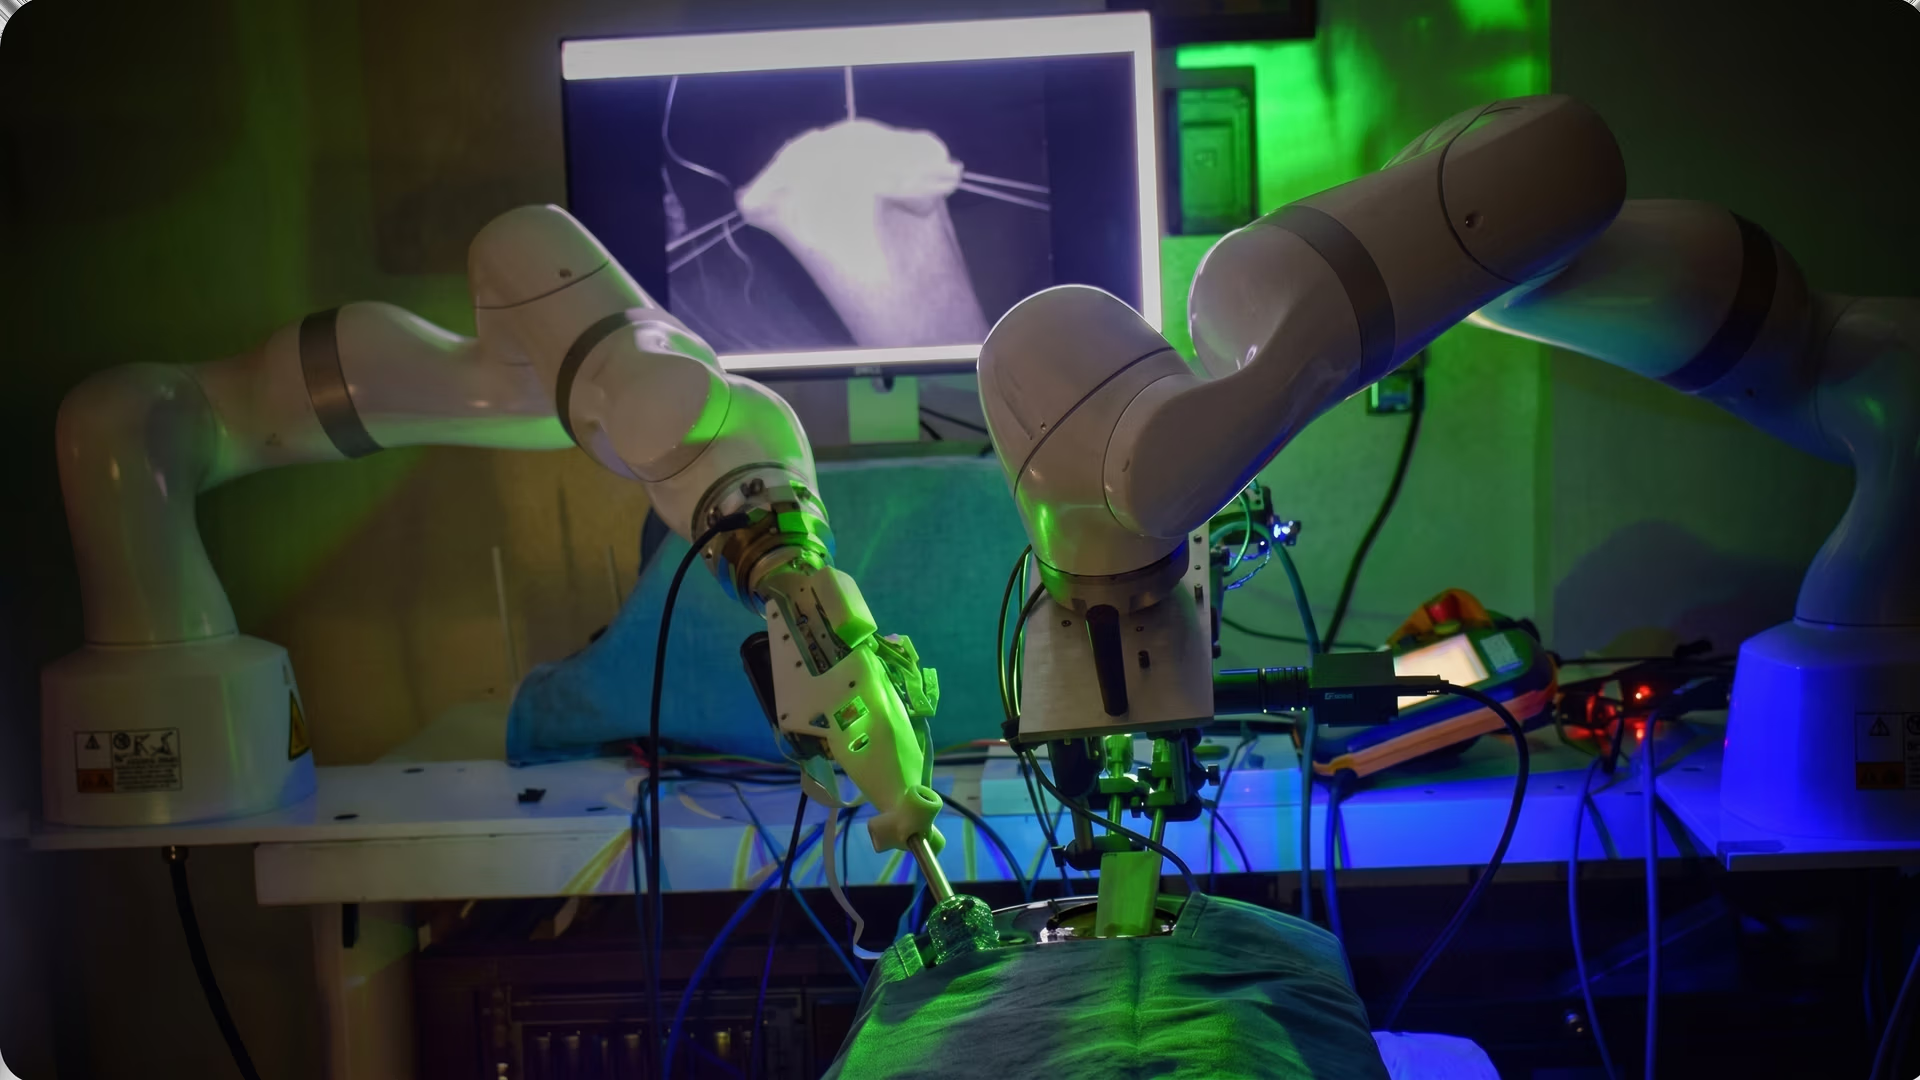
図5. 手術ロボットはますます高度化しています。
たとえば、手術部位からガーゼを慎重に持ち上げる必要がある状況を想像してみてください。ビジョンAIを搭載したロボットは、まずセグメンテーションを使ってガーゼと周囲の組織を識別し、状況を分析します。
次に、強化学習によって手術ロボットが作業への取り組み方を判断し、ガーゼをつかむ最適な角度や加える力、近くの繊細な部位に触れずに持ち上げる方法を決定します。時間をかけてシミュレーション環境で繰り返し練習することで、ロボットはこうした繊細で重要な動作を、より高い熟練度と自信を持って実行できるようになります。
Vision AIにおける強化学習のメリットとデメリット#
強化学習により、ビジョンAIシステムは単純な認識を超えて、見たものに基づいて意思決定できるようになります。これにより、ロボティクス、自動化、リアルタイムのインタラクションなどの分野に新たな可能性が広がります。
ビジョンAIのワークフローに強化学習を統合する主な利点をいくつかご紹介します。
- ラベル付きデータへの依存を軽減: こうしたシステムは相互作用から学習できるため、学習を始めるのに大量のラベル付きデータセットを必要としません。
- 不確実性への対応力を向上: 強化学習は、完璧なデータだけに頼るのではなく、フィードバックに基づいて行動を調整することで、不完全またはノイズの多い視覚情報に対応できます。
- 長期的な学習をサポート: 単一ステップの意思決定だけでなく、一連の行動から学習することで、モデルの時間とともに改善を支援します。
一方で、強化学習には次のような制約もあります。
- 信用割り当て問題: 特に意思決定が長く連なる場合、最終的な結果にどの行動が影響したのかをエージェントが特定するのは困難です。
- 安全でない探索のリスク: トレーニング中に、エージェントが医療や自動運転などの実世界のアプリケーションでは許容されない、安全でない行動や望ましくない行動を試す可能性があります。
- 収束の遅さ: 特に複雑なタスクでは、モデルが良好な性能に実際に到達するまで長い時間がかかることがあります。
重要なポイント#
コンピュータービジョンプロジェクトに強化学習を導入すると、AIシステムは周囲を理解し、経験を通じて行動方法を学習できます。Ultralytics YOLO11のようなモデルがリアルタイム物体検出を担うことで、システムは視覚情報に基づいて適切な意思決定を行えます。
このアプローチでは、ラベル付きデータだけに頼るのではなく、試行とフィードバックを通じてAIを改善できるため、従来の手法を超えることができます。継続的な学習を支援し、時間とともに性能が向上する、より柔軟で適応性と知能に優れたビジョンAIシステムの構築に役立ちます。
成長を続けるコミュニティにぜひご参加ください。GitHubリポジトリでAIについてさらに詳しくご覧ください。独自のコンピュータービジョンプロジェクトを始めたいですか?ライセンスオプションをご確認ください。ソリューションページで、製造業におけるAIや自動車業界のビジョンAIについて詳しくご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









