最適な物体検出モデル
Ultralytics YOLOからRT-DETRまで、2026年に最適な物体検出モデルを取り上げ、アーキテクチャ、性能のトレードオフ、デプロイ時の要因を比較します。
今年の初め、AIと機械学習の先駆者であるAndrew Ng氏が、エージェント型物体検出という概念を紹介しました。この手法では、膨大な学習データを必要とせず、推論エージェントがテキストプロンプトに基づいて物体を検出します。
大量のラベル付きデータセットを必要とせずに画像や動画内の物体を識別できることは、よりスマートで柔軟なコンピュータービジョンシステムへの一歩です。しかし、エージェント型ビジョンAIはまだ初期段階にあります。
画像内の人物や道路標識の検出など、一般的なタスクには対応できますが、より高精度なコンピュータービジョンの用途では、従来型の物体検出モデルが今も使われています。これらのモデルは、何を探し、物体がどこにあるかを正確に学習するために、慎重にラベル付けされた大規模なデータセットで学習します。
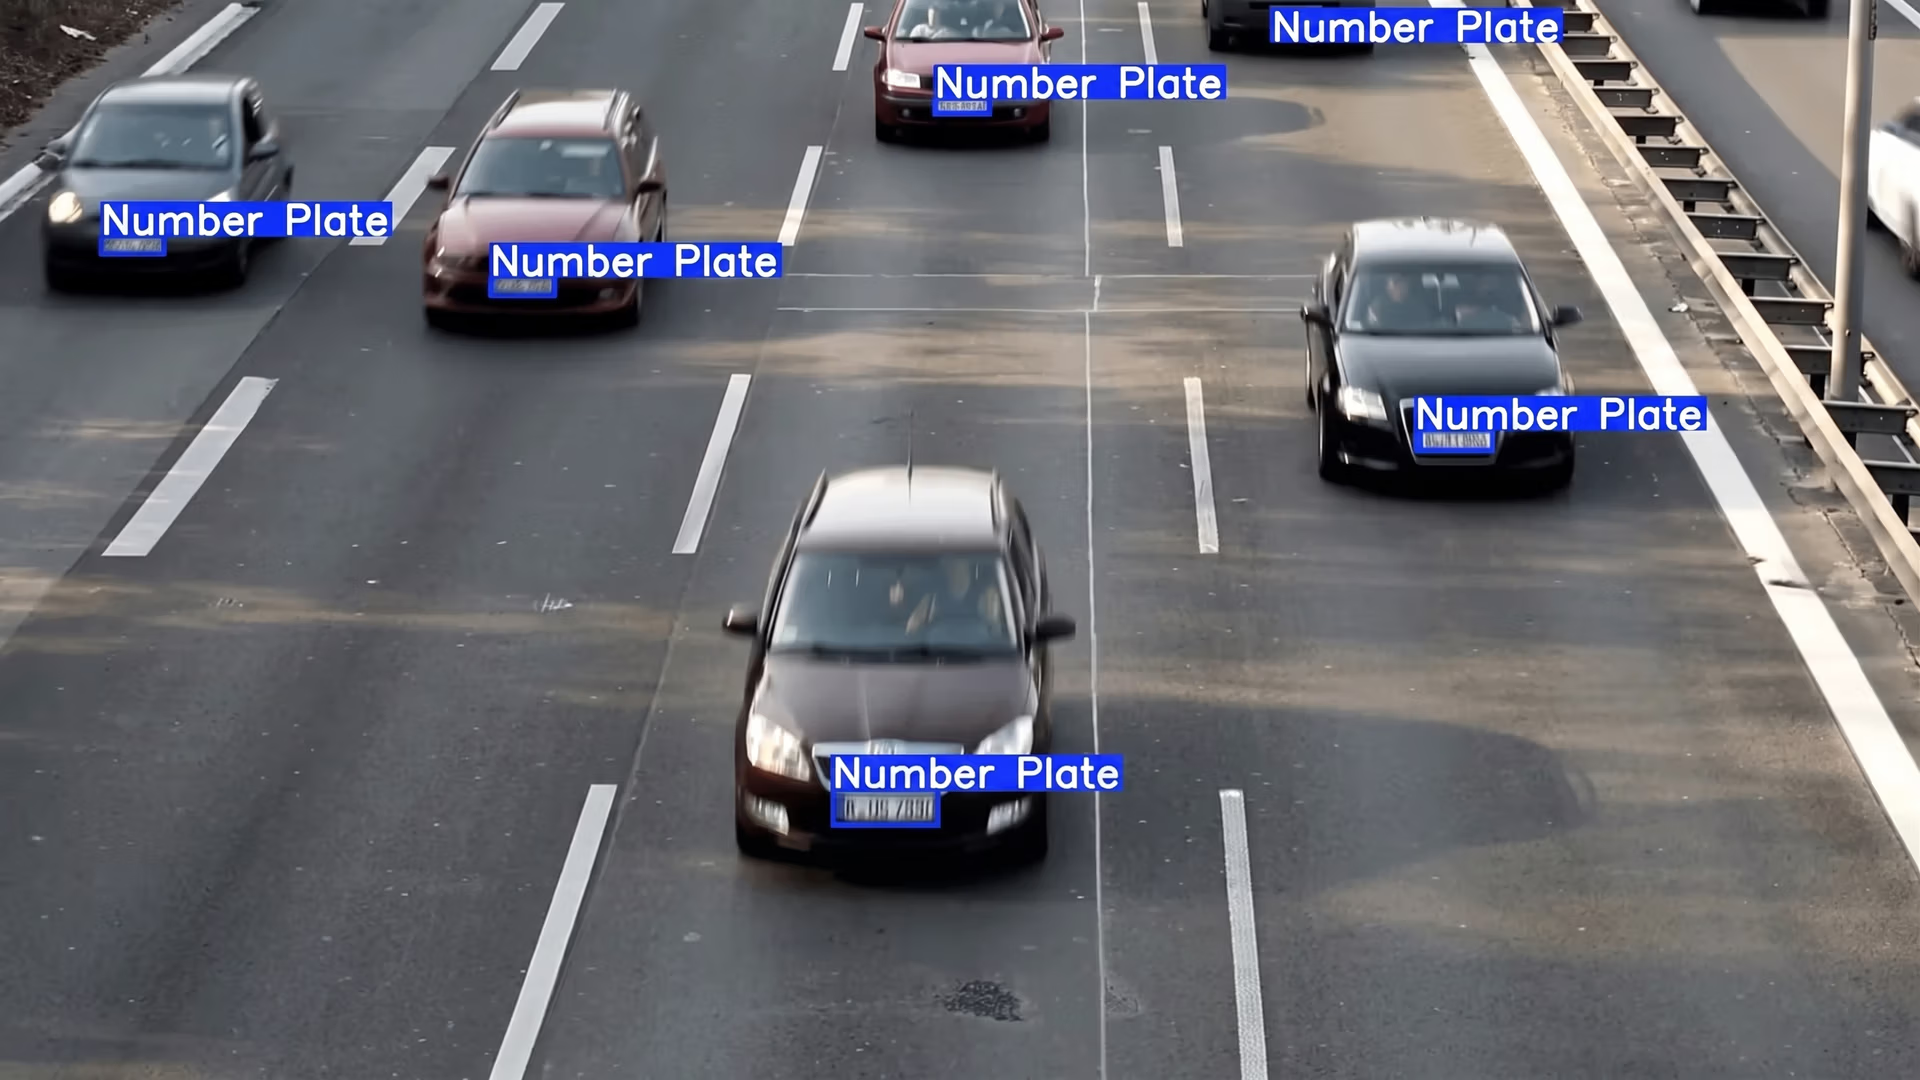
図1. 物体検出の例(出典)
従来型の物体検出が不可欠なのは、物体が何であるかを識別する認識と、画像内の正確な位置を特定する位置推定の両方を実現するためです。この組み合わせによって、自動運転車から産業オートメーション、医療診断まで、機械は複雑な実世界のタスクを確実に実行できます。
テクノロジーの進歩により、物体検出モデルは高速化と高精度化が進み、実環境にもより適したものになっています。この記事では、現在利用できる優れた物体検出モデルをいくつか紹介します。それでは始めましょう。
物体検出の必要性#
画像分類のようなコンピュータービジョンタスクを使うと、画像に車、人、その他の物体が含まれているかどうかを判定できます。しかし、画像内のどこに物体があるかは特定できません。
ここで役立つのが物体検出です。物体検出モデルは、どの物体が存在するかを識別し、その正確な位置も特定できます。位置推定と呼ばれるこの処理により、機械はシーンをより正確に理解し、自動運転車の停止、ロボットアームの誘導、医用画像内の領域の強調表示など、状況に応じて適切に対応できます。
ディープラーニングの台頭は、物体検出を大きく変えました。最新のモデルは、人手で作成したルールに頼るのではなく、アノテーションと視覚データから直接パターンを学習します。これらのデータセットを通じて、モデルは物体の見た目や通常の位置に加え、小さな物体、複雑なシーン、照明条件の変化といった課題への対処方法を学びます。
実際、最先端の物体検出システムは複数の物体を同時に正確に検出できます。そのため、物体検出は自動運転、ロボティクス、医療、産業オートメーションなどの用途で重要なテクノロジーとなっています。
物体検出タスクの仕組み#
物体検出モデルへの入力は画像で、カメラやビデオフレーム、医療スキャンから取得できます。入力画像はニューラルネットワークを通じて処理されます。通常は、視覚データのパターンを認識するよう学習させた畳み込みニューラルネットワーク (CNN) が使われます。
ネットワーク内部では、画像を複数の段階に分けて分析します。検出した特徴に基づいて、モデルは存在する物体の種類と、その位置を予測します。
予測結果はバウンディングボックスで表されます。バウンディングボックスは、検出した物体を囲む長方形です。モデルは各バウンディングボックスにクラスラベル(例: 車、人、犬)と信頼度スコアを割り当てます。信頼度スコアは予測の確かさを示し、確率として捉えることもできます。
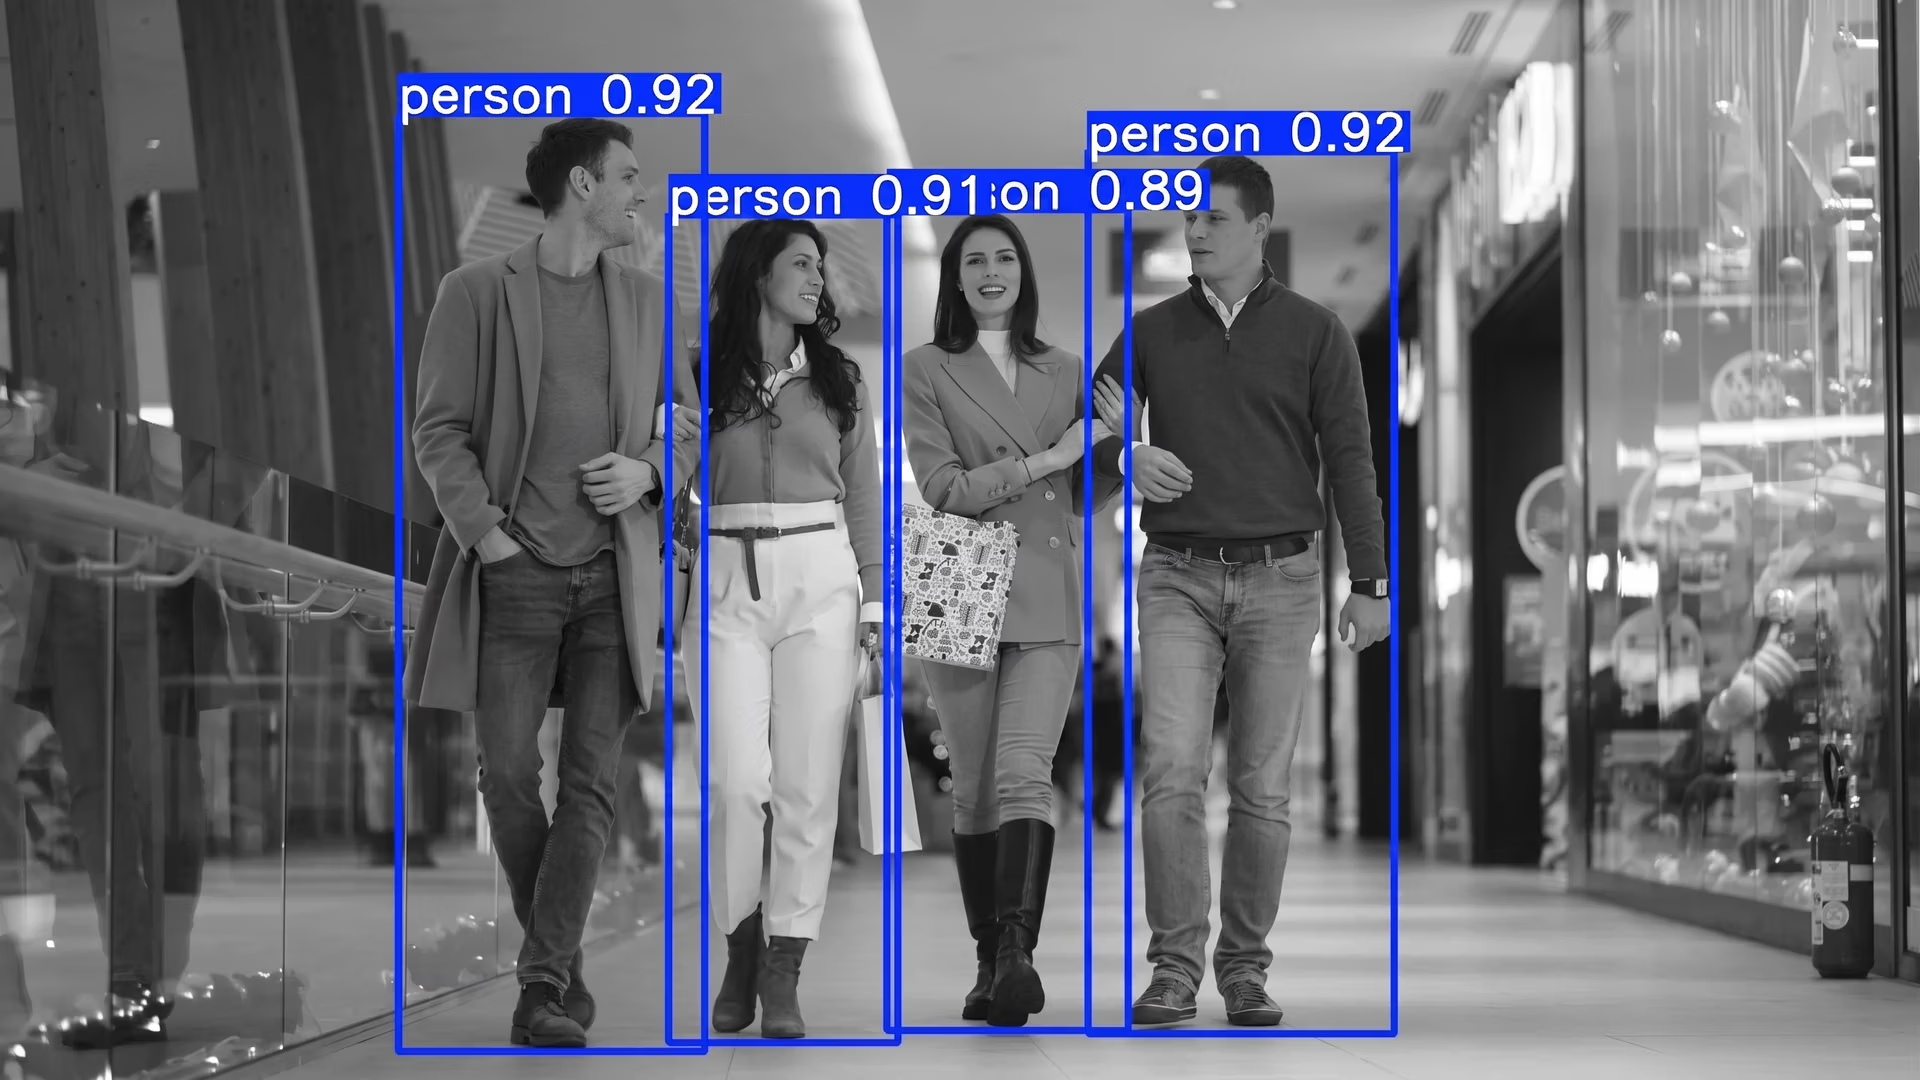
図2. 物体検出の予測結果は、バウンディングボックスを使って可視化できます。
このプロセス全体では、特徴抽出が重要な役割を果たします。モデルは、エッジ、形状、テクスチャなど、識別に役立つ視覚的なパターンを学習します。これらのパターンは特徴マップに符号化され、ネットワークが画像をさまざまな詳細度で理解するのに役立ちます。
物体検出: 2段階方式と1段階方式#
モデルのアーキテクチャに応じて、物体検出器は異なる方法で物体の位置を特定し、速度、精度、複雑さのバランスを取ります。
Faster R-CNNのような2段階検出器をはじめ、多くの物体検出モデルは、関心領域 (ROIs) と呼ばれる画像の特定領域に注目します。これらの領域に焦点を当てることで、すべてのピクセルを均等に分析するのではなく、物体が含まれる可能性の高い領域を優先します。
一方、初期のYOLOモデルのような1段階モデルは、2段階モデルのように特定のROIを選択しません。代わりに画像をグリッドに分割し、アンカーボックスと呼ばれる事前定義ボックスを特徴マップとともに使って、1回の処理で画像全体の物体を予測します。
現在、最先端の物体検出モデルでは、アンカーフリー方式が検討されています。事前定義されたアンカーボックスに依存する従来の1段階モデルとは異なり、アンカーフリーモデルは特徴マップから物体の位置とサイズを直接予測します。これにより、アーキテクチャの簡素化や計算オーバーヘッドの削減が可能になり、特に形状やサイズがさまざまな物体の検出性能を向上できます。
優れた物体検出モデルを紹介#
現在、物体検出モデルは数多くあり、それぞれ特定の目標に合わせて設計されています。リアルタイム性能に最適化されたモデルもあれば、最高精度の実現に重点を置いたモデルもあります。コンピュータービジョンソリューションに適したモデルは、ユースケースや性能要件によって異なります。
次に、2026年に利用できる優れた物体検出モデルをいくつか見ていきましょう。
1. Ultralytics YOLOモデル#
現在、最も広く利用されている物体検出モデルのファミリーの一つが、Ultralytics YOLOモデルファミリーです。YOLOは「You Only Look Once」の略称で、優れた検出性能を高速かつ高い信頼性で実現し、扱いやすいことから、さまざまな業界で広く利用されています。
Ultralytics YOLOファミリーには、Ultralytics YOLOv5、Ultralytics YOLOv8、Ultralytics YOLO11、そして今後リリース予定のUltralytics YOLO26が含まれており、さまざまな性能要件やユースケースに対応する選択肢を提供します。軽量な設計と速度の最適化により、Ultralytics YOLOモデルはリアルタイム検出に適しており、計算能力やメモリに制約のあるエッジデバイスにもデプロイできます。
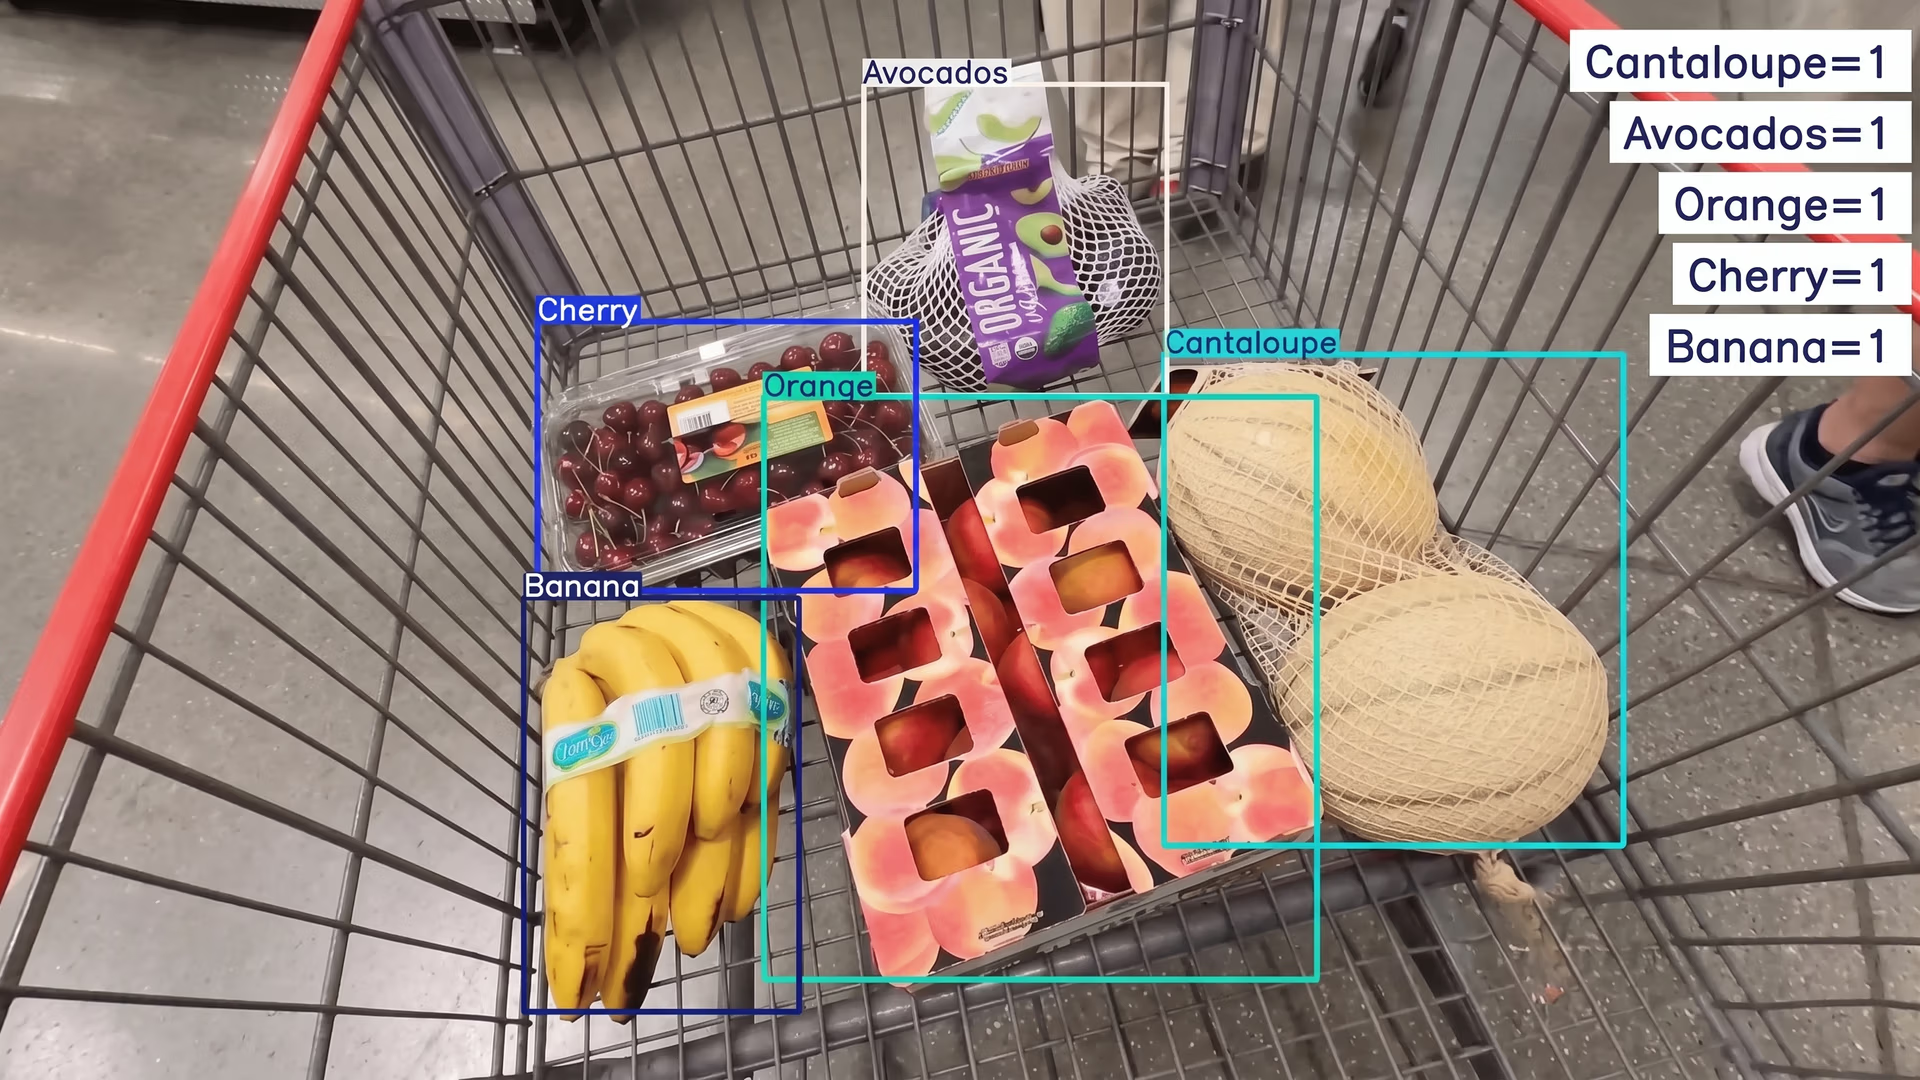
図3. 物体検出にUltralytics YOLO11を使用(出典)
基本的な物体検出にとどまらず、これらのモデルは非常に汎用性に優れています。ピクセル単位で物体の輪郭を特定するインスタンスセグメンテーションや、人や物体のキーポイントを特定する姿勢推定などのタスクにも対応しています。この柔軟性により、Ultralytics YOLOモデルは農業や物流から小売、製造に至るまで、幅広い用途で選ばれています。
Ultralytics YOLOモデルが人気を集めているもう一つの大きな理由は、トレーニング、ファインチューニング、モデルのデプロイに使えるシンプルで使いやすいインターフェースを提供するUltralytics Pythonパッケージです。開発者は、事前トレーニング済みの重みから始め、独自のデータセットに合わせてモデルをカスタマイズし、わずか数行のコードでデプロイできます。
2. RT-DETRとRT-DETRv2#
RT‑DETR(リアルタイム物体検出Transformer)と新しいRT‑DETRv2は、リアルタイム用途向けに開発された物体検出モデルです。多くの従来型モデルとは異なり、画像を入力すると、非最大値抑制(NMS)を使わずに最終的な検出結果を直接出力できます。
NMSは、モデルが同じ物体を複数回予測した場合に、重なり合う余分なボックスを取り除く処理です。NMSを省略することで、検出処理をよりシンプルかつ高速にできます。
これらのモデルはCNNとTransformerを組み合わせています。CNNはエッジや形状などの視覚的な特徴を検出し、Transformerは画像全体を一度に捉え、各部分の関係を理解できるニューラルネットワークの一種です。この包括的な理解により、モデルは近接または重なり合った物体も検出できます。
RT‑DETRv2は、小さな物体と大きな物体の両方を見つけやすくするマルチスケール検出や、複雑なシーンへの対応の改善などの機能により、初代モデルを改良しています。これらの変更により、モデルの速度を維持しながら精度を向上させています。
3. RF-DETR#
RF‑DETRは、Transformerベースのリアルタイムモデルで、Transformerアーキテクチャの精度と実環境のアプリケーションに必要な速度を両立するように設計されています。RT‑DETRやRT‑DETRv2と同様に、Transformerで画像全体を解析し、CNNでエッジ、形状、テクスチャなどの細かな視覚的特徴を抽出します。
このモデルは入力画像から物体を直接予測し、アンカーボックスと非最大値抑制を省略することで、検出処理をシンプルにし、推論速度を維持します。RF‑DETRはインスタンスセグメンテーションにも対応しており、バウンディングボックスの予測に加えて、ピクセル単位で物体の輪郭を特定できます。
4. EfficientDet#
2019年後半にリリースされたEfficientDetは、効率的なスケーリングと高い性能を実現するよう設計された物体検出モデルです。EfficientDetの大きな特徴は複合スケーリングです。これは、1つの要素だけを調整するのではなく、入力解像度、ネットワークの深さ、ネットワークの幅を同時にスケーリングする手法です。この方法により、高性能なタスク向けに拡大する場合も、軽量なデプロイ向けに縮小する場合も、安定した精度を維持できます。
EfficientDetのもう一つの重要な構成要素は、効率的な特徴ピラミッドネットワーク(FPN)です。これにより、モデルは複数のスケールで画像を解析できます。このマルチスケール解析は、サイズの異なる物体を検出するうえで重要であり、EfficientDetは同じ画像内の小さな物体と大きな物体の両方を確実に識別できます。
5. PP-YOLOE+#
2022年にリリースされたPP-YOLOE+は、YOLO形式の物体検出モデルです。つまり、画像を1回処理するだけで物体を検出・分類します。この方式により高速な処理が可能で、リアルタイムアプリケーションに適している一方、高い精度も維持します。
PP-YOLOE+の主な改良点の一つは、タスクアライメント学習です。これにより、モデルの信頼度スコアが物体の位置特定の精度を反映しやすくなります。これは、小さな物体や重なり合った物体の検出に特に役立ちます。
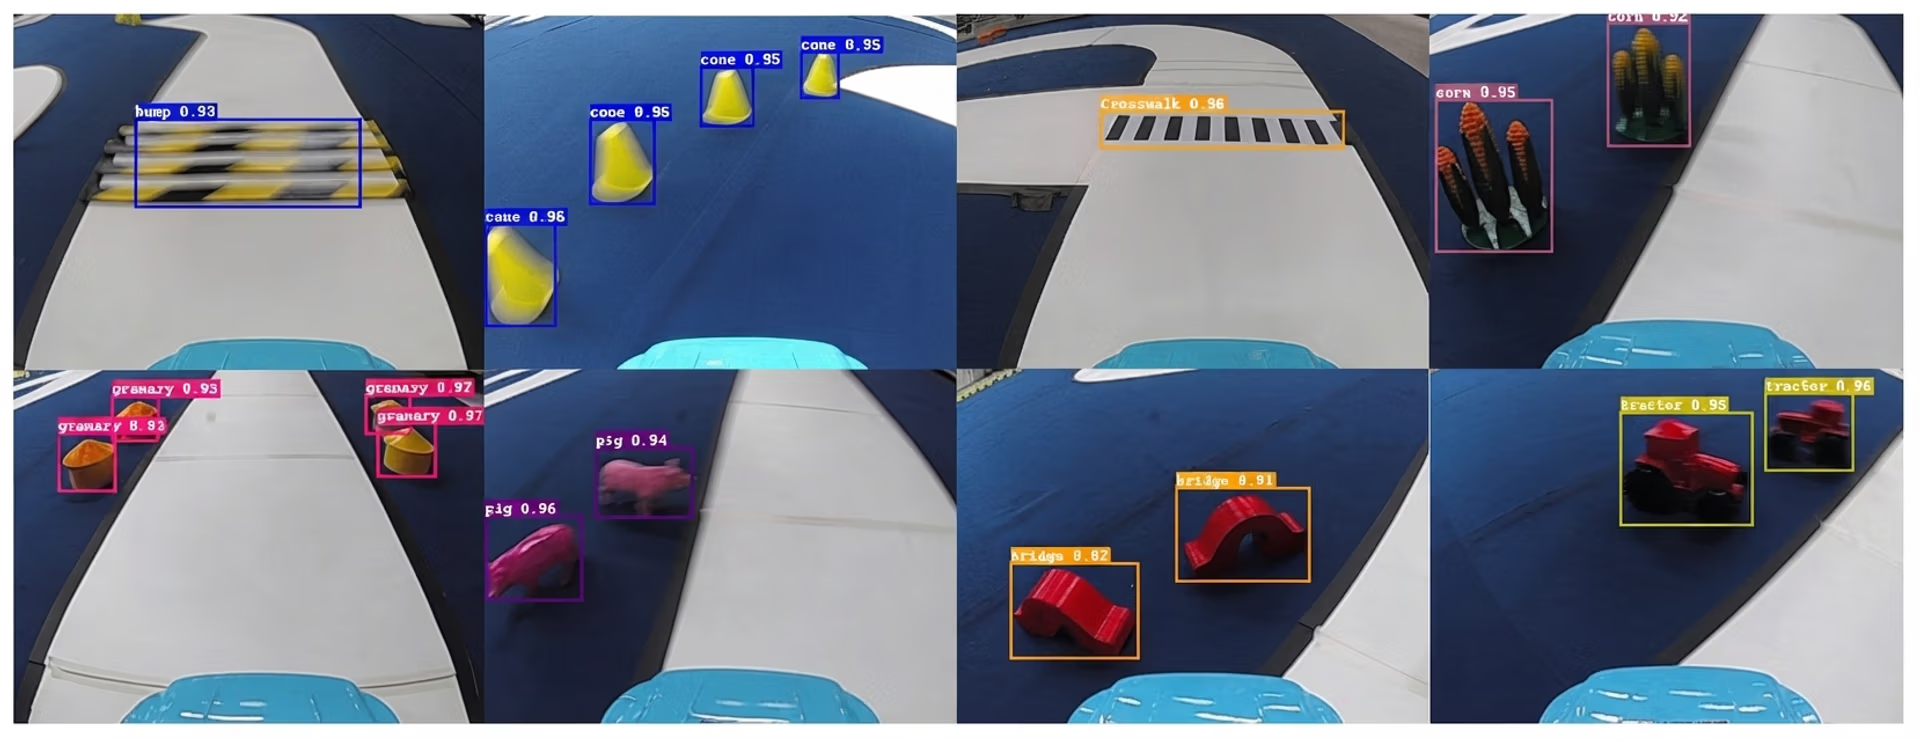
図4. PP-YOLOE+による物体検出(出典)
このモデルは、物体の位置とクラスラベルを予測するタスクを分離する、デカップルドヘッドアーキテクチャも採用しています。これにより、物体を正しく分類しながら、より正確なバウンディングボックスを描画できます。
6. GroundingDINO#
GroundingDINOは、ビジョンと言語を組み合わせたTransformerベースの物体検出モデルです。固定されたカテゴリセットに依存するのではなく、自然言語のテキストプロンプトを使って物体を検出できます。
画像の視覚的特徴とテキストの説明を対応付けることで、学習データに該当するラベルが含まれていない場合でも、物体の位置を特定できます。つまり、「ヘルメットをかぶった人」や「建物の近くにある赤い車」といった説明をプロンプトとしてモデルに入力すると、条件に一致する物体を囲む正確なバウンディングボックスを生成します。
さらに、ゼロショット検出に対応しているため、GroundingDINOでは新しいユースケースごとにモデルを再トレーニングまたはファインチューニングする必要性が低く、幅広い用途に柔軟に対応できます。言語理解と視覚認識の組み合わせにより、対話型で適応性の高いAIシステムの新たな可能性が広がります。
物体検出モデルの評価に使用される一般的な指標#
さまざまな物体検出モデルを比較する際、どのモデルが実際に最も優れているかをどう判断すればよいのか、疑問に思うかもしれません。モデルアーキテクチャやデータの品質だけでなく、多くの要因が性能に影響するため、当然の疑問です。
研究者は、モデルを一貫した方法で評価し、結果を比較し、速度と精度のトレードオフを把握するために、共通のベンチマークや標準的な性能指標をよく利用します。多くの物体検出モデルがCOCOデータセットなどの同じデータセットで評価されるため、標準的なベンチマークは特に重要です。
検出精度と速度の測定#
ここでは、物体検出モデルの評価によく使用される指標をいくつか紹介します。
- Intersection over Union(IoU): この指標は、予測されたバウンディングボックスが画像内の実際の物体とどの程度重なっているかを測定します。モデルが描画したボックスと、データセットでラベル付けされた物体の位置を示す正解ボックスを比較します。IoUは、2つのボックスの重なり部分の面積を和集合の面積で割って算出します。IoUが高いほど、モデルがより正確な位置にボックスを配置していることを示し、低いほど予測の精度が低いことを意味します。簡単に言えば、IoUはモデルの予測が実際の物体の位置とどの程度一致しているかを示します。
- 平均適合率(mAP):物体検出全体の性能を評価するために使用される主要な指標です。モデルが正しく検出した物体の数と、さまざまな信頼度レベルや物体カテゴリにおける検出精度の両方を考慮します。
- フレーム毎秒(FPS)とレイテンシ:FPSは、モデルが1秒間に処理できる画像または動画フレームの数を示します。たとえば、30 FPSで動作するモデルは、毎秒30フレームを処理できます。FPSが高いほどシステムの応答が速くなるため、ライブ動画、交通監視、ロボティクスなどのユースケースで重要です。一方、レイテンシは、画像やフレームを受け取ってから結果が出るまでに、モデルが1つの画像またはフレームを処理するのにかかる時間を測定します。
物体検出アルゴリズムを使用するメリットとデメリット#
実環境のアプリケーションで物体検出モデルを使用する主なメリットをいくつか紹介します。
- さまざまな業界に適用可能: 物体検出は、交通監視や小売分析から、ヘルスケア、農業、製造まで、幅広いユースケースに適用できます。
- 手作業を削減: 目視検査や監視タスクを自動化することで、人間が常に監督する必要性を減らし、チームがより価値の高い業務に集中できるようになります。
- オープンソースエコシステムの恩恵: GitHub上の活発なオープンソースコミュニティやリソースにより、事前トレーニング済みモデルへのアクセス、実験、ソリューションのカスタマイズが容易になります。
こうしたメリットがある一方で、物体検出モデルの性能に影響する実用上の制約もあります。考慮すべき重要な要素を以下に示します。
- 高品質なデータの要件: 物体検出モデルのトレーニングには、大規模で適切にアノテーションされたデータセットが必要です。このデータの作成と維持には時間とコストがかかり、規模の拡大も困難です。
- 計算リソースの要求: 高い検出精度を実現するモデルは、トレーニング時とリアルタイムのデプロイ時の両方で、相当な処理能力を必要とすることがよくあります。通常、高性能GPUが必要となるため、インフラコストが増加する可能性があります。
- 実環境の条件への敏感さ: 照明、カメラアングル、天候、混雑したシーンなどの変化は検出性能に影響するため、継続的なテストと調整が必要です。
重要なポイント#
コンピュータービジョンプロジェクトに最適な物体検出モデルは、ユースケース、データ環境、性能要件、ハードウェアの制約によって異なります。速度に最適化されたモデルもあれば、精度を重視するモデルもあり、多くの実環境のアプリケーションでは両者のバランスが必要です。オープンソースのフレームワークやGitHub上の活発なコミュニティのおかげで、これらのモデルは実用に向けた評価、適応、デプロイがますます容易になっています。
詳しくは、GitHubリポジトリをご覧ください。コミュニティに参加して、ヘルスケアにおけるAIや自動車業界におけるコンピュータービジョンなどの活用例をソリューションページでご確認ください。ライセンスオプションを確認して、ビジョンAIを今すぐ始めましょう。








