Как выбрать облачный GPU для обучения моделей компьютерного зрения на Ultralytics Platform
Узнай, как выбрать подходящий облачный GPU для обучения моделей компьютерного зрения на Ultralytics Platform с учетом размера набора данных, сложности модели и стоимости.
 Abirami Vina13 мин. чтения
В прошлом месяце мы представили Ultralytics Platform — комплексную среду, которая упрощает весь рабочий процесс компьютерного зрения: от управления наборами данных до обучения и развертывания моделей. Ultralytics Platform объединяет все необходимое для создания и масштабирования моделей компьютерного зрения на базе ИИ в единой среде.
Важная часть этого рабочего процесса — обучение моделей, в ходе которого нейронные сети изучают закономерности в данных, чтобы строить точные предсказания; при этом ключевую роль играет доступ к подходящим вычислительным ресурсам. Ранее мы рассказывали, как Ultralytics Platform поддерживает обучение моделей в облаке с использованием графических процессоров (GPU), позволяя обучать модели компьютерного зрения без управления локальной инфраструктурой.
Благодаря доступу по запросу к мощным GPU NVIDIA, пользователи — от студентов и стартапов до исследователей и крупных организаций — могут эффективнее, чем когда-либо, выполнять задачи ИИ. Начать облачное обучение несложно, но при выборе подходящего GPU нужно учитывать такие факторы, как размер набора данных, сложность модели и стоимость.
Сегодня доступен широкий выбор оборудования: от доступных по цене GPU RTX до высокопроизводительных NVIDIA H100 и аппаратных решений нового поколения Blackwell. Выбор подходящей конфигурации может существенно повлиять как на разработку модели, так и на расходы.
В этой статье мы рассмотрим обучение моделей компьютерного зрения в облаке с GPU на Ultralytics Platform и расскажем, как выбрать подходящее оборудование для твоей рабочей нагрузки.
Обзор облачного обучения в Ultralytics Platform#
Прежде чем разбирать выбор GPU для облачного обучения на Ultralytics Platform, давай сначала посмотрим, как устроено обучение в облаке.
Что такое обучение на облачных GPU?#
Обучение на облачных GPU — это использование GPU, размещенных в облачной вычислительной среде, для обучения моделей машинного и глубокого обучения вместо собственного локального оборудования или рабочей станции. В Ultralytics Platform это позволяет по запросу получать доступ к мощным GPU и удаленно запускать задачи обучения, не настраивая собственную систему.
Так тебе проще масштабировать ресурсы в соответствии с нагрузкой. При необходимости можно выбрать более мощные GPU или увеличить емкость, не ограничиваясь возможностями своей системы. Это похоже на доступ к мощным машинам, или узлам, в удаленных центрах обработки данных, ресурсы которых можно увеличивать или уменьшать по мере необходимости.
Кроме того, не нужно настраивать и обслуживать дорогостоящее оборудование. Тебе не придется покупать GPU, устанавливать драйверы или решать проблемы совместимости.
Ultralytics Platform управляет всем процессом с помощью облачных сервисов: от выделения ресурсов и настройки среды до оркестрации и запуска задач обучения. Так ты можешь сосредоточиться на обучении, экспериментах и улучшении моделей.
Как проходит обучение моделей в Ultralytics Platform#
На Ultralytics Platform рабочий процесс обучения с ускорением на GPU прост. Для начала можно добавить датасет одним из нескольких способов.
Ты можешь загрузить собственные данные, использовать общедоступные наборы данных на платформе или клонировать наборы данных, которыми поделилось сообщество, чтобы продолжить уже начатую работу. При клонировании в твоем рабочем пространстве создается копия набора данных: ее можно редактировать и расширять, не меняя оригинал.
Выбрав набор данных, ты можешь просмотреть и упорядочить изображения и аннотации, чтобы убедиться, что все структурировано правильно. На платформе также есть встроенные инструменты аннотирования: с их помощью можно размечать данные для задач обнаружения объектов, сегментации и классификации или ускорить процесс с помощью функций на базе ИИ.
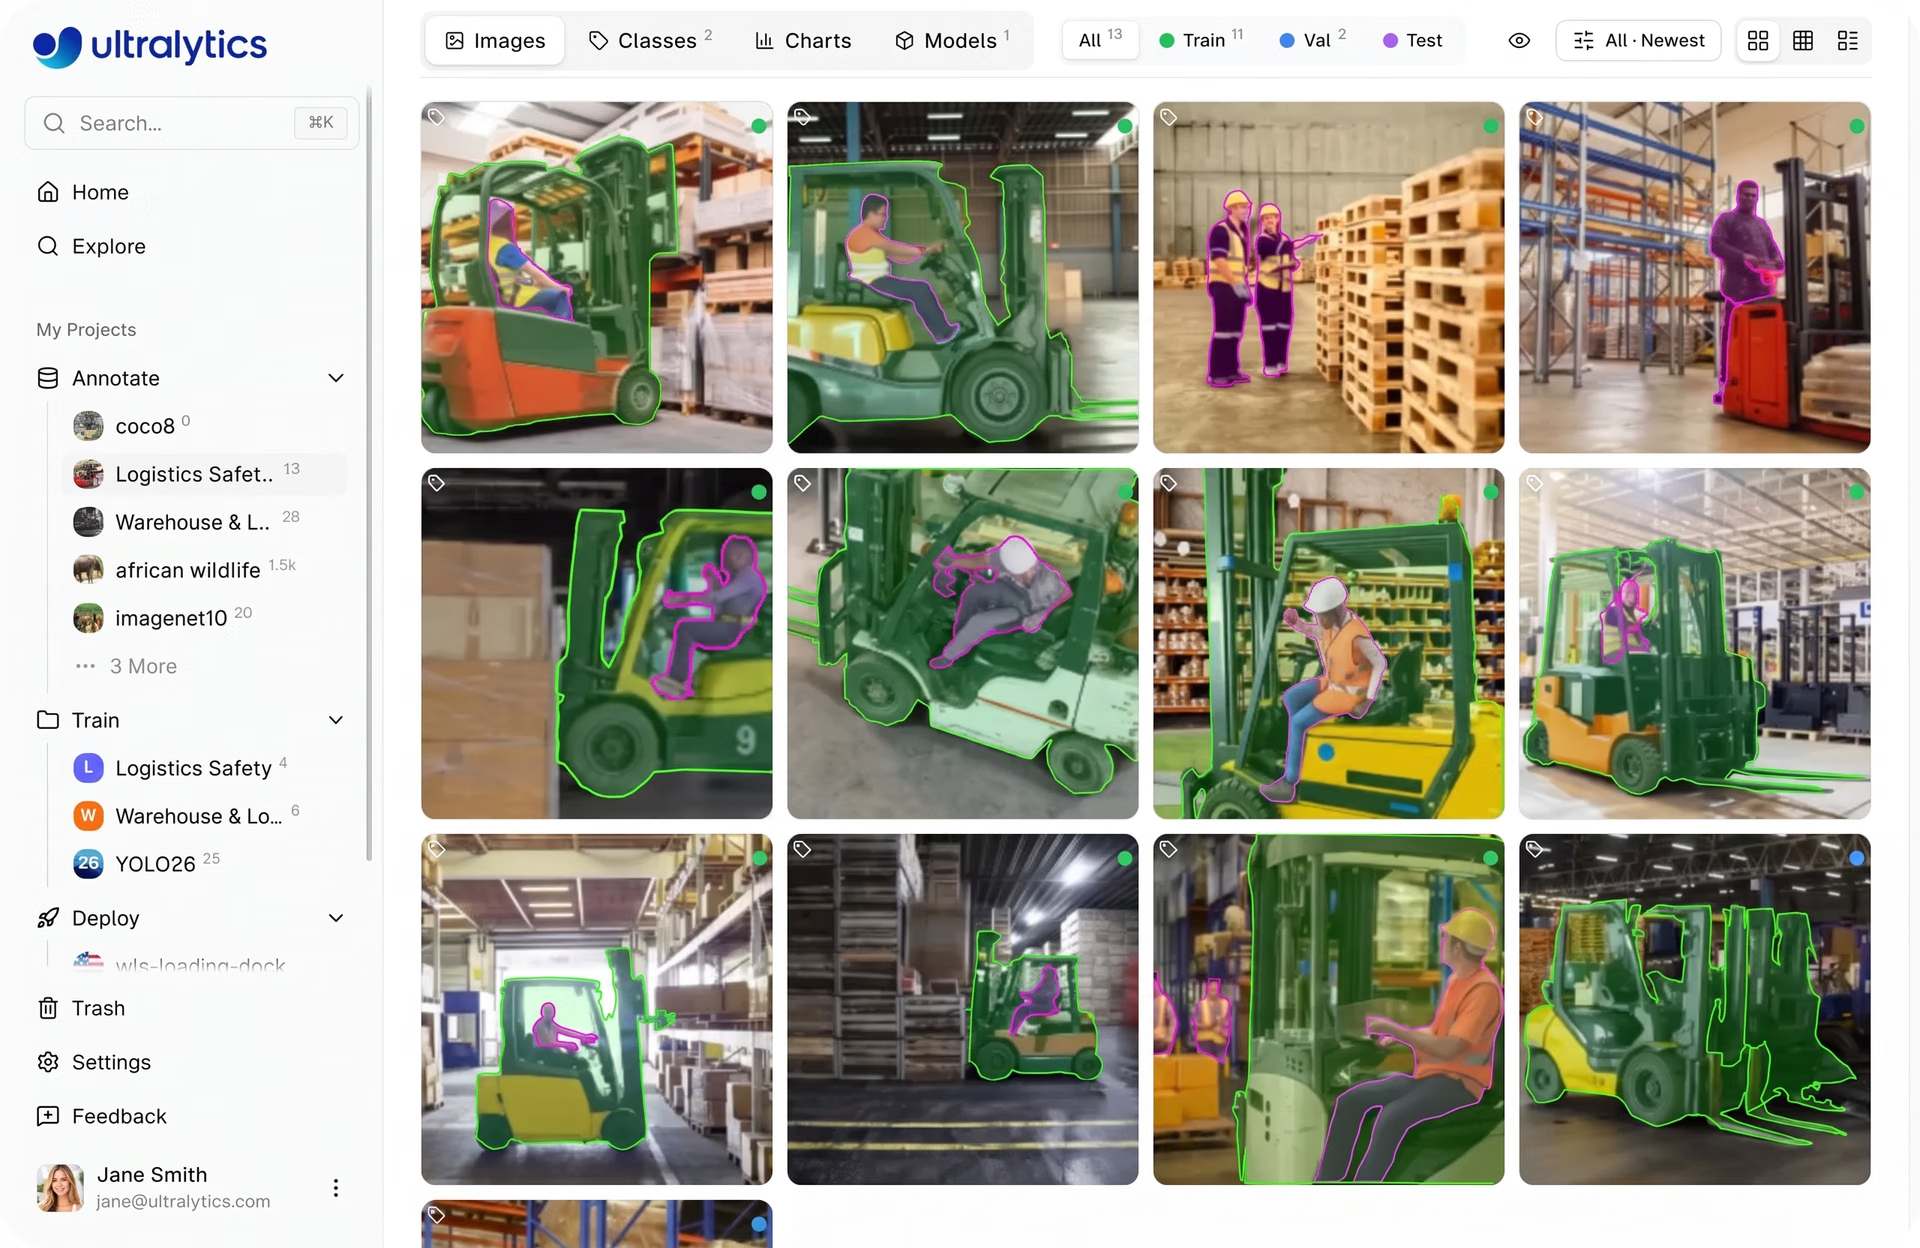
Рис. 1. Просмотр набора данных в Ultralytics Platform (Источник)
Затем можно выбрать или создать проект для управления запусками обучения. Проекты помогают упорядочивать и сравнивать модели, отслеживать метрики производительности и хранить связанные эксперименты в одном месте.
После этого можно перейти к облачному обучению: выбрать модель, настроить параметры и подобрать GPU с учетом требований к производительности и бюджету. Платформа сама управляет базовой облачной инфраструктурой.
Платформа выделяет экземпляр выбранного GPU, подготавливает набор данных и запускает задачу обучения в облаке. По мере обучения ты можешь отслеживать метрики, журналы и производительность системы в реальном времени, не управляя настройкой среды, окружениями CUDA, такими фреймворками, как PyTorch или TensorFlow, и оборудованием.
Ключевые возможности обучения на GPU в Ultralytics Platform#
Вот некоторые ключевые возможности обучения в облаке с GPU на Ultralytics Platform:
- Обучение в один клик: запускай задачи обучения с минимальной настройкой и быстро переходи от набора данных к обучению модели без сложной конфигурации.
- GPU по запросу: выбирай подходящий GPU из доступных вариантов и при необходимости масштабируй ресурсы без долгосрочных обязательств.
- Мониторинг в реальном времени: отслеживай ход обучения с помощью графиков и журналов, а также смотри системные метрики, например загрузку GPU и использование памяти.
- Автоматические контрольные точки: ход обучения регулярно сохраняется, поэтому при необходимости работу легко продолжить или восстановить.
- Простое развертывание: после завершения обучения можно развернуть обученные модели и использовать их в приложениях или рабочих процессах через общие API инференса, выделенные конечные точки или экспортировать для использования во внешних системах. Эти варианты развертывания обеспечивают инференс с низкой задержкой, позволяя создавать приложения реального времени, например для видеоаналитики, автоматизации и интерактивных решений на базе ИИ.
Различные варианты облачных GPU в Ultralytics Platform#
Теперь, когда мы разобрались, как проходит обучение на платформе, давай рассмотрим доступные варианты GPU. Выбор GPU влияет на скорость обучения модели, ее производительность и стоимость.
Ultralytics Platform предлагает широкий выбор GPU: от RTX 2000 Ada и RTX A4500 до RTX 4000 Ada, RTX A5000, RTX 3090 и RTX A6000, а также более мощных RTX 4090 и RTX PRO 6000.
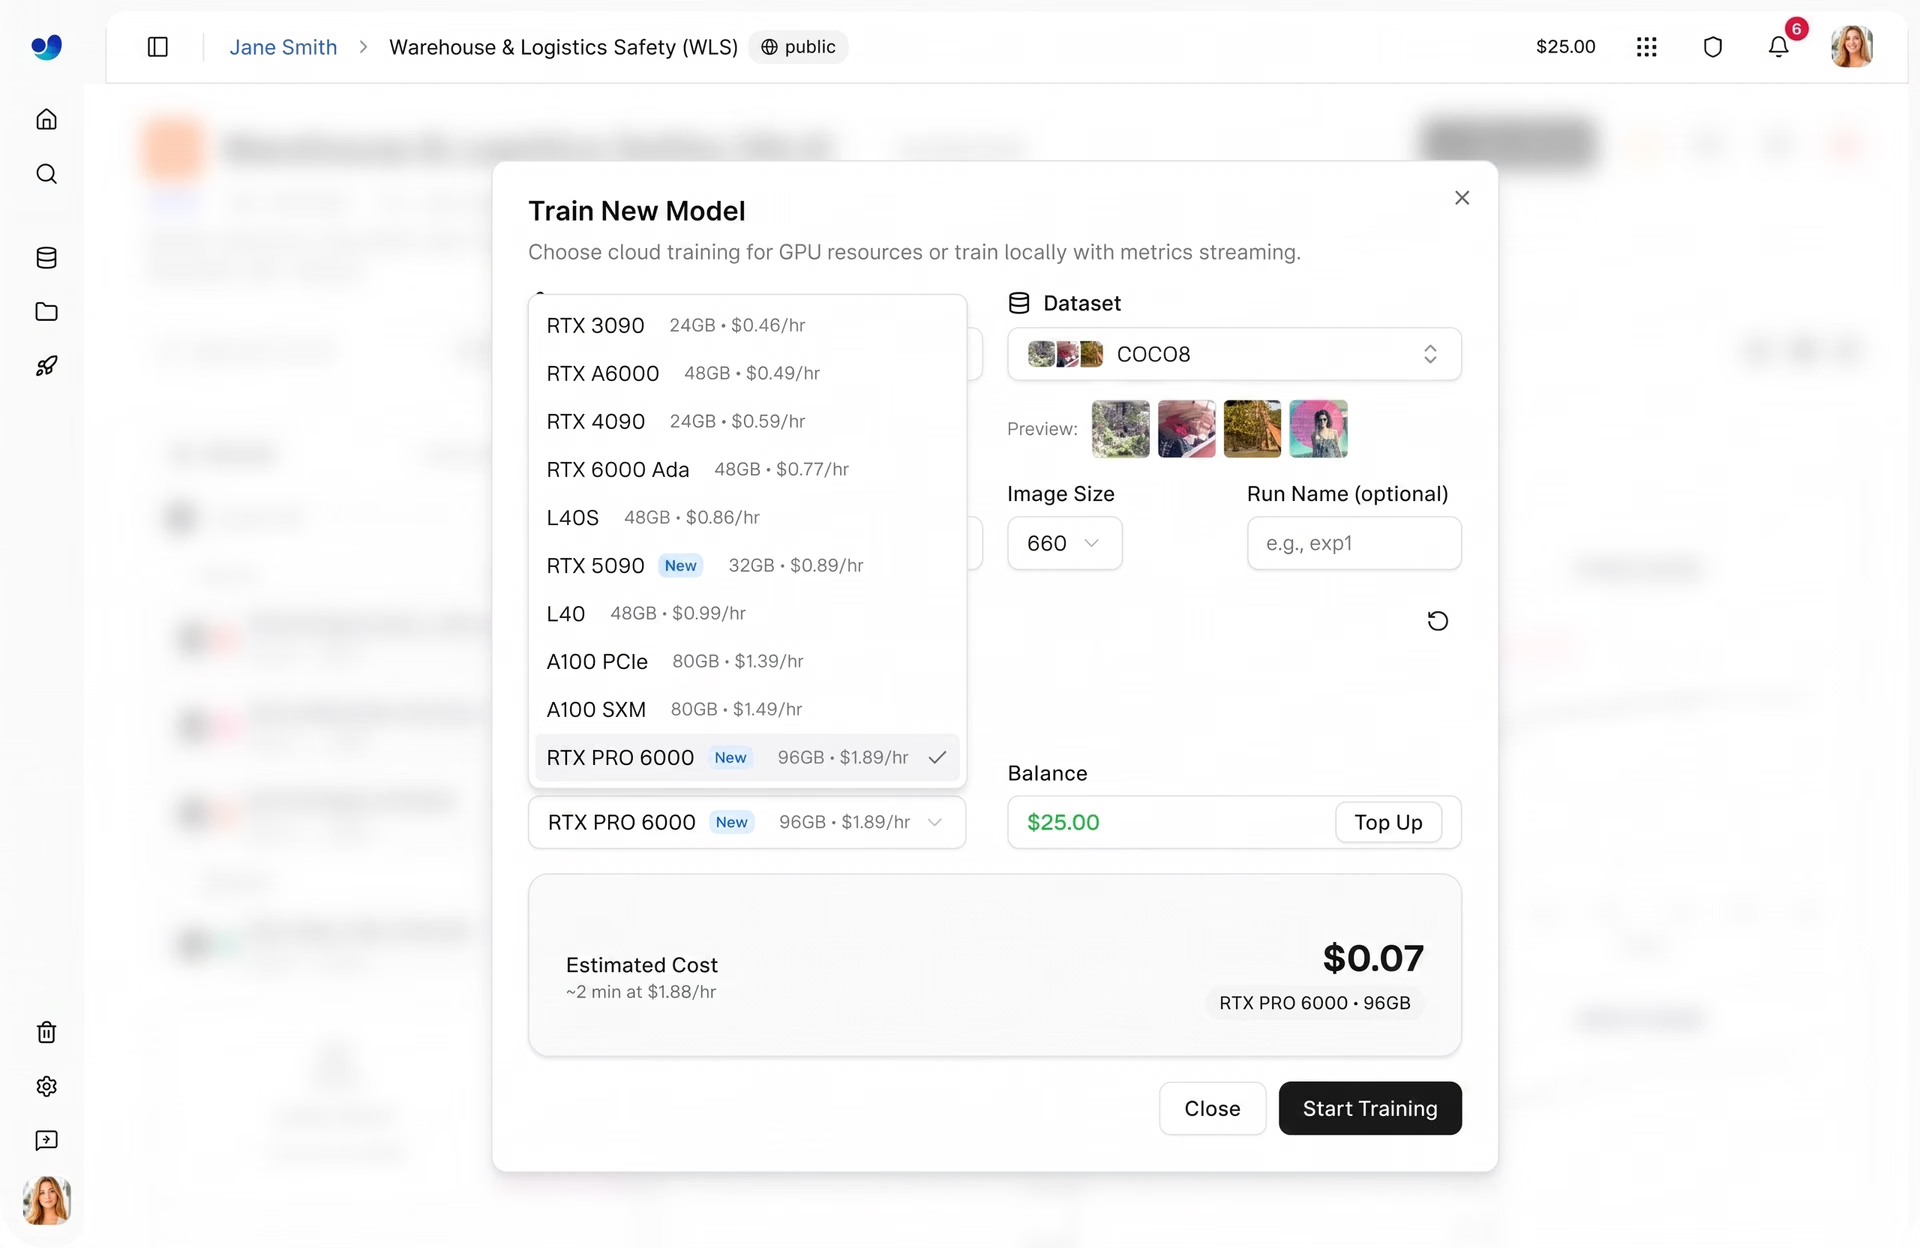
Рис. 2. Пример различных GPU, поддерживаемых Ultralytics Platform (Источник)
Для большинства пользователей RTX PRO 6000 — сбалансированный вариант по умолчанию. Она обеспечивает стабильную производительность при разных нагрузках и не требует сложной настройки. RTX 4090 — еще один популярный вариант с высокой производительностью за свою цену.
Для небольших задач, таких как быстрые эксперименты, создание прототипов или работа с компактными наборами данных, подойдут GPU вроде RTX 2000 Ada и RTX A4500. По мере роста нагрузки RTX 4000 Ada, RTX A5000 и RTX 3090 обеспечат более стабильную производительность при обучении общего назначения.
GPU высокого класса, такие как A100 (Ampere), H100 и H200 (Hopper), а также B200 (Blackwell), предназначены для масштабных задач. Они лучше всего подходят для обучения очень больших моделей, обработки огромных наборов данных и выполнения задач, где критически важны скорость и производительность.
Типы GPU и варианты их применения#
Теперь давай сравним разные типы GPU и разберемся, для каких задач каждый из них подходит лучше всего.
GPU NVIDIA RTX обычно обходятся дешевле и часто используются для повседневного обучения, экспериментов и небольших или средних нагрузок. Они сочетают производительность и доступность, поэтому подходят для самых разных задач.
В отличие от них, GPU A100, A40 и L40 предназначены для более тяжелых нагрузок и обучения в большем масштабе. Они обеспечивают более высокую стабильность и масштабируемость, особенно при работе с крупными наборами данных или сложными моделями.
GPU высокого класса, такие как H100 и модели на архитектуре NVIDIA Blackwell, представляют собой более новое оборудование для ИИ. Они предназначены для высокопроизводительных задач и обычно используются для масштабного обучения, передовых исследований и срочных задач.
Широкий выбор GPU на Ultralytics Platform позволяет подобрать конфигурацию для разных рабочих нагрузок. В зависимости от требований можно начать с небольшой конфигурации и при необходимости масштабировать её.
Как выбрать подходящий облачный GPU для проекта#
Выбирая GPU для облачного обучения на Ultralytics Platform, учитывай несколько факторов, в том числе размер датасета, сложность модели и стоимость. Давай разберём каждый из них.
Как подобрать мощность GPU под размер набора данных#
Один из основных факторов при выборе GPU — размер набора данных, поскольку от него зависят длительность обучения и необходимая вычислительная мощность.
Для небольших датасетов — обычно менее 1 000 изображений — часто достаточно маломощного GPU, например RTX 2000 Ada. Он хорошо подходит для быстрых экспериментов и коротких запусков обучения.
Для наборов среднего размера — примерно от 1000 до 10 000 изображений — GPU вроде RTX 4090 или RTX A6000 обеспечивают более удачный баланс производительности и эффективности, помогая обучать модели без долгих задержек.
Для крупных датасетов, содержащих более 10 000 изображений, вероятно, понадобится более мощное оборудование, чтобы время обучения оставалось приемлемым. GPU, например H100, лучше подходят для ресурсоёмких задач и эффективного масштабирования.
В целом нужно подобрать вычислительную мощность и возможности параллельной обработки в соответствии с размером набора данных.
Как выбрать GPU с учетом размера и сложности модели#
Еще один важный фактор при выборе GPU — размер и сложность твоей модели компьютерного зрения на базе ИИ. Для вычислений моделям разного размера требуется разная мощность.
Например, небольшим моделям требуется меньше вычислительной мощности GPU, поэтому они эффективно работают на RTX 2000 Ada, RTX A4500 или даже RTX 4090, если нужен более быстрый результат. Эти GPU идеально подходят для быстрых экспериментов, прототипирования и несложных задач: они позволяют быстрее перебирать варианты и проверять идеи без больших расходов на вычисления.
С другой стороны, для более крупных и сложных моделей требуется значительно больше памяти и вычислительной мощности. Для таких нагрузок лучше подходят RTX A6000, RTX PRO 6000 и GPU высокого класса, например H100. Они справляются с более крупными архитектурами, сокращают время обучения и предотвращают проблемы с памятью. Это особенно важно при работе с изображениями высокого разрешения, большими размерами пакета или более сложными архитектурами моделей.
Сравнение размера пакета и объема памяти GPU#
Размер пакета также играет важную роль в обучении модели. Размер пакета — это число обучающих примеров, которые модель обрабатывает одновременно за один шаг.
Больший размер пакета может повысить эффективность обучения, поскольку за раз обрабатывается больше данных, но для этого требуется больше памяти GPU (VRAM). Как правило, GPU с большим объёмом памяти поддерживают пакеты большего размера, а GPU с меньшим объёмом памяти могут требовать уменьшения размера пакета.
Например, GPU RTX A6000, RTX PRO 6000 и A100 благодаря большему объему памяти легче справляются с крупными пакетами, тогда как для RTX 4090 или RTX 2000 Ada может потребоваться уменьшить размер пакета в зависимости от нагрузки.
Однако самый мощный GPU нужен не всегда. GPU высокого класса могут повысить скорость и доступную емкость, но стоят дороже. Во многих случаях эффективнее настроить размер пакета на менее мощном GPU.
В конечном счете нужно найти оптимальный баланс между размером пакета, доступной памятью GPU и стоимостью с учетом модели и набора данных.
Как конфигурация обучения влияет на производительность GPU#
На производительность GPU влияет и конфигурация обучения. К ней относятся такие параметры, как количество эпох, размер изображения и другие настройки, определяющие процесс обучения модели.
Например, для изображений большего размера требуется больше вычислений на каждом шаге. Это может замедлить обучение и потребовать большей вычислительной мощности или объема памяти для сохранения высокой производительности.
Аналогично, увеличение количества эпох удлиняет общее время обучения, особенно на менее мощном оборудовании. Эпоха — это один полный проход по всему набору данных во время обучения.
Такие методы, как аугментация данных, также увеличивают вычислительную нагрузку во время обучения. Аугментация данных применяет преобразования — например, отражение, поворот или масштабирование — чтобы повысить разнообразие данных и улучшить производительность модели. Она может повысить устойчивость модели, но также способна замедлить обучение.
Как правило, более мощные GPU эффективнее справляются с повышенной нагрузкой, но результат зависит от общей конфигурации и характера задач.
Как сбалансировать стоимость и время обучения#
При выборе GPU для проекта часто приходится искать компромисс между скоростью обучения и стоимостью GPU.
Ultralytics Platform помогает заранее оценить и понять эти затраты до запуска обучения. На основе выбранной конфигурации, включая размер датасета, модель и GPU, ты можешь заранее увидеть расчётную стоимость и продолжительность обучения.
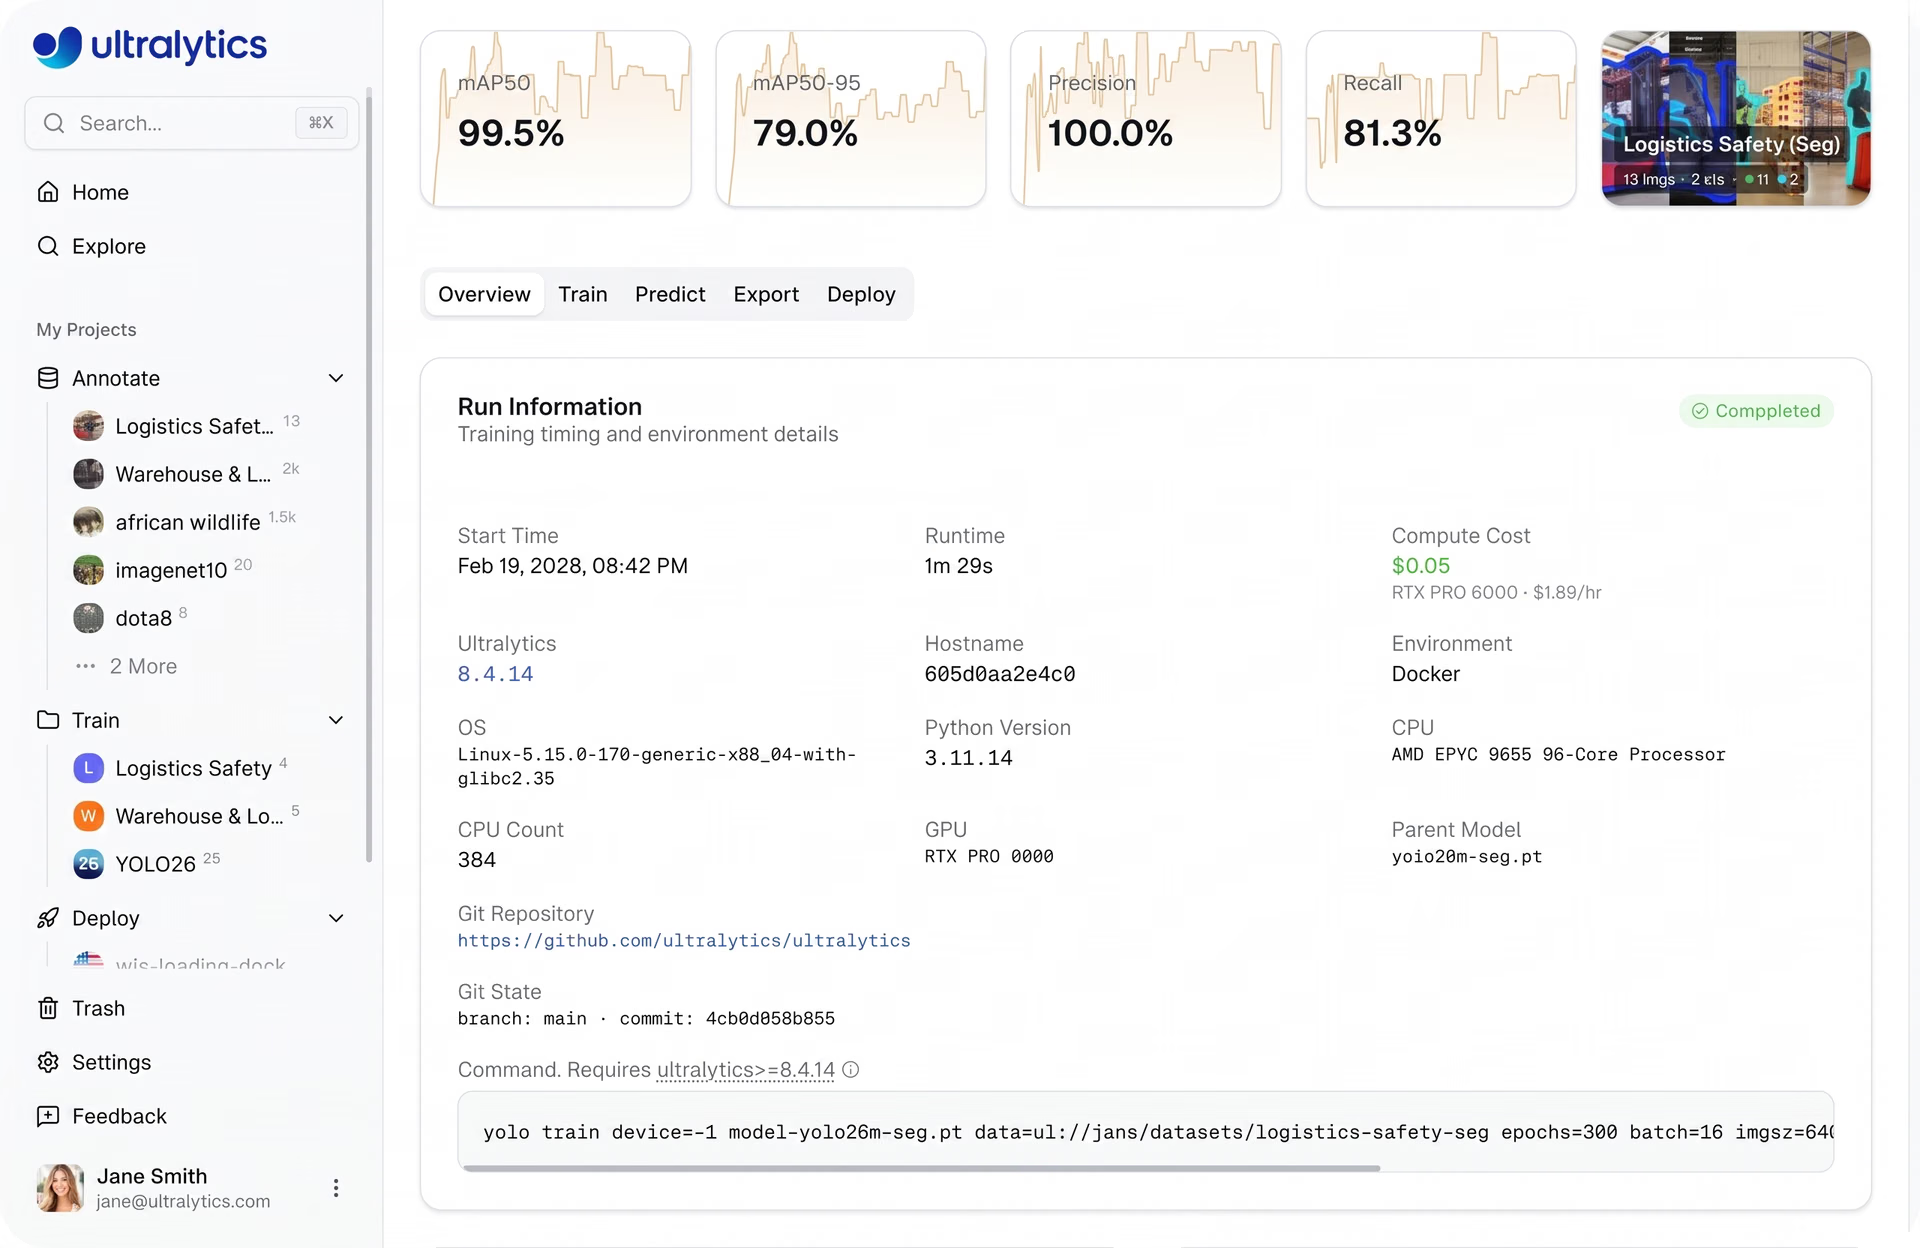
Рис. 3. Ultralytics Platform упрощает оценку и понимание расходов на облачные ресурсы. (Источник)
Быстрые GPU обычно стоят дороже в расчете на час, но могут сократить общее время обучения. GPU RTX 4090, RTX PRO 6000 и H100 обычно позволяют быстрее завершить обучение благодаря более высокой производительности.
Более медленные GPU обычно дешевле в расчете на час, но обучение на них занимает больше времени. Например, RTX 2000 Ada и RTX A4500 часто используют для небольших нагрузок или длительных задач, когда важнее снизить расходы.
Кроме того, самые мощные GPU — B200 и B300 — доступны только в планах Pro или Enterprise, а все остальные варианты доступны и на тарифе Free.
Стратегии оптимизации расходов#
Помимо выбора подходящего GPU, есть несколько практических способов контролировать расходы на обучение (подробнее об этом рассказывается в уроке Ultralytics Academy о том, как планировать бюджет проекта на Platform). Один из самых эффективных подходов — начать с небольших тестовых запусков, прежде чем масштабировать процесс.
Вместо того чтобы сразу запускать полноценное обучение, начни с меньшего числа эпох, чтобы убедиться, что настройка работает как ожидается. Так ты быстро проверишь данные, аннотации и конфигурацию модели и не потратишь время и вычислительные ресурсы на запуски, которые могут не дать полезных результатов.
По мере обучения следи за метриками и досрочно останавливай запуски, если качество перестаёт расти или выходит на плато. Мониторинг кривых обучения поможет решить, стоит ли продолжать или изменить настройки.
Ты также можешь настроить такие параметры, как размер батча и размер изображения. Меньшие значения сокращают потребление памяти и вычислительных ресурсов, поэтому удобнее экспериментировать, тестировать разные конфигурации или проводить небольшие симуляции перед масштабированием.
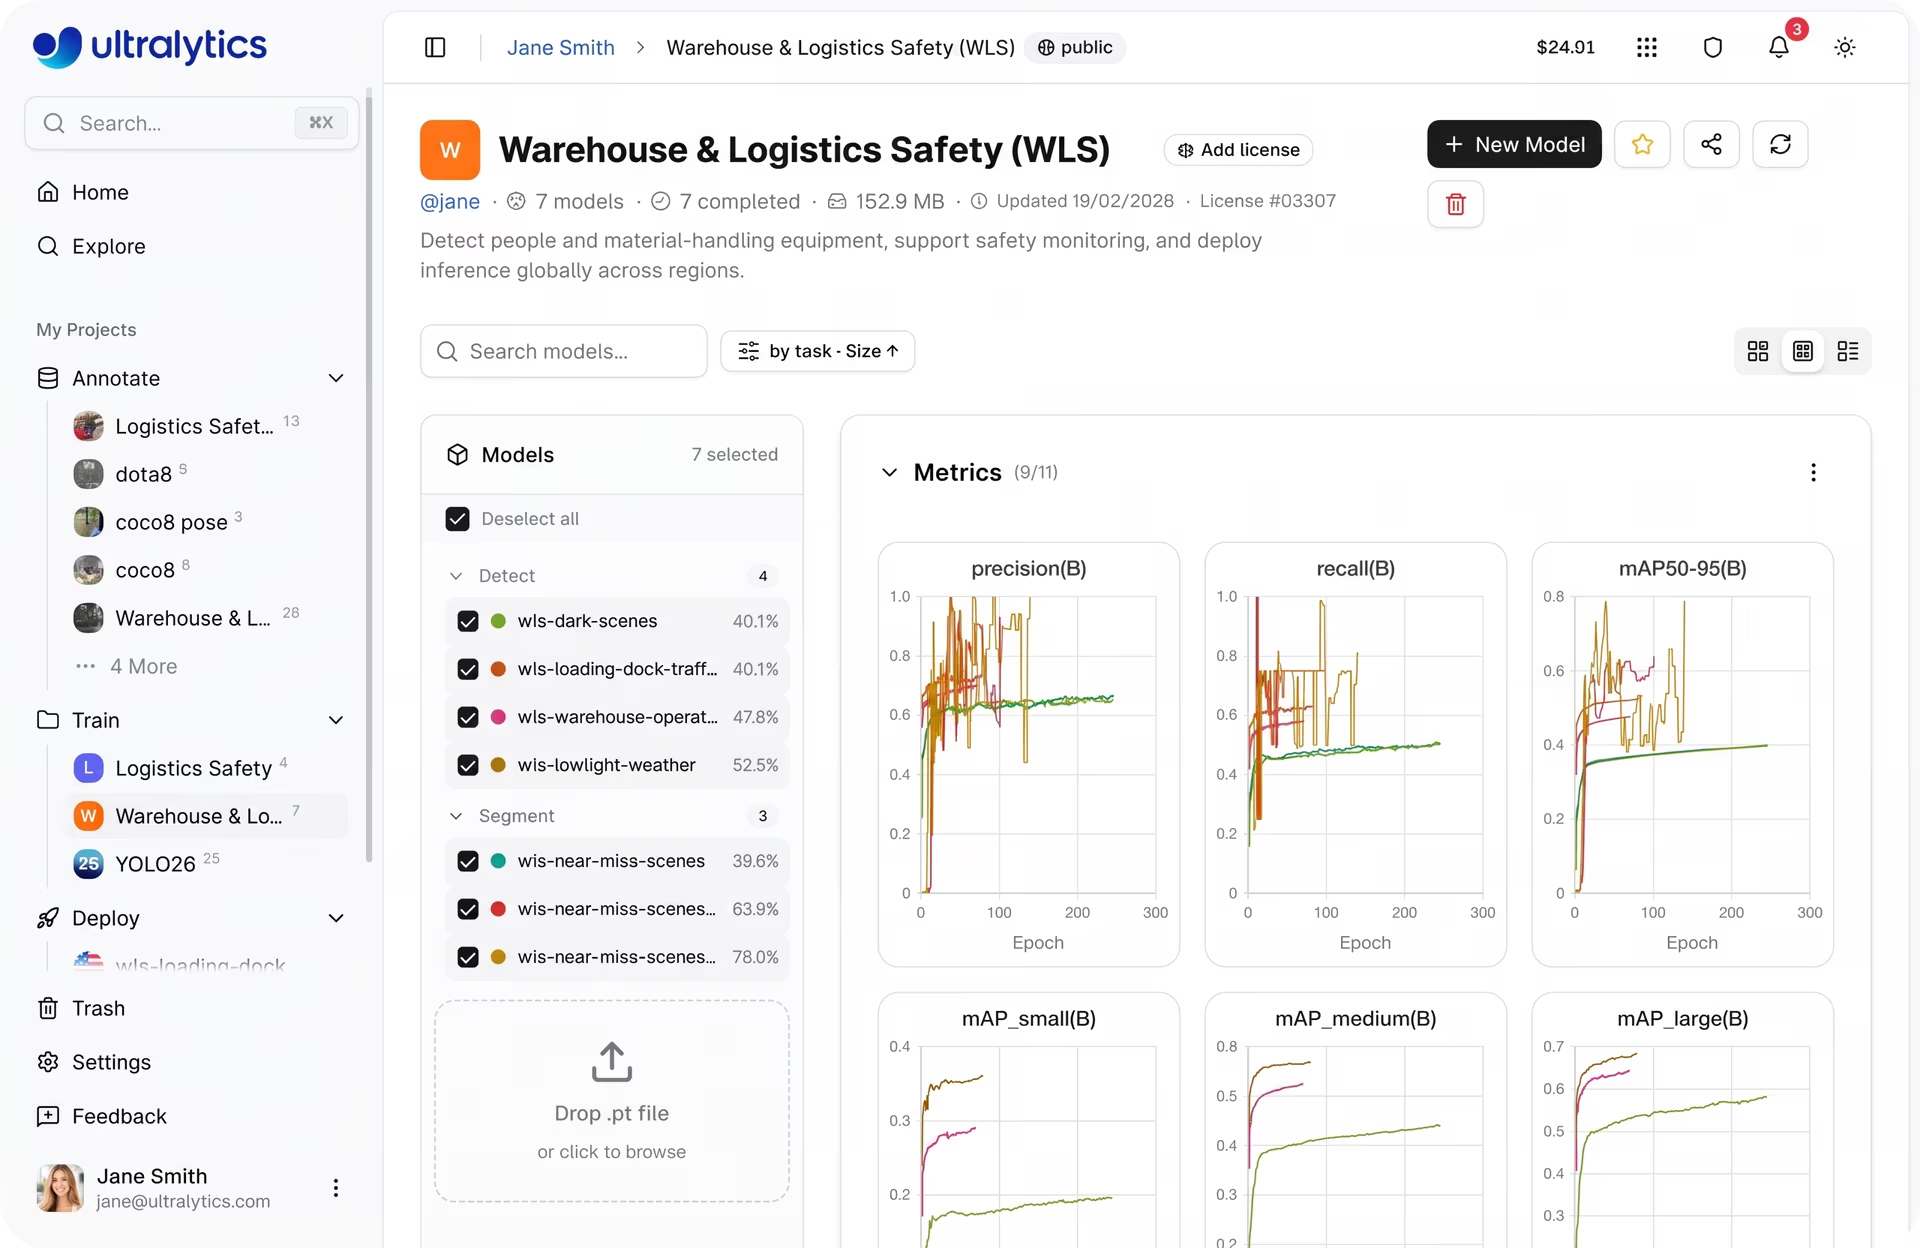
Рис. 4. Визуализация метрик обучения на платформе Ultralytics (Источник)
Кроме того, платформа Ultralytics упрощает управление расходами. В неё встроена оценка стоимости, которая позволяет узнать предполагаемые затраты до запуска задачи.
При системе на основе кредитов с оплатой по факту использования ты платишь только за фактически использованное вычислительное время. Так проще не выходить за рамки бюджета и масштабировать процесс, когда ты убедишься, что настройки обучения подходят.
Рекомендации по обучению моделей компьютерного зрения на облачных GPU#
Вот несколько рекомендаций, которые стоит учитывать при обучении на облачных GPU в Ultralytics Platform:
- Проверяй наборы данных перед обучением: Перед началом убедись, что набор данных чистый, хорошо размечен и согласован. Раннее выявление проблем помогает избежать лишних затрат вычислительных ресурсов и повысить качество модели.
- Сначала проводи быстрые эксперименты: Начни с небольших тестовых запусков и меньшего числа эпох, чтобы проверить настройки. Так ты выявишь проблемы заранее и не будешь тратить ресурсы на длительное и дорогостоящее обучение. По сути, ты создаёшь шаблон, который можно повторно использовать и масштабировать, когда всё заработает как ожидается.
- Отслеживай основные метрики: Следи за такими метриками, как функция потерь, mAP, точность и полнота, на протяжении всего обучения. Эти метрики служат ориентирами для оценки качества модели и помогают решить, когда нужно изменить настройки или остановить обучение.
- Поддерживай эффективность конвейеров обработки данных: Убедись, что загрузка и предобработка данных выполняются эффективно: эти операции используют ресурсы CPU и могут стать узким местом, влияющим на общую производительность обучения.
- Используй встроенные инструменты: Используй графики, журналы консоли и системные метрики, чтобы отслеживать обучение в реальном времени и быстро принимать обоснованные решения.
Главные выводы#
Чтобы выбрать подходящий облачный GPU для компьютерного зрения на платформе Ultralytics, нужно понимать особенности своей рабочей нагрузки, включая размер набора данных, сложность модели и конфигурацию обучения. Благодаря широкому выбору GPU на базе облачной инфраструктуры и виртуальных машин ты можешь начать со сбалансированного варианта и масштабировать ресурсы по мере роста потребностей в обучении или дообучении модели. Сочетая подходящее оборудование с такими полезными практиками, как мониторинг и контроль затрат, ты сможешь эффективно обучать современные модели искусственного интеллекта и максимально использовать гибкость высокопроизводительных вычислений.
Загляни в наше растущее сообщество и репозиторий GitHub, чтобы узнать больше о компьютерном зрении. Если ты хочешь создавать решения для компьютерного зрения, ознакомься с нашими вариантами лицензирования. На страницах решений ты найдёшь больше информации о преимуществах компьютерного зрения в производстве и ИИ в сельском хозяйстве.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









