Endpoint suy luận chuyên dụng và suy luận dùng chung cho triển khai
Tìm hiểu khi nào nên chọn endpoint suy luận chuyên dụng trên Ultralytics Platform để triển khai AI thị giác có khả năng mở rộng và độ trễ thấp thay vì suy luận dùng chung.
Gần đây, chúng tôi đã giới thiệu Ultralytics Platform, một giải pháp đầu cuối đưa toàn bộ quy trình làm việc về thị giác máy tính vào cùng một nơi, từ chuẩn bị dataset và huấn luyện model đến inference, triển khai và giám sát.
Được xây dựng dựa trên phản hồi từ cộng đồng thị giác máy tính, nền tảng này được thiết kế để đơn giản hóa từng giai đoạn phát triển bằng cách cung cấp các tính năng tích hợp hỗ trợ toàn bộ vòng đời của ứng dụng AI thị giác.
Ví dụ: sau khi huấn luyện xong model, bước tiếp theo là triển khai để có thể chạy inference và đưa ra dự đoán trong các ứng dụng thực tế. Nền tảng giúp quy trình này trở nên đơn giản nhờ cung cấp nhiều tùy chọn triển khai.
Bạn có thể export model để chạy trong môi trường riêng, sử dụng inference dùng chung để kiểm thử nhanh hoặc triển khai endpoint chuyên dụng cho các ứng dụng có khả năng mở rộng và sẵn sàng đưa vào production. Mỗi tùy chọn triển khai này đều cho phép chạy inference AI, nhưng được thiết kế cho các giai đoạn và trường hợp sử dụng khác nhau.
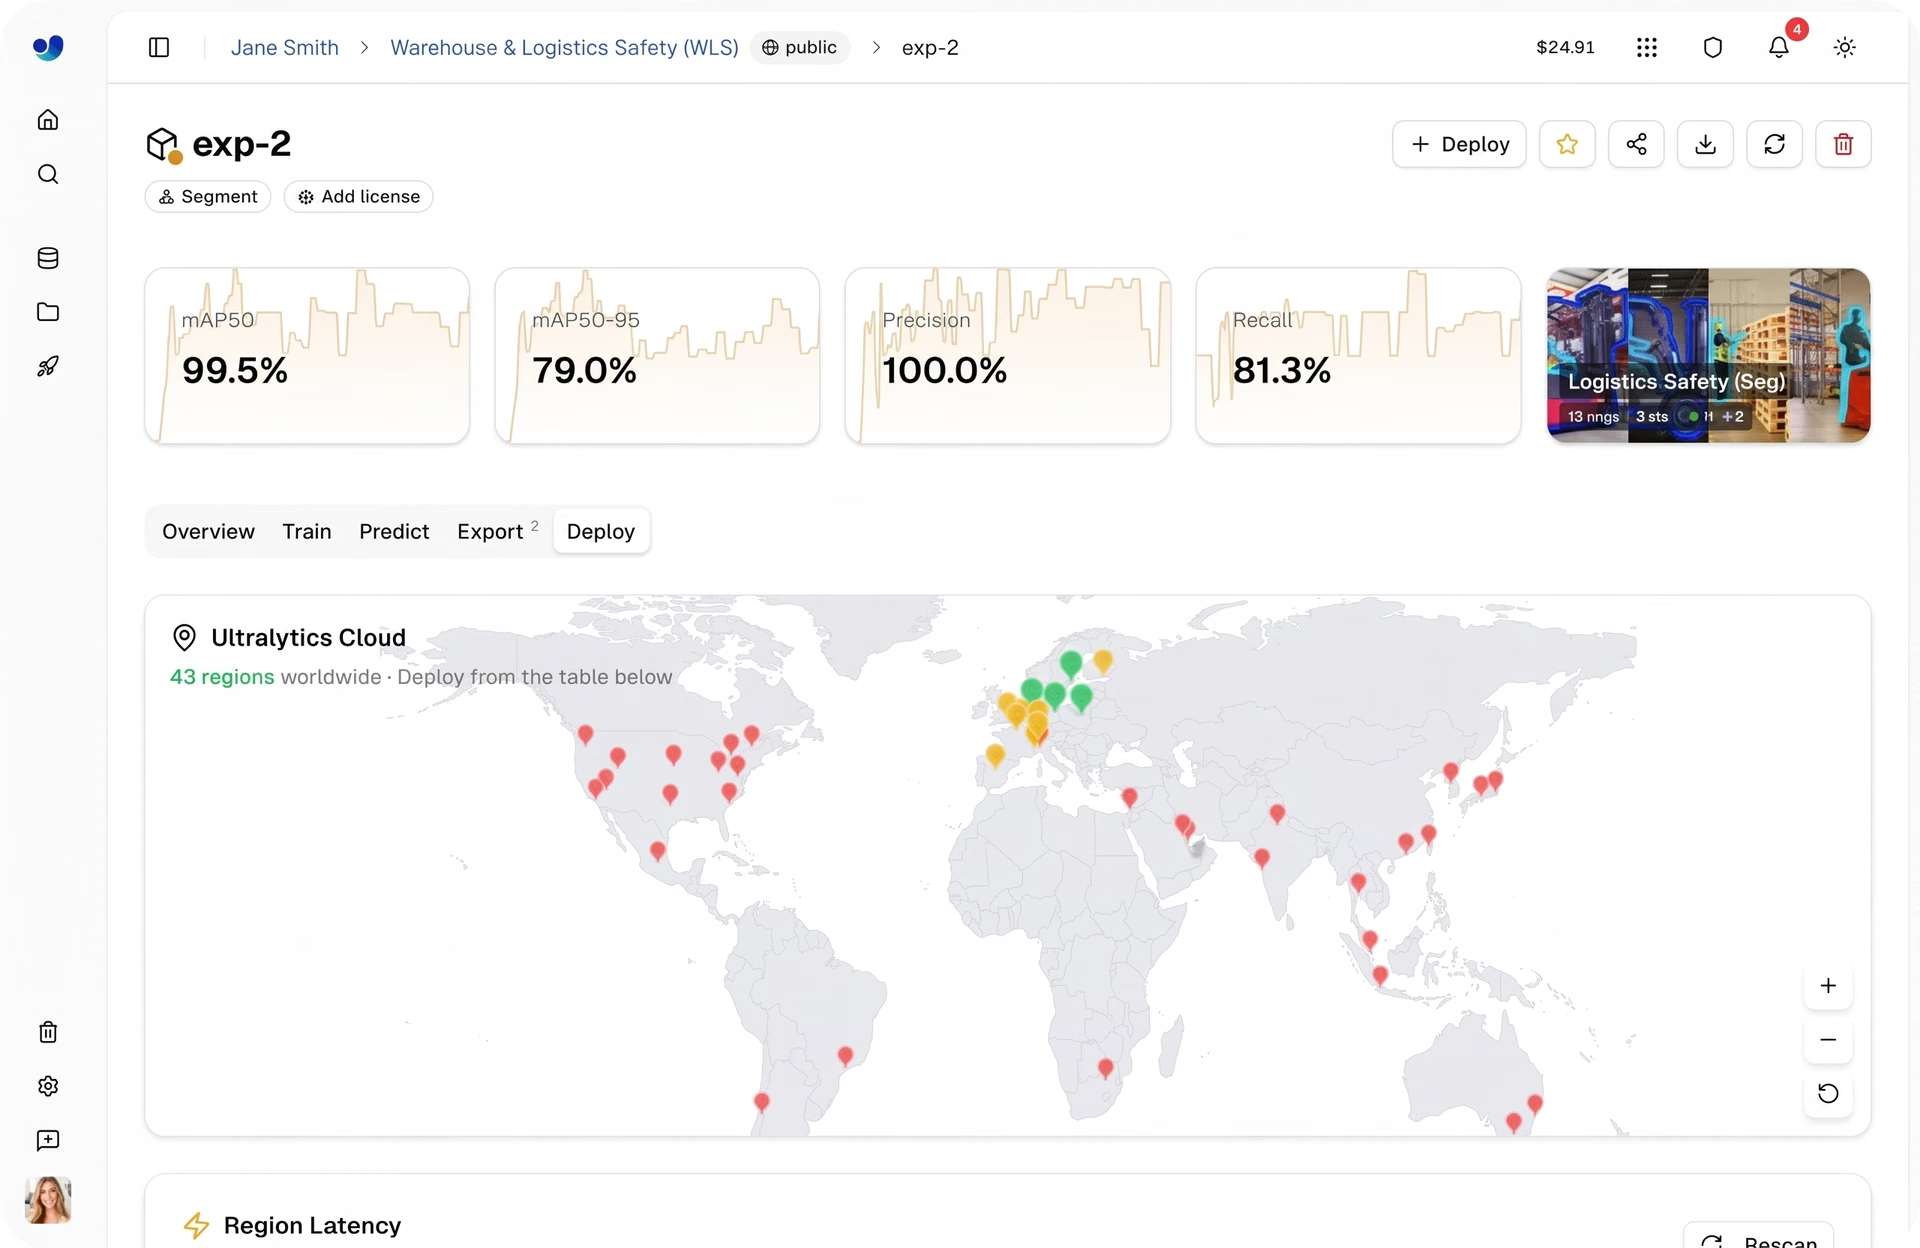
Hình 1. Ultralytics Platform hỗ trợ triển khai model AI thị giác trên toàn cầu với khả năng mở rộng (Nguồn)
Export model giúp bạn toàn quyền kiểm soát việc chạy model trên hạ tầng riêng, inference dùng chung giúp kiểm thử và thử nghiệm dễ dàng mà không cần thiết lập, còn endpoint chuyên dụng được xây dựng cho khối lượng công việc production quy mô lớn, đòi hỏi độ tin cậy cao.
Thoạt nhìn, inference dùng chung và endpoint chuyên dụng có vẻ khá giống nhau. Cả hai đều cho phép bạn gửi yêu cầu API đến model và nhận dự đoán có cấu trúc, giúp dễ dàng tích hợp AI thị giác vào ứng dụng.
Tuy nhiên, khi khối lượng công việc tăng lên và ứng dụng thị giác máy tính bắt đầu xử lý các yêu cầu inference theo thời gian thực, sự khác biệt giữa các tùy chọn này càng trở nên quan trọng. Trong bài viết này, chúng ta sẽ tìm hiểu kỹ hơn về inference dùng chung và endpoint chuyên dụng, cách so sánh, thời điểm sử dụng từng loại và lý do endpoint chuyên dụng trở thành lựa chọn tốt hơn khi ứng dụng mở rộng.
Tổng quan về triển khai bằng inference dùng chung#
Inference dùng chung là cách đơn giản để chạy inference AI trên model mà không cần thiết lập hạ tầng hay lo lắng về loại GPU, tích hợp framework hoặc cấu hình runtime. Sau khi huấn luyện hoặc fine-tune model, bạn có thể dùng model để đưa ra dự đoán trực tiếp thông qua nền tảng.
Trong thiết lập này, model của bạn chạy trên các tài nguyên tính toán dùng chung, đa tenant tại một số khu vực chính như Mỹ, châu Âu và châu Á-Thái Bình Dương. Các yêu cầu được tự động định tuyến đến những dịch vụ khả dụng, vì vậy bạn không cần cấu hình phiên bản GPU hay môi trường runtime. Mọi thứ đều được xử lý sẵn, giúp bạn dễ dàng bắt đầu.
Khi sử dụng inference dùng chung, bạn gửi yêu cầu đến model thông qua REST API bằng các công cụ như Python hoặc CLI, rồi nhận đầu ra JSON có cấu trúc, chẳng hạn như các đối tượng được phát hiện, điểm confidence và những thông tin chi tiết khác về dự đoán. Nhờ vậy, việc kiểm thử model và tích hợp model vào ứng dụng trở nên liền mạch.
Do sử dụng chung tài nguyên, hệ thống được thiết kế cho phát triển, kiểm thử và nhu cầu sử dụng nhẹ. Hệ thống phù hợp để xác thực dự đoán và xây dựng các tích hợp ban đầu. Tuy nhiên, hiệu suất có thể thay đổi tùy theo tải hệ thống và mức sử dụng bị giới hạn ở 20 yêu cầu mỗi phút cho mỗi API key, nên giải pháp này kém phù hợp hơn với khối lượng công việc production cần thông lượng cao.
Nhìn chung, inference dùng chung phù hợp nhất với giai đoạn phát triển ban đầu, khi trọng tâm là tìm hiểu và cải thiện model trước khi chuyển sang các ứng dụng quy mô lớn hơn.
Triển khai model trên toàn cầu bằng endpoint chuyên dụng#
Endpoint chuyên dụng là dịch vụ inference đơn tenant, nơi các model AI thị giác của bạn chạy trên tài nguyên tính toán tách biệt. Thay vì dùng chung hạ tầng, mỗi endpoint có runtime riêng với các tài nguyên có thể cấu hình như CPU và bộ nhớ, giúp bạn kiểm soát hiệu suất tốt hơn.
Khi triển khai model dưới dạng endpoint chuyên dụng, model được cấp một URL API duy nhất và sử dụng API key của bạn để xác thực, giúp dễ dàng tích hợp vào ứng dụng. Có thể triển khai các endpoint này tại 43 khu vực trên toàn cầu, cho phép chạy inference gần người dùng hơn và giảm độ trễ.
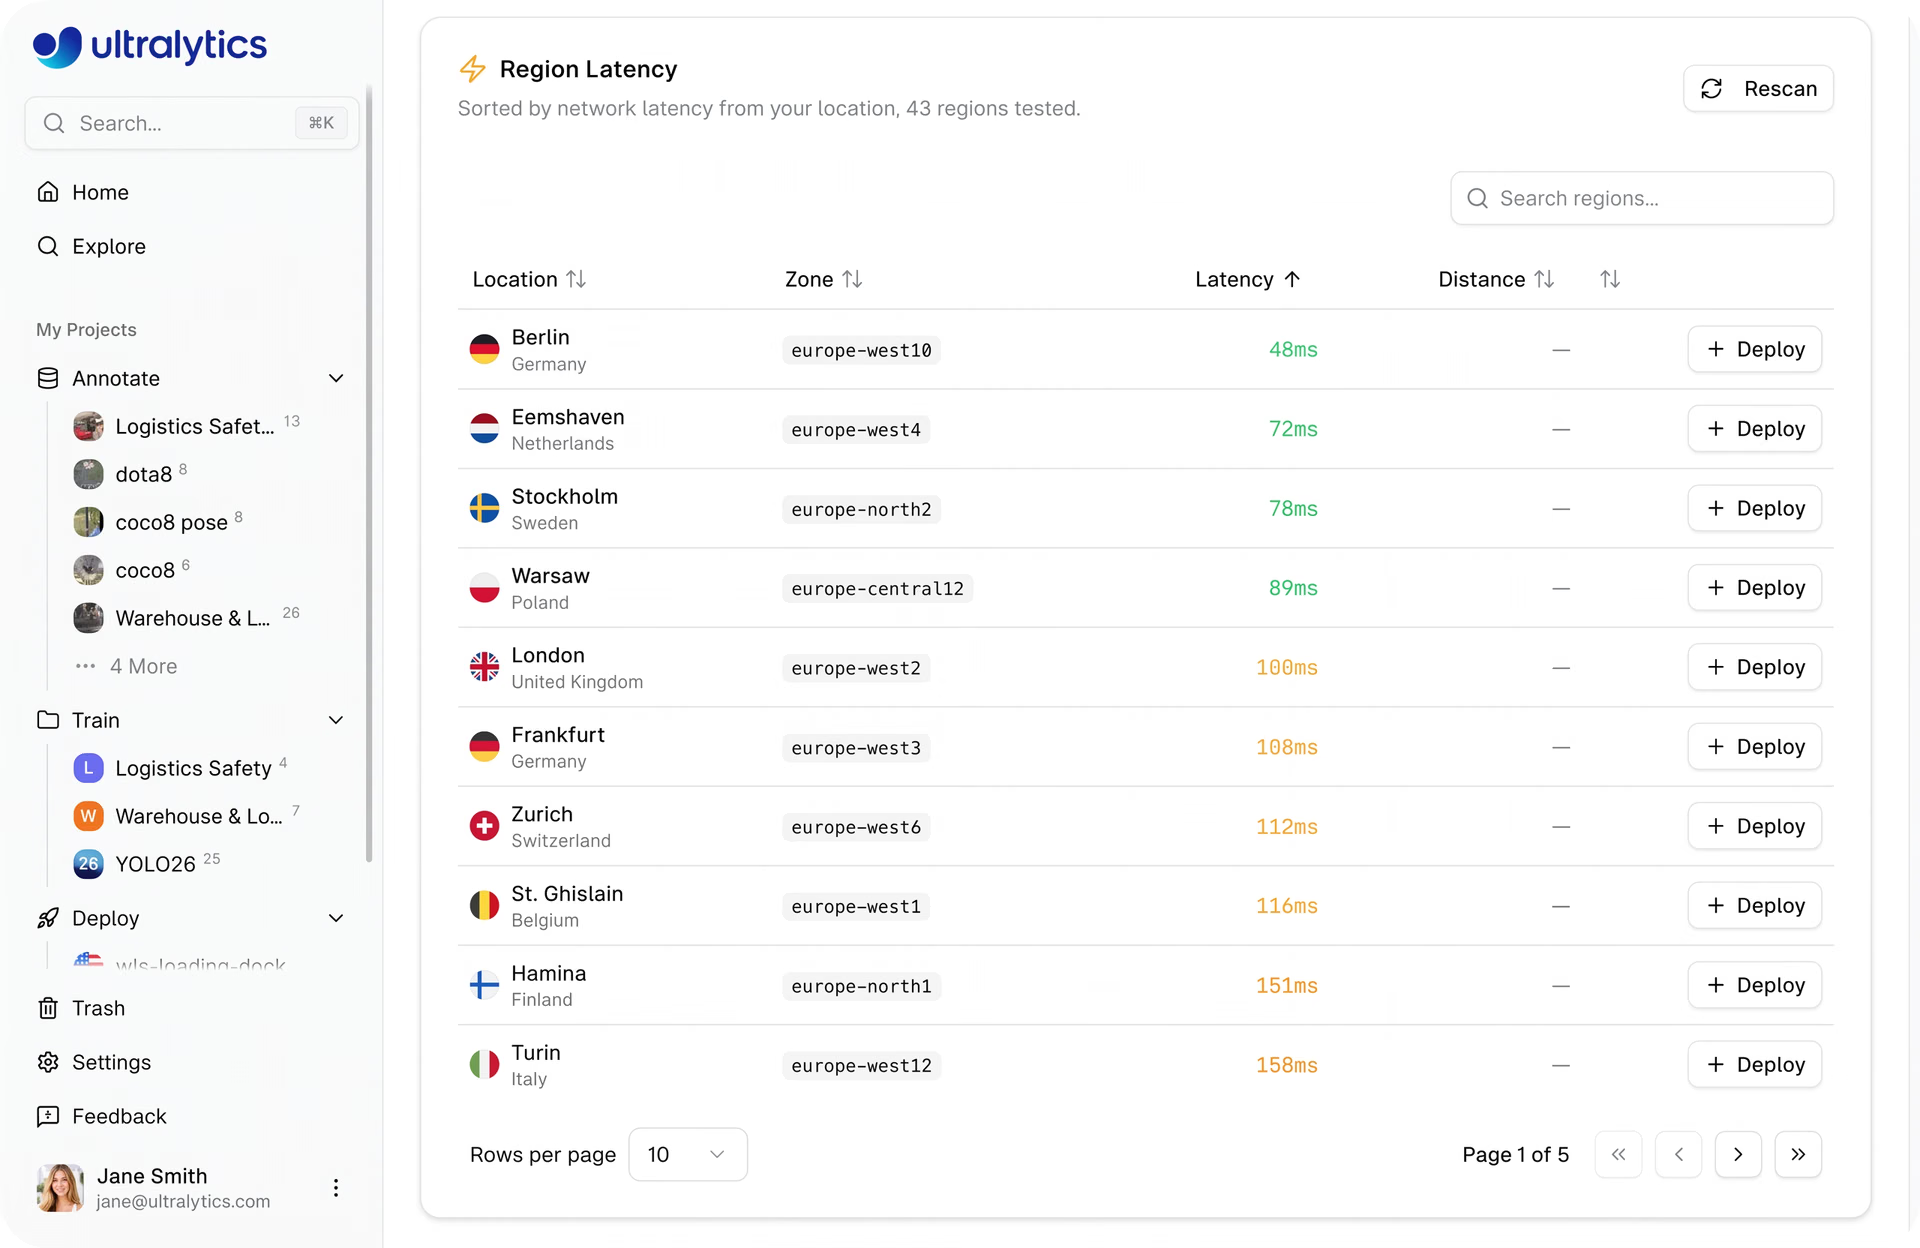
Hình 2. Bạn có thể triển khai endpoint chuyên dụng tại 43 khu vực trên toàn cầu (Nguồn)
Một trong những ưu điểm chính là tự động mở rộng quy mô. Endpoint tự động điều chỉnh theo các yêu cầu đến, mở rộng để xử lý lưu lượng cao hơn và thu hẹp khi nhu cầu giảm. Theo mặc định, tính năng thu về 0 được bật, cho phép endpoint tắt khi không hoạt động và khởi động lại khi cần, giúp tối ưu hóa việc sử dụng tài nguyên.
Nói cách khác, endpoint chuyên dụng được thiết kế cho khối lượng công việc production. So với inference dùng chung, endpoint chuyên dụng mang lại độ trễ thấp ổn định, thông lượng cao hơn và độ tin cậy tốt hơn.
Ngoài ra, endpoint chuyên dụng không có giới hạn tốc độ. Yêu cầu được gửi trực tiếp đến endpoint, vì vậy lưu lượng bạn có thể xử lý phụ thuộc vào thiết lập và khả năng mở rộng của bạn thay vì các giới hạn cố định.
Bên cạnh đó, tính năng giám sát, nhật ký, kiểm tra tình trạng cùng hành vi runtime và khởi động có thể dự đoán được tích hợp sẵn giúp dễ dàng theo dõi hiệu suất và duy trì các triển khai ổn định trên mọi gói dịch vụ. Trên gói Free, quá trình khởi động nguội thường mất từ 5 đến 45 giây, trong khi endpoint thuộc gói Pro luôn ở trạng thái sẵn sàng, giúp inference nhanh hơn và có hiệu suất dễ dự đoán hơn.
Nói đơn giản, endpoint chuyên dụng là lựa chọn lý tưởng cho các ứng dụng AI thị giác theo thời gian thực cần inference đáng tin cậy, có khả năng mở rộng và hiệu năng cao.
Inference dùng chung và endpoint chuyên dụng: Những khác biệt chính#
Dưới đây là phần so sánh chi tiết hơn giữa inference dùng chung và endpoint chuyên dụng:
- Độ trễ: Độ trễ trong môi trường dùng chung có thể thay đổi do chia sẻ tài nguyên, trong khi endpoint chuyên dụng cung cấp phản hồi ổn định hơn với độ trễ thấp.
- Khu vực: Inference dùng chung khả dụng tại một số khu vực (Mỹ, EU, AP), trong khi endpoint chuyên dụng hỗ trợ triển khai tại 43 khu vực trên toàn cầu.
- Khả năng mở rộng: Không thể cấu hình khả năng mở rộng của inference dùng chung, trong khi endpoint chuyên dụng tự động mở rộng theo lưu lượng yêu cầu đến.
- Giới hạn tốc độ: Inference dùng chung bị giới hạn tốc độ (20 yêu cầu hoặc lệnh gọi API mỗi phút cho mỗi API key), trong khi endpoint chuyên dụng không bị giới hạn tốc độ ở cấp nền tảng.
- Giá: Inference dùng chung được bao gồm mà không mất thêm chi phí cho mục đích kiểm thử và phát triển, trong khi endpoint chuyên dụng cung cấp khả năng kiểm soát và mở rộng tốt hơn; mức sử dụng tùy thuộc vào cấu hình tài nguyên và nhu cầu triển khai.
Vì sao endpoint chuyên dụng phù hợp hơn với khối lượng công việc production#
Khi các ứng dụng AI và machine learning chuyển từ kiểm thử sang sử dụng thực tế, hiệu suất, khả năng mở rộng và độ tin cậy trở nên thiết yếu. Đó là lý do endpoint chuyên dụng có những ưu điểm rõ rệt so với inference dùng chung.
Với endpoint chuyên dụng, model dựng sẵn hoặc model tùy chỉnh của bạn chạy trên tài nguyên tính toán riêng, nên hiệu suất không bị ảnh hưởng bởi người dùng khác. Điều này giúp duy trì độ trễ thấp và ổn định, yếu tố quan trọng đối với các ứng dụng thời gian thực như phân tích video và hệ thống giám sát.
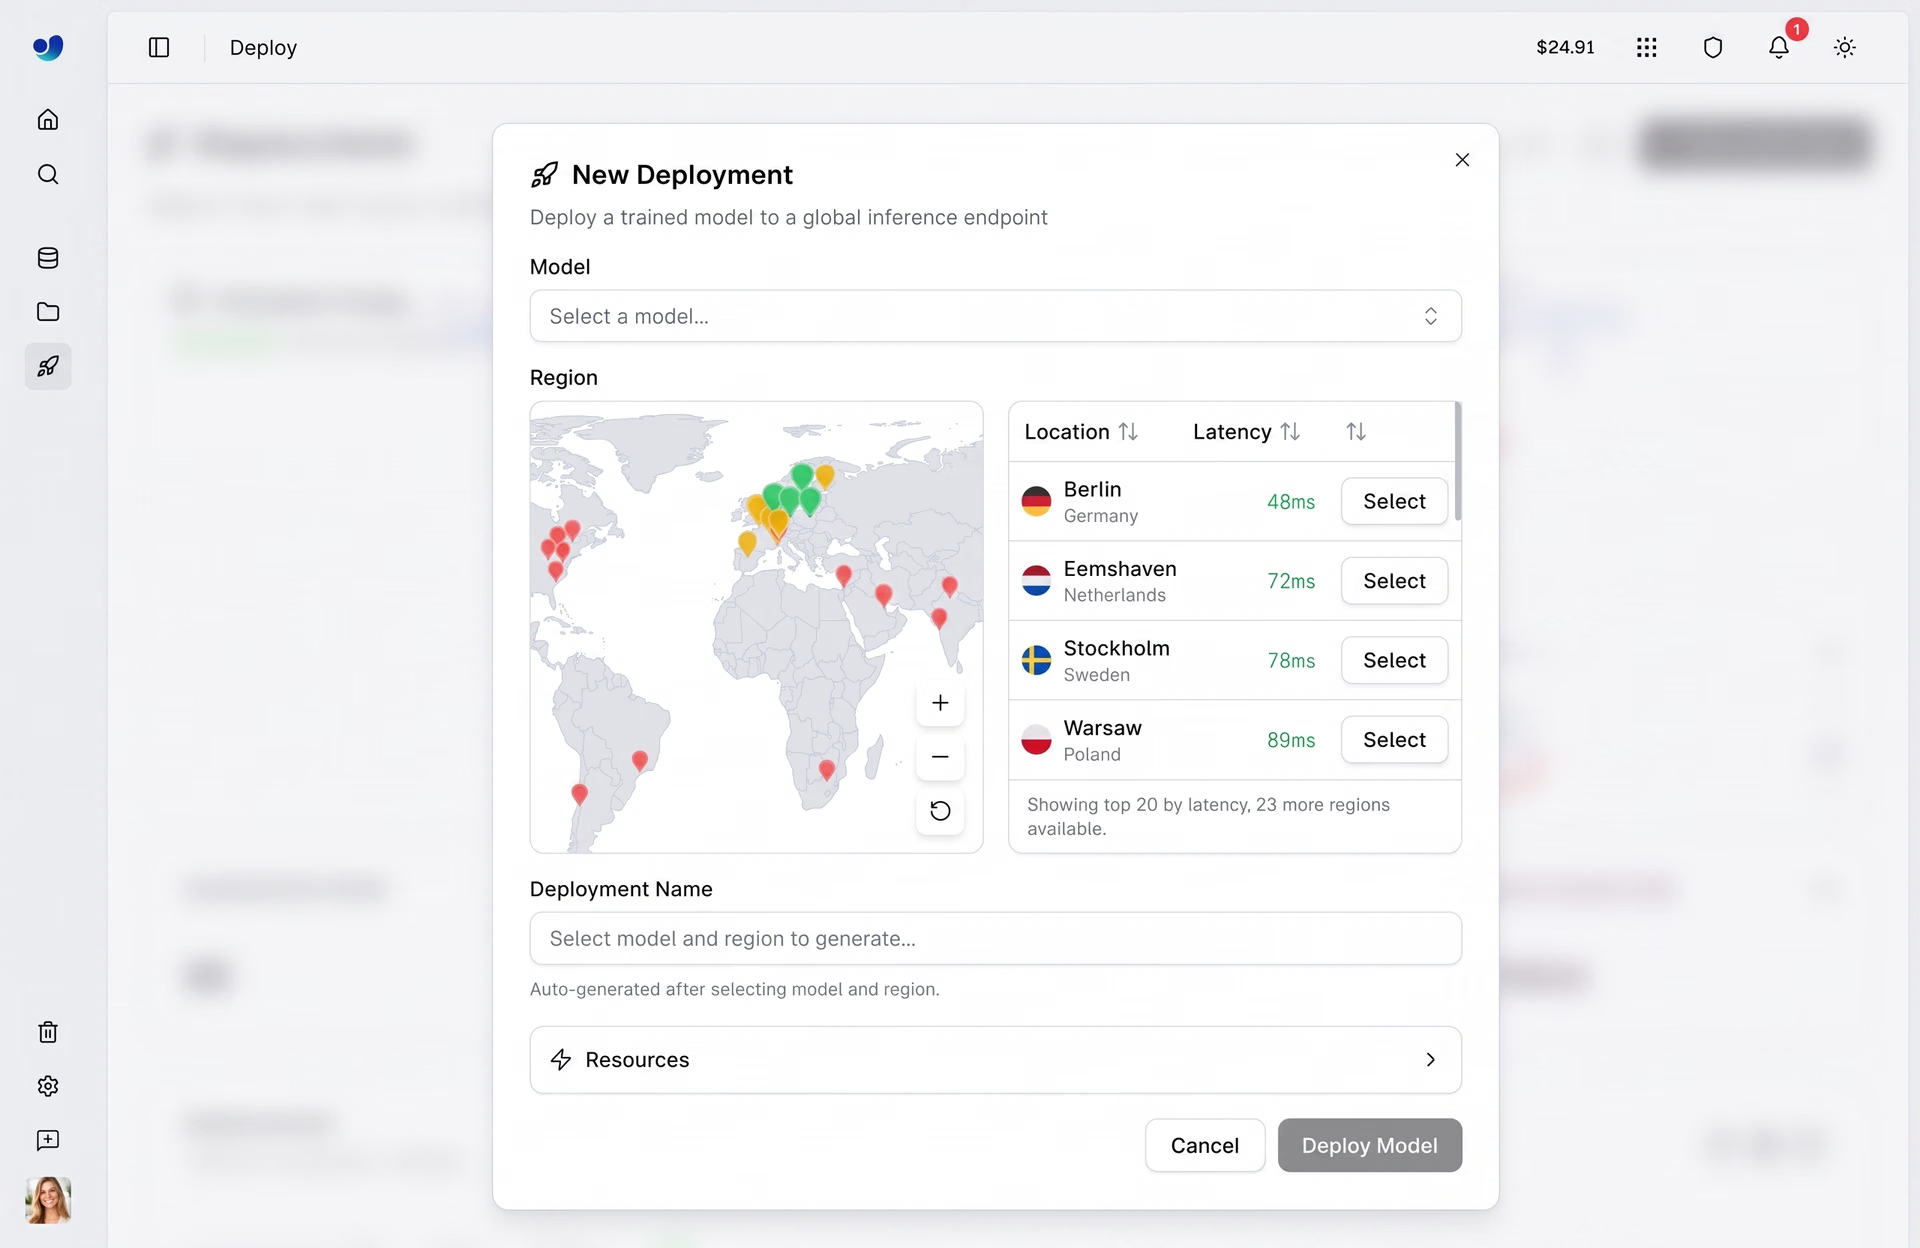
Hình 3. Tổng quan về triển khai bằng endpoint inference chuyên dụng (Nguồn)
Ví dụ, hãy hình dung một hệ thống phân tích bán lẻ xử lý luồng hình ảnh trực tiếp từ camera tại nhiều cửa hàng. Bằng cách triển khai endpoint tại 43 khu vực trên toàn cầu, inference có thể chạy gần từng cửa hàng hơn, giảm độ trễ và cải thiện thời gian phản hồi.
Với inference dùng chung, nơi tài nguyên được chia sẻ và số khu vực bị giới hạn, hiệu suất có thể thay đổi vào những thời điểm cao điểm.
Endpoint chuyên dụng cũng có thể xử lý lưu lượng cao hơn và tự động mở rộng theo nhu cầu. Với tính năng giám sát, nhật ký và kiểm tra tình trạng tích hợp sẵn, endpoint chuyên dụng mang lại hiệu suất dễ dự đoán hơn, phù hợp với các khối lượng công việc AI liên tục và quy mô lớn.
Vai trò của inference dùng chung trong quy trình làm việc AI thị giác#
Khi tìm hiểu sự khác biệt giữa inference dùng chung và endpoint chuyên dụng, có thể bạn sẽ thắc mắc inference dùng chung phù hợp ở đâu trong toàn bộ quy trình làm việc về thị giác máy tính.
Hãy cùng xem lại ví dụ về phân tích bán lẻ. Trước khi triển khai giải pháp thị giác tại nhiều cửa hàng, các nhóm thường cần kiểm thử hiệu suất trên dữ liệu thực tế và tinh chỉnh giải pháp dựa trên kết quả đó.
Inference dùng chung giúp đơn giản hóa quy trình này bằng cách cho phép bạn gửi ảnh mẫu hoặc khung hình video từ camera cửa hàng rồi nhanh chóng xem lại các dự đoán mà không cần thiết lập hạ tầng. Tính năng này đặc biệt hữu ích để kiểm thử hành vi của model, gỡ lỗi các dự đoán sai và xác thực kết quả trong những điều kiện khác nhau, chẳng hạn như thay đổi về ánh sáng hoặc bố cục cửa hàng.
Thông qua quá trình lặp lại như vậy, các nhóm có thể cải thiện độ chính xác và độ tin cậy của model trước khi đưa vào production. Khi model hoạt động tốt trong những kịch bản kiểm thử này, bạn có thể triển khai model lên endpoint chuyên dụng để sử dụng theo thời gian thực tại nhiều địa điểm.
Inference dùng chung cũng phù hợp với các ứng dụng có tần suất sử dụng thấp hoặc không thường xuyên. Chẳng hạn, một cửa hàng bán lẻ nhỏ có thể thỉnh thoảng dùng giải pháp này để phân tích lưu lượng người qua lại hoặc xem xét hoạt động của khách hàng vào những thời điểm cụ thể mà không cần triển khai ở quy mô đầy đủ. Trong những trường hợp này, inference dùng chung là cách đơn giản và tiết kiệm chi phí để chạy inference theo nhu cầu.
Các trường hợp sử dụng endpoint chuyên dụng trong thực tế#
Khi ứng dụng AI vượt ra ngoài giai đoạn kiểm thử, lựa chọn triển khai bắt đầu ảnh hưởng trực tiếp đến hiệu suất, khả năng mở rộng và trải nghiệm người dùng. Endpoint chuyên dụng có thể được sử dụng rộng rãi trong nhiều ngành vì mang lại hiệu suất ổn định, độ trễ thấp và khả năng xử lý khối lượng công việc quy mô lớn.
Dưới đây là một số trường hợp sử dụng phổ biến cho thấy endpoint chuyên dụng có thể được ứng dụng trong thực tế:
- Bán lẻ và phân tích video: Một chuỗi bán lẻ có thể sử dụng thị giác máy tính để theo dõi di chuyển của khách hàng, xác định sản phẩm được ưa chuộng và giám sát hoạt động tại cửa hàng theo thời gian thực. Endpoint chuyên dụng giúp inference nhanh và ổn định tại nhiều cửa hàng, kể cả trong giờ cao điểm.
- Sản xuất và kiểm tra chất lượng: Trên dây chuyền sản xuất, model có thể phát hiện lỗi hoặc điểm bất thường khi sản phẩm di chuyển qua hệ thống. Endpoint chuyên dụng hỗ trợ inference liên tục theo thời gian thực, giúp các nhóm phát hiện vấn đề sớm và duy trì chất lượng sản phẩm mà không làm chậm hoạt động.
- Chăm sóc sức khỏe và chẩn đoán hình ảnh: Các nhà cung cấp dịch vụ chăm sóc sức khỏe và phòng xét nghiệm chẩn đoán có thể dựa vào model thị giác để phân tích hình ảnh y tế như X-quang hoặc ảnh quét. Endpoint chuyên dụng mang lại hiệu suất ổn định và đáng tin cậy, yếu tố rất quan trọng khi xử lý dữ liệu nhạy cảm và các chẩn đoán cần được đưa ra kịp thời.
- Tự động hóa kho bãi và logistics: Các kho hàng lớn thường vận hành nhiều hệ thống giống hệt nhau, chẳng hạn như băng chuyền và dây chuyền phân loại, về cơ bản là các bản sao của cùng một thiết lập. Model thị giác máy tính có thể giám sát từng bản sao để phát hiện vấn đề như kẹt hàng hoặc kiện hàng bị định tuyến sai. Endpoint chuyên dụng đảm bảo inference nhất quán trên tất cả bản sao theo thời gian thực.
Chuyển từ inference dùng chung sang endpoint chuyên dụng#
Một trong những lợi ích chính của Ultralytics Platform là khả năng chuyển từ inference dùng chung sang endpoint chuyên dụng dễ dàng khi ứng dụng phát triển. Thay vì đổi công cụ hoặc xây dựng lại thiết lập, bạn có thể chuyển sang triển khai sẵn sàng cho production ngay trong cùng một môi trường.
Sau khi kiểm thử model bằng inference dùng chung, chuyển sang endpoint chuyên dụng là bước tiếp theo đơn giản. Bạn có thể triển khai cùng model lên endpoint, chọn khu vực và tài nguyên tính toán mong muốn, rồi cập nhật URL endpoint trong ứng dụng. Tích hợp tổng thể vẫn tương tự, nên hầu như không cần thay đổi cách gửi yêu cầu hoặc xử lý phản hồi.
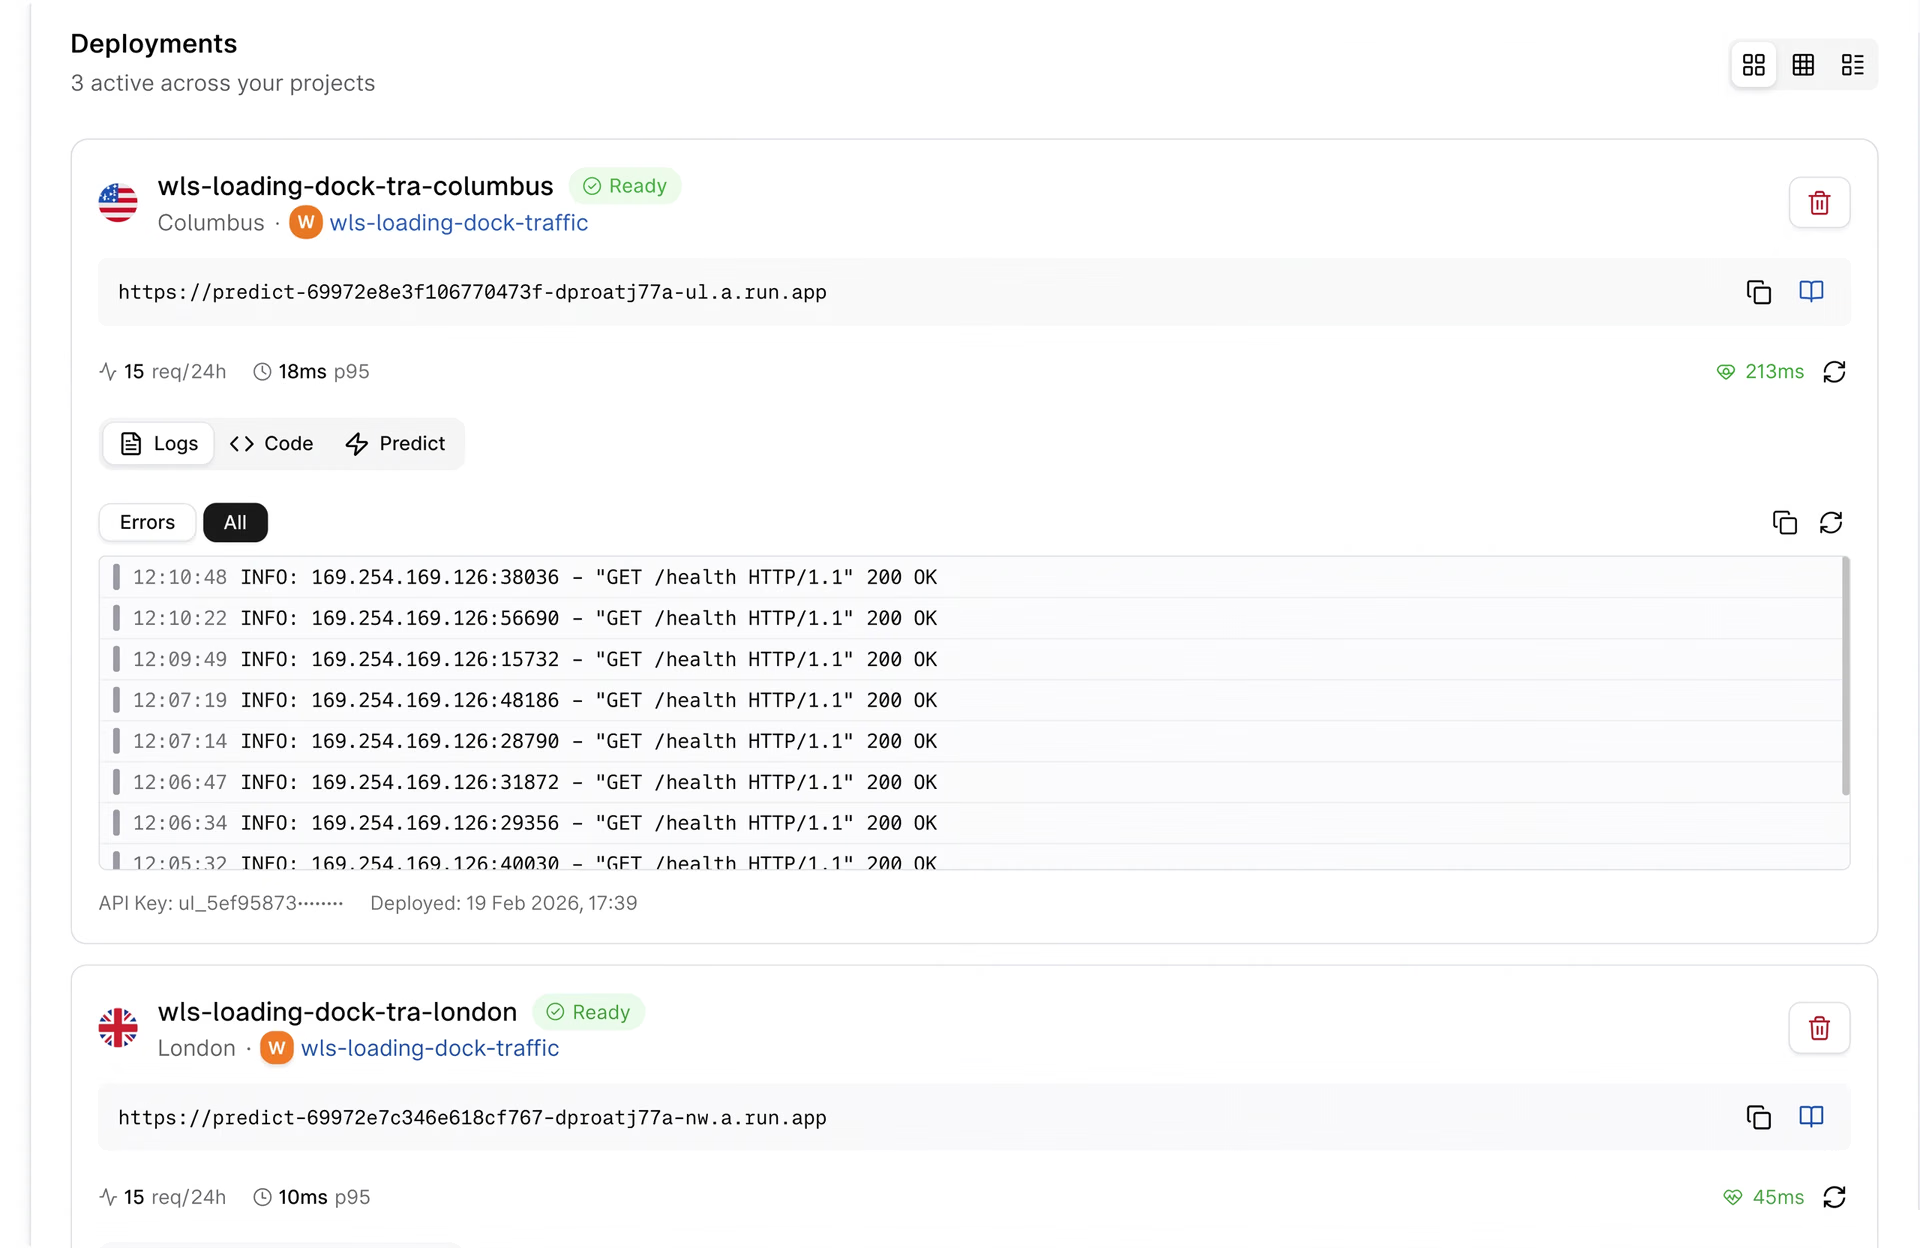
Hình 4. Xem URL endpoint chuyên dụng trên Ultralytics Platform (Nguồn)
Điều này có nghĩa là bạn có thể chuyển từ kiểm thử sang production chỉ với vài thao tác nhấp. Khi khối lượng công việc tăng hoặc ứng dụng cần hiệu suất ổn định hơn, bạn có thể chuyển sang endpoint chuyên dụng mà không làm gián đoạn quy trình làm việc hiện tại.
Để tìm hiểu thêm về cách triển khai model bằng endpoint chuyên dụng trên Ultralytics Platform, hãy xem tài liệu chính thức của Ultralytics Platform.
Điểm chính cần ghi nhớ#
Inference dùng chung là điểm khởi đầu tuyệt vời cho việc kiểm thử và thử nghiệm, nhưng khối lượng công việc production đòi hỏi tính nhất quán và khả năng mở rộng cao hơn. Khi ứng dụng phát triển, endpoint chuyên dụng cung cấp hiệu suất và độ tin cậy cần thiết để hỗ trợ việc sử dụng thực tế. Vì vậy, đây là lựa chọn tốt nhất cho hầu hết các triển khai production.
Tham gia cộng đồng và khám phá repository GitHub của chúng tôi để tìm hiểu thêm về các model thị giác máy tính. Đọc về những ứng dụng như AI trong nông nghiệp và thị giác máy tính trong robot học trên các trang giải pháp của chúng tôi. Xem các tùy chọn cấp phép và bắt đầu sử dụng AI thị giác.








