Quản lý dataset thông minh trong thị giác máy tính với Ultralytics Platform
Khám phá cách sử dụng Ultralytics Platform để quản lý dataset hiệu quả hơn trong các dự án thị giác máy tính. Dễ dàng theo dõi, so sánh và cải thiện dataset.
AI thị giác, hay thị giác máy tính, đã có những bước tiến dài kể từ thời kỳ đầu, phát triển từ lĩnh vực nghiên cứu thử nghiệm thành công nghệ chủ chốt hỗ trợ các ứng dụng thực tế. Ngày nay, những người đam mê AI có thể xây dựng các model mạnh mẽ cho những tác vụ như phát hiện đối tượng và phân đoạn instance bằng các công cụ và framework dễ tiếp cận.
Tuy nhiên, khi các ứng dụng này chuyển từ thử nghiệm sang triển khai thực tế, quản lý dataset vẫn là một thách thức quan trọng nhưng thường bị bỏ qua. Khi dataset thị giác máy tính tăng về quy mô và độ phức tạp, các nhóm thường gặp khó khăn trong việc duy trì annotation nhất quán, theo dõi thay đổi giữa các phiên bản và đảm bảo chất lượng dữ liệu tổng thể.
Ngay cả những model tiên tiến nhất cũng có thể hoạt động kém trong môi trường thực tế nếu dữ liệu dùng để huấn luyện không đầy đủ, mất cân bằng hoặc được quản lý kém. Khoảng cách ngày càng lớn giữa hiệu năng trong quá trình phát triển và độ tin cậy ngoài thực tế là lý do cần có cách tiếp cận quản lý dataset bài bản hơn.
Một hạn chế phổ biến khác là việc thu thập dữ liệu, gán nhãn và huấn luyện thường được thực hiện bằng các công cụ riêng biệt. Quy trình phân mảnh khiến việc quản lý dataset kém hiệu quả hơn, làm tăng nguy cơ thiếu nhất quán và kéo dài thời gian lặp lại.
Để giải quyết các nút thắt trong AI thị giác như quản lý dataset và quy trình phân mảnh, gần đây chúng tôi đã ra mắt Ultralytics Platform. Đây là workspace toàn diện, tích hợp quản lý dataset, gán nhãn, huấn luyện, triển khai và giám sát trong một quy trình thống nhất.
Bằng cách kết nối từng giai đoạn trong vòng đời thị giác máy tính, bạn có thể dễ dàng theo dõi thay đổi của dataset, so sánh hiệu năng giữa các phiên bản và liên tục tinh chỉnh dữ liệu để đạt kết quả tốt hơn.
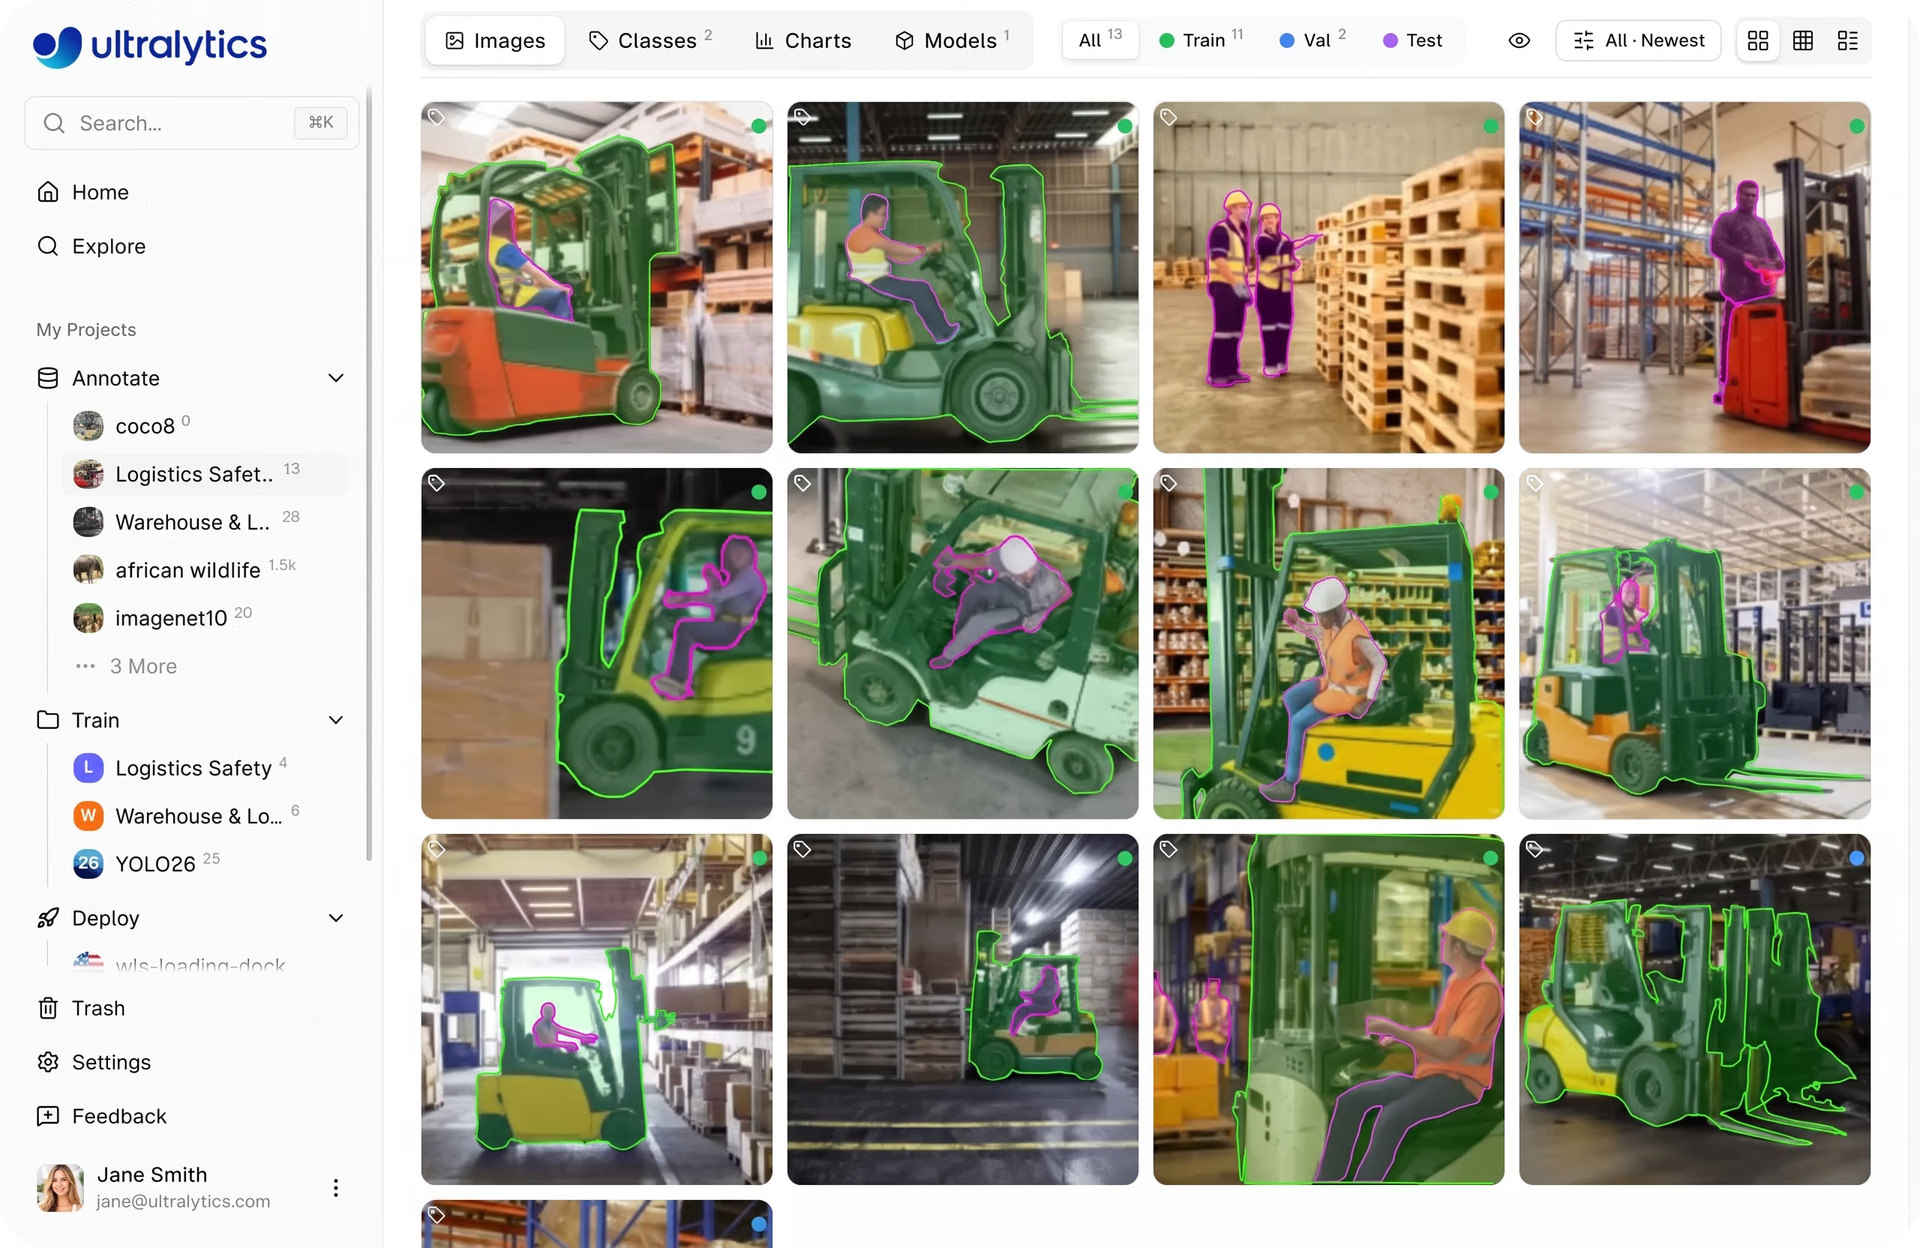
Hình 1. Ví dụ về cách xem hình ảnh trong dataset trên Ultralytics Platform (Nguồn)
Trong bài viết này, chúng ta sẽ tìm hiểu cách Ultralytics Platform giúp bạn theo dõi, so sánh và cải thiện dataset để xây dựng các model thị giác máy tính đáng tin cậy hơn. Hãy bắt đầu!
Tầm quan trọng của việc quản lý dataset trong thị giác máy tính#
Hiệu năng của một model thị giác máy tính gắn chặt với dữ liệu dùng để huấn luyện model đó. Độ chính xác của model, tức tần suất các dự đoán chính xác, không chỉ phụ thuộc vào thuật toán mà còn phụ thuộc vào mức độ dataset phản ánh các điều kiện thực tế.
Nói đơn giản, model học các pattern trực tiếp từ dữ liệu, vì vậy mọi thiếu sót, thiên lệch hoặc điểm không nhất quán trong dataset đều có thể ảnh hưởng đến cách model đưa ra dự đoán. Nói cách khác, dữ liệu kém chất lượng, annotation sai hoặc phạm vi bao phủ hạn chế đối với các biến thể thực tế trong ảnh—chẳng hạn như điều kiện ánh sáng, góc nhìn của đối tượng, hậu cảnh hoặc mức độ che khuất khác nhau—có thể làm giảm đáng kể độ chính xác, ngay cả khi kiến trúc model vốn đã mạnh.
Điều này cũng áp dụng khi fine-tune model, tức là tiếp tục huấn luyện một model đã được huấn luyện trước bằng dữ liệu mới hoặc đã cập nhật để model thích ứng tốt hơn với trường hợp sử dụng hoặc môi trường cụ thể. Vì độ chính xác của model phụ thuộc rất nhiều vào dữ liệu nên việc quản lý dữ liệu đúng cách là điều thiết yếu.
Quản lý dataset bao gồm sắp xếp, gán nhãn và liên tục cập nhật dữ liệu để dữ liệu luôn chính xác và phù hợp. Việc này giúp cải thiện hiệu năng theo thời gian dễ dàng hơn, đặc biệt khi huấn luyện lại hoặc fine-tune model bằng dữ liệu mới.
Chất lượng dataset ảnh hưởng như thế nào đến độ tin cậy trong thực tế#
Các trường hợp sử dụng thị giác máy tính, chẳng hạn như hệ thống giám sát an ninh, là ví dụ điển hình cho thấy vì sao quản lý dữ liệu đúng cách lại quan trọng. Những hệ thống này cần hoạt động đáng tin cậy trong nhiều điều kiện thực tế, bao gồm môi trường ánh sáng, góc camera, mật độ đám đông và mức độ che khuất một phần khác nhau.
Nếu dữ liệu huấn luyện không bao quát những biến thể này hoặc thiếu tính đa dạng về hình thức xuất hiện của đối tượng trong các cảnh và điều kiện khác nhau, model có thể gặp khó khăn khi phát hiện đối tượng chính xác. Ví dụ, model chủ yếu được huấn luyện trên những cảnh đủ sáng, ít vật cản có thể hoạt động kém trong môi trường thiếu sáng hoặc đông đúc. Trong các hệ thống an ninh, điều này có thể dẫn đến bỏ sót sự kiện hoặc cảnh báo giả.
Để tránh tình trạng này, cần duy trì dataset không chỉ sạch và được gán nhãn chính xác mà còn cân bằng tốt và liên tục cập nhật. Điều này có nghĩa là xác định các thiếu sót trong dữ liệu, bổ sung ví dụ mới khi điều kiện thay đổi và đảm bảo các class cũng như môi trường được thể hiện đồng đều.
Với dataset đầy đủ và có cấu trúc hơn, model sẽ được trang bị tốt hơn để xử lý các biến thiên trong thực tế và tạo ra dự đoán đáng tin cậy hơn.
Các khía cạnh chính của việc quản lý dataset#
Vậy quản lý dataset trên thực tế bao gồm những gì? Quá trình này bao gồm sắp xếp, gán nhãn và duy trì dữ liệu để dữ liệu có thể được sử dụng hiệu quả trong suốt quá trình phát triển model.
Ví dụ, sắp xếp dữ liệu bao gồm cấu trúc dataset và chia dataset thành các tập huấn luyện, validation và test. Tập huấn luyện được dùng để dạy model, tập validation được dùng để giám sát hiệu năng và định hướng điều chỉnh trong quá trình phát triển, còn tập test được dùng để đánh giá mức độ hoạt động của model cuối cùng trên dữ liệu hoàn toàn chưa từng thấy.
Trong khi đó, gán nhãn bao gồm việc chú thích ảnh bằng các thông tin như nhãn class, bounding box hoặc mask phân đoạn. Vì model học từ các annotation này nên độ chính xác và tính nhất quán là yếu tố then chốt giúp model học được các pattern có ý nghĩa và đưa ra dự đoán đáng tin cậy.
Ngoài ra, duy trì dataset còn bao gồm việc rà soát và cập nhật dữ liệu theo thời gian. Công việc này có thể bao gồm sửa lỗi annotation, loại bỏ dữ liệu kém chất lượng hoặc trùng lặp, và bổ sung ví dụ mới để bao quát các trường hợp còn thiếu hoặc điều kiện đang thay đổi.
Nhìn rộng hơn, quản lý dataset là một quá trình liên tục. Khi model được đánh giá và dữ liệu mới được thu thập, dataset cần được cập nhật để phản ánh các điều kiện thực tế và trường hợp ngoại lệ. Theo dõi những cập nhật này và so sánh các phiên bản khác nhau giúp nhóm hiểu rõ điều gì đang cải thiện hiệu năng và cần thay đổi thêm ở đâu.
Quản lý dataset bằng Ultralytics Platform#
Ultralytics Platform cung cấp quy trình có cấu trúc để quản lý dataset trong một môi trường duy nhất, bao quát mọi công đoạn từ chuẩn bị dữ liệu đến xuất dữ liệu. Nền tảng được thiết kế để hỗ trợ cả nhà phát triển cá nhân lẫn các nhóm, giúp quản lý dataset nhất quán dễ dàng hơn dù bạn làm việc độc lập hay cộng tác giữa nhiều dự án.
Mỗi giai đoạn được thiết kế để đơn giản hóa cách sắp xếp, xử lý và sử dụng dataset trong suốt vòng đời phát triển model. Bằng cách tập hợp các bước này vào một nơi, nền tảng giảm sự phân mảnh và giúp duy trì tính nhất quán giữa các quy trình dễ dàng hơn.
Tiếp theo, hãy cùng tìm hiểu các bước chính và cách nền tảng hỗ trợ từng bước.
Tải dataset lên Ultralytics Platform#
Bạn có thể bắt đầu làm việc với dataset trên nền tảng một cách linh hoạt, với nhiều cách để đưa dữ liệu vào hoặc tái sử dụng dữ liệu. Bạn có thể tải dữ liệu của riêng mình lên hoặc bắt đầu nhanh hơn bằng các dataset công khai có trên nền tảng. Bạn cũng có thể clone các dataset hiện có do cộng đồng chia sẻ và phát triển dựa trên những dataset đó.
Các tính năng cộng đồng của nền tảng giúp bạn dễ dàng khám phá và tái sử dụng những sản phẩm hiện có. Với quyền truy cập vào dataset do người dùng khác tạo, bao gồm hàng triệu hình ảnh và annotation, bạn có thể bắt đầu nhanh chóng mà không cần tự thu thập và gán nhãn mọi thứ. Clone một dataset sẽ tạo bản sao trong workspace của bạn, cho phép bạn chỉnh sửa và mở rộng dataset trong khi vẫn giữ nguyên bản gốc.
Để tải lên, nền tảng hỗ trợ ảnh riêng lẻ, video và các tệp lưu trữ dataset như ZIP, TAR hoặc GZ. Nền tảng cũng hỗ trợ các định dạng dataset được sử dụng rộng rãi như YOLO và COCO, giúp bạn dễ dàng nhập dataset và annotation hiện có mà không cần chuyển đổi thêm. Ngoài ra, bạn có thể tải dataset lên bằng tệp NDJSON được xuất từ nền tảng, giúp dễ dàng tái tạo hoặc tái sử dụng dataset giữa các dự án.
Sau khi tải dữ liệu lên, nền tảng sẽ xử lý dữ liệu thông qua một pipeline có cấu trúc. Quy trình này bao gồm xác thực định dạng và kích thước tệp, thay đổi kích thước ảnh khi cần, phân tích annotation và tạo thống kê dataset.
Ví dụ, video được chuyển thành các frame để có thể dùng cho huấn luyện, trong khi ảnh được tối ưu hóa và chuẩn bị để duyệt cũng như phân tích dễ dàng hơn. Sau khi xử lý, dataset đã sẵn sàng để gán nhãn, phân tích và huấn luyện model ngay trên nền tảng.
Gán nhãn dữ liệu trên Ultralytics Platform#
Sau khi tải lên, bạn có thể xem xét và gán nhãn dataset trực tiếp trên nền tảng. Nền tảng tích hợp sẵn các công cụ gán nhãn ảnh cho nhiều tác vụ thị giác máy tính như phát hiện đối tượng, phân đoạn instance, ước tính pose, phát hiện bounding box định hướng (OBB) và phân loại ảnh.
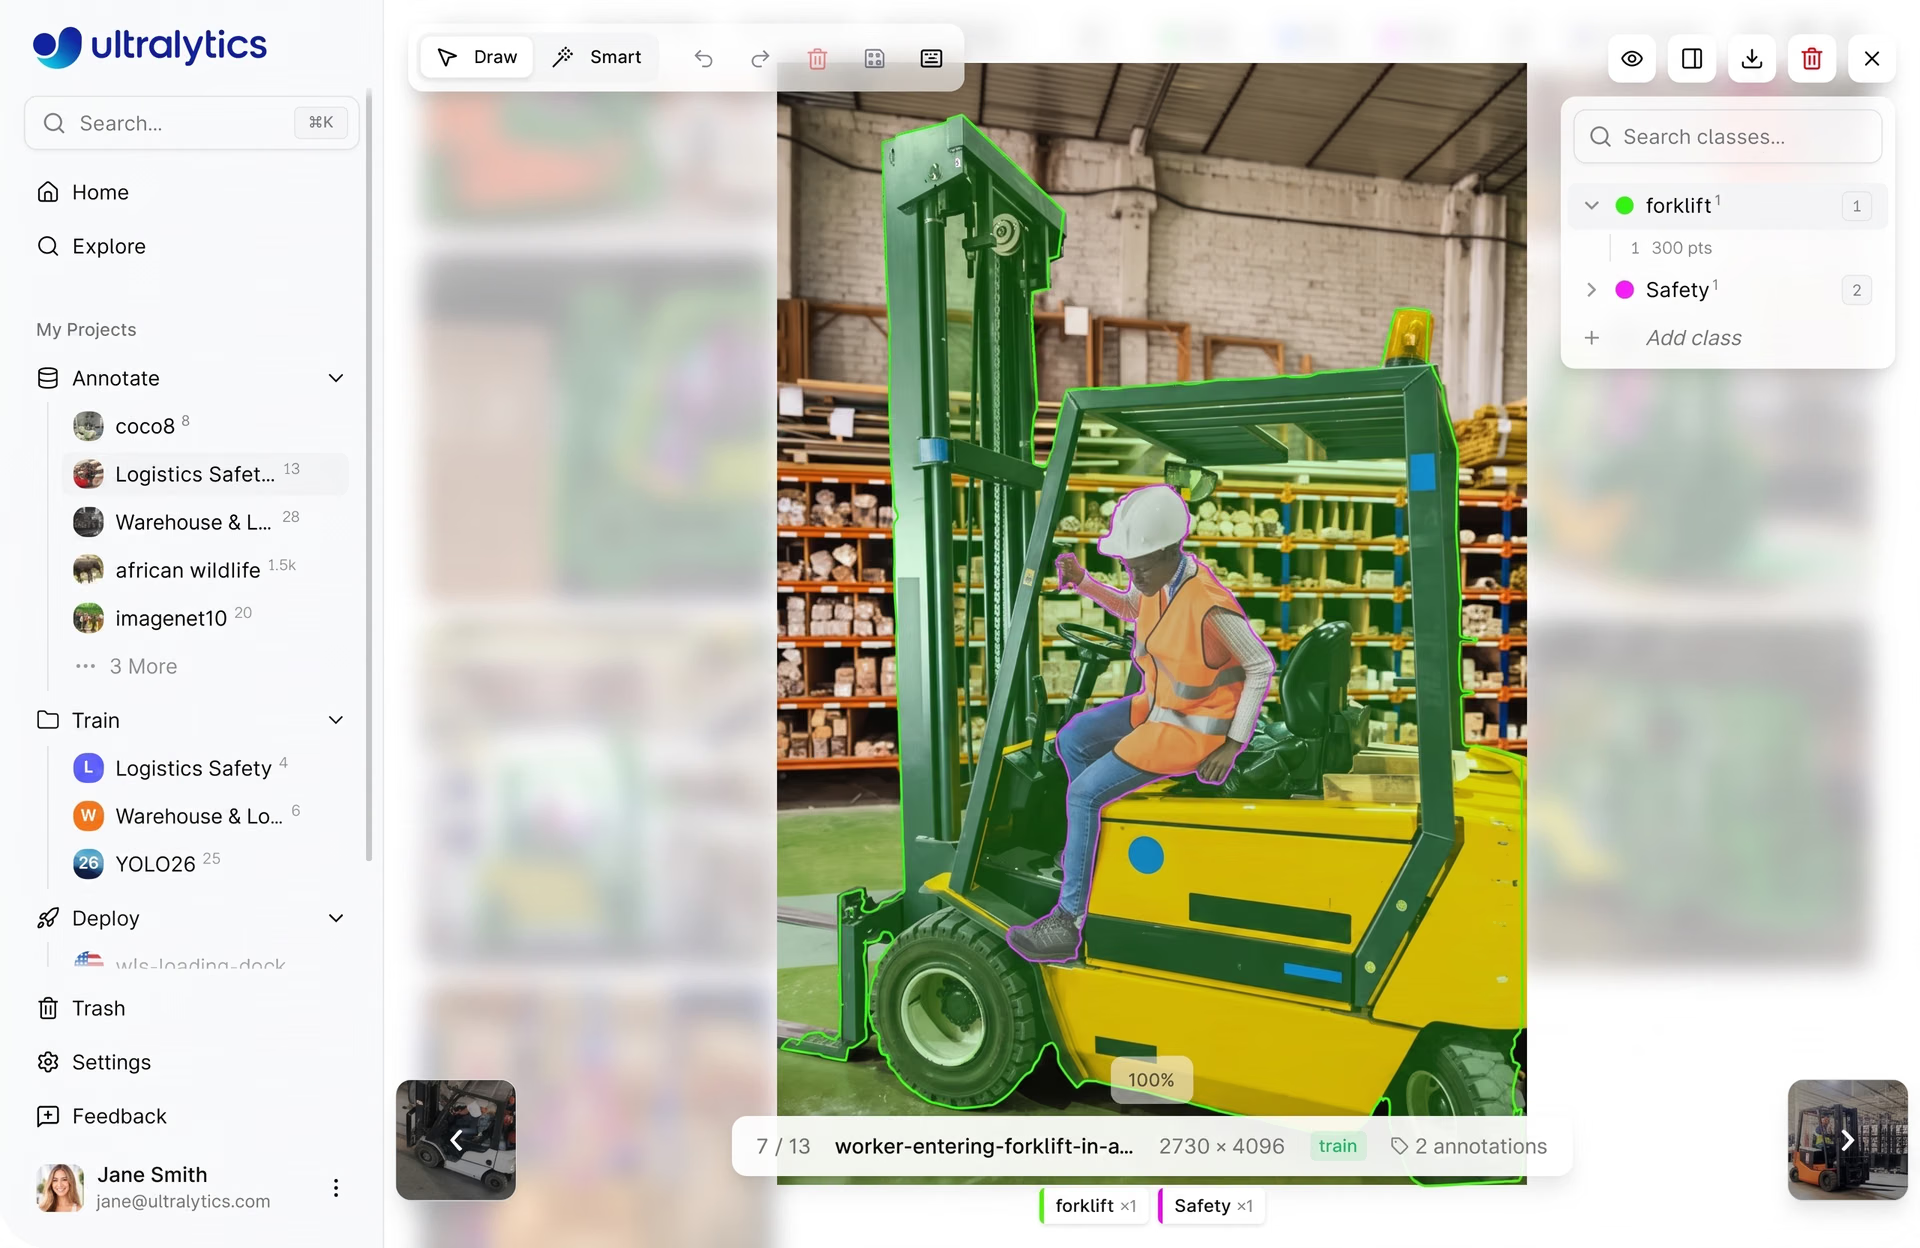
Hình 2. Sử dụng Ultralytics Platform để gán nhãn dữ liệu (Nguồn)
Có thể tạo annotation thủ công bằng những công cụ này hoặc tăng tốc quy trình bằng các tính năng có AI hỗ trợ như gán nhãn thông minh dựa trên SAM. Với SAM, bạn có thể tạo mask, bounding box hoặc box định hướng bằng cách tương tác với ảnh, giúp đẩy nhanh quá trình gán nhãn mà vẫn duy trì độ chính xác.
Phân tích chất lượng dataset thông qua Ultralytics Platform#
Ngoài việc chuẩn bị và gán nhãn dữ liệu, hiểu rõ chất lượng dataset là yếu tố thiết yếu để xây dựng các model thị giác máy tính đáng tin cậy. Nếu không có cái nhìn rõ ràng về các yếu tố như phân phối class, chất lượng annotation, cách chia dataset và mức độ dữ liệu được thể hiện trong các điều kiện khác nhau, bạn sẽ khó phát hiện các vấn đề ảnh hưởng đến hiệu năng model.
Ultralytics Platform tích hợp các tính năng giúp phân tích dataset hiệu quả hơn. Bạn có thể xem trực tiếp những thông tin chuyên sâu này trong giao diện dataset, tại các tab như Images, Classes và Charts.
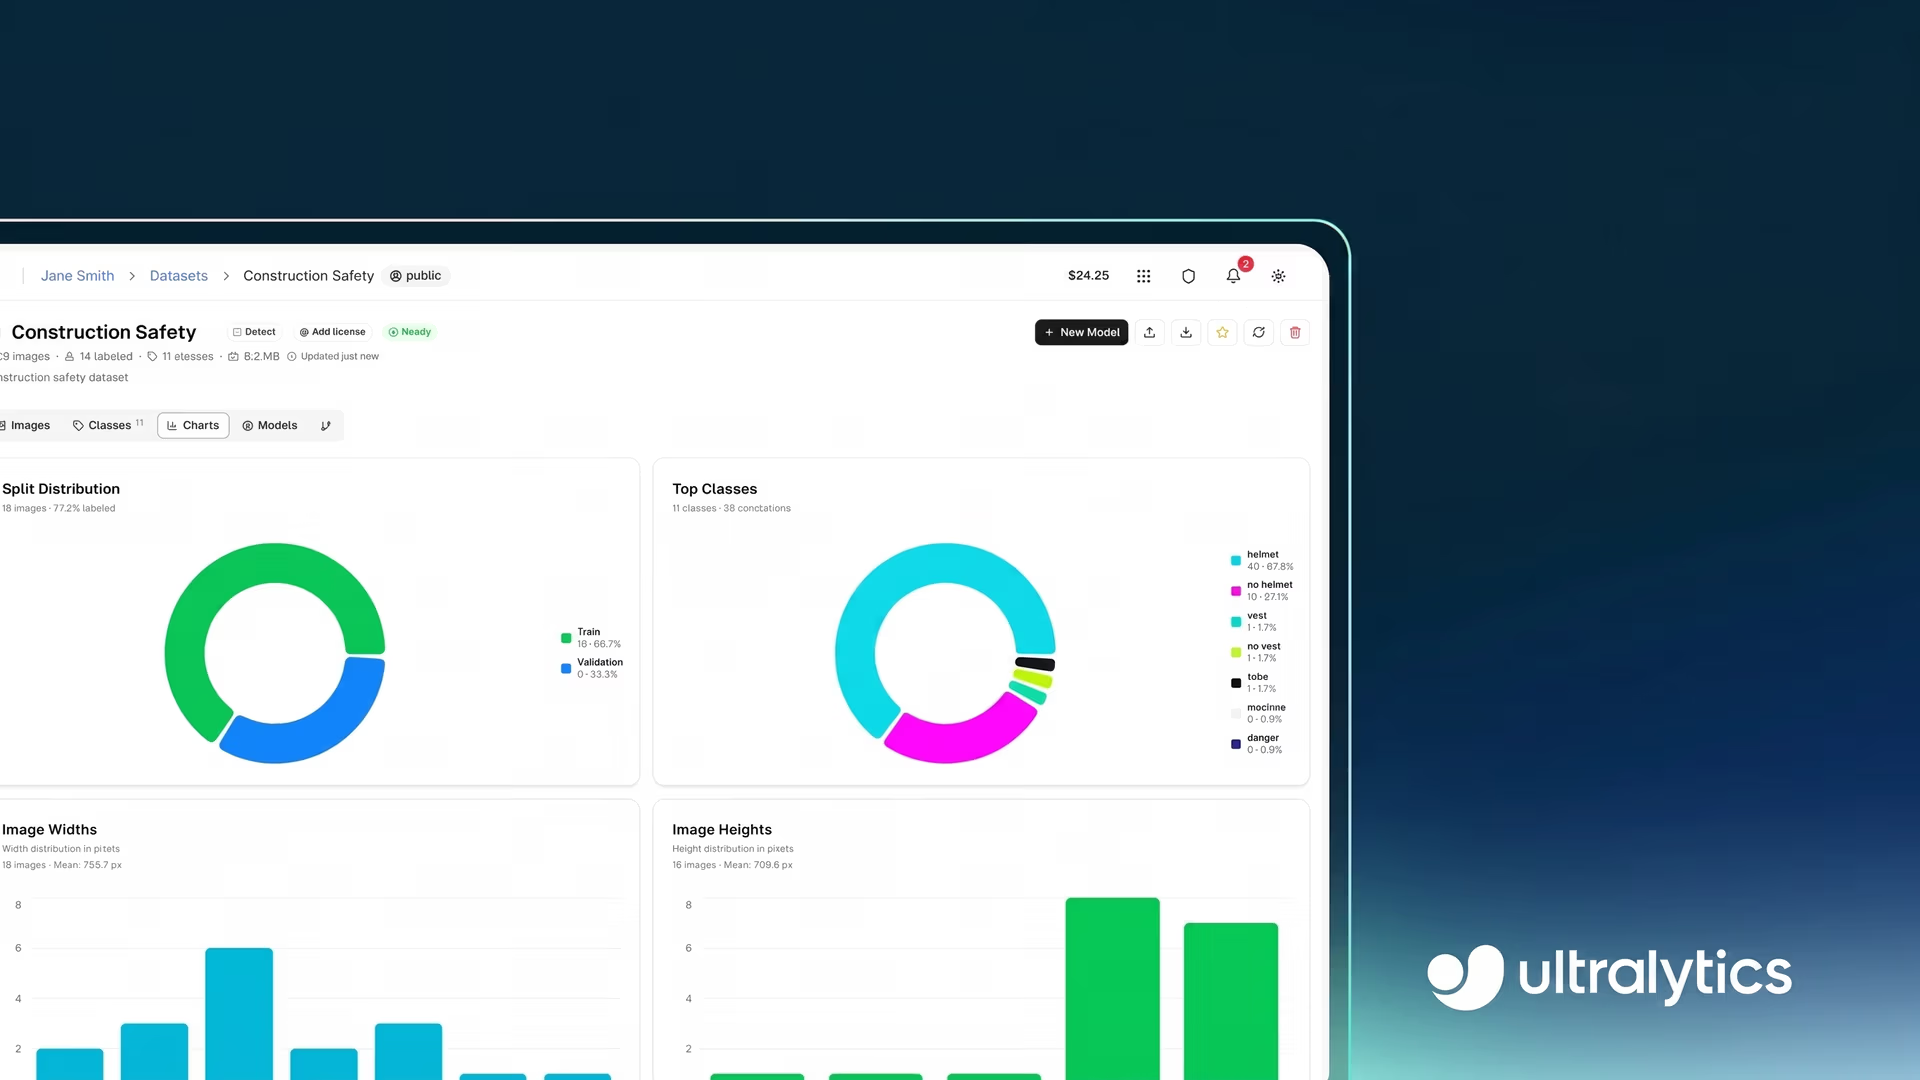
Trong tab Charts, bạn có thể xem thống kê ở cấp dataset như phân phối các tập (huấn luyện, validation và test), tần suất class và heatmap annotation cho biết vị trí xuất hiện của các đối tượng trong ảnh.
Tab Classes cung cấp phân tích số lượng annotation theo từng class, giúp dễ phát hiện tình trạng mất cân bằng class hơn. Trong khi đó, tab Images hiển thị thông tin chi tiết ở cấp ảnh như kích thước, số lượng annotation và cách nhãn được phân phối trên từng ảnh.
Những thông tin chuyên sâu này giúp bạn dễ xác định các vấn đề như mất cân bằng class, thiếu tình huống hoặc phân phối dữ liệu không đồng đều. Chẳng hạn, bạn có thể nhận thấy một số class có rất ít ví dụ hoặc phần lớn annotation tập trung ở những khu vực cụ thể trong ảnh.
Ngoài phân tích dữ liệu, nền tảng còn hỗ trợ chọn lọc và tăng cường dataset, tức là tinh chỉnh dataset bằng cách sửa hoặc loại bỏ dữ liệu có vấn đề và tạo các biến thể từ dữ liệu hiện có để cải thiện hiệu năng model. Bạn có thể thực hiện những cải tiến này trực tiếp trên nền tảng bằng cách cập nhật annotation, bổ sung dữ liệu mới hoặc sắp xếp lại các tập của dataset dựa trên thông tin phân tích.
Xuất dataset từ Ultralytics Platform#
Sau khi dataset được chuẩn bị và xác thực, bạn có thể xuất dataset để sử dụng trong các môi trường khác nhau. Nhờ đó, bạn có thể linh hoạt sử dụng dữ liệu thị giác máy tính ở bất cứ nơi nào phù hợp, dù là huấn luyện model cục bộ, trên cloud hay bằng các công cụ và quy trình khác.
Ultralytics Platform hỗ trợ nhiều định dạng xuất, bao gồm YOLO, COCO và NDJSON, giúp dễ dàng tích hợp dataset vào các công cụ và quy trình huấn luyện khác nhau.
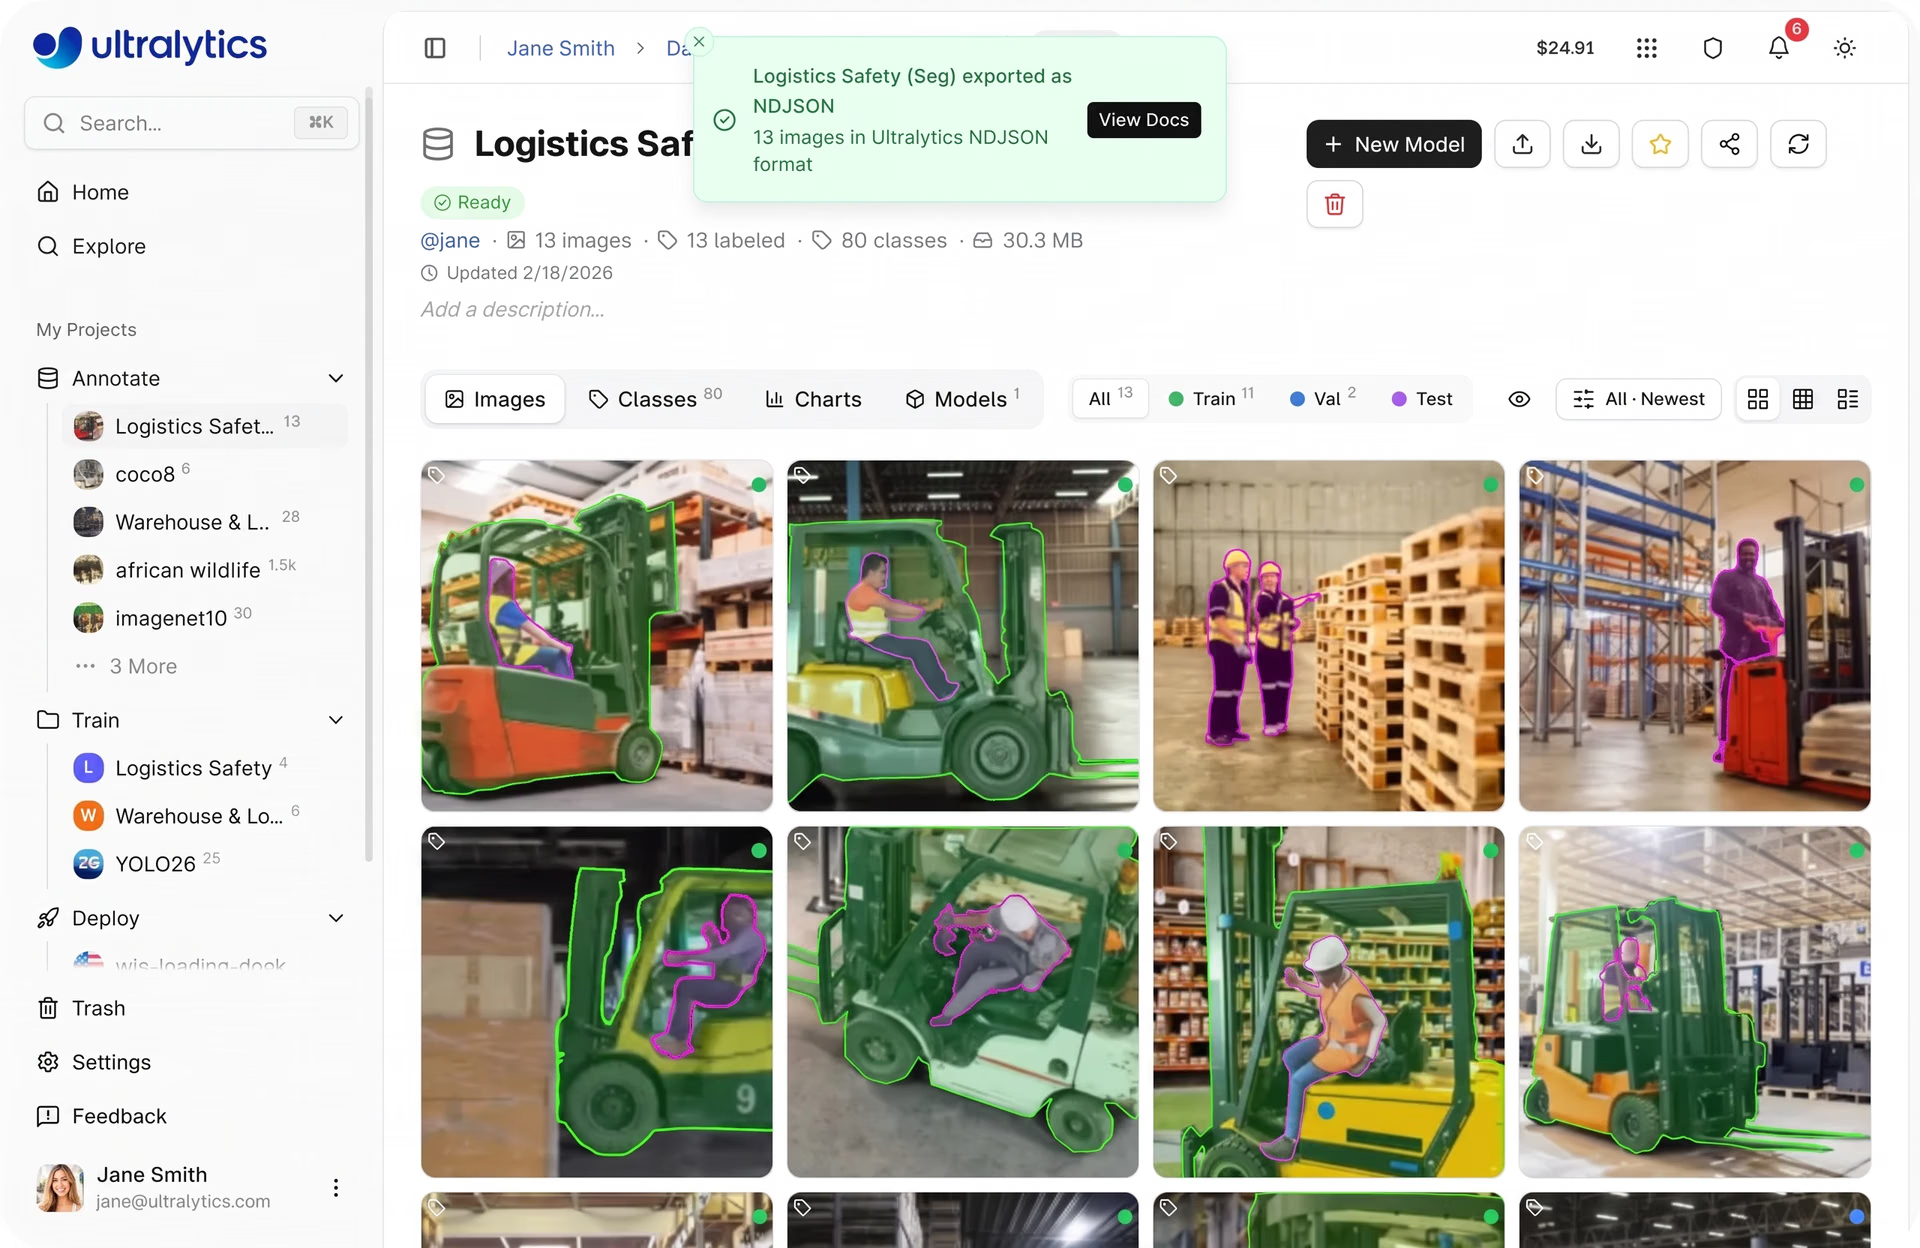
Hình 3. Xuất dataset từ Ultralytics Platform (Nguồn)
Xuất dataset sẽ tạo một snapshot dữ liệu cố định tại một thời điểm cụ thể, bao gồm hình ảnh, annotation và cấu trúc dataset. Điều này hữu ích vì dataset thường thay đổi khi dữ liệu mới được thêm vào, annotation được cập nhật hoặc các tập được điều chỉnh. Bằng cách xuất snapshot, bạn có thể lưu giữ chính xác phiên bản dataset được dùng cho một lần huấn luyện cụ thể.
Điều này giúp tái tạo kết quả sau này dễ dàng hơn, vì bạn có thể huấn luyện lại model trên cùng cấu hình dữ liệu và so sánh hiệu năng giữa các phiên bản dataset khác nhau. Ví dụ, bạn có thể đánh giá xem việc thêm ảnh mới hoặc sửa annotation có thực sự cải thiện độ chính xác của model hay không, thay vì phải phỏng đoán những gì đã thay đổi.
Quá trình xuất được thực hiện bất đồng bộ; khi hoàn tất, bạn có thể tải dataset xuống và sử dụng trong môi trường huấn luyện cục bộ, trên cloud hoặc ngoại tuyến.
Cải thiện chất lượng dataset qua các vòng lặp trên Ultralytics Platform#
Trong quy trình machine learning và deep learning, việc quản lý dataset vẫn tiếp diễn sau khi triển khai vì dữ liệu thực tế thường khác với dữ liệu dùng trong quá trình huấn luyện.
Khi model tiếp nhận đầu vào mới, những thiếu sót trong dataset—chẳng hạn như thiếu các điều kiện như môi trường thiếu sáng, góc camera khác nhau, tình trạng che khuất hoặc cảnh đông đúc—cũng như lỗi annotation sẽ trở nên rõ ràng hơn, khiến việc tinh chỉnh dữ liệu theo thời gian trở nên cần thiết.
Có một số cách để cải thiện dataset. Bạn có thể thêm ảnh hoặc video mới để bao quát các điều kiện còn thiếu như môi trường thiếu sáng, góc camera khác nhau, tình trạng che khuất hoặc cảnh đông đúc, qua đó giúp giảm các điểm mù trong dữ liệu.
Đồng thời, đảm bảo annotation chính xác và nhất quán—chẳng hạn như nhãn đối tượng đúng, bounding box hoặc mask chính xác—sẽ giúp model học được các pattern đáng tin cậy hơn.
Quy trình này thường tuân theo một vòng lặp đơn giản: huấn luyện model, đánh giá kết quả, xác định lỗi, cải thiện dataset và huấn luyện lại. Mỗi bước giúp phát hiện các vấn đề như annotation sai, dữ liệu còn thiếu hoặc các trường hợp chưa được thể hiện đầy đủ.
Giả sử bạn đang phát triển một hệ thống giám sát kệ hàng bán lẻ theo thời gian thực để phát hiện sản phẩm trong cửa hàng. Các phiên bản dataset ban đầu có thể chưa bao gồm một số loại sản phẩm, điều kiện ánh sáng hoặc cách sắp xếp kệ đông đúc. Trong quá trình đánh giá, bạn có thể nhận thấy model gặp khó khăn khi phát hiện sản phẩm trong những tình huống này.
Để cải thiện hiệu năng, bạn có thể thu thập ảnh mới bao quát những tình huống còn thiếu và cập nhật annotation khi cần. Lặp lại quy trình này theo thời gian giúp model chính xác và đáng tin cậy hơn trong các điều kiện thực tế.
Ultralytics Platform hỗ trợ quy trình này bằng cách kết nối các cập nhật dataset với hoạt động huấn luyện và đánh giá. Với tính năng theo dõi thử nghiệm và các chỉ số hiệu năng được tích hợp sẵn, bạn có thể dễ dàng theo dõi tiến độ và liên tục cải thiện dataset theo thời gian.
Theo dõi thay đổi dataset bằng Ultralytics Platform#
Chúng ta đã đề cập ngắn gọn đến cách dataset thay đổi theo thời gian trong quá trình phát triển model. Khi dữ liệu mới được thêm vào, annotation được tinh chỉnh và class được cập nhật, việc theo dõi những thay đổi này trở nên thiết yếu để duy trì chất lượng dữ liệu và đảm bảo hiệu năng model nhất quán.
Dưới đây là một số tính năng chính của Ultralytics Platform hỗ trợ theo dõi dataset và quản lý phiên bản:
- Quản lý phiên bản dataset: Bạn có thể tạo các phiên bản dataset cố định dưới dạng snapshot NDJSON. Mỗi phiên bản ghi lại các thông tin chính như số lượng ảnh, số lượng class, số lượng annotation và kích thước dataset tại một thời điểm cụ thể. Các phiên bản này được lưu trữ và có thể tải xuống sau, giúp tái tạo thử nghiệm và so sánh kết quả giữa các trạng thái dataset khác nhau dễ dàng hơn.
- Tab Versions: Tất cả phiên bản dataset được sắp xếp trong tab Versions, nơi bạn có thể xem lịch sử phiên bản, thêm mô tả về các thay đổi và theo dõi quá trình dataset phát triển theo thời gian.
- Liên kết với model: Tab Models hiển thị tất cả model được huấn luyện trên một dataset, bao gồm các metric như mAP và thông tin chi tiết về quá trình huấn luyện. Các phiên bản dataset được liên kết với những lần huấn luyện, giúp bạn hiểu rõ thay đổi dữ liệu ảnh hưởng đến hiệu năng model như thế nào.
- Tab Errors: Tab Errors làm nổi bật các tệp gặp lỗi trong quá trình xử lý, kèm theo thông tin chi tiết về lỗi và đề xuất khắc phục. Nhờ đó, bạn có thể xác định và sửa các vấn đề như tệp bị hỏng hoặc định dạng không được hỗ trợ trước khi huấn luyện.
- Giao diện dataset (các tab Images và Classes): Những giao diện này cho phép bạn duyệt ảnh, xem lại annotation, quản lý nhãn class và phân tích phân phối class. Các tính năng như lọc, sắp xếp và xác định ảnh chưa được gán nhãn giúp việc theo dõi chất lượng dataset theo thời gian trở nên đơn giản hơn.
- Thống kê và biểu đồ: Các hình ảnh trực quan hóa dữ liệu được tích hợp sẵn, chẳng hạn như phân phối các tập, tần suất class và heatmap annotation, giúp theo dõi thay đổi trong phân phối dữ liệu và xác định tình trạng mất cân bằng khi dataset phát triển.
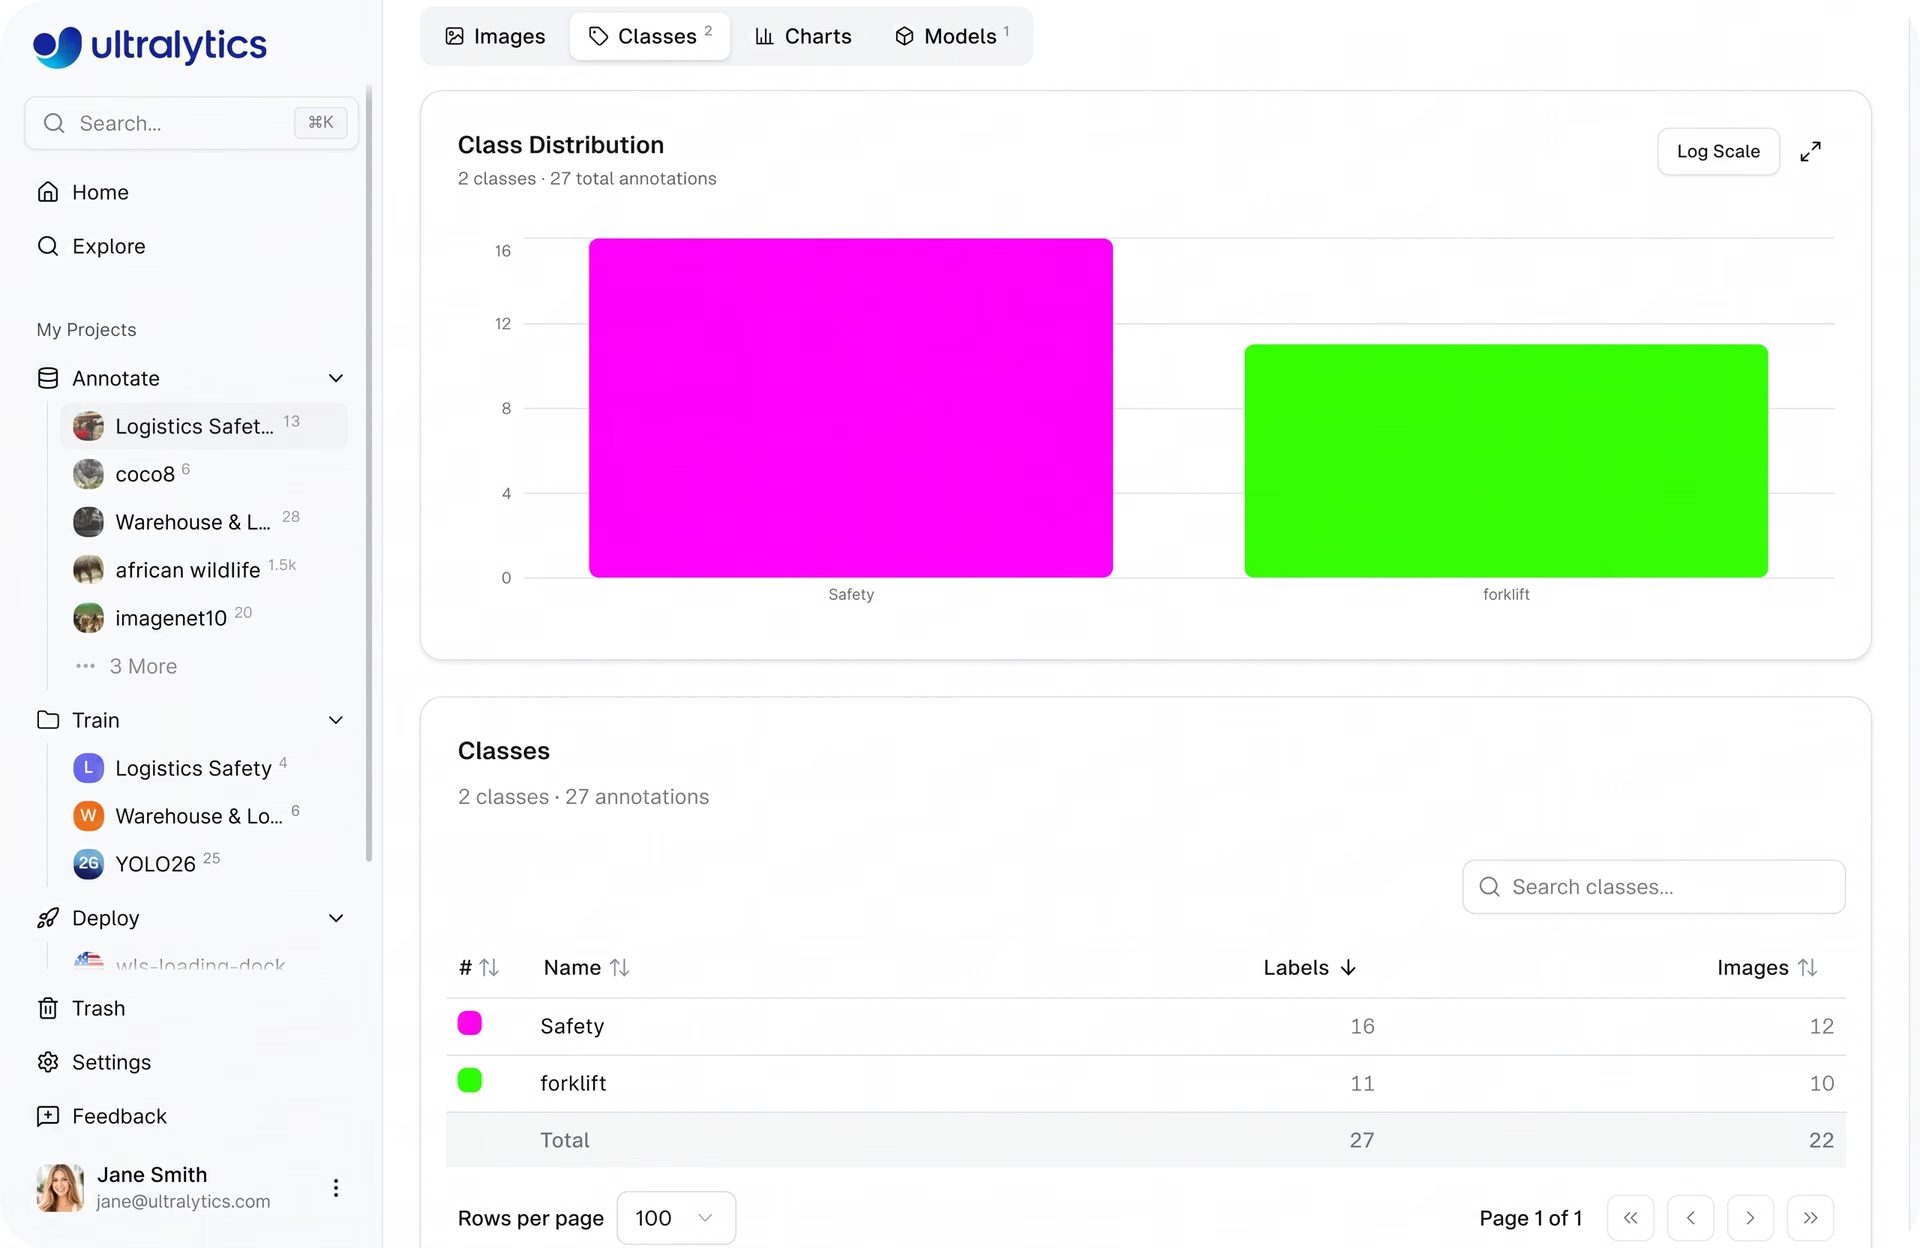
Hình 4. Minh họa việc phân tích phân phối class của dataset trên Ultralytics Platform (Nguồn)
Kết nối dataset với quá trình huấn luyện và triển khai trên Ultralytics Platform#
Ultralytics Platform kết nối các giai đoạn khác nhau trong quá trình phát triển model AI thành một pipeline duy nhất. Điều này giúp đơn giản hóa quy trình chuyển từ dữ liệu thô sang các ứng dụng AI thị giác sẵn sàng đưa vào môi trường production.
Sau khi dataset được chuẩn bị và gán nhãn, bạn có thể dùng dataset để huấn luyện model thị giác máy tính, chẳng hạn như Ultralytics YOLO26, ngay trên nền tảng. Trong quá trình huấn luyện, bạn có thể theo dõi metric hiệu năng, quản lý thử nghiệm và đánh giá khả năng học của model bằng các dashboard tích hợp sẵn.
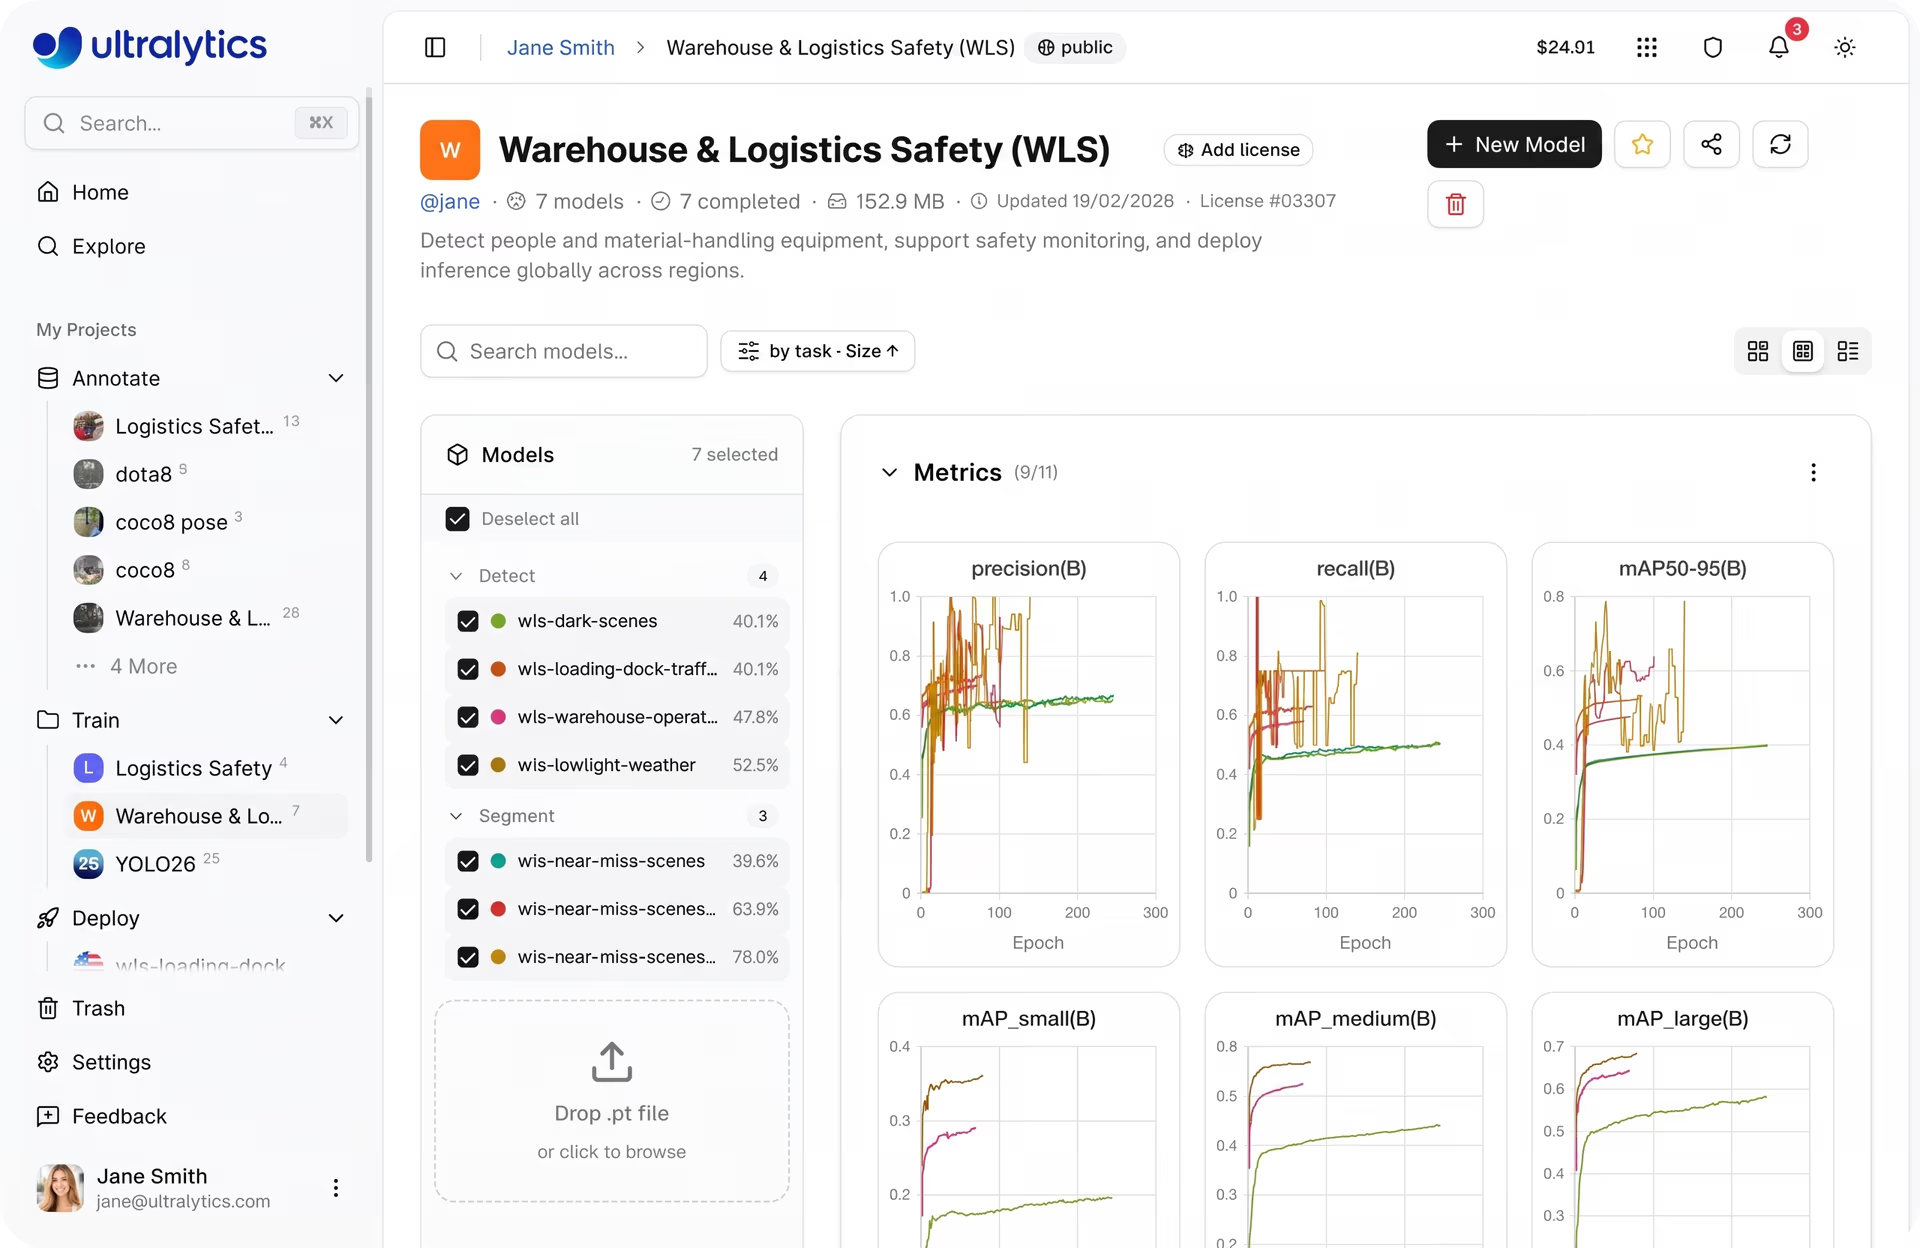
Hình 5. Minh họa việc xem metric huấn luyện model trên Ultralytics Platform (Nguồn)
Sau khi huấn luyện, bạn có thể kiểm thử model trên ảnh mới ngay trong trình duyệt để đánh giá dự đoán và xác định những điểm cần cải thiện trước khi triển khai. Khi model hoạt động tốt, bạn có thể đưa model vào môi trường production.
Nền tảng hỗ trợ xuất model sang nhiều định dạng hoặc triển khai model thông qua các dịch vụ inference và endpoint chuyên dụng, cho phép model chạy trong nhiều môi trường khác nhau.
Sau khi triển khai, các công cụ giám sát tích hợp sẵn giúp theo dõi hiệu năng hệ thống theo thời gian, bao gồm các metric liên quan đến mức sử dụng và hành vi của model. Nhờ đó, việc duy trì và cải thiện các hệ thống AI thị giác trong ứng dụng thực tế trở nên đơn giản hơn.
Các phương pháp hay nhất để quản lý dataset bằng Ultralytics Platform#
Dưới đây là một số yếu tố quan trọng cần lưu ý khi quản lý dataset bằng Ultralytics Platform:
- Dùng bộ lọc để tìm thiếu sót: Dùng công cụ lọc để xác định dữ liệu chưa được gán nhãn hoặc chưa được thể hiện đầy đủ, giúp hoàn tất annotation và cải thiện phạm vi bao quát dễ dàng hơn.
- Sửa lỗi sớm: Dùng tab Errors để kiểm soát chất lượng, phát hiện các lần tải lên thất bại, tệp bị hỏng hoặc định dạng không được hỗ trợ trước khi huấn luyện.
- Liên tục cập nhật dataset: Bổ sung dữ liệu mới, sửa annotation và thêm các trường hợp ngoại lệ khi chúng xuất hiện. Điều này giúp cải thiện phạm vi bao quát và đảm bảo model hoạt động đáng tin cậy trong các tình huống thực tế.
- Quản lý cẩn thận các tập của dataset: Đảm bảo sự cân bằng hợp lý giữa tập huấn luyện, validation và test. Khi cần, bạn có thể sắp xếp lại các tập theo cách thủ công hoặc dùng tính năng phân phối lại tự động.
Để tìm hiểu thêm về Ultralytics Platform, hãy xem tài liệu chính thức của Ultralytics.
Những điểm chính cần nhớ#
Khi các dự án thị giác máy tính mở rộng quy mô, việc quản lý dataset hiệu quả cũng quan trọng không kém quá trình phát triển model. Cách tiếp cận quản lý dataset có cấu trúc giúp cải thiện chất lượng dữ liệu, tinh giản quy trình và hỗ trợ nâng cao hiệu năng model theo thời gian.
Ultralytics Platform đơn giản hóa quy trình này bằng cách tích hợp quản lý dataset, huấn luyện và triển khai trong một quy trình duy nhất. Bằng cách áp dụng phương pháp quản lý dataset có cấu trúc, các nhóm có thể giảm độ phức tạp, nâng cao hiệu quả và xây dựng các hệ thống thị giác máy tính có khả năng mở rộng cũng như độ tin cậy cao hơn.
Tham gia cộng đồng ngày càng phát triển của chúng tôi và khám phá repository GitHub để tìm tài nguyên AI. Để bắt đầu xây dựng với AI thị giác ngay hôm nay, hãy xem các tùy chọn cấp phép của chúng tôi. Tìm hiểu cách AI trong nông nghiệp đang chuyển đổi ngành nông nghiệp và cách AI thị giác trong chăm sóc sức khỏe đang định hình tương lai bằng cách truy cập các trang giải pháp của chúng tôi.








