تسريع Ultralytics YOLO26 باستخدام OpenVINO على Intel Core Ultra Series 3 (Panther Lake)
تعرّف على كيفية تصدير نماذج Ultralytics YOLO26 إلى تنسيق OpenVINO وتسريع الاستدلال على أجهزة Intel، بما فيها CPU وGPU وNPU.
على مدى السنوات القليلة الماضية، انتقل الذكاء الاصطناعي والرؤية الحاسوبية من مرحلة التجريب إلى أن أصبحا جزءاً أساسياً من العمليات التجارية اليومية. وتشير الاستطلاعات بالفعل إلى أن نحو 88% من المؤسسات تستخدم الذكاء الاصطناعي في جانب واحد على الأقل من أعمالها.
لكن تحويل هذا الاعتماد إلى قيمة فعلية، سواء في أنظمة الإنتاج أو المشاريع الشخصية، يتوقف غالباً على مدى كفاءة تشغيل النماذج بعد نشرها. ففي كثير من سيناريوهات العالم الحقيقي، تُنشر نماذج الرؤية الحاسوبية مثل Ultralytics YOLO26 على الأجهزة الطرفية ومجموعة متنوعة من العتاد، وغالباً ما تكون وحدات CPU أو GPU مدمجة أو NPU، بدلاً من وحدات GPU عالية الأداء.
هنا قد يبدأ تفاوت الأداء، وهنا يصبح التحسين أمراً بالغ الأهمية. فقد يواجه نموذج يعمل جيداً في بيئة ما صعوبة في بيئة أخرى إذا لم يُحسّن بالشكل المناسب للعتاد الأساسي.
لتبسيط هذه العملية، تدعم حزمة Ultralytics Python تصدير نماذج YOLO26 إلى تنسيقات محسّنة مثل OpenVINO، لتعمل بسلاسة على عتاد Intel من دون الحاجة إلى تغيير سير عملك.
على سبيل المثال، عندما يُصدَّر نموذج Ultralytics YOLO26 إلى تنسيق OpenVINO، يمكنه العمل بكفاءة أكبر على معالجات Intel Core Ultra Series 3، مع تحسن سرعة الاستدلال عبر GPU بمقدار يصل إلى ثلاثة أضعاف.
في هذه المقالة، سنستكشف كيف يجعل التكامل المحدّث بين Ultralytics وOpenVINO نشر نماذج YOLO26 على عتاد Intel Core Ultra Series 3 أسهل. لنبدأ!
نظرة عامة على تكامل Ultralytics وOpenVINO#
توفر حزمة Ultralytics Python واجهة موحدة لتدريب نماذج Ultralytics YOLO مثل YOLO26 وتشغيل الاستدلال عليها ونشرها. وتدعم مجموعة من عمليات التكامل التي تساعد في مختلف مراحل سير عمل الذكاء الاصطناعي للرؤية، بدءاً من التدريب والتجريب ووصولاً إلى النشر والتحسين.
من عمليات التكامل المخصصة للنشر التكامل مع مجموعة أدوات OpenVINO، التي تتيح لك تصدير نماذج Ultralytics YOLO26 إلى تنسيق محسّن لـعتاد Intel. وتحول هذه العملية نماذج YOLO إلى تنسيق يعمل بكفاءة أكبر على وحدات CPU وGPU وNPU من Intel، بما في ذلك الأنظمة التي تعمل بمعالجات Intel® Core™ Ultra™.
يسهّل ذلك تشغيل النماذج على أجهزة Intel المختلفة من دون الحاجة إلى ضبطها يدوياً لكل إعداد. وسواء كنت تعمل على جهاز محلي أو جهاز طرفي أو عملية نشر أكبر، يمكنك إعادة استخدام النموذج المُصدَّر نفسه.
ما يجعل هذا التكامل عملياً بشكل خاص هو اندماجه السلس في سير عمل Ultralytics الحالي. يمكنك تصدير النموذج باستخدام الواجهة نفسها التي تستخدمها للتدريب والاستدلال، من دون الحاجة إلى أدوات إضافية أو إعداد معقد.
بعد التصدير، يمكن استخدام النموذج للاستدلال إما عبر حزمة Ultralytics Python أو بيئة تشغيل OpenVINO، بحسب مستوى التحكم والمرونة الذي تحتاج إليه.
نظرة أقرب على OpenVINO وعتاد Intel Panther Lake للاستدلال بالذكاء الاصطناعي#
قبل أن نرى مدى كفاءة تشغيل نموذج Ultralytics YOLO26 المُصدَّر على عتاد Intel، دعونا نتوقف لحظة لفهم كيفية عمل OpenVINO وعتاد Intel معاً لتمكين الاستدلال بكفاءة.
OpenVINO مجموعة أدوات مفتوحة المصدر مصممة لتحسين استدلال الذكاء الاصطناعي وتشغيله على عتاد Intel، بما في ذلك وحدات CPU ووحدات GPU المدمجة ووحدات NPU. وتوفر بيئة تشغيل موحدة، بحيث يمكن تشغيل النموذج نفسه على وحدات الحوسبة المختلفة هذه من دون الحاجة إلى إعادة كتابته.
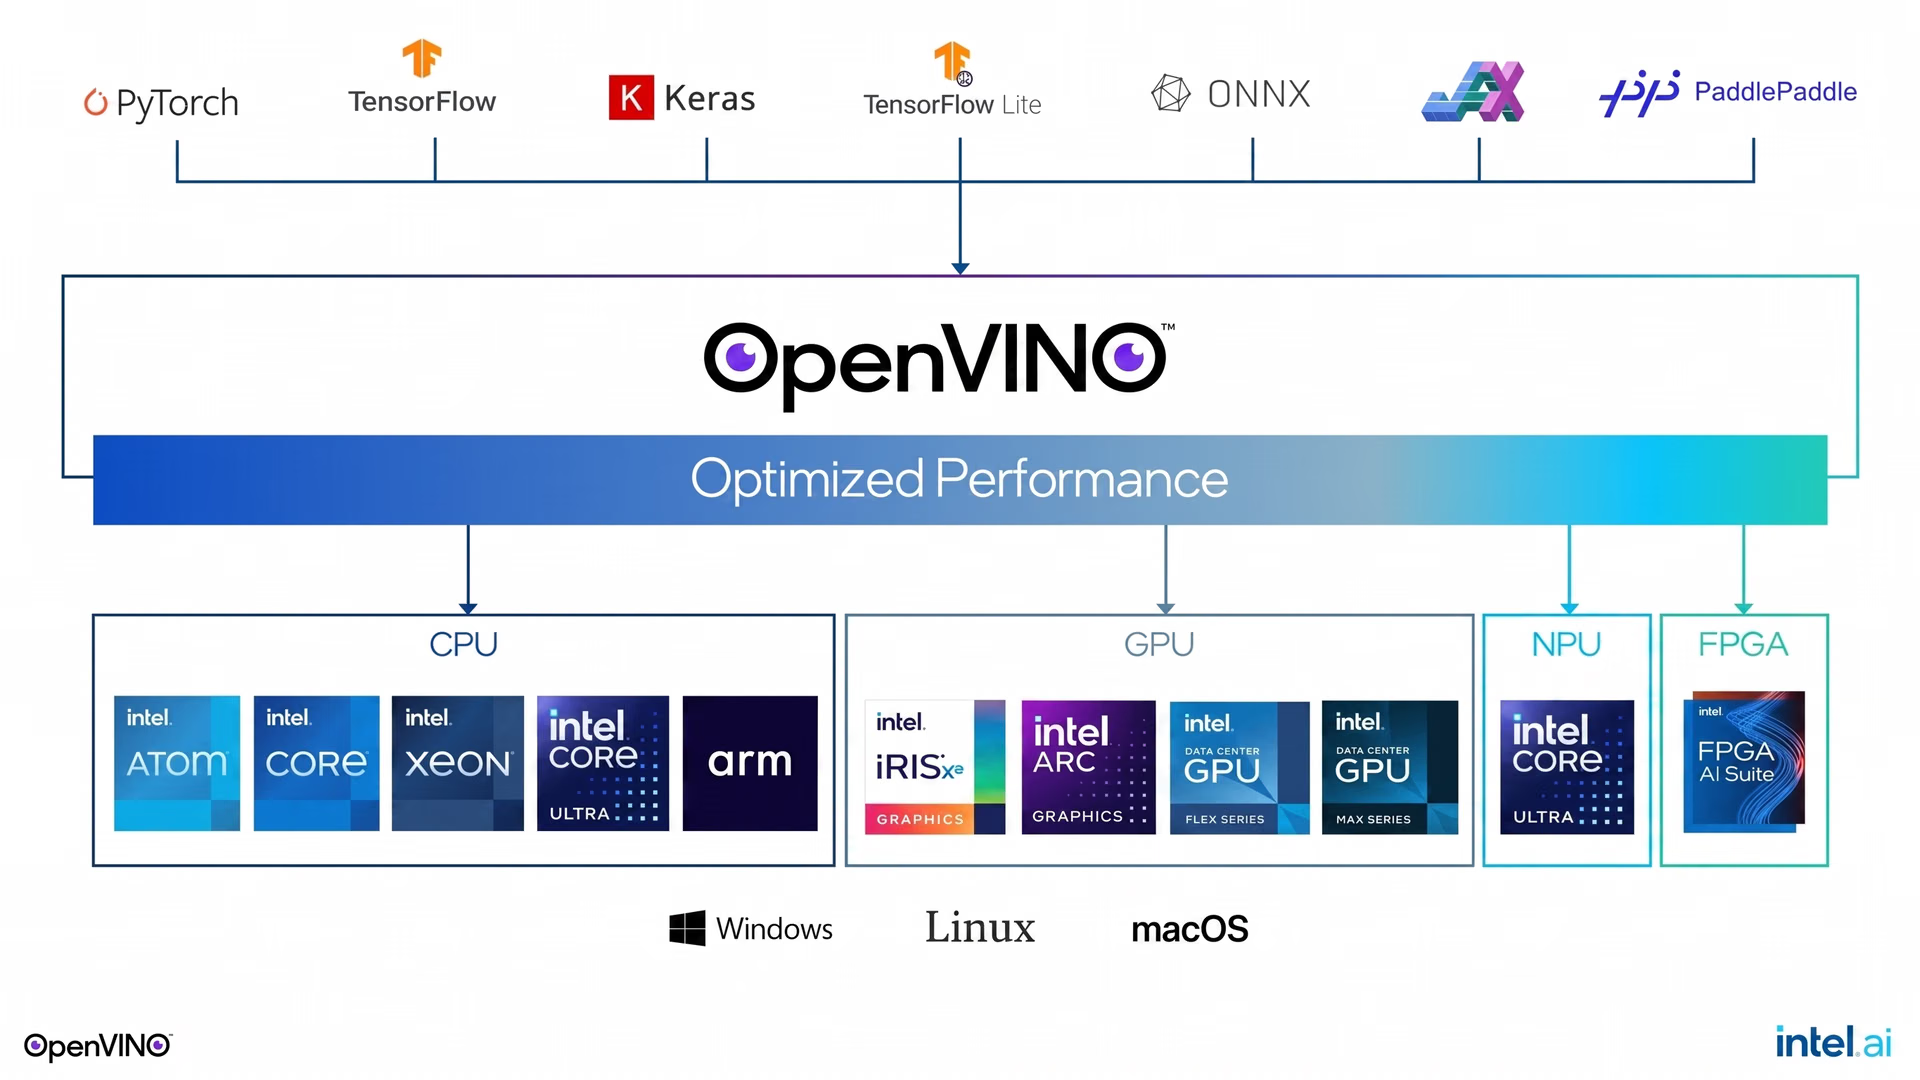
الشكل 1. يسهّل OpenVINO نشر النماذج على أهداف عتادية متعددة. (المصدر)
على معالجات Intel® Core™ Ultra™ Series 3 الجديدة (التي تحمل الاسم الرمزي Panther Lake)، تعمل أحمال الذكاء الاصطناعي على وحدات حوسبة متعددة ضمن المعالج نفسه. وتجمع كل شريحة بين أنوية CPU للمهام العامة، وGPU مدمجة للمعالجة المتوازية، ووحدة NPU مخصصة صُممت خصيصاً للاستدلال بالذكاء الاصطناعي.
يوفر OpenVINO واجهة API موحدة تتيح لك استهداف أي من وحدات الحوسبة هذه، سواء CPU أو GPU أو NPU، من دون تغيير شيفرتك. ما عليك سوى تحديد الجهاز الذي تريد تشغيل الاستدلال عليه وقت التشغيل، ما يسهل التبديل بين الوحدات الثلاث بحسب احتياجاتك للأداء والكفاءة.
قياس أداء Ultralytics YOLO26 على سلسلة Intel® Core™ Ultra™#
أثناء استكشاف تكامل Ultralytics وOpenVINO، قد تتساءل عن مقدار التحسن في أداء النموذج المتوقع عند تصدير YOLO26 إلى تنسيق OpenVINO.
يتضح الفرق في سرعة الاستدلال عند قياس أداء نماذج YOLO26 بتنسيقات ومستويات دقة مختلفة. فعلى سبيل المثال، عند تشغيل الإصدار nano من YOLO26 (YOLO26n) على Intel Core Ultra X7 358H، وهو معالج Panther Lake، ينخفض زمن الاستدلال من 25.18 ms لكل صورة باستخدام PyTorch بدقة FP32 إلى 2.64 ms باستخدام OpenVINO بالدقة نفسها عبر وحدة NPU المدمجة.
وهذا أسرع من خط الأساس الأصلي لـ PyTorch بدقة FP32، ما قد يُحدث فرقاً ملحوظاً في التطبيقات الآنية والتطبيقات الطرفية التي يكون فيها زمن الاستجابة بالغ الأهمية. وتصبح هذه المكاسب أوضح عند تشغيل النموذج نفسه على وحدة GPU المدمجة Intel Arc.
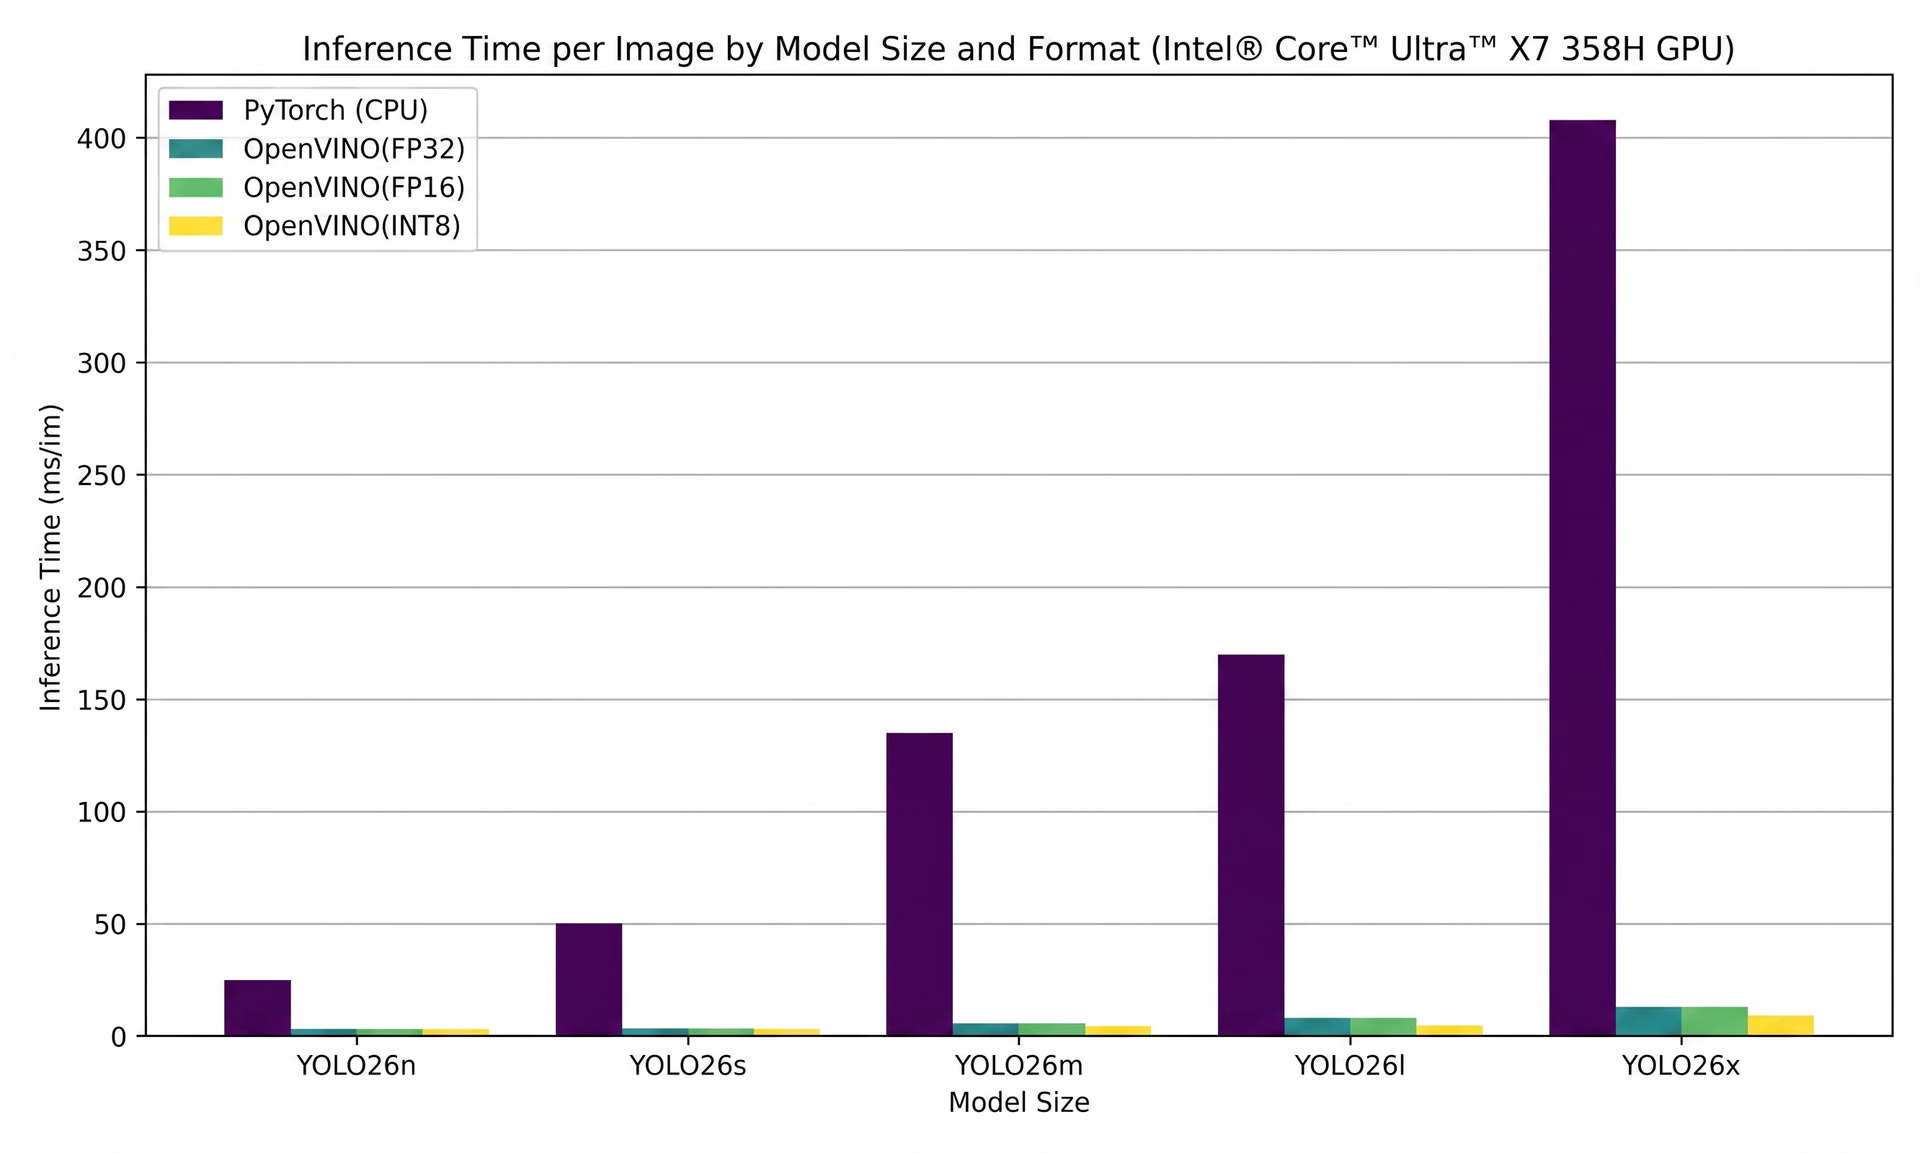
الشكل 2. قياس أداء استدلال Ultralytics YOLO26 على GPU في Intel Panther Lake باستخدام OpenVINO (المصدر)
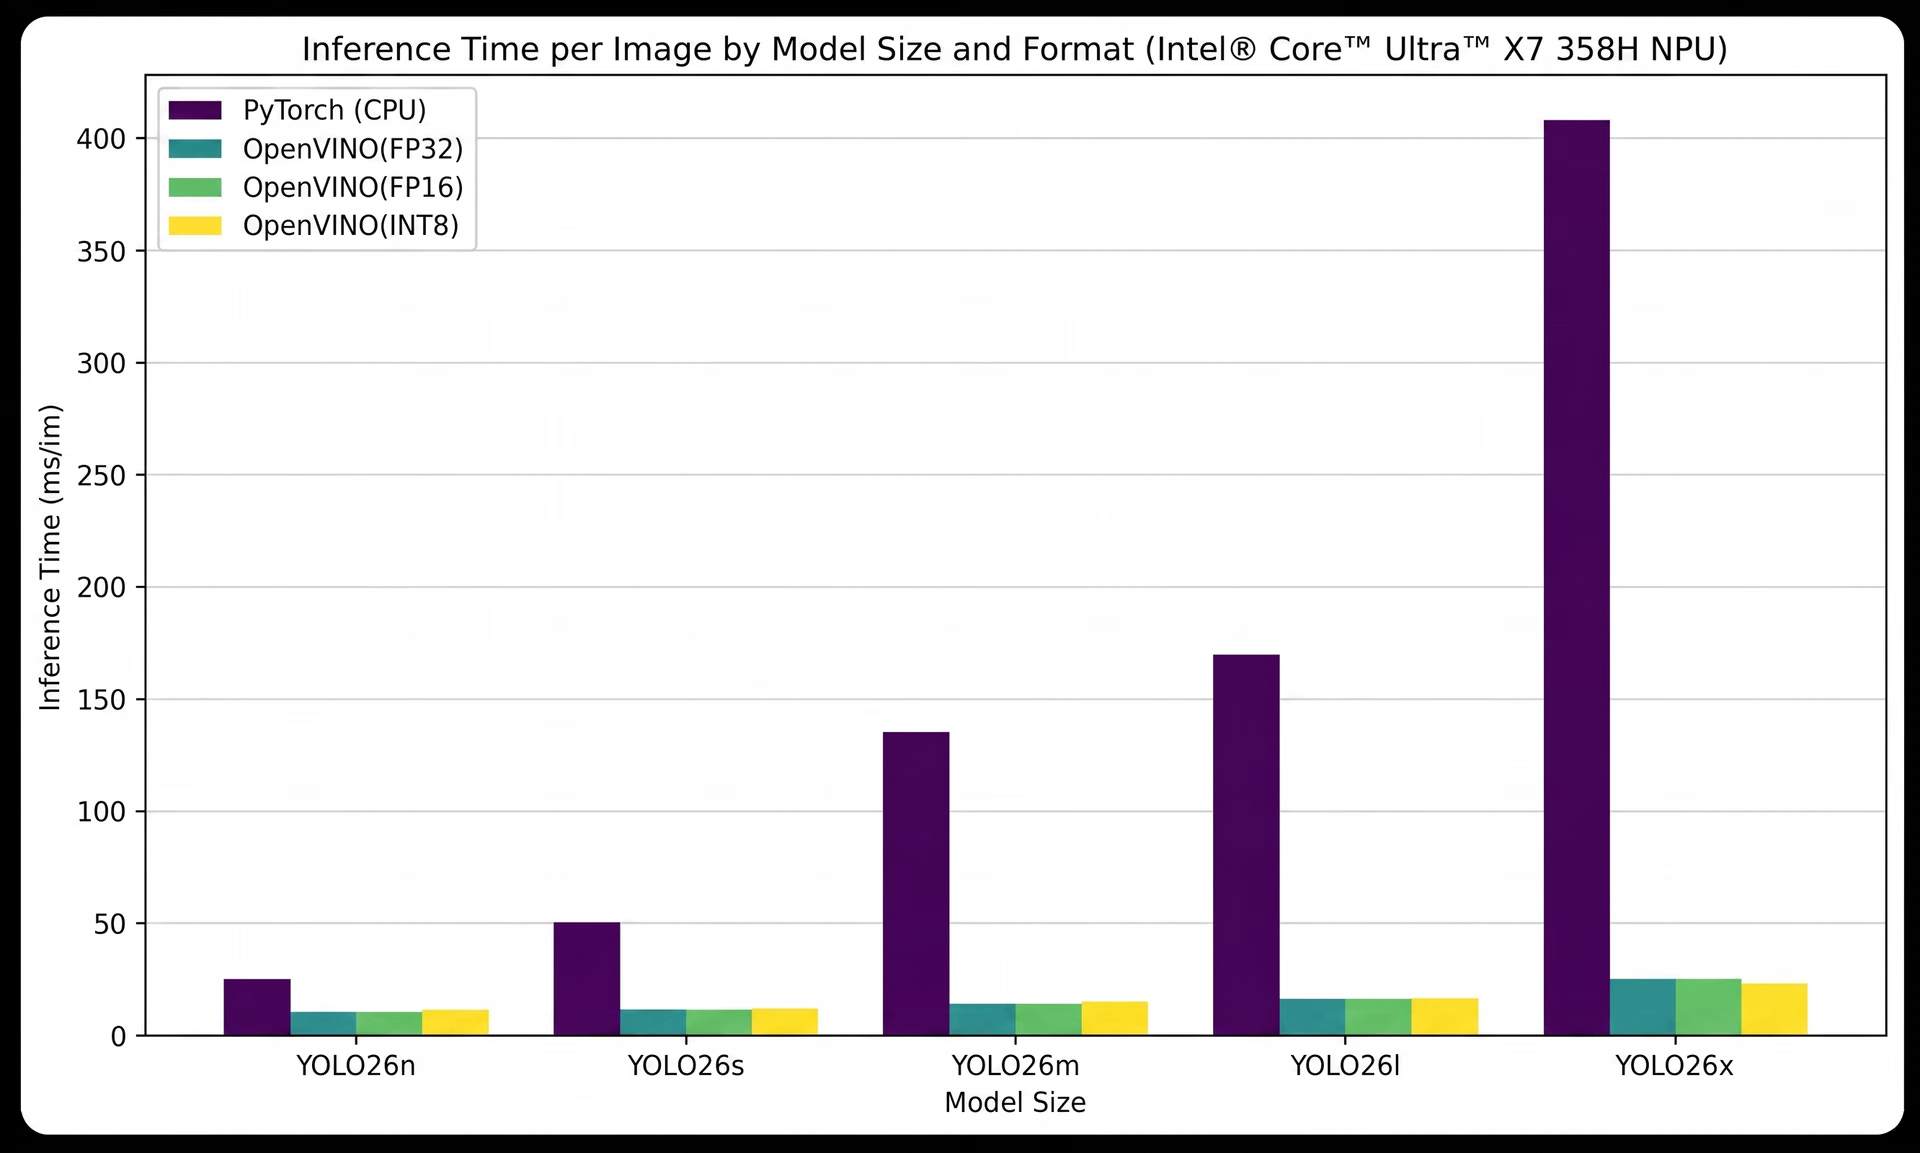
الشكل 3. قياس أداء استدلال Ultralytics YOLO26 على NPU في Intel Panther Lake باستخدام OpenVINO (المصدر)
استكشاف طريقتين لتصدير Ultralytics YOLO26 إلى تنسيق OpenVINO#
هناك طريقتان رئيسيتان لتصدير نماذج YOLO26 إلى تنسيق OpenVINO. يمكنك استخدام حزمة Ultralytics Python أو التصدير مباشرةً عبر Ultralytics Platform، وهي مساحة عمل متكاملة لبناء سير عمل الرؤية الحاسوبية وإدارته في مكان واحد. نستعرض فيما يلي الطريقتين.
استخدام حزمة Ultralytics Python لتصدير YOLO26#
توفر حزمة Ultralytics Python طريقة مباشرة لتصدير نماذج YOLO26 إلى تنسيق OpenVINO ضمن سير عمل قائم على الشيفرة. وبما أن الواجهة نفسها تُستخدم للتدريب والاستدلال، يندمج تصدير النموذج بسلاسة في مسارات العمل الحالية من دون الحاجة إلى أدوات إضافية.
للبدء، يمكنك تثبيت حزمة Ultralytics. ويمكنك ذلك بتشغيل الأمر “pip install ultralytics” في الطرفية أو موجه الأوامر. وإذا كنت تعمل في بيئة تفاعلية مثل Jupyter Notebook أو Google Colab، فيمكنك تشغيل الأمر نفسه مع إضافة علامة التعجب قبله.
بعد التثبيت، يمكنك تحميل نموذج YOLO26 مدرَّب وتصديره مباشرةً إلى تنسيق OpenVINO. وكما هو موضح أدناه، يُحمَّل نموذج YOLO26n مدرَّب مسبقاً (yolo26n.pt)، ثم يُحوَّل إلى تنسيق OpenVINO باستخدام طريقة التصدير.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
بعد تشغيل الشيفرة، يُحفظ النموذج المحوّل في مجلد جديد، حيث يمكن استخدامه للنشر.
تصدير YOLO26 على Ultralytics Platform#
إذا كنت تبحث عن طريقة أبسط لا تتطلب كتابة شيفرة، فيمكنك تصدير نماذج YOLO26 مباشرةً عبر Ultralytics Platform. وتجمع المنصة سير عمل الرؤية الحاسوبية بالكامل في مساحة عمل واحدة، ما يسهّل الانتقال من التدريب إلى النشر من دون إعداد إضافي.
بعد أن يصبح النموذج جاهزاً، يمكنك فتحه داخل المنصة والانتقال إلى علامة تبويب Export. ومن هناك، يمكنك اختيار OpenVINO تنسيقاً للتصدير، وضبط إعدادات اختيارية مثل حجم الصورة أو الدقة.
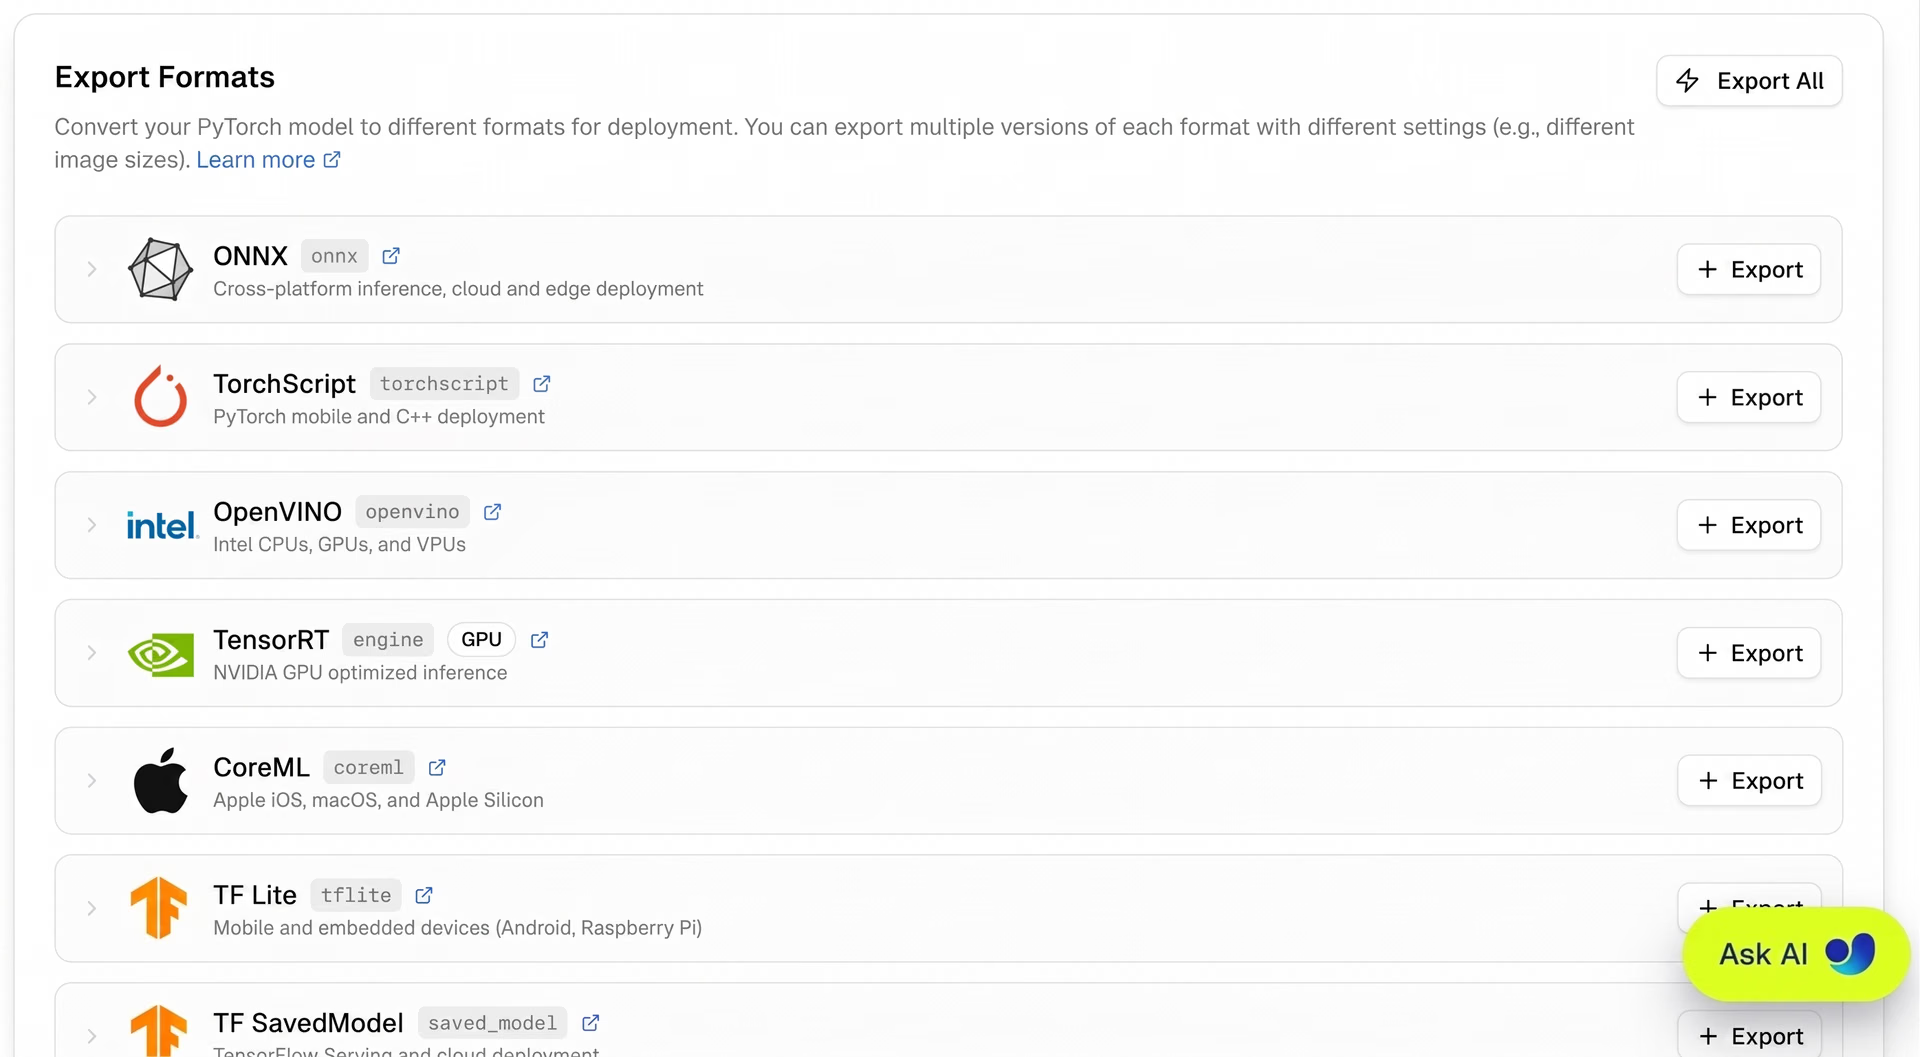
الشكل 4. نظرة على تصدير YOLO26 ضمن Ultralytics Platform
تتولى المنصة التحويل تلقائياً، فلا حاجة إلى إدارة البرامج النصية أو الاعتماديات أو إعداد البيئة. وبعد اكتمال التصدير، يمكن تنزيل النموذج المحسّن واستخدامه للنشر على وحدات CPU وGPU وNPU من Intel.
خيارات النشر التي يتيحها تكامل Ultralytics وOpenVINO#
بعد تصدير نموذج YOLO26 إلى تنسيق OpenVINO، تتوفر عدة طرق لتشغيل الاستدلال بحسب سير عملك ومستوى التحكم الذي تحتاج إليه. يمكنك استخدام حزمة Ultralytics Python لنهج أبسط ومتكامل، أو بيئة تشغيل OpenVINO الأصلية لمزيد من المرونة والتحكم.
تشغيل الاستدلال باستخدام حزمة Ultralytics Python#
بعد تصدير نموذجك إلى تنسيق OpenVINO، يمكنك تشغيل الاستدلال باستخدام حزمة Ultralytics Python. يناسب هذا النهج الاختبارات السريعة والنشر المبسط، إذ يستخدم الواجهة نفسها المستخدمة للتدريب والتصدير.
باستخدام هذا النهج، يمكنك تحميل نموذج OpenVINO المُصدَّر من دليله وتشغيل الاستدلال على مُدخل مثل صورة أو مقطع فيديو. كما يمكنك اختيار الجهاز الذي تريد التشغيل عليه بتحديد خيارات مثل "intel:cpu" أو "intel:gpu" أو "intel:npu"، بحسب العتاد المتاح في نظامك.
يوضح مقتطف الشيفرة أدناه كيفية تحميل النموذج المُصدَّر وتشغيل الاستدلال على صورة مع استهداف GPU. وبعد اكتمال الاستدلال، تُحفظ الصورة الناتجة في الدليل “runs/detect/predict”.
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
الاستفادة من حزمة OpenVINO الأصلية للاستدلال#
إذا كنت بحاجة إلى مزيد من التحكم في تشغيل نموذجك في بيئة الإنتاج، فيمكنك استخدام بيئة تشغيل OpenVINO الأصلية للاستدلال. وتفيد هذه الطريقة عند دمج النماذج في تطبيقات أكبر أو عند الرغبة في ضبط كيفية تنفيذ الاستدلال على عتاد محدد.
يوفر OpenVINO طريقة موحدة لتشغيل النماذج على وحدات CPU وGPU وNPU من Intel، إلى جانب ميزات مثل التنفيذ غير المتزامن والاستخدام الفعال لموارد الحوسبة المتاحة. ولإعداد ذلك، يمكنك العمل مباشرةً مع ملفات النموذج المُصدَّرة، بما فيها ملف .xml الذي يعرّف بنية النموذج وملف .bin الذي يحتوي على الأوزان المدرَّبة.
بحسب حالة الاستخدام، يمكنك أيضاً ضبط إعدادات مثل حجم المُدخل أو خطوات المعالجة المسبقة. ويتضمن إعداد الاستدلال تهيئة بيئة تشغيل OpenVINO، وتحميل النموذج وتجميعه لجهاز مستهدف، وإعداد بيانات المُدخل، ثم تشغيل الاستدلال.
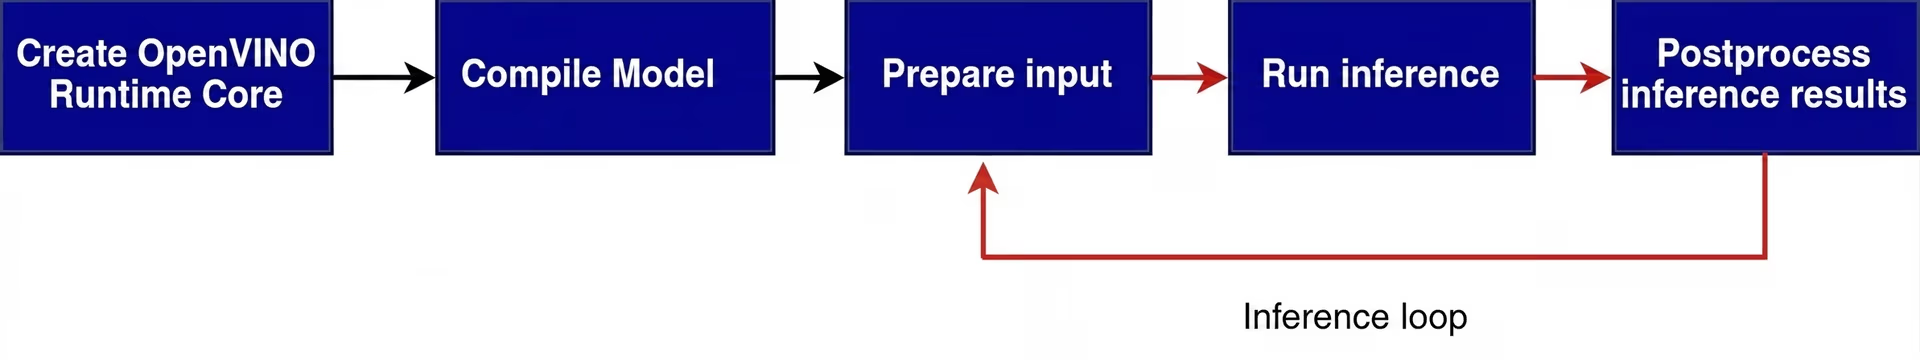
الشكل 5. مثال على مسار استدلال نموذجي باستخدام OpenVINO (المصدر)
يتيح لك ذلك التحكم في كيفية تنفيذ النموذج واندماجه في عملية النشر الشاملة. ولمعرفة المزيد عن إعداد الاستدلال وتشغيله باستخدام بيئة تشغيل OpenVINO، يمكنك الاطلاع على وثائق Ultralytics الرسمية.
تطبيقات Ultralytics YOLO26 في العالم الحقيقي على عتاد Intel#
تظهر القيمة الفعلية لتكامل Ultralytics وOpenVINO في بيئات الإنتاج، حيث يمكن للاستدلال الموثوق ذي زمن الاستجابة المنخفض أن يُحدث فرقاً ملموساً. إليك نظرة على بعض القطاعات الرئيسية التي يحقق فيها هذا التكامل نتائج مهمة:
- التصنيع: من خلال تصدير Ultralytics YOLO26 إلى OpenVINO، يمكن لأنظمة خطوط الإنتاج اكتشاف العيوب البصرية تلقائياً، مثل المكونات المفقودة أو عدم المحاذاة أو تلف السطح، على عتاد Intel، ما يساعد على تحسين جودة المنتجات وتقليل الأخطاء المكلفة.
- الرعاية الصحية: يمكن لأنظمة التصوير الطبي ومراقبة المرضى تشغيل نماذج Ultralytics YOLO26 المُصدَّرة محلياً على عتاد Intel، ما يدعم متطلبات خصوصية البيانات الصارمة مع الحفاظ على أداء استدلال موثوق.
- المدن الذكية: يمكن نشر أنظمة مراقبة حركة المرور وتحليل الحشود باستخدام نماذج Ultralytics YOLO26 المُصدَّرة على كاميرات طرفية تعمل بعتاد Intel، ما يتيح الحصول على رؤى آنية مثل إحصاء المركبات وتتبع المشاة واكتشاف الحوادث.
- السيارات: يُعد زمن الاستجابة المنخفض وكفاءة استهلاك الطاقة عاملين حاسمين في مراقبة السائق والاستشعار داخل المقصورة، ما يجعل عتاد Intel المقترن بنماذج Ultralytics YOLO26 المُصدَّرة خياراً مناسباً لأنظمة السيارات المدمجة.
إذا كنت ترغب في معرفة المزيد عن هذا التكامل، فانضم إلينا في سلسلة ورش عمل OpenVINO DevCon من Intel، بعنوان «من التعليق التوضيحي إلى النشر: بناء مسار عمل لاكتشاف الأجسام باستخدام Geti وUltralytics YOLO26 وOpenVINO™»، حيث سينضم Francesco Mattioli، مدير الشراكات والنظام البيئي لدينا، إلى Adrian Boguszewski، مبشر برمجيات الذكاء الاصطناعي في Intel، لتقديم عرض حي وشرح لكيفية بناء مسارات عمل للرؤية الحاسوبية جاهزة للإنتاج لسيناريوهات صناعية واقعية. وستتناول الورشة سير عمل متكاملاً لاكتشاف الأجسام من البداية إلى النهاية، بدءاً من إنشاء مجموعة البيانات وتدريب النموذج ووصولاً إلى التحسين والنشر على الأجهزة الطرفية.
فوائد استخدام تنسيق التصدير OpenVINO#
إليك بعض المزايا الرئيسية لاستخدام تنسيق التصدير OpenVINO:
- سهل الوصول والدمج: بفضل واجهة API موحدة وأكثر من 80 دفتراً تعليمياً، يسهّل OpenVINO الانتقال من التجريب إلى النشر من دون إضافة تعقيد كبير.
- تشغيل النموذج نفسه على عتاد مختلف: يتيح لك OpenVINO استخدام نموذج مُصدَّر واحد على عتاد Intel المدعوم، ونشره على وحدات CPU أو GPU أو NPU من دون الحاجة إلى إعادة كتابته أو تكييفه لكل جهاز.
- تحسين مدمج أثناء التصدير: يحوّل التصدير إلى OpenVINO النماذج من أطر عمل شائعة مثل PyTorch وTensorFlow إلى تنسيق محسّن وجاهز للاستدلال، ما يلغي الحاجة إلى خطوات تحويل منفصلة.
- استخدام أفضل لموارد العتاد: يدعم OpenVINO الاستدلال غير المتزامن وموازنة الأحمال على عتاد Intel، ما يساعد على تحسين الكفاءة في التطبيقات الواقعية.
تشغيل Ultralytics YOLO26 باستخدام ExecuTorch وخلفية OpenVINO#
إذا كنت تنشر Ultralytics YOLO26 في بيئات إنتاج أكثر تطلباً، فهناك خيار آخر يجمع بين الكفاءة على الجهاز وضغط النماذج المتقدم.
تدعم ExecuTorch، وهي إطار PyTorch للاستدلال على الجهاز، خلفية OpenVINO التي تتيح لك نشر Ultralytics YOLO26 على عتاد Intel عبر مسار مختلف للتصدير وبيئة التشغيل.
تعمل ExecuTorch على إدارة تصدير النموذج وتنفيذه في بيئة التشغيل، بينما يعمل OpenVINO طبقةً لتسريع العتاد في الأسفل، ويتولى الحسابات الفعلية على وحدات CPU أو GPU أو NPU من Intel. ويعمل الاثنان معاً لتستفيد من قابلية النقل والكفاءة على الجهاز التي توفرها ExecuTorch، إلى جانب التحسينات الخاصة بالعتاد التي يقدمها OpenVINO.
لمعرفة المزيد عن آلية العمل وكيفية البدء باستخدام Ultralytics YOLO26 على ExecuTorch وخلفية OpenVINO، اطلع على مدونة Intel التي تتناول أحدث التحديثات الخاصة بـ ExecuTorch وOpenVINO.
أبرز النقاط#
يؤدي تصدير نماذج YOLO26 عبر تكامل Ultralytics وOpenVINO إلى تحسين الأداء على عتاد Intel من دون إضافة تعقيد إلى سير عملك. ويمكنك الانتقال من التدريب إلى النشر من دون إعادة هيكلة مسار عملك. وبوجه عام، يوفر ذلك طريقة مباشرة لتشغيل النماذج بكفاءة على وحدات CPU وGPU وNPU من Intel في التطبيقات الواقعية.
انضم إلى مجتمعنا واستكشف مستودع GitHub لمعرفة المزيد عن الذكاء الاصطناعي للرؤية. واطلع على خيارات الترخيص لبدء مشاريعك في الرؤية الحاسوبية. هل تهتم بابتكارات مثل الذكاء الاصطناعي في التصنيع أو الرؤية الحاسوبية في قطاع السيارات؟ تفضل بزيارة صفحات حلولنا لمعرفة المزيد.









