Jetson Orin Nano Super مقابل Raspberry Pi 5 لكشف الأجسام باستخدام YOLO26
استدلال YOLO26n: 4.57 ms على Jetson Orin Nano Super (TensorRT FP16) مقابل 67.03 ms على وحدة المعالجة المركزية في Pi 5، ضمن اختبارين منفصلين. اختر بناءً على النموذج ومعدل الإطارات وعدد الكاميرات.
 Onuralp Sezer15 دقيقة قراءة
هل ينبغي تشغيل كشف الأجسام على Raspberry Pi 5 أم NVIDIA Jetson Orin Nano؟ لكاميرا واحدة، وهدف معدل إطارات منخفض، ونموذج صغير، قد تكفي وحدة المعالجة المركزية في Pi 5: ففي الاختبار المعياري المنشور لدينا، يستغرق Ultralytics YOLO26n، بعد تصديره إلى NCNN، 67.03 ms للاستدلال على كل صورة عبر أنويته الأربعة من Arm، أي نحو 15 إطارًا للاستدلال في الثانية. عندما تحتاج إلى كاميرات أكثر، أو نموذج أكبر، أو هامش أكبر لمعدل الإطارات مما يتيحه Pi، يصبح Jetson خيارًا مناسبًا: على Jetson Orin Nano Super Developer Kit، يستغرق النموذج نفسه 4.57 ms عند استخدام محرك TensorRT FP16.
تنشر Ultralytics هذه المقارنة وتطوّر YOLO26، الذي يعمل على اللوحتين؛ ولا نصنع أيًا منهما. تستند أرقام Jetson لدينا إلى Orin Nano Super Developer Kit، وهي مجموعة التطوير للمبتدئين من NVIDIA Orin، وتستند أرقام Pi إلى Raspberry Pi 5، ضمن اختبارين منفصلين. ما زال كثيرون يبحثون عن «Jetson Nano»، اللوحة الأصلية التي صدرت عام 2019. وهي تشغّل YOLO26 عبر JetPack 4، لكن دليل Jetson لدينا لا يتضمن نتائج معيارية لـ YOLO26 عليها، لذلك ترد هنا مواصفاتها فقط.
فيما يلي مقارنة اللوحتين بحسب حجم النموذج وهدف معدل الإطارات وعدد تدفقات الكاميرات، وأسباب انخفاض FPS عند إضافة كاميرات، وكيفية قياس أداء كلتا اللوحتين بنفسك، وأيهما يلائم مشروعك. ترد خطوات الإعداد في دليل NVIDIA Jetson ودليل Raspberry Pi، كما يتناول شرحنا التفصيلي لـكشف الأجسام على وحدة المعالجة المركزية في Raspberry Pi 5 جانب Pi بتعمق.
يشغّل Pi 5 نموذج YOLO على وحدة المعالجة المركزية؛ أما Orin Nano Super فيوفّر GPU#
تحل اللوحتان المشكلة نفسها باستخدام مكونات سيليكون مختلفة. Raspberry Pi 5 حاسوب متعدد الأغراض يضم أربعة أنوية Arm Cortex-A76 ولا يحتوي على مسرّع مخصص للذكاء الاصطناعي، لذا تُجرى اختبارات Pi المعيارية لدينا بتشغيل YOLO على وحدة المعالجة المركزية. تجمع Jetson Orin Nano Super Developer Kit بين وحدة Orin Nano، المبنية حول GPU من Ampere، ولوحة حاملة، ويترجم وقت تشغيل TensorRT من NVIDIA النماذج لتعمل على ذلك GPU. إنها منصة ذكاء اصطناعي طرفي مصممة لهذا النوع من أعباء العمل.
| Jetson Nano بسعة 4GB (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| قدرة الحوسبة لتشغيل YOLO | GPU من Maxwell بـ128 نواة | GPU من Ampere بـ1024 نواة و32 نواة Tensor | CPU من Arm Cortex-A76 بأربع نوى |
| CPU | Cortex-A57 بأربع نوى، بتردد 1.43 GHz | Cortex-A78AE بست نوى، حتى 1.7 GHz | Cortex-A76 بأربع نوى، حتى 2.4 GHz |
| الذاكرة | 4 GB LPDDR4، بسرعة 25.6 GB/s | 8 GB LPDDR5، بسرعة 102 GB/s | تختلف بحسب الطراز |
| أداء الذكاء الاصطناعي (القيمة القصوى من NVIDIA) | 472 GFLOPS | 67 TOPS بتنسيق INT8 المتناثر | — |
| JetPack / نظام التشغيل | JetPack 4 فقط | JetPack من الإصدار 5 إلى 7 | Raspberry Pi OS |
| مسار نشر Ultralytics | TensorRT، بما في ذلك DeepStream | TensorRT (الأسرع في اختبارنا المعياري) | NCNN (الأسرع في اختبارنا المعياري) |
المواصفات، لا القياسات، كما جرى التحقق منها في 19 نوفمبر 2026. تستخدم القيم القصوى من NVIDIA تنسيقات أرقام مختلفة، لذا لا يمكن مقارنتها مباشرة. قيمة 67 TOPS في Orin Nano Super هي قيمة متناثرة بتنسيق INT8؛ وتذكر NVIDIA قيمة 33 TOPS الكثيفة. تستند صفوف Jetson إلى جدولي المقارنة وJetPack في دليل NVIDIA Jetson ودليل DeepStream؛ وتستند صفوف Pi 5 إلى وثائق Raspberry Pi.
الطاقة عامل آخر في الاختيار. تحدد NVIDIA قدرة Jetson Orin Nano Super Developer Kit ضمن نطاق 7 W إلى 25 W. عند تثبيت تهيئة مفعّلة لوضع Super على اللوحة، يوفّر Orin Nano 8GB أوضاع طاقة 15 W و25 W وMAXN SUPER؛ أما في التهيئة الافتراضية، فيحتفظ بأوضاعه الأصلية 7 W و15 W. أيًا كانت اللوحة التي تختارها، قِس استهلاك النظام بأكمله مع توصيل الكاميرات، لأن مزود الطاقة والهيكل يجب أن يتحملا هذا الاستهلاك.
احسب تكلفة التجميعة كاملة، لا اللوحة وحدها: فالتخزين والطاقة والتبريد والكاميرات ترفع التكلفة في الحالتين. رفعت Raspberry Pi أسعار Pi 5 أكثر من مرة في عام 2026 مع ارتفاع تكاليف الذاكرة. اعتبارًا من نوفمبر 2026، يبلغ السعر المعلن لـPi 5 بسعة 2GB 77.50 دولارًا، ولـاللوحة بسعة 16GB 385 دولارًا. للاطلاع على أسعار Jetson وتوافره حاليًا، راجع صفحة مجموعة التطوير لدى NVIDIA، وأضف تكلفة أي مسرّع يحتاجه Pi، مثل Raspberry Pi AI HAT+. للإنتاج، تبيع NVIDIA وحدات Jetson لاستخدامها مع لوحة حاملة من تصميمك؛ أما مجموعة التطوير التي اختبرناها فهي مخصصة للتطوير والنمذجة الأولية.
تناسب وحدة المعالجة المركزية في Pi 5 أعباء YOLO26n ذات معدل الإطارات المنخفض#
يتعامل Pi 5 مع كشف الأجسام بكاميرا واحدة دون أجهزة إضافية عندما يكون معدل الإطارات المطلوب متواضعًا. في الاختبار المعياري من Ultralytics (تصدير FP32، إدخال بدقة 640 بكسل، COCO128، Ultralytics 8.4.108، زمن الاستدلال فقط)، كان NCNN أسرع تنسيق تصدير: 67.03 ms للصورة الواحدة من YOLO26n، عند قيمة mAP50-95 تبلغ 0.4784. يعادل ذلك نحو 15 FPS للاستدلال، وهو ما قد يناسب محطة عدّ أو كاميرا رف أو نموذجًا أوليًا للروبوتات لا يتطلب حركة سريعة. تحقّق من مسار عمل الكاميرا كاملًا، لا من الاستدلال وحده. وتنشر Arm أيضًا وقت تشغيل مفتوح المصدر لـ YOLO26n على Pi 5، وقد قاست سرعته لتجدها أعلى من NCNN في اختبارها الخاص؛ وتقارن جولتنا التفصيلية حول Raspberry Pi 5 بينهما.
حجم النموذج هو موضع قصور Pi. يستغرق YOLO26s الأكبر 172.88 ms باستخدام NCNN على Pi 5، أي أقل من 6 FPS للاستدلال. لا تغطي مقارنة تنسيقات النماذج المتعددة في دليل Raspberry Pi (Ultralytics 8.4.108) سوى n وs. أما مقارنة ONNX الأقدم (Ultralytics 8.4.14) فتتضمن أيضًا m وl وx، وتذكر أن YOLO26m يستغرق 993.78 ms. إذا دفعتك الأجسام الصغيرة أو الفئات التي يصعب التمييز بينها إلى اختيار نموذج أكبر أو دقة إدخال أعلى، فاختبر ذلك النموذج على اللوحة قبل اتخاذ القرار.
إضافة AI HAT+ إلى Pi 5#
هناك إعداد ثالث يستحق النظر: Pi 5 مع AI HAT+ من Raspberry Pi، الذي يضيف مسرّع Hailo بإصدارين، 13 TOPS و26 TOPS. في الاختبار المعياري لتكامل Hailo من Ultralytics (Ultralytics 8.4.174، COCO128)، يستغرق YOLO26n المُصدّر لإصدار Hailo-8 ذي 26 TOPS 21.7 ms للصورة الواحدة عند قيمة mAP50-95 تبلغ 0.455، مقارنةً بـ364.6 ms لنموذج PyTorch غير المُصدّر على Pi نفسه. لا يحدد هذا الاختبار حجم الإدخال، ويعمل بتنسيق INT8، لذا اعتبره اختبارًا معياريًا منفصلًا لا صفًا في المقارنة أدناه. تحتاج نماذج Hailo إلى خطوة ترجمة، لذا تحقّق من الدقة على صورك بعد التصدير.
على Orin Nano Super، يستغرق YOLO26n إلى YOLO26l أقل من 18 ms#
على Jetson، يصبح تشغيل النماذج الأكبر عمليًا. تضع الاختبارات المعيارية من Ultralytics على Jetson Orin Nano Super Developer Kit (إدخال بدقة 640 بكسل، COCO128، Ultralytics 8.4.33، الاستدلال فقط) كل حجم من n إلى l دون 18 ms للاستدلال على الصورة الواحدة باستخدام محرك TensorRT FP16:
| نموذج YOLO26 | وحدة المعالجة المركزية في Raspberry Pi 5 (ms/صورة) | Orin Nano Super، TensorRT FP16 (ms/صورة) | قيمة mAP50-95 لنموذج Orin Nano Super، FP16 |
|---|---|---|---|
| YOLO26n | 67.03 (NCNN FP32، 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172.88 (NCNN FP32، 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993.78 (اختبار ONNX أقدم، 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259.46 (اختبار ONNX أقدم، 8.4.14) | 17.42 | 0.6225 |
نتائج منشورة من اختبارات منفصلة. Orin Nano Super: Ultralytics 8.4.33. جميع الصفوف بإدخال بدقة 640 بكسل، وزمن الاستدلال فقط، دون المعالجة المسبقة واللاحقة.
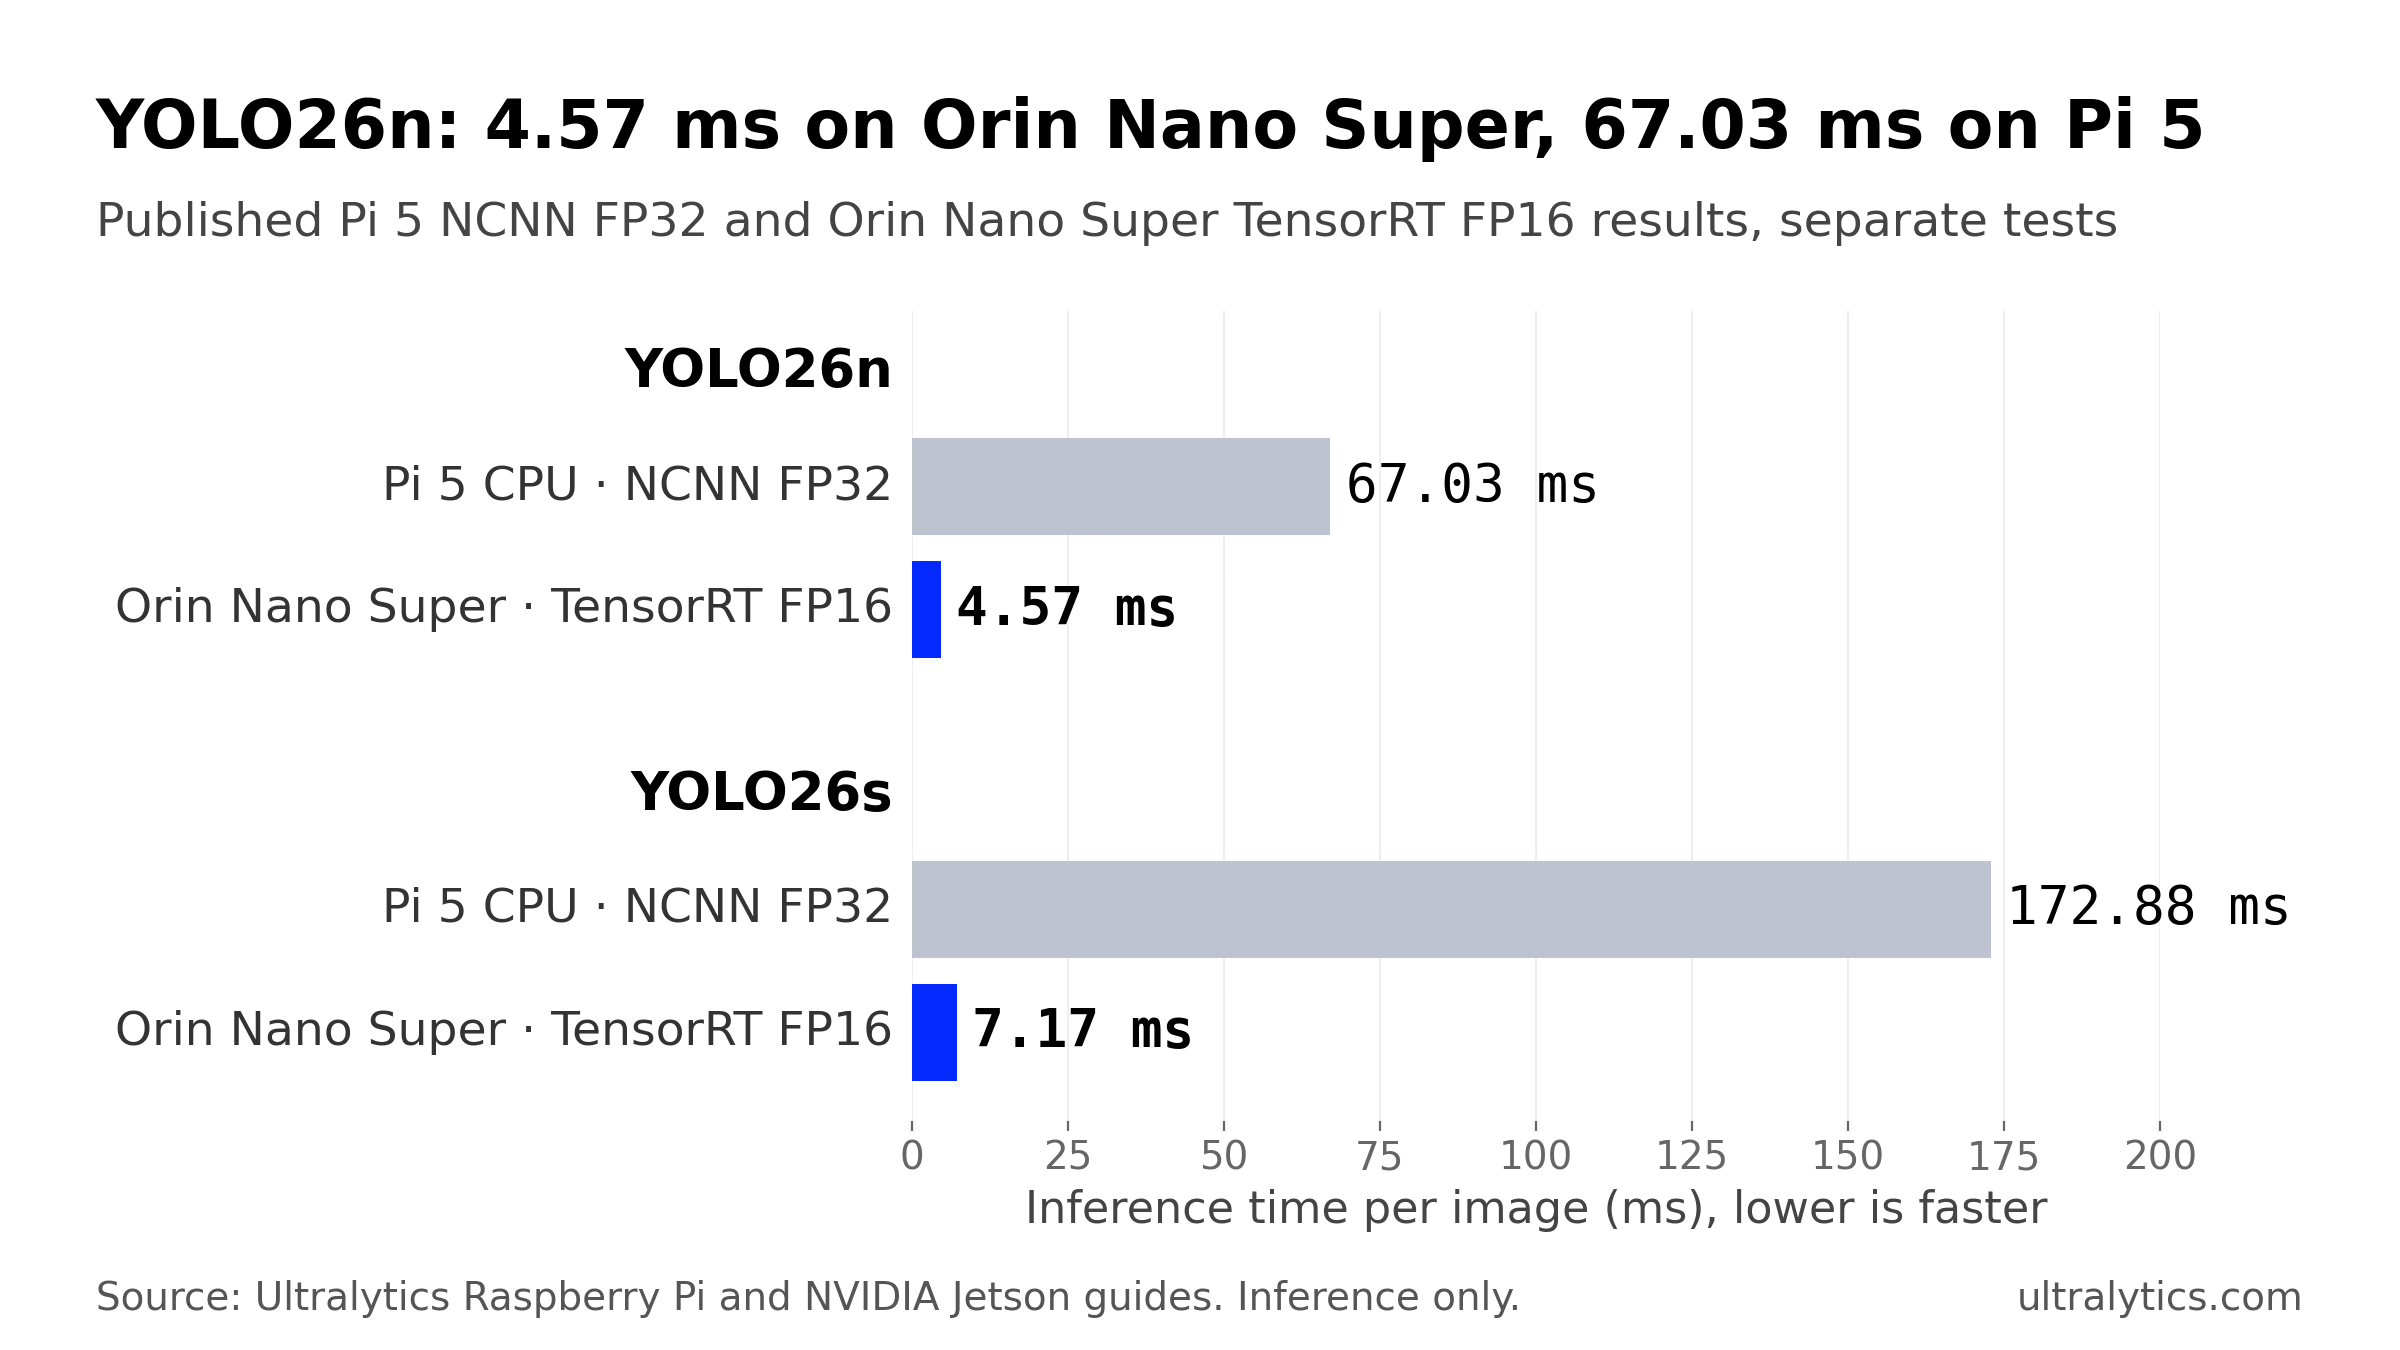
نتائج NCNN FP32 وTensorRT FP16 المنشورة من اختبارين منفصلين: Raspberry Pi 5 مع Ultralytics 8.4.108، وOrin Nano Super Developer Kit مع Ultralytics 8.4.33. الاستدلال فقط، دون المعالجة المسبقة واللاحقة. المصدر: دليلا Raspberry Pi وNVIDIA Jetson من Ultralytics.
يعادل ذلك لـ YOLO26n زمن استدلال أقل بنحو 93% من وحدة المعالجة المركزية في Pi 5. يعود جزء من الفارق إلى الدقة، لذا قارن عمليات التصدير بتنسيق FP32 أيضًا: يستغرق محرك TensorRT FP32 في Orin Nano Super 7.53 ms، ولا يزال أسرع بنحو تسع مرات من تصدير NCNN FP32 على Pi، رغم اختلاف وقتي التشغيل وإصدارات الاختبار. أما النتيجة الأبرز فهي YOLO26m: 0.6225 mAP50-95 في 13.59 ms، وهو نموذج شغّلته وحدة المعالجة المركزية في Pi 5 بمعدل يقارب إطارًا واحدًا في الثانية في اختبار ONNX الأقدم.
يقلل INT8 الزمن قليلًا أيضًا. ينخفض زمن YOLO26n إلى 3.80 ms باستخدام محرك INT8، لكن قيمة mAP50-95 تتراجع من 0.4800 إلى 0.4490 على COCO128، لذا ابدأ بـFP16 وانتقل إلى تكميم INT8 فقط إذا لم يحقق FP16 ميزانيتك وكان بإمكانك المعايرة باستخدام صور من كاميراتك. يشرح درس Academy حول التحسين باستخدام TensorRT كيفية اتخاذ هذا القرار.
ينخفض FPS عند إضافة كاميرات لأن كل تدفق يشترك في ميزانية واحدة#
من الأنماط الشائعة عند التوسع: تعمل كاميرا واحدة بسلاسة، ثم ينخفض معدل الإطارات المعالَجة عند إضافة كاميرا ثالثة أو رابعة. تتطلب كل صورة فك الترميز والمعالجة المسبقة والاستدلال والمعالجة اللاحقة، وتستهلك كل كاميرا من موارد الحوسبة المشتركة. على Pi 5، تفك أنوية وحدة المعالجة المركزية الأربعة نفسها ترميز الفيديو وتشغّل النموذج، لذا تستهلك كل تدفقات إضافية وقتًا من المهمتين.
تتولى Ultralytics إدارة البنية التشغيلية. أدرج مصدرًا واحدًا في كل سطر في ملف .streams ومرّره إلى وضع التنبؤ: يحصل كل تدفق على خيط قارئ خاص به، ويجمع المحمّل أحدث إطار من كل كاميرا في دفعة واحدة، لذا قد يؤدي مصدر بطيء أو متوقف إلى تعطيل الدفعة. تشغّل الواجهات الخلفية التي تقبل الدُفعات هذه الدفعة في تمريرة أمامية واحدة؛ أما NCNN فيعالج الإطارات واحدًا تلو الآخر، ويُقسّم الدفعة أو تُضاف إليها حشوة لتناسب حجم التصدير في محرك TensorRT ذي الأبعاد الثابتة. افتراضيًا (stream_buffer=False)، يتخطى النموذج البطيء الإطارات القديمة بدلًا من وضعها في قائمة انتظار، ما يبقي التراكم داخل تطبيقك قصيرًا، مع أن التخزين المؤقت في الكاميرا أو مفكك الترميز أو الشبكة قد يضيف زمن استجابة.
زمن الاستجابة لصورة واحدة هو نقطة بداية، وليس عدد الكاميرات. يغيّر التجميع معدل الإنتاجية، وتضيف عمليات فك الترميز والتتبع والرسم تكاليفها الخاصة. يشرح درس الاستدلال متعدد التدفقات في Ultralytics Academy قاعدة تحديد السعة: يقارب عدد التدفقات لكل جهاز معدل الإنتاجية المستدام عند حجم الدفعة الفعلي، مقسومًا على FPS الذي يحتاجه كل تدفق، مع هامش احتياطي يتراوح بين 20 و30% لمواجهة الذروات. قِس معدل الإنتاجية هذا على اللوحة مع توصيل الكاميرات، كما يوضح القسم التطبيقي أدناه. بالنسبة إلى مسارات عمل الكاميرات المتعددة على Jetson، يشغّل DeepStream عدة مصادر عبر محرك TensorRT واحد ضمن تطبيق واحد مقسّم إلى مربعات.
اختر بناءً على FPS المقاس لكل كاميرا وحجم النموذج ودقته#
ابدأ بأقل اللوحات تكلفةً مما قد يفي بالغرض، واختبرها على كاميراتك، ثم انتقل إلى خيار أعلى فقط عندما لا تفي بالغرض:
| إذا أظهرت قياساتك أن… | ابدأ بـ |
|---|---|
| يحقق YOLO26n هدف الدقة المطلوب وFPS المطلوب لكل كاميرا | وحدة المعالجة المركزية في Pi 5 مع NCNN. قد يناسب العمل بمعدل FPS منخفض أكثر من كاميرا. |
| معدل الإطارات في Pi غير كافٍ، لكنك تريد الاستمرار في استخدامه | Pi 5 مع مسرّع مثل Hailo-8 AI HAT+ أو DEEPX DX-M1. يشغّل كلاهما نماذج مكمّمة ويضيف خطوة ترجمة، لذا تحقّق من الدقة بعد التصدير. |
| تحتاج إلى نموذج أكبر بمعدل FPS أعلى، أو تدفقات أكثر مما يستطيع Pi مواصلته، أو وقت من وحدة المعالجة المركزية لبرامج أخرى | Jetson Orin Nano Super مع TensorRT، مع الانتقال إلى Orin NX أو AGX Orin عندما لا يكفي معدل الإنتاجية الذي تقيسه. |
معدل الإطارات متطلب عملي قبل أن يكون رقمًا في اختبار معياري. يشرح دليلنا حول FPS في الرؤية الحاسوبية كيفية تحديده بناءً على سرعة ما تراقبه، ويتناول دليل اختيار الجهاز الطرفي المناسب لوحات أخرى غير هاتين.
قِس أداء اللوحتين باستخدام كاميراتك#
قِيست الأرقام أعلاه في ظروف ثابتة، وستختلف نتائجك بحسب التبريد ووضع الطاقة وصورة نظام التشغيل وإصدار البرنامج والنموذج الذي تستخدمه. تستخدم حزمة Ultralytics واجهة API نفسها على اللوحتين، لذا يمكنك إجراء القياس نفسه على كلتيهما. جرى التحقق من الأوامر أدناه باستخدام Ultralytics 8.4.215.
الخطوة 1: قياس أداء تنسيقات التصدير على كل لوحة#
شغّل yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 على اللوحة. يعرض وضع قياس الأداء الحجم وقيمة mAP50-95 وزمن الاستدلال لكل تنسيق تصدير تدعمه اللوحة؛ أضف quantize=16 أو quantize=8 لقياس FP16 أو INT8 عندما يدعم التنسيق ذلك. على Jetson Orin Nano Super Developer Kit المثبّت عليها إعداد مفعّل لوضع Super، اختر أولًا وضع الطاقة MAXN SUPER؛ وفي منشور Super Mode من NVIDIA بشأن JetPack 6.2 على Orin Nano، يكون الأمر sudo nvpmodel -m 2. ثم شغّل sudo jetson_clocks. راقب درجات الحرارة أثناء التشغيل لفترات طويلة.
الخطوة 2: تصدير أسرع تنسيق على كل لوحة#
على Raspberry Pi 5، صدّر إلى NCNN كما هو موضح في جولتنا التفصيلية حول Raspberry Pi 5. على Jetson، أنشئ المحرك على الجهاز نفسه، لأن محركات TensorRT مرتبطة بإصدار TensorRT وGPU اللذين استُخدما لإنشائها. للمحرك الذي صُدّر دون dynamic أبعاد إدخال ثابتة. أحد الخيارات هو ضبط batch على عدد كاميراتك، وإعادة التصدير بدقة imgsz أصغر إذا احتجت إلى سرعة أكبر:
from ultralytics import YOLO
# Jetson فقط: يتطلب NVIDIA GPU. محرك TensorRT FP16، بدقة 640 بكسل، ودفعة من أربع كاميرات
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4) # يكتب yolo26n.engineالخطوة 3: قياس FPS المعالَج لكل كاميرا#
ضع عنوان RTSP URL واحدًا في كل سطر من cams.streams، وشغّل نموذج اللوحة عليه نحو دقيقة، ثم قارن FPS المعالَج لكل كاميرا بمعدل الإطارات الذي ترسله. يبدأ المؤقّت بعد أول دفعة كاملة، عقب اتصال التدفقات واستقرار النموذج، ويتوقف عند اكتمال دفعة:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
يقيس هذا معدل إنتاجية النتائج المعالَجة لمسار العمل هذا. إذا أصبح FPS المعالَج لكاميرا أقل بكثير من معدل إطاراتها عند إضافة التدفقات، فهذا يعني أن اللوحة لا تواكبها. تحقّق من ذلك باستخدام عدّادات صريحة للإطارات المُسقطة لكل تدفق من مثال المنتج والمستهلك في درس Academy متعدد التدفقات، وأضف التتبع أو الرسم الذي يحتاجه تطبيقك، ثم أعد التصدير بدقة imgsz أصغر، أو انتقل إلى نموذج أصغر أو تنسيق تصدير أسرع، أو استخدم أجهزة أقوى، ثم أعد القياس.
إذا كنت تفضّل عدم إعداد بيئة بناء، فإن علامة التبويب Export في Ultralytics Platform تنشئ محركات TensorRT لأجهزة Jetson المستهدفة، بما في ذلك Orin Nano 8GB Super. تُبنى اختيارات Orin على AGX Orin، وما زال التحقق على Orin Nano نفسه قيد الانتظار؛ لذا تحقّق من توافق TensorRT ووقت تشغيل CUDA على جهازك مع المحرك، وتحقّق من كل محرك على الجهاز الذي ستنشره عليه. للمقارنة بين ONNX Runtime وTensorRT على NVIDIA GPU، راجع ONNX مقابل TensorRT.
أي لوحة تختار؟#
اختر Raspberry Pi 5 عندما يحقق YOLO26n هدف الدقة المطلوب، ويغطي FPS المعالَج الذي تقيسه على اللوحة جميع الكاميرات التي تحتاج إليها. بمعدل يقارب 15 FPS للاستدلال، فهو خيار بسيط لمحاسبة البيع بالتجزئة، وعدّ المنتجات على السيور الناقلة، ومراقبة الحياة البرية، وكاميرات المنازل، والنماذج الأولية المبكرة للروبوتات. أضف مسرّعًا عندما تحتاج إلى إطارات أكثر وتريد الاستمرار في استخدام Pi.
اختر Jetson Orin Nano Super عندما تحتاج إلى نموذج أكبر من nano بمعدل إطارات عملي، أو تدفقات أكثر مما يستطيع Pi مواصلته، أو وقتًا متاحًا لوحدة المعالجة المركزية للتتبع والملاحة وبقية تطبيقك. يستغرق YOLO26s إلى YOLO26l أقل من 18 ms للاستدلال على الصورة الواحدة، وتستفيد من هذا الهامش عند إضافة الكاميرات. قِس أداء التطبيق كاملًا للتحقق من ذلك.
موضع Ultralytics في المنظومة#
لا تصنع Ultralytics أيًا من اللوحتين؛ بل نصنع النماذج والأدوات التي تعمل عليهما. يمكن تصدير أوزان YOLO26 نفسها إلى NCNN لاستخدامها على Pi 5، وإلى Hailo لاستخدامها على Pi مع AI HAT+، وإلى TensorRT لاستخدامها على Jetson، ما يتيح لك إنشاء نموذج أولي على Pi والانتقال إلى Jetson عند ازدياد أعباء العمل دون إعادة التدريب؛ تحقّق من الدقة بعد كل عملية تصدير. تتولى Ultralytics Platform الخطوات السابقة للنشر: أضف تعليقات توضيحية إلى مجموعة بيانات، ودرّب في السحابة عندما يحتاج مشروعك إلى موارد تدريب أكثر مما يتوفر لديك محليًا، ثم صدّر إلى أي من اللوحتين.
القيود: تقتصر اختباراتنا المعيارية المنشورة على الاستدلال، وأُجريت على أجهزة الاختبار المحددة بالاسم، لا على كاميراتك أو هيكلك أو وحدة الإنتاج لديك، كما أن دليل Jetson لدينا لا يتضمن نتائج YOLO26 على Jetson Nano الأصلي. يتوفر Ultralytics YOLO بموجب AGPL-3.0 أو ترخيص Ultralytics Enterprise؛ راجع ترخيص Ultralytics لمعرفة متطلبات النشر لديك.
الأسئلة الشائعة
إنه أسرع بكثير لكل صورة. في اختباراتنا المعيارية المنشورة من اختبارين منفصلين، يستغرق YOLO26n 4.57 ms باستخدام محرك TensorRT FP16 على Jetson Orin Nano Super Developer Kit، مقابل 67.03 ms باستخدام NCNN على وحدة المعالجة المركزية في Raspberry Pi 5 (إدخال بدقة 640 بكسل، الاستدلال فقط)، ويستغرق YOLO26m 13.59 ms على Jetson. يعتمد احتياجك إليه على النموذج وعدد الكاميرات وهدف FPS: إذا حقق Pi 5 هذه المتطلبات في قياساتك، فسيكون الخيار الأبسط.
لا. أُطلق Jetson Nano الأصلي عام 2019 مزودًا بـGPU من Maxwell ذي 128 نواة وذاكرة بسعة 4 GB، ولا يدعم سوى JetPack 4. أما Jetson Orin Nano فهو وحدة أحدث مزودة بـGPU من Ampere ذي 1024 نواة؛ وتضم Jetson Orin Nano Super Developer Kit التي اختبرناها ذاكرة بسعة 8 GB وتدعم JetPack من الإصدار 5 إلى 7. تغطي مقارنة الأداء في هذه المقالة Orin Nano Super، لا Nano الأصلي.
نعم. يدعم Jetson Nano الصادر عام 2019 JetPack 4، وتوفّر Ultralytics صورة Docker لـJetPack 4، كما اختُبر دليل DeepStream لدينا لـ YOLO26 باستخدام TensorRT على Jetson Nano 4GB مع JetPack 4.6.4. لا يتضمن دليل Jetson لدينا اختبارًا معياريًا لـ YOLO26 عليه، كما أن عتاده أضعف بكثير من Orin Nano Super.
تشترك جميع التدفقات في موارد الحوسبة للوحة: إذ تحتاج كل كاميرا مضافة إلى فك الترميز والمعالجة المسبقة والاستدلال والمعالجة اللاحقة الخاصة بها. باستخدام ملف
.streams، تجمع Ultralytics الإطارات من جميع الكاميرات في دفعات وتتخطى الإطارات القديمة عندما يتأخر النموذج، لذا قد ينخفض FPS المعالَج لكل كاميرا عندما يصبح مسار العمل المشترك عنق الزجاجة. يرفع ذلك استخدام تنسيق تصدير أسرع أو نموذج أصغر أوimgszأو أجهزة أقوى.نعم. درّب مرة واحدة، ثم صدّر الأوزان نفسها باستخدام
format="ncnn"لـ Pi 5 وformat="engine"لـ Jetson، مع إنشاء محرك TensorRT على الجهاز المستهدف أو له. تحقّق من الدقة على بياناتك بعد كل عملية تصدير.
بقلم
مهندس تعلم آلي أول · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









