مقارنة منصات التدريب المُدارة بوحدات GPU المستضافة ذاتيًا في مجال الرؤية الحاسوبية
قارن بين منصات التدريب المُدارة على GPU وخدمات تعلّم الآلة السحابية ووحدات GPU المستأجرة وأجهزتك الخاصة في مجال الرؤية الحاسوبية: التكاليف والإعداد ونقطة التعادل ومتى يناسب كل خيار.
 Miles Deans9 دقيقة قراءة
تتولى منصات التدريب المُدارة تشغيل البنية التحتية للتدريب نيابةً عنك، وتحتسب التكلفة وفق مدة استخدام GPU؛ أما وحدات GPU المستضافة ذاتيًا فتجعل فريقك مسؤولًا عن الأجهزة والبيئة، سواء استأجرت الأجهزة أم امتلكتها. يناسب التدريب المُدار عادةً أعباء العمل المتقطعة والفرق التي ترغب في تقليل العمل المتعلق بالبنية التحتية. وقد يكون امتلاك وحدات GPU أقل تكلفةً عند الاستخدام المستمر، لكن النتيجة تعتمد على مدى انشغال الأجهزة، وعمرها الافتراضي، والكهرباء، والوقت الهندسي.
يقارن هذا الدليل بين أربعة خيارات شائعة لتدريب نماذج الرؤية في عام 2026، ويوضح كيفية حساب نقطة التعادل لأعباء العمل الخاصة بك، ويشرح موضع Ultralytics Platform بينها.
الخيارات الأربعة لتدريب نموذج للرؤية#
غالبًا ما يخفي تعبير «مُدار مقابل مستضاف ذاتيًا» أربعة إعدادات مختلفة:
- منصة مُدارة لتدريب نماذج الرؤية. تحمّل مجموعة بيانات أو تربطها، وتختار نموذجًا وGPU، ثم تتولى المنصة التدريب. تعمل Ultralytics Platform بهذه الطريقة مع نماذج YOLO.
- منصة تعلّم آلي للأغراض العامة. تشغّل خدمات مثل Amazon SageMaker وGoogle Vertex AI وAzure Machine Learning مهام التدريب على مثيلات سحابية لأُطر عمل عديدة. تضبط مهمة التدريب وبيئتها وأذوناتها وتخزينها، وتُحتسب تكلفة الحوسبة والخدمات المرتبطة بها على نحو منفصل؛ لذا راجع صفحة الأسعار الرسمية لكل مزود بدلًا من مقارنة أسعار GPU وحدها.
- GPU سحابي مستأجر. تؤجّر لك سُحُب GPU مثل RunPod وLambda جهازًا بحسب مدة الاستخدام. وما لم تتضمن صورة المزود مسبقًا ما تحتاج إليه، فعليك إعداد برامج التشغيل وCUDA وحزم Python ورمز التدريب، وإيقاف المثيل عند الانتهاء.
- وحدة GPU تملكها. محطة عمل أو خادم في مكتبك أو مركز بياناتك. تشتري الأجهزة مرة واحدة، وتدفع تكاليف الطاقة والتبريد والصيانة والوقت اللازم لإبقائها قيد التشغيل.
التدريب المُدار مقابل وحدات GPU المستضافة ذاتيًا بنظرة سريعة#
| عامل القرار | منصة مُدارة للرؤية الحاسوبية | منصة تعلّم آلي عامة | GPU سحابي مستأجر | GPU مملوك |
|---|---|---|---|---|
| هل يلزم شراء الأجهزة | لا | لا | لا | نعم |
| ما الذي تدفع مقابله | مدة استخدام GPU | مدة استخدام المثيل والخدمات المرتبطة به | مدة تشغيل المثيل | الأجهزة والطاقة والصيانة |
| الإعداد قبل التشغيل الأول | اختيار مجموعة البيانات والنموذج وGPU | ضبط المهمة والبيئة والأذونات والتخزين | إعداد البيئة والرمز والتبعيات أو التحقق منها | الأجهزة ونظام التشغيل وبرامج التشغيل والحزم |
| بيئة التدريب | تشغّلها المنصة؛ وأنت تختار الإعدادات | مسؤولية مشتركة بين الخدمة وفريقك | فريقك في الغالب | فريقك |
| الحصول على GPU أكبر | اختيار GPU آخر متاح | اختيار نوع مثيل آخر | استئجار جهاز آخر | شراء GPU آخر |
| موقع البيانات | تخزين المنصة، أو حاوية سحابية متصلة (Pro وEnterprise)، أو بيانات محلية في مقرك (Enterprise) | حسابك السحابي | أي مكان تنسخ البيانات إليه | في مقرك |
| متى يكون مناسبًا | تدريب سريع ومتكرر لنماذج الرؤية | الفرق التي تعتمد مسبقًا أدوات تعلّم الآلة لدى مزود سحابي واحد | المهندسون المتمرسون في إدارة الأجهزة | التدريب المستمر أو شبه المتواصل، أو القواعد الصارمة التي تفرض بقاء البيانات في المقر |
آلية احتساب تكلفة التدريب المُدار على GPU#
على Ultralytics Platform، يسهل تقدير تكلفة GPU في عملية التدريب:
GPU cost = selected GPU hourly rate × billable GPU hoursعند مقارنة المزودين، استخدم عبء العمل نفسه والدقة المستهدفة نفسها، وأضف أي اشتراك أو تخزين أو نقل بيانات أو وقت هندسي إلى التكلفة.
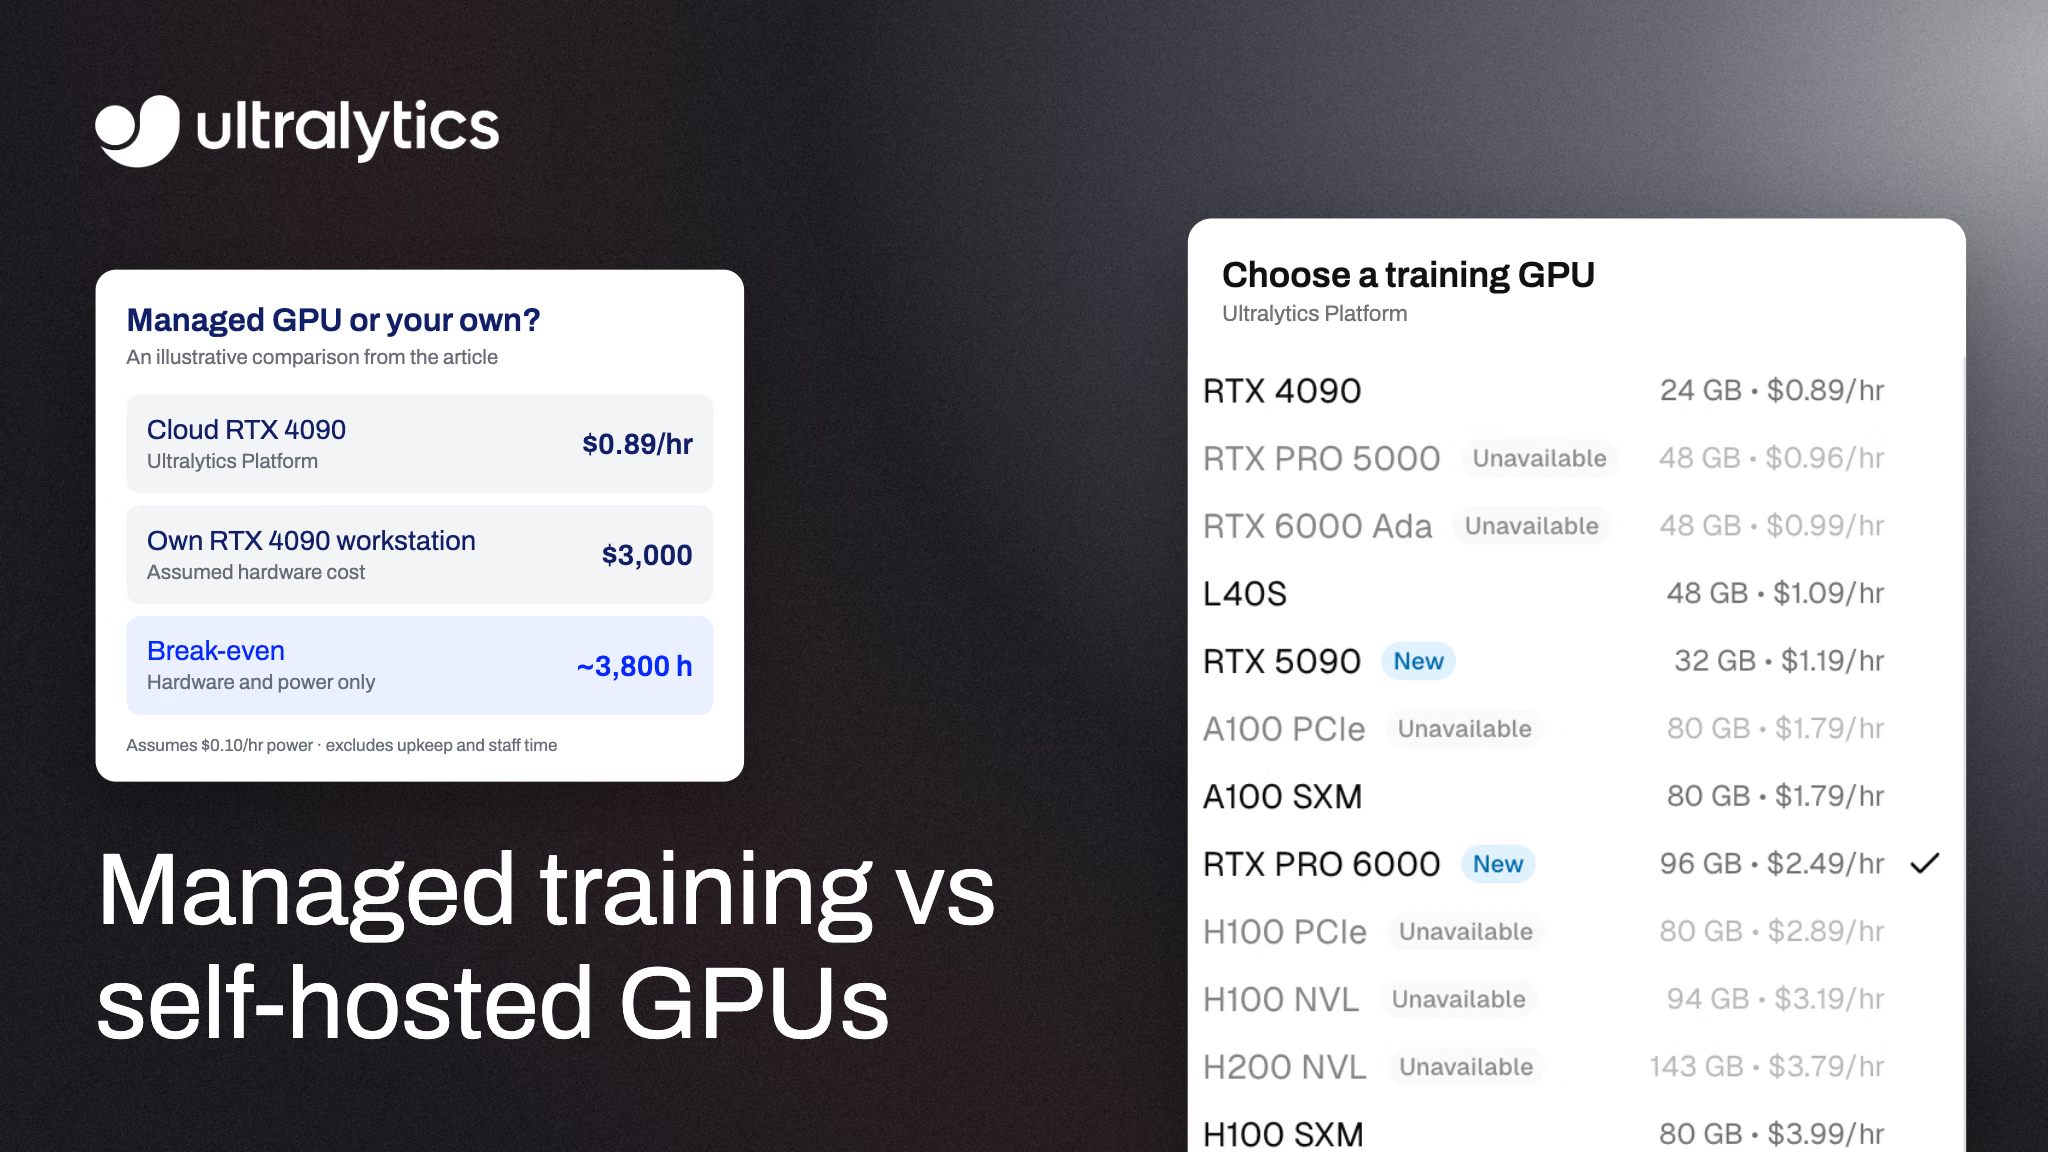
تدرج Ultralytics Platform 26 نوعًا من وحدات GPU من NVIDIA، تبدأ أسعارها من $0.24/hr، من دون حد أدنى أو التزام؛ ويمكن للخطة المجانية استخدام 24 منها، بينما تتيح خطتا Pro وEnterprise الأنواع الـ26 كلها. فيما يلي بعض الخيارات الشائعة:
| وحدة GPU | ذاكرة VRAM | السعر لكل ساعة |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (الخيار الافتراضي الموصى به) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (خطتا Pro وEnterprise) | 180 GB | $7.99 |
تُحتسب الفوترة وفق مدة استخدام GPU الفعلية. تُفرض رسوم على عمليات التدريب المكتملة والملغاة وتلك التي تفشل بعد بدء GPU، بناءً على مدة استخدام GPU المنقضية؛ أما الإخفاق قبل بدء GPU فلا يكلف شيئًا. تعرض نافذة التدريب تقديرًا للمدة والتكلفة قبل البدء، ويحجز كل تقدير 15 دقيقة على الأقل من رصيد وقت GPU لديك؛ ويحدد هذا الحجز الرصيد اللازم لبدء التدريب، بينما تُحتسب الفوترة وفق مدة استخدام GPU الفعلية.
لوضع ذلك في سياقه، تستغرق أوقات التدريب المعتادة لدى Ultralytics، لتدريب 1,000 صورة على مدى 100 حقبة باستخدام RTX PRO 6000، نحو 15 دقيقة لـYOLO26m ونحو 30 دقيقة لـYOLO26x. وبسعر $2.49 للساعة، يعادل ذلك نحو $0.62 و$1.25 من وقت GPU. تختلف المدة الفعلية باختلاف حجم الصورة والتعزيز وحجم الدفعة؛ لذا اعتبر هذه الأرقام تقديرات أولية لا عروض أسعار.
التكلفة الحقيقية لوحدات GPU المستضافة ذاتيًا#
لا تُحتسب فاتورة بالساعة لوحدة GPU التي تملكها، لكنها ليست مجانية عند كل عملية تدريب. تشمل التكلفة الإجمالية:
- الأجهزة، إضافةً إلى بقية مكونات محطة العمل أو الخادم المحيط بوحدة GPU.
- الطاقة والتبريد عن كل ساعة تدريب.
- الوقت الهندسي لمعالجة مشكلات برامج التشغيل وإصدارات CUDA وتعارض الحزم والبيئات المعطلة.
- وقت الخمول. إذا تدربت وحدة GPU ساعتين يوميًا، فستظل خاملة بقية الوقت، وترتفع تكلفتها لكل ساعة تدريب تبعًا لذلك.
- حدود السعة. عندما يحتاج النموذج إلى ذاكرة VRAM أكبر مما تملكه، أو تحتاج عدة تجارب إلى العمل في الوقت نفسه، فعليك الانتظار أو شراء مزيد من الأجهزة.
فيما يلي مقارنة مبسطة بين تكلفة الأجهزة والطاقة، بافتراض أن وحدة GPU المملوكة تتدرب بسرعة وحدة GPU السحابية نفسها:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)على سبيل المثال، لنفترض أن محطة عمل مزودة بـRTX 4090 تكلفك $3,000، وأن تكلفة الطاقة تبلغ نحو $0.10 لكل ساعة تدريب. وبمقارنتها بوحدة RTX 4090 بسعر $0.89 للساعة، تصل إلى نقطة التعادل بعد نحو 3,800 ساعة تدريب: أي نحو 5.3 أشهر من الاستخدام المتواصل على مدار الساعة، أو 15.8 شهرًا بمعدل ثماني ساعات يوميًا. لا يشمل ذلك التبريد أو طاقة الخمول أو الإصلاحات أو التمويل أو قيمة إعادة البيع أو وقتك، ولا يكون التملك مجديًا إلا إذا تحقق هذا القدر من التدريب خلال العمر الافتراضي للأجهزة. استخدم عرض السعر الفعلي للأجهزة وسعر الكهرباء وساعات التدريب المتوقعة؛ فالنتيجة تتغير كثيرًا بحسب معدل الاستخدام.
متى يكون استخدام وحدات GPU المستضافة ذاتيًا مناسبًا#
يكون امتلاك الأجهزة خيارًا أفضل عندما:
- تظل وحدات GPU لديك مشغولة. يؤدي تكرار التدريب باستمرار، أو إجراء عمليات بحث واسعة للمعلمات الفائقة، أو مشاركة الفريق جهازًا واحدًا طوال اليوم، إلى رفع معدل الاستخدام نحو نقطة التعادل.
- لا يمكن إخراج البيانات من مقرك. تمنع بعض البيئات الخاضعة للتنظيم أو المعزولة عن الشبكات إجراء التدريب السحابي بالكامل.
- تملك الأجهزة بالفعل. إذا كانت لديك وحدة GPU مؤهلة خاملة، فقارن تكلفة تشغيلها ومدة التدريب بخيارات السحابة قبل الدفع مقابل أجهزة إضافية.
- تحتاج إلى تحكم كامل في برامج التشغيل أو النوى أو رمز تدريب مخصص لا تدعمه منصة مُدارة.
متى يكون التدريب المُدار مناسبًا#
تكون المنصة المُدارة خيارًا أفضل عندما:
- يكون التدريب متقطعًا. تدرب النماذج عند تغير البيانات، ثم لا تجري أي تدريب لأيام.
- تريد البدء اليوم. لن تحتاج إلى تثبيت برامج التشغيل أو معالجة عدم توافق CUDA أو تصحيح أخطاء البيئة قبل التشغيل الأول.
- تتفاوت أحجام النماذج. يمكنك تدريب نموذج nano على GPU صغير، ونموذج كبير على GPU بسعة 80 GB أو أكثر، من دون شراء أيٍّ منهما.
- يتولى عدة أشخاص التدريب. تبقى عمليات التدريب والمقاييس ونقاط التحقق في مكان واحد بدلًا من توزيعها على الأجهزة الفردية.
الخيار الهجين: امتلاك وحدات GPU واستخدام لوحة تحكم مُدارة#
لست مضطرًا إلى اختيار أحد الخيارين. تدعم Ultralytics Platform التدريب عن بُعد: تدرب على وحدة GPU الخاصة بك باستخدام حزمة ultralytics، وتبث المقاييس المباشرة إلى لوحة تحكم Platform نفسها المستخدمة للتدريب السحابي، ثم ترفع الأوزان النهائية عند انتهاء التدريب. تستخدم عمليات التدريب عن بُعد وحدة GPU الخاصة بك، لا وحدات GPU السحابية من Ultralytics؛ لذلك لا تستهلك وقت GPU سحابيًا.
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
model.train(
data="coco8.yaml",
epochs=100,
project="username/my-project", # مشروعك على Platform
name="local-gpu-run",
)أعد مفتاح API أولًا باستخدام export ULTRALYTICS_API_KEY="YOUR_API_KEY". يتطلب التكامل مع Platform استخدام Python 3.11 أو إصدار أحدث وultralytics 8.4.120 أو إصدار أحدث. من الأنماط الشائعة إجراء التجارب السريعة على GPU محلي، ثم إرسال عمليات التدريب الأكبر أو الحساسة للوقت إلى GPU سحابي عندما يكون الجهاز المحلي مشغولًا.
كيفية تدريب YOLO26 على GPU مُدار باستخدام Ultralytics Platform#
- أنشئ حسابًا على platform.ultralytics.com. تحصل الحسابات الجديدة على رصيد تسجيل بقيمة $5، أو $25 بعد التحقق من بريد إلكتروني للعمل.
- أضف مجموعة بيانات بتحميل الصور والتسميات، أو اربط حاوية Amazon S3 ضمن خطة Pro أو Enterprise.
- افتح نافذة التدريب، واختر نموذج YOLO26 وحدد عدد الحقب وحجم الصورة.
- اختر GPU. يُعد RTX PRO 6000 الخيار الافتراضي الموصى به؛ راجع كيفية اختيار GPU سحابي لفهم المفاضلات.
- تحقق من تقدير التكلفة، وابدأ التدريب، وتابع المقاييس المباشرة حتى انتهاء العملية.
تتيح الخطة المجانية تشغيل ما يصل إلى 3 مهام تدريب سحابية في الوقت نفسه. ترفع خطة Pro، بسعر $29 لكل مقعد شهريًا، هذا الحد إلى 10، وتشمل رصيدًا قدره $30 لكل مقعد شهريًا.
بعد انتهاء التدريب، يمكنك تصدير النموذج أو نشره كواجهة API. وإذا كنت تقرر أيضًا مكان تشغيل الاستدلال، فقارن في دليلنا عن الذكاء الاصطناعي للرؤية الحاسوبية السحابي مقابل المستضاف ذاتيًا بين التكلفة وزمن الاستجابة والتحكم في البيانات لأغراض النشر.
الأسئلة الشائعة
قد يكون كذلك، ولا سيما عندما يكون التدريب متقطعًا، لأنك لا تدفع إلا مقابل ساعات استخدام GPU. قارن التكلفة الإجمالية ومدة الإنجاز لعبء العمل نفسه؛ فحساب نقطة التعادل أعلاه (تكلفة الأجهزة مقسومة على سعر الساعة السحابي مطروحًا منه تكلفة الطاقة لكل ساعة) يمثل نقطة بداية لا ضمانًا.
يوفر لك GPU السحابي المستأجر جهازًا، ويضبط فريقك عبء عمل التدريب ويتحقق من البيئة أو يهيئها. أما منصة التدريب المُدارة فتتولى جزءًا أكبر من سير العمل: على Ultralytics Platform، تختار مجموعة بيانات ونموذجًا وGPU، وتتولى المنصة توفير GPU وتشغيل التدريب وبث المقاييس وحفظ نقاط التحقق.
على Ultralytics Platform، تُحتسب تكلفة عملية التدريب التي تفشل بعد بدء GPU السحابي وفق مدة استخدام GPU المنقضية، بينما يكون الإخفاق قبل بدء GPU مجانيًا. وتُحتسب تكلفة عمليات التدريب الملغاة عن مدة استخدام GPU حتى الإلغاء.
نعم. يعمل التدريب عن بُعد على أجهزتك، ويبث المقاييس المباشرة إلى Platform ويرفع الأوزان النهائية؛ لذا لا يستخدم وقت GPU سحابيًا.
يُعد RTX PRO 6000 (96 GB) الخيار الافتراضي الموصى به لمعظم المهام. توصي Ultralytics بـRTX 4090 للتدريب العام، وA100 SXM لأحجام الدفعات الكبيرة أو النماذج الأكبر، ووحدات GPU من طراز H100 وH200 وB200 وB300 للمهام الحساسة للوقت وعالية الذاكرة وأكبر أعباء العمل.
تحصل الحسابات الجديدة على منصة Ultralytics على رصيد تسجيل بقيمة 5 دولارات، يرتفع إلى 25 دولارًا بعد التحقق من بريد إلكتروني خاص بالعمل. وتتضمن الخطط Pro رصيدًا بقيمة 30 دولارًا لكل مقعد شهريًا.
لا. يمكن لـ Kubernetes جدولة أعباء عمل GPU، لكن وثائق جدولة GPU تتطلب تثبيت برامج تشغيل GPU ومكوّن إضافي لأجهزة المورّد على العُقد. ولا تزال مجموعة التدريب التي تديرها بنفسك بحاجة إلى شخص مسؤول عن البيئات والأذونات ومراقبة المهام ونقاط التحقق، لذا خصص ميزانية لهذا العمل إلى جانب تكلفة الحوسبة.
بقلم
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









