ONNX مقابل TensorRT لاستدلال الرؤية الحاسوبية: المعايير وكيفية الاختيار
ONNX Runtime مقابل TensorRT لاستدلال الرؤية الحاسوبية: قياسات سرعة ودقة Ultralytics YOLO26 على 19 وحدة GPU من NVIDIA، وكيفية الاختيار.
 Miles Deans11 دقيقة قراءة
ليس ONNX وTensorRT متنافسين حقًا. ONNX هو تنسيق للطرازات، وTensorRT هو محرك الاستدلال من NVIDIA، الذي يستخدم عادةً ملف ONNX مدخلًا له. والاختيار الحقيقي هو كيفية تشغيل ذلك الملف: باستخدام ONNX Runtime، الذي يعمل عبر أنواع مختلفة من الأجهزة ويمكنه حتى تمرير العمل إلى TensorRT، أو تحويله إلى محرك TensorRT مستقل، لا يعمل إلا على وحدات GPU من NVIDIA. في المعايير على Ultralytics Platform لطراز Ultralytics YOLO26 على 19 وحدة GPU من NVIDIA، كان TensorRT FP16 أسرع من نتائج ONNX FP16 المنشورة على كل وحدة GPU ولكل حجم طراز، مع دقة لا يتجاوز الفرق فيها 0.001 mAP50-95. وتراوحت الزيادات الوسيطة في السرعة بين 1.85x و2.55x باختلاف أحجام الطرازات. لا توضح صفحة المعايير موفّر التنفيذ في ONNX Runtime الذي أنتج نتائج ONNX، لذا لا تحسم المقارنة العامة بين ONNX Runtime وTensorRT، ولا المقارنة عند استخدام موفّر تنفيذ TensorRT فيه. بالنسبة إلى Ultralytics YOLO26 على وحدات GPU من NVIDIA، ابدأ بـTensorRT FP16 عندما يكون زمن الاستجابة مهمًا، واستخدم ONNX Runtime عندما يلزم تشغيل ملف طراز واحد على أكثر من نوع من الأجهزة. ويمكن تصدير Ultralytics YOLO إلى كليهما باستخدام وسيطة واحدة.
من أين تبدأ مع Ultralytics YOLO:
| النشر | ابدأ بـ | تصدير Ultralytics YOLO |
|---|---|---|
| وحدة GPU من NVIDIA، وزمن الاستجابة مهم | TensorRT FP16 | format="engine", quantize=16 |
| CPU، أو أجهزة غير تابعة لـNVIDIA، أو أسطول مختلط | ONNX Runtime | format="onnx" |
| واجهة API الخاصة بـONNX Runtime على وحدة GPU من NVIDIA | ONNX Runtime مع موفّر تنفيذ TensorRT | format="onnx" |
ONNX مقابل TensorRT: التنسيق وبيئة التشغيل والمحرك#
تختبئ وراء هذه المقارنة ثلاثة أشياء مختلفة:
- ONNX (تبادل الشبكات العصبية المفتوحة) هو تنسيق ملف يخزّن مخطط الطراز المدرّب وأوزانه بطريقة مستقلة عن إطار العمل. يمكنك التصدير من PyTorch إلى ONNX كي تتمكن الأدوات الأخرى من قراءة الطراز.
- يشغّل ONNX Runtime طرازات ONNX. ويفوّض العمل إلى واجهات خلفية للأجهزة تُسمى موفّري التنفيذ، مثل CPU وCUDA وTensorRT، بحيث يمكن تشغيل الملف نفسه على CPU حاسوب محمول أو GPU سحابية.
- يقرأ TensorRT الطراز، وغالبًا ما يكون ملف ONNX، عبر محلّل ONNX الخاص به. ويدمج الطبقات، ويختار أسرع نواة لكل عملية على وحدة GPU المستهدفة، ثم يكتب محركًا محسّنًا.
لذا فالسؤال الحقيقي هو: ONNX Runtime أم TensorRT؟ يستطيع ONNX Runtime أيضًا استدعاء TensorRT عبر موفّر تنفيذ TensorRT، ما يتيح لك الإبقاء على واجهة API الخاصة بـONNX Runtime فيما يشغّل TensorRT المخططات الفرعية التي يدعمها. ويوصي ONNX Runtime بتسجيل موفّر تنفيذ CUDA بعده، لكي تعمل العقد التي لا يدعمها TensorRT على CUDA بدلًا من ذلك.
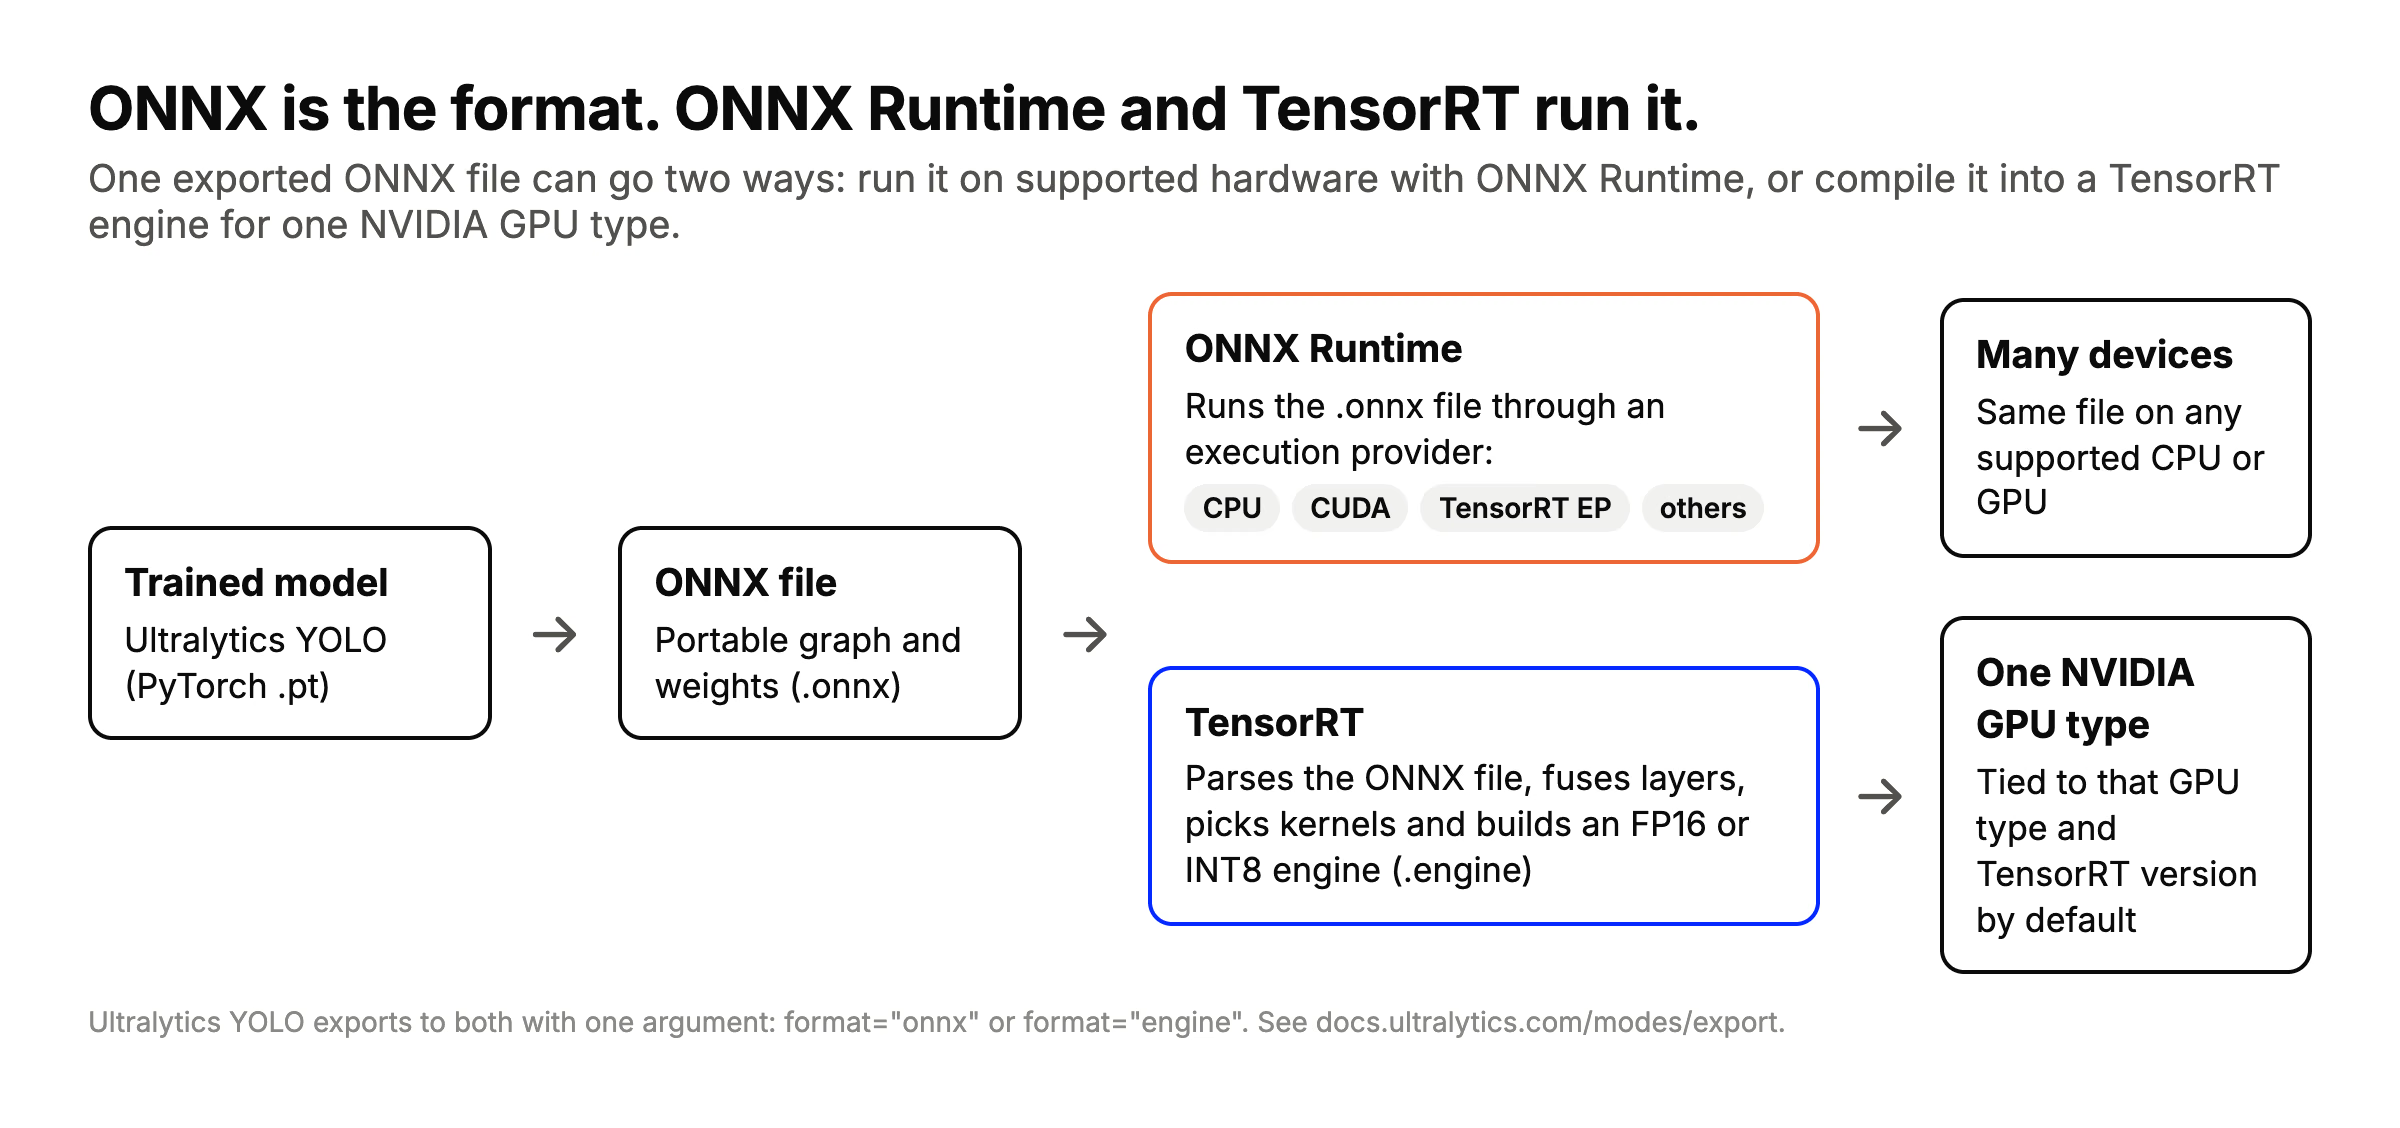
ملف ONNX واحد ومساران: يشغّله ONNX Runtime على الأجهزة المدعومة، بينما يجمّعه TensorRT في محرك لنوع واحد من وحدات GPU من NVIDIA. يتيح Ultralytics YOLO التصدير إلى كليهما.
المعايير: YOLO26 على ONNX Runtime مقابل TensorRT#
تأتي الأرقام أدناه من معايير الاستدلال على Ultralytics Platform. صُدّر كل طراز كشف من Ultralytics YOLO26 بالتنسيق الموضح، ثم قيس زمن استدلاله على وحدات GPU في Ultralytics Platform بحجم دفعة 1 ودقة 640 بكسل على COCO val2017، مع استبعاد الإحماء وقصّ القيم الشاذة لأزمنة التشغيل باستخدام سيغما. الدقة هي mAP50-95 على COCO val2017، وقِيست مرة واحدة لكل تنسيق ودقة عددية. تستخدم المقارنة وحدات GPU الـ19 من NVIDIA (Ampere وAda وHopper) التي تتوفر لها نتائج بالتنسيقات الأربعة جميعها.
لا تحدد صفحة المعايير موفّر التنفيذ في ONNX Runtime الذي أنتج نتائج ONNX، كما لا تصنّف أيًا من النتائج على أنها ناتجة عن استخدام موفّر تنفيذ TensorRT في ONNX Runtime، الذي يمرر الأجزاء المدعومة من الطراز إلى TensorRT. تصف نتائج ONNX هذه التهيئة التي خضعت للقياس؛ وقد يختلف الأداء باختلاف موفّر التنفيذ في ONNX Runtime. إذا أردت استخدام واجهة API الخاصة بـONNX Runtime مع TensorRT في الخلفية، فقِس أداء هذا المزيج على أجهزتك.
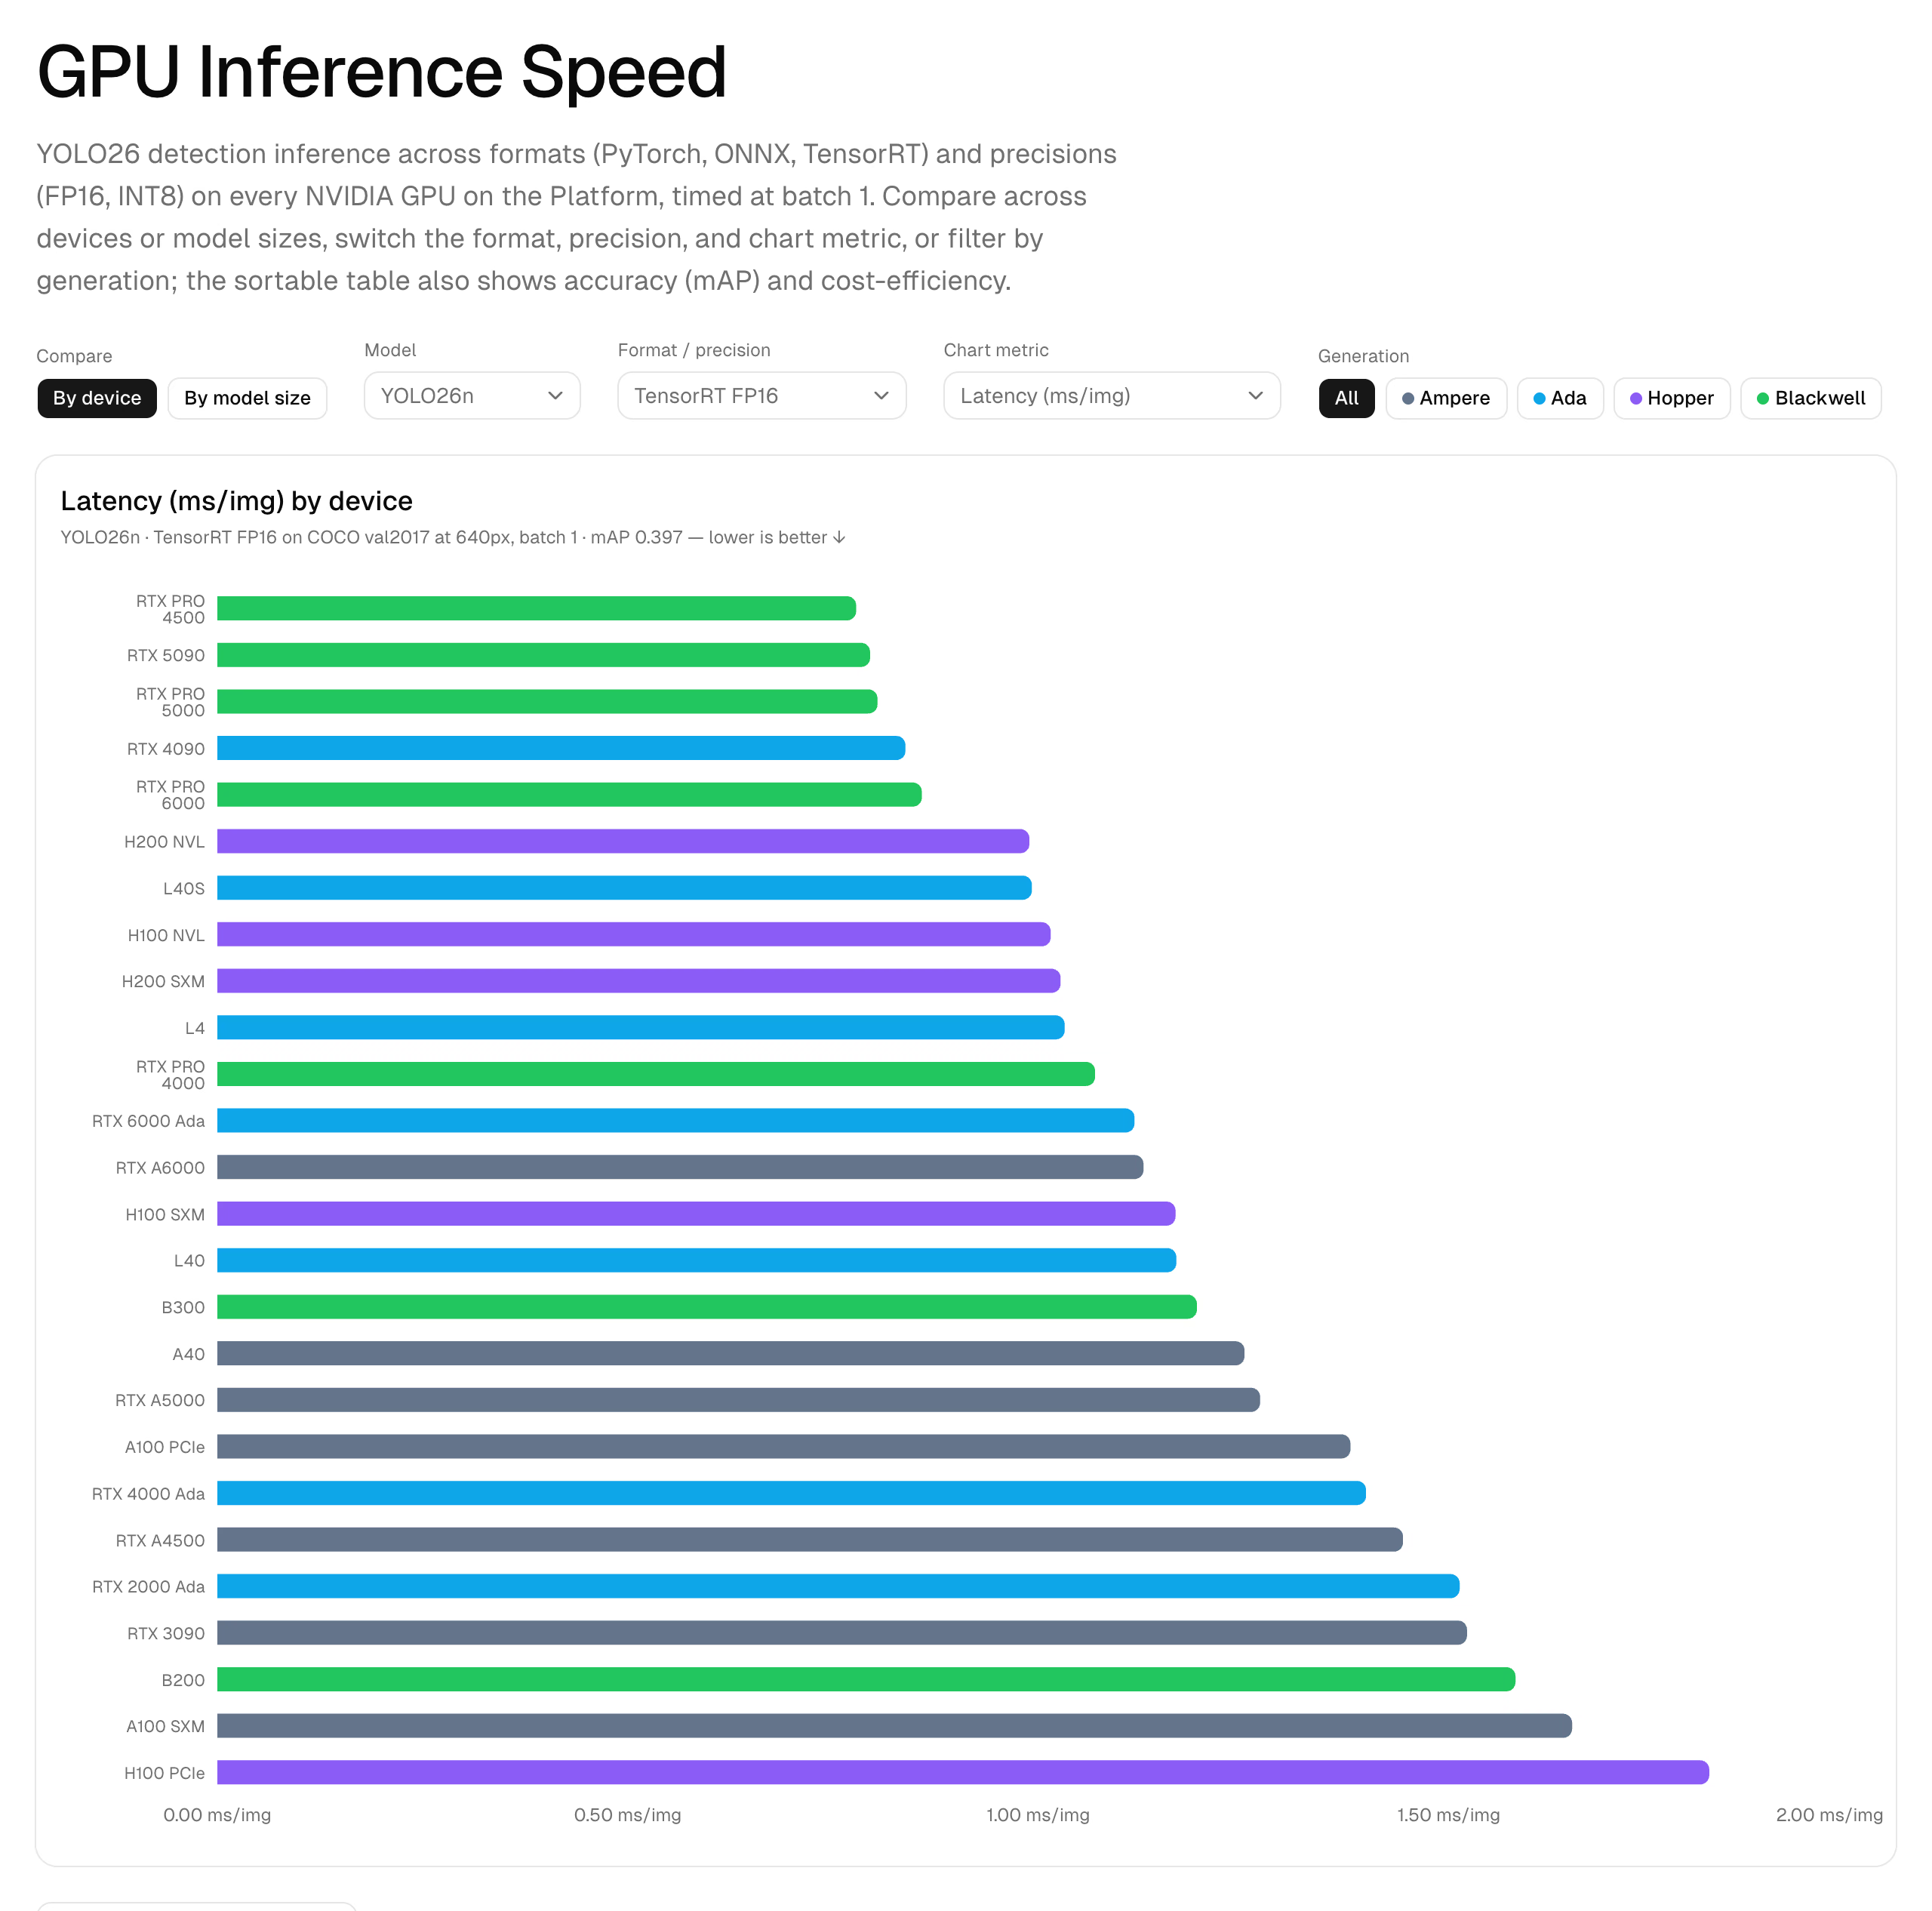
تتيح لك علامة التبويب Inference التبديل بين حجم الطراز والتنسيق والدقة العددية، ثم فرز كل وحدة GPU بحسب زمن الاستجابة أو الدقة أو التكلفة.
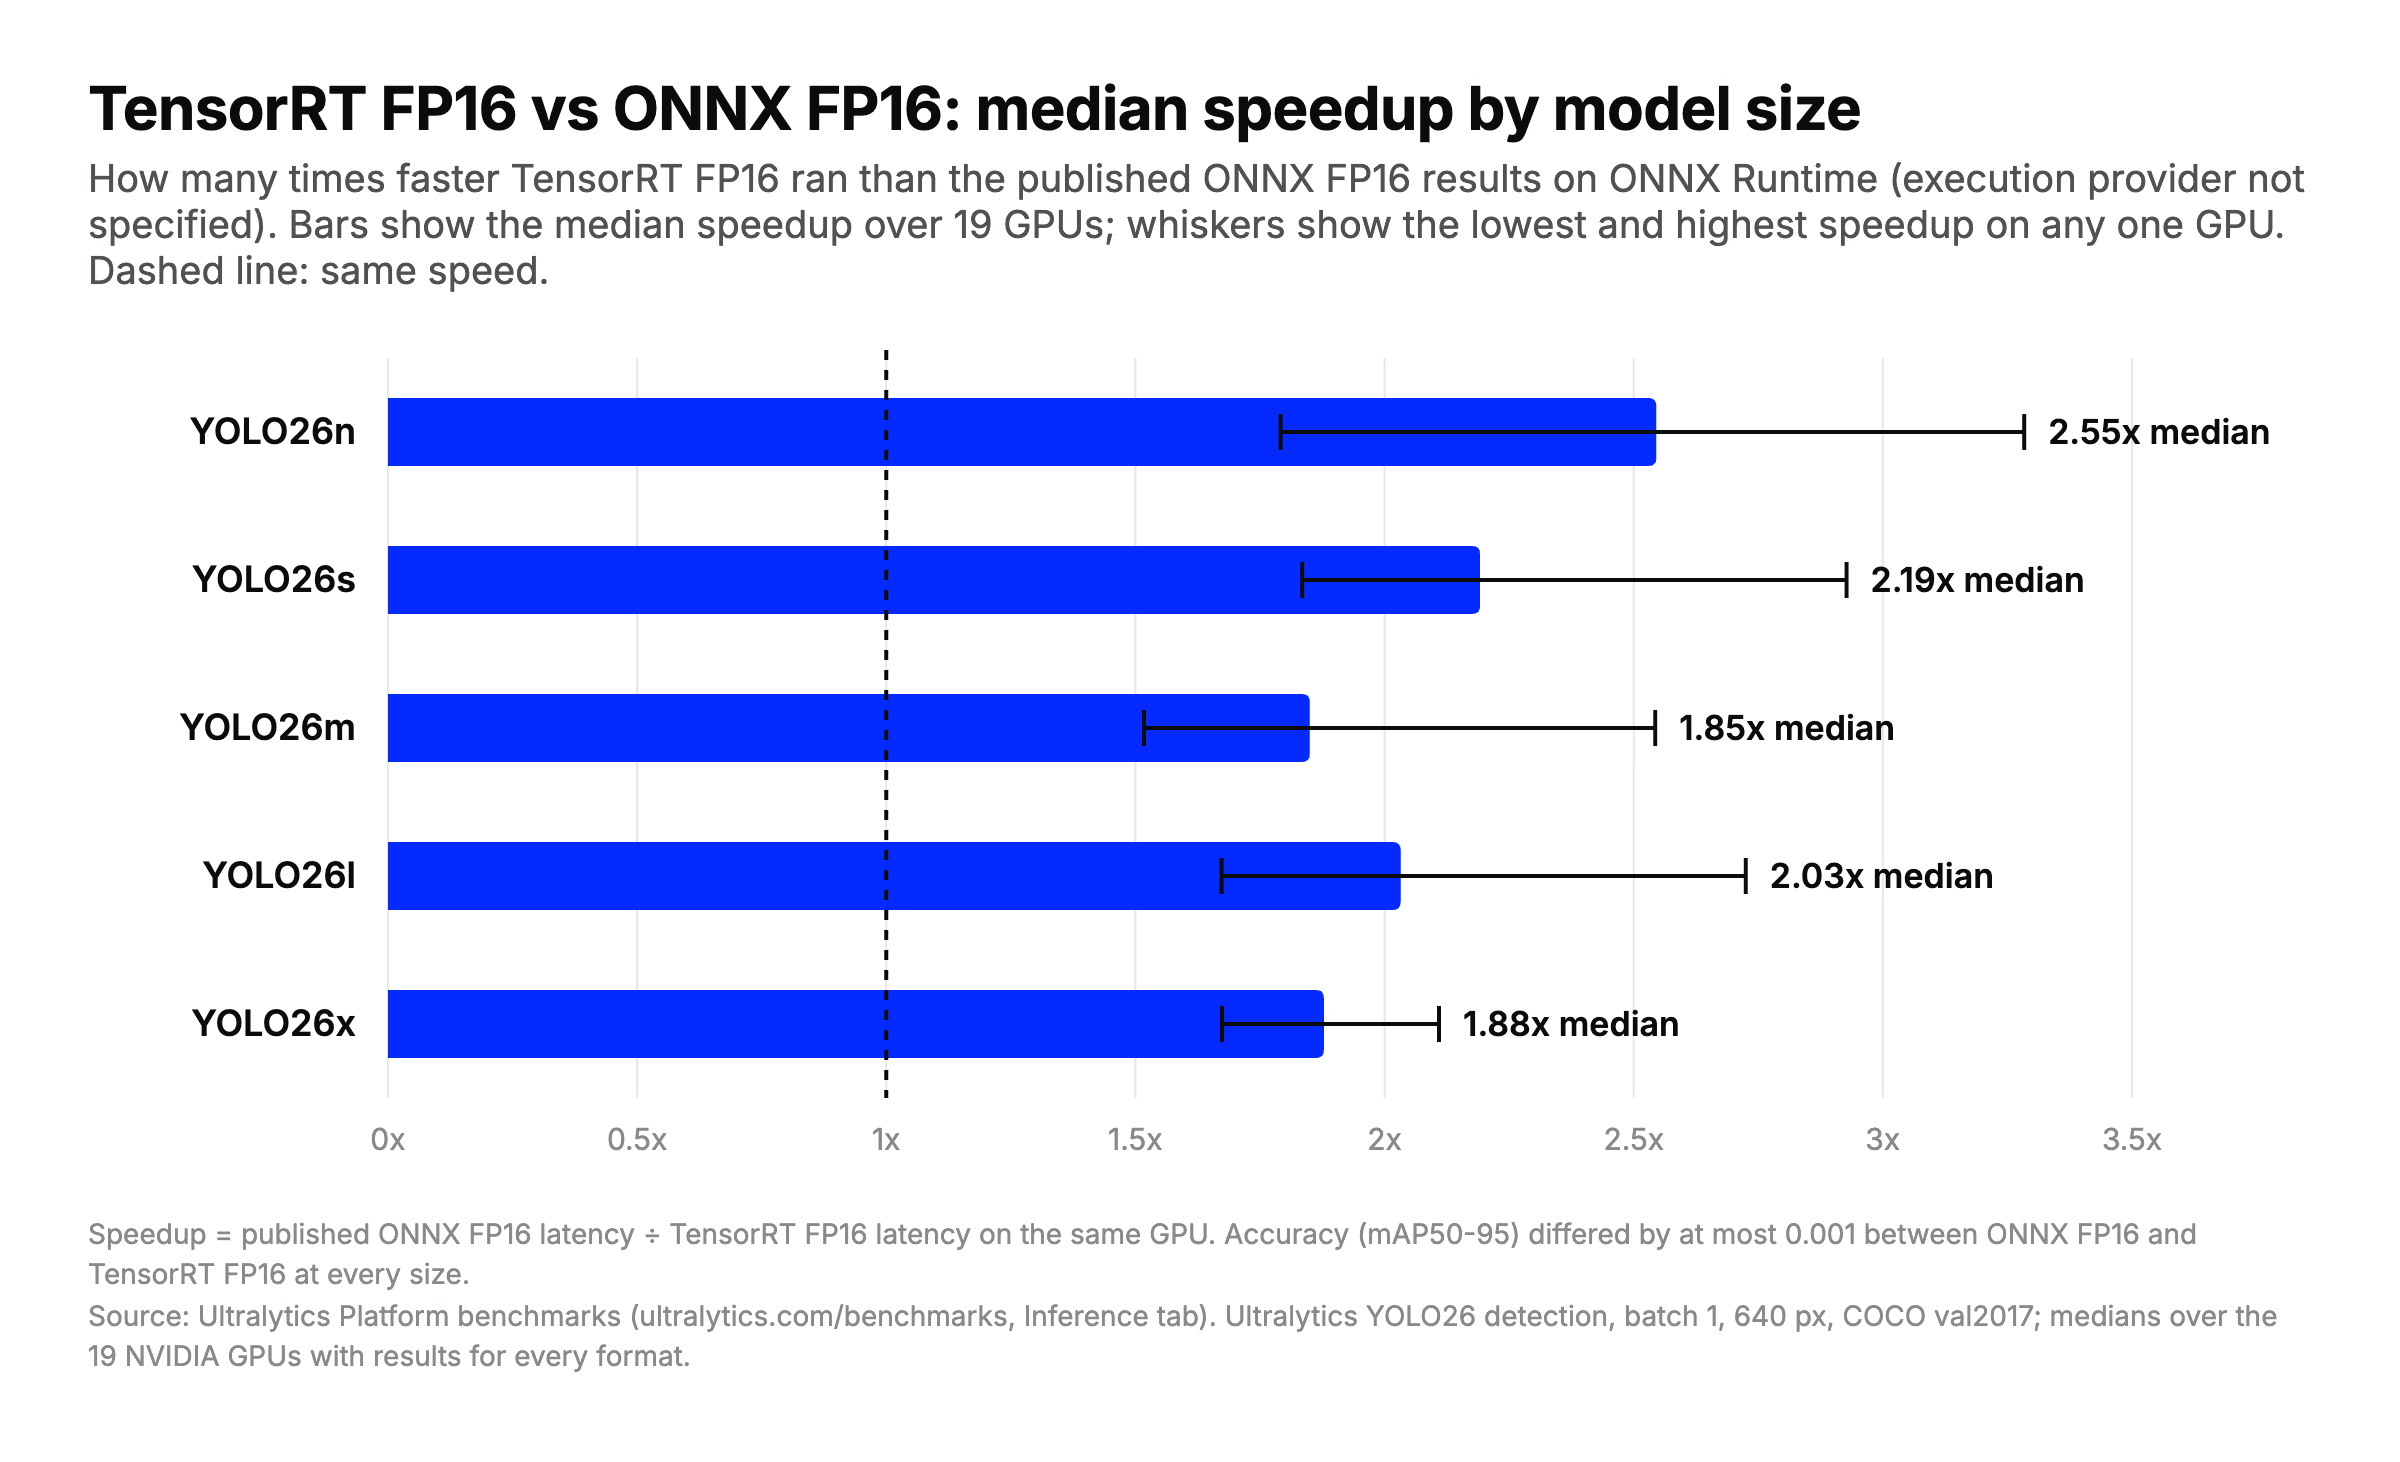
كان TensorRT FP16 أسرع من نتائج ONNX FP16 المنشورة على كل وحدة GPU ولكل حجم طراز؛ ولا تحدد الصفحة موفّر التنفيذ في ONNX Runtime الذي أنتجها. تعرض الأعمدة وسيط زيادة السرعة عبر 19 وحدة GPU، ويعرض نطاق كل عمود أدنى وأعلى زيادة سرعة على أي وحدة GPU. حُسب ذلك من معايير الاستدلال على Ultralytics Platform.
| النموذج | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | زيادة سرعة TensorRT FP16 مقارنةً بـONNX FP16 (الوسيط، النطاق) | زيادة سرعة TensorRT INT8 مقارنةً بـTensorRT FP16 (الوسيط، النطاق) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
حُسب ذلك من معايير الاستدلال على Ultralytics Platform. زيادة السرعة هي زمن استدلال ONNX FP16 ÷ زمن استدلال TensorRT FP16، أو زمن استدلال TensorRT FP16 ÷ زمن استدلال TensorRT INT8، على وحدة GPU نفسها؛ لذا تعني القيم الأكبر من 1x أن TensorRT FP16 (أو INT8) كان أسرع. حُسبت الوسيطات باستخدام وحدات GPU الـ19 من NVIDIA التي تتوفر لها التنسيقات الأربعة، وتمثل النطاقات أدنى وأعلى النسب عبر هذه الوحدات. الدقة هي قيمة mAP50-95 المسجلة لكل تنسيق ودقة عددية. تشير ONNX FP16 إلى نتائج ONNX Runtime المنشورة، التي لم يُحدد موفّر التنفيذ المستخدم فيها.
زمن الاستجابة على أربع وحدات GPU شائعة، بالمللي ثانية لكل صورة، كما نُشر في صفحة المعايير:
| وحدة GPU | النموذج | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
تبرز ثلاثة أمور:
- تفوق TensorRT FP16 على نتائج ONNX FP16 المنشورة على كل وحدة GPU ولكل حجم طراز، مع دقة لا يتجاوز الفرق فيها 0.001 mAP50-95. إذا كنت تنشر على وحدات GPU من NVIDIA هذه وتحتاج إلى زمن استجابة منخفض، فابدأ بـTensorRT FP16.
- ليس INT8 خيارًا رابحًا تلقائيًا. كان أبطأ من TensorRT FP16 على 17 من أصل 19 وحدة GPU مع YOLO26n، وخفّض mAP50-95 بمقدار 0.04. وقدّم فائدة أكثر على الطرازات الأكبر، وصلت إلى 1.67x مع YOLO26x على L4، لكنه خفّض mAP50-95 بمقدار يتراوح بين 0.034 و0.076.
- لا تتوفر نتائج ONNX لوحدات GPU السبع من Blackwell. وتعزو صفحة المعايير ذلك إلى عدم توفر نوى Blackwell في بيئة اختبار ONNX Runtime. أما TensorRT فعمل على الوحدات السبع كلها.
تغطي هذه النتائج الإعداد الموضح في صفحة المعايير، بحجم دفعة 1 ودقة 640 بكسل؛ لذا قِس أداء طرازك على جهاز النشر وباستخدام بياناتك قبل الاختيار.
FP16 مقابل INT8 مع TensorRT#
الدقة العددية الأقل عامل رئيسي آخر، وتوضح المعايير سبب حاجتها إلى الاختبار:
- FP16 (دقة نصفية) يخفض حجم الأوزان والتنشيطات إلى النصف مقارنةً بـFP32. في معايير Ultralytics Platform، حقق TensorRT FP16 دقة مماثلة لـONNX FP16 وPyTorch FP16 بفارق لا يتجاوز 0.003 mAP50-95.
- يمثّل INT8 الأوزان والتنشيطات كأعداد صحيحة من 8 بت، وهو شكل من تكميم الطراز. ويتطلب المعايرة: إذ تُمرر مجموعة تمثيلية من الصور عبر الطراز لقياس نطاقات التنشيط. استخدم معيار Ultralytics Platform أداة NVIDIA ModelOpt مع COCO128 بوصفها بيانات المعايرة.
كما توضح منهجية المعايير، يحقق INT8 أكبر فائدة مع الطرازات الأكبر والمحدودة بالحوسبة. أما في الطرازات الأصغر، فقد تعادل كلفة التكميم الإضافية أداء FP16 أو حتى تبطئه. عاير باستخدام صور من نطاقك، ثم تحقّق من الدقة على بياناتك قبل نشر محرك INT8.
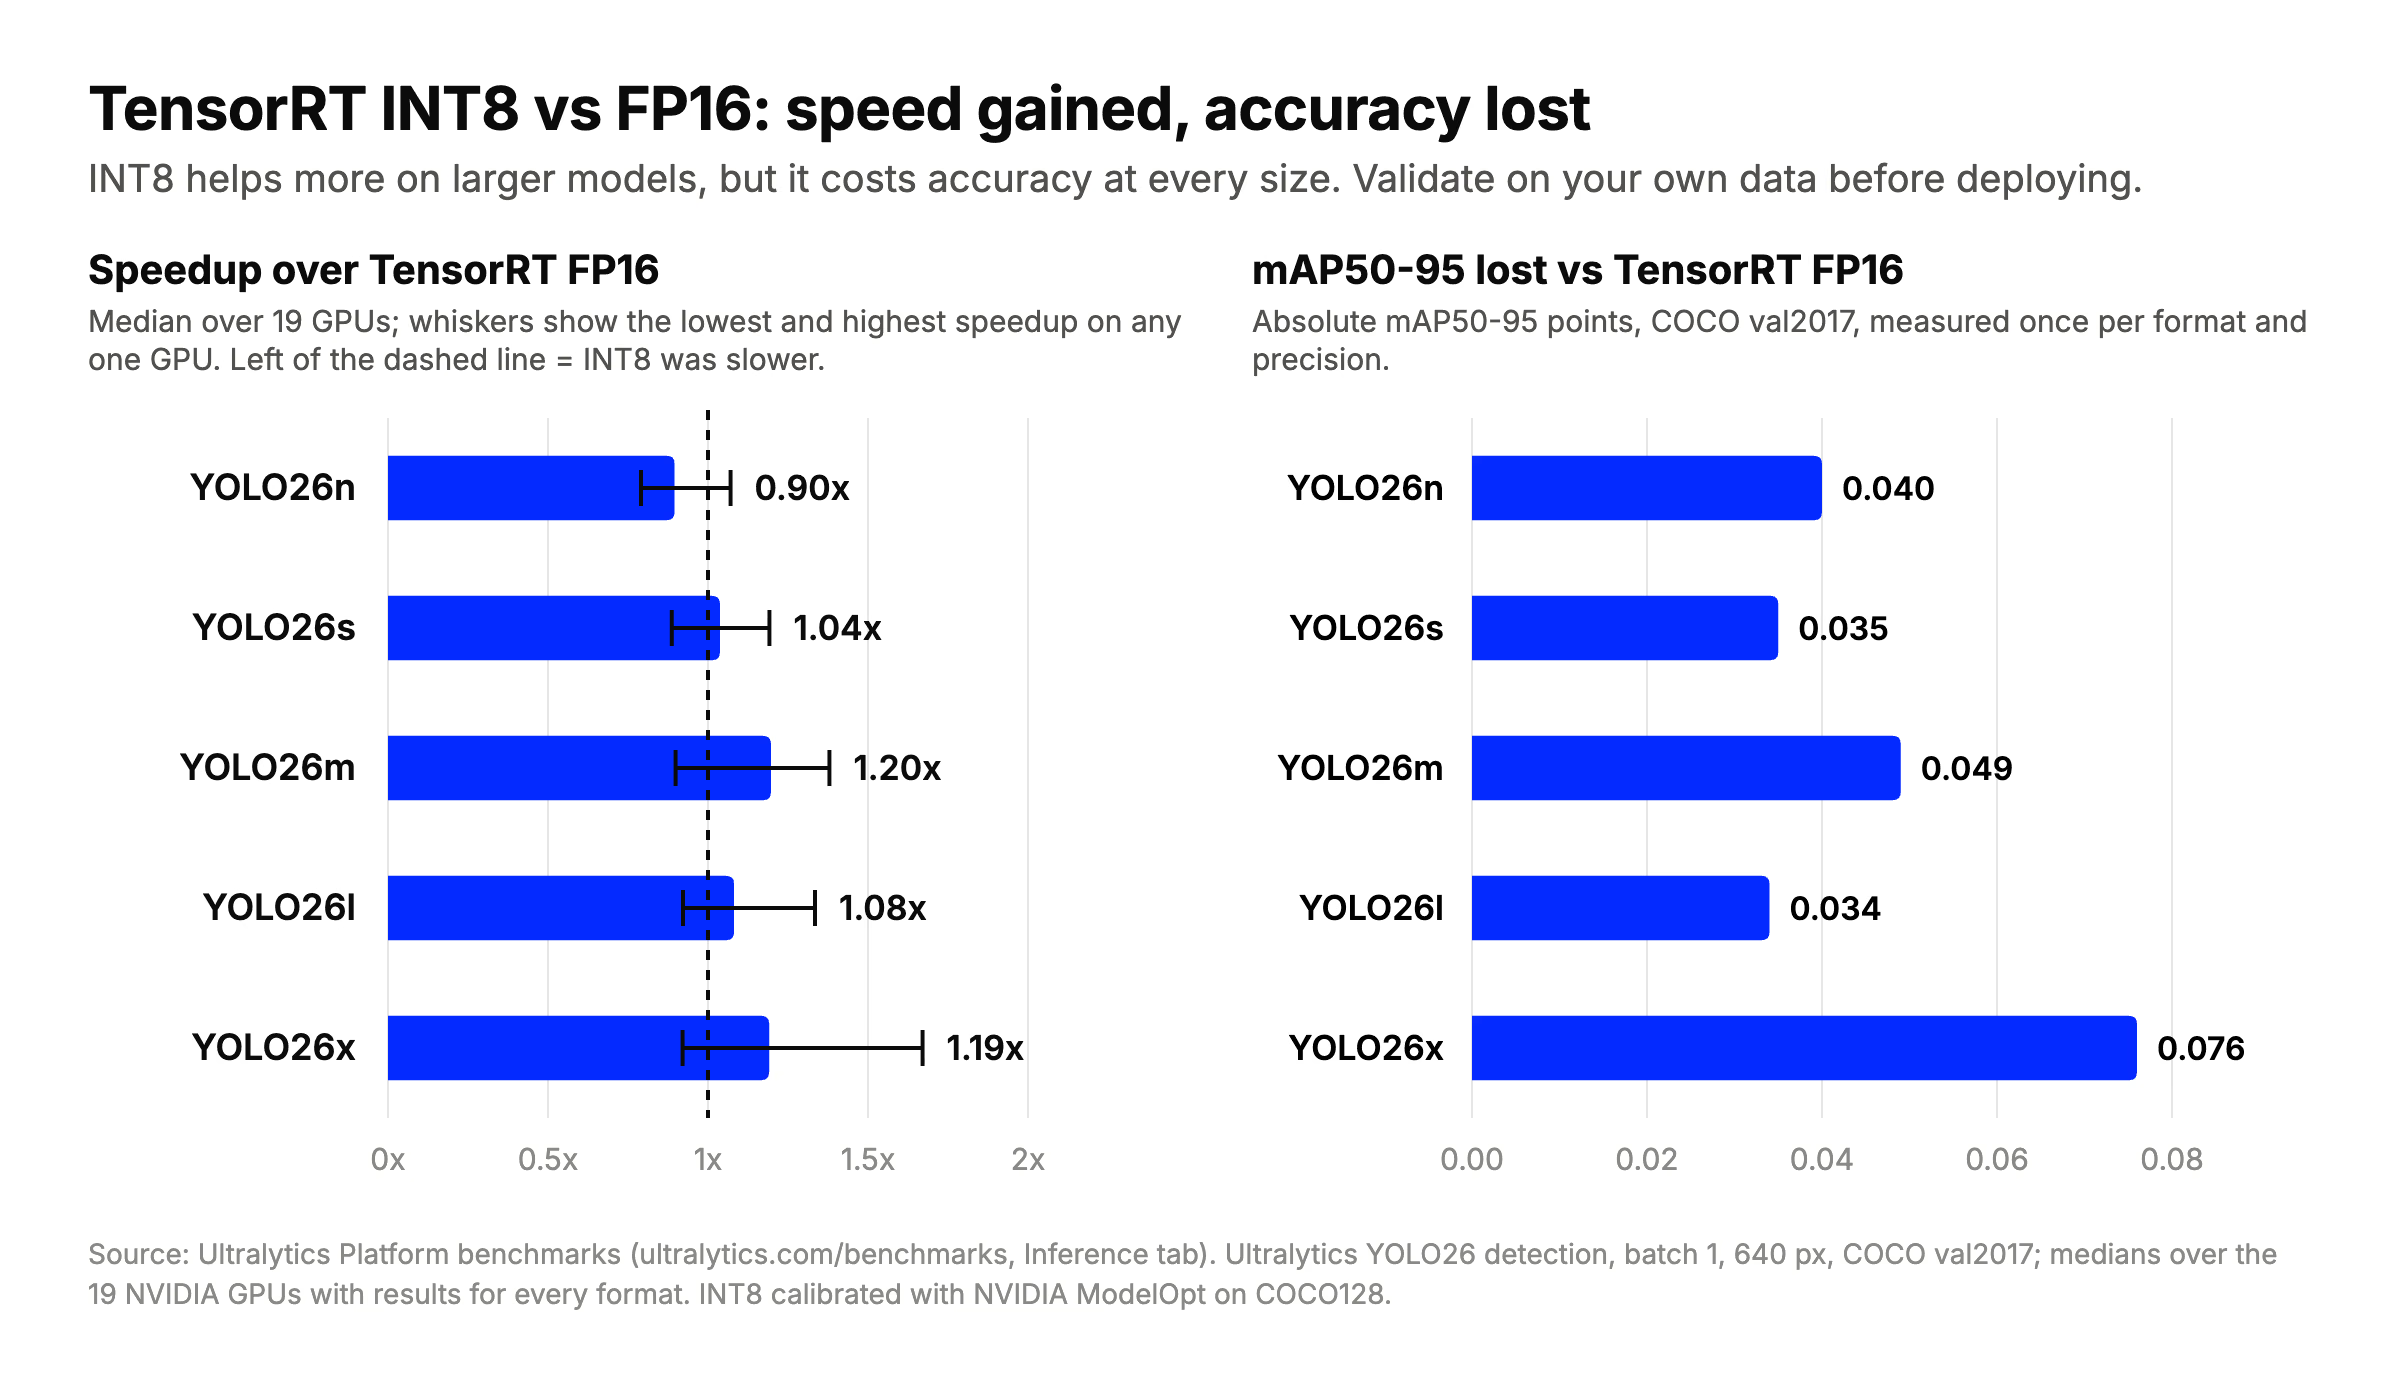
كان INT8 أبطأ من FP16 عند أخذ الوسيط في YOLO26n، ووصل إلى سرعة أعلى بنحو 1.2x في الطرازات الأكبر عبر وحدات GPU الـ19، مع خفض mAP50-95 بمقدار يتراوح بين 0.034 و0.076 في كل الأحجام. حُسب ذلك من معايير الاستدلال على Ultralytics Platform.
قابلية نقل المحرك وأحجام الإدخال الديناميكية#
افتراضيًا، يرتبط محرك TensorRT بوحدة GPU التي بُني عليها وبإصدار TensorRT الذي أنشأه؛ لذا ليس المقصود نقل محرك بُني على RTX 4090 إلى H100 أو Jetson. يوفر TensorRT خيارات للتوافق مع الأجهزة والإصدارات تخفف هذه القيود، لكن الخيار الآمن افتراضيًا هو البناء على الجهاز الذي ستنشر عليه، أو لأجله، وإعادة البناء بعد ترقية TensorRT. ولهذا السبب، تطلب منك علامة التبويب Export على Ultralytics Platform اختيار نوع وحدة GPU عند التصدير إلى TensorRT. ولا يرتبط ملف ONNX بمثل هذا القيد: إذ يعمل الملف نفسه أينما توفر ONNX Runtime وموفّر تنفيذ مناسب.
يدعم التنسيقان أحجام إدخال متغيرة. وفي TensorRT، تتطلب الأشكال الديناميكية ملف تعريف تحسين يحدد أبعاد الإدخال الدنيا والمثلى والقصوى، ويجب أن تقع المدخلات وقت التشغيل ضمن حدوده. عند تصدير طرازات Ultralytics YOLO، يفعّل dynamic=True أشكال الإدخال الديناميكية لكل من ONNX وTensorRT. تمنح الأشكال الثابتة TensorRT مجالًا أكبر للتحسين، كما يوضح دليل الأشكال الديناميكية من NVIDIA؛ لذا استخدم الأشكال الديناميكية عندما تتغير مدخلاتك فعلًا، وقارن أداء الخيارين.
متى تختار ONNX Runtime ومتى تختار TensorRT#
- وحدة GPU من NVIDIA في السحابة أو في مقر العمل، وزمن الاستجابة مهم: TensorRT، بدءًا من FP16. جرّب INT8 مع الطرازات الأكبر بعد معايرته والتحقق من دقته.
- NVIDIA Jetson على الطرف: TensorRT. راجع دليل NVIDIA Jetson.
- CPU، أو أجهزة غير تابعة لـNVIDIA، أو أسطول مختلط: استخدم ONNX مع ONNX Runtime، واختَر موفّر التنفيذ الذي يدعمه كل جهاز.
- لم تحدد أجهزة النشر بعد: صدّر إلى ONNX أولًا. ويمكنك لاحقًا إنشاء محرك TensorRT من الطراز نفسه.
- وحدات CPU أو GPU أو NPU من Intel: فكّر في OpenVINO، مجموعة أدوات الاستدلال من Intel.
للاطلاع على القائمة الكاملة للتنسيقات ومقارنتها، راجع دليل خيارات نشر الطرازات. كما أن الدقة العددية ليست العامل الوحيد: فحجم الطراز ودقة الإدخال مهمان أيضًا، ويتناول دليلنا حول التقليم والتكميم طريقتين إضافيتين لتقليل حجم الطراز.
تصدير Ultralytics YOLO إلى ONNX وTensorRT#
يمكن تصدير Ultralytics YOLO إلى كلا التنسيقين باستخدام وسيطة format واحدة، ويمكنك تشغيل التنبؤ أو التحقق مباشرةً على الطراز المُصدّر:
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
model.export(format="onnx", quantize=16) # ONNX FP16، لاستخدام ONNX Runtime
model.export(format="engine", quantize=16) # محرك TensorRT FP16، بُني على وحدة GPU هذه
# لاستخدام INT8 بدلًا من ذلك، عاير باستخدام ملف YAML لمجموعة بيانات (coco8.yaml مجموعة تجريبية صغيرة؛ استخدم مجموعتك الخاصة):
# model.export(format="engine", quantize=8, data="coco8.yaml")
trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")يحدد quantize=16 دقة FP16، ويحدد quantize=8 دقة INT8. ينتج كلا تصديري المحرك yolo26n.engine، لذا شغّل أحدهما فقط. عند استخدام INT8، وجّه data إلى ملف YAML لمجموعة بياناتك كي تستخدم المعايرة صورًا مماثلة للصور التي ستنشر عليها. راجع وسائط التصدير ودليلي التكامل ONNX وTensorRT للاطلاع على جميع الخيارات، أو اتبع منشوراتنا الإرشادية خطوة بخطوة حول التصدير إلى ONNX والتحسين باستخدام TensorRT. يمكنك أيضًا تصدير الطرازات المدرّبة في متصفحك على Ultralytics Platform.
الأسئلة الشائعة
ONNX تنسيق للطرازات، وليس محركًا؛ لذا فالمقارنة العادلة هي بين ONNX Runtime وTensorRT. في معايير Ultralytics Platform لطراز Ultralytics YOLO26 على 19 وحدة GPU من NVIDIA، كان TensorRT FP16 أسرع من نتائج ONNX FP16 المنشورة على ONNX Runtime في جميع وحدات GPU، بزيادات سرعة وسيطة محسوبة تراوحت بين 1.85x و2.55x باختلاف أحجام الطرازات، وفروق في mAP50-95 لا تتجاوز 0.001. لا توضح المعايير موفّر التنفيذ في ONNX Runtime الذي أنتج نتائج ONNX، ولا تصنّف أيًا منها على أنها ناتجة عن استخدام موفّر تنفيذ TensorRT فيه؛ لذا اختبر هذا المزيج بنفسك إذا كنت بحاجة إلى واجهة API الخاصة بـONNX Runtime.
نعم. عادةً ما يكون ONNX هو مدخل TensorRT: إذ يقرأ محلّل ONNX الطراز وينشئ منه محركًا. ويمكن لـONNX Runtime أيضًا استدعاء TensorRT عبر موفّر تنفيذ TensorRT.
لا. في معايير Ultralytics Platform، كان TensorRT INT8 أبطأ من TensorRT FP16 مع YOLO26n على 17 من أصل 19 وحدة GPU. وكان أسرع في حالات أكثر مع الطرازات الأكبر، بوسيط بلغ نحو 1.2x في YOLO26m وYOLO26x عبر وحدات GPU الـ19 التي شغّلت التنسيقات كلها. وفي كل مرة، انخفض mAP50-95 بمقدار يتراوح بين 0.034 و0.076؛ لذا تحقّق من أداء طراز INT8 على بياناتك أولًا.
لا تعتمد على ذلك. يرتبط محرك TensorRT افتراضيًا بوحدة GPU وإصدار TensorRT اللذين بُني بهما، لذا أنشئه على جهاز النشر أو لأجله. احتفظ بملف ONNX بوصفه النسخة القابلة للنقل، وأعِد بناء المحرك لكل جهاز مستهدف.
عادةً ما يكون TensorRT هو الخيار المفضل: إذ تتضمن JetPack من NVIDIA TensorRT، كما أن بناء المحرك على جهاز Jetson نفسه يضبطه ليتلاءم مع ذلك الجهاز. لا تشمل المعايير أعلاه Jetson، لذا قِس الأداء على وحدتك قبل اتخاذ القرار. يشرح دليل NVIDIA Jetson إعداد Ultralytics YOLO وتصديره خطوة بخطوة.
بقلم
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









