Florence-2: el último modelo de lenguaje y visión de Microsoft
Descubre Florence-2, el modelo de visión y lenguaje de Microsoft para la detección y segmentación de objetos, la generación de descripciones y la localización, con un sólido rendimiento de cero disparos.
 Abirami Vina9 min de lectura
En junio de 2024, Microsoft presentó Florence-2, un modelo multimodal de visión y lenguaje (VLM) diseñado para realizar una amplia variedad de tareas, como la detección de objetos, la segmentación, la generación de descripciones de imágenes y la fundamentación. Florence-2 establece un nuevo referente de rendimiento de cero ejemplos, es decir, puede realizar tareas sin entrenamiento específico previo, y tiene un tamaño de modelo menor que otros modelos de visión y lenguaje de vanguardia.
Florence-2 es mucho más que otro modelo. Su versatilidad y su mejor rendimiento pueden tener un impacto significativo en diversos sectores al mejorar la precisión y reducir la necesidad de un entrenamiento exhaustivo. En este artículo, veremos las características clave de Florence-2, compararemos su rendimiento con el de otros VLM y hablaremos de sus posibles aplicaciones.
¿Qué es Florence-2?#
Florence-2 puede realizar diversas tareas dentro de un único marco unificado. Parte de las capacidades del modelo se deben a su amplio conjunto de datos de entrenamiento, llamado FLD-5B. FLD-5B incluye 5.400 millones de anotaciones en 126 millones de imágenes. Este completo conjunto de datos se creó específicamente para dotar a Florence-2 de las capacidades necesarias para realizar una amplia variedad de tareas de visión con gran precisión y eficiencia.
Estas son las tareas que admite Florence-2:
- Detección de objetos: puede identificar y localizar objetos en imágenes con gran precisión.
- Segmentación: esta tarea consiste en dividir una imagen en segmentos significativos para facilitar su análisis e interpretación.
- Generación de descripciones de imágenes: Florence-2 puede generar descripciones detalladas de imágenes que aportan contexto e información.
- Localización visual: el modelo puede asociar frases o palabras específicas de una descripción con las regiones correspondientes de la imagen.
- Rendimiento sin ejemplos previos: puede realizar tareas sin entrenamiento específico.
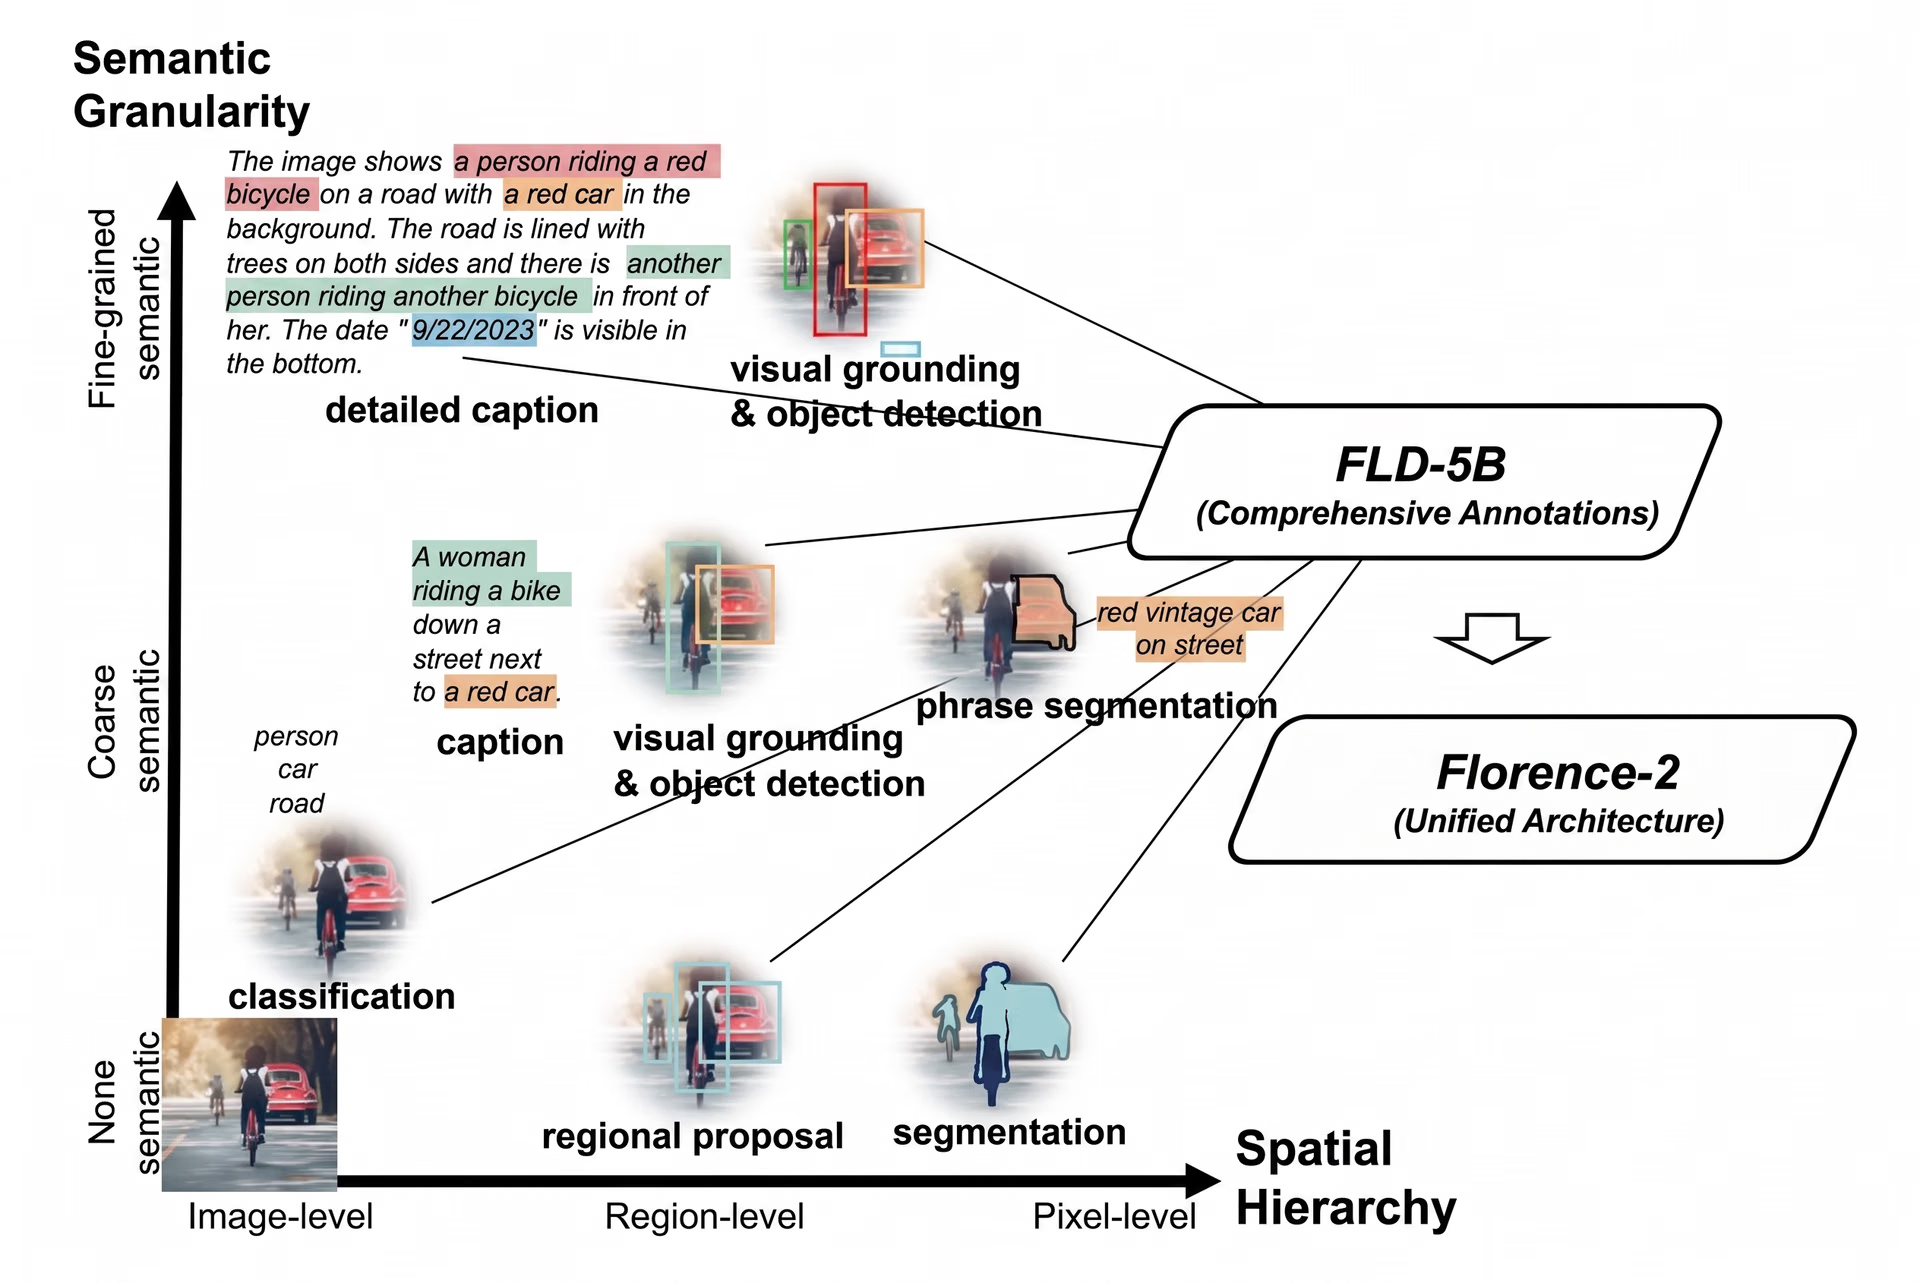
Fig. 1. Cómo se entrenó Florence-2.
El modelo admite tanto tareas basadas en texto como tareas basadas en regiones. Para las tareas que abarcan regiones específicas de una imagen, se añaden a su vocabulario tokens especiales de ubicación. Estos tokens ayudan al modelo a comprender distintas formas, como rectángulos alrededor de objetos (representación de cuadros), formas de cuatro lados (representación de cuadros cuadriláteros) y formas de muchos lados (representación de polígonos). El modelo se entrena con una función de pérdida de entropía cruzada estándar, que le ayuda a aprender comparando sus predicciones con las respuestas correctas y ajustando sus parámetros internos en consecuencia.
Creación del conjunto de datos FLD-5B#
El conjunto de datos FLD-5B incluye distintos tipos de anotaciones: descripciones de texto, pares de regiones y texto, y combinaciones de texto, frases y regiones. Se creó mediante un proceso de dos pasos que incluía la recopilación y anotación de datos. Las imágenes procedían de conjuntos de datos populares como ImageNet-22k, Objects365, Open Images, Conceptual Captions y LAION. La mayoría de las anotaciones del conjunto de datos FLD-5B son sintéticas, es decir, se generaron automáticamente en lugar de etiquetarse manualmente.
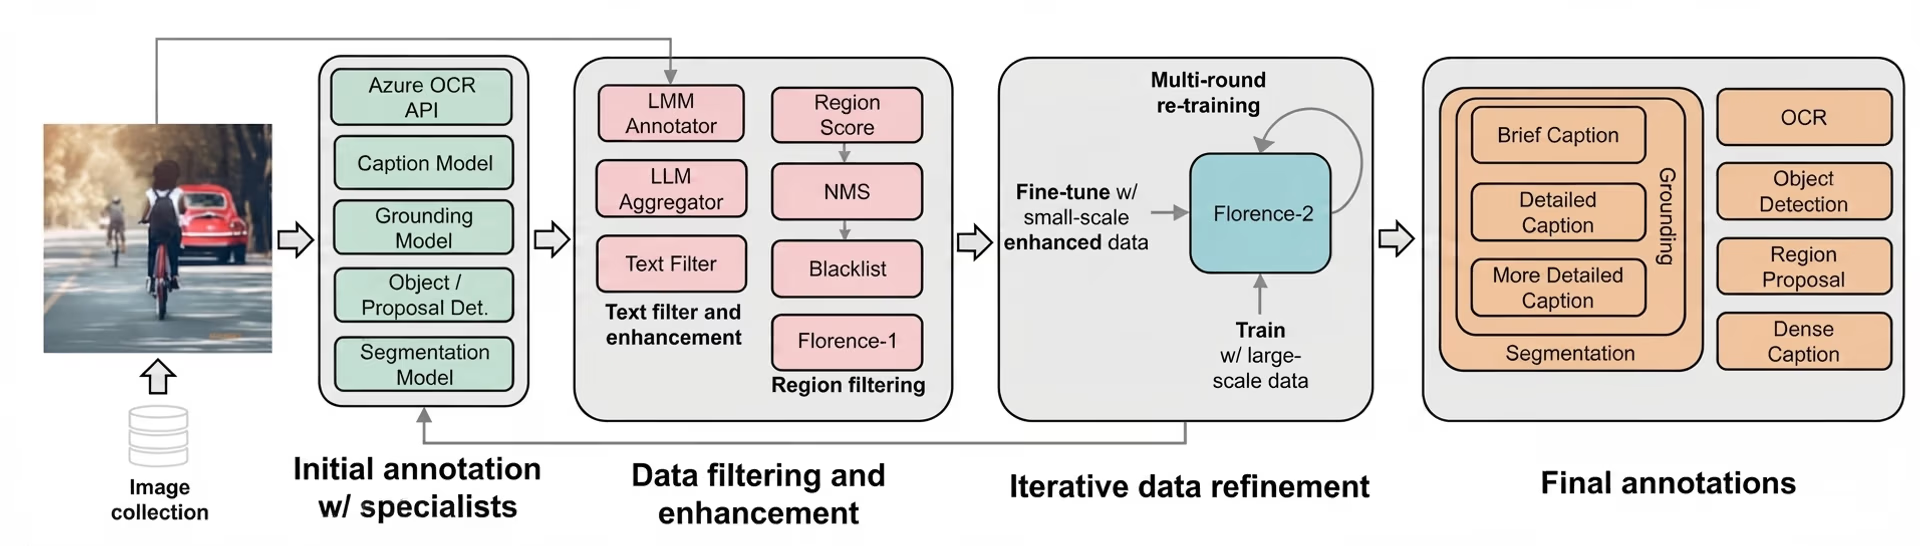
Fig. 2. Creación del conjunto de datos FLD-5B.
Al principio, modelos especializados en tareas concretas, como la detección de objetos o la segmentación, crearon estas anotaciones. Después, se aplicó un proceso de filtrado y mejora para garantizar que las anotaciones fueran detalladas y precisas. Tras eliminar el ruido, el conjunto de datos se sometió a un refinamiento iterativo en el que los resultados de Florence-2 se utilizaron para actualizar y mejorar continuamente las anotaciones.
Arquitectura del modelo Florence-2#
La arquitectura del modelo Florence-2 sigue un enfoque de aprendizaje secuencia a secuencia. Esto significa que el modelo procesa una secuencia de entrada (como una imagen con una instrucción de texto) y genera una secuencia de salida (como una descripción o una etiqueta) paso a paso. En el marco de secuencia a secuencia, cada tarea se trata como un problema de traducción: el modelo recibe una imagen de entrada y una instrucción específica para la tarea, y genera la salida correspondiente.
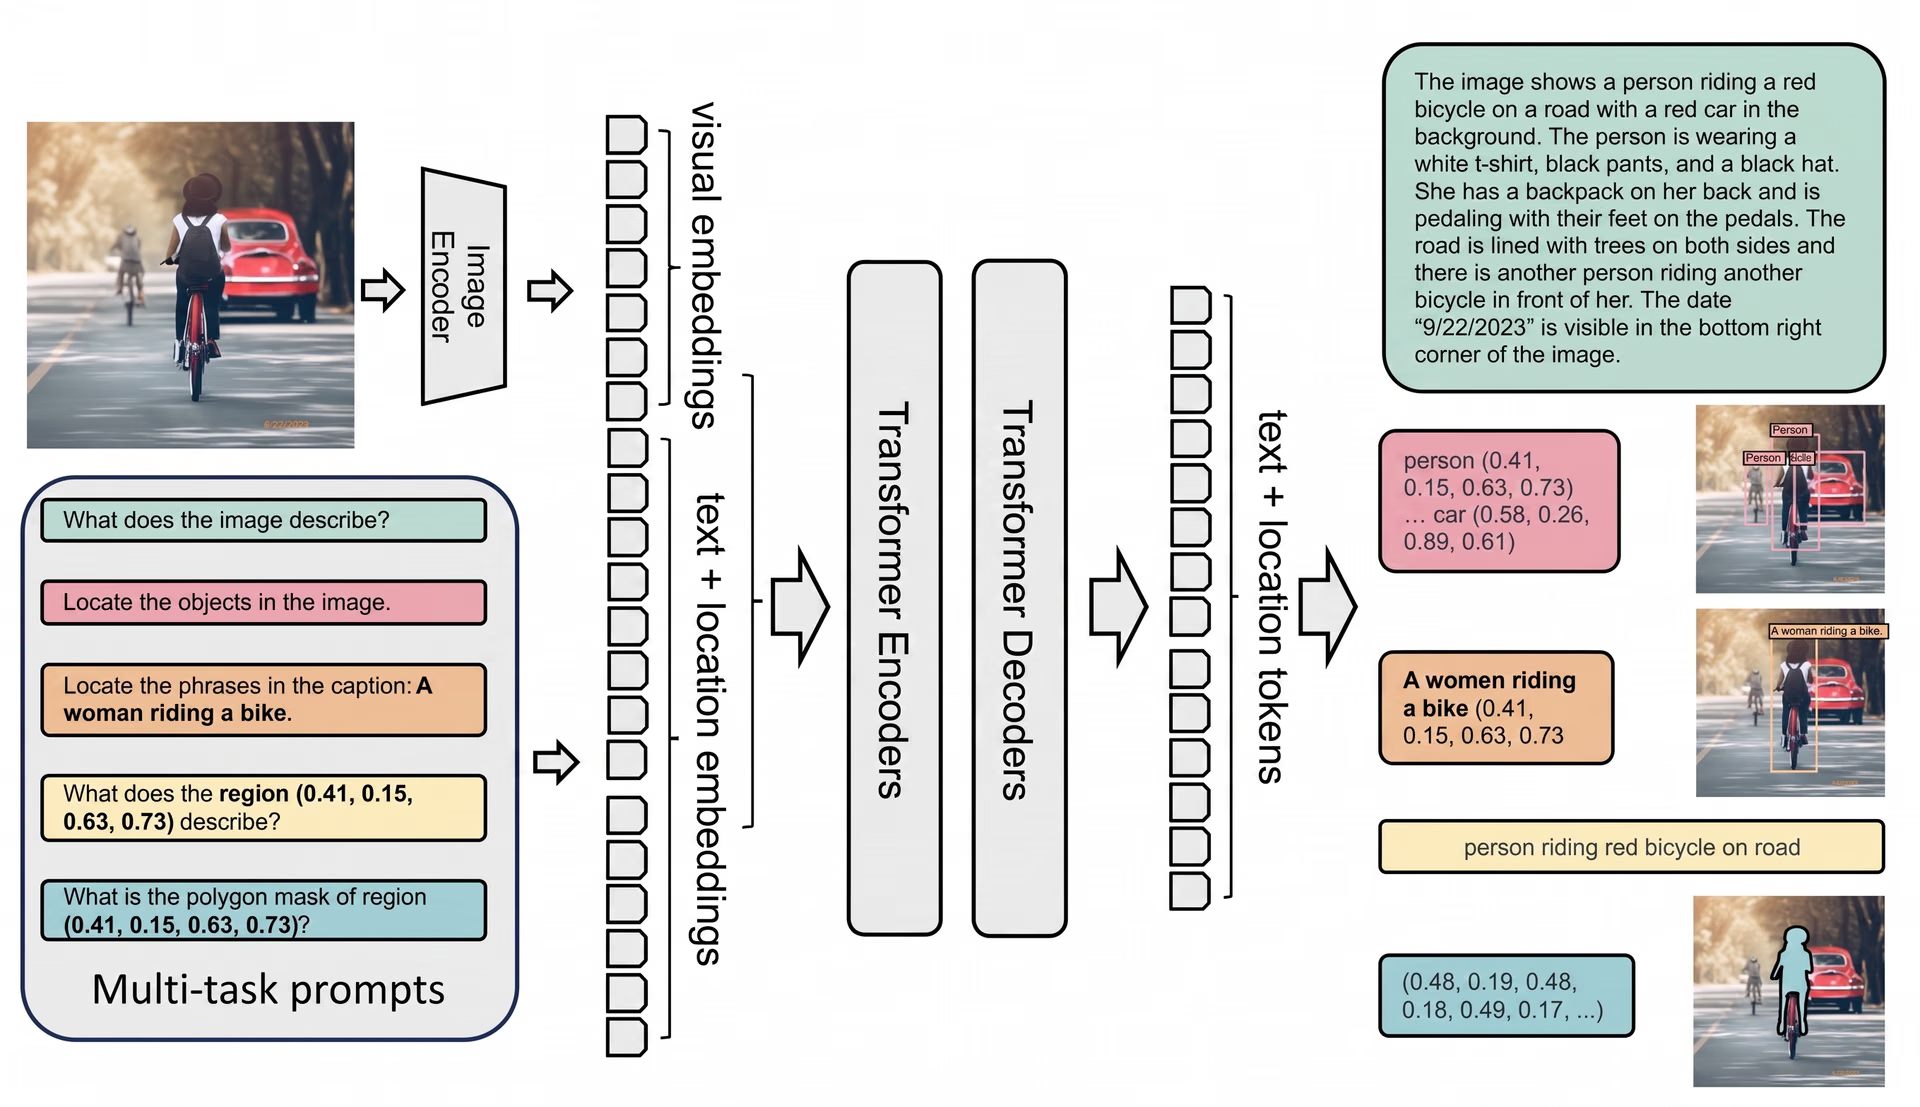
Fig. 3. Arquitectura del modelo de visión y lenguaje Florence-2.
En el núcleo de la arquitectura del modelo hay un Transformer codificador-decodificador multimodal, que combina un codificador de imágenes y un codificador-decodificador multimodal. El codificador de imágenes, llamado DaViT (Dual Attention Vision Transformer), procesa las imágenes de entrada convirtiéndolas en embeddings de tokens visuales, es decir, representaciones compactas de la imagen que capturan información tanto espacial (dónde están las cosas) como semántica (qué son las cosas). Después, estos tokens visuales se combinan con embeddings de texto (representaciones del texto), lo que permite al modelo combinar datos textuales y visuales.
Comparación de Florence-2 con otros VLM#
Florence-2 destaca frente a otros modelos de visión y lenguaje por sus sólidas capacidades de cero ejemplos. A diferencia de modelos como PaliGemma, que dependen de un ajuste fino exhaustivo para adaptarse a distintas tareas, Florence-2 funciona bien desde el primer momento. Además, Florence-2 puede competir con modelos más grandes como GPT-4V y Flamingo, que suelen tener muchos más parámetros, pero no siempre igualan el rendimiento de Florence-2. Por ejemplo, Florence-2 obtiene mejores resultados de cero ejemplos que Kosmos-2, aunque Kosmos-2 tiene más del doble de parámetros.
En las pruebas de rendimiento, Florence-2 ha ofrecido buenos resultados en tareas como la generación de descripciones para COCO y la comprensión de expresiones referenciales. Superó a modelos como PolyFormer y UNINEXT en tareas de detección de objetos y segmentación en el conjunto de datos COCO. Es una opción muy competitiva para aplicaciones del mundo real en las que tanto el rendimiento como la eficiencia de recursos son fundamentales. Puedes anotar automáticamente conjuntos de datos de detección con Florence-2 en Ultralytics Platform y ver cómo se compara con otros modelos de visión y lenguaje en la clasificación de VLM.
Aplicaciones de Florence-2#
Florence-2 puede utilizarse en muchos sectores distintos, como el entretenimiento, la accesibilidad, la educación, etc. Veamos algunos ejemplos para entenderlo mejor.
Aplicaciones de la generación de descripciones de imágenes#
Cuando estás en una plataforma de streaming intentando decidir qué ver, quizá leas el resumen de una película para ayudarte a elegir. ¿Y si la plataforma también pudiera ofrecer una descripción detallada del cartel de la película? Florence-2 puede hacerlo mediante la generación de descripciones de imágenes, que crea textos descriptivos a partir de imágenes. Florence-2 puede generar descripciones detalladas de carteles de películas, lo que hace que las plataformas de streaming sean más inclusivas para las personas con discapacidad visual. Al analizar los elementos visuales de un cartel, como los personajes, el escenario y el texto, Florence-2 puede crear descripciones detalladas que transmiten su contenido y su ambiente. La imagen siguiente muestra el nivel de detalle que Florence-2 puede ofrecer en sus descripciones.
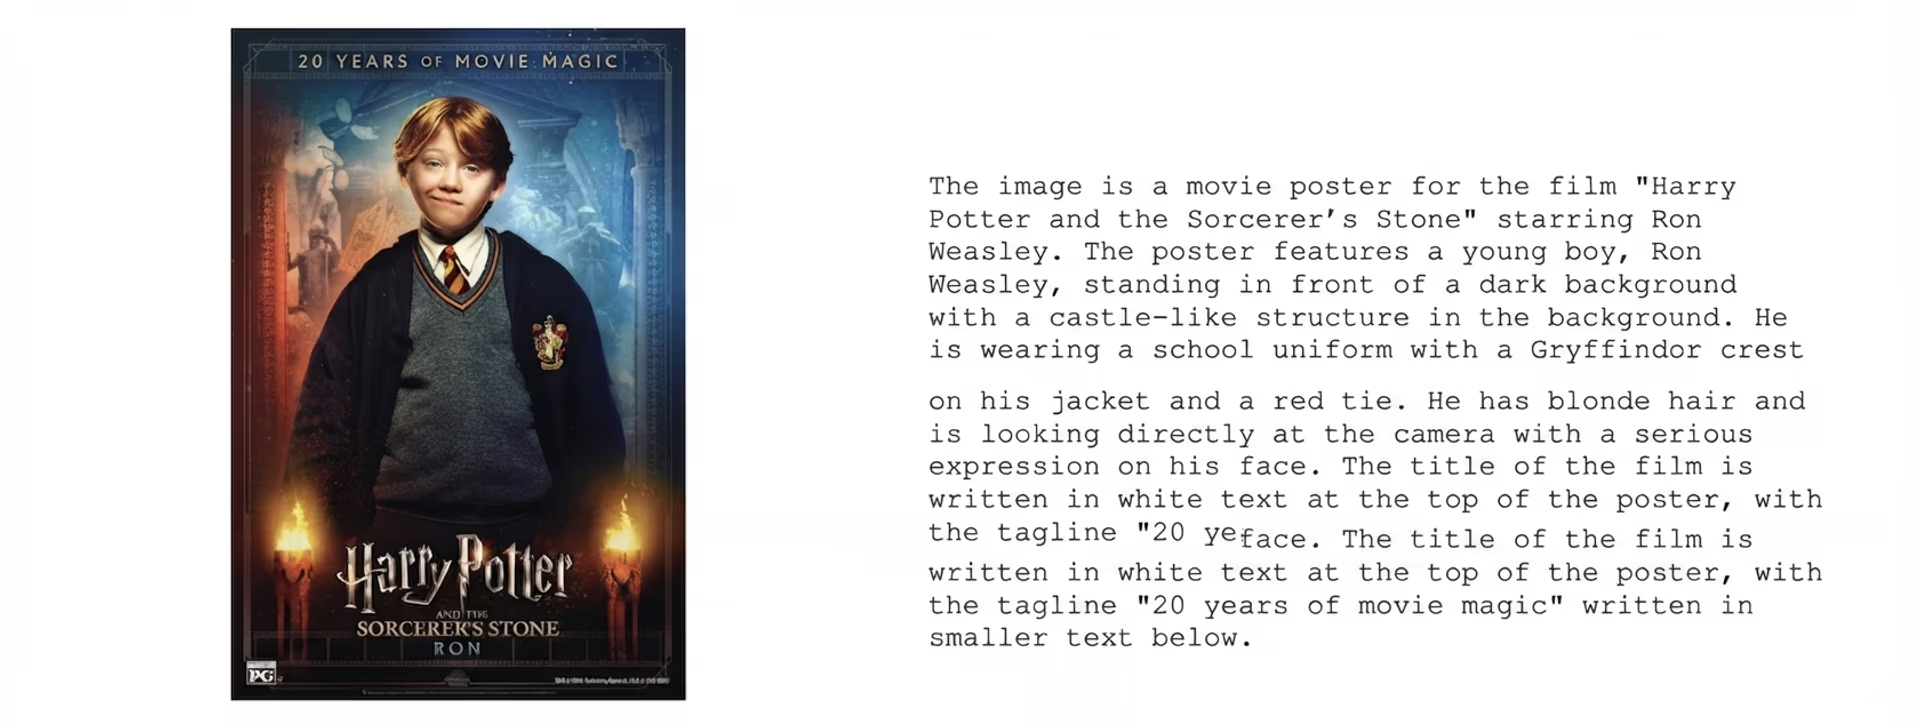
Fig. 4. Ejemplo de una descripción de imagen generada por Florence-2.
Estos son otros ejemplos de casos en los que puede resultar útil generar descripciones de imágenes:
- Comercio electrónico: la generación de descripciones de imágenes puede ofrecer descripciones detalladas de las imágenes de productos y ayudar a los clientes a comprender mejor sus características y detalles.
- Viajes y turismo: puede ofrecer descripciones detalladas de lugares emblemáticos y atracciones en guías y aplicaciones de viaje.
- Educación: la generación de descripciones de imágenes puede etiquetar y describir imágenes y diagramas educativos, lo que facilita la enseñanza y el aprendizaje.
- Inmobiliaria: puede ofrecer descripciones detalladas de imágenes de propiedades que destaquen sus características y servicios para posibles compradores.
Uso de la localización visual al cocinar#
Florence-2 también puede utilizarse para enriquecer las experiencias culinarias. Por ejemplo, un libro de cocina en línea podría utilizar Florence-2 para localizar visualmente y etiquetar elementos de una imagen compleja de una receta. En este caso, la localización visual ayuda a vincular partes concretas de la imagen con el texto descriptivo correspondiente. Cada ingrediente y cada paso pueden etiquetarse y explicarse con precisión, lo que facilita que quienes cocinan en casa sigan la receta y entiendan la función de cada elemento en el plato.
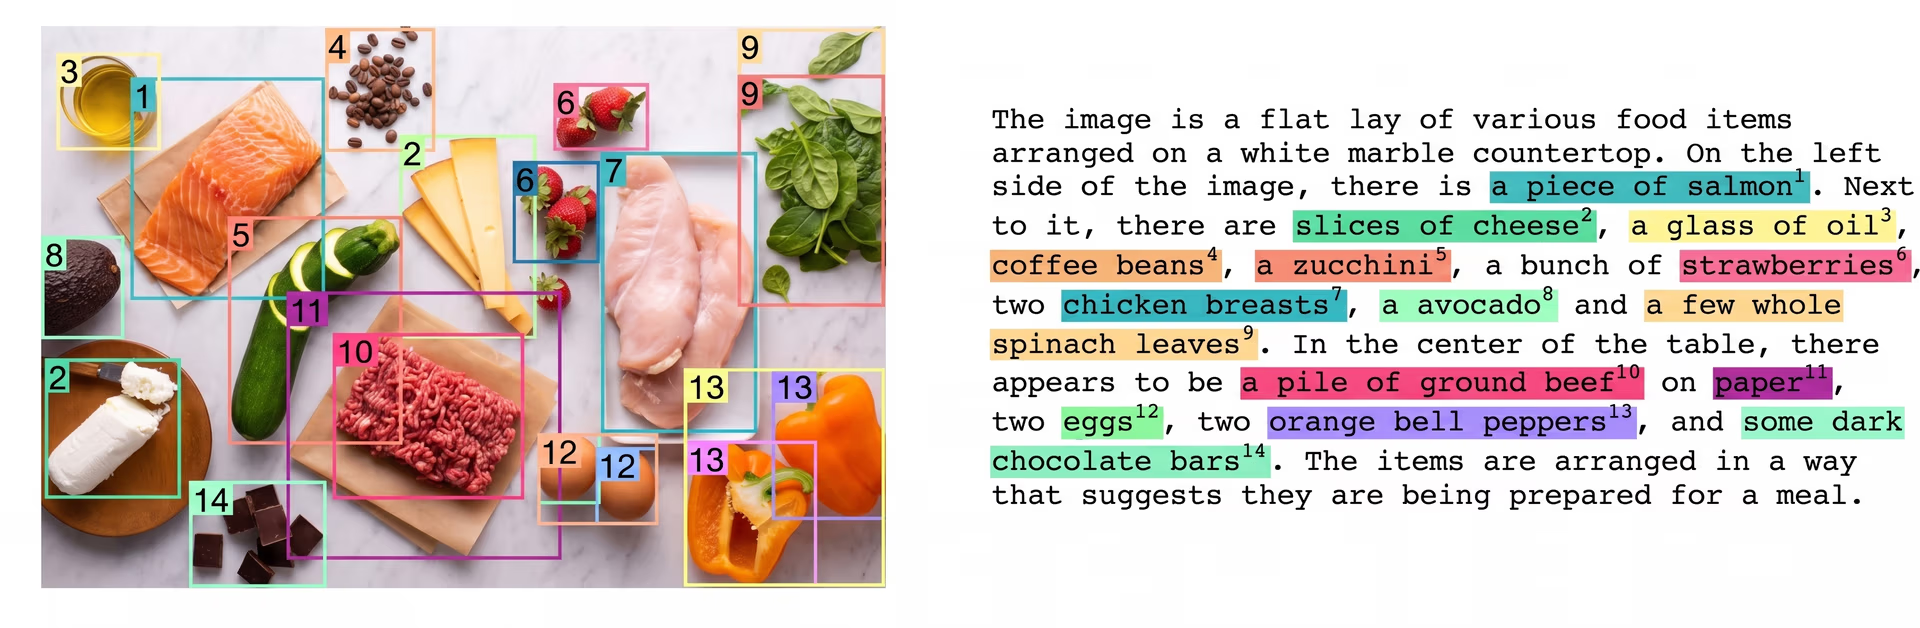
Fig. 5. Ejemplo de localización visual con Florence-2.
OCR por regiones para documentos financieros#
El OCR con procesamiento por regiones, que se centra en extraer texto de áreas concretas de un documento, puede resultar útil en ámbitos como la contabilidad. Se pueden analizar áreas específicas de documentos financieros para extraer automáticamente información importante, como los detalles de las transacciones, los números de cuenta y las fechas de vencimiento. Al reducir la necesidad de introducir datos manualmente, se minimizan los errores y se agiliza el procesamiento. Las entidades financieras pueden utilizarlo para agilizar tareas como la tramitación de facturas, la conciliación de recibos y la compensación de cheques, lo que permite realizar transacciones más rápidas y ofrecer un mejor servicio al cliente.
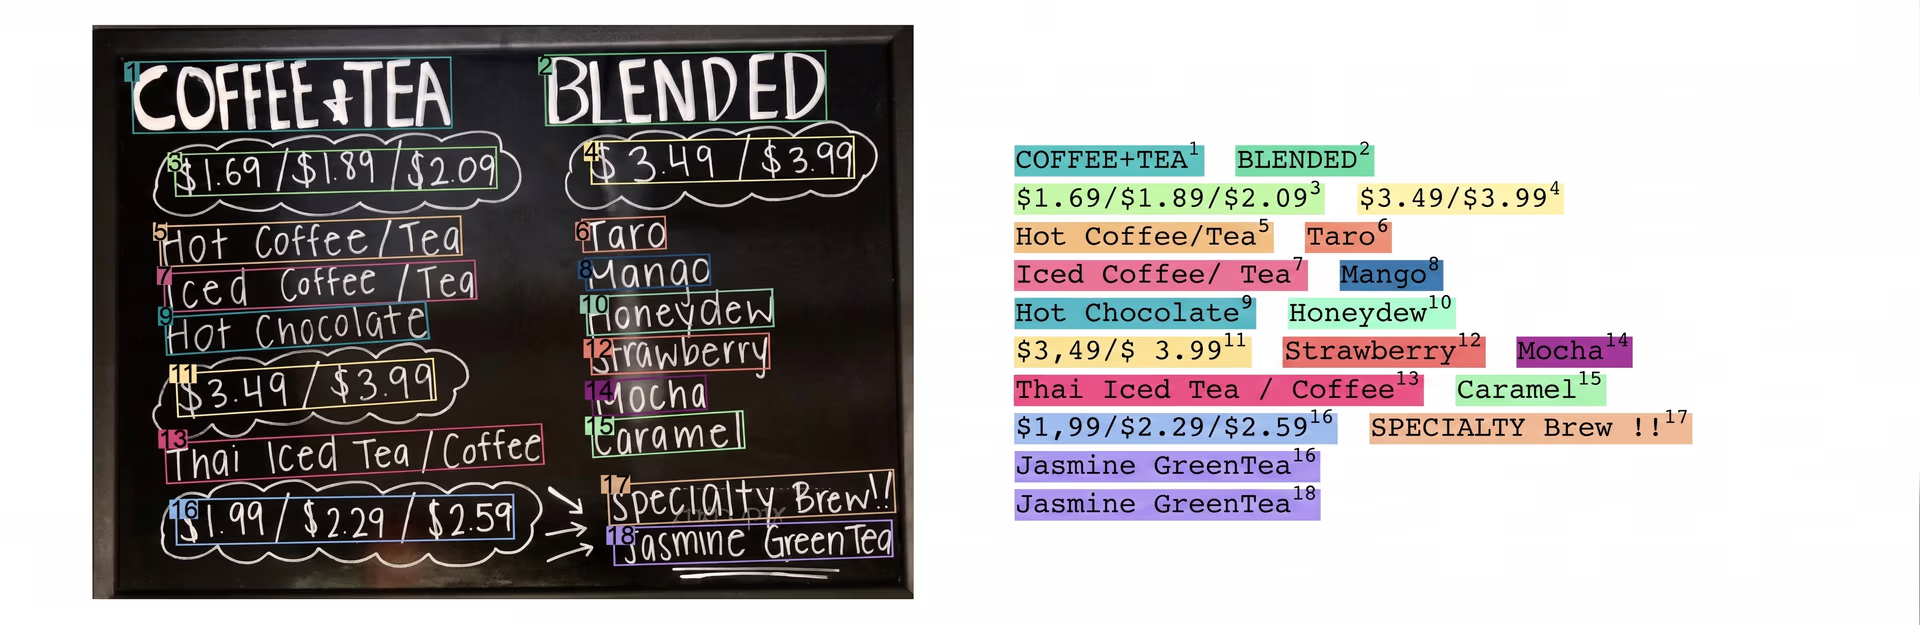
Fig. 6. Ejemplo de extracción de texto con OCR por regiones mediante Florence-2.
Segmentación por regiones en aplicaciones industriales#
La segmentación por regiones, que consiste en dividir una imagen en partes significativas para facilitar un análisis específico y una inspección detallada, puede impulsar las aplicaciones industriales que mejoran la precisión y la eficiencia de diversos procesos. Al centrarse en áreas concretas de una imagen, esta tecnología permite inspeccionar y analizar detalladamente componentes y productos. En el control de calidad, puede identificar defectos o irregularidades en los materiales, como grietas o desalineaciones, y garantizar que solo lleguen al mercado productos de máxima calidad.
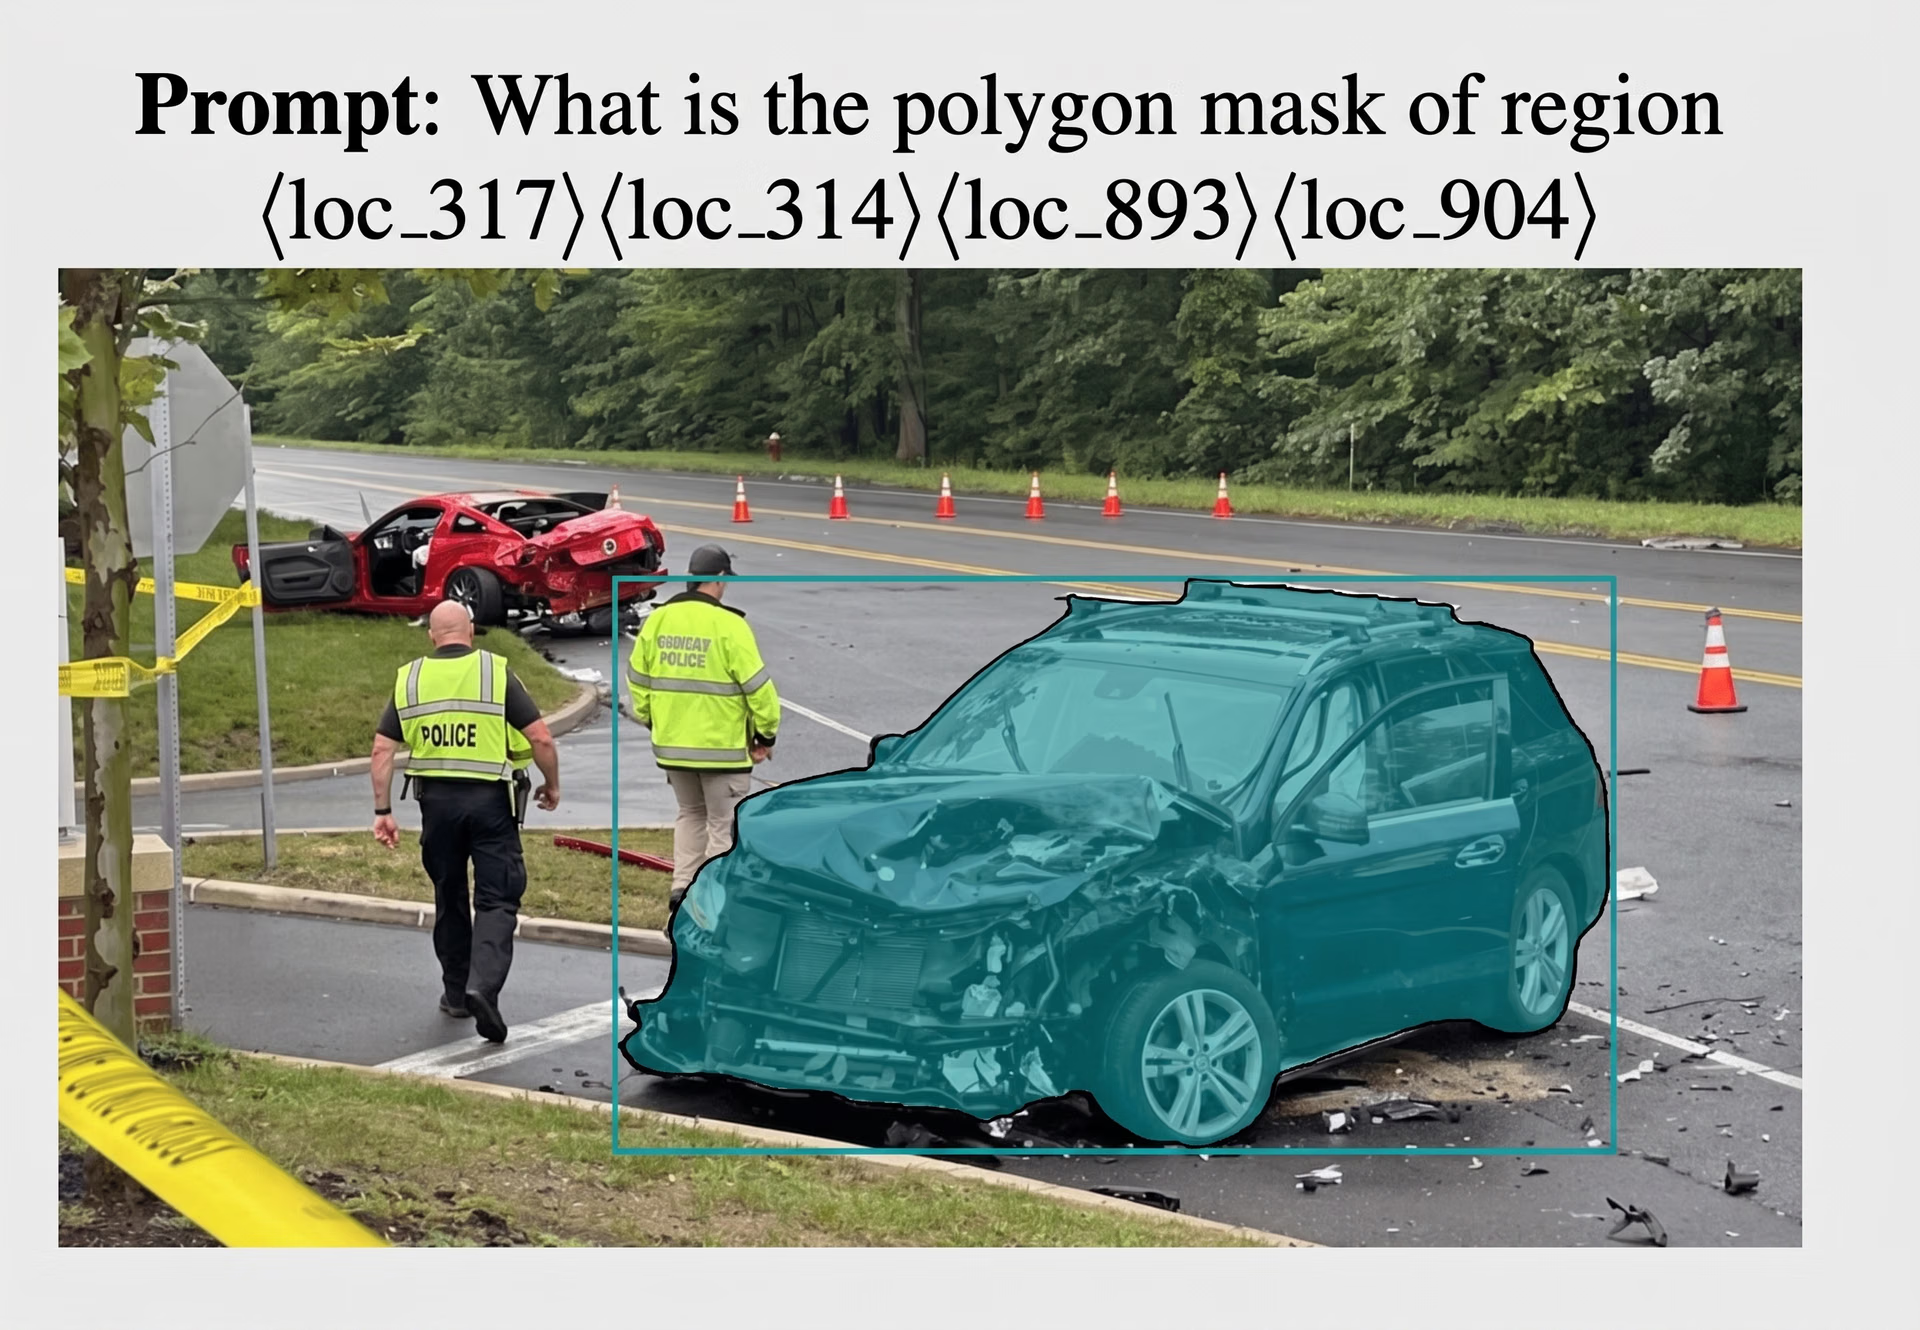
Fig. 7. Ejemplo de segmentación por regiones con Florence-2.
También mejora las líneas de montaje automatizadas al guiar los brazos robóticos hacia piezas concretas y optimizar la colocación y el montaje de los componentes. Del mismo modo, en la gestión de inventario, ayuda a seguir y supervisar el estado y la ubicación de las mercancías, lo que permite una logística más eficiente y reduce los tiempos de inactividad. En general, la segmentación por regiones aumenta la precisión y la productividad, y permite reducir costes y mejorar la calidad de los productos en entornos industriales.
Conclusiones clave#
Estamos empezando a ver una tendencia hacia modelos de IA más ligeros que mantienen un alto rendimiento. Florence-2 supone un gran avance para los modelos de visión y lenguaje. Puede realizar diversas tareas, como la detección de objetos, la segmentación, la generación de descripciones de imágenes y la fundamentación, con un impresionante rendimiento de cero ejemplos. A pesar de su menor tamaño, Florence-2 es eficiente y multifuncional, lo que lo hace útil en aplicaciones de distintos sectores. Modelos como Florence-2 abren nuevas posibilidades y amplían el potencial de la innovación en IA.
Descubre más sobre la IA en nuestro repositorio de GitHub y únete a nuestra comunidad. Consulta nuestras páginas de soluciones para leer sobre aplicaciones de IA en la fabricación y la agricultura.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









