Ultralytics Platform: despliegue de modelos de visión artificial en cualquier región
Aprende a desplegar tus modelos de visión artificial en cualquier región usando Ultralytics Platform para conseguir un despliegue de IA escalable, rápido y flexible.
A principios de esta semana, Ultralytics lanzó Ultralytics Platform, un nuevo entorno integral diseñado para acelerar la puesta en producción de sistemas de visión artificial (CV) al agilizar cada etapa del flujo de trabajo de IA para visión, desde la preparación de datos y el desarrollo de modelos hasta el despliegue.
Una de las principales motivaciones para desarrollar Ultralytics Platform es que llevar desde la idea hasta la obtención de resultados una solución de visión artificial que permita a las máquinas analizar imágenes y vídeos implica mucho más que crear un modelo sólido. Una vez entrenado y validado un modelo, hay que desplegarlo para que las aplicaciones puedan enviar imágenes, recibir predicciones y ejecutar inferencias de forma fiable en entornos reales.
Esta etapa del ciclo de vida del aprendizaje automático es cuando los modelos de visión artificial van más allá de la experimentación y empiezan a impulsar sistemas prácticos. Aunque etapas anteriores como la preparación del conjunto de datos, la anotación, el entrenamiento del modelo y las pruebas avancen sin problemas, sin una forma fiable de desplegar los modelos, esos resultados no pueden marcar la diferencia.
La realidad en muchos proyectos de visión artificial es que el despliegue puede ser uno de los pasos más complejos del flujo de trabajo.
A menudo, los equipos tienen que configurar API de inferencia, gestionar recursos informáticos, desplegar modelos cerca de los usuarios para reducir la latencia y supervisar el rendimiento una vez que los sistemas están en producción.
Ultralytics Platform agiliza y automatiza este proceso al proporcionar varias opciones de despliegue, incluidos formatos de exportación de modelos, servicios de inferencia compartidos y endpoints dedicados en regiones de todo el mundo. Con infraestructura gestionada y supervisión integrada, los equipos pueden pasar fácilmente de modelos entrenados a sistemas de visión artificial listos para producción.
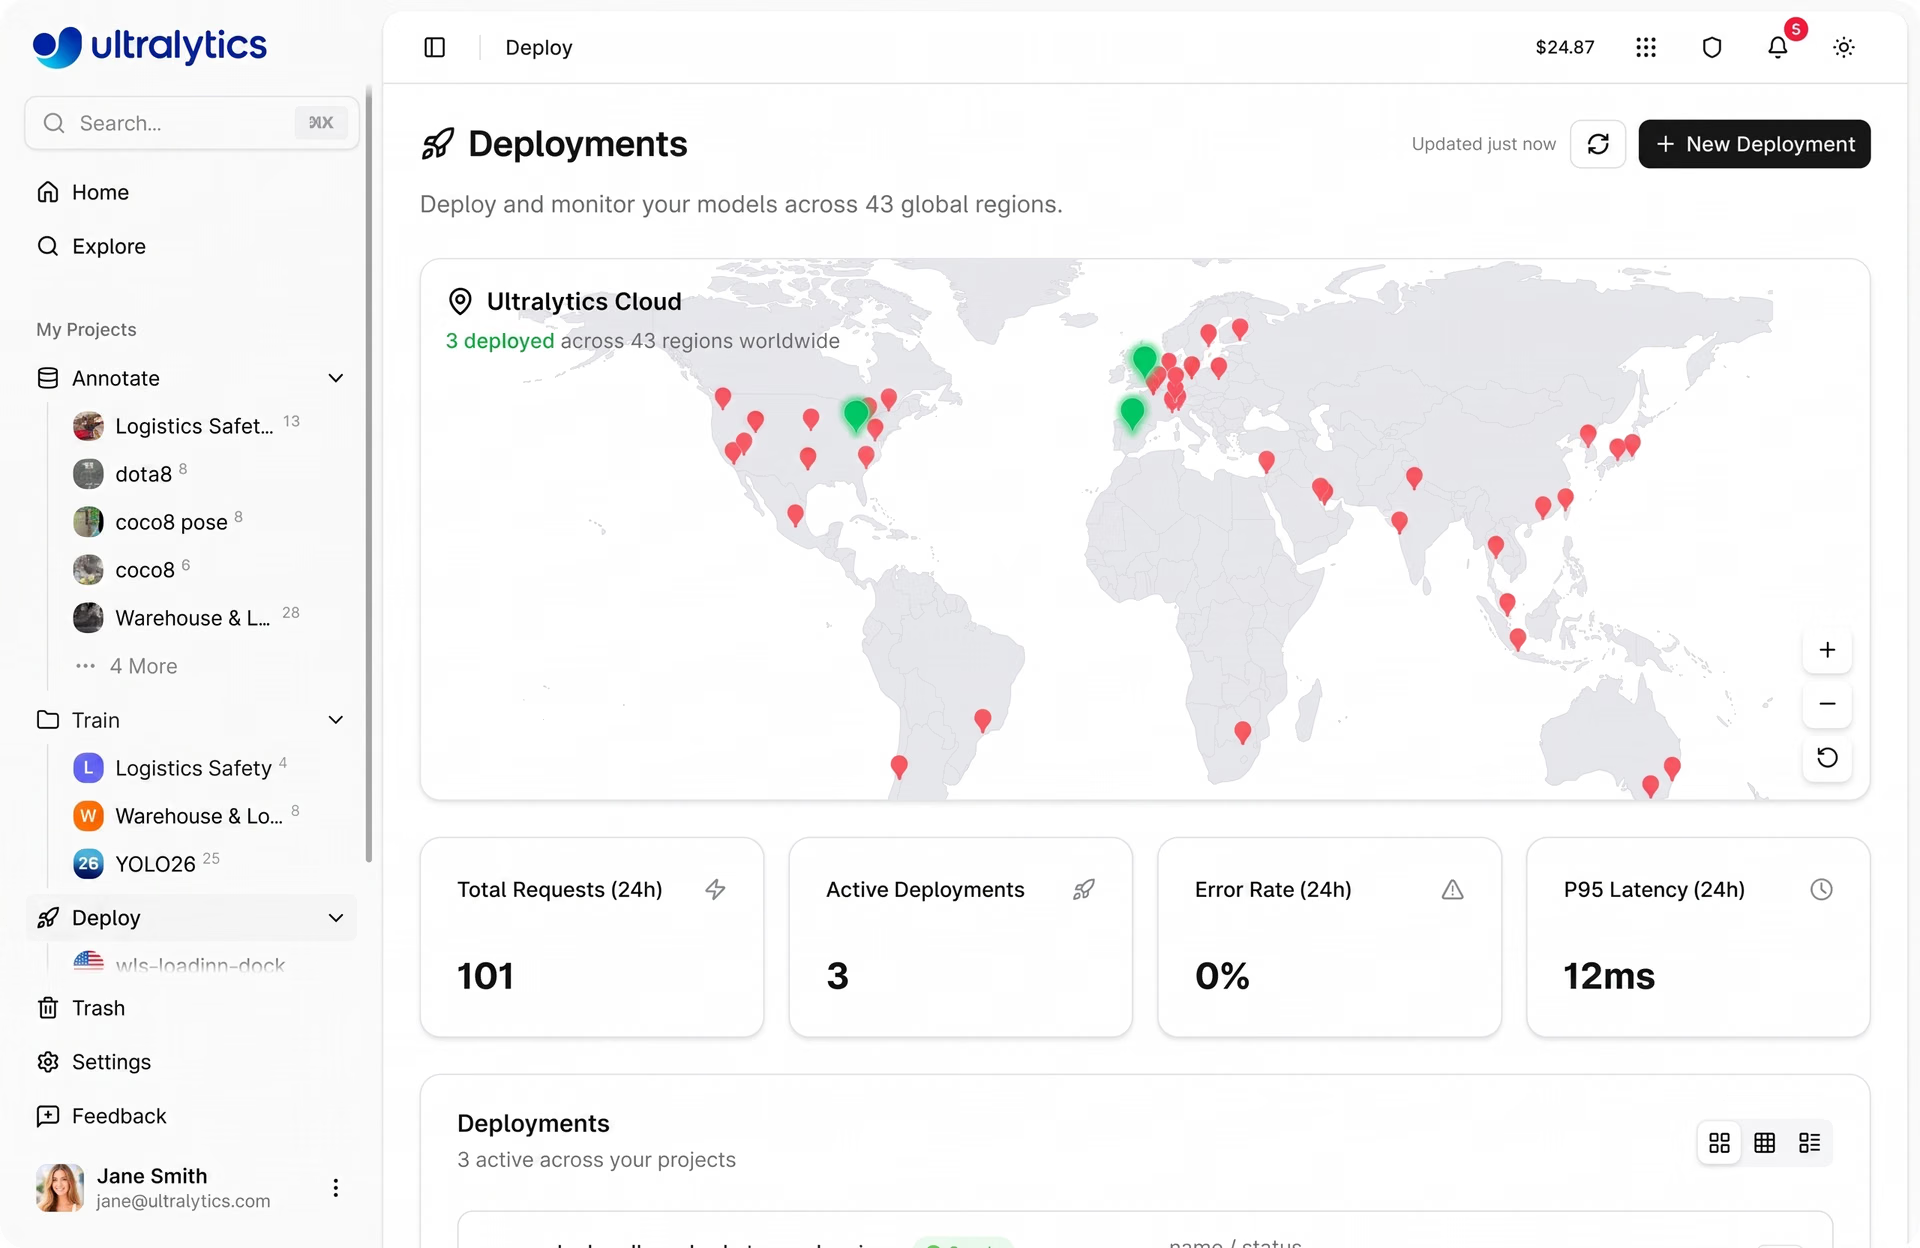
Fig. 1. Una vista del despliegue de modelos mediante Ultralytics Platform (Fuente)
En este artículo, veremos cómo desplegar modelos de visión artificial en cualquier región mediante endpoints dedicados en Ultralytics Platform. ¡Empecemos!
¿Qué es el despliegue de modelos de CV?#
Antes de profundizar en cómo desplegar modelos de aprendizaje profundo mediante Ultralytics Platform, entendamos mejor qué significa realmente desplegar un modelo de visión artificial.
El despliegue de modelos de visión artificial es el proceso de poner un modelo entrenado a disposición para su uso en el mundo real. En lugar de ejecutarse únicamente en un entorno de entrenamiento, el modelo se configura para que las aplicaciones puedan enviarle imágenes o vídeos y recibir predicciones a cambio.
Por ejemplo, un modelo puede detectar objetos en una imagen, realizar segmentación de imágenes, identificar artículos en un almacén o reconocer patrones en secuencias de vídeo. En la mayoría de los sistemas reales, esto se hace mediante una API o un endpoint de inferencia.
Una aplicación envía una imagen al modelo, el modelo la procesa y devuelve una predicción en cuestión de milisegundos. Esto es lo que permite que modelos de visión artificial como Ultralytics YOLO impulsen aplicaciones en tiempo real.
Los modelos se pueden desplegar en distintos entornos según el caso de uso. Algunos se ejecutan en la nube (a través de plataformas en la nube) y muchas aplicaciones pueden acceder a ellos, mientras que otros se ejecutan en dispositivos periféricos, como cámaras locales, robots o sistemas integrados que necesitan predicciones locales rápidas.
Opciones de despliegue de modelos de IA en Ultralytics Platform#
Aunque Ultralytics Platform aborda muchos de los retos a los que se enfrenta la comunidad de visión artificial, especialmente en lo que respecta al despliegue de modelos, ofrece formas flexibles de ejecutar inferencias según las necesidades de tu aplicación.
Estas son, a grandes rasgos, las opciones de despliegue de modelos disponibles en la plataforma:
- Exportación de modelos: puedes exportar modelos a 17 formatos diferentes, incluidos ONNX, TensorRT, CoreML y TFLite, lo que permite ejecutar modelos en una amplia variedad de entornos, como dispositivos periféricos como Raspberry Pi y NVIDIA Jetson, aplicaciones móviles, contenedores Docker e infraestructura personalizada.
- Inferencia compartida: la plataforma te permite ejecutar predicciones mediante un servicio de inferencia compartido y gestionado, ideal para probar modelos rápidamente.
- Endpoints dedicados: despliega fácilmente modelos como servicios independientes con URL de API únicas que pueden ejecutarse en 43 regiones de todo el mundo, con autoescalado, supervisión y comprobaciones de estado integrados para despliegues en producción.
Despliegue mediante endpoints dedicados#
Una de las formas más escalables de ejecutar en producción modelos preentrenados o modelos de visión artificial entrenados a medida en Ultralytics Platform es mediante endpoints dedicados. Un endpoint dedicado te permite desplegar un modelo entrenado como su propio servicio, de modo que las aplicaciones puedan enviarle imágenes y recibir predicciones a través de una API.
En lugar de ejecutar un modelo únicamente en un entorno de entrenamiento o en un cuaderno local, desplegarlo como endpoint hace que esté disponible para aplicaciones reales. Por ejemplo, un sistema de almacén podría enviar imágenes de paquetes para detectar objetos, una cámara inteligente podría analizar fotogramas de vídeo o un sistema robótico podría utilizar predicciones para guiar sus acciones.
Cada endpoint dedicado se ejecuta como un servicio de inquilino único, lo que significa que la infraestructura que ejecuta tu modelo no se comparte con otros usuarios. Esto proporciona un rendimiento más predecible y facilita la supervisión del comportamiento del modelo en producción.
Comprender la funcionalidad de los endpoints de inferencia dedicados#
Puedes considerar un endpoint dedicado como un servicio alojado para tu modelo. Ultralytics Platform proporciona una URL de endpoint única que actúa como punto de entrada para las aplicaciones.
Cuando una aplicación envía una solicitud a esa URL, incluye una imagen y parámetros opcionales, como umbrales de confianza o el tamaño de la imagen, junto con una clave de API para la autenticación.
El servicio ejecuta la inferencia sobre la imagen utilizando tu modelo y devuelve las predicciones en una respuesta estructurada. Esta configuración permite a los desarrolladores integrar modelos de visión artificial en sistemas reales mediante herramientas web estándar.
Las aplicaciones pueden enviar solicitudes mediante Python, JavaScript, cURL u otros clientes HTTP, lo que facilita conectar modelos con paneles, sistemas robóticos o aplicaciones en la nube. Como el endpoint se ejecuta de forma independiente, también admite el escalado, la supervisión y el despliegue global, ayudando a los equipos a crear sistemas de visión artificial fiables para producción.
El despliegue multirregional mejora la inferencia en tiempo real#
Una ventaja clave de los endpoints dedicados en Ultralytics Platform es la posibilidad de desplegar modelos en 43 regiones de todo el mundo. Estas regiones abarcan varias zonas del planeta, como Norteamérica, Sudamérica, Europa, Asia-Pacífico y Oriente Medio y África.
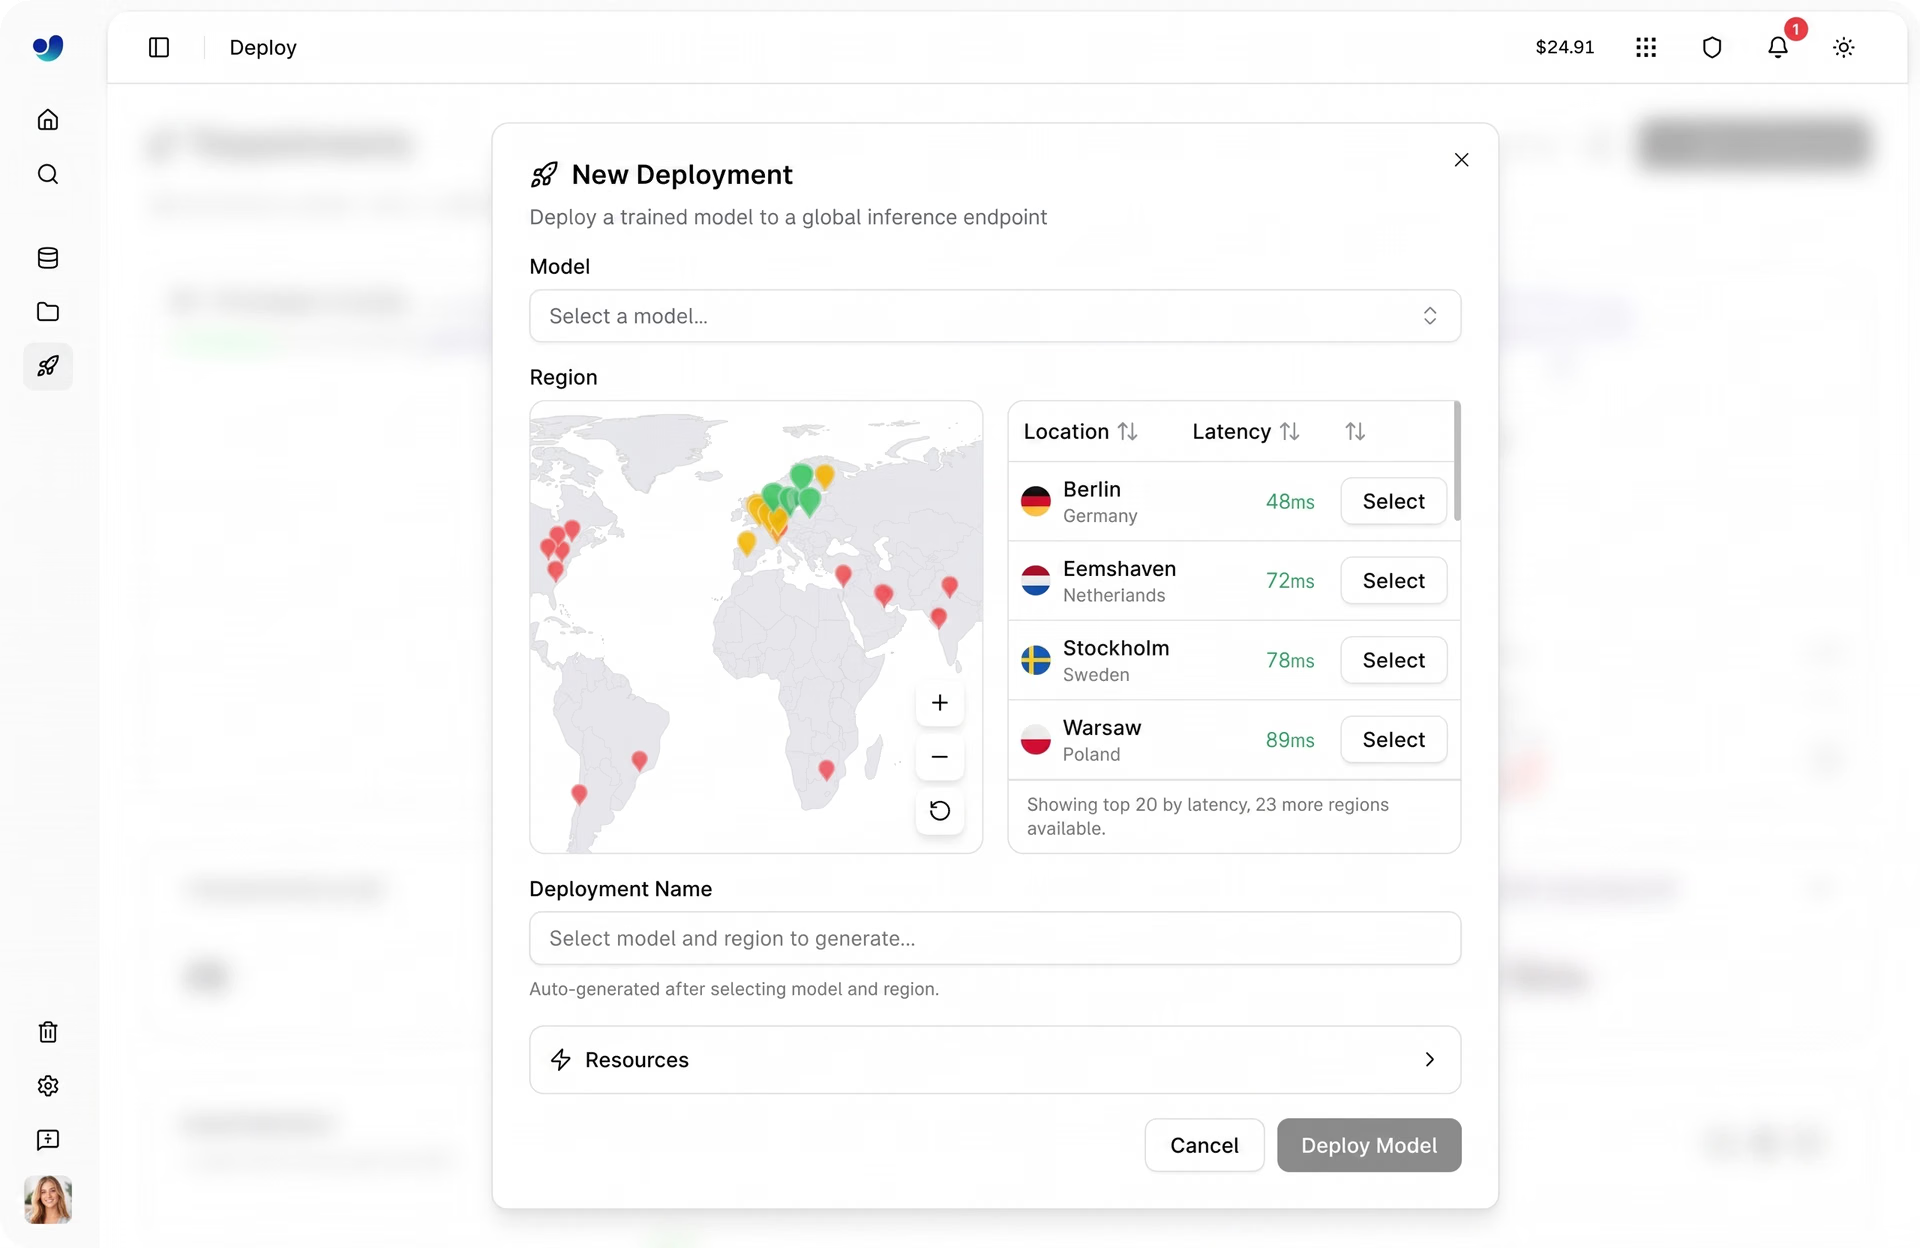
Fig. 2. Ultralytics Platform admite 43 regiones de todo el mundo (Fuente)
Desplegar modelos en regiones más cercanas al lugar donde se ejecutan las aplicaciones ayuda a reducir la latencia, es decir, el tiempo que tarda una aplicación en enviar una imagen y recibir una predicción. También puede ayudar a las organizaciones a cumplir los requisitos de privacidad y residencia de datos al mantener el procesamiento de datos más cerca de su origen.
La baja latencia es importante para muchas aplicaciones de visión artificial que dependen de la inferencia en tiempo real, como los sistemas robóticos, los dispositivos del Internet de las cosas (IoT), los procesos de inspección industrial y la infraestructura de las ciudades inteligentes.
Por ejemplo, si una aplicación se utiliza principalmente en Europa, desplegar el modelo en una región europea puede mejorar significativamente los tiempos de respuesta en comparación con ejecutar el modelo en una región distante.
Cómo desplegar en cualquier región con Ultralytics Platform#
Desplegar un modelo en una región específica es sencillo y normalmente solo lleva un par de minutos. La plataforma se encarga de configurar la infraestructura para que los desarrolladores puedan centrarse en integrar el modelo en sus aplicaciones. Veamos los pasos necesarios.
Paso 1: entrena o sube un modelo#
Antes de desplegarlo, necesitas tener un modelo entrenado disponible en tu proyecto. Puede ser un modelo entrenado directamente en Ultralytics Platform, un modelo subido después de entrenarlo en otro lugar o un modelo clonado de un proyecto de la comunidad encontrado en la «pestaña Explorar», donde puedes copiar a tu propia cuenta con un solo clic proyectos públicos compartidos por otros usuarios.
Cuando el modelo esté listo, abre su página dentro de tu proyecto para continuar.
Paso 2: abre la pestaña Deploy#
Ve a la pestaña Deploy del modelo. Esta sección de la plataforma te permite configurar e iniciar despliegues.
En esa página verás una tabla de regiones y un mapa interactivo que muestra las ubicaciones de despliegue disponibles en todo el mundo. La plataforma mide la latencia desde tu ubicación y ordena las regiones en consecuencia para ayudarte a elegir la más adecuada.
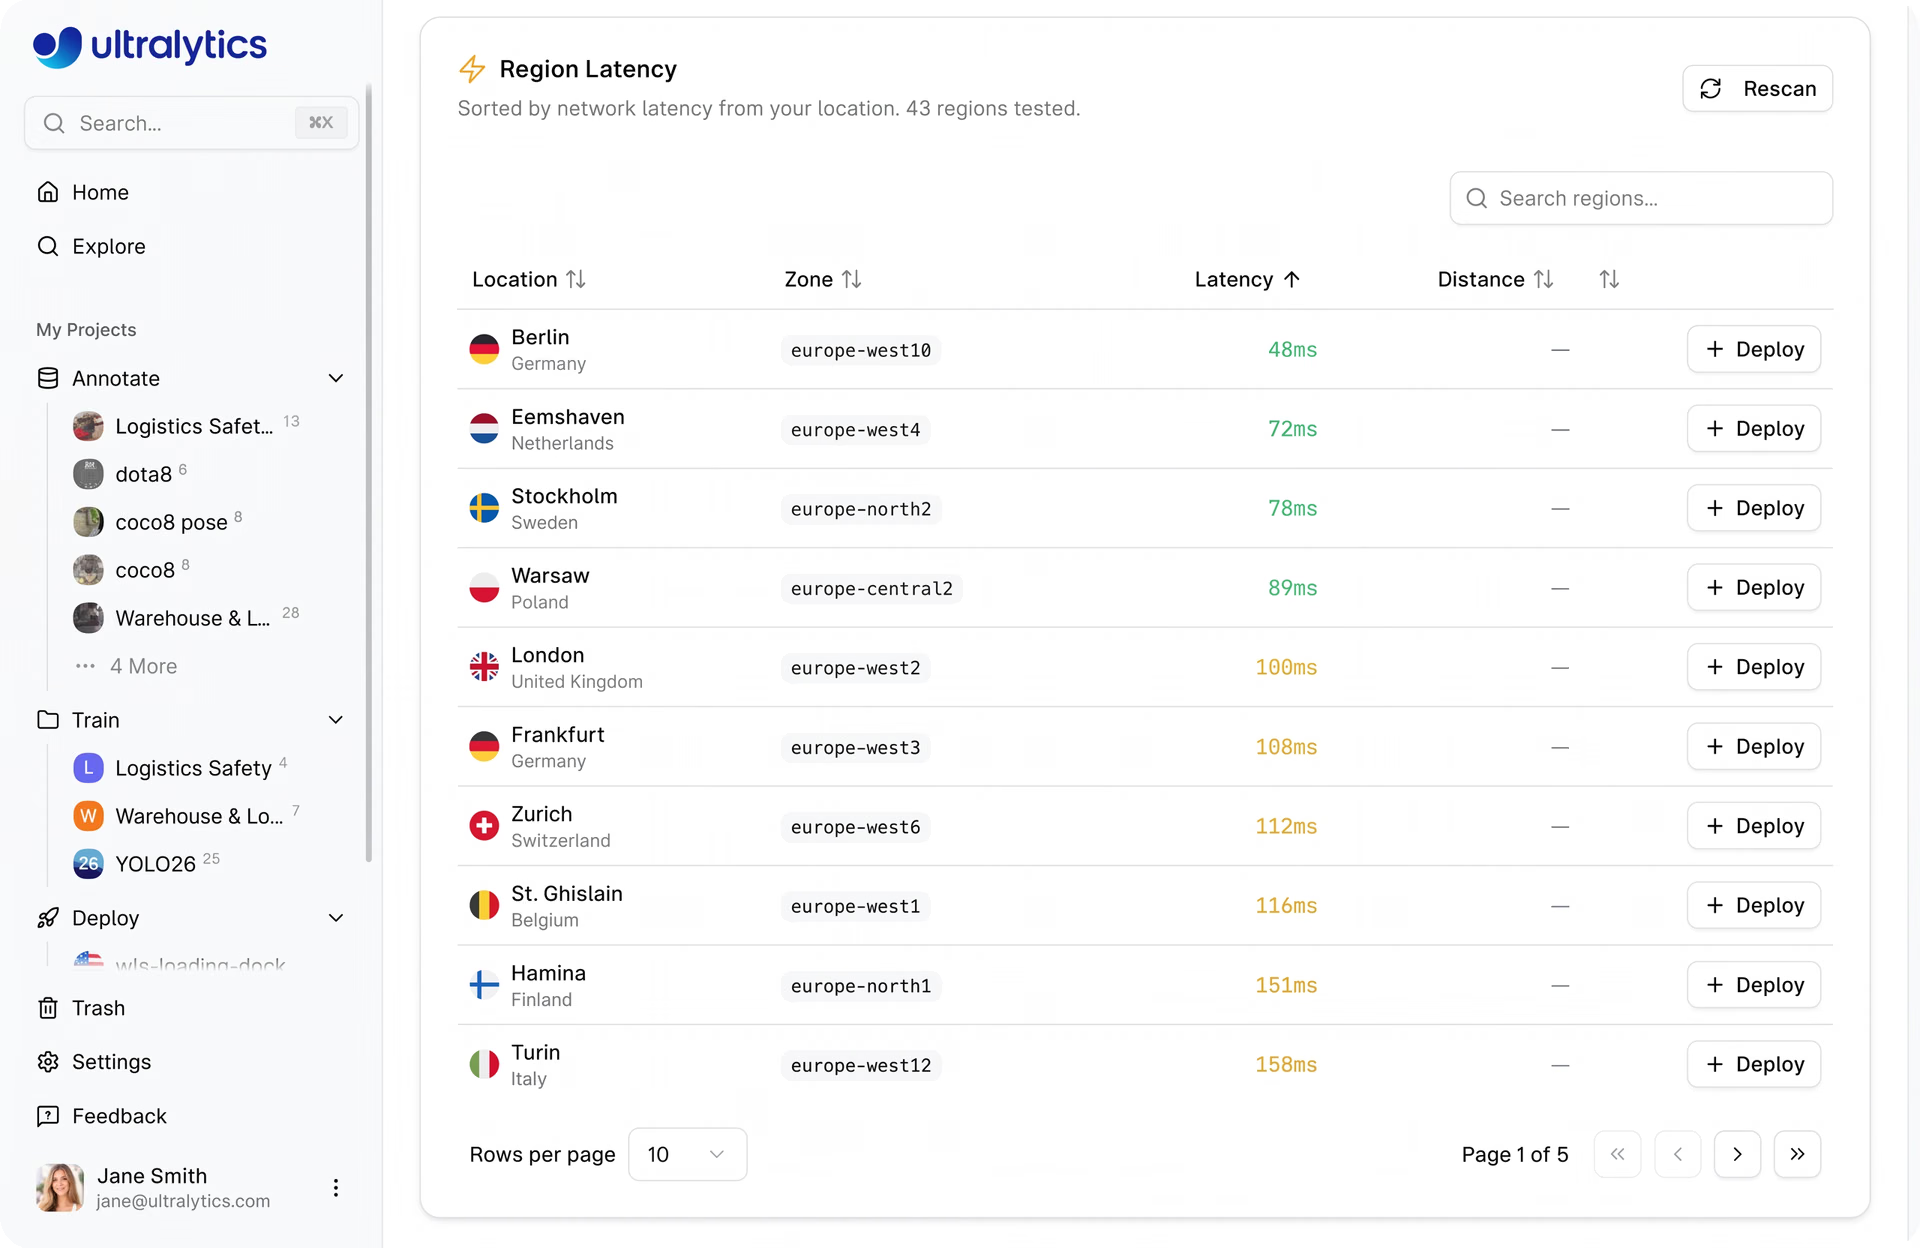
Fig. 3. Regiones ordenadas por latencia en Ultralytics Platform (Fuente)
Paso 3: elige una región de despliegue#
Selecciona una región en función de la ubicación de tus usuarios o aplicaciones. Desplegar el modelo más cerca del origen de las solicitudes puede reducir significativamente los tiempos de respuesta.
Paso 4: despliega el endpoint#
Después de seleccionar la región y confirmar la configuración, puedes hacer clic en Deploy.
A continuación, la plataforma prepara el entorno de despliegue, obtiene la imagen del modelo, inicia el servicio y realiza una comprobación de estado para garantizar que el endpoint está listo. Este proceso suele tardar entre uno y dos minutos.
Cuando se completa el despliegue, la plataforma genera una URL de endpoint única que las aplicaciones pueden utilizar para enviar solicitudes de inferencia.
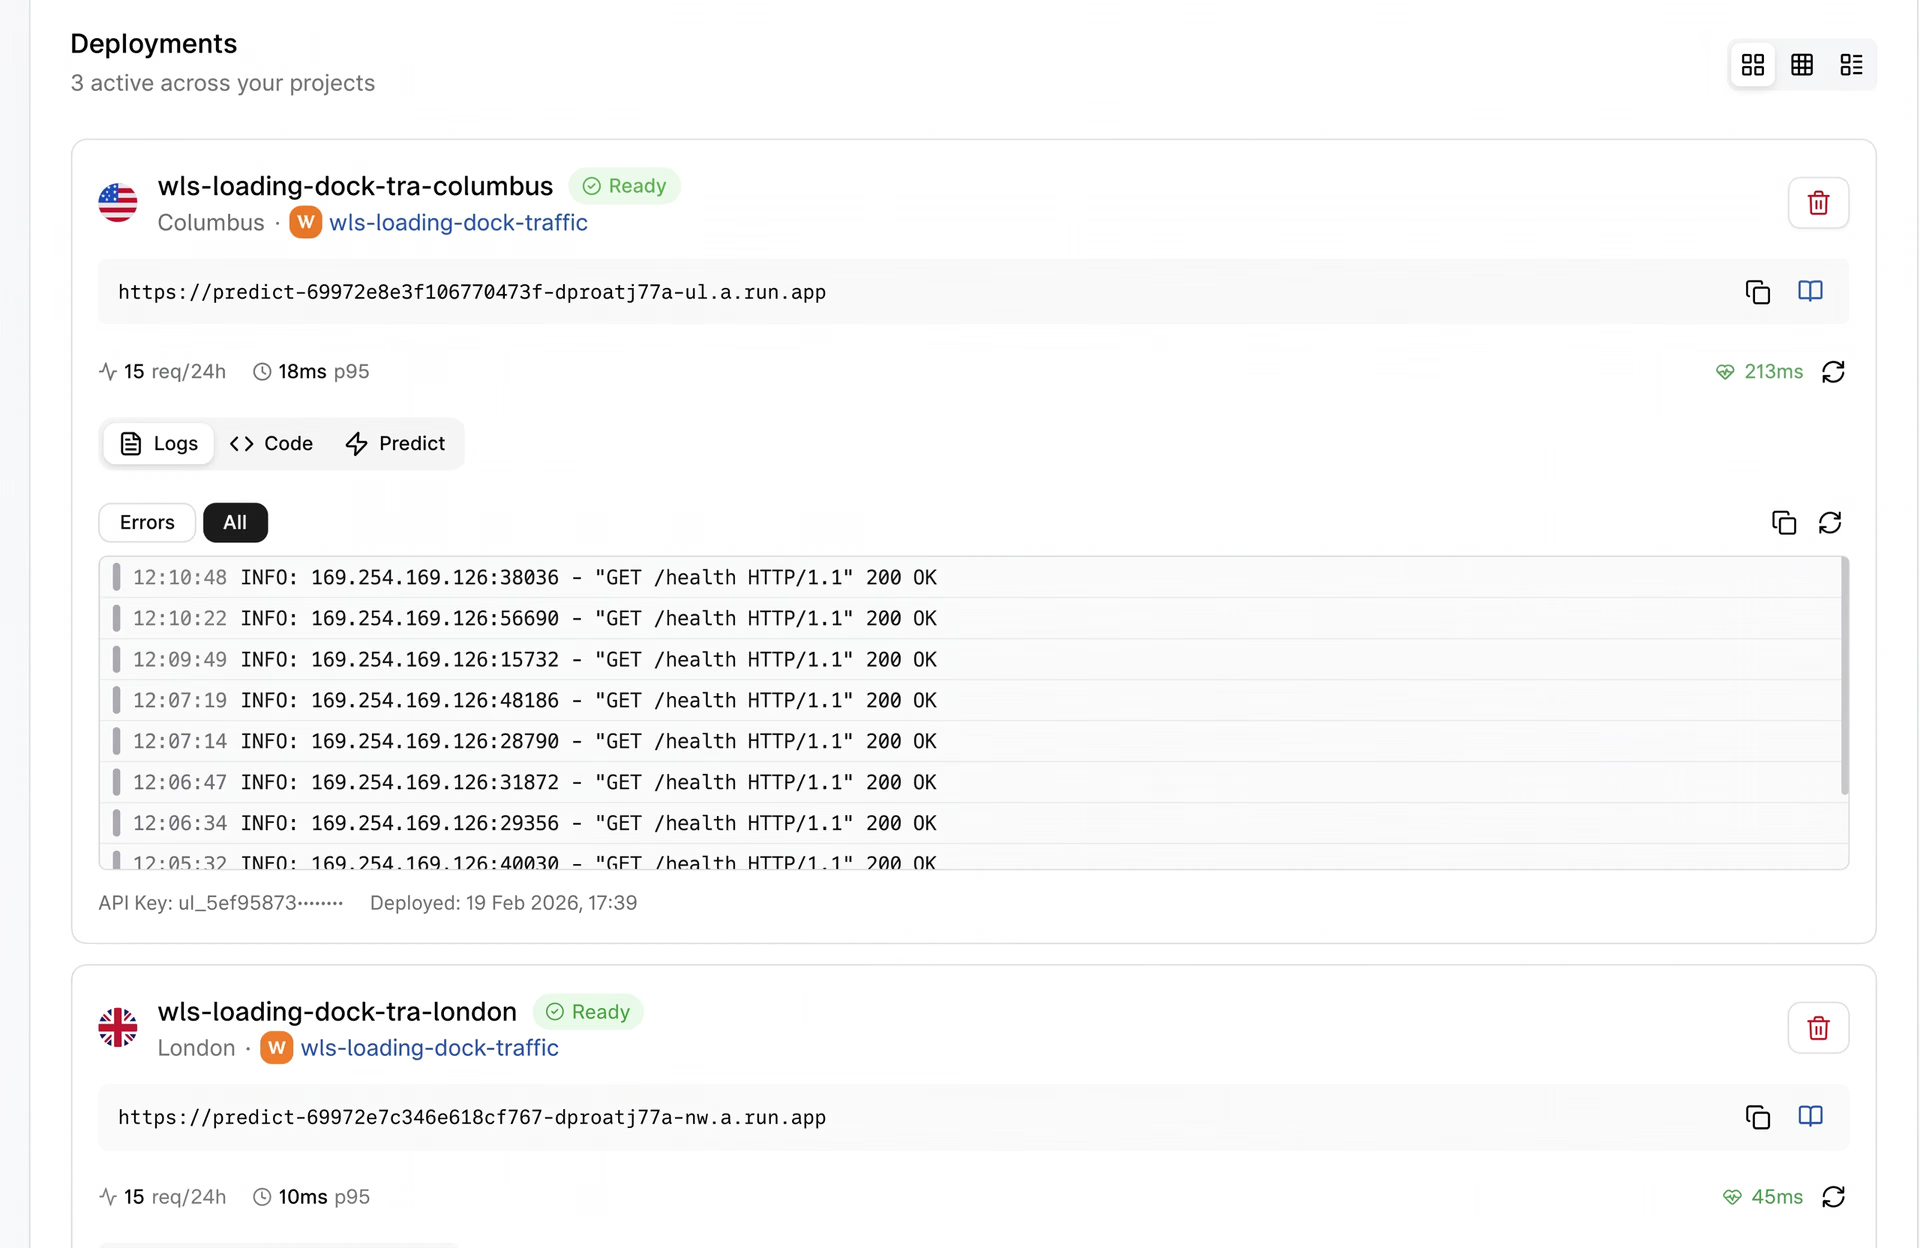
Fig. 4. Ejemplo de un endpoint desplegado (Fuente)
Paso 5: empieza a enviar solicitudes de inferencia#
Con el endpoint en ejecución, las aplicaciones pueden empezar a enviar imágenes al modelo mediante el endpoint de REST API proporcionado y una clave de API incluida en la cabecera Authorization. El endpoint procesa cada solicitud y devuelve predicciones, como objetos detectados, cuadros delimitadores u otros resultados específicos de la tarea.
Para obtener más información sobre el despliegue de modelos, consulta la documentación oficial de Ultralytics Platform.
Supervisión del rendimiento y las métricas de los modelos para endpoints desplegados#
Una vez desplegado un modelo de visión artificial, supervisar su rendimiento se convierte en una parte importante del mantenimiento de la fiabilidad y la robustez del sistema. Incluso un modelo bien entrenado debe observarse en producción para garantizar que sigue respondiendo rápidamente, gestionando correctamente las solicitudes entrantes y ofreciendo predicciones precisas.
Ultralytics Platform proporciona herramientas de supervisión integrada que permiten a los equipos conocer el rendimiento de los endpoints desplegados. La página Deploy de la plataforma funciona como un panel de supervisión y ofrece una vista centralizada de todos los endpoints en ejecución, junto con métricas clave que ayudan a realizar un seguimiento del estado y el uso del sistema.
Estas son algunas de las métricas que puedes supervisar mediante Platform:
- Latencia P95: esta métrica mide el tiempo de respuesta del servidor correspondiente al percentil 95 de las solicitudes de inferencia. Proporciona información sobre cuánto tardan la mayoría de las solicitudes de inferencia e identifica ralentizaciones del rendimiento.
- Tasa de errores: representa el porcentaje de solicitudes que han fallado o han devuelto errores durante el intervalo de supervisión seleccionado. Supervisar las tasas de error permite a los equipos detectar rápidamente problemas en los despliegues o en las solicitudes entrantes.
- Solicitudes totales: esta métrica muestra el número total de solicitudes de inferencia procesadas en los endpoints desplegados durante el periodo seleccionado (por ejemplo, las últimas 24 horas). Ayuda a los equipos a comprender los niveles de tráfico y la frecuencia con la que se utilizan sus modelos.
Además de estas métricas, la plataforma también proporciona comprobaciones de estado de los endpoints y registros de despliegue. Las comprobaciones de estado indican si un endpoint responde correctamente, mientras que los registros ofrecen información detallada sobre las solicitudes recientes y la actividad del sistema.
Conclusiones clave#
Desplegar modelos de visión artificial es un paso crucial para convertir modelos entrenados en sistemas que impulsen aplicaciones del mundo real. Con Ultralytics Platform, los equipos pueden desplegar fácilmente modelos mediante endpoints dedicados en 43 regiones de todo el mundo, ejecutar inferencias en tiempo real a través de API y supervisar el rendimiento desde un único entorno. Al combinar opciones de despliegue flexibles, supervisión integrada e infraestructura escalable, la plataforma ayuda a los desarrolladores a pasar más rápidamente de modelos de aprendizaje automático entrenados a aplicaciones de visión artificial fiables.
¡Forma parte de nuestra creciente comunidad! Visita nuestro repositorio de GitHub para obtener más información sobre la IA. Si quieres crear soluciones de visión artificial, consulta nuestras opciones de licencia. ¡Descubre las ventajas de la visión artificial en la atención sanitaria y comprueba cómo la IA en la logística está marcando la diferencia!








