Comment améliorer le mAP d’un modèle sur les petits objets : guide rapide
Découvre comment améliorer le mAP d’un modèle sur les petits objets grâce à des conseils pratiques sur la qualité des données, l’augmentation, les stratégies d’entraînement, l’évaluation et le déploiement.
À mesure que l’adoption de l’intelligence artificielle (AI), du machine learning et de la vision par ordinateur progresse, les systèmes de détection d’objets sont utilisés partout, des caméras de circulation intelligentes aux drones et aux outils d’analyse du commerce de détail. Ces systèmes doivent souvent détecter des objets de toutes tailles, qu’il s’agisse d’un gros camion proche de la caméra ou d’un minuscule piéton au loin.
En général, repérer des objets grands et bien visibles est plus simple. En revanche, la détection de petits objets est plus difficile.
Lorsqu’un objet n’occupe qu’une infime partie de l’image, les informations visuelles disponibles sont très limitées. Un piéton éloigné dans un flux vidéo de circulation ou un petit véhicule photographié depuis une vue aérienne peut ne représenter que quelques pixels, mais ces pixels peuvent contenir des informations cruciales.
Les modèles de vision par ordinateur, comme les modèles Ultralytics YOLO, s’appuient sur des motifs visuels pour reconnaître les objets. Lorsque ces motifs sont limités ou peu clairs, les performances diminuent. Le traitement peut faire perdre des détails importants, ce qui rend les prédictions plus sensibles aux erreurs de localisation. Même un léger décalage de la boîte englobante peut transformer une détection correcte en détection manquée.
Cette différence apparaît clairement quand on examine les performances des modèles. La plupart des modèles de détection et de segmentation gèrent bien les objets moyens et grands, mais les petits objets réduisent souvent la précision globale.
Les performances de l’apprentissage profond sont généralement mesurées à l’aide de la précision moyenne, ou mAP. Cette métrique reflète à la fois la précision des détections et l’alignement des boîtes prédites sur les objets réels.
Elle combine la précision, qui indique combien d’objets prédits sont corrects, et le rappel, qui indique combien d’objets réels sont détectés avec succès, à différents niveaux de confiance et seuils d’intersection sur l’union, ou IoU (une métrique qui mesure le chevauchement entre la boîte englobante prédite et la boîte de référence).
Nous avons déjà étudié la détection de petits objets et les raisons pour lesquelles elle représente un problème particulièrement difficile pour les modèles de vision par ordinateur. Dans cet article, nous allons nous appuyer sur ces bases et nous concentrer sur l’amélioration de la mAP en présence de petits objets. C’est parti !
Pourquoi les petits objets sont-ils plus difficiles à détecter ?#
Pour les applications qui utilisent des détecteurs d’objets, la taille d’un petit objet se définit par l’espace qu’il occupe dans l’image, pas nécessairement par la taille qu’il semble avoir à l’œil humain. S’il n’occupe qu’une infime partie de l’image, il contient très peu d’informations visuelles, ce qui complique sa détection précise par un algorithme de vision par ordinateur.
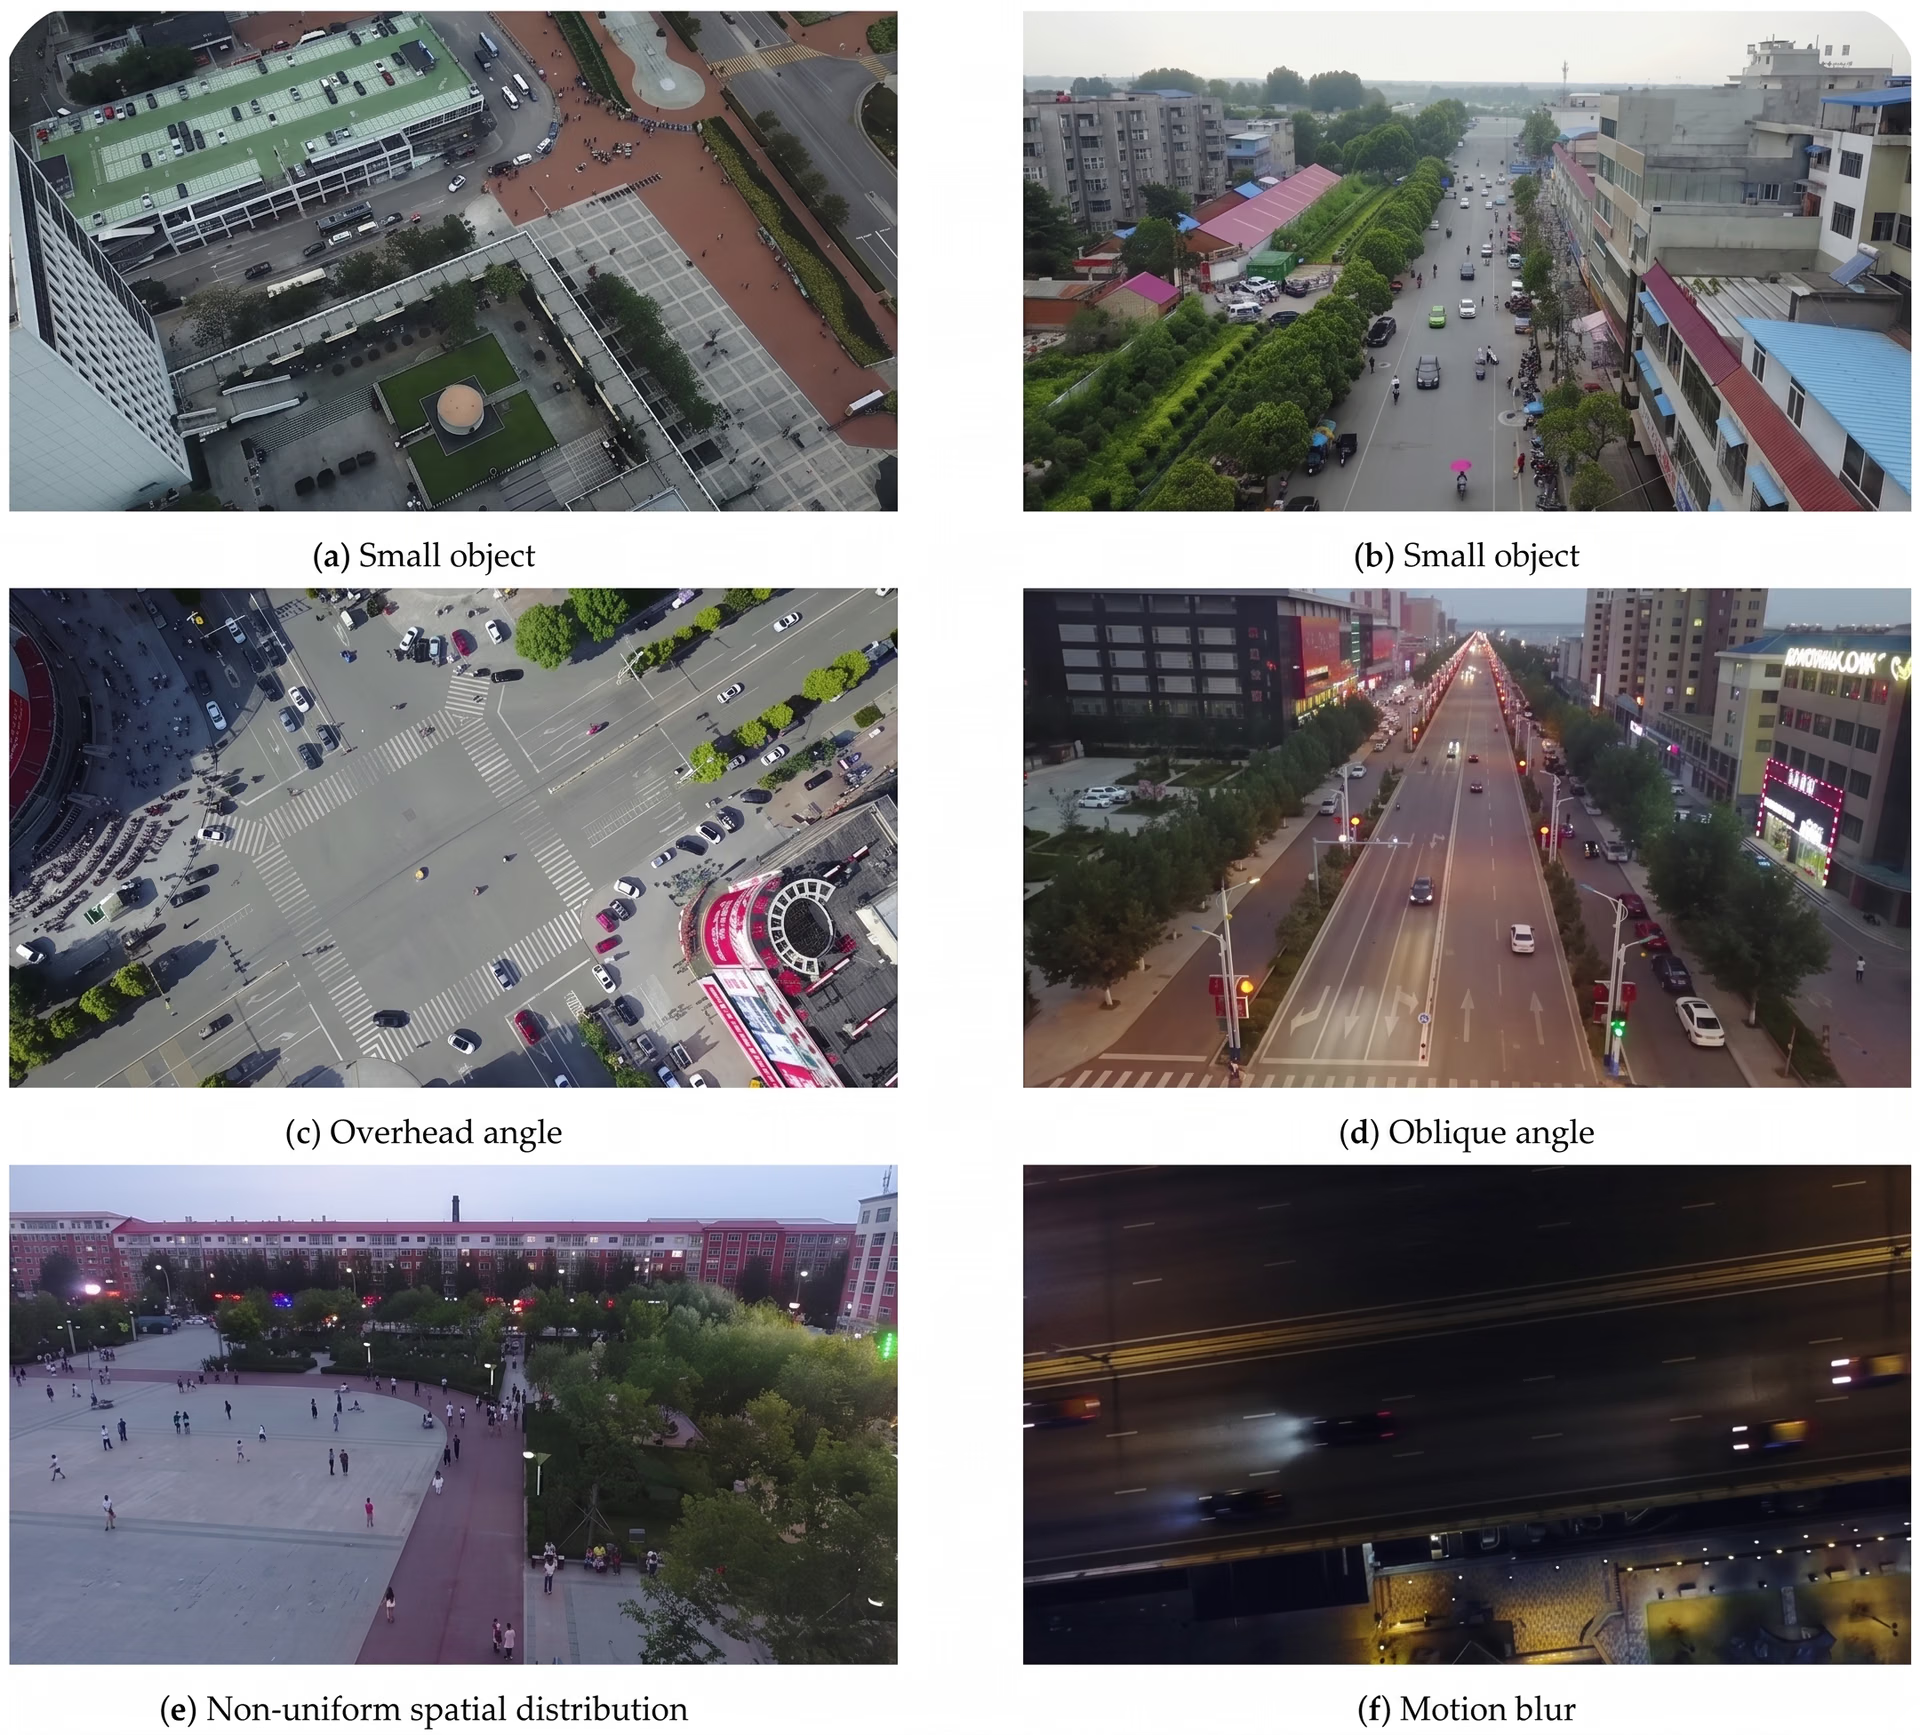
Fig. 1. Exemples d’images montrant de petits objets occupant une zone limitée en pixels (Source)
Avec moins de pixels à leur disposition, des détails importants comme les contours, les formes et les textures peuvent être flous ou facilement perdus. Lorsque le modèle traite l’image, il la redimensionne et la simplifie pour mettre en évidence les motifs utiles.
Cela aide le modèle à comprendre la scène dans son ensemble, mais peut aussi réduire davantage les détails fins. Pour les petits objets, ces détails sont souvent essentiels à une détection correcte.
Ces difficultés sont encore plus évidentes lorsqu’on examine les métriques d’évaluation. Les petits objets sont particulièrement sensibles aux erreurs de localisation. Même une boîte englobante légèrement mal alignée peut passer sous le seuil d’intersection sur l’union, ou IoU, requis.
Dans ce cas, une prédiction qui semble raisonnable peut être considérée comme incorrecte. Cela réduit à la fois la précision et le rappel, et donc la précision moyenne, ou mAP.
Comme ces facteurs sont étroitement liés, améliorer les performances nécessite souvent de réfléchir au système dans son ensemble. Il faut donc équilibrer soigneusement la résolution de l’image, l’extraction des caractéristiques, la conception du modèle et les paramètres d’évaluation afin de mieux préserver et interpréter les petits détails visuels.
L’importance de la qualité des jeux de données et des annotations#
Pour la détection de petits objets, la qualité d’un jeu de données est souvent le facteur qui influe le plus sur les performances. Les petits objets n’occupent qu’une infime partie de l’image, ce qui laisse très peu d’informations visuelles au modèle pour apprendre. Les données d’entraînement sont donc particulièrement importantes. Si le jeu de données ne contient pas suffisamment d’exemples clairs et représentatifs, le modèle de détection d’objets aura du mal à reconnaître des motifs cohérents.
Les jeux de données adaptés à la détection de petits objets contiennent généralement des images haute résolution, de nombreuses occurrences de petites cibles et des conditions visuelles cohérentes. Les jeux de données génériques comme le jeu de données COCO constituent un bon point de départ, mais ils ne correspondent souvent pas à l’échelle, à la densité ou au contexte de cas d’usage précis dans le monde réel. Dans ce cas, il devient nécessaire de collecter des données d’entraînement propres au domaine pour améliorer les performances du modèle.
La qualité des annotations joue aussi un rôle essentiel. Les annotations établissent la vérité terrain en indiquant les étiquettes correctes des objets et l’emplacement de leurs boîtes englobantes, que le modèle apprend à prédire.
Pour les petits objets, les boîtes englobantes doivent être tracées avec soin et de façon cohérente. Même de légères différences dans leur placement peuvent affecter sensiblement la précision de la localisation, car les petits objets sont très sensibles aux décalages au niveau du pixel.
Des annotations de mauvaise qualité ou incohérentes peuvent réduire considérablement la mAP. Si les objets sont mal étiquetés, le modèle apprend des motifs incorrects, ce qui peut augmenter le nombre de faux positifs.
Si des objets apparaissent dans l’image, mais sont absents de la vérité terrain, les détections correctes peuvent être comptées comme des faux positifs lors de l’évaluation. Ces deux situations réduisent les performances globales.
Il est intéressant de noter que des recherches récentes indiquent que la précision moyenne pour les petits objets reste souvent comprise entre 20 % et 40 % sur les benchmarks standards, soit un niveau nettement inférieur à celui obtenu pour les objets plus grands. Cet écart souligne l’importance de la conception des jeux de données et de la cohérence des annotations pour la précision globale de la détection.
L’augmentation des données peut jouer un rôle clé dans l’amélioration de la précision#
Maintenant que nous comprenons l’importance de la qualité des jeux de données et de la cohérence des annotations, voyons comment un modèle de détection d’objets peut apprendre plus efficacement à partir des données existantes. Même s’il est difficile ou coûteux de collecter des images supplémentaires, il existe des moyens d’améliorer les performances en exploitant mieux les données déjà disponibles.
L’une des approches les plus pratiques est l’augmentation des données. Elle joue un rôle particulièrement important dans la détection de petits objets, car ceux-ci fournissent moins d’indices visuels au modèle pour apprendre. En introduisant des variations contrôlées pendant l’entraînement, l’augmentation aide le modèle à mieux généraliser sans nécessiter de nouvelles collectes de données.
Une augmentation des données efficace vise à garder les petits objets bien visibles. Des techniques comme le redimensionnement contrôlé, le recadrage léger et le mosaïquage d’images peuvent mieux faire ressortir les petits objets tout en préservant leur forme et leur apparence. L’objectif est d’aider le modèle à voir plus souvent les petits objets dans des conditions légèrement différentes, sans modifier leur apparence dans des situations réelles.
Cependant, l’augmentation doit être appliquée avec soin. Certaines transformations peuvent réduire la visibilité des petits objets ou modifier leur apparence d’une façon peu probable dans des données réelles. Le modèle peut alors avoir du mal à apprendre des contours d’objets précis.
Une augmentation des données plus intelligente grâce à l’IA générative#
Une autre forme intéressante d’augmentation des données, de plus en plus populaire, consiste à utiliser l’IA générative pour créer des données d’entraînement synthétiques. Plutôt que de s’appuyer sur des images collectées et annotées manuellement, les équipes peuvent désormais générer des scènes réalistes simulant des environnements, des tailles d’objets, des conditions d’éclairage et des variations d’arrière-plan spécifiques.
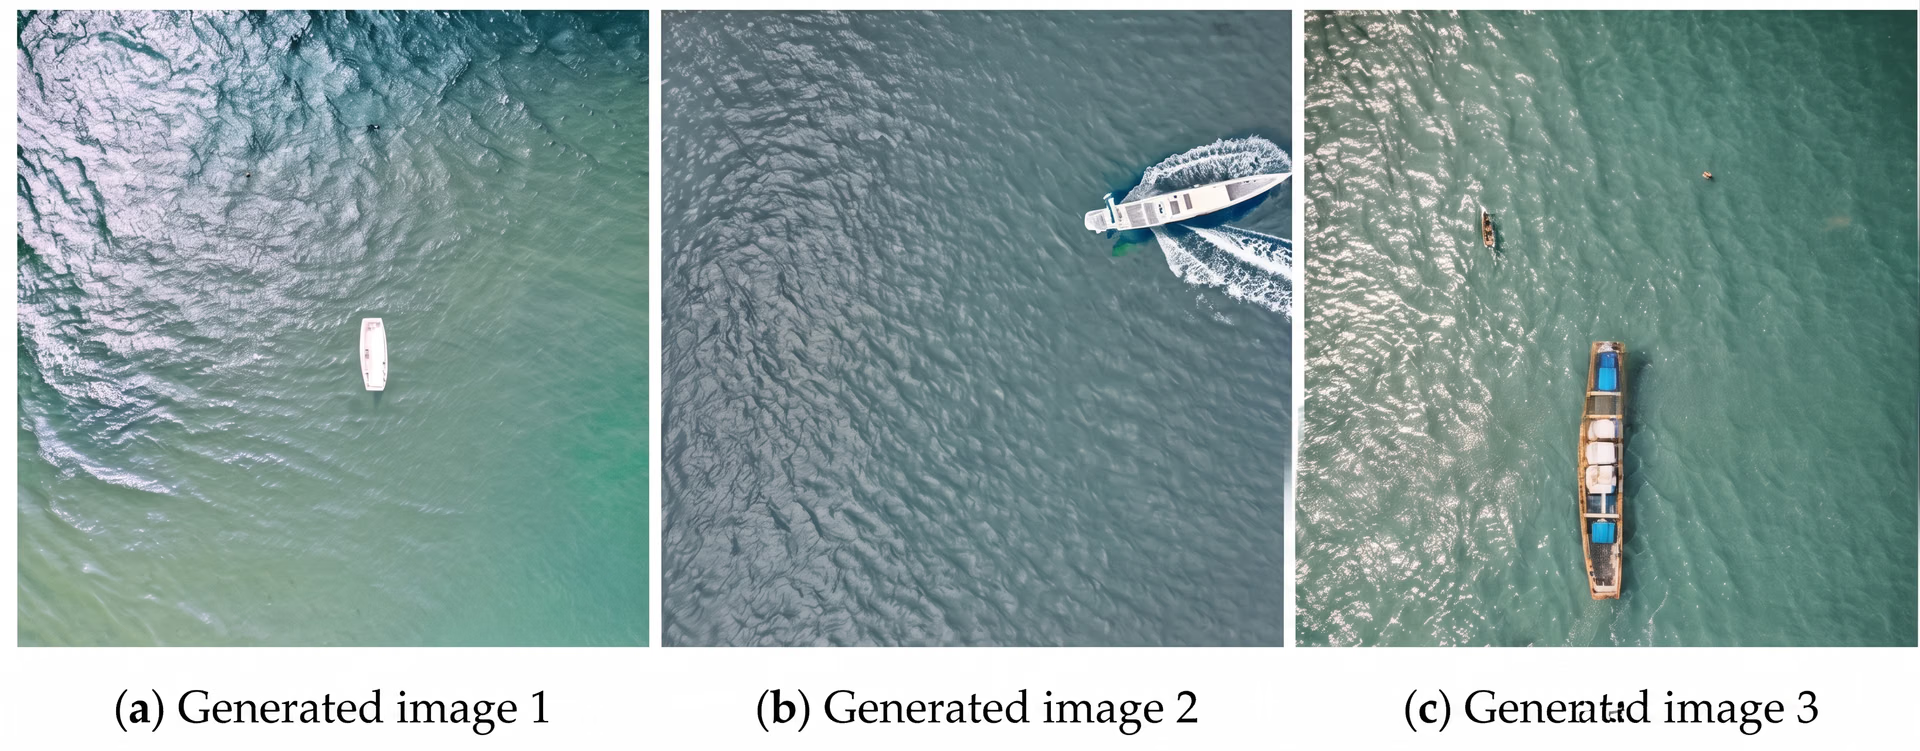
Fig. 2. Exemples d’images aériennes synthétiques utilisées pour l’augmentation des données (Source)
Cette approche est particulièrement utile pour la détection de petits objets, car il peut être difficile de capturer des exemples réels de manière cohérente. En contrôlant l’apparence des petits objets dans les images synthétiques, par exemple en ajustant leur échelle, leur densité et leur emplacement, on peut exposer les modèles à un éventail plus large de scénarios d’entraînement.
Associée avec soin à des données réelles, l’augmentation synthétique peut améliorer la robustesse du modèle, réduire les coûts de collecte des données et favoriser des améliorations ciblées des performances.
Choix d’entraînement du modèle susceptibles d’influer sur la mAP des petits objets#
Outre la qualité des jeux de données et la cohérence des annotations, les choix d’entraînement du modèle influent fortement sur les performances de détection des petits objets.
Voici quelques stratégies d’entraînement clés à prendre en compte :
- Commence par des modèles préentraînés : un modèle préentraîné, comme Ultralytics YOLO26, a déjà appris des motifs visuels généraux à partir de grands jeux de données d’images. C’est un meilleur point de départ qu’un entraînement depuis zéro, ce qui est particulièrement utile pour détecter de petits objets avec peu de données.
- Utilise le transfert d’apprentissage de manière stratégique : le transfert d’apprentissage consiste à adapter un modèle préentraîné à ton jeu de données spécifique. Il aide le modèle à se concentrer sur tes petits objets tout en réduisant le surapprentissage (le fait de mémoriser les données d’entraînement au lieu d’apprendre des motifs généraux).
- Gère le déséquilibre des classes : si les petits objets apparaissent moins souvent que les grands, le modèle risque de privilégier l’apprentissage des grands objets. Des techniques comme la pondération des classes ou les stratégies d’échantillonnage aident à ne pas négliger les petits objets.
- Ajuste les seuils de confiance et d’IoU : les petits objets sont sensibles aux faibles erreurs de localisation. Le réglage fin de ces seuils permet de mieux évaluer et interpréter les performances sur les petits objets pendant la validation et l’inférence.
Considérations sur l’architecture du modèle pour la détection de petits objets#
Tu peux utiliser un modèle général de détection d’objets pour les tâches impliquant de petits objets, mais certaines architectures sont conçues spécifiquement pour améliorer leur détection. Par exemple, il existe des variantes P2 du modèle Ultralytics YOLOv8, optimisées pour préserver les détails spatiaux fins.
Ultralytics YOLOv8 traite les images à plusieurs échelles en les réduisant progressivement à mesure qu’elles avancent dans le réseau. Cela aide le modèle à comprendre la scène dans son ensemble, mais réduit aussi les détails fins.
Lorsqu’un objet est déjà très petit, des informations visuelles importantes peuvent disparaître pendant ce processus. La variante P2 d’Ultralytics YOLOv8 remédie à ce problème en utilisant un stride de 2 dans sa pyramide de caractéristiques.
Une pyramide de caractéristiques est la partie du modèle qui analyse l’image à plusieurs résolutions internes afin de détecter des objets de différentes tailles. Avec un stride de 2, l’image est réduite plus progressivement à cette étape, ce qui permet de préserver davantage de détails d’origine au niveau du pixel.
La préservation de davantage de détails spatiaux permet aux petits objets de conserver une structure plus visible dans le réseau. Le modèle peut ainsi localiser et détecter plus facilement les objets qui n’occupent que quelques pixels, ce qui peut améliorer la mAP des petits objets.
Évaluation en fonction de la taille pour la détection de petits objets#
La précision moyenne résume les performances globales du modèle, mais ne montre pas toujours dans quelle mesure il gère les objets de différentes tailles. Pour les petits objets, les performances sont souvent limitées par la précision de la localisation plutôt que par la classification seule, ce qui signifie que de légers décalages des boîtes englobantes peuvent avoir une incidence importante sur les résultats.
Autrement dit, le modèle peut identifier correctement la classe de l’objet, mais si la boîte englobante prédite est légèrement mal alignée, la détection peut tout de même être considérée comme incorrecte. Comme les petits objets ne couvrent qu’un petit nombre de pixels, même un léger décalage de la boîte peut réduire considérablement son chevauchement avec la vérité terrain. Les scores d’évaluation peuvent donc baisser même si l’objet a été correctement identifié.
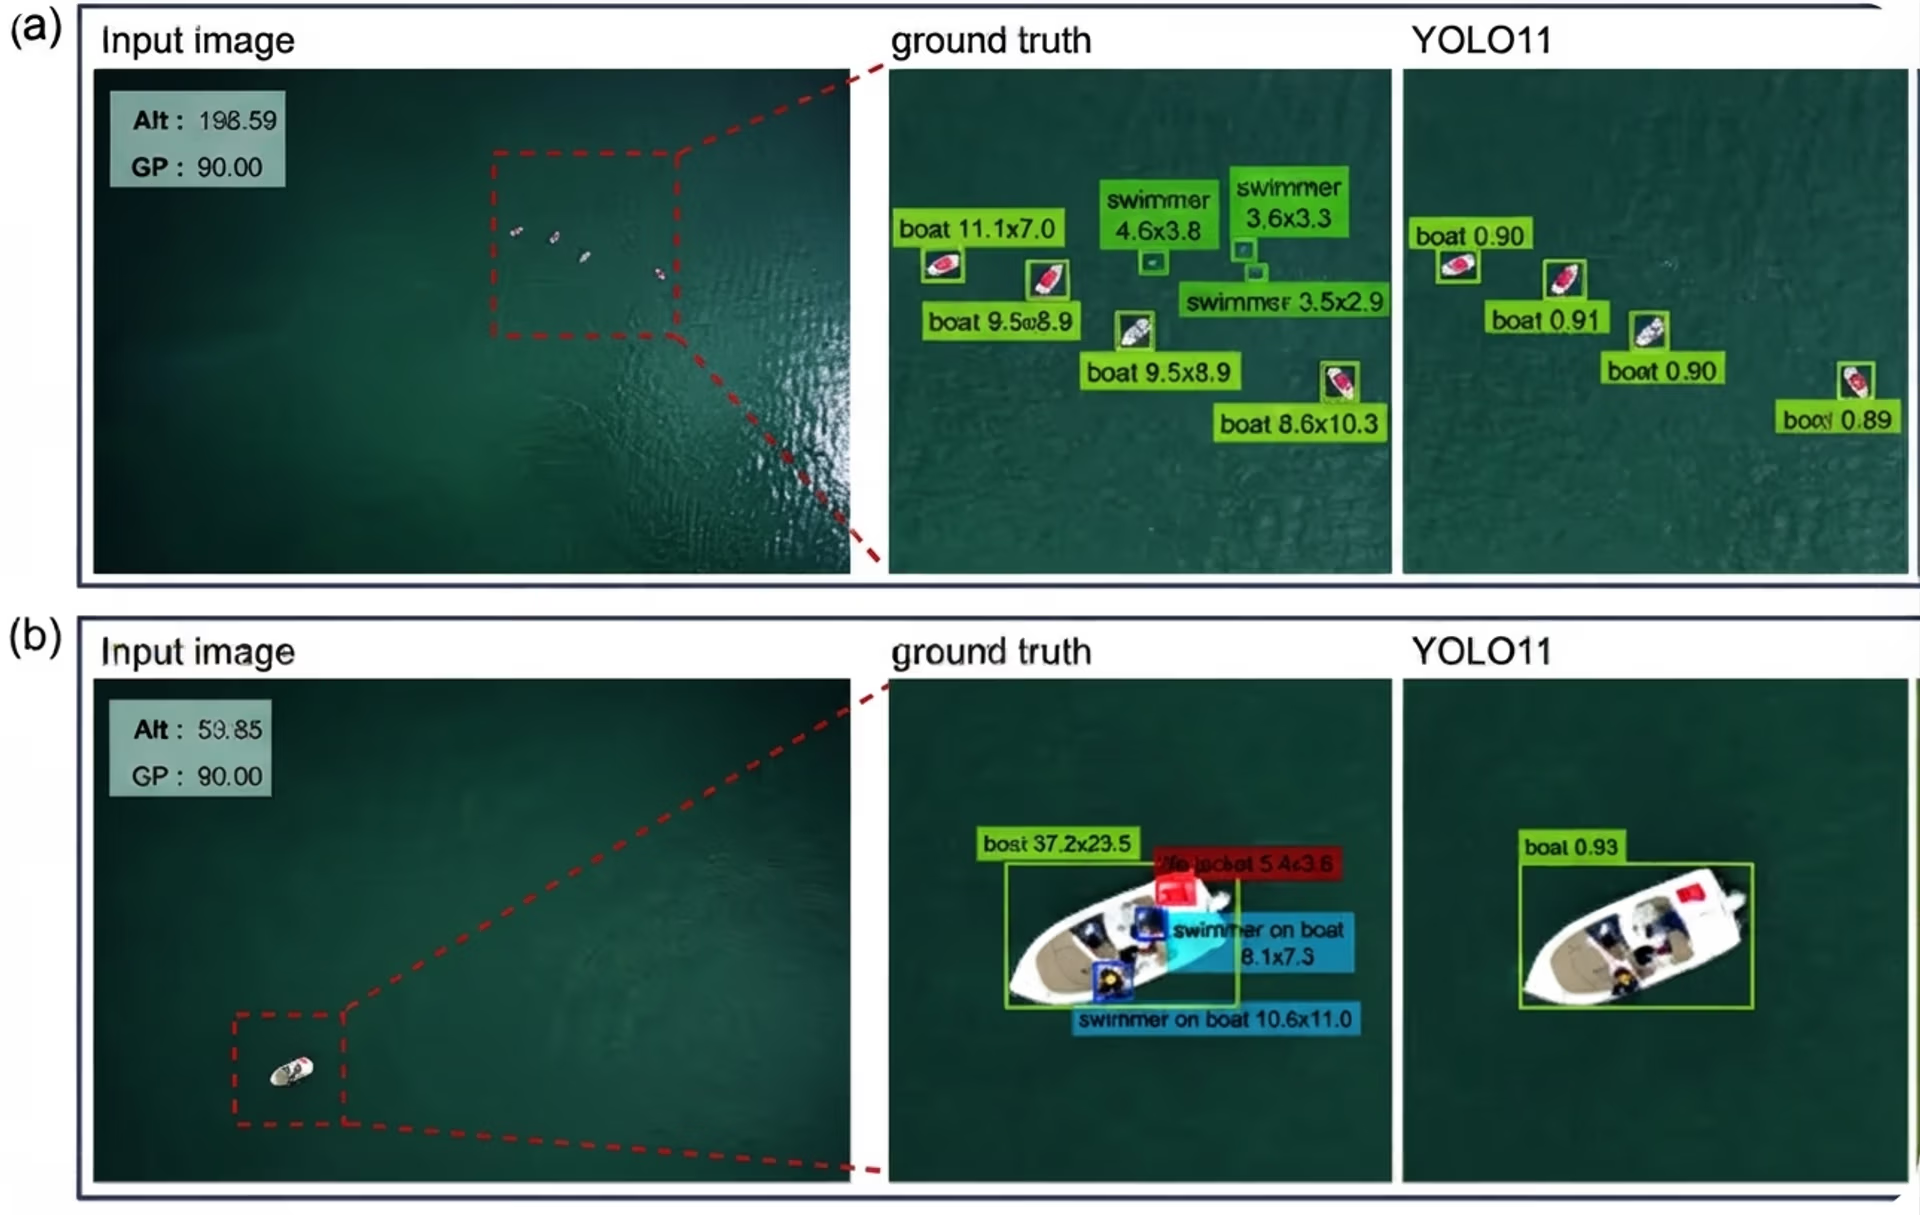
Fig. 3. L’évaluation de la détection de petits objets peut être délicate (Source)
Une approche plus informative consiste à évaluer les performances en fonction de la taille des objets. La plupart des benchmarks couramment utilisés indiquent séparément la précision moyenne pour les petits, moyens et grands objets.
Cette ventilation par taille permet de mieux voir où le modèle est performant et où il rencontre des difficultés. En pratique, l’AP des petits objets est souvent inférieure à la mAP globale, ce qui met en évidence des difficultés de localisation qui peuvent passer inaperçues dans les métriques agrégées.
Prends en compte les contraintes de déploiement et les compromis dans le monde réel#
Les performances du modèle changent souvent lorsqu’on passe d’environnements de test contrôlés à un déploiement dans le monde réel. Des facteurs comme la résolution des images, la vitesse de traitement et le matériel disponible impliquent des compromis qui influent directement sur la détection de petits objets.
Par exemple, augmenter la résolution d’entrée peut améliorer la mAP des petits objets, car les petites cibles occupent alors davantage de pixels et conservent plus de détails. Cependant, une résolution plus élevée augmente aussi l’utilisation de la mémoire et le temps de traitement. Cela peut ralentir l’inférence et accroître les coûts opérationnels.
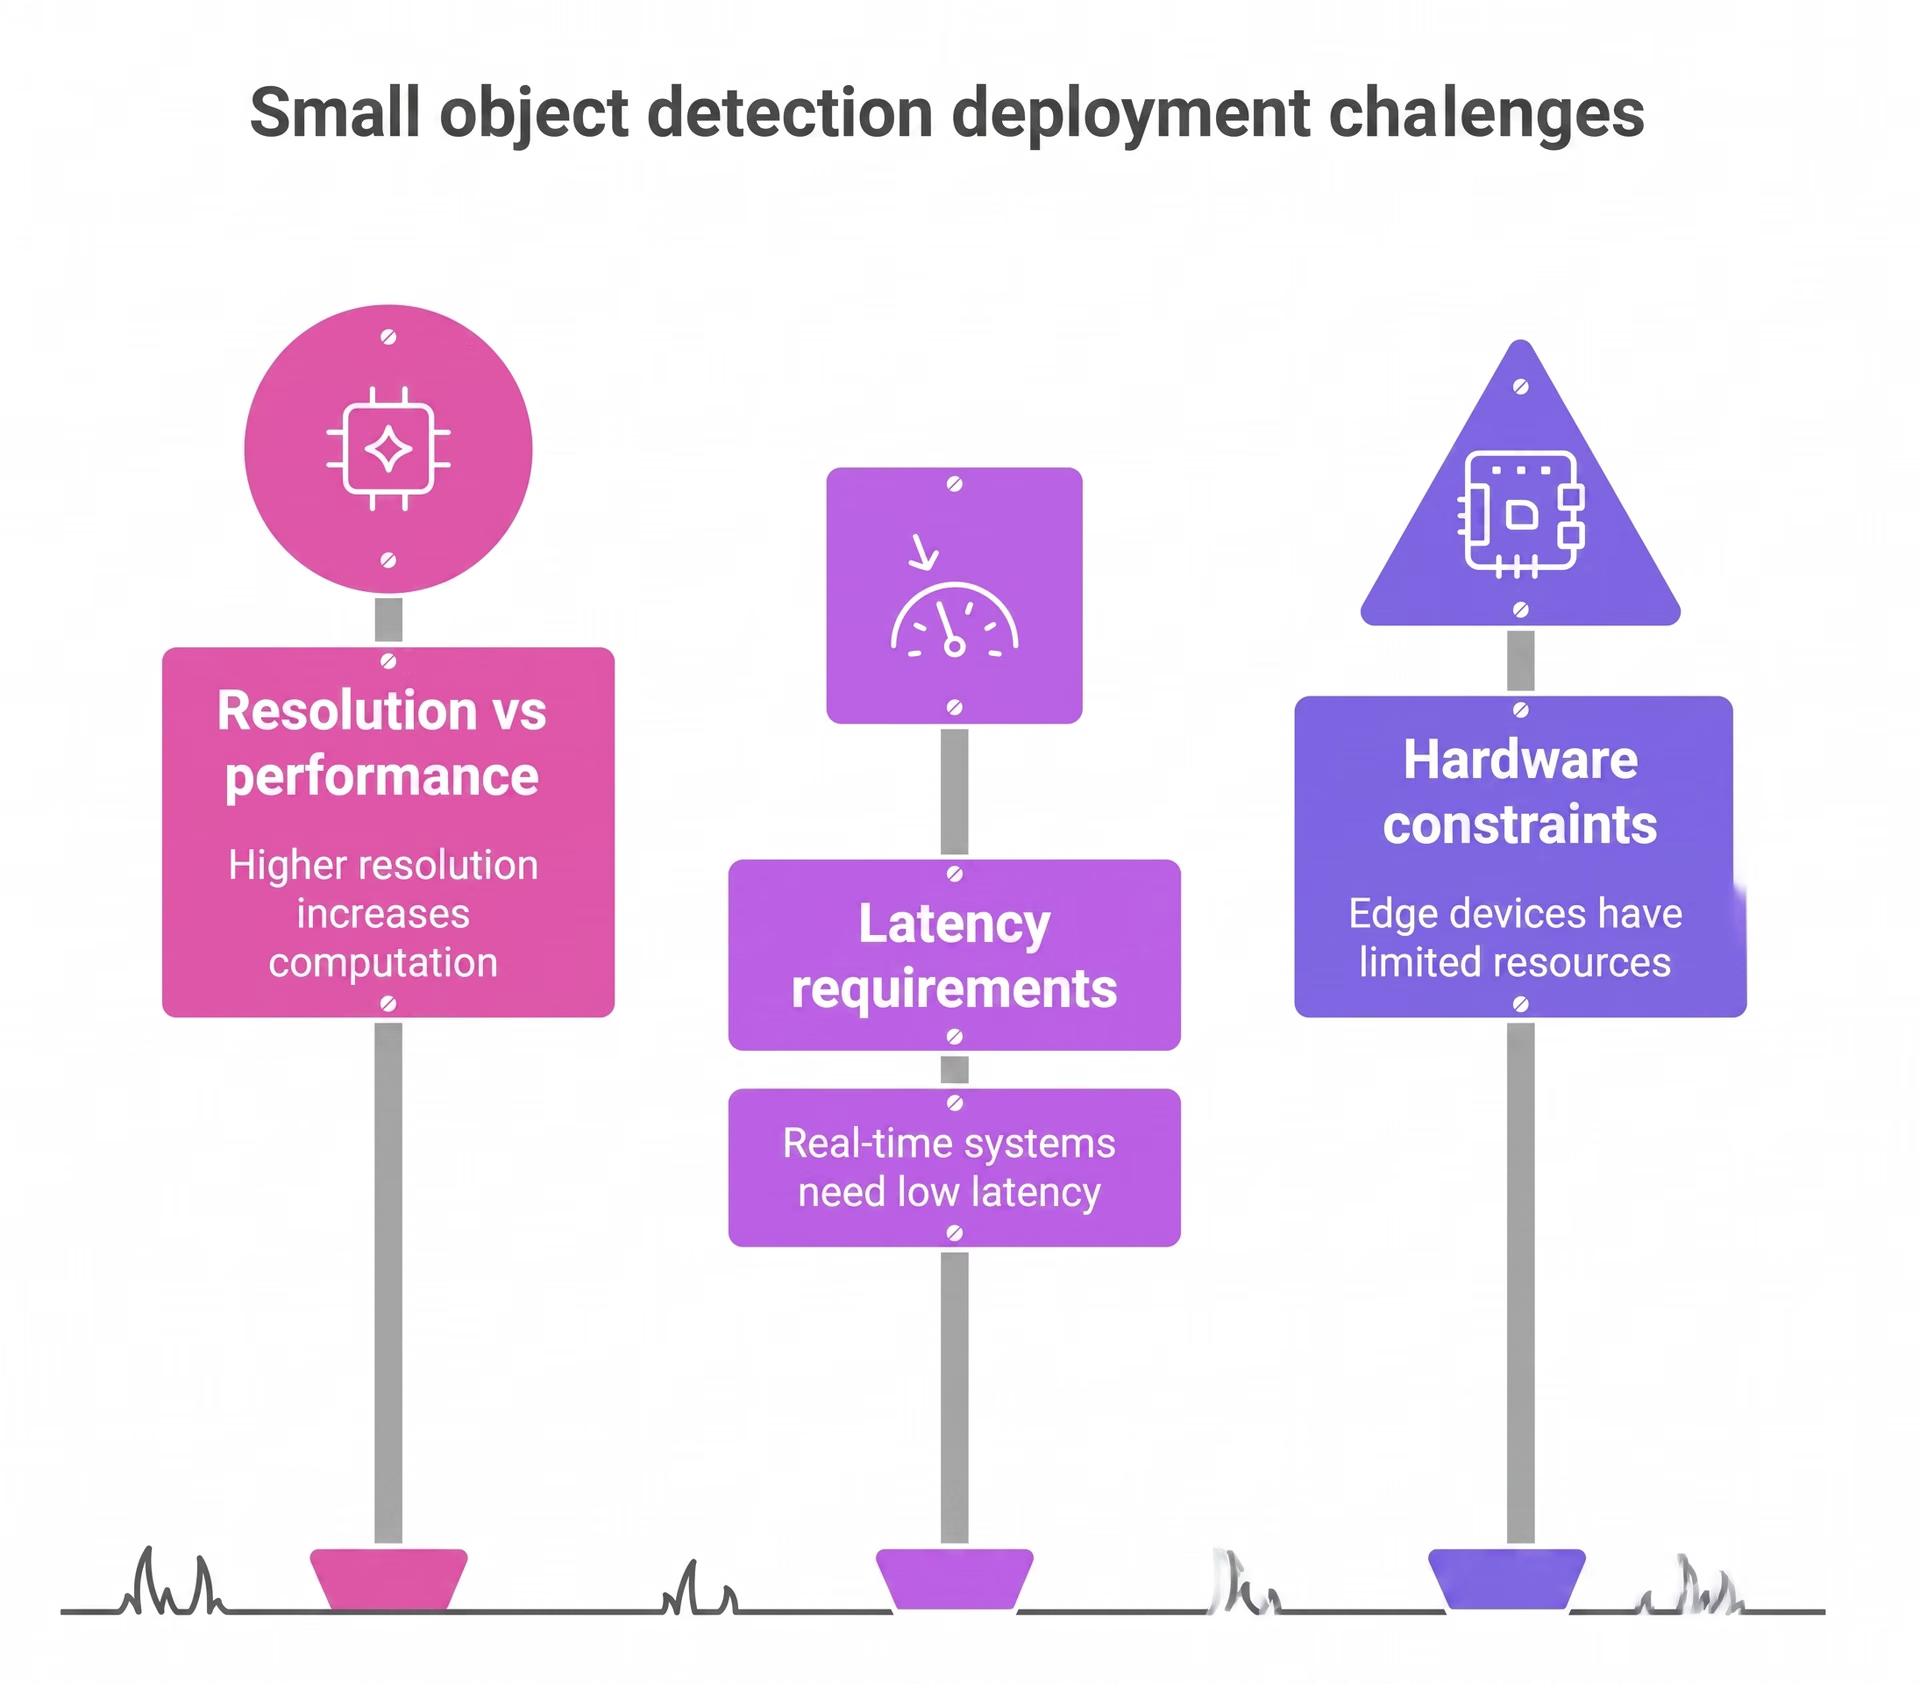
Fig. 4. Défis liés au déploiement de la détection de petits objets. Image de l’auteur.
Le choix du matériel joue un rôle clé dans la gestion de ces compromis. Des GPU plus puissants permettent d’utiliser des modèles plus grands et d’accélérer le traitement, mais les environnements de déploiement, en particulier les appareils en périphérie, disposent souvent de ressources de calcul et de mémoire limitées.
Les applications en temps réel ajoutent une autre contrainte : maintenir une faible latence peut nécessiter de réduire la taille du modèle ou la résolution d’entrée, ce qui peut nuire au rappel des petits objets. En définitive, les décisions de déploiement nécessitent de trouver un équilibre entre les performances de détection, les limites matérielles, les exigences de vitesse et le coût global.
Pour tout rassembler : améliorer la mAP du modèle sur les petits objets#
L’amélioration de la détection de petits objets nécessite une approche pratique et structurée, en particulier dans des environnements réels. Voici un aperçu des principales étapes à garder à l’esprit :
- Audite la qualité de ton jeu de données : vérifie qu’il contient suffisamment d’exemples de petits objets, qu’il utilise si possible des images haute résolution et qu’il reflète les conditions de déploiement du modèle.
- Vérifie la cohérence des annotations : assure-toi que les boîtes englobantes sont précises, complètes et étiquetées de façon cohérente. Des annotations incohérentes peuvent directement limiter les performances de localisation.
- Ajuste soigneusement les paramètres d’entraînement : règle judicieusement la taille de lot, le nombre d’époques et les paramètres d’optimisation afin que les petits objets soient correctement représentés pendant l’entraînement.
- Procède étape par étape : effectue des ajustements contrôlés, mesure leur impact et affine ton approche. Une démarche progressive fondée sur les données entraîne des améliorations cohérentes au fil du temps.
Points clés à retenir#
Améliorer la mAP des petits objets demande une approche structurée, fondée sur les données, plutôt que des ajustements au hasard. De réels progrès reposent sur la combinaison de données de qualité, d’annotations cohérentes, d’un entraînement soigneux et de méthodes d’évaluation adaptées. Dans les projets du monde réel, des tests réguliers et de petits changements mesurables permettent d’améliorer progressivement la détection des petits objets et de la rendre plus fiable.
Rejoins notre communauté en pleine croissance et consulte notre dépôt GitHub pour accéder à des ressources pratiques sur l’IA. Pour créer dès aujourd’hui avec l’IA visuelle, découvre nos options de licence. Découvre comment l’IA dans l’agriculture transforme les pratiques agricoles et comment l’IA visuelle en robotique façonne l’avenir en consultant nos pages de solutions.








