Qu’est-ce que Mask R-CNN et comment fonctionne-t-il ?
Découvre le fonctionnement de Mask R-CNN, de son réseau dorsal et de son réseau de proposition de régions à ROI Align et à la prédiction des masques, ainsi que ses usages, ses limites et ses successeurs YOLO.
 Abirami Vina10 min de lecture
Avec l’adoption croissante de l’IA, les innovations se généralisent : robots dans les entrepôts, voitures autonomes circulant en toute sécurité dans les rues animées, drones surveillant les cultures et systèmes d’IA inspectant les produits en usine. Une technologie clé au cœur de ces innovations est la vision par ordinateur, une branche de l’IA qui permet aux machines de comprendre et d’interpréter les données visuelles.
Par exemple, la détection d’objets est une tâche de vision par ordinateur qui aide à identifier et à localiser des objets dans des images à l’aide de cadres de délimitation. Ces cadres fournissent des informations utiles, mais ne donnent qu’une estimation approximative de la position d’un objet et ne peuvent pas en représenter la forme exacte ni les contours. Ils sont donc moins efficaces dans les applications qui nécessitent une identification précise.
Pour résoudre ce problème, des chercheurs ont développé des modèles de segmentation qui capturent les contours exacts des objets et fournissent des détails au niveau du pixel pour améliorer la précision de la détection et de l’analyse.
Mask R-CNN est l’un de ces modèles. Présenté en 2017 par la Recherche en IA de Facebook (FAIR), il s’appuie sur des modèles antérieurs comme R-CNN, Fast R-CNN et Faster R-CNN. Étape importante dans l’histoire de la vision par ordinateur, Mask R-CNN a ouvert la voie à des modèles plus avancés, comme Ultralytics YOLO11.
Dans cet article, nous allons découvrir ce qu’est Mask R-CNN, son fonctionnement, ses applications et les améliorations qui lui ont succédé jusqu’à Ultralytics YOLO11.
Présentation de Mask R-CNN#
Mask R-CNN, abréviation de réseau neuronal convolutif basé sur des régions et doté de masques, est un modèle d’apprentissage profond conçu pour des tâches de vision par ordinateur comme la détection d’objets et la segmentation d’instance.
La segmentation d’instance va au-delà de la détection d’objets traditionnelle : elle identifie les objets dans une image et délimite précisément chacun d’eux. Elle attribue une étiquette unique à chaque objet détecté et en capture la forme exacte au niveau du pixel. Cette approche détaillée permet de distinguer clairement les objets qui se chevauchent et de traiter avec précision les formes complexes.
Mask R-CNN s’appuie sur Faster R-CNN, qui détecte et étiquette les objets sans en définir les formes exactes. Mask R-CNN améliore cette approche en identifiant les pixels qui composent chaque objet, ce qui permet une analyse d’images beaucoup plus détaillée et précise.
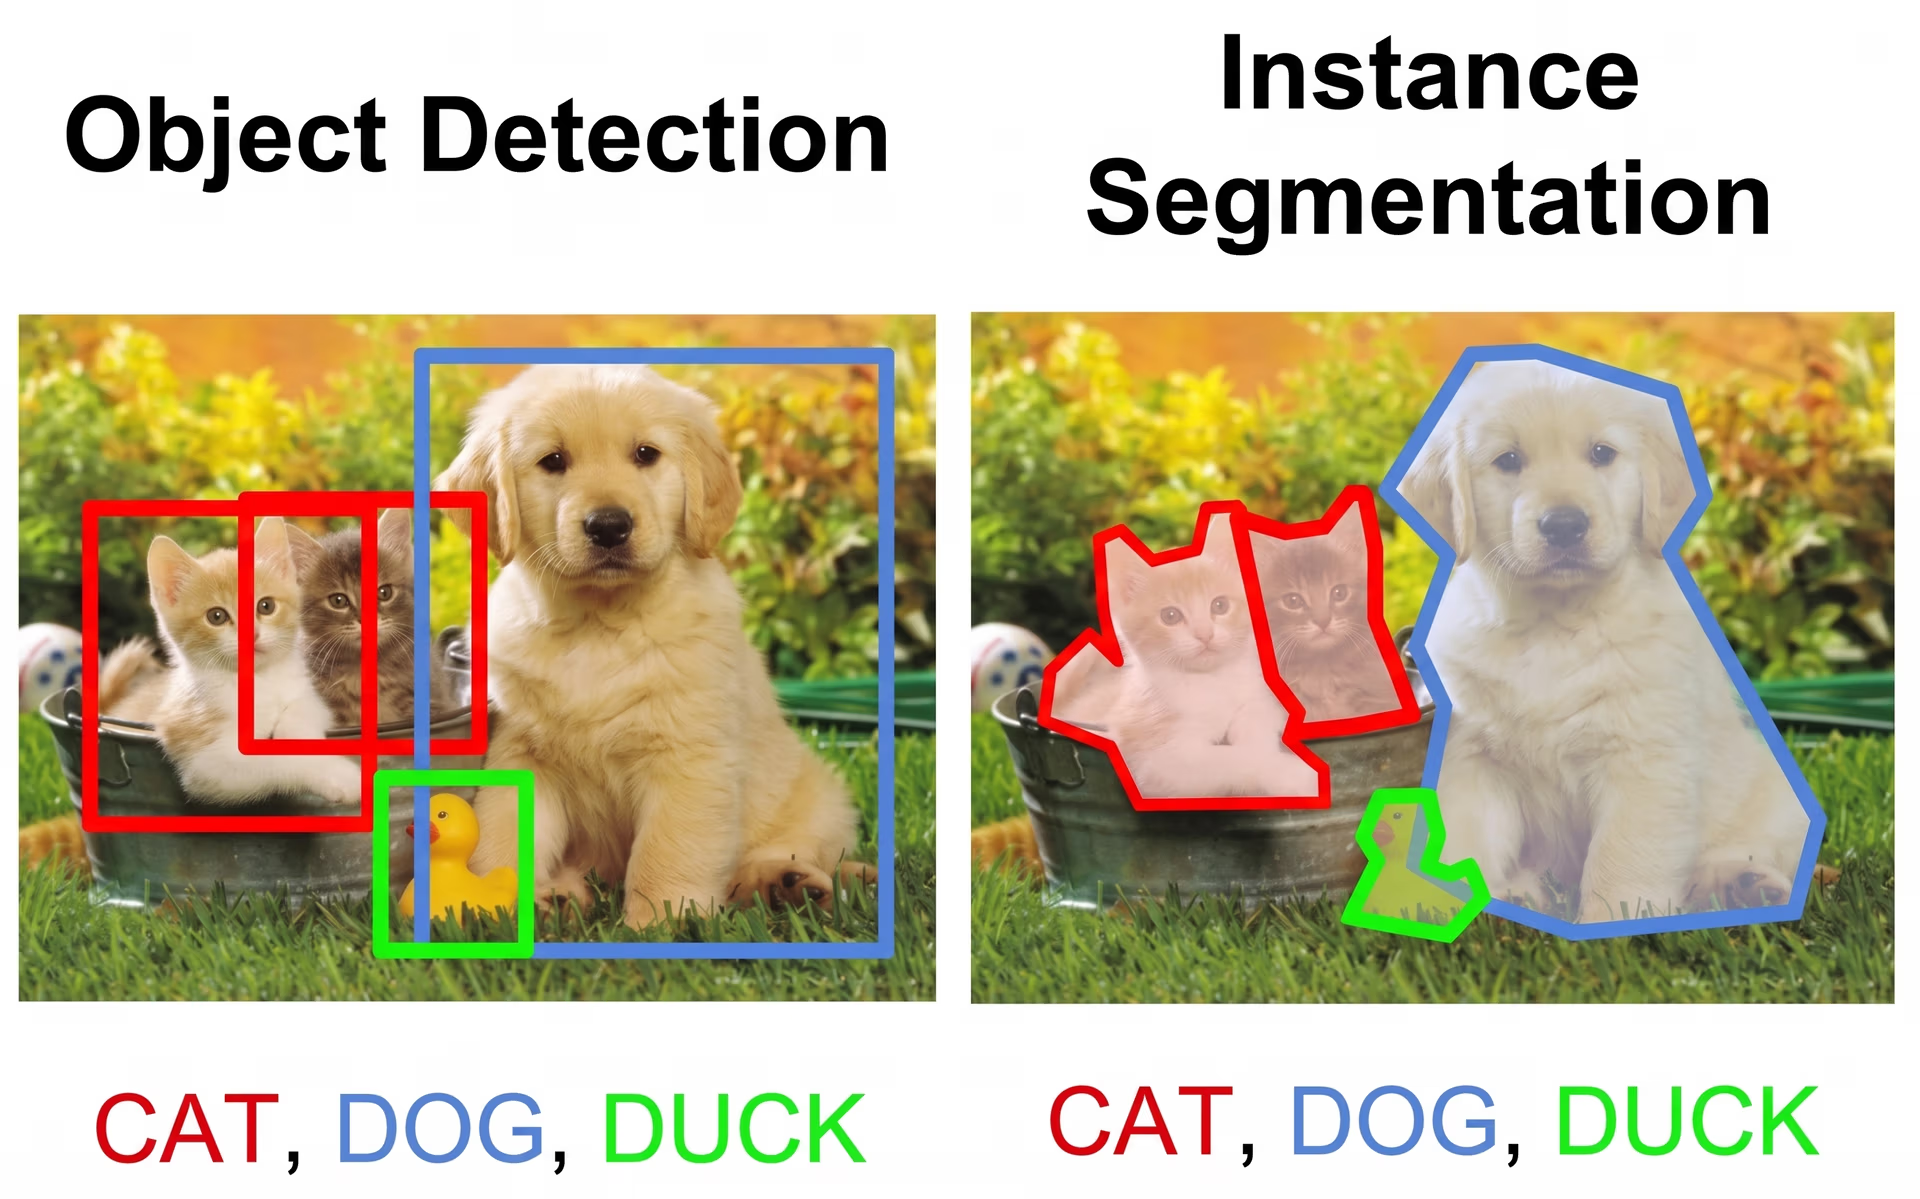
Fig. 1. Comparaison de la détection d’objets et de la segmentation d’instance.
Architecture de Mask R-CNN et fonctionnement#
Mask R-CNN suit une approche étape par étape pour détecter et segmenter les objets avec précision. Il commence par extraire les caractéristiques importantes à l’aide d’un réseau neuronal profond (un modèle à plusieurs couches qui apprend à partir des données), puis identifie les zones susceptibles de contenir des objets grâce à un réseau de proposition de régions (un composant qui propose les régions où des objets pourraient se trouver), et affine enfin ces zones en créant des masques de segmentation détaillés (des contours précis des objets) qui représentent la forme exacte de chaque objet.
Passons en revue chaque étape pour mieux comprendre le fonctionnement de Mask R-CNN.
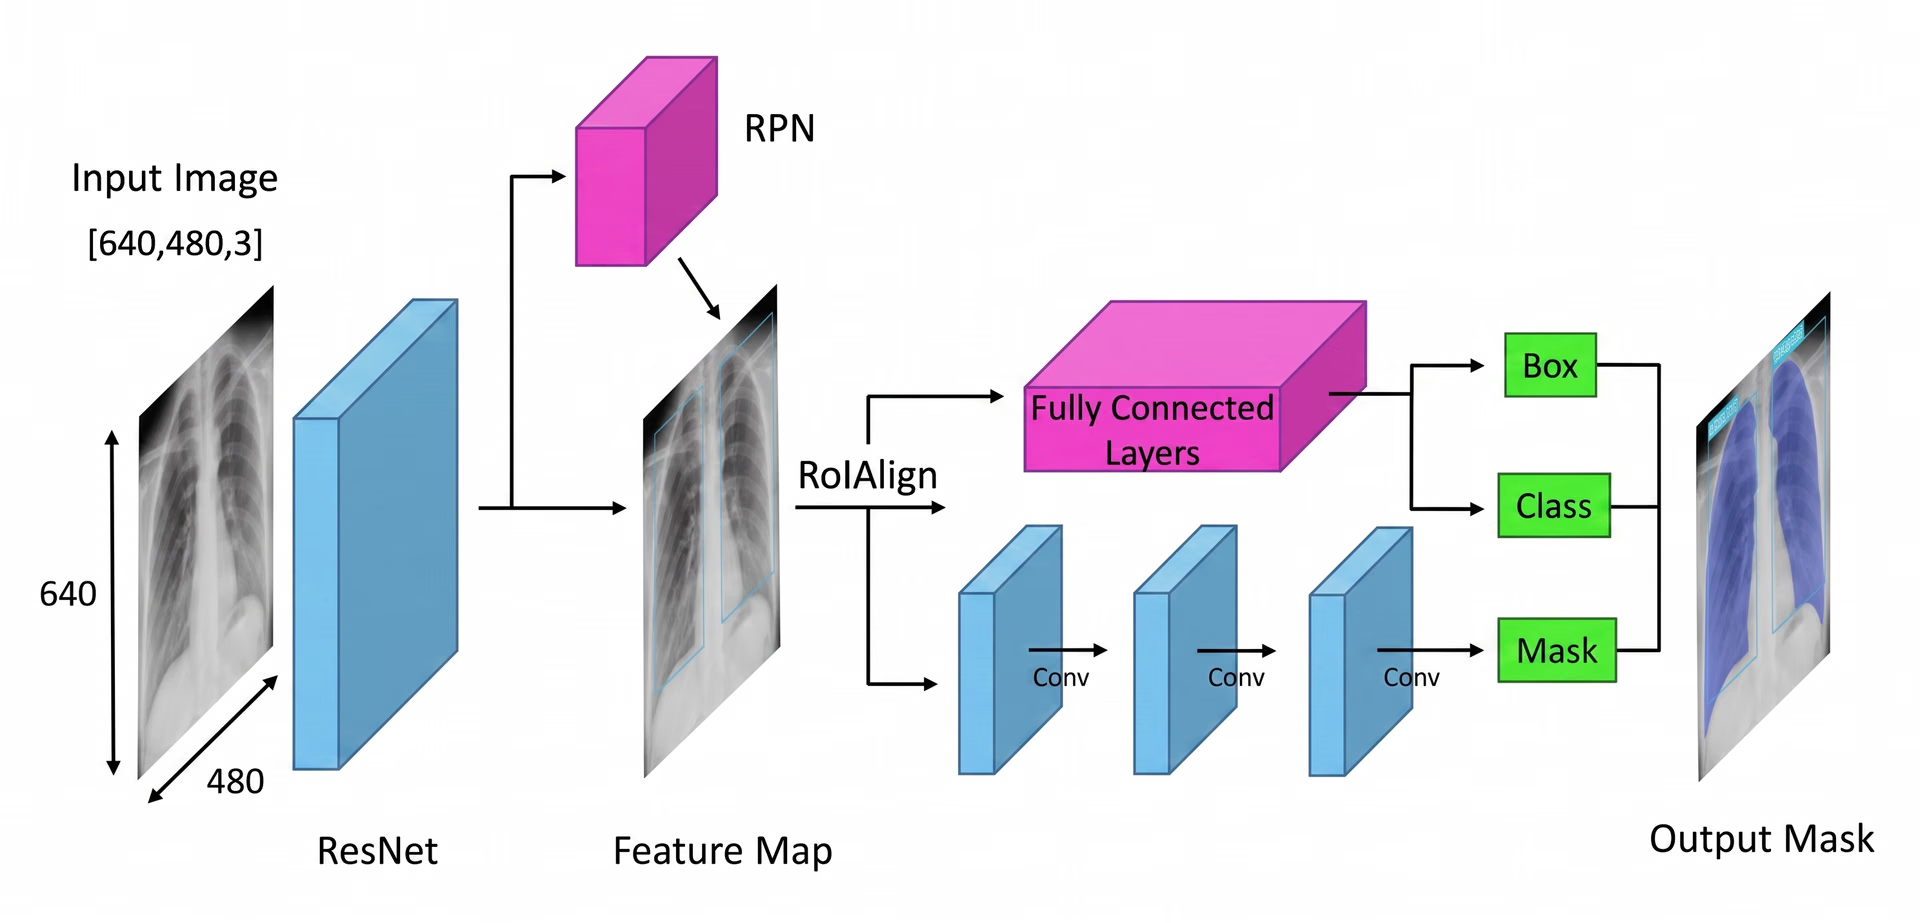
Fig. 2. Présentation de l’architecture de Mask R-CNN (source : researchgate.net).
Commencer par l’extraction des caractéristiques#
La première étape de l’architecture de Mask R-CNN consiste à décomposer l’image en ses éléments clés afin que le modèle puisse comprendre ce qu’elle contient. Imagine que tu regardes une photo et que tu remarques naturellement des détails comme les formes, les couleurs et les contours. Le modèle fait quelque chose de similaire à l’aide d’un réseau neuronal profond appelé « backbone » (souvent ResNet-50 ou ResNet-101), qui lui sert d’yeux pour parcourir l’image et en repérer les détails importants.
Comme les objets dans les images peuvent être très petits ou très grands, Mask R-CNN utilise un réseau pyramidal de caractéristiques. C’est comme si le modèle disposait de loupes de différentes tailles pour voir à la fois les détails fins et l’ensemble de la scène, afin de repérer les objets de toutes tailles.
Une fois ces caractéristiques importantes extraites, le modèle passe à la localisation des objets potentiels dans l’image, première étape d’une analyse plus approfondie.
Proposer les zones de l’image susceptibles de contenir des objets#
Une fois l’image traitée pour en extraire les caractéristiques importantes, le réseau de proposition de régions prend le relais. Cette partie du modèle examine l’image et propose les zones susceptibles de contenir des objets.
Pour cela, le réseau génère plusieurs emplacements possibles pour les objets, appelés ancres. Il évalue ensuite ces ancres et sélectionne les plus prometteuses pour une analyse plus approfondie. Le modèle se concentre ainsi sur les zones les plus susceptibles de présenter un intérêt, au lieu d’examiner chaque pixel de l’image.
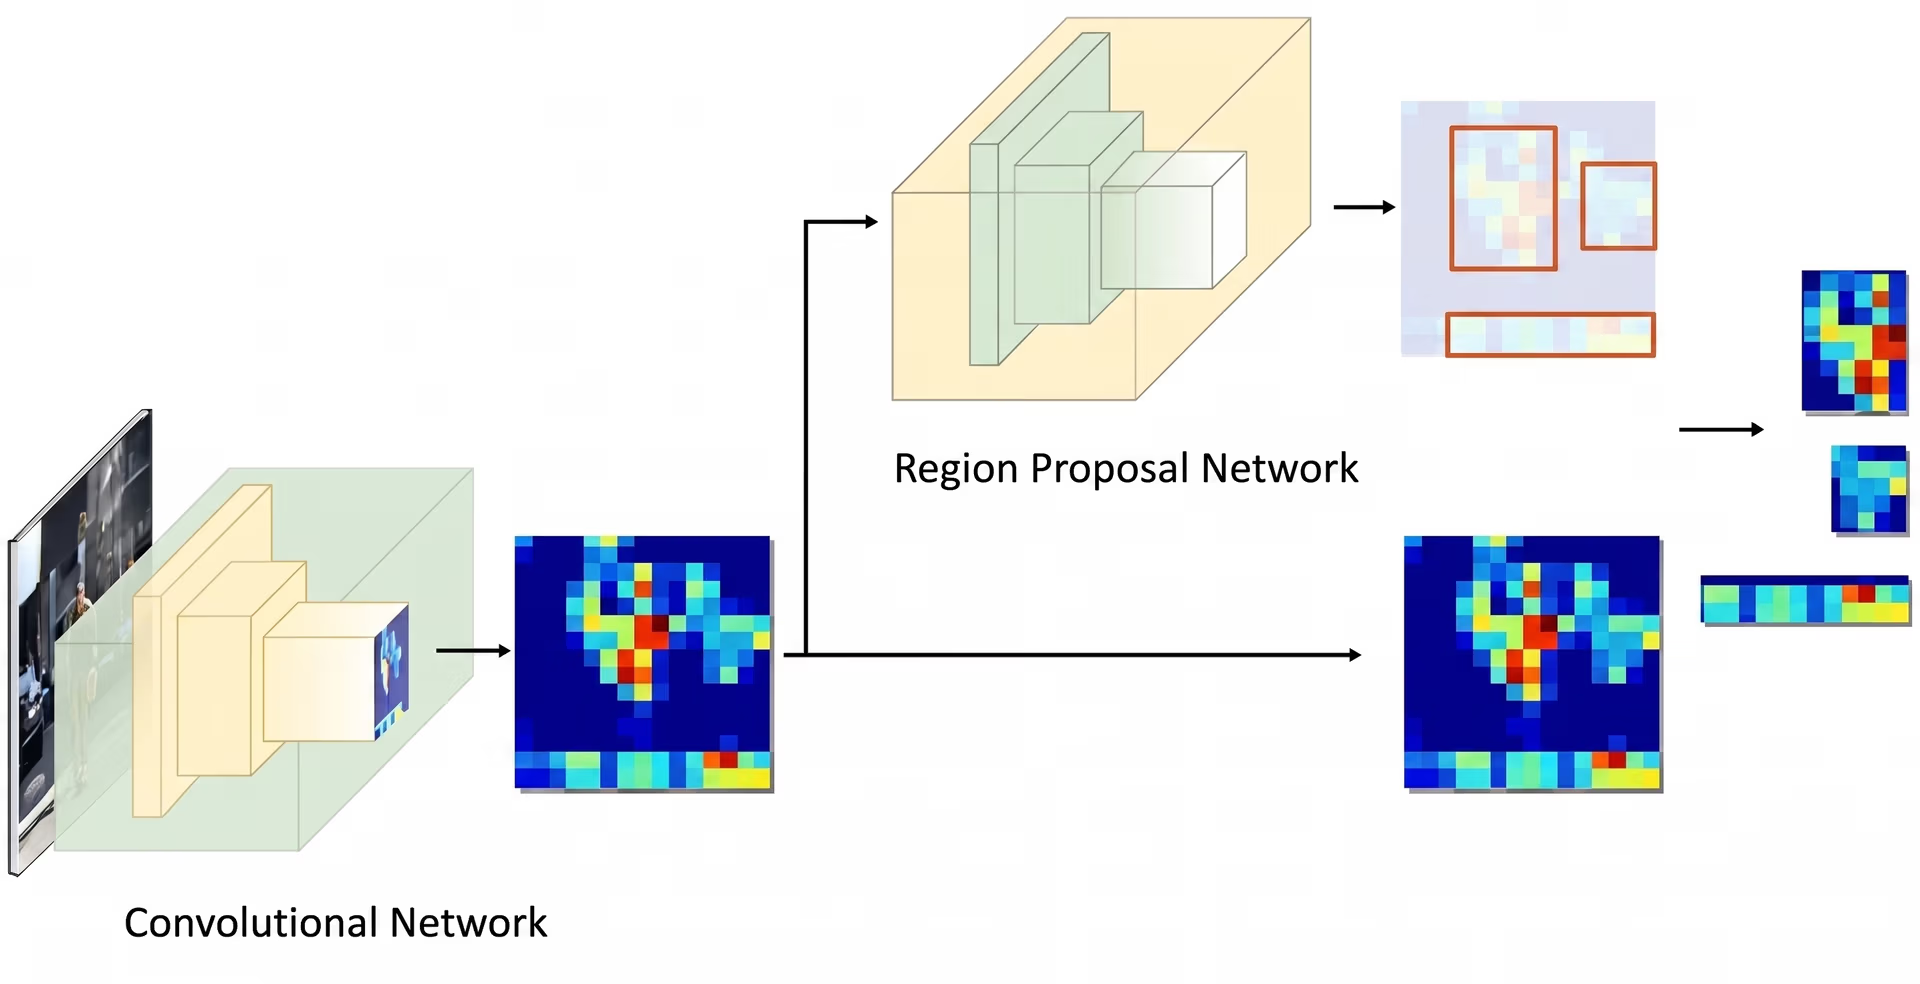
Fig. 3. Exemple de réseau de proposition de régions.
Améliorer les caractéristiques extraites#
Une fois les zones importantes identifiées, l’étape suivante consiste à affiner les détails extraits de ces régions. Les anciens modèles utilisaient une méthode appelée ROI Pooling (mise en commun des régions d’intérêt) pour extraire les caractéristiques de chaque zone, mais cette technique entraînait parfois de légers décalages lors du redimensionnement des régions, ce qui la rendait moins efficace, en particulier pour les objets petits ou qui se chevauchent.
Mask R-CNN améliore cette méthode grâce à une technique appelée ROI Align (alignement des régions d’intérêt). Contrairement à ROI Pooling, qui arrondit les coordonnées, ROI Align utilise l’interpolation bilinéaire pour estimer les valeurs des pixels avec plus de précision. L’interpolation bilinéaire calcule la valeur d’un nouveau pixel en établissant une moyenne pondérée des valeurs de ses quatre voisins les plus proches, ce qui produit des transitions plus douces. Les caractéristiques restent ainsi correctement alignées sur l’image d’origine, ce qui améliore la précision de la détection et de la segmentation des objets.
Par exemple, lors d’un match de football, deux joueurs proches l’un de l’autre pourraient être confondus si leurs cadres de délimitation se chevauchent. ROI Align aide à les séparer en préservant la distinction entre leurs formes.
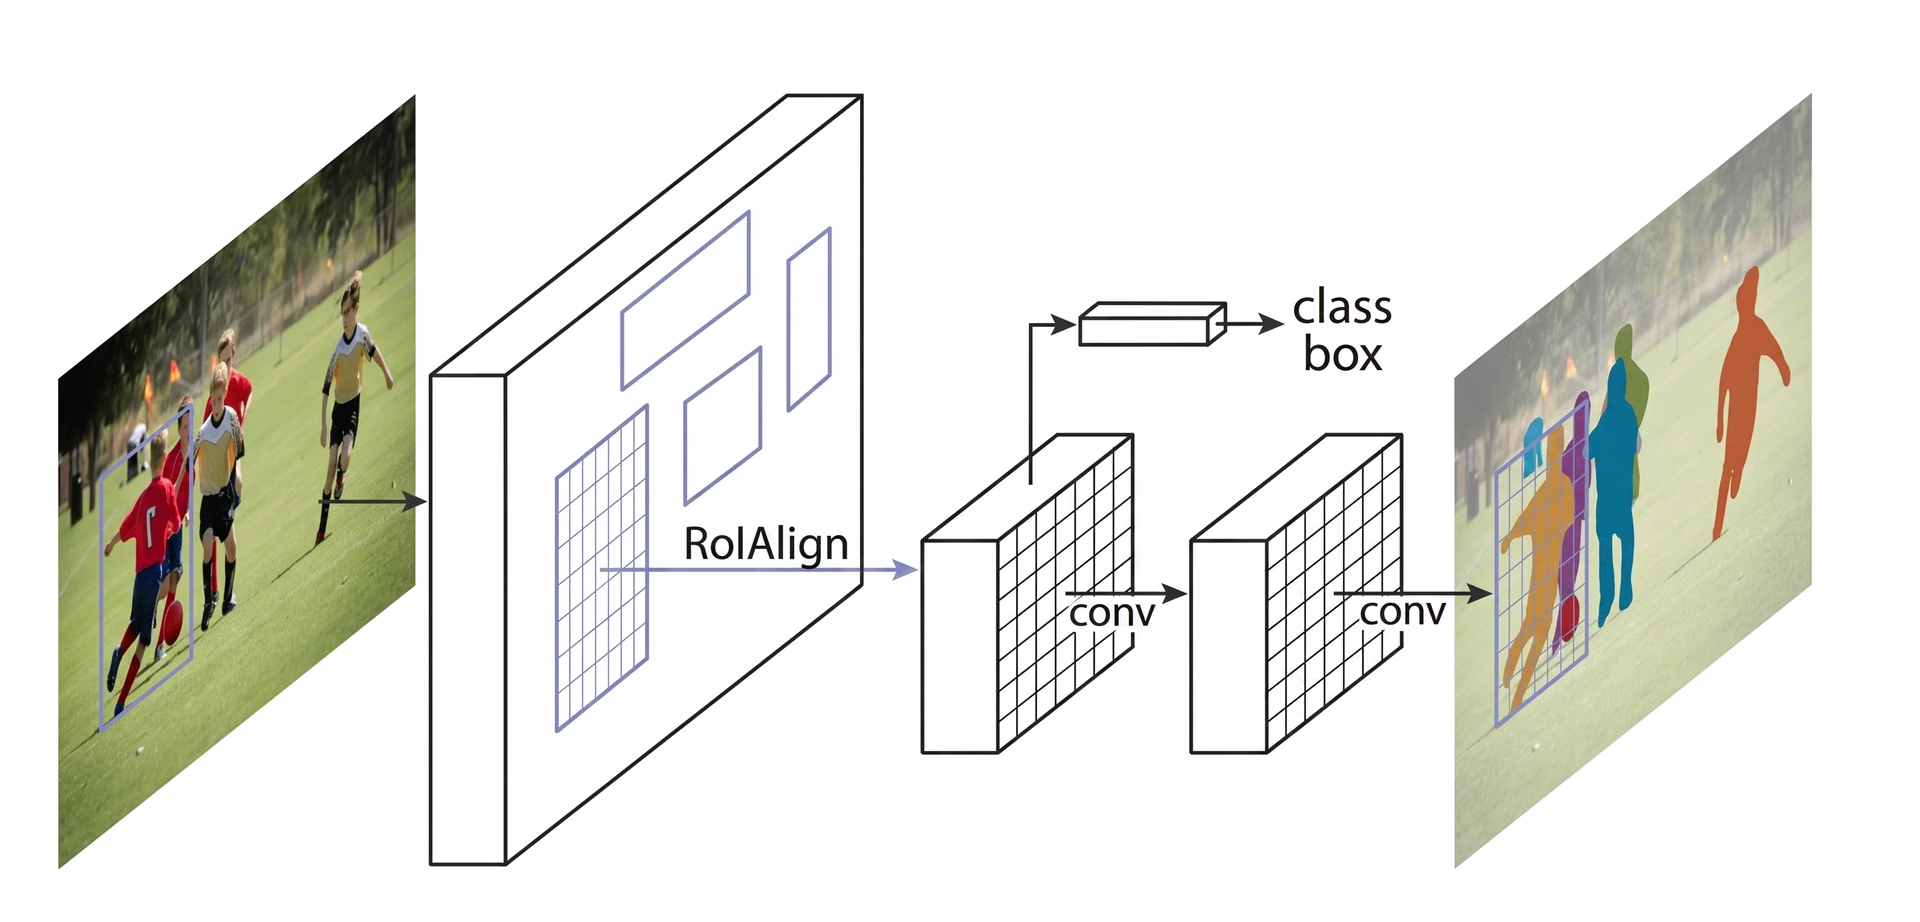
Fig. 4. Mask R-CNN utilise ROI Align.
Classification des objets et prédiction de leurs masques#
Une fois l’image traitée par ROI Align, l’étape suivante consiste à classifier les objets et à affiner leur emplacement. Le modèle examine chaque région extraite et détermine quel objet elle contient. Il attribue un score de probabilité aux différentes catégories, puis choisit la plus probable.
En parallèle, il ajuste les boîtes englobantes pour qu’elles épousent mieux les objets. Les boîtes initiales ne sont pas toujours placées de façon idéale ; ces ajustements améliorent donc la précision en veillant à ce que chaque boîte entoure étroitement l’objet détecté.
Enfin, Mask R-CNN va plus loin : il génère en parallèle un masque de segmentation détaillé pour chaque objet.
Mask R-CNN et ses applications dans le monde réel#
À sa sortie, ce modèle a suscité beaucoup d’enthousiasme dans la communauté de l’IA et a rapidement été utilisé dans diverses applications. Sa capacité à détecter et à segmenter des objets avec une précision au pixel près l’a rendu populaire dans différents secteurs.
Par exemple, suivre des animaux menacés dans la nature est une tâche difficile. De nombreuses espèces se déplacent dans des forêts denses, ce qui complique leur suivi par les défenseurs de l’environnement. Les méthodes traditionnelles utilisent des pièges photographiques, des drones et des images satellite, mais trier toutes ces données manuellement prend beaucoup de temps. Les erreurs d’identification et les observations manquées peuvent ralentir les efforts de conservation.
En reconnaissant des caractéristiques uniques comme les rayures des tigres, les taches des girafes ou la forme des oreilles des éléphants, Mask R-CNN peut détecter et segmenter les animaux dans les images et les vidéos avec une plus grande précision. Même lorsque des arbres les cachent partiellement ou qu’ils sont proches les uns des autres, le modèle peut les séparer et identifier chaque animal individuellement, ce qui rend le suivi de la faune plus rapide et plus fiable.
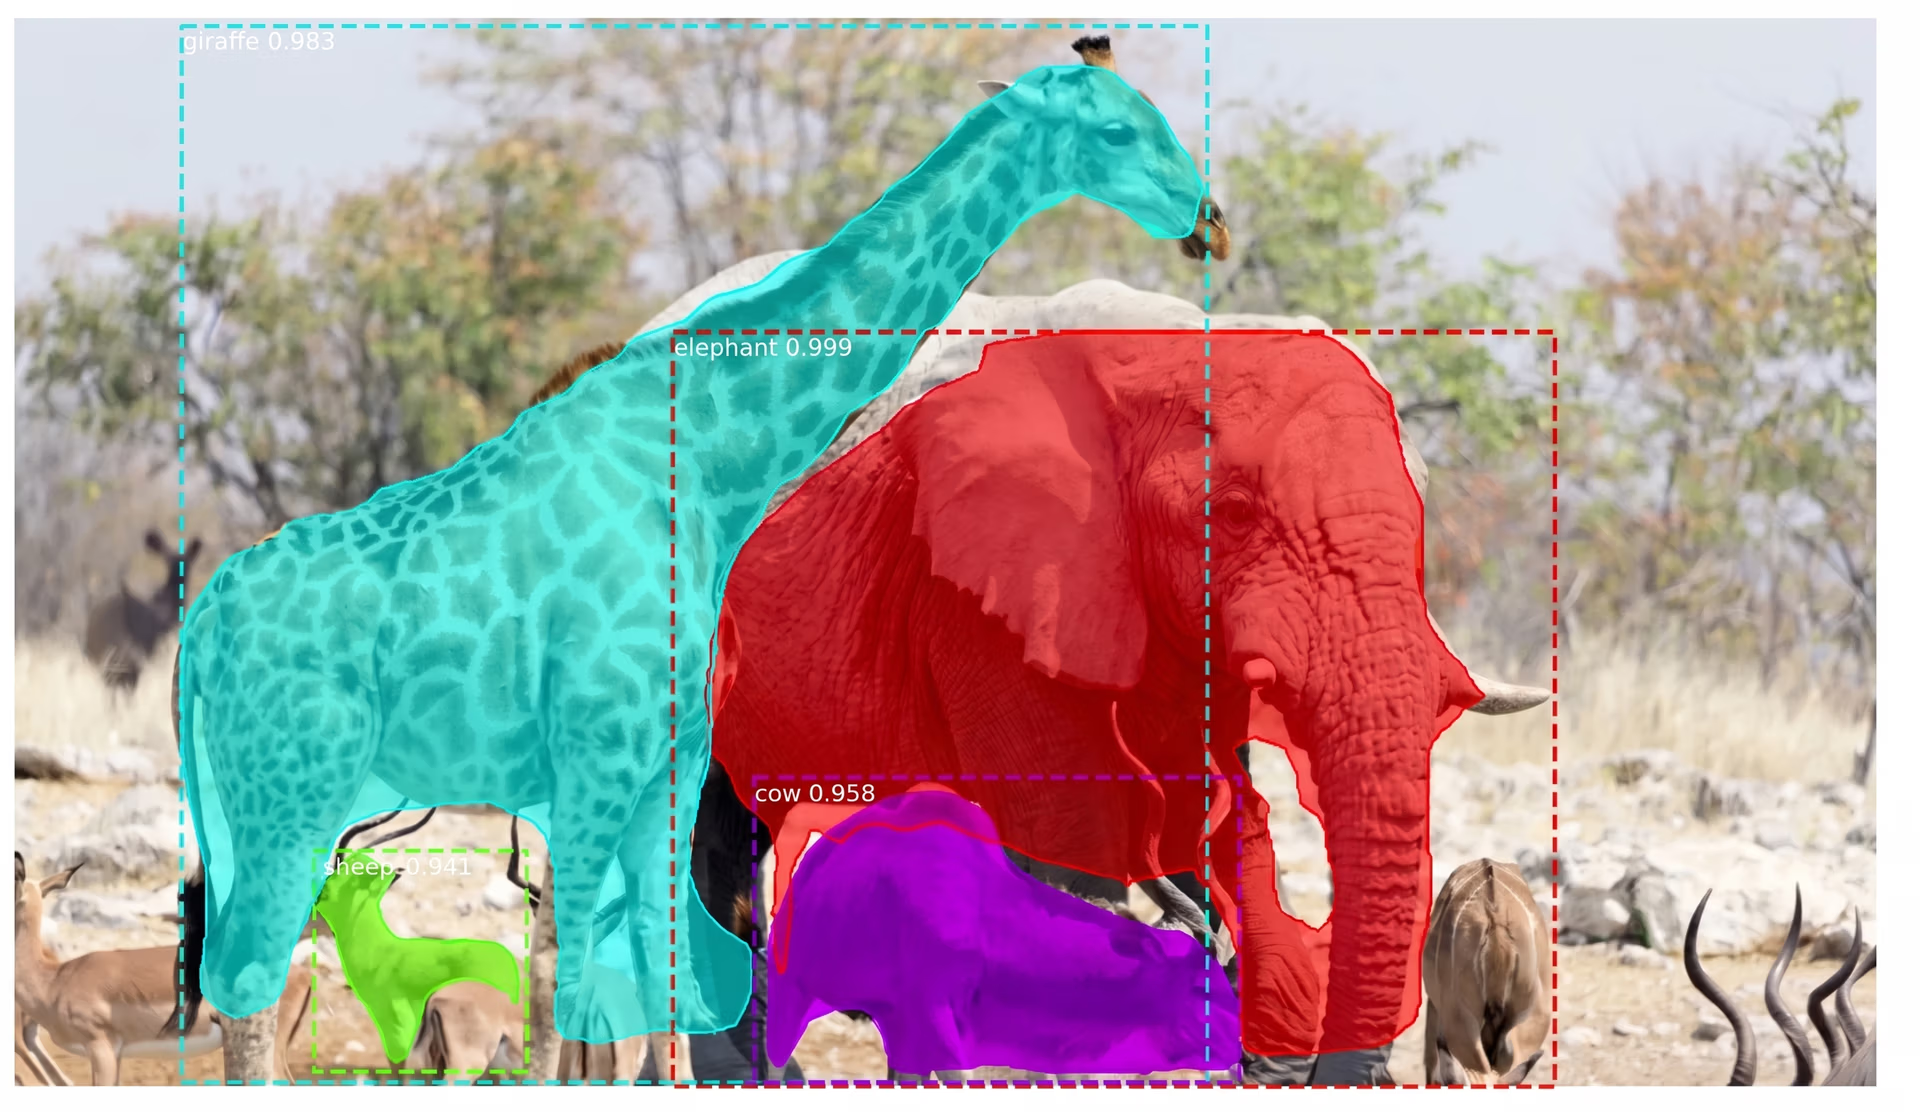
Fig. 5. Détection et segmentation d’animaux à l’aide de Mask R-CNN.
Limites de Mask R-CNN#
Malgré son importance historique pour la détection et la segmentation d’objets, Mask R-CNN présente aussi quelques inconvénients majeurs. Voici certains défis associés à Mask R-CNN :
- Besoins élevés en calcul : il nécessite des GPU puissants, ce qui peut rendre son exécution coûteuse et ralentir le traitement de grandes quantités de données.
- Vitesse de traitement plus faible : son processus en plusieurs étapes le rend plus lent que des modèles plus rapides en temps réel comme YOLO, ce qui peut ne pas convenir aux tâches sensibles au temps.
- Dépendance à des données de haute qualité : le modèle donne les meilleurs résultats avec des images nettes et bien annotées. Les images floues ou mal éclairées peuvent réduire considérablement sa précision.
- Mise en œuvre complexe : l’architecture en plusieurs étapes peut être difficile à configurer et à optimiser, surtout avec de grands jeux de données ou des ressources limitées.
De Mask R-CNN à Ultralytics YOLO11#
Mask R-CNN était performant pour les tâches de segmentation, mais de nombreux secteurs cherchaient à adopter la vision par ordinateur tout en privilégiant la vitesse et les performances en temps réel. Ce besoin a conduit les chercheurs à développer des modèles à une seule étape, capables de détecter les objets en un seul passage et d’améliorer considérablement l’efficacité.
Contrairement au processus en plusieurs étapes de Mask R-CNN, les modèles de vision par ordinateur à une étape comme YOLO (You Only Look Once) sont conçus pour les tâches de vision par ordinateur en temps réel. Au lieu de traiter séparément la détection et la segmentation, les modèles YOLO peuvent détecter et segmenter des objets en un seul passage. Ils sont donc parfaitement adaptés à des applications comme la conduite autonome, la santé, l’industrie manufacturière et la robotique, où il est essentiel de prendre des décisions rapidement.
En particulier, Ultralytics YOLO11 (auquel a succédé Ultralytics YOLO26) va encore plus loin en alliant rapidité et précision. Il utilise 22 % de paramètres en moins que YOLOv8m, tout en obtenant une meilleure précision moyenne (mAP) sur le jeu de données COCO, ce qui signifie qu’il détecte les objets avec plus de précision. Sa vitesse de traitement améliorée en fait un bon choix pour les applications en temps réel où chaque milliseconde compte.
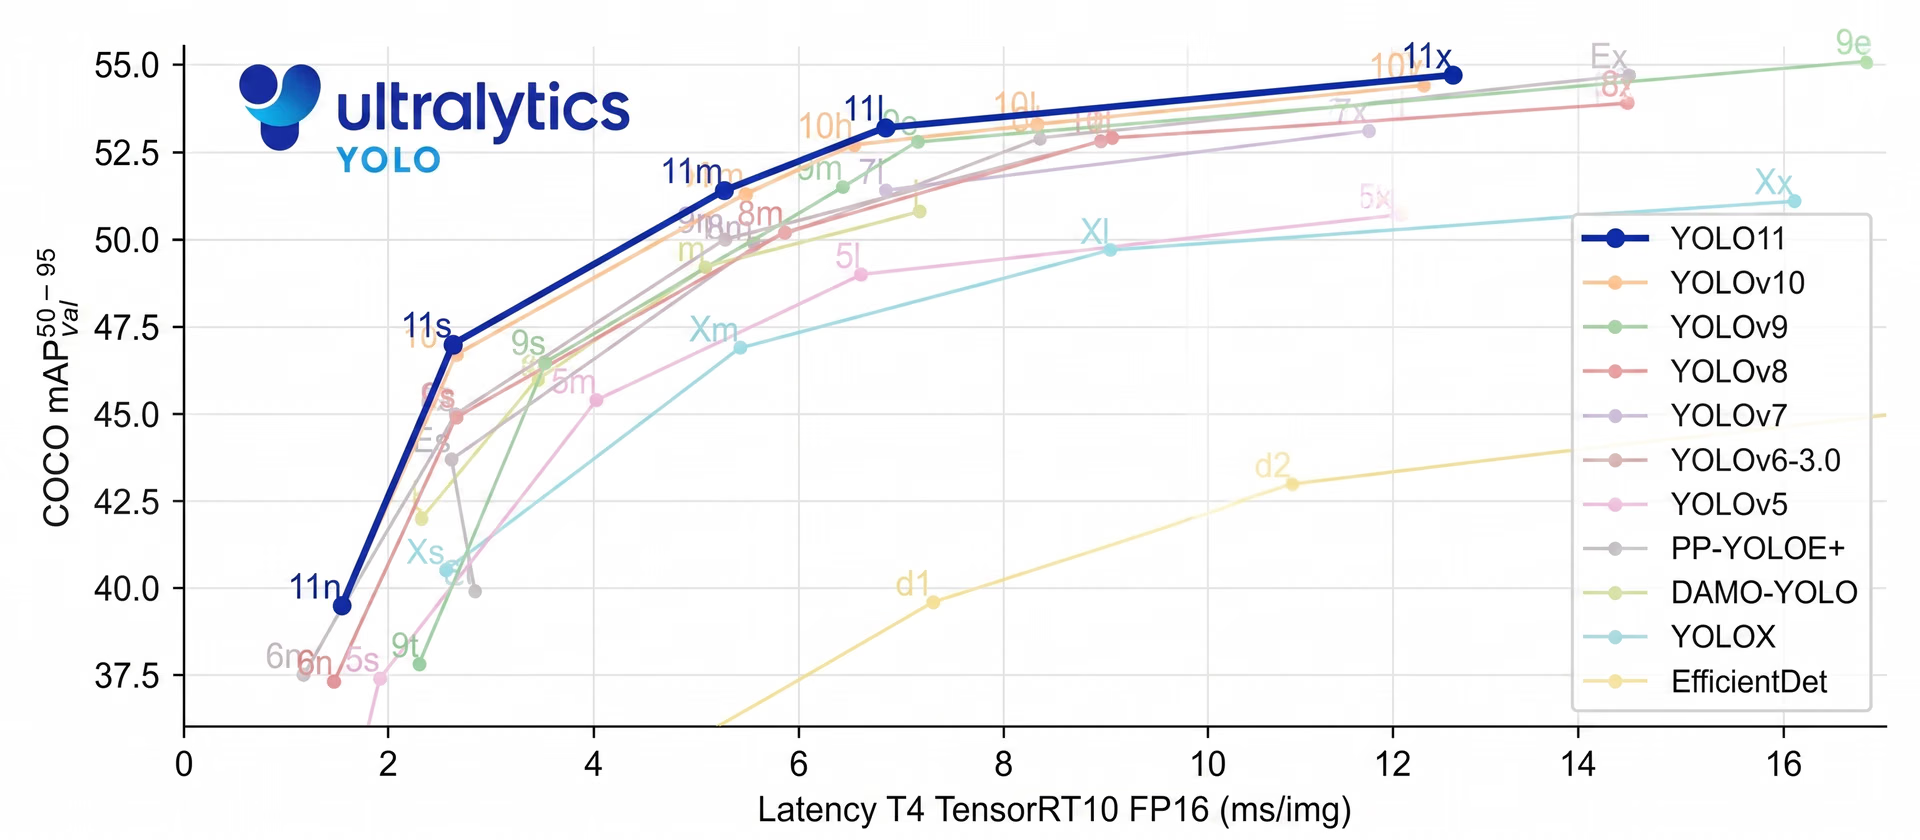
Fig. 6. Comparaison des performances de YOLO11 avec celles d’autres modèles.
Points clés à retenir#
Rétrospectivement, Mask R-CNN est reconnu comme une avancée majeure dans la détection et la segmentation d’objets. Son processus détaillé en plusieurs étapes lui permet de produire des résultats très précis, même dans des situations complexes.
Cependant, ce même processus le rend plus lent que les modèles en temps réel comme YOLO. Face aux besoins croissants en rapidité et en efficacité, de nombreuses applications utilisent désormais des modèles à une étape comme Ultralytics YOLO11, qui offrent une détection d’objets rapide et précise. Mask R-CNN reste important pour comprendre l’évolution de la vision par ordinateur, mais la transition vers les modèles en temps réel reflète une demande croissante de solutions plus rapides et plus efficaces.
Rejoins notre communauté grandissante ! Explore notre dépôt GitHub pour en savoir plus sur l’IA. Prêt à démarrer tes propres projets de vision par ordinateur ? Consulte nos options de licence. Découvre l’IA dans l’agriculture et l’IA visuelle dans la santé sur nos pages consacrées à nos solutions !
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









