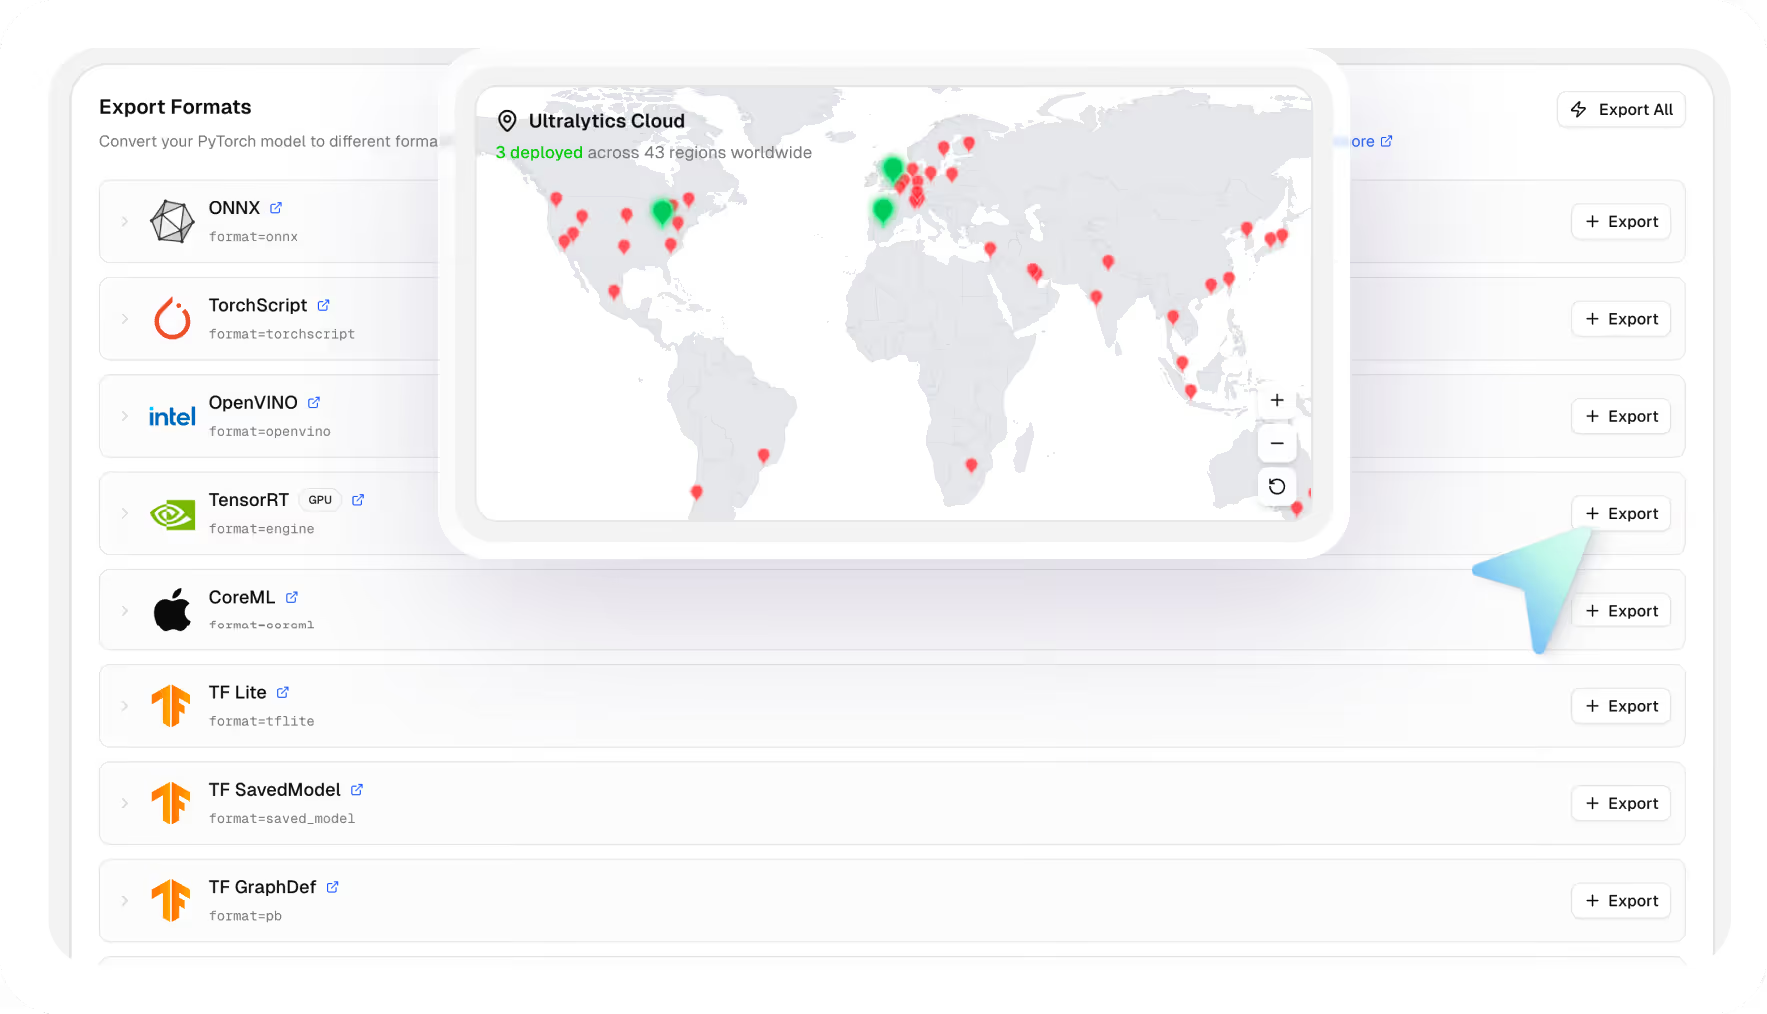
Déploie des modèles de vision par ordinateur dans 42 régions du monde
Fais passer tes modèles entraînés des tests dans le navigateur aux points de terminaison de production en quelques clics, grâce aux points de terminaison dédiés, à la supervision du déploiement et aux 22 formats d’export.
Déploie à l’échelle mondiale en production
Déploie en production les modèles entraînés grâce à une disponibilité mondiale, à une large prise en charge des formats d’exportation et au volume d’utilisation éprouvé par l’écosystème Ultralytics.
Teste ton modèle dans le navigateur
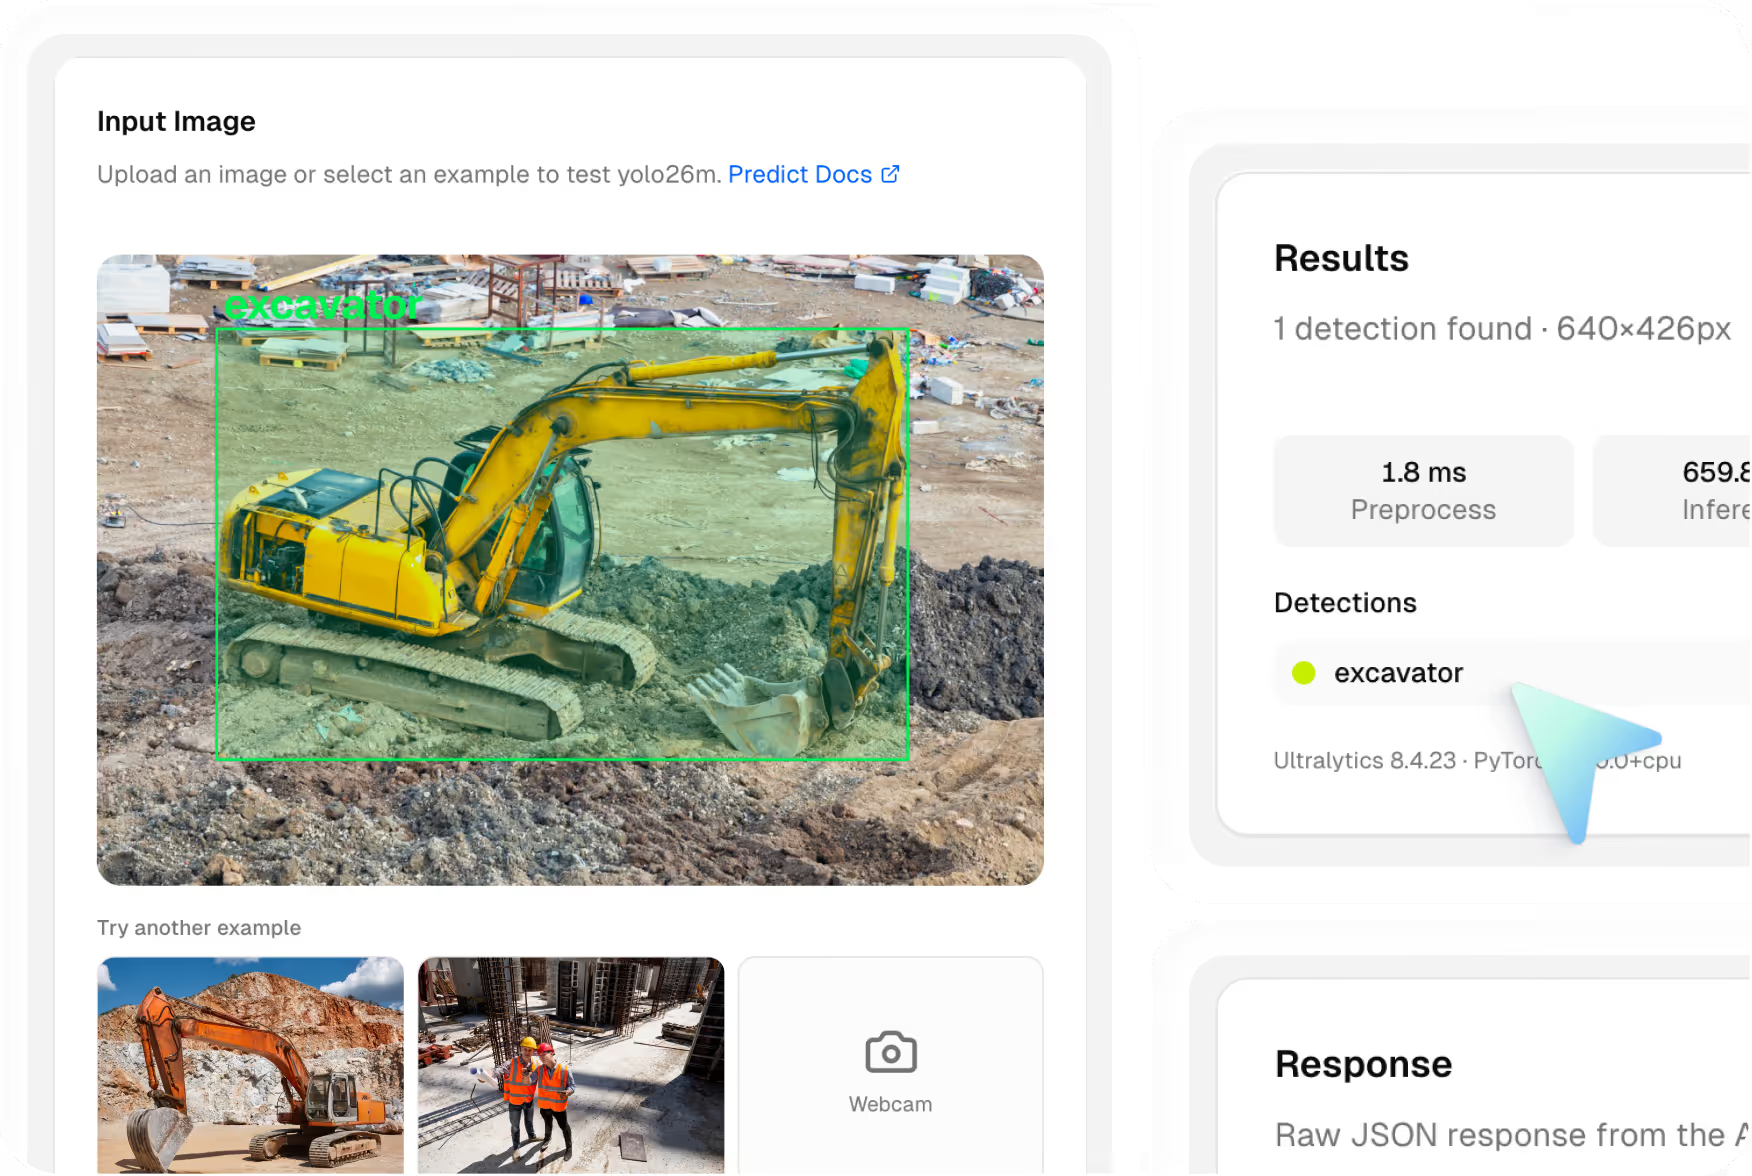
Chaque modèle entraîné comprend une fonctionnalité intégrée dans l’onglet Predict. Importe une image ou ouvre ta caméra ; les boîtes englobantes apparaissent instantanément.
Déploie dans 42 régions du monde
Déploie tes modèles sur des points de terminaison dédiés dans les Amériques, en Europe, en Asie-Pacifique et au Moyen-Orient. Chaque point de terminaison possède sa propre URL, des ressources CPU et mémoire configurables, ainsi que des outils de suivi des requêtes, de la latence, des erreurs et des journaux.
Des points de terminaison adaptés à ta charge de travail
Commence avec la taille incluse ou choisis les ressources CPU et mémoire dont chaque point de terminaison a besoin.
- Mise à l’échelle jusqu’à zéro par défaut :La taille incluse passe à zéro lorsqu’elle est inactive et n’entraîne aucuns frais de disponibilité.
- Aucune limite de débit de l’API Platform :Les requêtes vont directement à ton point de terminaison, sans passer par le limiteur de débit de l’API Platform.
- Ressources configurables :Choisis les ressources CPU (1 à 8 cœurs) et la mémoire (2 à 32 Go) adaptées à ta charge de travail. Les tailles personnalisées maintiennent une instance active, facturée selon sa durée de disponibilité.
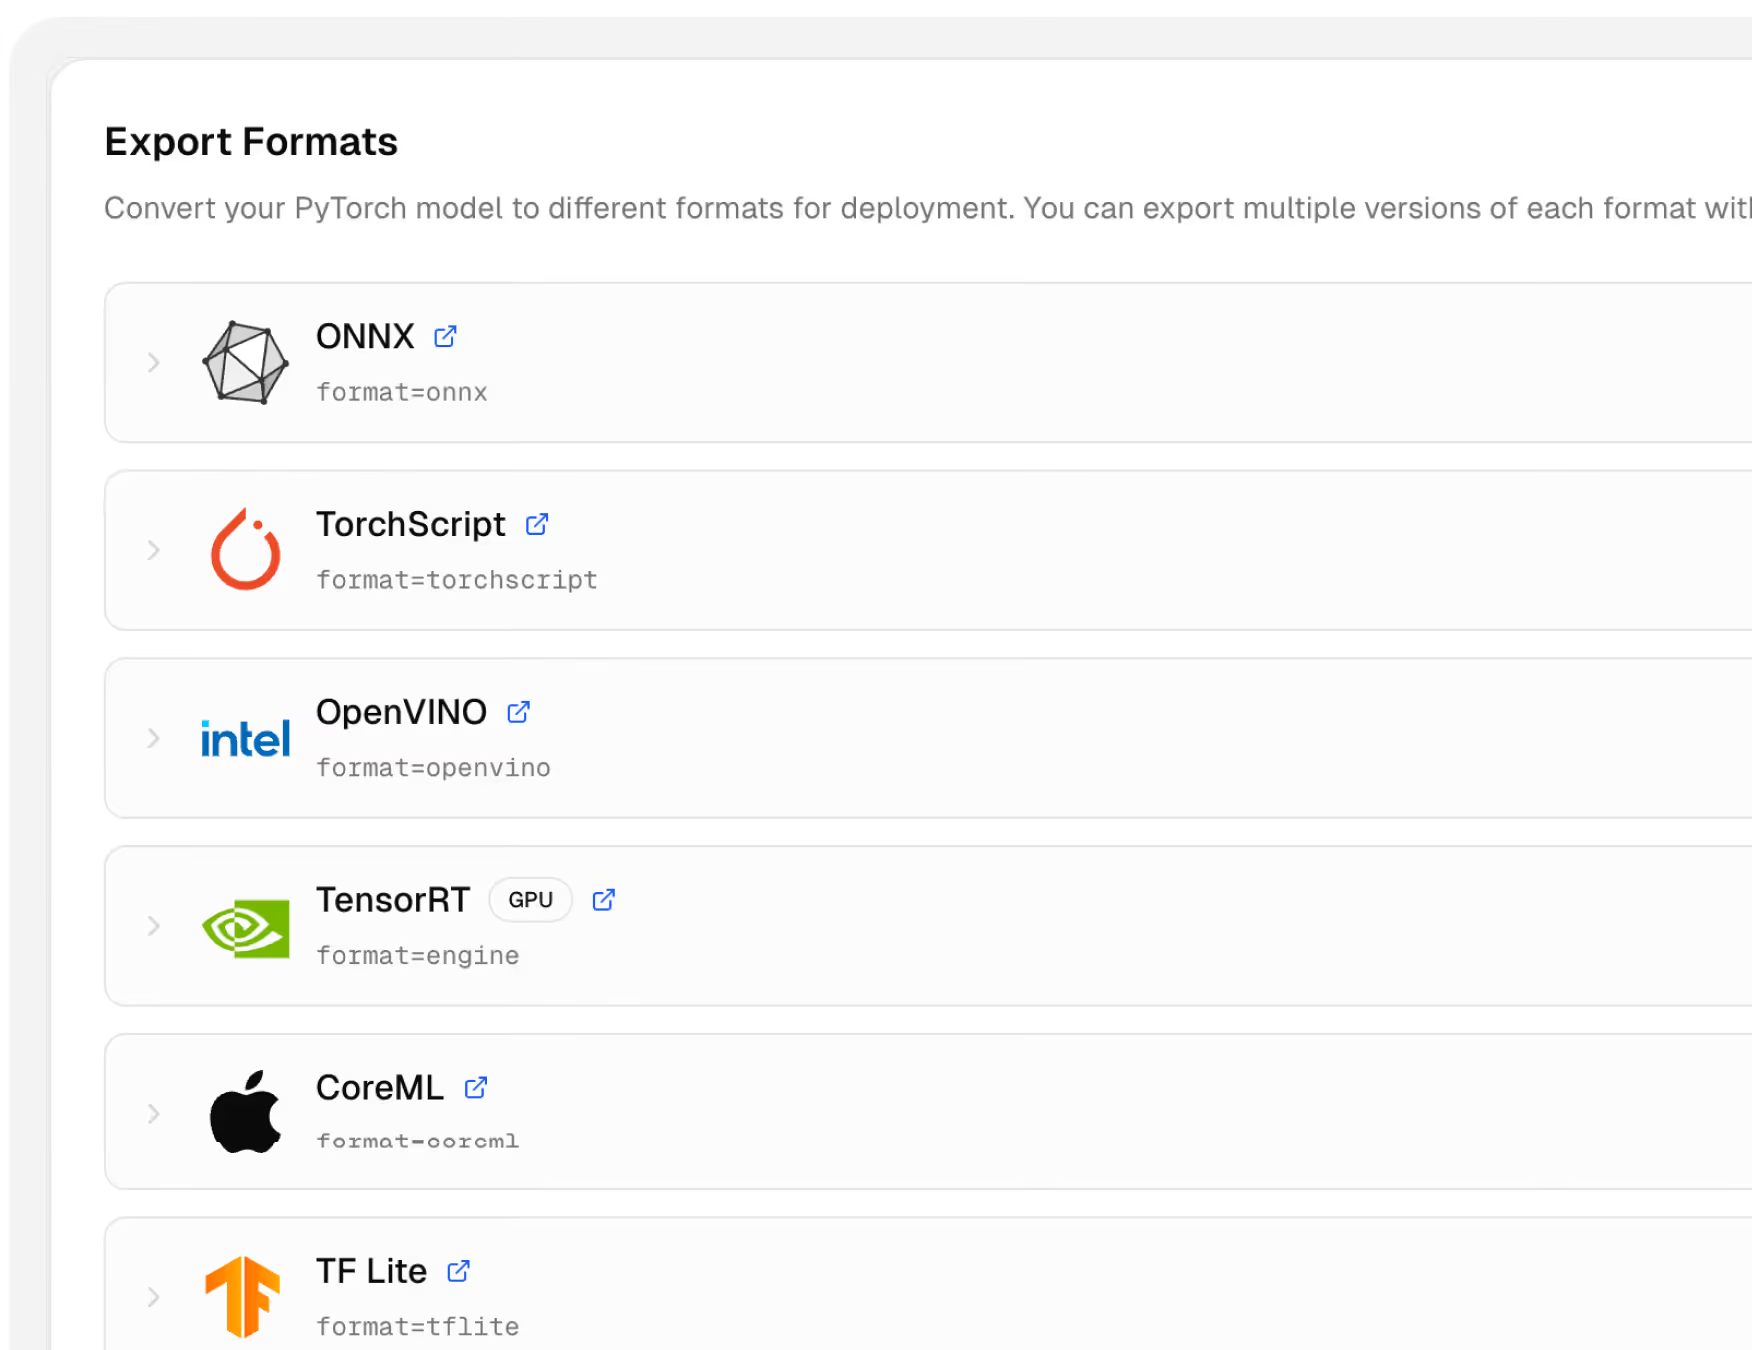
22 formats d’export. Ton modèle. Tous les environnements.
Ultralytics Platform prend en charge le déploiement dans le cloud et en périphérie pour des performances élevées. Tous les modèles Ultralytics YOLO sont optimisés nativement pour fonctionner efficacement dans différents environnements, avec une grande précision, des performances fiables et une compatibilité même avec les appareils en périphérie aux ressources de calcul limitées.
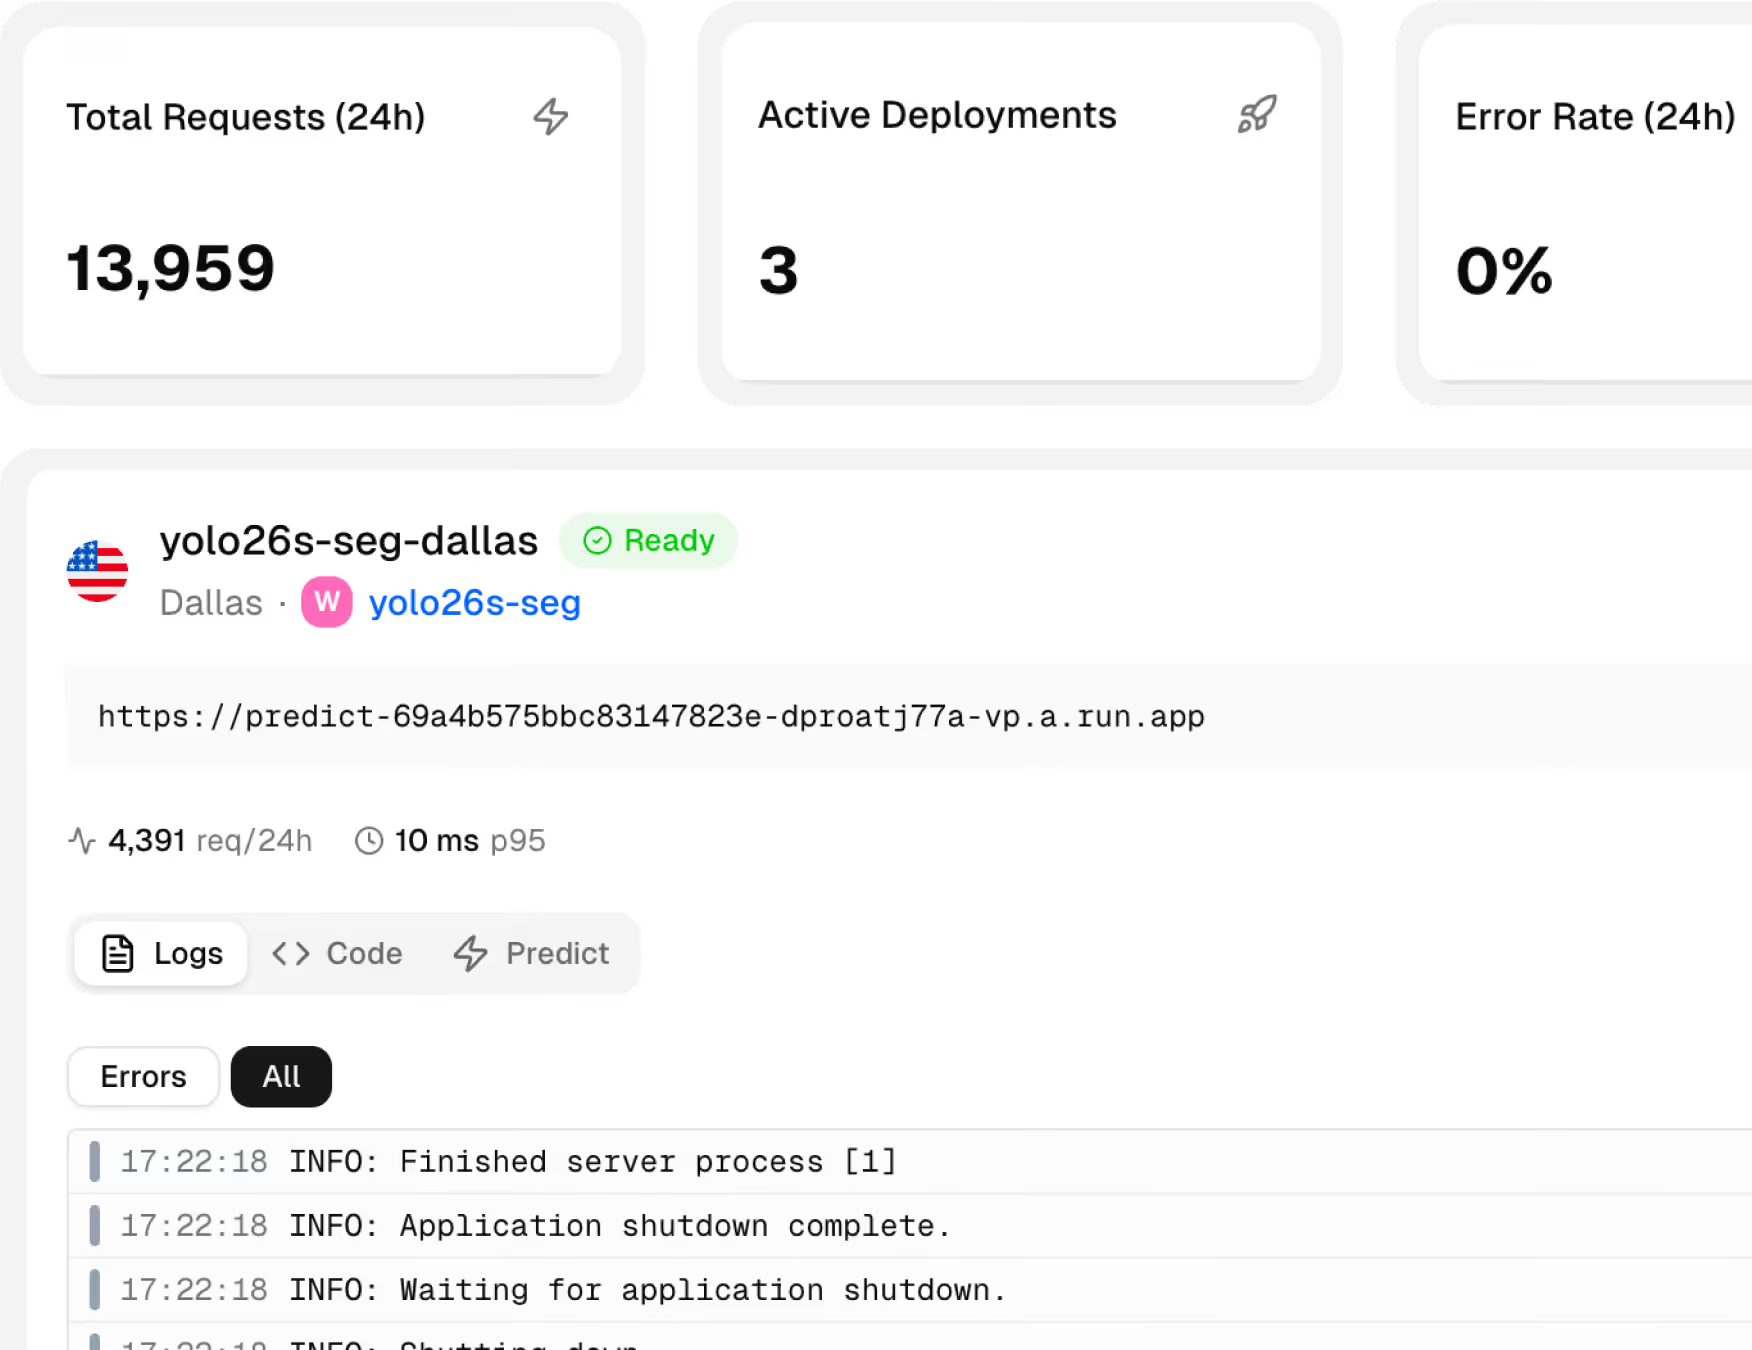
Surveille tout en production
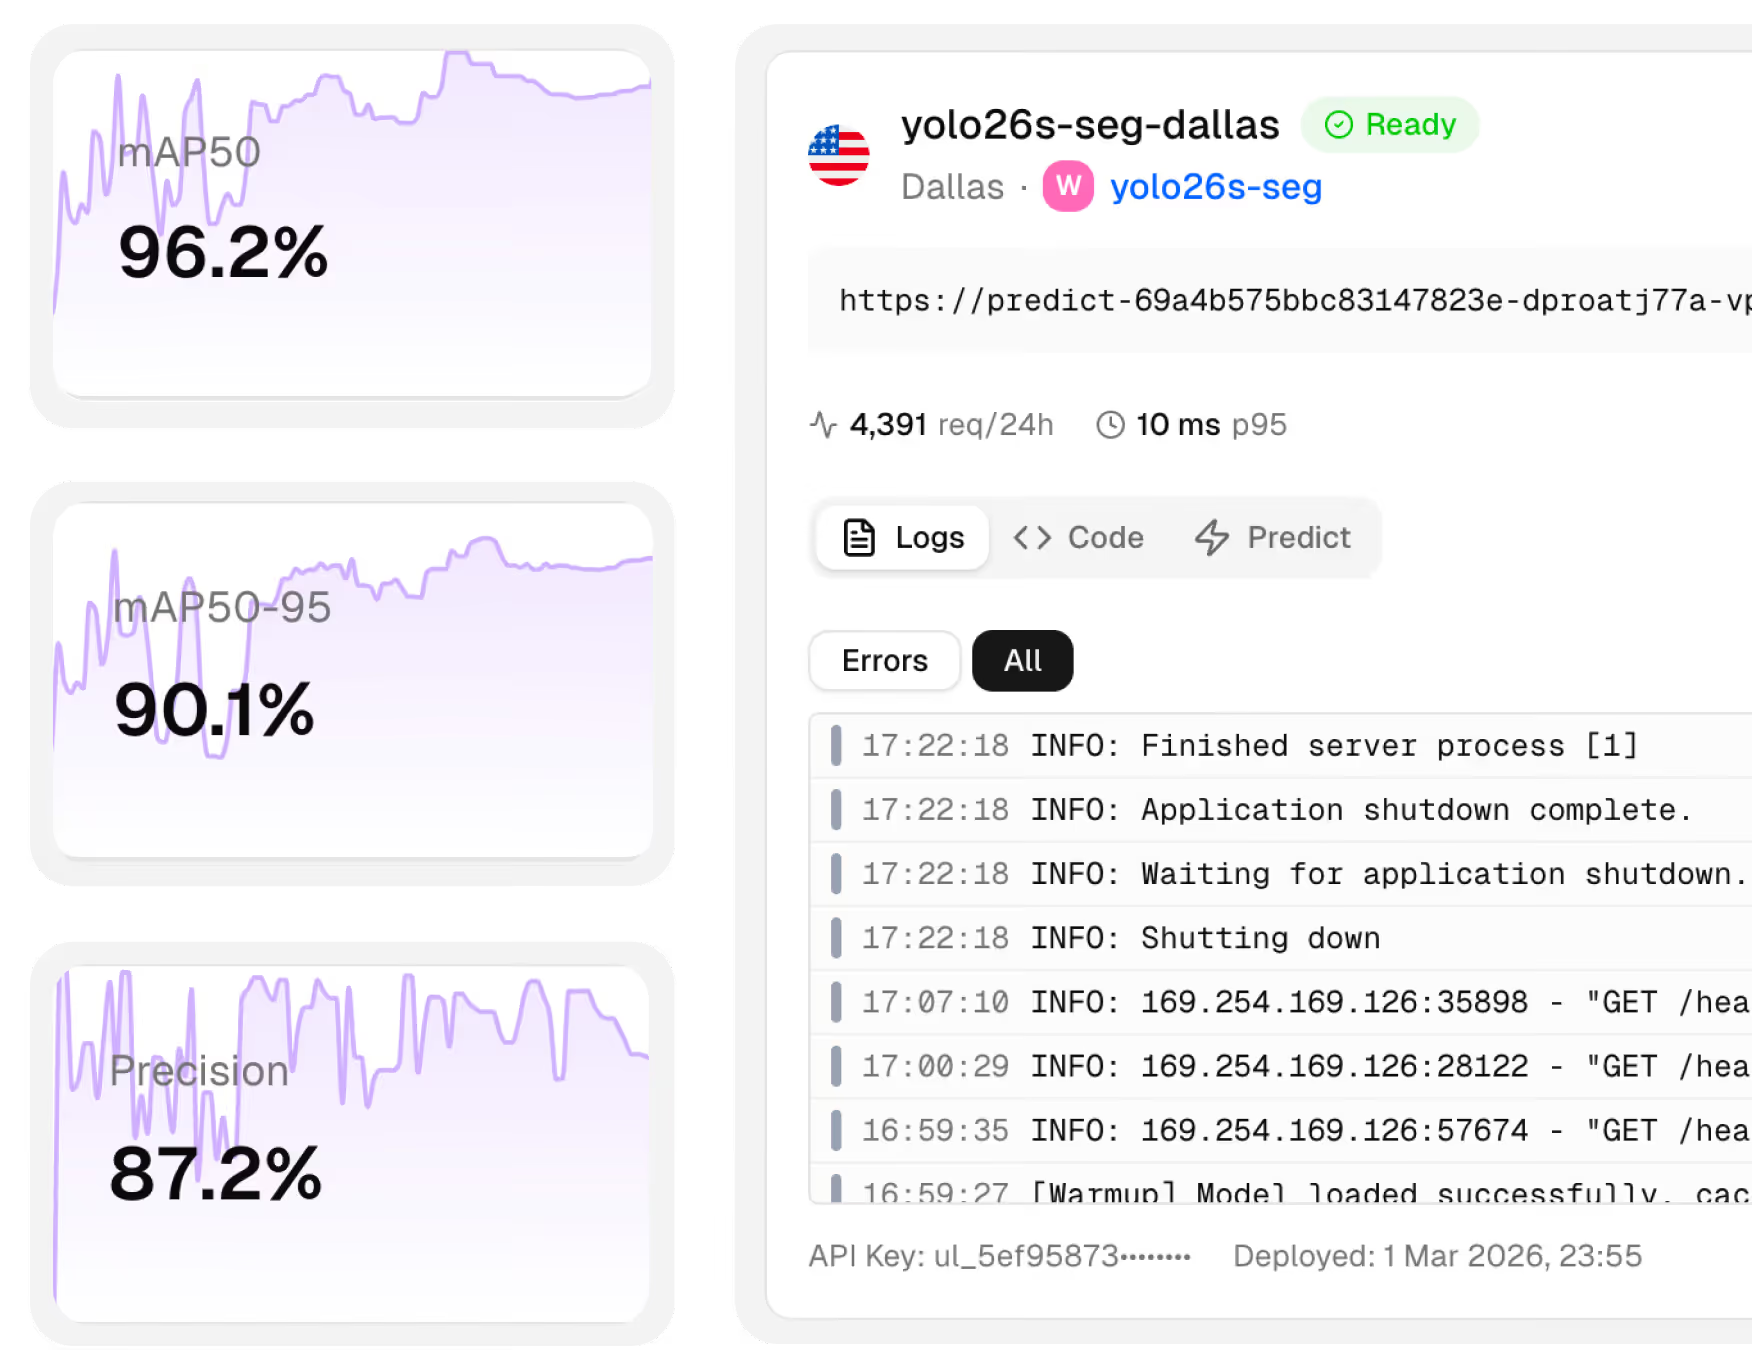
Suis les requêtes, la latence, les erreurs et les journaux des points de terminaison depuis le tableau de bord des déploiements. Les points de terminaison dédiés fournissent aussi des statistiques de prédiction en direct et des exemples temporaires que tu peux examiner et enregistrer dans un jeu de données.
- Requêtes, latence et erreurs :Volume HTTP sur 24 heures, latence P95 pondérée par le volume et alertes de taux d’erreur supérieur à 5 %.
- Contrôles d’état et journaux :État du point de terminaison en direct avec nouvelle tentative automatique, ainsi que journaux filtrés par niveau de gravité pour diagnostiquer rapidement les problèmes.
- Exemples temporaires :Examine les prédictions échantillonnées sur les points de terminaison dédiés. Les exemples sont conservés dans la mémoire du point de terminaison ; enregistre les images utiles dans un jeu de données pour les conserver.
- Statistiques de prédiction :Nombre de classes, confiance, durée d’inférence et cartes thermiques spatiales, si la tâche du modèle le permet. Les statistiques sont réinitialisées lorsque l’instance de service est remplacée.
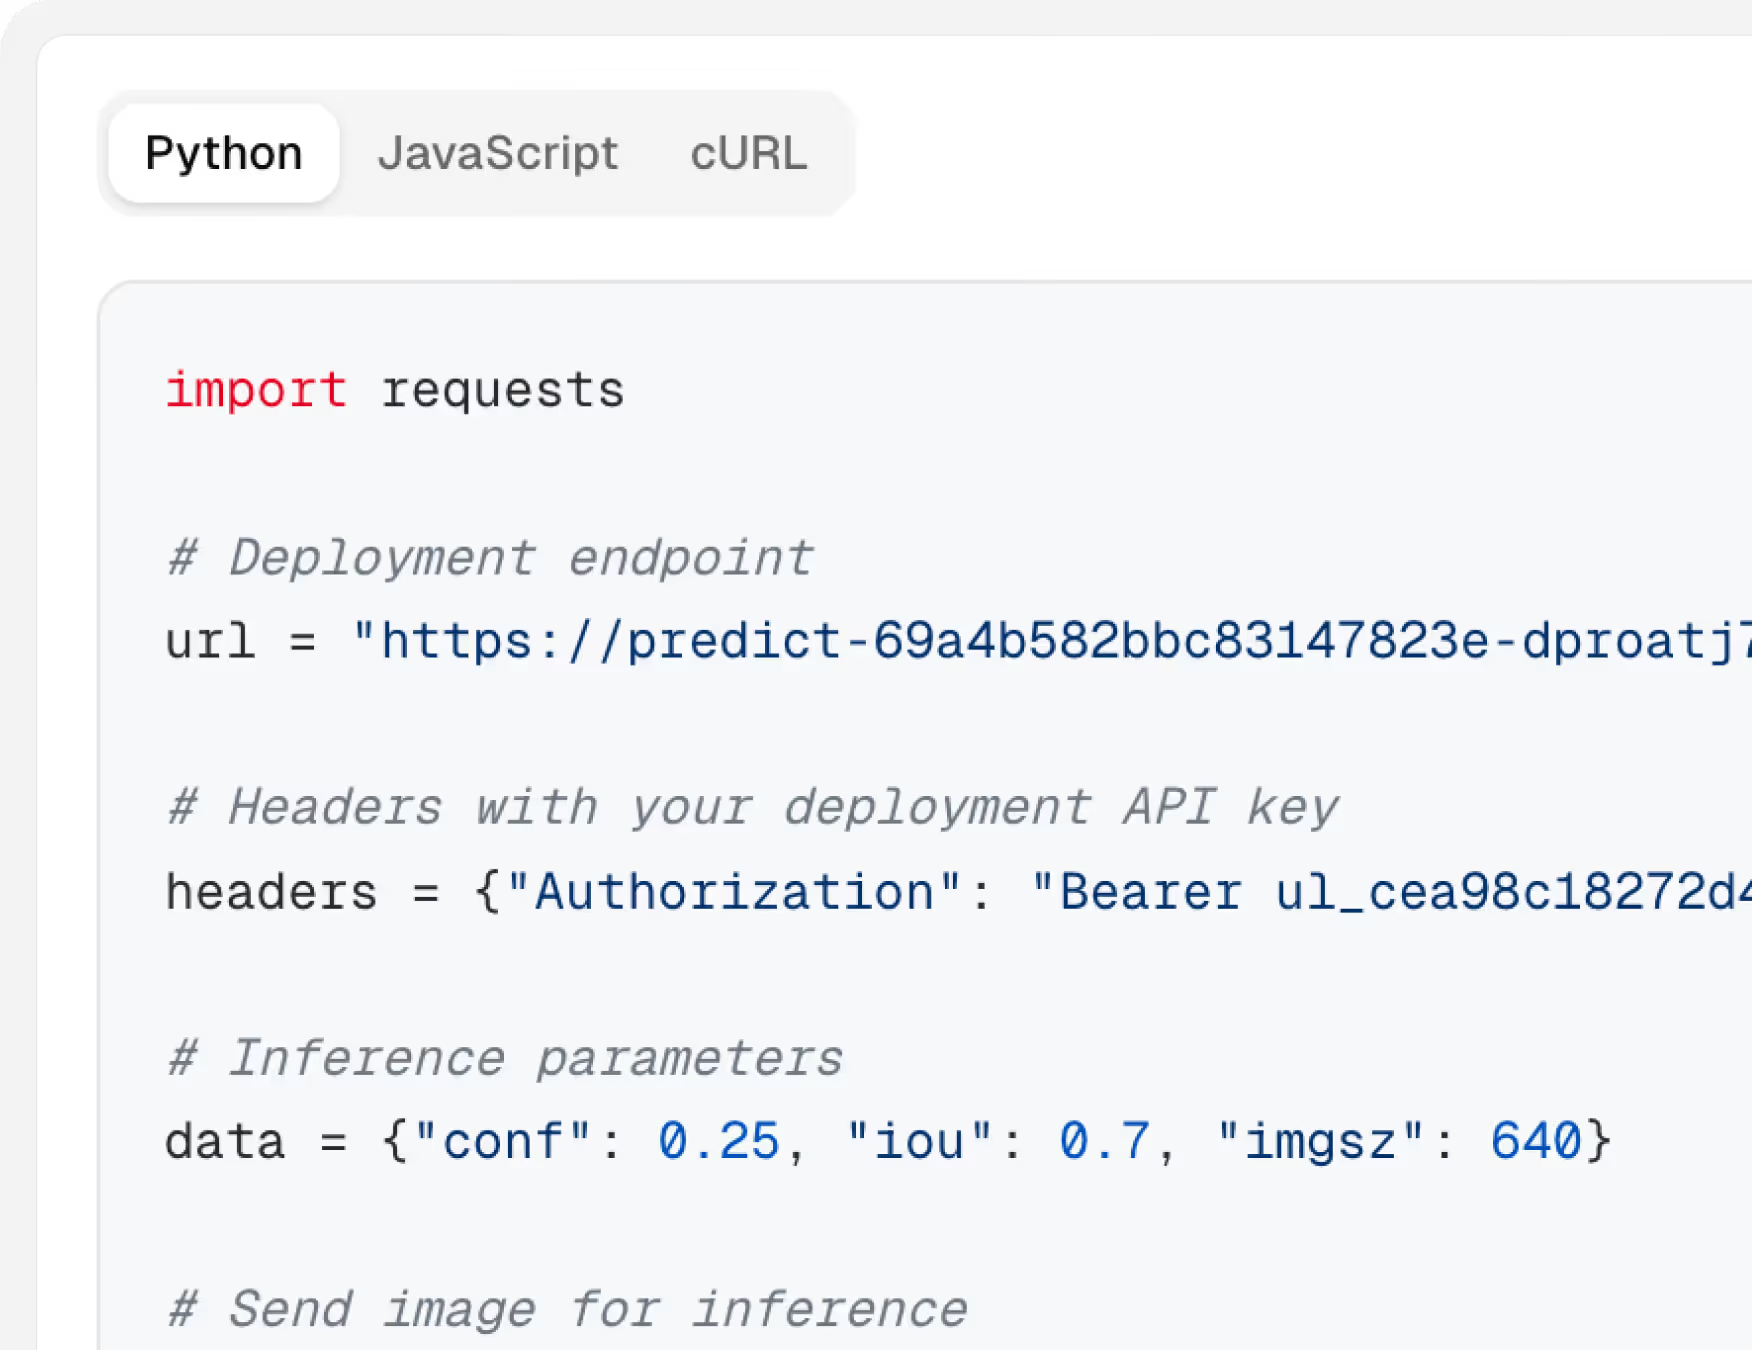
Intègre en quelques minutes
Chaque point de terminaison déployé inclut des exemples de code générés automatiquement en Python, JavaScript et cURL, préremplis avec l’URL réelle de ton point de terminaison et ta clé API. Copie, colle et commence à envoyer des requêtes d’inférence depuis n’importe quelle application.
Essayer l’inférence YOLO26
Glisse-dépose une image pour voir la détection d’objets en temps réel
Découvre comment déployer !
Regarde comment tester un modèle entraîné, le déployer sur un point de terminaison mondial et suivre les requêtes, la latence et les prédictions en direct.
Tu dois d’abord entraîner un modèle ?
Ultralytics Platform relie l’annotation, l’entraînement et le déploiement sur une seule plateforme.
Découvre les solutions par secteur
Découvre comment les équipes appliquent la vision par ordinateur d’Ultralytics dans des environnements de production.

La vision par ordinateur dans le sport

Vision par ordinateur pour les images aériennes

Vision par ordinateur dans l’aérospatiale

La vision par ordinateur dans la sécurité

La vision par ordinateur en robotique

La vision par ordinateur dans la logistique

La vision par ordinateur dans le commerce de détail

La vision par ordinateur dans le secteur de la santé

La vision par ordinateur dans l’industrie manufacturière

La vision par ordinateur dans l’automobile

Vision par ordinateur dans l’agriculture
La vision par ordinateur dans le sport
Vision par ordinateur pour les images aériennes
Vision par ordinateur dans l’aérospatiale
La vision par ordinateur dans la sécurité
La vision par ordinateur en robotique
La vision par ordinateur dans la logistique
La vision par ordinateur dans le commerce de détail
La vision par ordinateur dans le secteur de la santé
La vision par ordinateur dans l’industrie manufacturière
La vision par ordinateur dans l’automobile
Vision par ordinateur dans l’agriculture
Une sécurité certifiée de niveau entreprise
Fais l’objet d’une certification et d’un audit indépendants, pour que tes données restent protégées pendant leur transfert et leur stockage.
SOC 2 Type I
ISO 27001:2022
RGPD et CCPA
Foire aux questions
Oui. Déploie un modèle dans autant des 42 régions que ton forfait le permet : 3 points de terminaison avec Free, 10 avec Pro et un nombre illimité avec Enterprise, tous comptabilisés dans ton espace de travail. Un déploiement plus proche de tes utilisateurs peut réduire la latence.
La taille par défaut d'un point de terminaison (1 vCPU, 2 GiB) est gratuite, même lorsqu'il traite des requêtes, et sa capacité passe à zéro lorsqu'il est inactif. Les tailles personnalisées, jusqu'à 8 vCPU et 32 GiB, maintiennent une instance active et sont facturées sur les crédits en fonction de la durée de fonctionnement, y compris le temps d'inactivité, selon la taille et la région. L'inférence partagée est incluse dans tous les forfaits.
L'inférence partagée fonctionne sur un service mutualisé dans 3 régions et est limitée à 20 requêtes par minute et par clé API ou appelant, ce qui convient aux tests. Un point de terminaison dédié est un service à locataire unique situé dans l'une des 42 régions, avec sa propre URL et sa propre clé API. Les requêtes qui lui sont adressées directement ne sont pas soumises à cette limite, mais chaque point de terminaison exécute une seule instance et peut refuser des requêtes lorsqu'il est occupé : effectue donc un test de charge avant la mise en production.
Un nouveau point de terminaison est généralement prêt en quelques minutes, selon le modèle et la région. Les points de terminaison de taille par défaut passent à zéro lorsqu'ils sont inactifs : après une période sans activité, la première requête peut donc prendre environ une minute, le temps que le point de terminaison démarre.
Le déploiement de modèles rend un modèle entraîné disponible pour effectuer des prédictions sur de nouvelles données, comme des images ou des images vidéo envoyées depuis une application. Sur Ultralytics Platform, tu peux tester un modèle dans le navigateur, le déployer sur un point de terminaison dédié dans l'une des 42 régions, l'appeler depuis ton application et le surveiller, le tout depuis le même espace de travail.
Envoie des images ou des fichiers vidéo pris en charge au REST API de ton endpoint ; les modèles de profondeur n’acceptent que des images. La page de chaque déploiement contient des exemples en Python, JavaScript et cURL. Les propriétaires d’espace de travail peuvent également exécuter un endpoint sur une webcam ou une caméra RTSP accessible depuis Internet à partir de l’onglet Predict (les adresses du réseau local ne sont pas prises en charge), et les endpoints de taille personnalisée peuvent continuer à surveiller une caméra IP en arrière-plan.
Oui. Exporte ton modèle pour le matériel cible et exécute-le sur tes propres serveurs ou appareils edge, même hors ligne. Les formats disponibles comprennent TensorRT pour NVIDIA Jetson, OpenVINO, CoreML, LiteRT, NCNN, RKNN, Hailo et Qualcomm ; leur disponibilité dépend du modèle et de la tâche. Pour utiliser le modèle dans des produits propriétaires sans être soumis aux obligations de l’AGPL-3.0, tu as besoin d’une licence Enterprise Ultralytics.
Commence à déployer dès aujourd’hui !
Mets tes modèles entraînés en production dans 42 régions du monde grâce à des points de terminaison dédiés et à une surveillance du déploiement.