Ultralytics YOLO26 ora supporta la stima monoculare della profondità
Scopri come la nuova attività di stima della profondità in Ultralytics YOLO26 predice la profondità metrica per ogni pixel da una singola immagine RGB, senza bisogno di un sistema stereo o di LiDAR.
Finora, per aggiungere la profondità a una pipeline YOLO dovevi assemblare i componenti da solo. La configurazione standard prevedeva di eseguire YOLO per il rilevamento e abbinarlo a un modello di profondità separato, proveniente da un altro progetto, come MiDaS o Depth Anything. Questo comportava una seconda dipendenza, un secondo framework e due serie di formati di input e output da riconciliare.
La stima monoculare della profondità è ora un'attività nativa in Ultralytics YOLO26. Una singola immagine RGB produce un valore di distanza per ogni pixel, usando lo stesso pacchetto, flusso di lavoro e percorso di esportazione del rilevamento, della segmentazione e della stima della posa.
Che cos'è la stima della profondità?#
La stima della profondità predice una mappa di profondità per ogni pixel a partire da una singola immagine RGB, senza bisogno di una seconda telecamera o di un sensore aggiuntivo. Ogni pixel in uscita contiene un valore di profondità in metri, che rappresenta la distanza stimata dalla telecamera a quel punto della superficie.
Il risultato è una mappa densa di valori float con forma (H, W), allineata all'input, in cui ogni pixel indica una distanza assoluta in metri: la distanza dalla telecamera, non un ordinamento relativo degli elementi in base a quanto sono vicini o lontani.
La profondità è un'attività autonoma con un checkpoint dedicato e il suo unico risultato è la mappa di profondità; non restituisce riquadri di delimitazione né maschere di segmentazione. Per combinare il rilevamento con la profondità, quindi, servono due modelli e due passaggi in avanti. La differenza rispetto alle pratiche precedenti è che ora entrambi rientrano in un unico pacchetto e condividono una sola installazione, un'unica interfaccia di addestramento e predizione, un unico percorso di esportazione e una sola versione da monitorare, senza dover mantenere un secondo framework accanto al primo.
È proprio questo risultato per pixel a rendere la profondità utile per il rilevamento di ostacoli e spazi liberi, la verifica delle distanze di sicurezza, la disposizione della scena e la comprensione di ciò che si trova davanti a cosa.
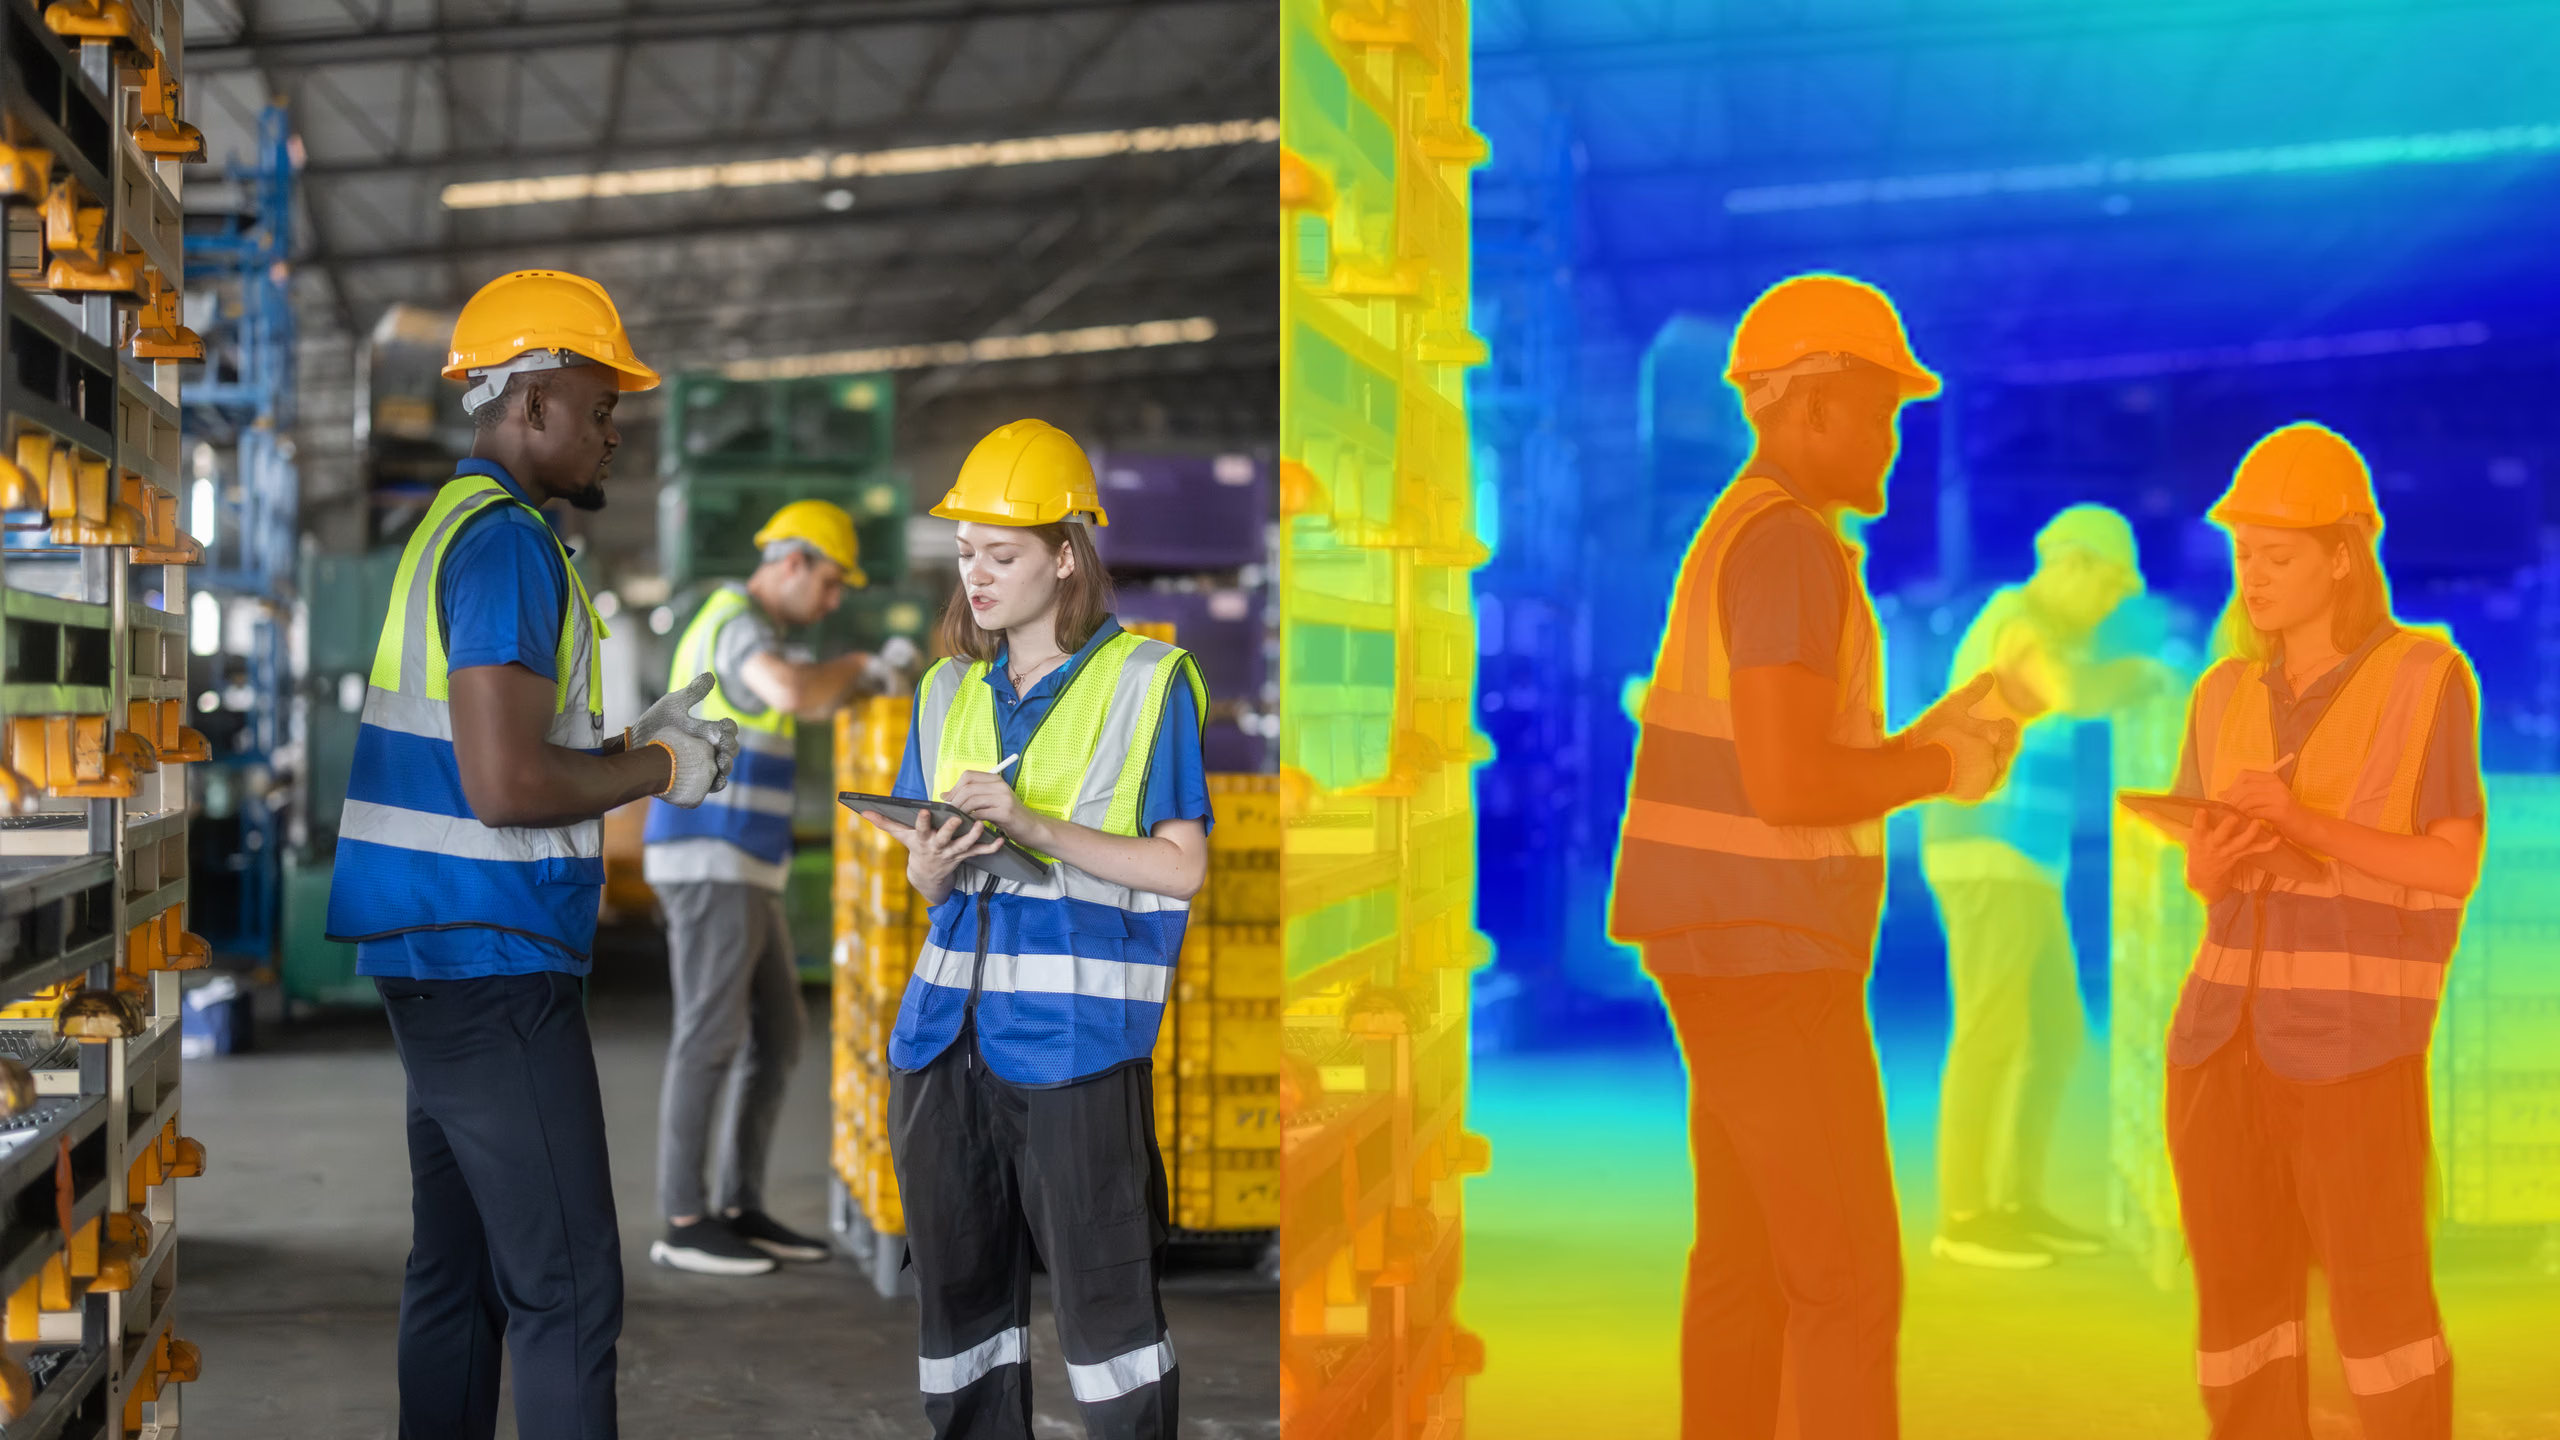 Fig. 1. Stima della profondità con Ultralytics YOLO26 per il monitoraggio della sicurezza e della conformità.
Ultralytics YOLO26 include cinque modelli di profondità preaddestrati, da yolo26n-depth a yolo26x-depth, addestrati su un'ampia combinazione di dataset, con circa 2,19 milioni di immagini di ambienti interni ed esterni. Sul dataset NYU Depth V2, l'accuratezza δ1 va da 0,882 per il modello nano a 0,933 per il modello extra-large, così puoi scegliere il compromesso tra velocità e accuratezza più adatto al tuo obiettivo di deployment.
Profondità senza limiti per progettazione#
La maggior parte dei modelli di profondità limita le previsioni a un intervallo fisso, ad esempio 0–10 metri: una soluzione che funziona bene per le scene in interni, ma non per quelle all'aperto. Ultralytics stima invece la profondità su una scala logaritmica senza limiti, senza una soglia massima fissa.
La differenza emerge nei test. Un modello con intervallo limitato raggiunge quasi subito un plateau quando viene addestrato su dati misti di ambienti interni ed esterni, e non regge su dataset con distanze maggiori come KITTI, dove gli oggetti possono trovarsi a 80 metri. L'approccio di Ultralytics YOLO26 non ha questo limite, quindi continua a migliorare con più dati e si comporta bene da pochi centimetri a qualche centinaio di metri. Su KITTI, δ1 raggiunge 0,942 con un intervallo di 80 m. Questo significa che la stessa famiglia di modelli gestisce altrettanto bene una scena su un tavolo e una scena autostradale.
Confronto tra la stima della profondità di Ultralytics YOLO26 e Depth Anything V2#
Se oggi usi Depth Anything insieme a YOLO, la differenza sta nella velocità e nei costi di calcolo che ne derivano. La stima della profondità di Ultralytics YOLO26 è fino a 20,3× più veloce di Depth Anything V2 Base e 7,7× più veloce di Depth Anything V2 Small, pur usando un modello molto più piccolo: meno di 10 milioni di parametri nella versione nano, contro circa 24 milioni per il checkpoint più piccolo di DA V2.
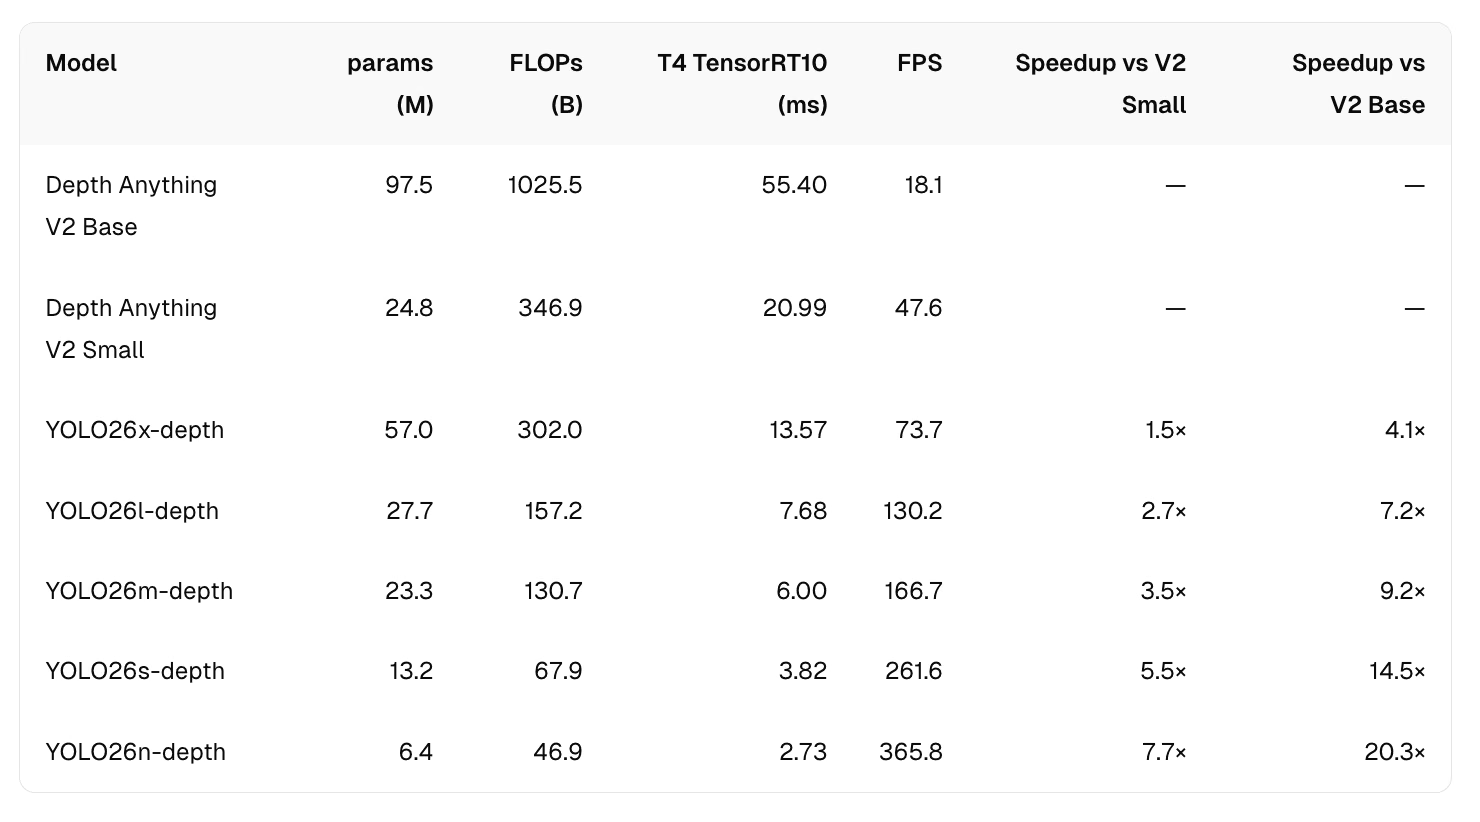 Fig. 2. Benchmark di velocità per la stima della profondità con Ultralytics YOLO26 a confronto con Depth Anything V2.
Questo divario è intenzionale. I modelli Depth Anything V2 sono decisamente più grandi; Ultralytics YOLO26-Depth offre prestazioni elevate nella stima della profondità con dimensioni e velocità che riducono il costo di calcolo per frame e consentono il deployment su hardware non supportato da quei modelli. Le metriche di accuratezza per ciascun modello su NYU Depth V2 e KITTI sono disponibili nella documentazione, così puoi confrontarle con i requisiti effettivi.
Dove può essere eseguito#
La differenza di dimensioni determina dove è possibile usare concretamente la stima della profondità. Alla maggior parte dei team che valutano questa tecnologia non mancano le idee, ma le risorse di calcolo. Droni a basso consumo, robot quadrupedi, dispositivi indossabili, dashcam, hardware per videoconferenze e PC industriali raggiungono tutti il limite di potenza e costo prima di quello di accuratezza.
La stima della profondità è disponibile in cinque modelli preaddestrati, così puoi scegliere le dimensioni più adatte al dispositivo di destinazione invece di quelle che vincono un benchmark. Essendo un task nativo di Ultralytics YOLO26, usa lo stesso percorso di esportazione di rilevamento, segmentazione e posa, con i seguenti formati: ONNX, TensorRT, CoreML, NCNN, LiteRT.
Per iniziare con la stima della profondità di Ultralytics YOLO26#
Il pacchetto Python di Ultralytics offre un'interfaccia unificata per addestrare, convalidare ed eseguire l'inferenza su tutti i task di YOLO26, inclusa la stima della profondità. Per eseguire un modello di profondità preaddestrato basta un solo comando:
from ultralytics import YOLO
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-depth.pt")  # carica un modello ufficiale
model = YOLO("path/to/best.pt")  # carica un modello personalizzato

# Esegui previsioni con il modello
results = model("https://ultralytics.com/images/bus.jpg")  # esegui previsioni su un'immagine

# Accedi ai risultati
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, shape (H, W), metri
Oppure dalla CLI:
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
La distanza assoluta dipende dalla fotocamera e dalla scena. Se la forma della mappa di profondità è corretta ma la scala non lo è, model.calibrate() adatta in pochi secondi due sole variabili nella testa di profondità del modello, una scala e un offset, usando circa 100 frame etichettati, senza addestramento e senza modificare il resto della rete.
Fine-tuning sui tuoi dati#
Per adattare un modello di profondità preaddestrato alla tua fotocamera o al tuo dominio, parti dai pesi preaddestrati, usa AdamW e imposta un tasso di apprendimento molto inferiore al valore predefinito per l'addestramento da zero, così il fine-tuning perfeziona il modello invece di sovrascriverlo:
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # parti dai pesi preaddestrati
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100 volte inferiore al valore predefinito per l'addestramento da zero
    warmup_bias_lr=1e-4,  # mantieni graduale anche il warmup
)
Poiché la testa logaritmica predefinita non ha limiti, il modello funziona subito sia con dataset a distanza ravvicinata sia con dataset a lunga distanza, senza dover ricorrere a max_depth per il fine-tuning. Se per la tua fotocamera è errata solo la scala assoluta, model.calibrate() calcola in pochi secondi una correzione leggera in forma chiusa su un piccolo sottoinsieme etichettato, senza modificare i pesi della rete.
Nei dataset, ogni immagine RGB è associata a un file di profondità .npy in una struttura di cartelle corrispondente. Ultralytics include configurazioni predefinite per NYU Depth V2, KITTI, Hypersim, SUN RGB-D e ARKitScenes, così la maggior parte dei team può iniziare subito la convalida su un benchmark standard.
Principali casi d'uso della stima della profondità#
Poiché questa nuova funzionalità può usare una singola fotocamera convenzionale, la stima monoculare della profondità apre innumerevoli possibilità per prodotti e settori che altrimenti non potrebbero giustificare i costi, il consumo energetico o l'onere di calibrazione di un sistema stereo o LiDAR. Vediamo alcuni settori e casi d'uso che possono trarre vantaggio da questa funzionalità:
- Robotica e navigazione autonoma. I robot mobili e i droni possono stimare la distanza dagli ostacoli e lo spazio libero usando una sola fotocamera a bordo, supportando la pianificazione del percorso in tempo reale senza hardware dedicato alla stima della profondità.
- Monitoraggio industriale e logistico. Verifica delle distanze di sicurezza, rilevamento dello spazio libero e analisi del contesto di scaffali o corsie con una sola fotocamera fissa, nei casi in cui aggiungere un secondo sensore non sia pratico.
- Monitoraggio della sicurezza e della conformità. Zone di sicurezza per carrelli elevatori e magazzini, rilevamento di incidenti ferroviari, rilevamento di persone cadute e oggetti dimenticati tramite sistemi CCTV esistenti: il contesto della distanza si aggiunge ai flussi video delle fotocamere già installate, affiancando i sensori di sicurezza certificati esistenti anziché sostituirli.
- Ispezione di infrastrutture e beni. Analisi della distanza dai cavi aerei, ispezione di beni e corrosione tramite droni e rilievi aerei, in contesti in cui la stessa famiglia di modelli deve gestire sia dettagli ravvicinati sia scene a lunga distanza.
- Assistenza alla guida e percezione automobilistica. L'output di profondità senza limiti e a lunga distanza consente alla stessa famiglia di modelli di gestire sia scene in interni a distanza ravvicinata sia scene di guida a oltre 80 m.
- AR e contenuti spaziali. Per collocare oggetti virtuali in modo realistico in una scena reale o applicare effetti che tengano conto della profondità, è necessario sapere quanto dista effettivamente dalla fotocamera ogni pixel.
Portare la stima della profondità in ogni deployment di Ultralytics YOLO26#
Ora che la stima della profondità è un task nativo di Ultralytics YOLO26, i team possono sfruttare la distanza per ogni pixel acquisita da qualsiasi fotocamera RGB in diversi settori, usando lo stesso flusso di lavoro di train, val, predict ed export già noto per rilevamento, segmentazione e posa, e mantenendo una dipendenza di terze parti in meno.
Quando definisci il tuo deployment con la stima della profondità di Ultralytics YOLO26, tieni presenti alcuni punti importanti:
- Ultralytics YOLO Depth è progettato per le fotocamere RGB. Funziona con qualsiasi fotocamera standard, incluse webcam, telefoni, fotocamere industriali e droni. Altre modalità, come nuvole di punti LiDAR, radar, sonar, bande termiche e multispettrali, nonché dati mesh e IFC, non rientrano tuttavia nel formato di input del modello.
- Distanza metrica per le decisioni di percezione. L'output è una distanza reale in metri, quindi è particolarmente adatto alla navigazione, alla verifica delle distanze di sicurezza e al monitoraggio. Tuttavia, per le applicazioni che richiedono una tolleranza certificata, lo strumento più adatto resta un'apparecchiatura metrologica dedicata.
- Inferenza per immagine. La stima della profondità viene eseguita separatamente su ciascun frame, come per tutti gli altri task di Ultralytics YOLO26, e può quindi essere integrata in una pipeline esistente basata su singoli frame senza apportare modifiche. L'elaborazione di una sequenza resta a carico del livello applicativo.
- Ultralytics YOLO26-Depth dà i risultati migliori sulle superfici opache e ricche di texture. Vetro, specchi, acqua stagnante, metallo lucidato e cielo aperto sono intrinsecamente ambigui per qualsiasi metodo basato su una sola fotocamera, quindi è opportuno convalidare il modello su scene rappresentative del tuo ambiente.
Ti interessa l'IA per la visione? Scopri le nostre opzioni di licenza per portare la computer vision nei tuoi progetti. Visita il nostro repository GitHub per scoprire tutti i task e le integrazioni di Ultralytics, e dai un'occhiata a Ultralytics Platform per iniziare a creare i tuoi flussi di lavoro end-to-end per l'IA per la visione.









