自動アノテーションでのGPT-6.2 SolとAstra:スコアは僅差、強みは異なる
GPT-6.2 SolとAstraは36種類の検出データセットでそれぞれ0.551と0.546 mAP50を記録しましたが、Solの料金は画像1,000枚あたり$8.10で、Astraの$31.88を大きく下回ります。どちらを使うべきかをご紹介します。
 Glenn Jocher12 分で読めます
OpenAIは2026年11月17日にGPT-6.2 AstraとGPT-6.2 Solをリリースし、Astraを最も高性能なモデル、Solを日常業務向けの標準モデルと説明しました。バウンディングボックスを描画するよう依頼したところ、精度は僅差でした。料金には大きな差がありました。
リリース当日に、両モデルを36種類の検出データセットを使ったUL37 ベンチマークで評価しました。GPT-6.2 Solは0.551 mAP50、GPT-6.2 Astraは0.546を記録し、50モデルを掲載したVLMリーダーボードでそれぞれ4位と5位でした。Solの料金は画像1,000枚あたり$8.10でした。Astraは$31.88で、ほぼ4倍でした。
現在、Ultralytics Platformの自動アノテーションでは、OpenAIの選択肢として両モデルを利用できます。GPT-6.1 SolとGPT-6 Astraに代わるモデルです。以下では両モデルを比較し、それぞれの強み、ラベリングバッチの料金、そしてOpenAIのGPT-6.1 Terraが依然として適した選択肢となる場合を解説します。
GPT-6.2 SolとAstraのUL37スコアの差は約0.005です#
UL37は、医療スキャンや航空画像から、小売店の棚、スポーツ、文書、回路基板まで幅広い分野を網羅する36種類の実世界の物体検出データセットから各10枚ずつ選んだ計360枚の画像を用いて、モデルのボックスが人手で付与されたラベルとどれほど一致するかを測定します。各画像は、Platformユーザーが利用するものと同じ本番パイプラインを通り、各データセット固有のクラス名とSAM 3.1を用いて各ボックスが調整されるため、スコアはモデルの生の出力ではなく、調整後の本番パイプラインの性能を示します。評価手法は公開されています。
2026年11月17日更新のUltralytics VLMリーダーボードにおけるUL37の結果。
今回の評価では、両モデルの精度は僅差でした。ボックスの位置精度を評価するmAP50-95の差は0.001、適合率の差は0.003です。Solはラベル付けされた物体をわずかに多く検出します。再現率は0.643で、リーダーボードに掲載された50モデル中で最も高く、Gemini 4 Carbonの0.642をわずかに上回ります。また、上位7モデルの中で最も高速で、画像1枚あたり3.4秒です。
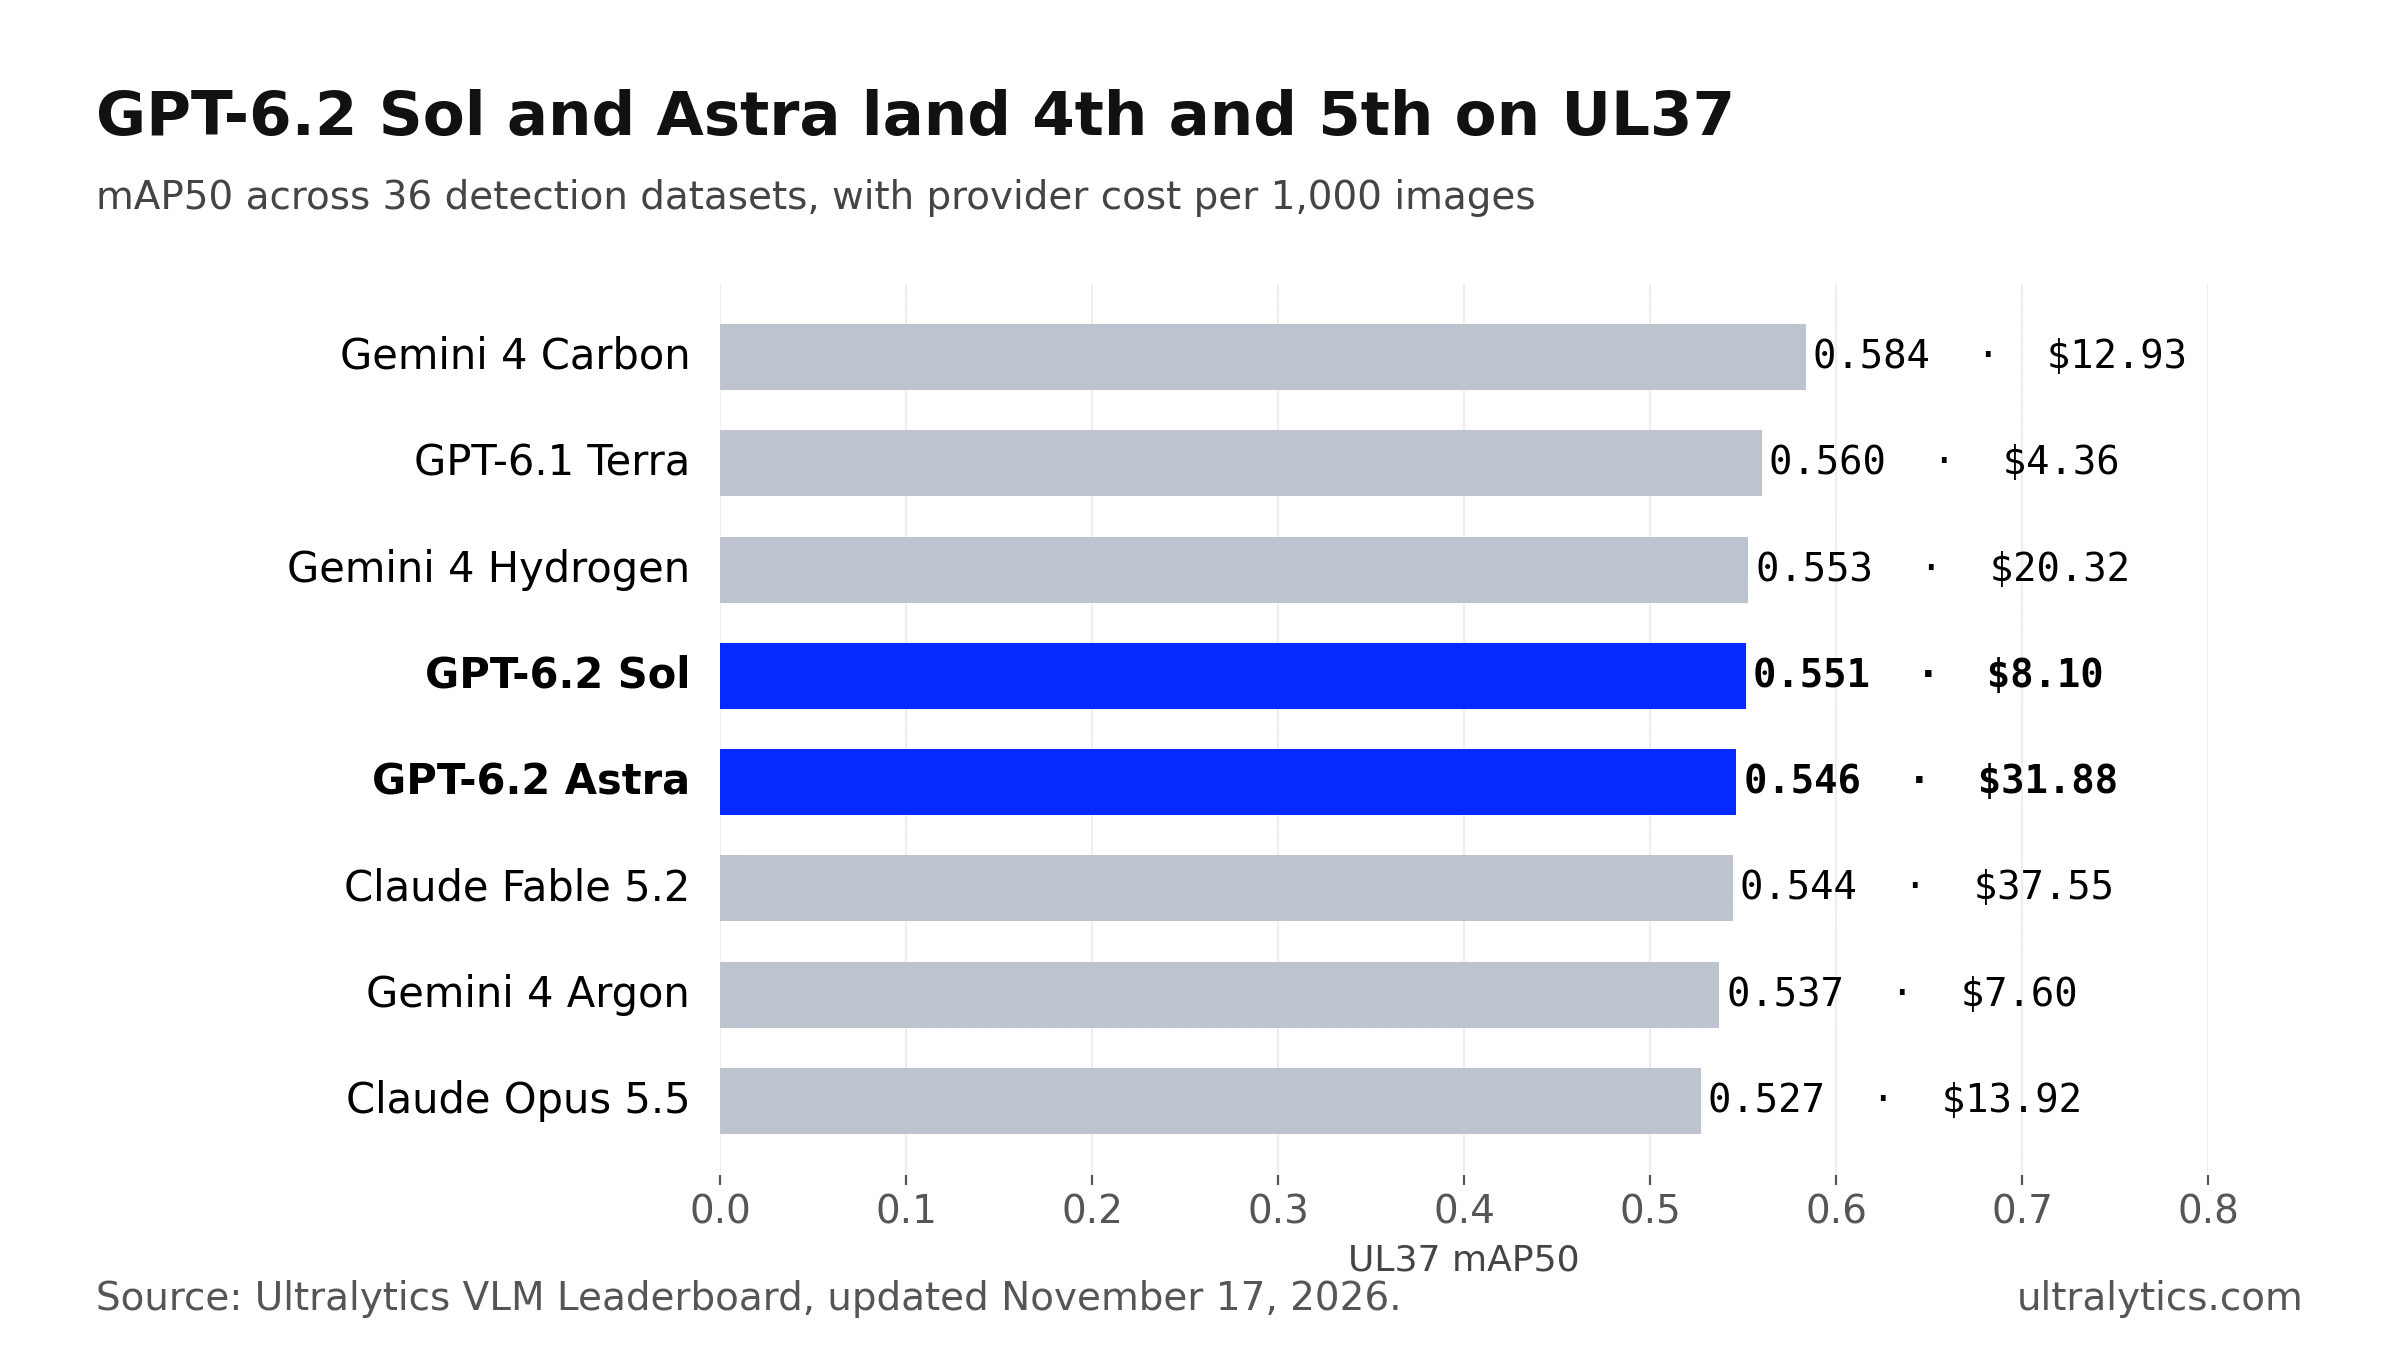
UL37でスコアが最も高かった8モデルと、画像1,000枚あたりのプロバイダー料金。
OpenAIがGPT-6.2を開発した目的#
OpenAIは、2つのモデルを異なる用途向けに位置付けています。変更履歴では、GPT-6.2 Astraを「高度な推論やコーディングタスク向け」、GPT-6.2 Solを「日常的なコーディングやエージェントワークフロー向け」と推奨しています。どちらもテキストと画像を入力として受け付け、テキストを出力します。また、Responses APIとChat Completionsの両方で利用できます。
料金にもこの違いが反映されています。OpenAIのモデルページによると、GPT-6.2 Solの料金は入力トークン100万個あたり$2、出力トークン100万個あたり$10です。GPT-6.2 Astraはそれぞれ$8と$40です。Astraのトークン料金はSolのちょうど4倍です。
どちらも専用の検出器ではなく汎用モデルのため、物体検出での性能を測定しました。Platformは、OpenAIの全モデルに送信するものと同じボックスのリクエストを使い、OpenAIのデフォルトの推論強度で両モデルを実行します。
Astraはより多くのデータセットで優位ですが、平均値を左右するのは1つの超音波データセットです#
平均スコアでSolが優位だからといって、勝つ頻度が高いとは限りません。36種類のデータセットで直接比較すると、Astraのスコアが高かったのは17種類、Solは15種類で、4種類は引き分けです。
この違いは1つのデータセットで説明できます。各ボックスに良性または悪性のラベルも付与されるTN5000甲状腺超音波では、Solのスコアは0.995、Astraは0.769です。この結果だけでSolの平均値は約0.006上がります。TN5000を除外すると、平均値はSolが0.539、Astraが0.540になります。
このベンチマークでは、両モデルの精度は僅差であり、より明確な違いは対応領域と料金です。
GPT-6.2 SolとAstraがそれぞれ優位な領域#
領域ごとの平均では、UL37の12領域のうち7領域でAstra、4領域でSolが優位で、セキュリティX線は引き分けです。
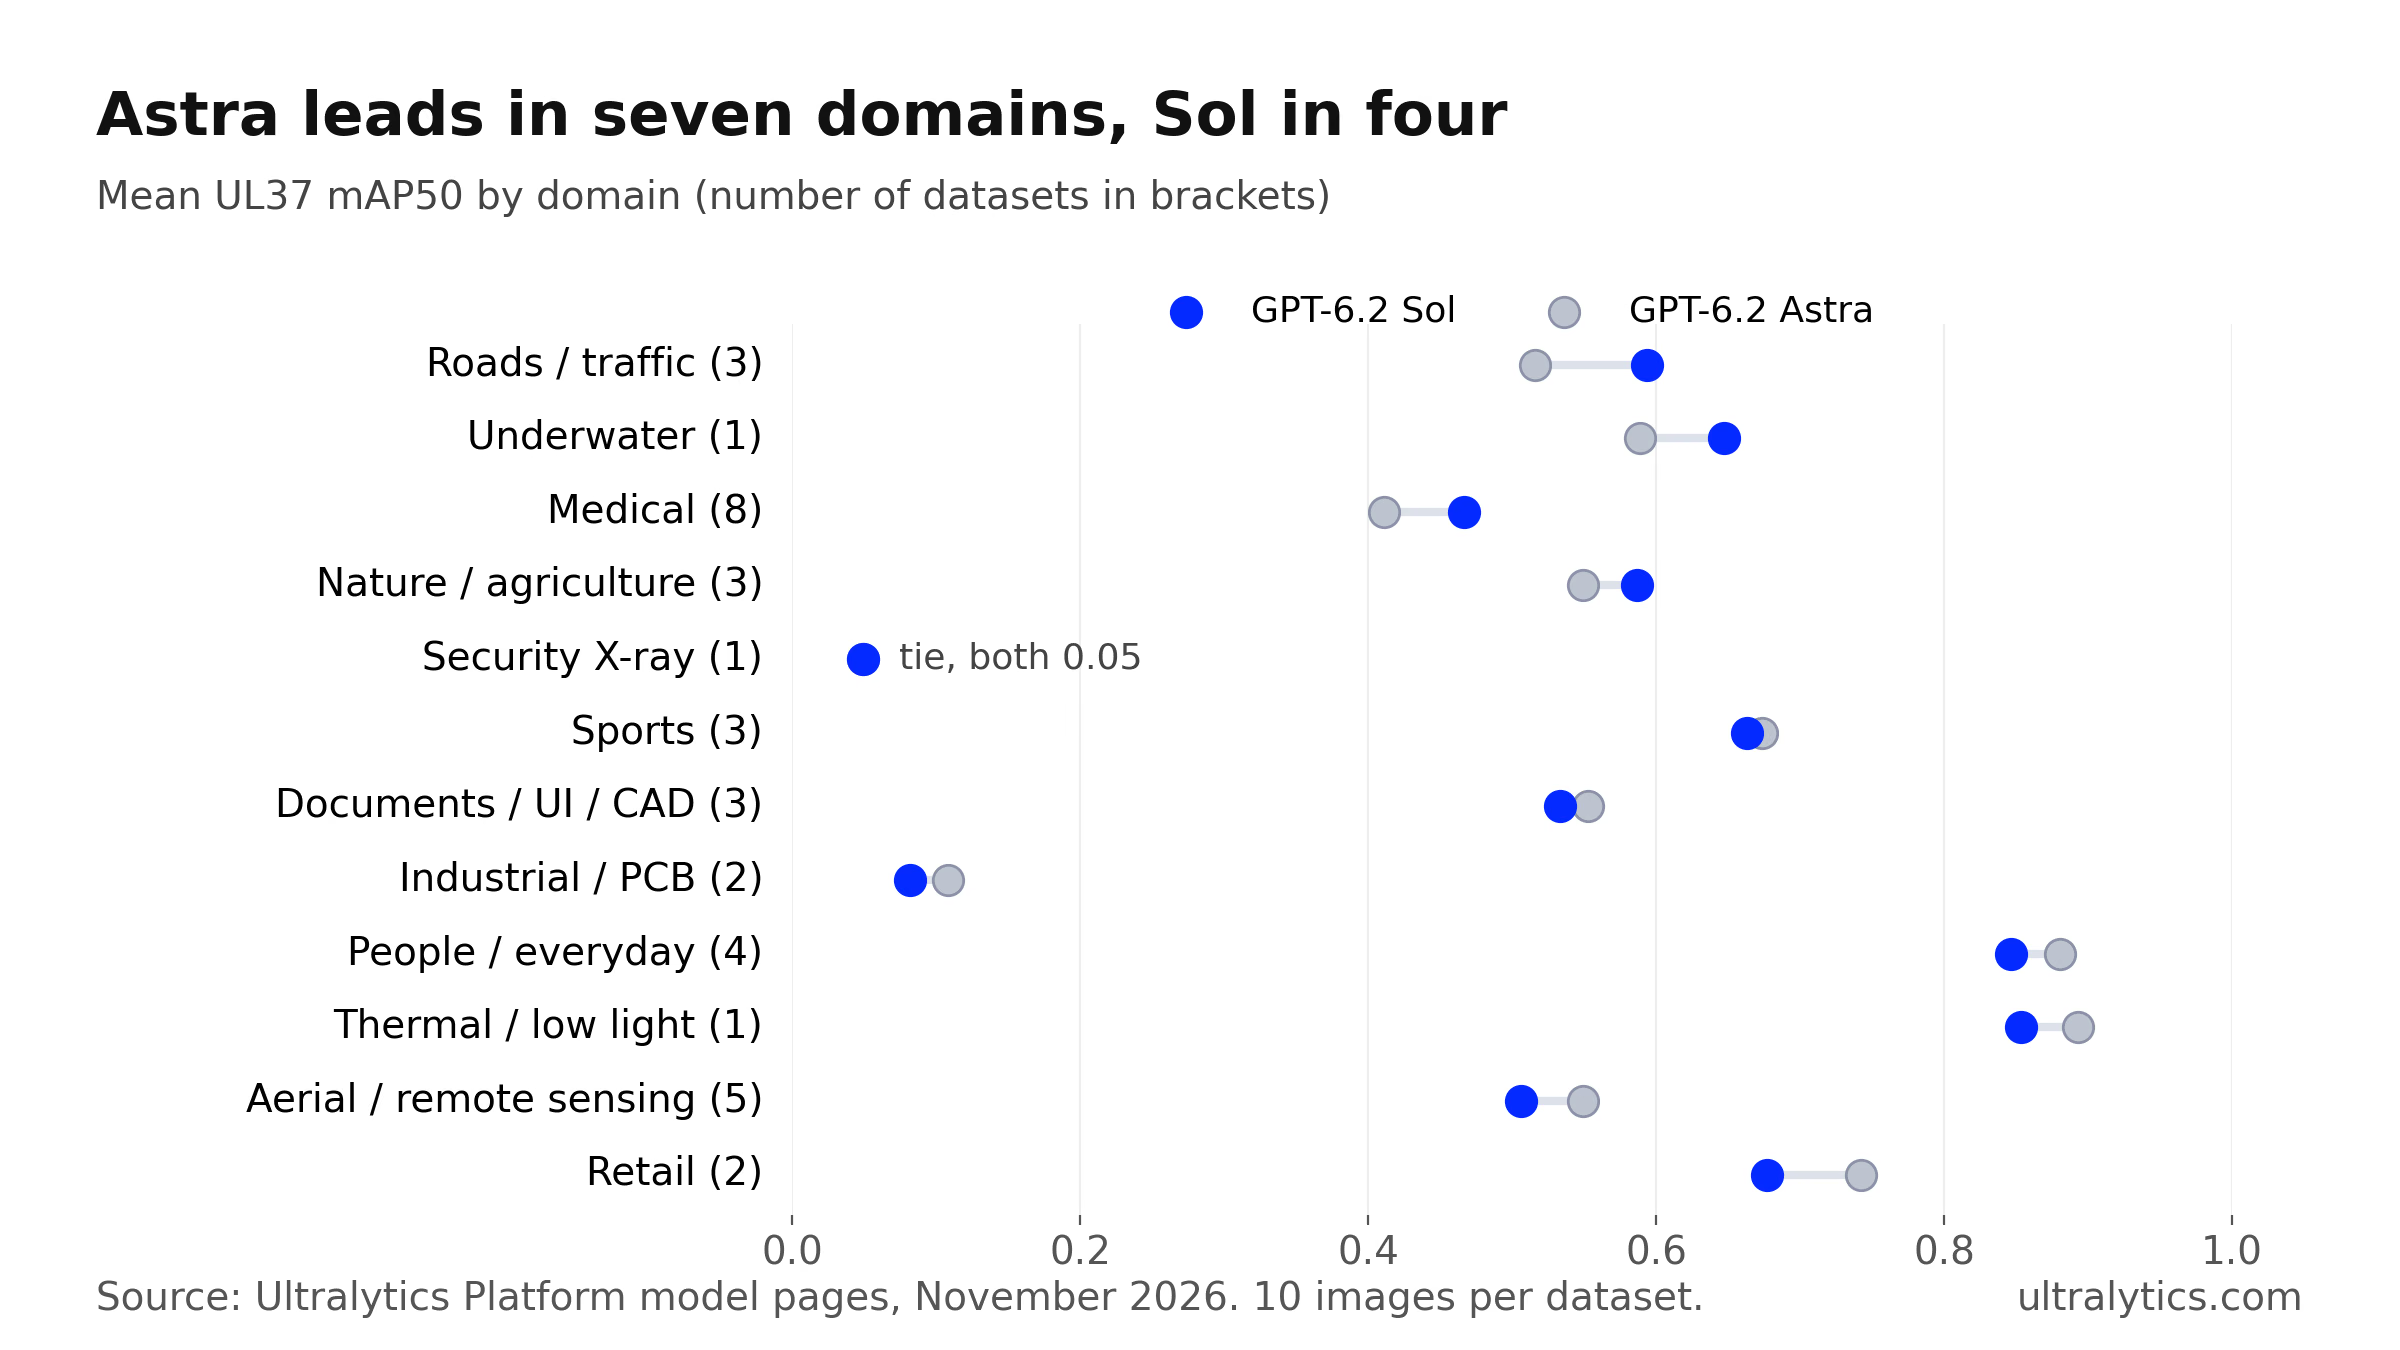
各領域には1~8種類のデータセットが含まれ、データセットごとに画像を10枚使用しています。
GPT-6.2 Solは医療、道路、自然画像に強みがあります。 医療分野の8種類のデータセットの平均は0.466で、Astraの0.411を上回ります。TN5000に加え、結腸ポリープを対象とするKvasir-SEGでも、Astraの0.707に対して0.805を記録しました。GWHDの小麦の穂では、Astraの0.537に対して0.684です。CeyMoの道路標示では、Astraの0.705に対して0.843です。
GPT-6.2 Astraは航空、小売、文書、人の画像に強みがあります。 航空分野の5種類のデータセットの平均は0.550で、Solの0.506を上回ります。これは、SSDDのレーダー画像に含まれる船舶で、Solの0.749に対して0.880を記録したことなどが要因です。RPCのレジでの商品ではSolの0.823に対して0.978を記録し、PPE、ゴミ、バスケットボールの検出でも優位です。
| データセット | 分野 | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| TN5000甲状腺超音波 | 医療 | 0.995 | 0.769 |
| GWHD小麦の穂 | 自然/農業 | 0.684 | 0.537 |
| CeyMo道路標示 | 道路/交通 | 0.843 | 0.705 |
| SoccerDB | スポーツ | 0.748 | 0.631 |
| RPC小売レジ | 小売 | 0.823 | 0.978 |
| バスケットボールとゴール | スポーツ | 0.726 | 0.872 |
| PlantDoc植物病害 | 自然/農業 | 0.302 | 0.447 |
| SSDD SAR船舶 | 航空/リモートセンシング | 0.749 | 0.880 |
UL37 mAP50で、各モデルが相手を最も大きく上回った4項目。
各データセットに含まれる画像は10枚のため、単一のスコアは判定ではなく、テストを行うための指標として捉えてください。大規模なデータセットにラベルを付ける前に、GPT-6.2 SolとGPT-6.2 Astraのモデルページを開くと、各モデルが記録したすべてのベンチマークデータセットのボックスを、期待されるラベルと並べて確認できます。
GPT-6.1 SolとGPT-6 Astraから大幅に進歩しましたが、回路基板は例外です#
Platformで置き換えられるモデルと比べると、どちらも精度と速度が向上し、画像あたりの料金も下がっています。
| mAP50 | 1,000枚あたりのコスト | 画像1枚あたりの中央値 | |
|---|---|---|---|
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6.2 Sol | 0.551 | $8.10 | 3.4秒 |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
| GPT-6.2 Astra | 0.546 | $31.88 | 4.3秒 |
GPT-6.2 Solは36種類のデータセットのうち23種類でGPT-6.1 Solを上回り、12種類で下回ります。また、約3倍高速です。画像あたりの料金は21%低下していますが、トークン料金は変わりません。GPT-6.2 Astraは24種類でGPT-6 Astraを上回り、11種類で下回ります。画像あたりの料金は35%低下し、トークン料金も安くなっています。OpenAIの記載によると、GPT-6 Astraの料金はトークン100万個あたり$10と$50です。
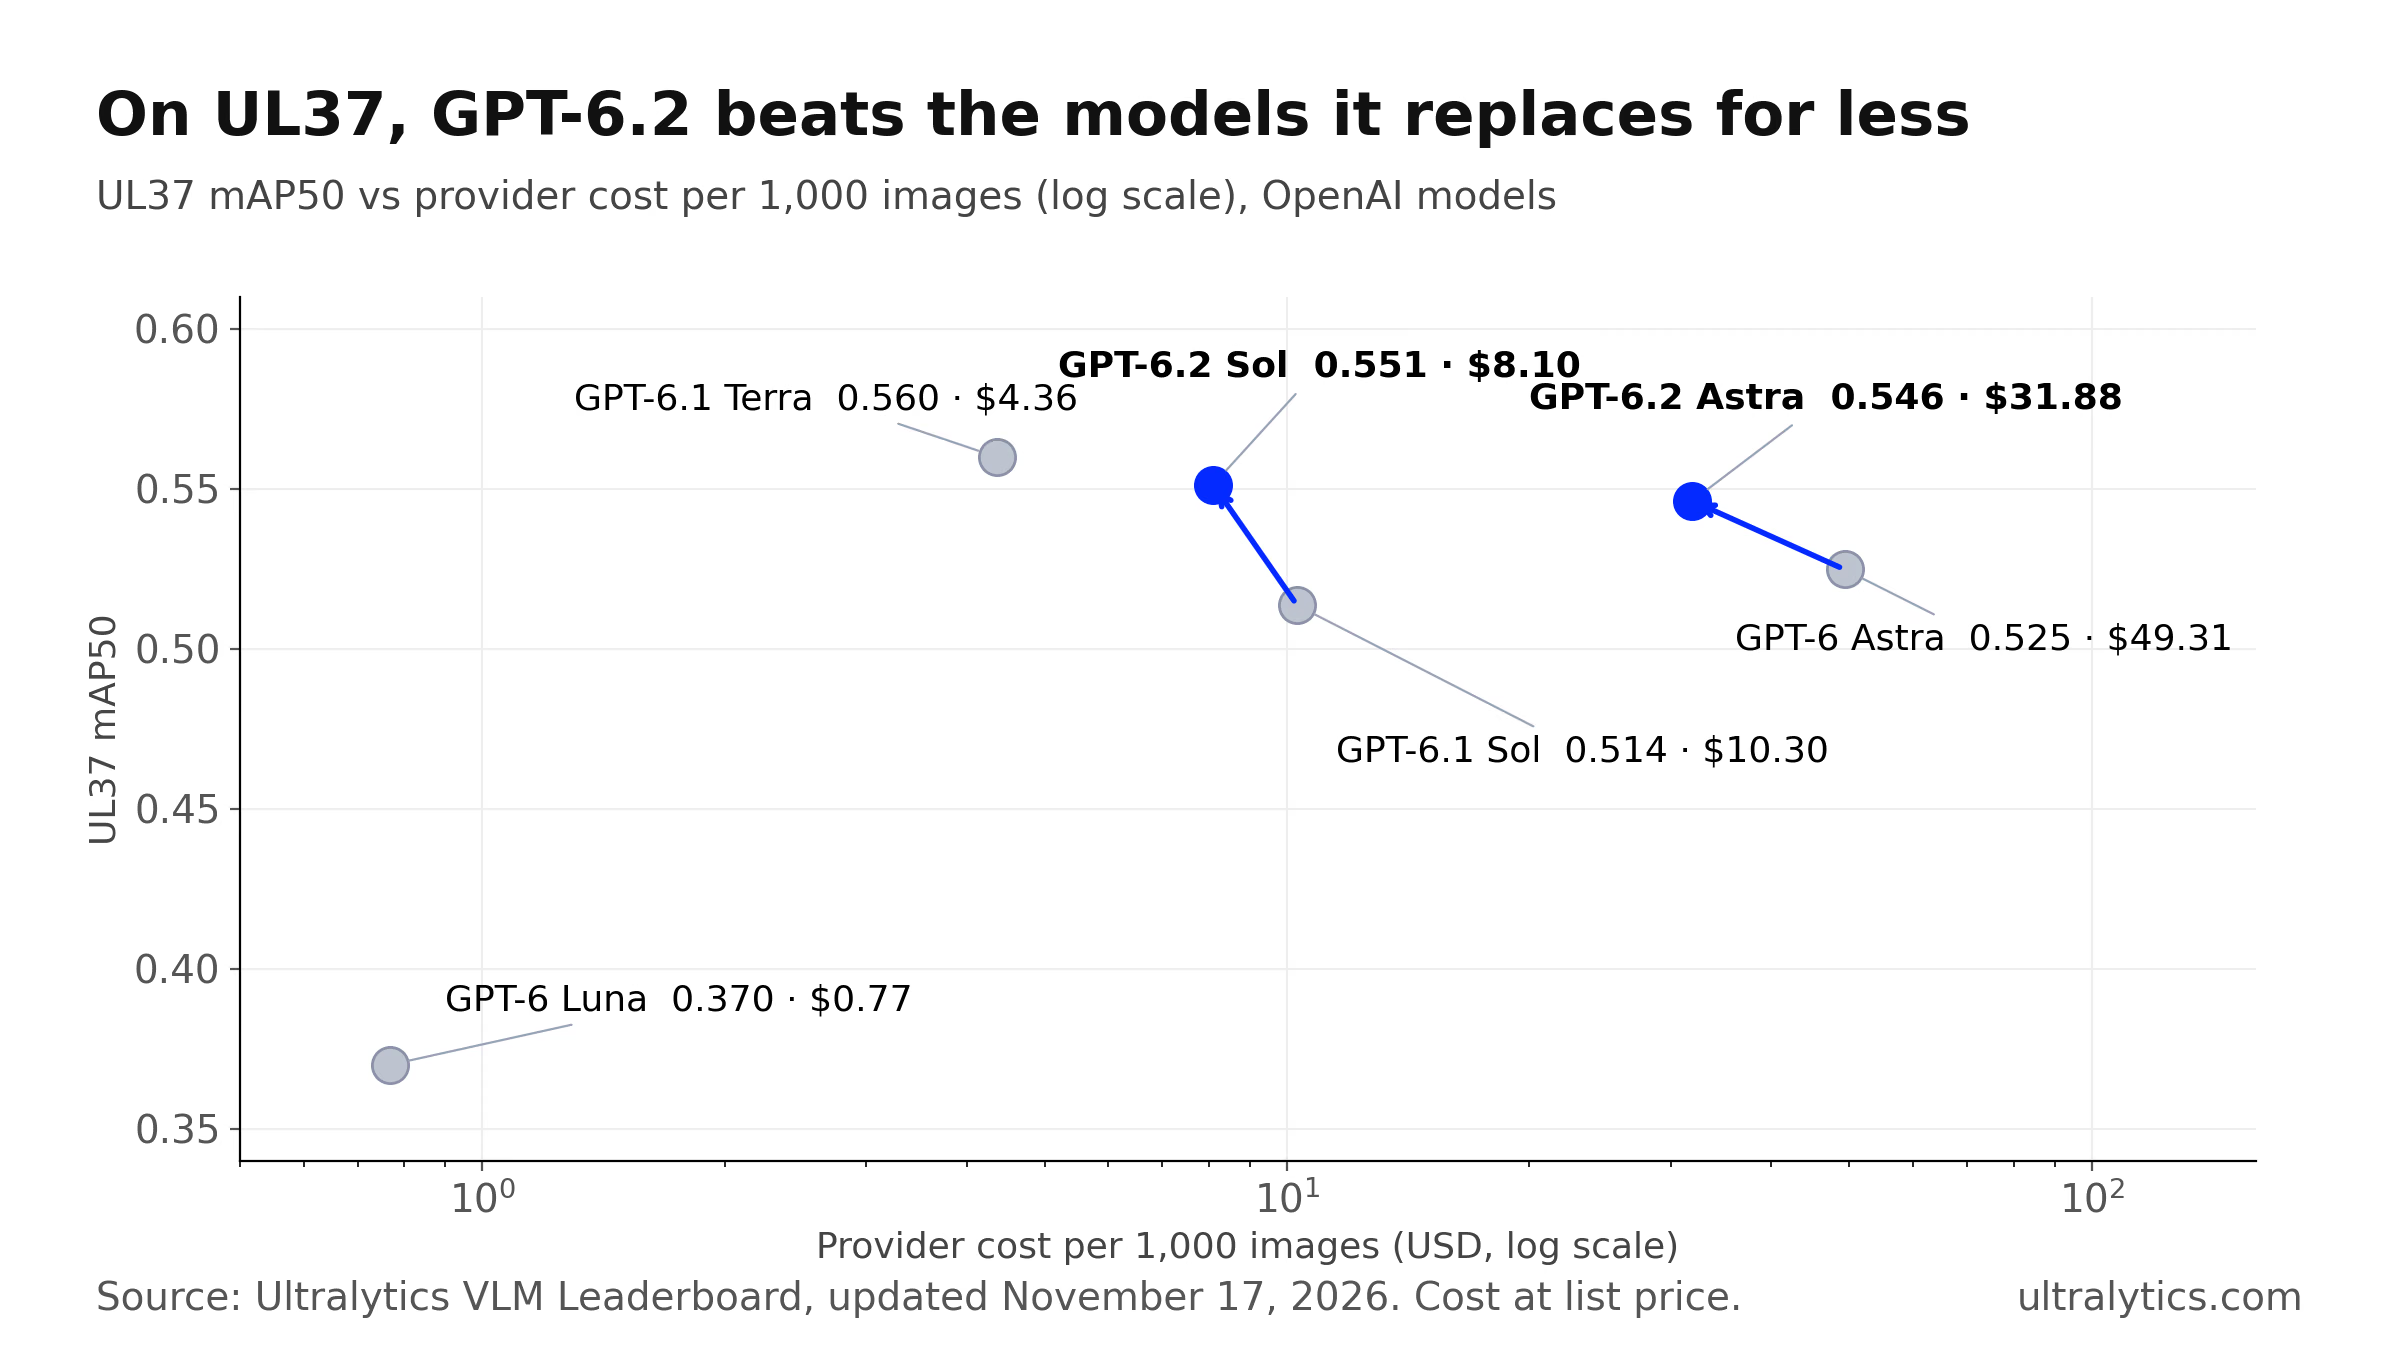
矢印は各GPT-6.2モデルと、Ultralytics Platformで置き換えられるモデルとの比較を示しています。
例外は回路基板です。DeepPCBの基板むき出し状態の欠陥では、GPT-6.2の両モデルが0.000で、GPT-6.1 Solの0.393を下回りました。DsPCBSD+の表面欠陥では、Solのスコアは0.392から0.164に低下し、Astraは0.216でした。セキュリティX線画像でも弱く、IEDXrayでは両モデルとも0.05で、Gemini 4 Argonの0.30を大きく下回ります。データがPCB検査やセキュリティ検査向けの場合は、導入を決める前にサンプルで他のモデルをテストしてください。
UL37ではGPT-6.1 Terraが現在もOpenAIの最良のアノテーションモデルです#
新しい2モデルのいずれも、GPT-6.1 Terraを上回っていません。Terraは画像1,000枚あたり$4.36で0.560 mAP50を記録し、リーダーボードで2位を維持しています。TerraとGPT-6.2 Solはそれぞれ17種類のデータセットで優位で、引き分けは2種類です。そのため、差はわずかです。Terraの適合率は0.646で、Solの0.623を上回り、料金は約半分です。Solはより多くの物体を検出し、応答も速く、画像1枚あたり3.4秒です。Terraは5.1秒です。
リーダーボードの首位では、Gemini 4 Carbonが画像1,000枚あたり$12.93で0.584 mAP50を記録し、引き続き優位です。GPT-6.1 Terraの結果とGemini 4 Carbonの結果では、これらのモデルを詳しく取り上げています。
GPT-6.2でアノテーションバッチを実行する場合の料金#
プロバイダー料金は、OpenAIが報告するトークン使用量に基づき、通常料金で計算しています。実際の画像で使用されるトークン数は、これより多い場合も少ない場合もあります。Batch Annotationでは、Platformの処理料金として画像1,000枚あたり$1.00が加算され、1回の実行につき最低$0.01が適用されます。
| 画像1,000枚あたり | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| OpenAIの料金 | $8.10 | $31.88 |
| Ultralytics Platformの処理料金 | $1.00 | $1.00 |
| 合計 | $9.10 | $32.88 |
最初に実行するテスト予測の料金も含め、OpenAIへの支払いはご自身のAPIキーを使って直接行います。Ultralyticsはトークン料金に上乗せしません。画像1万枚のデータセットの場合、Solでは約$91、Astraでは約$329です。
Ultralytics PlatformでGPT-6.2 SolまたはAstraの自動アノテーションを実行する方法#
GPT-6.2 SolとAstraは、クラス数が1~200の検出データセット向けに、クラス名をプロンプトとして指定するモデルです。データセット固有のクラス名に対応するバウンディングボックスを返し、保存する前に内容を確認できます。
- OpenAI APIキーのページでキーを作成します。
- データセットが保存されているPlatformワークスペースで、ワークスペースのオーナーにSettings > API KeysからAPIキーを追加してもらいます。詳しくはプロバイダーキーのドキュメントをご覧ください。
- アノテーションエディターでSmartモードに切り替え、モデル選択メニューのOpenAIからGPT-6.2 SolまたはGPT-6.2 Astraを選択します。
- データを代表する数枚の画像でPredictまたは
Pを実行し、同じ画像を使って2つのモデルを比較します。 - 結果に問題がなければ、データセットページを開き、More actions > Batch Annotationを選択して、未ラベルの画像すべてにラベルを付けます。Batch Annotationは、画像チャンネルが最大3つのPlatformホスト型データセットに対応します。Platformは先にデータセットのバージョンを保存するため、必要に応じて元に戻せます。
- ボックスを確認して保存し、同じワークスペースで結果を使ってUltralytics YOLO26モデルをトレーニングします。
アノテーションのドキュメントではSmartモードとBatch Annotationについて詳しく説明しています。また、適合率と再現率に基づいてVLMを選ぶガイドは、モデルをレビューのワークフローに合わせる際に役立ちます。
GPT-6.2 Sol、GPT-6.2 Astra、GPT-6.1 Terra:どれを選ぶべきか#
| 必要なものが… | まずは次から |
|---|---|
| 低コストで使える汎用的なOpenAIアノテーションモデル | GPT-6.1 Terra:3モデル中でUL37スコアが最も高く、料金はSolの約半分です |
| 速度、または検出物体数の最大化 | GPT-6.2 Sol:画像1枚あたり3.4秒で、リーダーボード最高の再現率です |
| 医療、道路、農業の画像 | GPT-6.2 Solを使い、医療データではTerraも確認します |
| 航空、小売のレジ、文書、またはPPEの画像 | GPT-6.2 Astra:自分のデータでの精度向上が、Solの約4倍の料金に見合う場合に適しています |
| PCBの欠陥、またはセキュリティX線画像 | まず他のモデルをテストしてください。ここではGPT-6.2の両モデルともUL37のスコアが低いです |
多くのラベリング作業では、新しい2モデルのうちGPT-6.2 Solのほうがコストパフォーマンスに優れています。AstraとUL37スコアは同程度で、料金は約4分の1です。自分の画像を使ったテストで対象領域における優位性が確認できた場合は、Astraを選んでください。
よくある質問
UL37ベンチマークではスコアは僅差です。GPT-6.2 Solは0.551 mAP50、GPT-6.2 Astraは0.546を記録し、Astraはより多くのデータセットでわずかに優位でした(17対15)。明確な違いは料金です。SolのOpenAI料金は画像1,000枚あたり$8.10で、Astraの$31.88を大きく下回ります。Solは医療、道路、自然画像で優位で、Astraは航空、小売、文書、人の画像で優位です。
はい。GPT-6.2の両モデルはUltralytics VLMリーダーボードで50モデル中トップ5に入り、リクエストの失敗はありませんでした。GPT-6.2 Solは0.643で、リーダーボード最高の再現率を記録しています。一方、両モデルとも回路基板の欠陥とセキュリティX線画像の検出は苦手です。
通常料金で報告されたトークン使用量に基づくと、OpenAI料金はGPT-6.2 Solで約$8.10、GPT-6.2 Astraで約$31.88です。Ultralytics Platformでは画像1,000枚あたり$1.00のBatch Annotation料金が加算され、合計はそれぞれ約$9.10と$32.88です。
UL37では、わずかな差で優れています。GPT-6.1 Terraは画像1,000枚あたり$4.36で0.560 mAP50を記録し、平均スコアと料金の両方でGPT-6.2の両モデルを上回ります。GPT-6.2 SolはTerraと同じ17種類のデータセットで優位で、速度が速く、より多くの物体を検出します。
平均的には、はい。GPT-6.2 Solは36種類のデータセットのうち23種類でGPT-6.1 Solを上回り、約3倍高速で、画像あたりの料金は21%低くなっています。GPT-6.2 Astraは24種類のデータセットでGPT-6 Astraを上回り、料金は35%低くなっています。回路基板の欠陥では、どちらの旧モデルもより高い性能を示しました。
Settings > API KeysからOpenAI APIキーを追加し、アノテーションエディターのSmartモードでGPT-6.2 SolまたはGPT-6.2 Astraを選択します。まず数枚の画像でテストし、その後Batch Annotationを使ってデータセット全体にラベルを付けます。ボックスを確認したら、同じワークスペースでUltralytics YOLO26モデルをトレーニングします。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









