インスタンスセグメンテーション向けにUltralytics YOLO26をカスタムトレーニングする方法
インスタンスセグメンテーション向けにUltralytics YOLO26をカスタムトレーニングする方法をご紹介します。モデルはピクセル単位のマスクを使用して、個々の物体を識別し、分離します。
近年の技術の進歩により、私たちの生活の中で目立たずとも大きな役割を果たす多くのスマートシステムが、AIによって支えられています。たとえば、車が赤信号を無視した際にカメラが自動で違反を記録するときや、生産ラインの自動品質検査システムが製造上の欠陥を検出するとき、舞台裏ではAIが処理を担っています。
特に、コンピュータービジョンとして知られるAIの一分野は、画像や動画を機械が解釈して理解できるようにします。コンピュータービジョンによって、システムは物体を認識し、動きを追跡し、視覚的な詳細をリアルタイムで分析できます。そのため、交通監視、産業検査、ロボティクスなどの用途に欠かせません。
こうした機能は、物体検出やインスタンスセグメンテーションなど、さまざまなビジョンタスクに対応するコンピュータービジョンモデル、たとえばUltralytics YOLO26によって実現されています。物体検出がシンプルなバウンディングボックスを使って物体を識別するのに対し、インスタンスセグメンテーションはさらに踏み込み、ピクセル単位で各物体の輪郭を描くため、現実の状況でより正確で信頼性の高い結果が得られます。
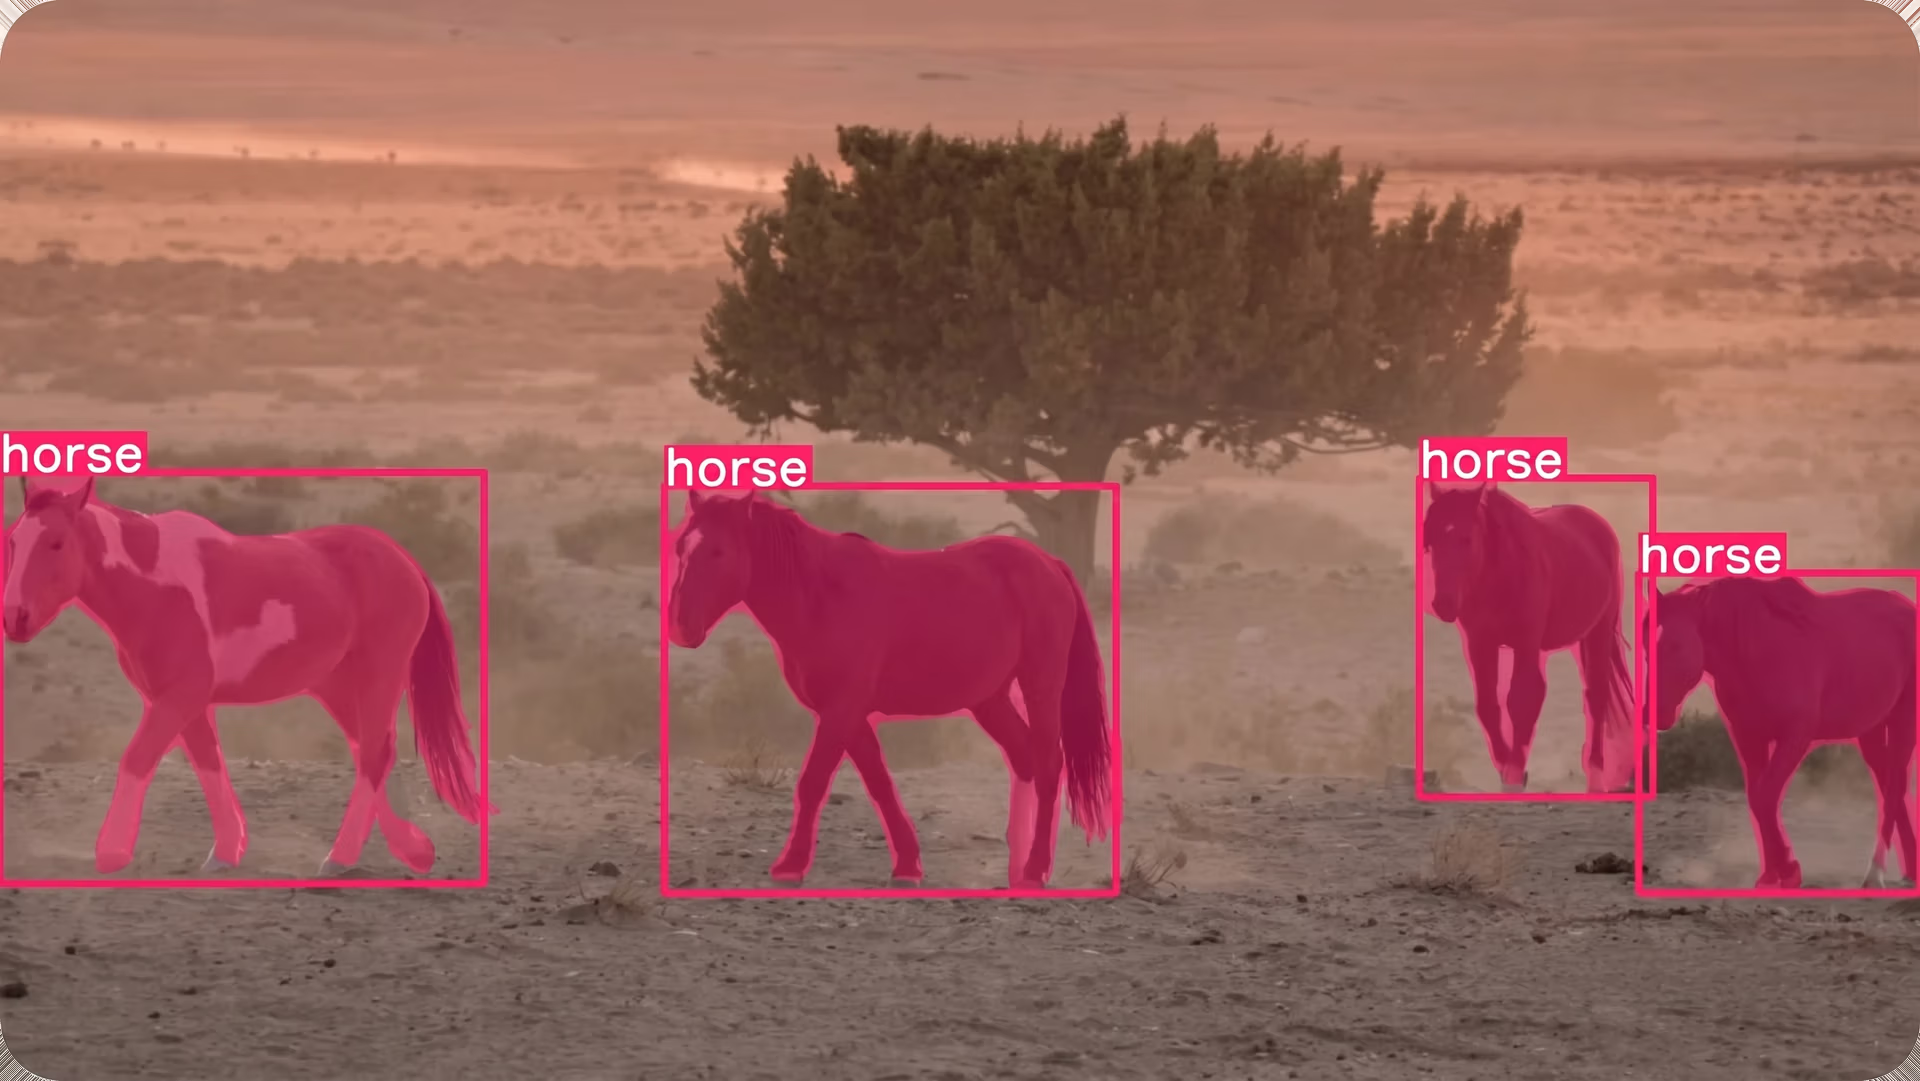
図1. Ultralytics YOLO26を使った画像内の物体のセグメンテーション
Ultralytics YOLO26のようなモデルは事前トレーニング済みで、人物、車、動物などの日常的な物体をすぐにセグメンテーションできます。一方、より特殊な用途では、独自のデータで追加トレーニングすることもできます。つまり、モデルに物体の外観と正確な輪郭の描き方を学習させられます。
この記事では、インスタンスセグメンテーション向けにUltralytics YOLO26をカスタムトレーニングする方法を説明します。さっそく始めましょう。
インスタンスセグメンテーションとは?#
モデルのトレーニングに入る前に、まずインスタンスセグメンテーションとは何かを改めて確認しましょう。
インスタンスセグメンテーションは、画像内の個々の物体をモデルが見つけ、その正確な形状の輪郭を描くコンピュータービジョンタスクです。物体の存在を識別するだけでなく、画像内のすべてのピクセルを調べ、特定の物体に属するかどうかを判定します。
これにより、物体が重なっていたり、非常に近くにあったりしても、それぞれを分離できます。インスタンスセグメンテーションを視覚的に理解するための重要な概念がマスクです。
マスクとは、物体の領域だけを覆うピクセル単位の輪郭です。蛍光ペンで物体を塗りつぶし、それ以外には手を加えないイメージです。
各物体にはそれぞれ独自のマスクが割り当てられるため、隣り合う2台の車や2人の人物のように、同じ種類の物体であってもモデルは区別できます。
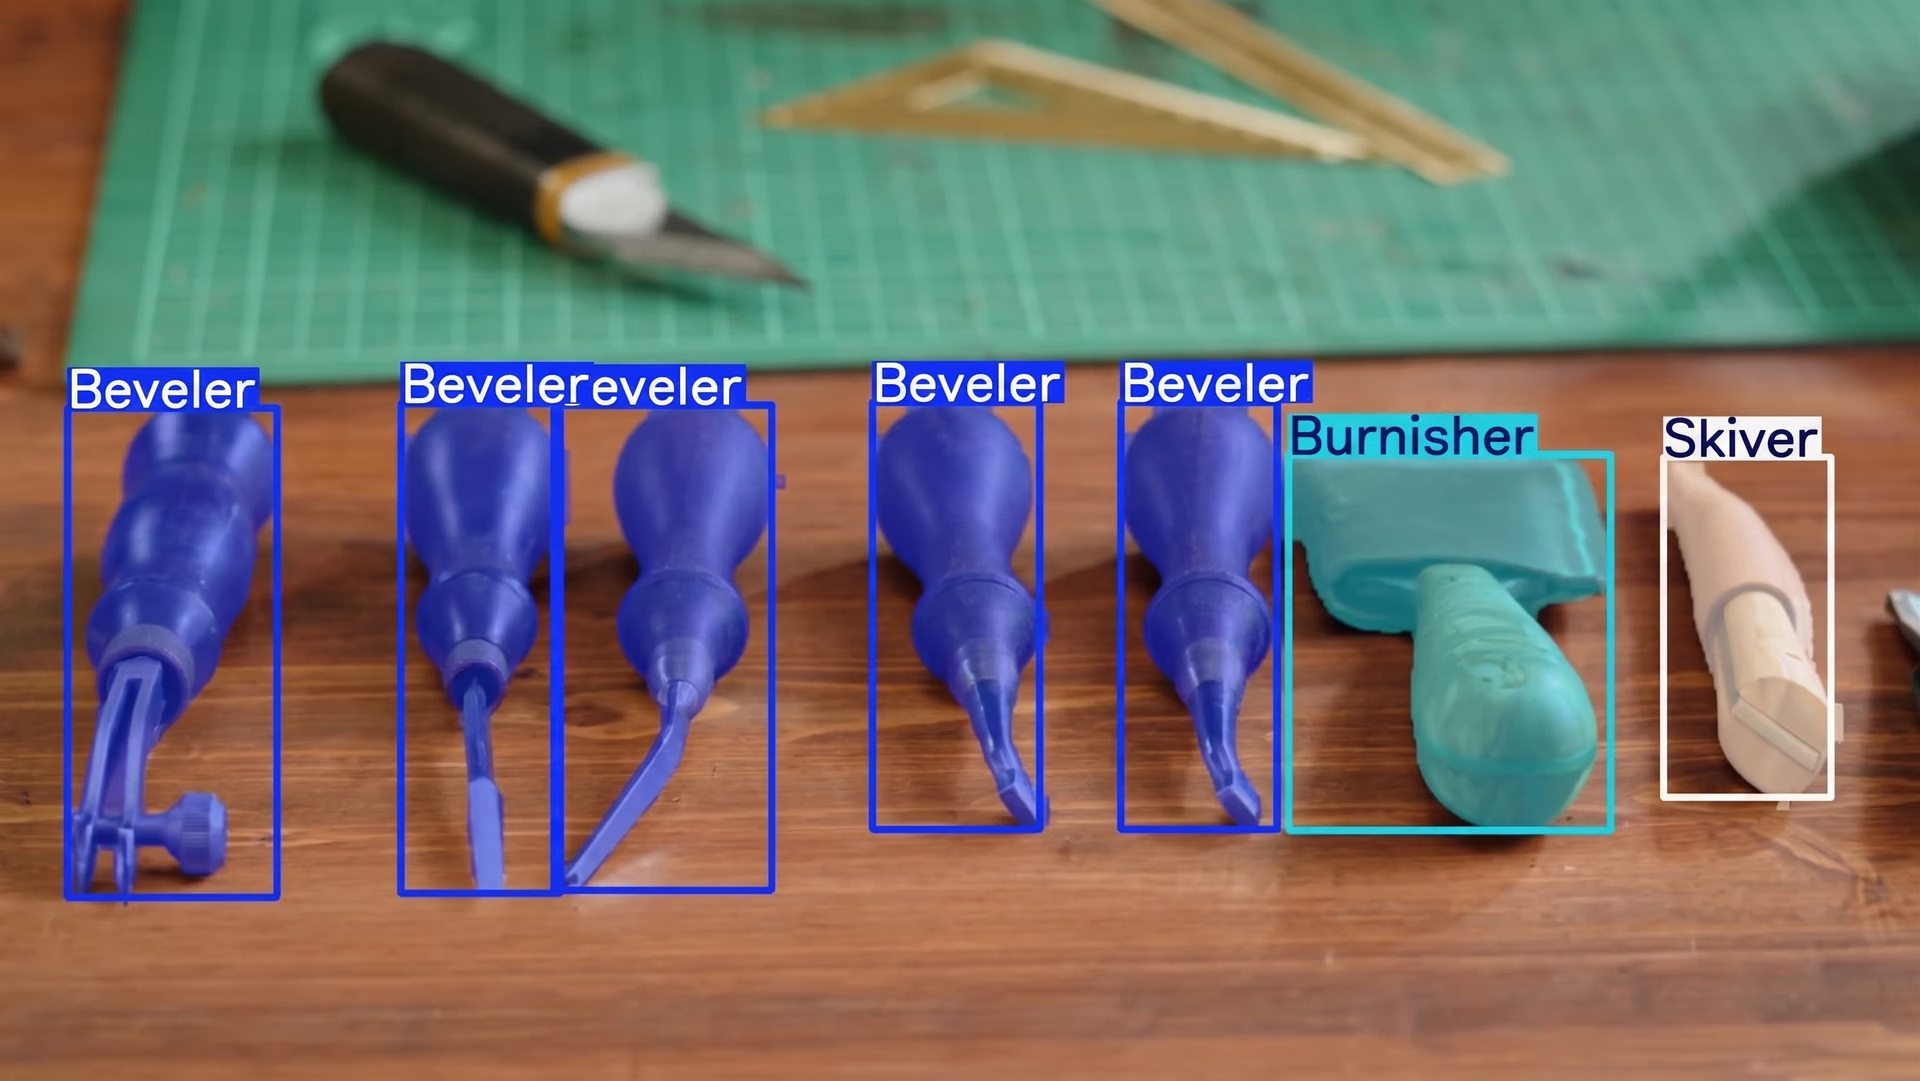
図2. インスタンスセグメンテーションの概要
インスタンスセグメンテーションをより深く理解するために、ほかの一般的なコンピュータービジョンタスクと比較してみましょう。物体検出では、物体の周囲に描画したシンプルな四角形であるバウンディングボックスを使います。バウンディングボックスは高速で便利ですが、物体の正確な形状までは捉えられません。
一方、セマンティックセグメンテーションでは、画像内のすべてのピクセルにカテゴリを割り当てますが、同じクラスの個々の物体は区別しません。インスタンスセグメンテーションは、物体のカテゴリを識別し、個々の物体に個別のマスクを割り当てることで、両方の手法の長所を組み合わせています。
インスタンスセグメンテーションは非常に詳細な情報を提供するため、自動品質検査、医用画像、ロボティクスなど、現実の用途で特に役立ちます。正確な測定、厳密な境界、物体の分離が必要なタスクでは、ピクセル単位の理解が効果を発揮します。
Ultralytics YOLO26はインスタンスセグメンテーションに対応しています#
Ultralytics YOLO26は、エンドツーエンドでNMSを使用しない最先端のコンピュータービジョンモデルであり、現実のビジョンタスクを高速かつ効率的に処理できるよう設計されています。Ultralytics YOLOの検出モデルファミリーに属し、正確な結果を提供しながら画像や動画をリアルタイムで処理できます。
Ultralytics YOLO26は、単一のフレームワークで複数のビジョンタスクに対応しており、物体検出、姿勢推定、画像分類、方向付きバウンディングボックス検出(obb検出)、インスタンスセグメンテーションを実行できます。
Ultralytics YOLO26は事前トレーニング済みで、COCOやImageNetなど、広く利用されている大規模データセットから人物、乗り物、日用品などの一般的な物体をすでに認識するよう学習されています。そのため、追加トレーニングなしですぐにモデルを使い始められます。
ただし、アプリケーションに固有の物体、特定の環境、特殊な照明条件が含まれる場合は、カスタムモデルのトレーニングによって結果を大幅に改善できます。ラベル付きの画像を使ってUltralytics YOLO26をトレーニングすることで、特定の用途に合わせて、何を探し、物体の輪郭をより正確に描く方法をモデルに教えられます。
このプロセスはファインチューニングとも呼ばれます。モデルをゼロからトレーニングするのではなく、事前トレーニング済みのUltralytics YOLO26モデルを出発点として、独自のデータを使って少しずつ適応させます。モデルはエッジ、形状、テクスチャなどの一般的な視覚パターンをすでに理解しているため、特定の物体を学習させるために必要なラベル付き画像と時間を大幅に減らせます。
つまり、ファインチューニングはモデルを一からトレーニングするよりも高速で効率的かつ取り組みやすい方法です。カスタムデータでUltralytics YOLO26をトレーニングする方法は、初心者やデータと計算リソースが限られたチームにとっても実用的な選択肢です。
Ultralytics YOLO26のインスタンスセグメンテーションの活用例#
では、インスタンスセグメンテーションはどのような場面で役立つでしょうか。物体を区別し、正確な形状を把握することが重要となる状況、特に物体が密集したり重なったりする場合に効果を発揮します。
インスタンスセグメンテーションが大きな効果をもたらす一般的なワークフローをいくつか紹介します。
- 航空・ドローン画像: このタスクを使うと、ドローンで撮影した航空画像から建物、車両、植生などを分離し、地図作成、点検、測量に活用できます。
- スポーツ分析: インスタンスセグメンテーションを使うと、試合中やトレーニング中に個々の選手を背景から分離し、選手の動きや相互作用を分析できます。
- 建設・インフラ監視: 建物、橋、道路の構造要素、ひび割れ、損傷箇所を特定し、保守計画の策定に役立てられます。
- ヘルスケア・医用画像: インスタンスセグメンテーションを使うと、細胞、組織、医療器具の輪郭を正確に描き、より精度の高い分析と診断を支援できます。
- 農業・環境監視: 作物、果物、植物の病気を識別して分離できるため、収穫量の推定や対象を絞った処置が容易になります。
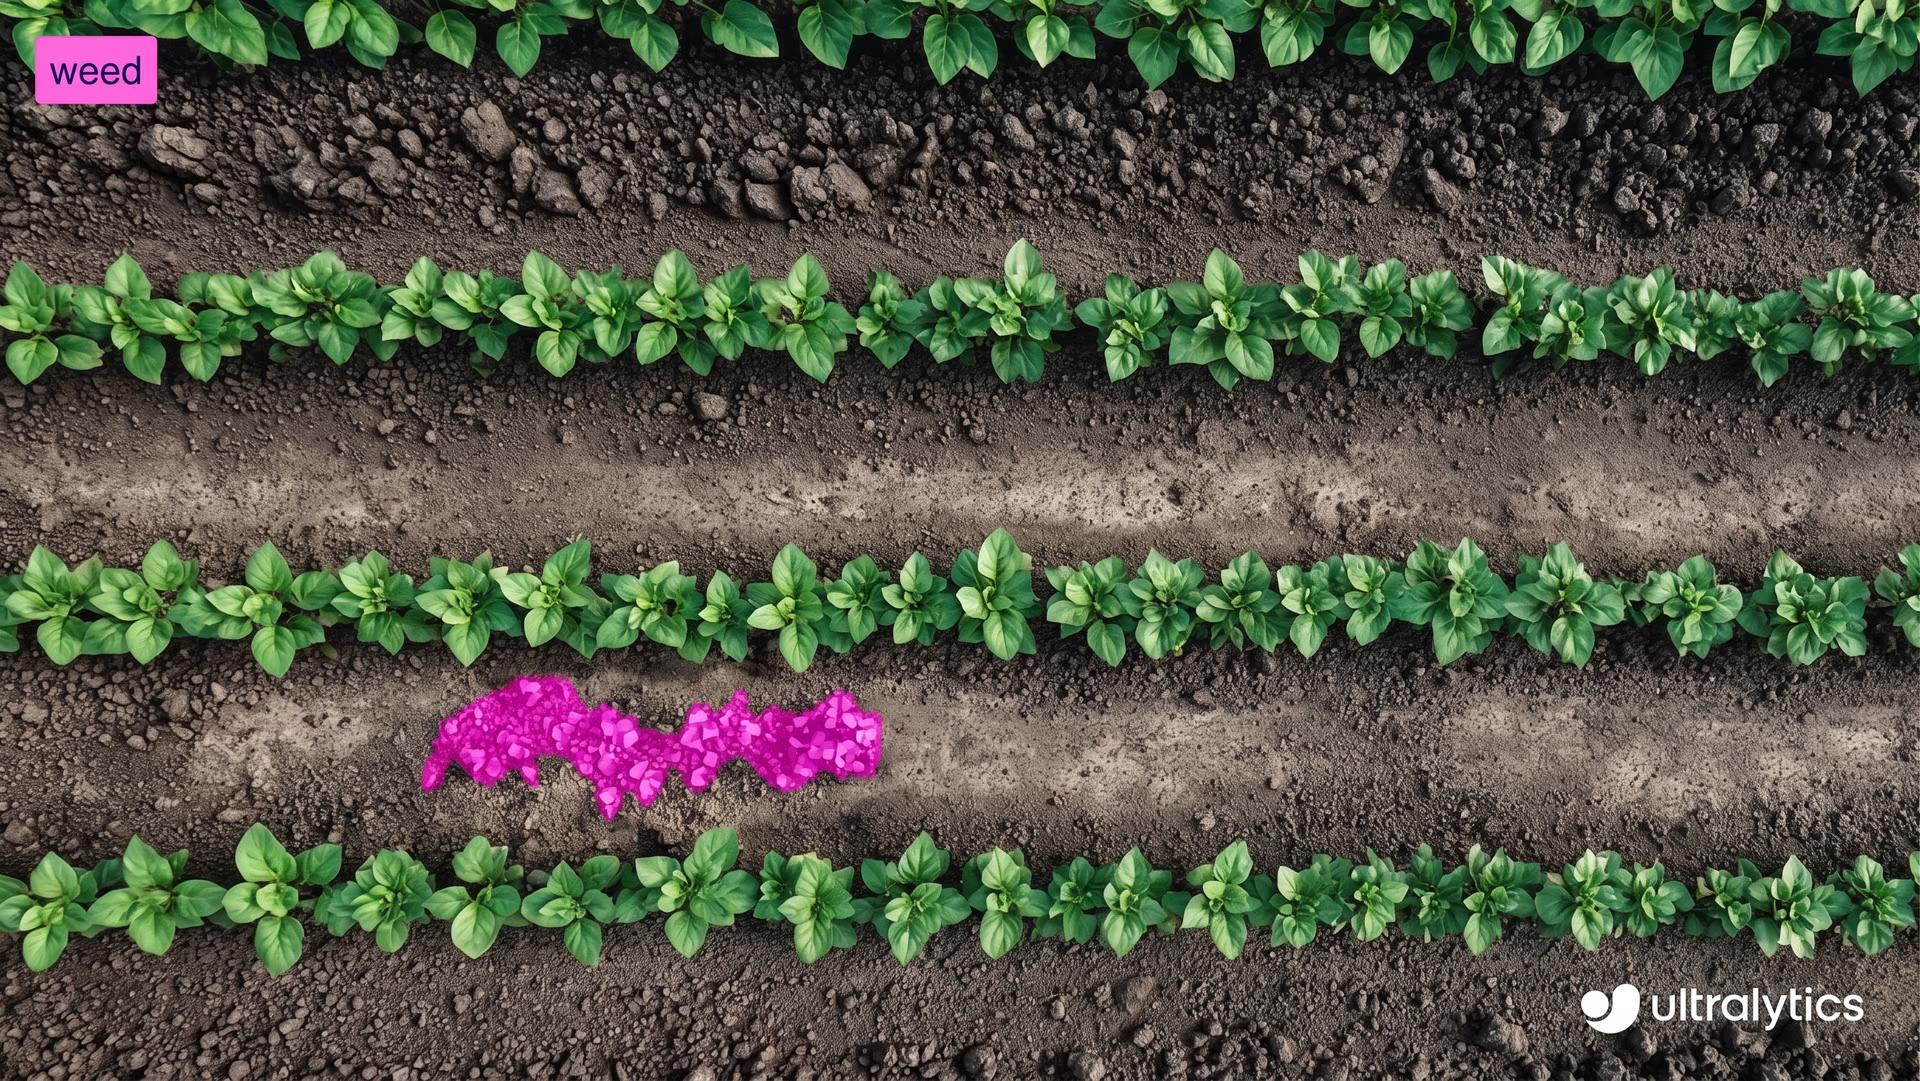
図3. YOLO26を使った雑草のセグメンテーション例(出典)
インスタンスセグメンテーション向けのUltralytics YOLO26のカスタムトレーニングの仕組み#
次に、カスタムトレーニングの仕組みを説明します。モデルのトレーニングは技術的に思えるかもしれませんが、全体のプロセスはシンプルです。
画像を準備し、モデルに学習させたい物体にラベルを付け、小さな設定ファイルを構成したら、Ultralytics Pythonパッケージを使ってYOLO26をトレーニングできます。Ultralytics Pythonパッケージは、すべてをゼロから構築する必要なく、YOLOモデルのトレーニング、テスト、デプロイにすぐ使えるツールを提供するソフトウェアライブラリです。
ステップ1: カスタムデータセットを準備する#
最初のステップは、カスタムセグメンテーションデータセットを準備することです。データセットとは、モデルに学習させたい対象が写った画像を集めたものです。
さまざまな角度、照明、背景、物体サイズなど、実際の環境を反映した画像を含めるようにしてください。画像のバリエーションが豊富であるほど、モデルの性能は向上します。
インスタンスセグメンテーションでは、画像にアノテーションを付ける必要もあります。アノテーションとは、モデルが学習対象を把握できるように、各画像内の物体にラベルを付けることです。単純なボックスを描くのではなく、各物体の正確な形状を示す詳細な輪郭(ポリゴン)を描画します。こうした輪郭が、モデルによる予測対象となるマスクになります。
ラベルの作成に使えるオープンソースのアノテーションツールはいくつかあります。多くのツールには使いやすいインターフェースが用意されており、画像をアップロードして、その上に物体の輪郭を直接描画できます。
画像とアノテーションの準備ができたら、トレーニング用と検証用のフォルダーに整理します。一般的には画像の80%をトレーニング用、20%を検証用に分けますが、データセットのサイズによっては、トレーニング用を70%、検証用を30%にすることもよくあります。トレーニングセットでモデルを学習し、検証セットでは、モデルがまだ見たことのない画像に対する性能を測定します。
この分割のバランスを保ち、両方のフォルダーに多様な例が含まれるようにすることが重要です。適切にトレーニング用と検証用に分割された、整理されたラベル付きデータセットが、高性能なインスタンスセグメンテーションモデルの基盤になります。
ステップ2:データセットのYAMLファイルを作成する#
画像とアノテーションを準備したら、次はデータセットのYAMLファイルを作成します。このファイルには、データセットの保存場所と、トレーニング中にモデルが学習する物体クラスを記述します。
このファイルでは、データセットのルートディレクトリ、トレーニング用および検証用画像フォルダーへのパス、クラス名のリストを定義できます。クラス名は、アノテーションファイルで使用されているクラス番号と同じ順序で記載する必要があります。これにより、すべてが正しく対応付けられます。
正確な形式について不明な点がある場合は、詳細についてUltralyticsの公式ドキュメントを参照してください。
ステップ3:Ultralytics Pythonパッケージをインストールする#
データセットとYAMLファイルの準備ができたので、次はUltralytics Pythonパッケージをインストールします。
このパッケージには、Ultralytics YOLO26モデルのトレーニング、検証、推論の実行、エクスポートに必要なツールが含まれています。複雑なトレーニングパイプラインをゼロから構築せずに、YOLOモデルを効率よく扱えます。
Ultralytics Pythonパッケージをインストールする前に、コードを実行する環境を選ぶことも重要です。Ultralyticsパッケージは、次のようなさまざまな開発環境で利用できます。
- コマンドラインインターフェース(CLI):コマンドを入力してコンピューターを操作する、テキストベースの環境です。グラフィカルインターフェースのようにボタンをクリックしたりメニューを操作したりする代わりに、指示を入力してプログラムを実行し、タスクを直接行います。
- Jupyter Notebooks:コードを小さなセクションに分けて記述・実行し、その結果をすぐに確認できるインタラクティブな環境です。実験や学習に役立ちます。
- Google Colab:ローカルへのインストールが不要なクラウドベースのノートブックプラットフォームで、グラフィックスプロセッシングユニット(GPUs)を任意で利用できます。初心者にとって最も簡単な選択肢となることがよくあります。
環境を選んだら、Ultralytics Pythonパッケージをインストールします。インストールするには、次のコマンドを実行してください。
pip install ultralytics
Google ColabやJupyter Notebookなどのノートブック環境を使用する場合は、コマンドの先頭に感嘆符を付けてください。インストールで問題が発生した場合は、一般的な解決方法や環境設定のヒントについて、Ultralyticsのドキュメントまたはトラブルシューティングガイドを参照してください。
インストールが完了したら、学習済みのUltralytics YOLO26セグメンテーションモデルを読み込み、トレーニングを開始できます。
ステップ4:インスタンスセグメンテーション用にUltralytics YOLO26をトレーニングする#
トレーニングを開始する前に、モデルのサイズを選ぶ必要があります。Ultralytics YOLO26モデルには、Nano(n)、Small(s)、Medium(m)、Large(l)、Extra Large(x)の各サイズがあります。
小型モデルはトレーニングが速く、中央処理装置(CPUs)やエッジデバイス上で効率よく動作します。一方、大型モデルは通常、精度が高いものの、より多くのメモリを必要とし、GPUアクセラレーションの活用が効果的です。初めて取り組む場合や、ハードウェアに制約がある場合は、Nanoバージョン(YOLO26n)が実用的な選択肢です。
モデルサイズを選んだら、次は学習済みのセグメンテーションモデルを読み込み、カスタムデータセットでトレーニングを開始します。そのためには、学習済みモデルファイル、データセットのYAMLファイルへのパス、エポック数、画像サイズを次のように指定します。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
results = model.train(data="path/to/file.yaml", epochs=100, imgsz=640)
エポック数は、モデルがトレーニングデータセット全体を何回処理するかを示します。各エポックでモデルは予測を行い、正解のアノテーションと比較して誤差を計算し、性能を向上させるために内部パラメーターを更新します。
トレーニングが正しく開始されると、モデル設定、データセットのスキャン状況、トレーニングの進行状況がターミナルまたはノートブックに表示されます。トレーニングが進むにつれて、各エポック後に損失値と評価指標が更新され、モデルの改善状況を確認できます。
ステップ5:カスタムトレーニングしたモデルの性能を評価する#
トレーニングが完了したら、モデルの性能指標を確認して検証できます。Google Colabでは、「runs」フォルダーから「segment」フォルダー、さらに「train」フォルダーへ移動すると、主要なパフォーマンス指標を示すログを確認できます。
Python環境を使用している場合、トレーニング結果はデフォルトで、現在の作業ディレクトリ内の「runs/train/」ディレクトリに保存されます。トレーニングを実行するたびに、runs/train/expやruns/train/exp2などの新しいサブディレクトリが作成され、ログ、保存された重み、実験に関連するその他の出力が格納されます。
CLIを使用している場合は、「yolo settings」コマンドで結果にアクセスし、管理できます。このコマンドを使うと、トレーニングログや実験の詳細に関連するパスと設定を表示または変更できます。
保存された出力には、トレーニング中に生成されたグラフも含まれています。これらのグラフから、モデルが時間とともにどのように改善したかを確認できます。たとえば、モデルの学習に伴う損失の低下や、適合率、再現率、平均適合率などの評価指標がエポックを重ねるごとに上昇する様子が示されます。
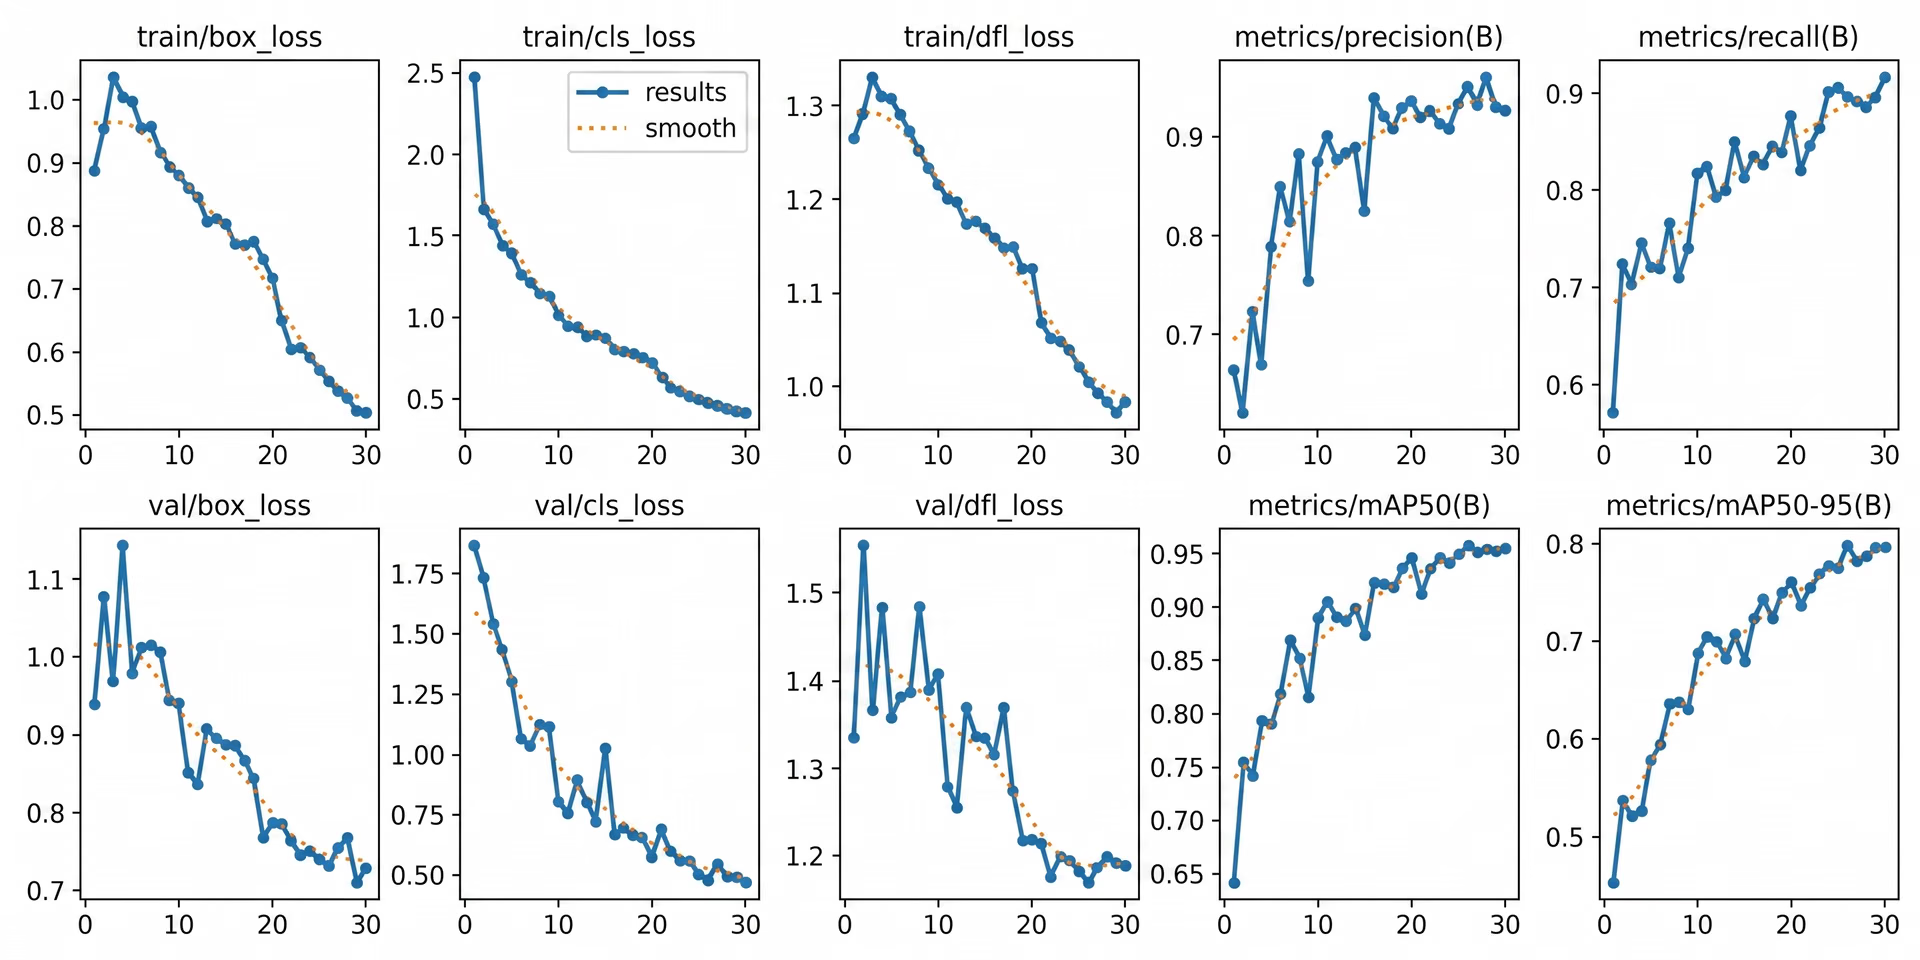
図4. モデルの評価に分析できるグラフの例(出典)
こうした視覚的な傾向から、モデルが適切にトレーニングされたか、トレーニングの開始時から終了時までにどれだけ改善したかを把握できます。数値指標とグラフの両方を確認すると、新しい画像でテストする前に、インスタンスセグメンテーションモデルの性能をより明確に理解できます。
ステップ6:モデルをテストして推論を実行する#
モデルを検証したら、最後に新しい画像でテストします。この処理を推論と呼び、トレーニング済みモデルを使って、まだ見たことのないデータに対する予測を行います。
Pythonで推論を実行するには、次のようにします。
results = model.predict("path/to/image.jpg", save=True, conf=0.3)この例では、「path/to/image.jpg」をテストする画像のパスに置き換えます。
「save=True」設定を指定すると、モデルは予測したセグメンテーションマスクを元の画像に重ねた新しい画像を生成して保存します。
「conf=0.3」設定は信頼度しきい値を指定します。つまり、モデルが正しいと判断する信頼度が30%以上の予測のみを表示します。この値を下げると検出数が増える場合があり、上げるとモデルの判定がより厳しくなります。
コマンドを実行すると、モデルはrunsディレクトリ内に新しいフォルダーを作成し、出力画像を保存します。保存された画像を開くと、セグメンテーションマスクが物体の境界に沿っているか、重なり合う物体が正しく分離されているかを目視で確認できます。
さまざまな画像、背景、照明条件でモデルをテストすると、トレーニングデータセット以外での性能をより明確に把握できます。結果に一貫性があり、精度も十分であれば、モデルをエクスポートしてデプロイする準備が整っています。
ステップ7:モデルをエクスポートしてデプロイする#
モデルをテストし、良好な性能を確認したら、最後にエクスポートしてデプロイします。エクスポートでは、トレーニング済みのUltralytics YOLO26モデルを、本番サーバー、エッジデバイス、モバイルアプリケーションなど、さまざまな環境で実行できる形式に変換します。
Ultralyticsは複数のエクスポート形式に対応しているため、デプロイ環境に最適な形式を選べます。たとえば、幅広いプラットフォームとの互換性を確保するにはONNX、NVIDIAハードウェア上でGPU性能を最適化するにはTensorRT、Intelデバイスに効率よくデプロイするにはOpenVINOにエクスポートできます。これらの統合により、トレーニング環境以外でモデルを実行し、高いリアルタイム性能を得やすくなります。
次のコマンドを使うと、Pythonでモデルをエクスポートできます。
model.export(format="onnx")このコマンドは、トレーニング済みモデルをONNX形式に変換します。デプロイの要件に応じて、「onnx」をほかの対応形式に置き換えられます。
エクスポートしたモデルは、Webサービス、組み込みビジョンシステム、ロボティクスプラットフォーム、産業用検査システムなどのアプリケーションに統合できます。この段階で、カスタムトレーニングしたUltralytics YOLO26のインスタンスセグメンテーションモデルを、実験から実環境へのデプロイへと移行できます。
重要なポイント#
インスタンスセグメンテーション用にUltralytics YOLO26をカスタムトレーニングすると、特定のユースケースに適したモデルを柔軟に構築できます。明確なデータセットを準備し、YAMLファイルを設定して、学習済みのセグメンテーション重みでトレーニングを行い、結果を確認することで、各物体の輪郭をピクセル単位で正確に描画するようモデルに学習させられます。テストとエクスポートを終えたYOLO26モデルは、開発環境から実環境のさまざまな規模のアプリケーションへと展開できます。
コミュニティに参加し、GitHubリポジトリを確認して、AIについてさらに詳しく知りましょう。独自のビジョンAIプロジェクトの構築をお考えの場合は、ライセンスオプションをご覧ください。また、ソリューションのページでは、医療分野のAIや小売分野のビジョンAIなどの活用例を詳しく紹介しています。








