姿勢推定におけるUltralytics YOLO26と他のUltralytics YOLOモデルの比較
Ultralytics YOLO26が、非人間のキーポイントへの対応強化、収束の高速化、オクルージョン処理の改善、効率的なリアルタイムデプロイによって、姿勢推定をどのように改善するかをご紹介します。
人の姿勢を見ると、猫背になっているか、前かがみになっているか、まっすぐ立っているかを簡単に見分けられます。人間は、身体の各部位が互いにどのように関係しているかをすばやく理解できます。
これは、日常生活の中で動きやボディランゲージを解釈するための、私たちに本来備わった能力です。しかし、機械が同じように視覚的に理解できるとは限りません。システムに動きや構造を認識させるには、画像を意味のある形で解釈できるようにする、高度な深層学習とコンピュータービジョンの技術が必要です。
特に、姿勢推定は、コンピュータービジョンモデルが同様の理解を構築できるようにするビジョンAI技術です。画像内の物体を検出するだけでなく、モデルは重要な構造上の目印を表すキーポイントを予測します。
これらのキーポイントは、身体の関節、動物の四肢、機械の部品、さらにはコートの角のような固定点を表します。システムはこれらの点を特定して追跡することで、位置、配置、動きを構造化された測定可能な方法で理解できます。
姿勢推定の実環境での活用が広がるにつれて、モデルには、人間以外のキーポイント、複雑なシーン、独自のデータセットへの対応力が求められています。たとえば、最先端のモデルであるUltralytics YOLO26は、姿勢推定などのコンピュータービジョンタスクに対応しています。また、柔軟性と全体的な性能の向上を目的としたアーキテクチャおよび学習面の改良により、従来のYOLO姿勢推定モデルを発展させています。
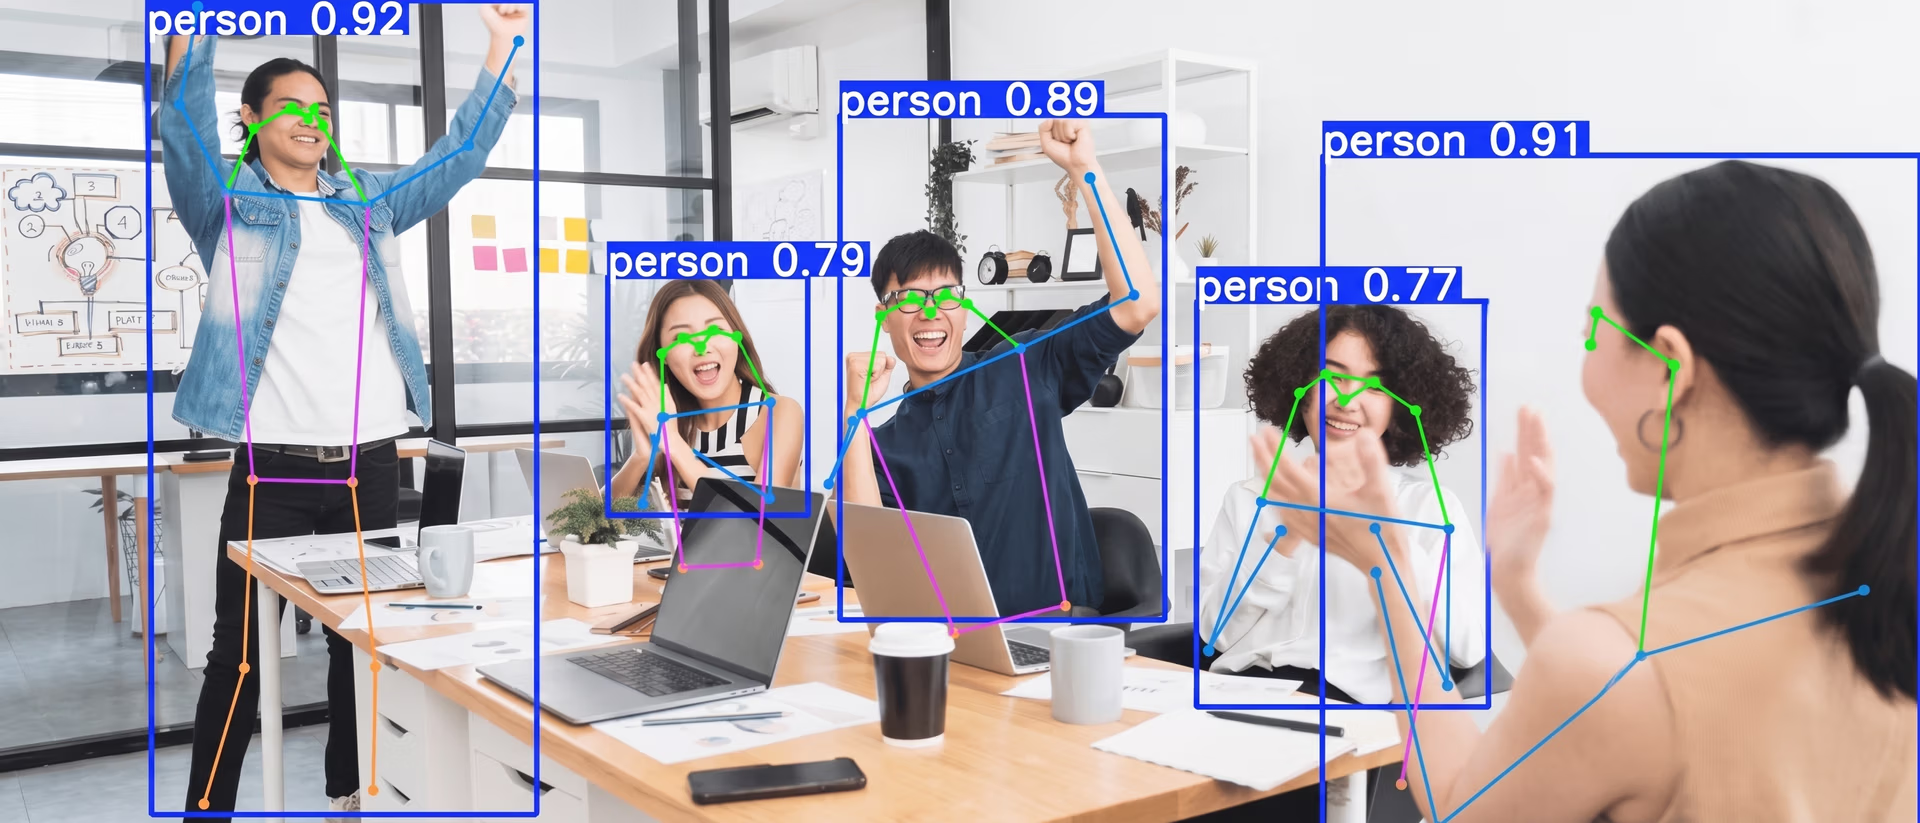
図1. YOLOによる姿勢推定の例(出典)
この記事では、YOLO26-poseと従来のUltralytics YOLO姿勢推定モデルを比較し、複雑なシーンにおける柔軟性、収束速度、性能がどのように向上したかを解説します。さっそく始めましょう。
姿勢推定とは何ですか?#
Ultralytics YOLOの姿勢推定モデルを比較する前に、コンピュータービジョンにおける姿勢推定の意味を詳しく見ていきましょう。
姿勢推定は、画像や動画フレーム内の特定のキーポイントを検出して追跡する技術です。キーポイントは、人間の身体の関節、動物の四肢、機械の部品、シーン内の固定された基準点など、重要な構造上の目印を表します。
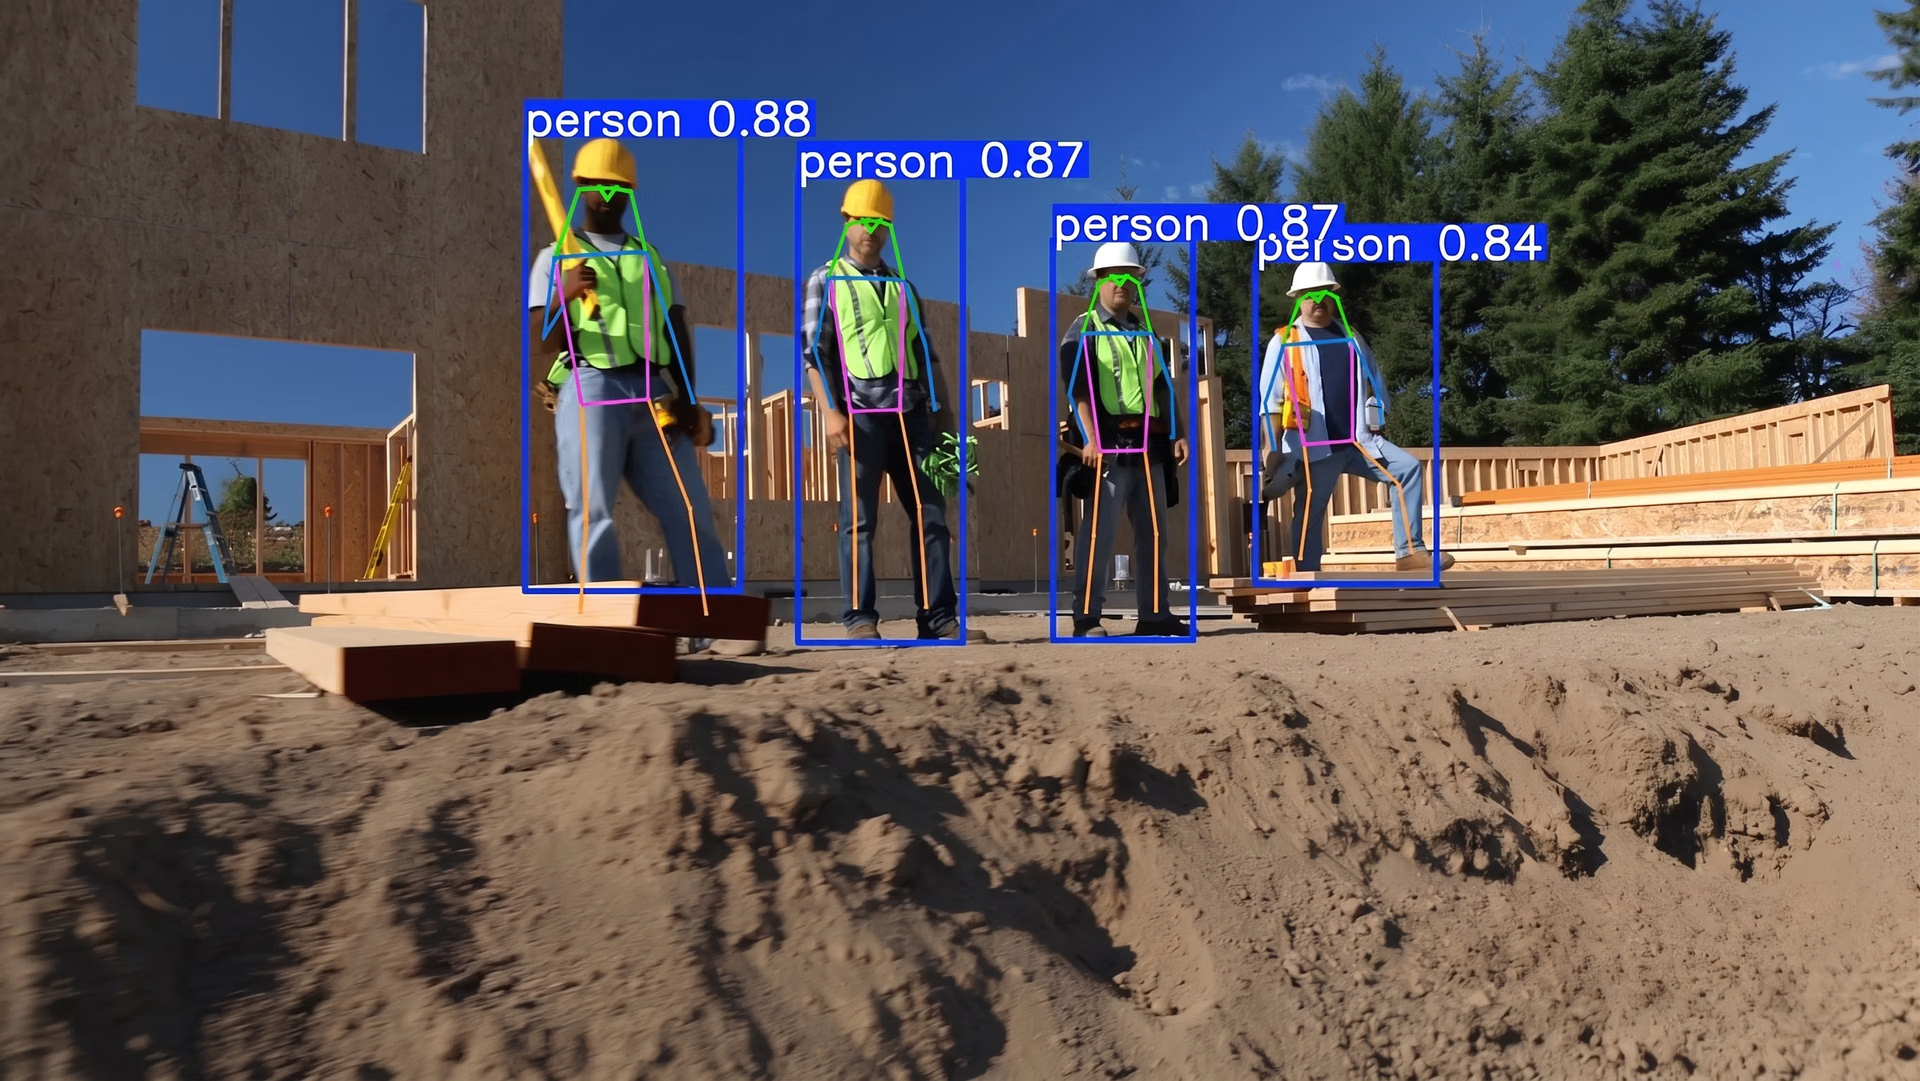
図2. 人間の姿勢推定による作業員の姿勢の推定(出典)
これらの点の座標を特定することで、モデルは物体の位置や時間経過に伴う動きを理解できます。画像全体に単一のラベルを付ける画像分類や、物体の周囲にバウンディングボックスを描くことに注力する物体検出モデルとは異なり、姿勢推定では構造や動きに関する、より詳細な空間情報を取得できます。
Ultralytics YOLO26-poseの概要#
YOLO26-poseには複数のモデルバリエーション、つまりモデルサイズがあり、YOLO26n-poseのような軽量モデルから、YOLO26m-pose、YOLO26l-pose、YOLO26x-poseのような大型モデルまで用意されています。これにより、チームはハードウェアや性能要件に応じて、速度と精度のバランスが適切なモデルを選択できます。
Ultralyticsは、COCOデータセットなどの大規模で汎用的なデータセット、特に人間の姿勢推定向けのCOCO-Pose(COCOキーポイント)アノテーションを使って学習させた、事前学習済み姿勢推定モデルも提供しています。そのため、ゼロから学習を始める必要はありません。多くの場合、チームは特定のキーポイント、レイアウト、環境に適応させるため、自社のデータセットでこれらのモデルをファインチューニングします。
通常は、キーポイントの座標とクラスラベルを構造化形式で定義する、独自のアノテーションファイルを用意します。これらのアノテーションは、各画像内の特定のピクセル座標にキーポイントを対応付けるため、学習中にモデルが正確な空間関係を学習できます。
事前学習済みモデルを使うと、学習時間を短縮し、必要なデータ量を減らして、プロジェクトをより効率的に本番環境へ移行できます。
人間の姿勢推定の実環境での活用例#
姿勢推定が重要な役割を果たす実環境での活用例をいくつかご紹介します。
- 医療とリハビリテーション: 臨床医は姿勢モデルを使って、姿勢の評価、回復状況のモニタリング、理学療法中の動作パターンの解析を行えます。
- 自律システム: ドローンやスマートカメラは、姿勢情報を活用して、動的なシーンにおける物体の向きや動きをより適切に理解できます。
- 職場の安全: 組織は身体の位置や反復動作をモニタリングし、潜在的な安全上のリスクを特定できます。
- フィットネスとパーソナルトレーニング: フィットネスアプリは姿勢推定を使い、運動フォームの追跡、反復回数のカウント、フィットネスのチュートリアル中に保たれる姿勢や動きへのリアルタイムのフィードバックを行います。
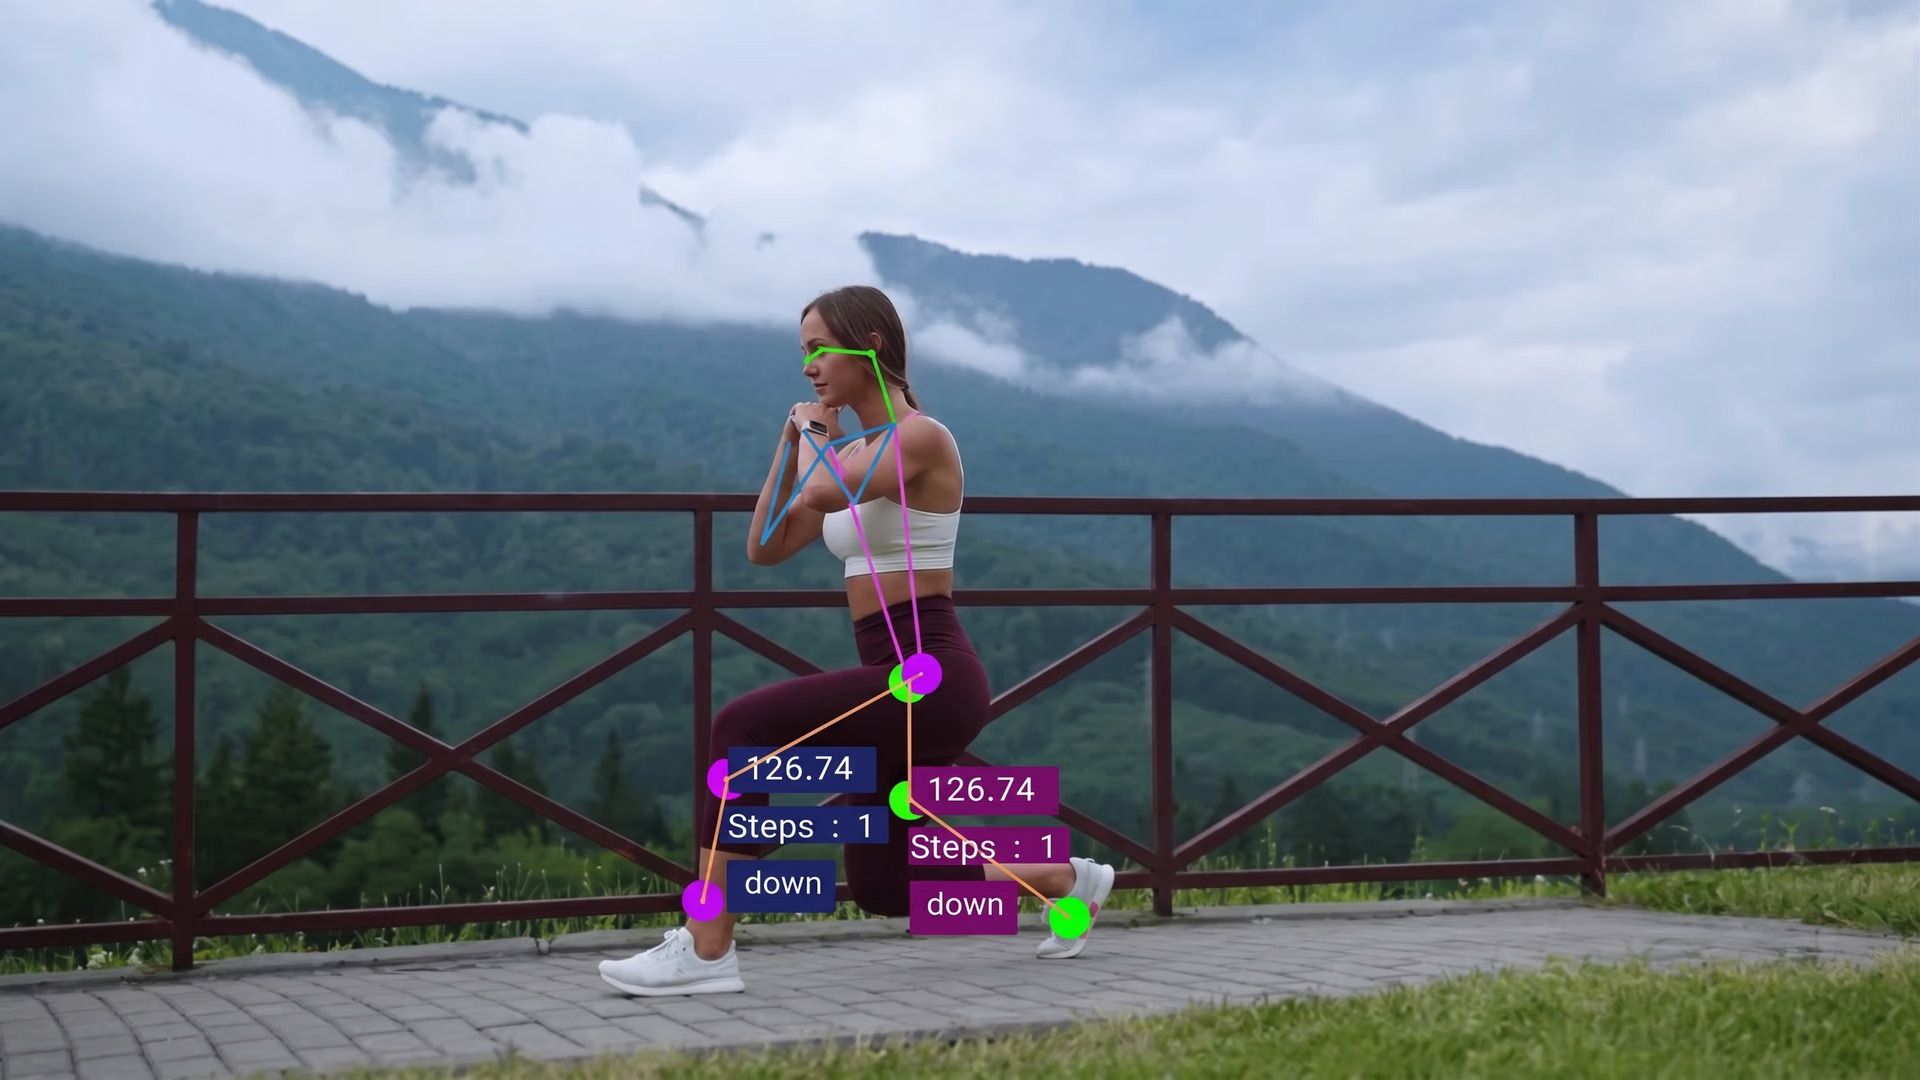
図3. 姿勢推定は、運動中の身体の主要なポイントの追跡に役立ちます。(出典)
Ultralytics YOLO26の姿勢推定対応を詳しく見る#
Ultralytics YOLO26は、トレーニングとデプロイをより実用的にするための更新を加え、従来のUltralytics YOLOモデルを発展させています。
従来のバージョンと同様、統合フレームワークの一部として姿勢推定に対応しています。主な違いは、より幅広い実環境の用途で柔軟性と安定性を高めるようにUltralytics YOLO26が設計されている点です。
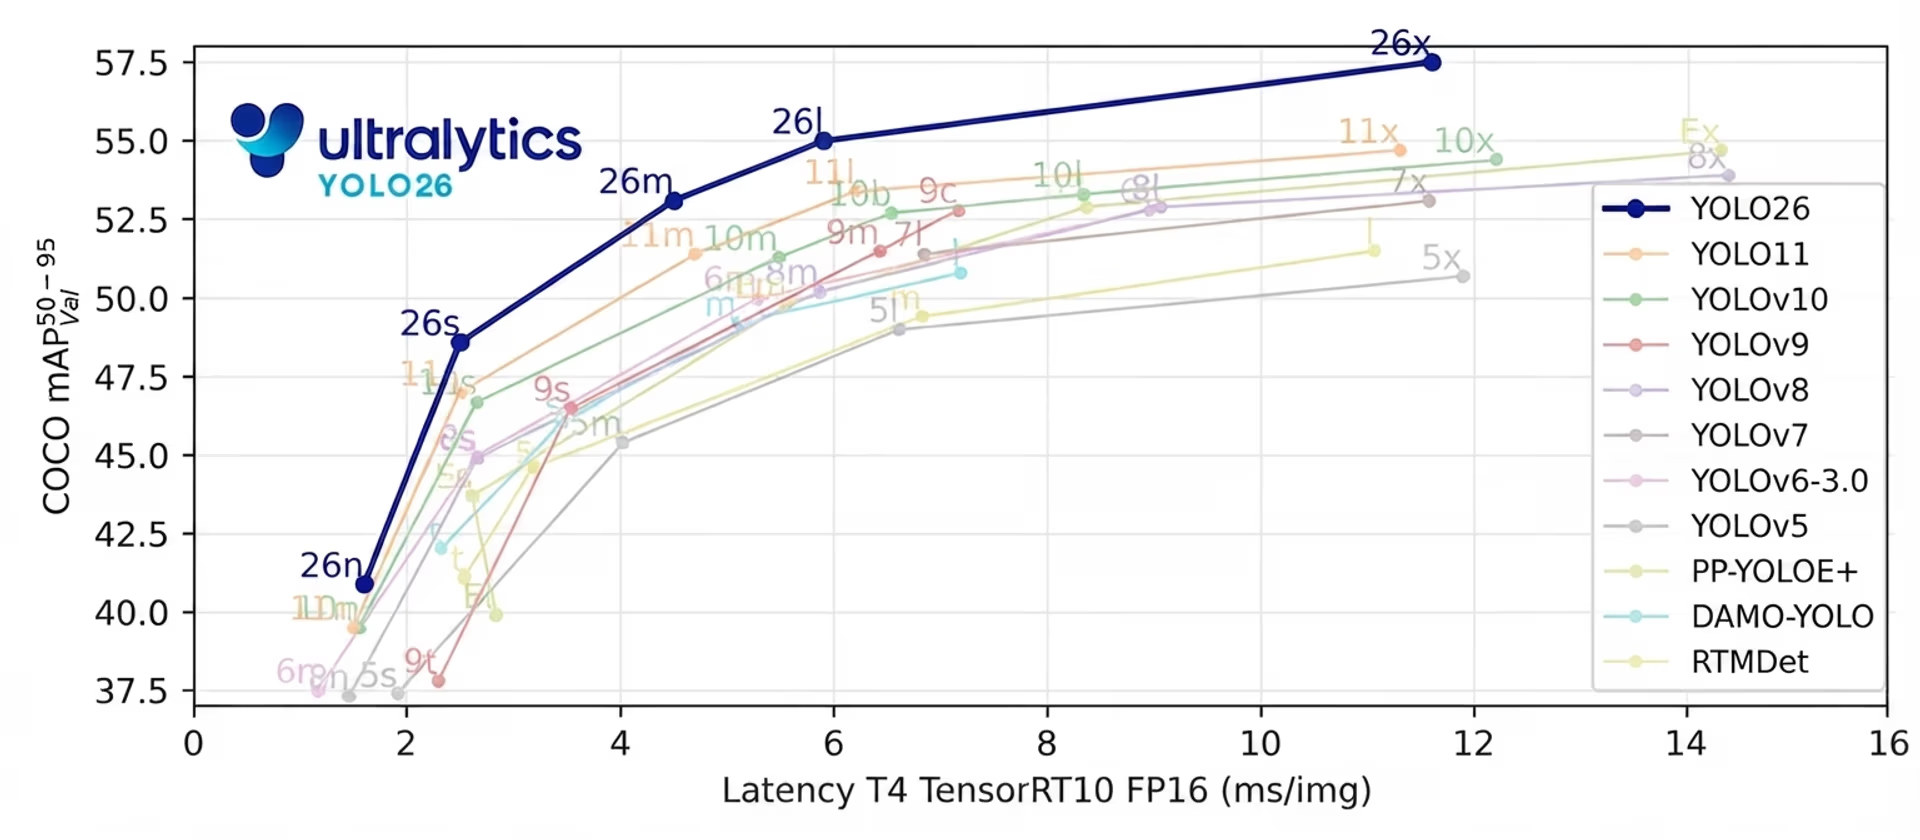
図4. YOLO26のベンチマーク(出典)
従来のUltralytics YOLO姿勢推定モデルは、人間の姿勢データセットの影響を大きく受けていました。そのため、以前の手法の一部は、人間の関節構造を前提に最適化されていました。YOLO26では、こうした人間固有の前提が取り除かれています。
その結果、テニスコートの角や、その他の独自の構造上の目印など、人間以外のキーポイントの検出により適しています。ただし、そのまま使える事前学習済みのUltralytics YOLO26-poseモデルは、COCO-poseなどのデータセットで学習されており、データセットのアノテーションで定義された人間のキーポイントを予測するため、この点は重要です。
一方、機械の部品、スポーツフィールドのマーカー、インフラのポイントなど、異なる種類の目印を検出したい場合、通常は対象のキーポイントにアノテーションを付けた独自のデータセットでモデルをファインチューニングする必要があります。
Ultralytics YOLO26は人間の関節構造に関する前提に縛られていないため、ファインチューニング時により効果的に適応できます。この柔軟性により、独自のキーポイントレイアウトをより確実に学習できるため、固有のキーポイント構成を持つデータセットで検証した際の評価指標の向上につながります。
Ultralytics YOLO26-poseは、物体の一部が隠れている場合や、非常に小さく写っている場合のキーポイント位置特定を改善するよう設計されています。遠くにいる対象、ドローン映像、小さな物体が含まれる実環境のシーンでは、従来の姿勢推定モデルより正確なキーポイント予測が可能になります。
もう一つの重要な更新は、学習時に使われる損失関数の改善です。損失関数は、学習中にモデルが誤りをどのように修正するかを決定します。
Ultralytics YOLO26-poseでは、このプロセスがより効果的であるため、モデルはより速く学習し、少ないエポック数で高い精度を達成できます。エポックとは、トレーニングデータセット全体を1回処理することを指します。
全体として、YOLO26-poseは従来のUltralytics YOLOのポーズ推定モデルを基盤とし、非人間のキーポイントへの対応と学習の収束性を明確に改善しながら、従来と同じ使い慣れたワークフローを維持しています。
YOLO26-poseとUltralytics YOLOv5の比較#
Ultralytics YOLOモデルの最初のバージョンであるUltralytics YOLOv5は、主に物体検出向けに構築されました。YOLOv5は後にインスタンスセグメンテーションにも対応しましたが、公式のUltralyticsフレームワークには、ネイティブの専用ポーズ推定ヘッドが含まれていません。
キーポイント検出が必要なチームは、通常、別個の実装やカスタム変更に頼っていました。Ultralytics YOLO26にはポーズ推定が組み込みタスクとして含まれており、キーポイントの予測に特化して設計された専用のアーキテクチャヘッドを備えています。
そのため、Ultralytics YOLO26-poseモデルは、検出やセグメンテーションと同じ統合ワークフロー内でトレーニング、検証、デプロイできます。構造化されたキーポイント検出を重視するプロジェクトに対し、YOLO26はネイティブのポーズ対応と、YOLOv5には標準で備わっていないタスク固有のアーキテクチャを提供します。
主な違い:YOLO26-poseとUltralytics YOLOv8-poseの比較#
Ultralytics YOLOv8は、統合されたUltralyticsフレームワークにネイティブのポーズ推定を導入し、検出やセグメンテーションと同じワークフローでキーポイントモデルを簡単にトレーニング、デプロイできるようにしました。従来型の後処理パイプラインを採用し、非最大値抑制(NMS)を使用するほか、バウンディングボックス回帰とトレーニングには以前の損失関数を使用します。
Ultralytics YOLO26はこの基盤を発展させ、ポーズ推定に直接影響するアーキテクチャとトレーニングの更新を行っています。大きな違いの一つは、エンドツーエンド設計です。YOLO26は推論時に外部NMSを必要としないため、デプロイが簡素化され、特にCPUやエッジデバイスでレイテンシーの一貫性が向上します。
もう一つの重要な改善点は、トレーニング手法です。Ultralytics YOLO26では、MuSGDオプティマイザーと更新された損失戦略が導入されています。ポーズタスクでは、Residual Log-Likelihood Estimationを統合し、キーポイントの不確実性をより適切にモデル化します。こうした変更により、特に複雑なシーンや部分的にオクルージョンが発生したシーンで、収束の高速化とキーポイント予測の安定化が期待できます。
要するに、Ultralytics YOLOv8-poseは強力で汎用性の高いベースラインを確立しました。YOLO26-poseは、トレーニング効率の向上、オクルージョンへの対応の改善、実環境における非人間のポーズへの柔軟性向上によって、そのベースラインを洗練させています。
YOLO26-poseとUltralytics YOLO11-poseの比較:何が改善されましたか?#
Ultralytics YOLO11は、バックボーンと特徴抽出レイヤーを改良し、Ultralytics YOLOv8を発展させたモデルです。FLOPsを削減し、パラメーター効率を高め、優れたリアルタイム性能を維持しながら、より高いmAPを達成しました。ポーズタスクでは、軽量なアーキテクチャでキーポイント精度が向上しました。
YOLO26-poseは、より根本的なアーキテクチャの転換によって、この進化をさらに進めています。簡単に言えば、YOLO11はYOLOv8の効率と精度を改良し、YOLO26はその基盤に、収束の高速化、推論の安定化、複雑なシナリオでのポーズ精度向上を目指すアーキテクチャとトレーニングの更新を加えています。
ポーズ推定にUltralytics YOLO26モデルを使い始めるべき理由#
Ultralytics YOLOモデルの違いを調べていると、YOLO26-poseに切り替えるべきか迷うかもしれません。
簡単に言えば、手軽にアップグレードできます。すでにUltralytics YOLOv8-poseまたはUltralytics YOLO11-poseを使用している場合、YOLO26-poseへの切り替えでは通常、パイプラインを再構築せずにモデルのバージョンを変更するだけです。
同じUltralyticsフレームワークを使い続けながら、非人間のキーポイントへの対応強化、トレーニング時の収束高速化、オクルージョンが発生した点への対応改善といったメリットを得られます。新規および既存のほとんどのポーズプロジェクトにおいて、YOLO26-poseへの移行は、最小限の手間でこれらの改善を取り入れる簡単な方法です。
さらに、YOLO26-poseはPyTorchを基盤とするUltralytics Python packageで完全にサポートされており、トレーニング、検証、デプロイを簡単に行えます。モデルはONNX、TensorRT、OpenVINO、CoreML、TFLiteなどの形式にエクスポートできるため、全体的なワークフローを変更せずに、GPU、CPU、エッジデバイスへ容易にデプロイできます。
重要なポイント#
Ultralytics YOLO26-poseは、特に非人間のキーポイントや複雑なシーンを扱う場合に、ポーズ推定の柔軟性と信頼性を高めます。トレーニングが速く、オクルージョンへの対応に優れ、さまざまなデータセットでより一貫した結果を得られます。すでにUltralytics YOLOのポーズ推定モデルを使用しているチームは、既存のワークフローを変更せずに、YOLO26の明確な改善を活用できます。
AIについてもっと知りたいですか?コミュニティとGitHubリポジトリをご覧ください。ロボティクス分野のAIと農業分野のコンピュータービジョンについて、ソリューションページをご覧ください。ライセンスの選択肢を確認して、今日からコンピュータービジョンの開発を始めましょう!









