プロンプト可能な概念セグメンテーションを理解する
プロンプト可能な概念セグメンテーションと従来手法との違いを解説し、YOLOE-26などの関連モデルがオープンボキャブラリー機能を実現する方法をご紹介します。
 Abirami Vina14 分で読めます
ビジョンAIは急速に進歩しており、実環境で画像や動画を分析するために広く利用されています。たとえば、交通管理システムから小売分析まで、さまざまなアプリケーションにコンピュータービジョンモデルが導入されています。
こうしたアプリケーションの多くでは、物体検出モデルなどのビジョンモデルが、車両、人、機器など、事前に定義された物体のセットを認識するよう学習されています。学習時に多数のラベル付きサンプルをモデルに提示することで、各物体の見え方や、シーン内の他の物体との見分け方を学習させます。
セグメンテーションタスクでは、モデルはさらに一歩進み、対象物の周囲にピクセル単位で正確な輪郭を生成します。これにより、システムは画像内の各対象物の位置を正確に把握できます。
システムが学習済みの対象だけを認識すればよい場合は、これで問題ありません。しかし、実環境ではそのようなケースはほとんどありません。
視覚的なシーンは通常、絶えず変化します。新しい物体や視覚的な概念が現れ、状況が変化し、ユーザーは元の学習設定に含まれていなかった物体をセグメント化したいと考えることもよくあります。
こうした制約は、セグメンテーションで特に顕著です。ビジョンAIの進化に伴い、繰り返し再学習することなく新しい概念に適応できる、より柔軟なセグメンテーションモデルの必要性が高まっています。そのため、プロンプト可能な概念セグメンテーション(PCS)が注目されています。
固定された物体カテゴリのリストに頼るのではなく、ユーザーはテキスト、視覚的なプロンプト、またはサンプル画像を使って、セグメント化したい対象を指定できます。モデルは、学習時に明示的に含まれていなかった概念であっても、説明に一致するすべての領域を特定してセグメント化できます。
この記事では、プロンプト可能な概念セグメンテーションの仕組み、従来の手法との違い、現在の活用例について解説します。
プロンプト可能な概念セグメンテーションとは何ですか?#
多くの場合、セグメンテーションモデルは、短いリストに含まれる種類の物体を認識するよう学習されています。ビジョンAIシステムが特定の物体セットだけを検知してセグメント化すればよい場合には、この方法が適しています。
しかし、実環境のアプリケーションでは、視覚的なシーンは絶えず変化します。新しい物体が現れ、タスクの要件が変化し、元のラベルセットに含まれていない概念をセグメント化する必要が生じることもよくあります。こうした状況に対応するには、通常、新しい高品質なデータとアノテーションを収集し、モデルを再学習する必要があり、コストが増加して導入が遅れます。
プロンプト可能な概念セグメンテーションは、固定されたラベルのリストから選ぶ代わりに、何を探すかをユーザーがモデルに伝えられるようにすることで、この問題を解決します。ユーザーは探している物体や概念を説明し、モデルは画像内で一致するすべての領域を強調表示します。これにより、ユーザーの意図を画像内の実際のピクセルに結び付けやすくなります。
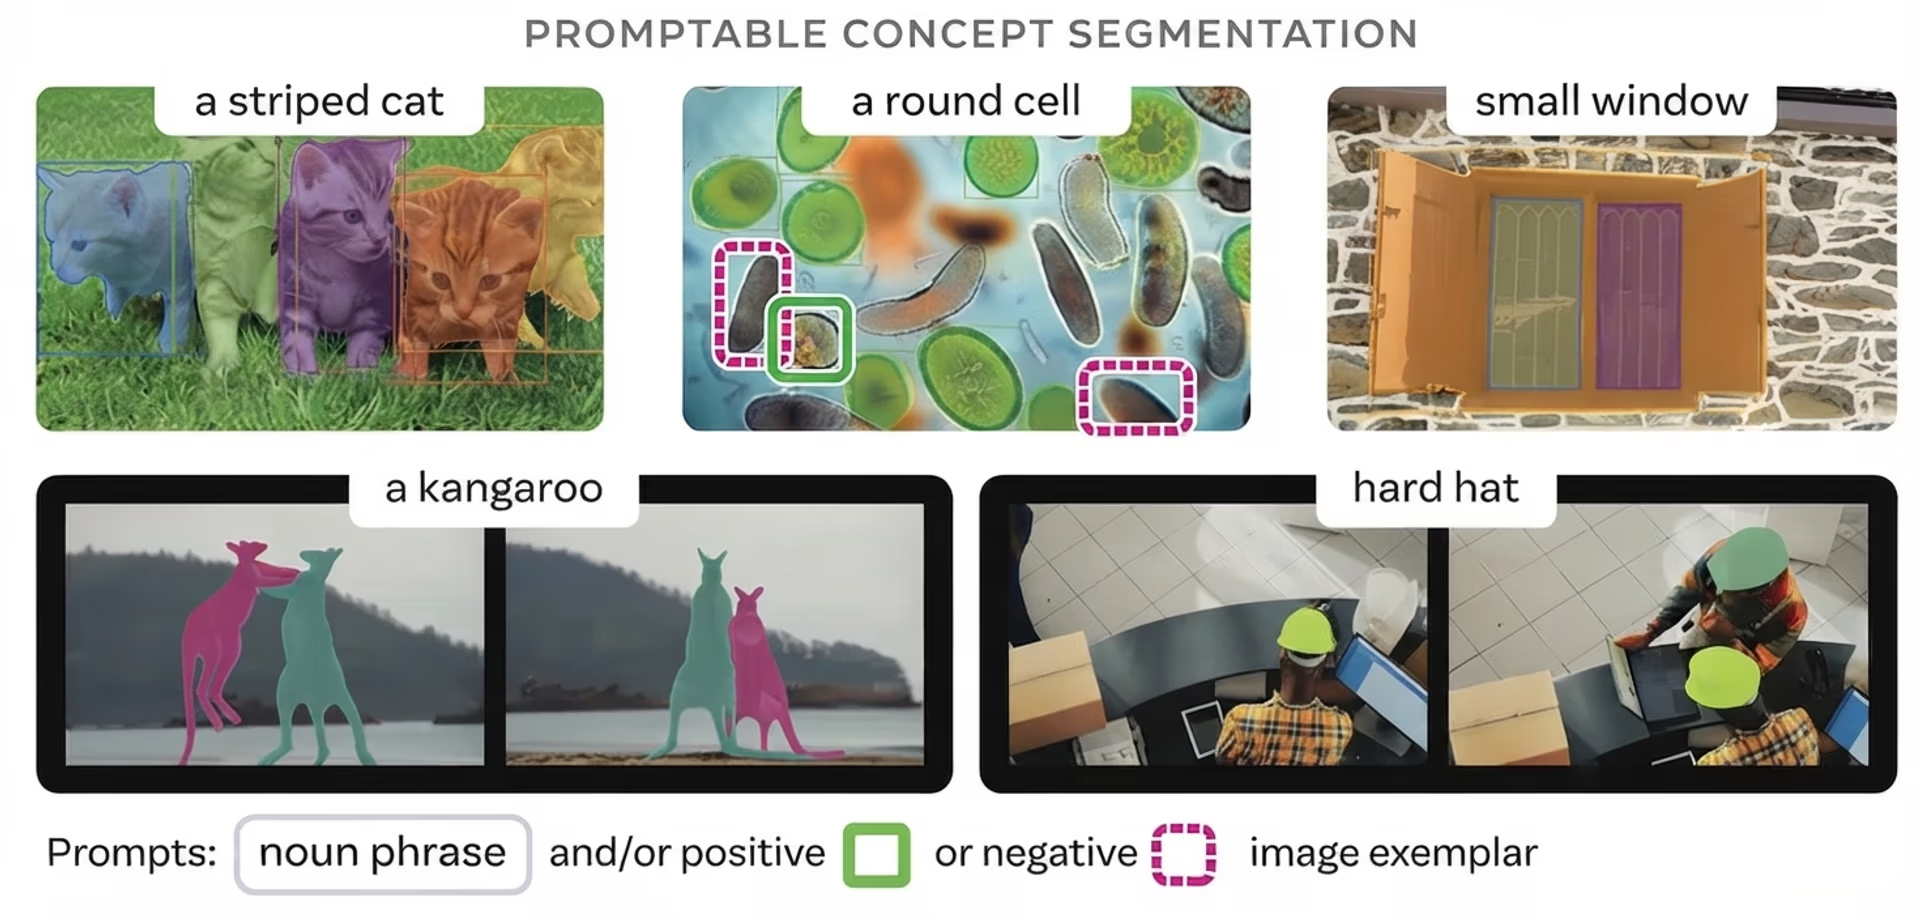
図1. 概念プロンプトを使ったセグメンテーションの例(出典)
さまざまな種類のプロンプトによるセグメンテーションのガイド#
プロンプト可能な概念セグメンテーションに対応するモデルは、さまざまな種類の入力を受け取れるため、柔軟に利用できます。つまり、テキストによる説明、視覚的な手がかり、サンプル画像など、複数の方法でモデルに対象を指定できます。
それぞれの方法を詳しく見てみましょう。
- テキストプロンプト: 「スクールバス」や「腫瘍領域」などの短いフレーズを使って、セグメント化する概念を説明できます。モデルは語句の意味を解釈し、一致する領域を特定します。
- 視覚的なプロンプト: 画像内の点、ボックス、または大まかなスケッチを手がかりとして使います。こうした手がかりは、注目する位置を示し、最終的な境界の形成に役立ちます。
- サンプル画像: 参照画像や小さく切り抜いた画像で、対象の概念を示します。モデルは視覚的に類似した領域を探し、見た目に基づいてセグメント化します。
PCSと従来のセグメンテーションの違い#
プロンプト可能な概念セグメンテーションの仕組みを詳しく見る前に、まず従来のさまざまな物体セグメンテーション手法と比較しましょう。
PCSでは、オープンボキャブラリーでプロンプト駆動型のモデルを実現できます。プロンプトで説明された新しい概念にも対応できますが、従来のセグメンテーションでは対応できません。従来のセグメンテーションにはいくつかの種類があり、それぞれ異なる前提と制約があります。
従来のセグメンテーションの主な種類をいくつか紹介します。
- セマンティックセグメンテーション: 画像内の各ピクセルに、道路、建物、人などのカテゴリを割り当てます。同じラベルのピクセルはすべてまとめられるため、モデルは個々の物体インスタンスを区別しません。
- インスタンスセグメンテーション: モデルは個々の物体を特定してセグメント化するため、2人の人や2台の車を別々の物体として扱います。
- パノプティックセグメンテーション: この手法はセマンティックセグメンテーションとインスタンスセグメンテーションを組み合わせ、背景領域と個々の物体の両方を含む、シーン全体の情報を提供します。
これらの手法はすべて、事前に定義された物体カテゴリのリストに依存しています。その範囲内ではうまく機能しますが、範囲外の概念への対応は得意ではありません。新しい特定の物体をセグメント化する必要がある場合、通常は追加の学習データとモデルのファインチューニングが必要です。
PCSはその状況を変えることを目指しています。事前に定義されたカテゴリに制限されるのではなく、推論時に画像内でセグメント化したい対象を説明できます。
PCSモデルの進化#
次に、セグメンテーションモデルがどのように進化し、プロンプト可能な概念セグメンテーションに至ったのかを見ていきましょう。
セグメンテーションに変革をもたらした人気の基盤モデルが、Segment Anything Model、すなわちSAMです。2023年に発表されました。事前に定義された物体カテゴリに依存せず、点やバウンディングボックスなどのシンプルな視覚的プロンプトを使って、ユーザーがセグメンテーションをガイドできるようにしました。
SAMでは、ユーザーがラベルを選ぶ必要はなくなりました。物体の位置を示すだけで、モデルがその物体のマスクを生成できます。これによりセグメンテーションはより柔軟になりましたが、ユーザーは引き続きモデルに注目する場所を示す必要がありました。
2024年に公開されたSAM 2は、この考え方を発展させ、より複雑なシーンに対応するとともに、プロンプト可能なセグメンテーションを動画に拡張しました。セグメンテーションのガイドには引き続き主に視覚的なプロンプトを使いながら、さまざまな照明条件、物体の形状、動きに対する堅牢性を高めました。
SAM 3モデルは、この進化における最新の段階です。昨年公開されたこの統合モデルは、視覚的な理解と言語によるガイダンスを組み合わせ、画像と動画のセグメンテーションタスクで一貫した動作を実現します。
SAM 3では、ユーザーはポイントや描画によるプロンプトに限定されません。代わりに、セグメンテーションしたい対象をテキストで記述すると、モデルが画像または動画フレームからその説明に一致する領域を探します。
セグメンテーションは固定された物体カテゴリではなく概念に基づいて行われるため、さまざまなシーンや時間の経過にわたってオープンボキャブラリーを利用できます。実際、SAM 3は、Wikidataなどのソースから構築されたオントロジーに基づき、大規模な学習データによって拡張された、学習済みの広大な概念空間を扱います。
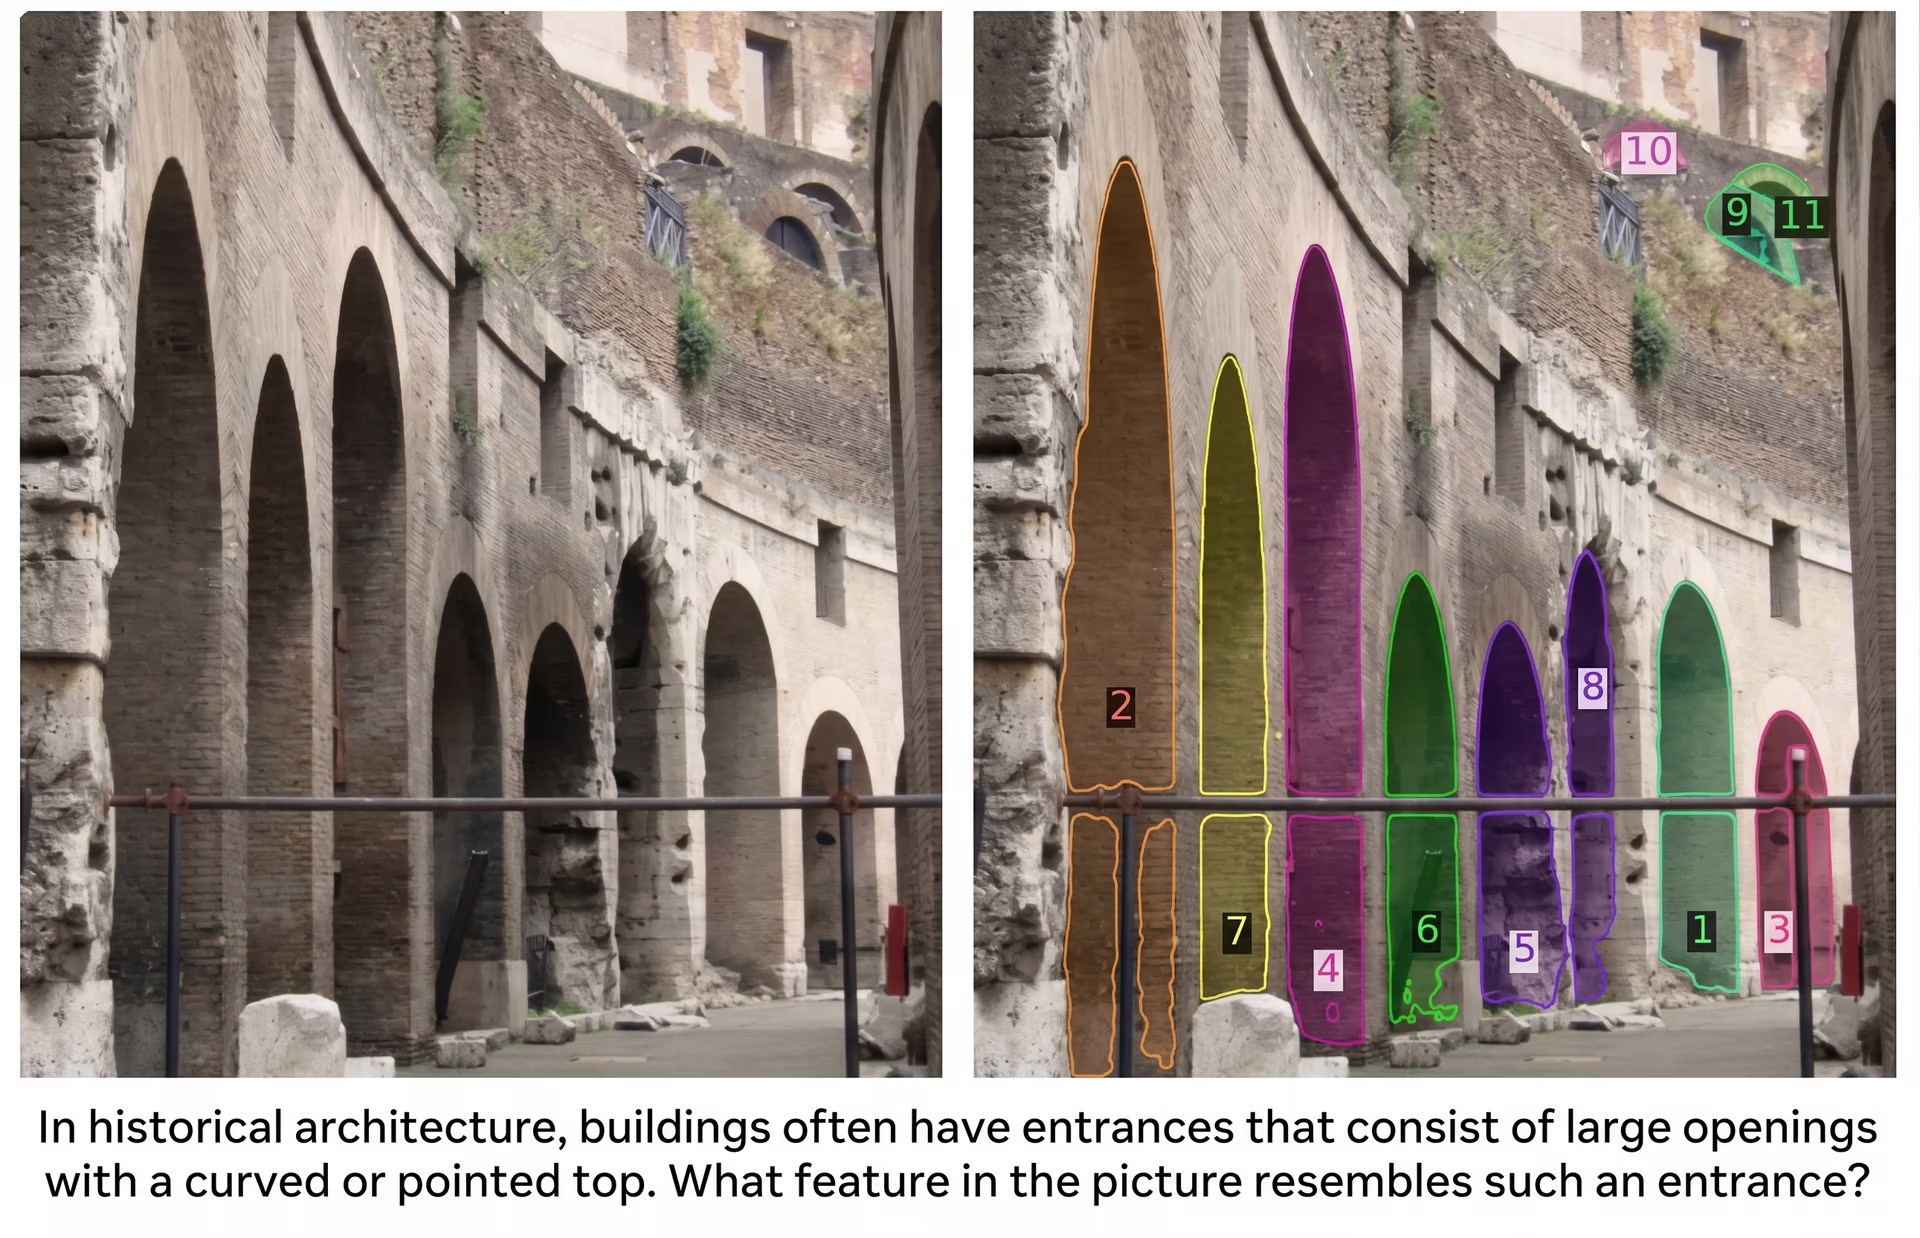
図2. SAM 3にプロンプトを与えて単一画像をセグメンテーションする例(出典)
幾何学的なプロンプトに主に依存していた従来のバージョンと比べると、SAM 3はより柔軟で概念主導型のセグメンテーションへの一歩となります。そのため、対象となる物体や概念が変化し、事前に常に定義できるとは限らない実環境での用途に、より適しています。
プロンプト可能な概念セグメンテーションの仕組みを探る#
では、プロンプト可能な概念セグメンテーションはどのように機能するのでしょうか。大規模な事前学習済みのビジョンモデルとビジョン言語モデルを基盤としており、これらのモデルは膨大な画像コレクションと、多くの場合はそれに対応するテキストで学習されています。この学習により、一般的な視覚パターンと意味を学習できます。
ほとんどのPCSモデルはTransformerベースのアーキテクチャを採用しており、画像全体を一度に処理して、異なる領域同士の関係を理解します。ビジョンTransformerは画像から視覚的特徴を抽出し、テキストエンコーダーは単語をモデルが処理できる数値表現に変換します。
学習時、これらのモデルは、物体の正確な境界を定めるピクセルレベルのマスク、物体のおおよその位置を示すバウンディングボックス、画像に何が写っているかを説明する画像レベルのラベルなど、さまざまな種類の教師信号から学習できます。異なる種類のラベル付きデータを使って学習することで、細部と幅広い視覚概念の両方を捉えられます。
推論時、つまりモデルが実際に予測を行う際、PCSはプロンプト主導のプロセスに従います。ユーザーはテキストによる説明、点やボックスなどの視覚的なヒント、またはサンプル画像で指示を与えます。モデルはプロンプトと画像の両方を共通の内部表現(埋め込み)にエンコードし、説明された概念に合致する領域を特定します。
次に、マスクデコーダーがこの共通表現を、ピクセルレベルの精密なセグメンテーションマスクに変換します。モデルは視覚的特徴と意味を結び付けるため、学習時に明示的に含まれていなかった新しい概念もセグメンテーションできます。
また、多くの場合、プロンプトを調整したり追加の指示を加えたりすることで出力を改善でき、複雑なシーンや曖昧なシーンへの対応に役立ちます。この反復的なプロセスにより、デプロイ時に実用的な最適化を行えます。
プロンプト可能な概念セグメンテーションモデルは、一般に、未見の概念をどれだけ適切にセグメンテーションできるか、また、さまざまなシーンでどれだけ堅牢に動作するかによって評価されます。ベンチマークでは、実環境でのデプロイ要件を反映し、マスクの品質、汎化性能、計算効率が重視されることがよくあります。
PCSの実環境でのユースケース#
次に、プロンプト可能な概念セグメンテーションがすでにどのような場面で使われ、実際にどのような影響をもたらし始めているのかを見ていきましょう。
医用画像向けの柔軟な画像セグメンテーション#
医用画像には多様な生体構造、疾患、スキャンの種類が含まれ、新しい症例が毎日のように現れます。従来のセグメンテーションモデルでは、この多様性に対応しきれません。
PCSは、限られた固定リストから選ぶのではなく、見つけたい対象を臨床医が説明できるため、この分野に自然に適合します。テキスト表現や視覚的なプロンプトを使えば、新しいタスクごとにモデルを再学習させなくても、臓器や懸念領域を直接セグメンテーションできます。そのため、多様な臨床ニーズに対応しやすくなり、手作業でマスクを描く必要性を減らし、さまざまな画像形式で利用できます。
優れた例の一つがMedSAM-3です。医用画像におけるテキストプロンプト対応のPCS向けに、SAM 3アーキテクチャを適応させています。このモデルには、肝臓や腎臓などの臓器名や、腫瘍や病変などの病変関連概念といった、明示的な解剖学的・病理学的用語でプロンプトを与えられます。プロンプトを与えると、モデルは医用画像内の対応する領域を直接セグメンテーションします。
MedSAM-3は、テキストと画像の両方を推論できるマルチモーダル大規模言語モデル(MLLMまたはマルチモーダルLLM)も統合しています。これらのモデルはエージェントを介在させた構成で動作し、より難しい症例で精度を高めるために結果を反復的に改善します。
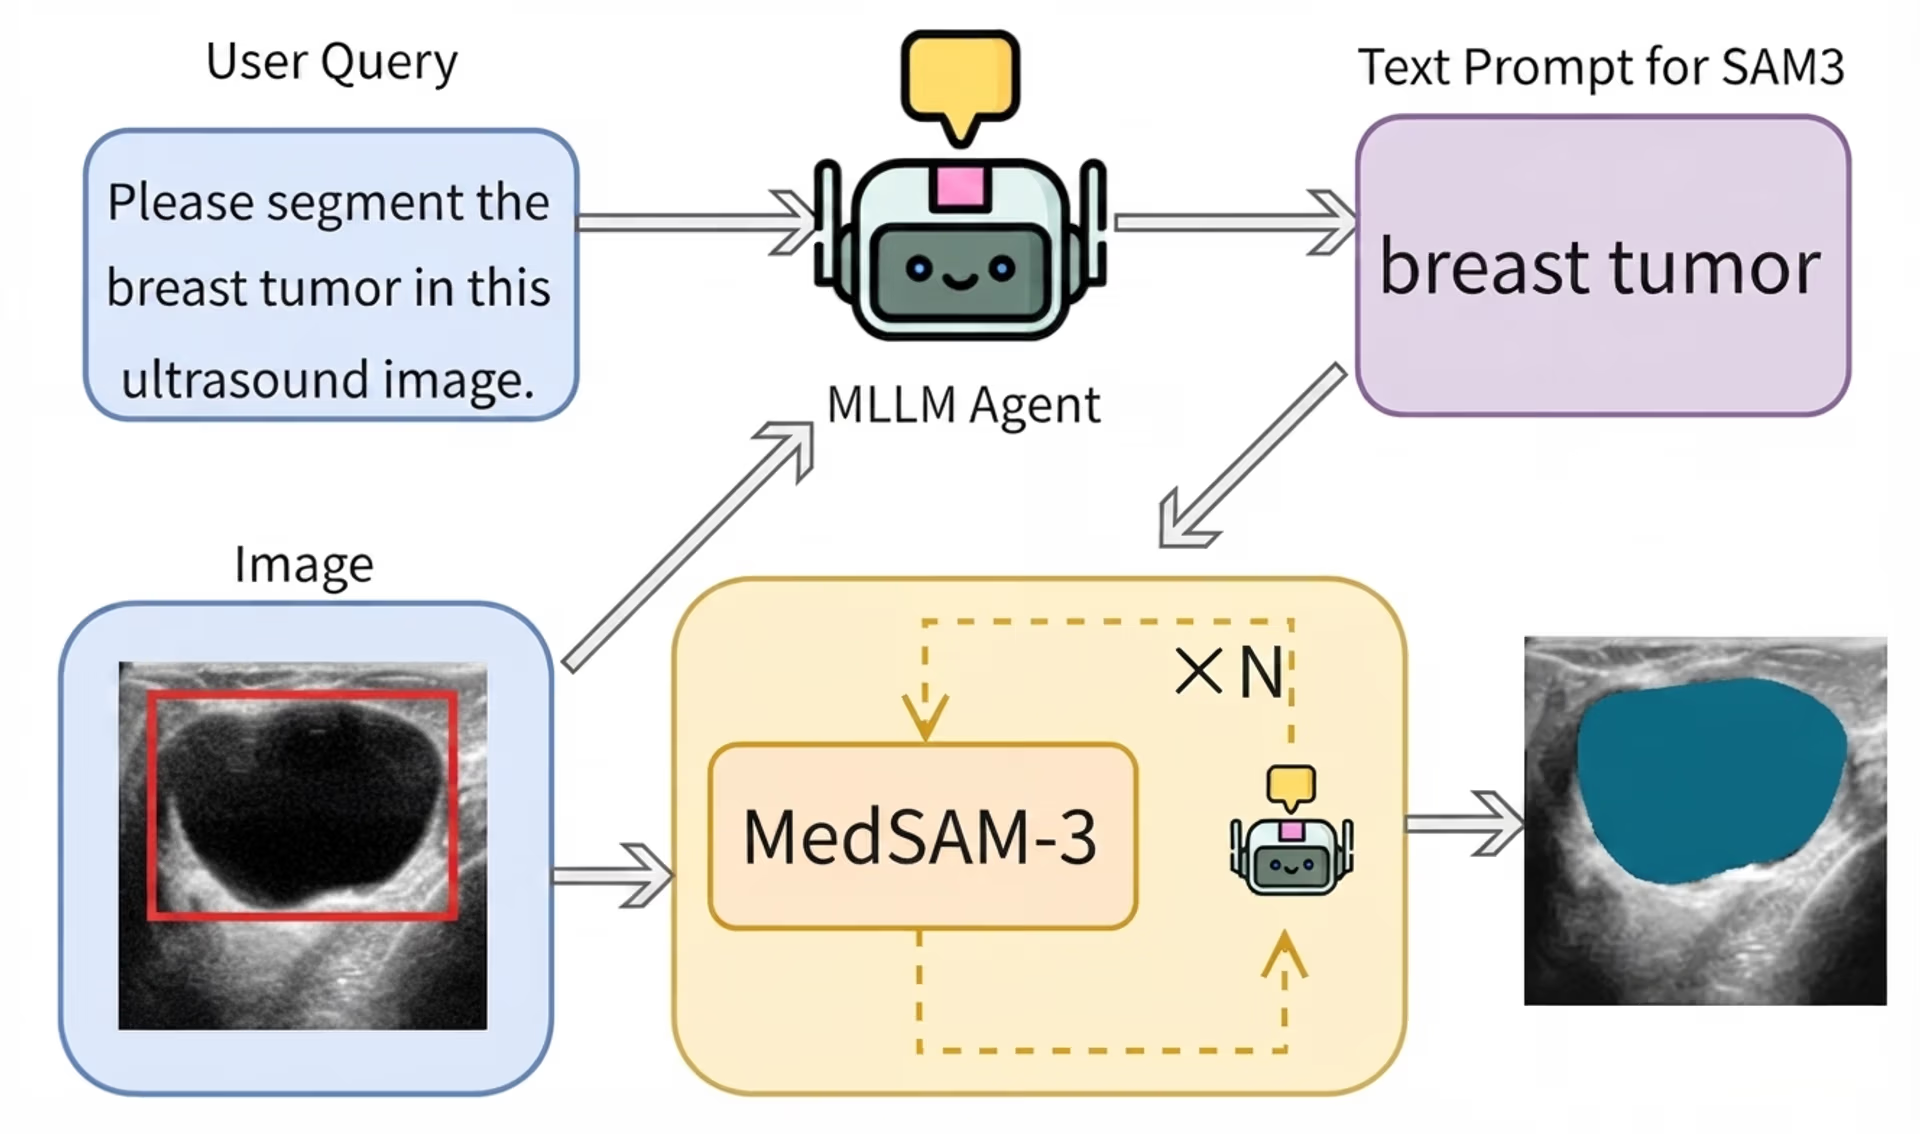
図3. 医用画像におけるテキストプロンプトによる腫瘍セグメンテーションのMedSAM-3パイプライン(出典)
MedSAM-3は、X線、MRI、CT、超音波、動画のデータで優れた性能を発揮し、PCSが実際の臨床現場における医用画像ワークフローの柔軟性と効率性を高めることを示しています。
ロボット手術と自動化に向けた適応型セグメンテーション#
ロボット手術では、器具を追跡し、急速に変化する手術シーンを理解するためにビジョンシステムが使われます。器具は素早く動き、照明は変化し、新しい器具がいつでも現れる可能性があるため、事前定義されたラベル体系の維持は困難です。
PCSを使えば、ロボットは器具を追跡し、カメラの向きを調整し、手術の手順をリアルタイムで追うことができます。これにより、手動でのラベリングが減り、さまざまな手術に合わせてシステムを調整しやすくなります。外科医や自動システムは、「グリッパー」、「メス」、「カメラ器具」などのテキストプロンプトを使って、画像内でセグメンテーションする対象を指定できます。
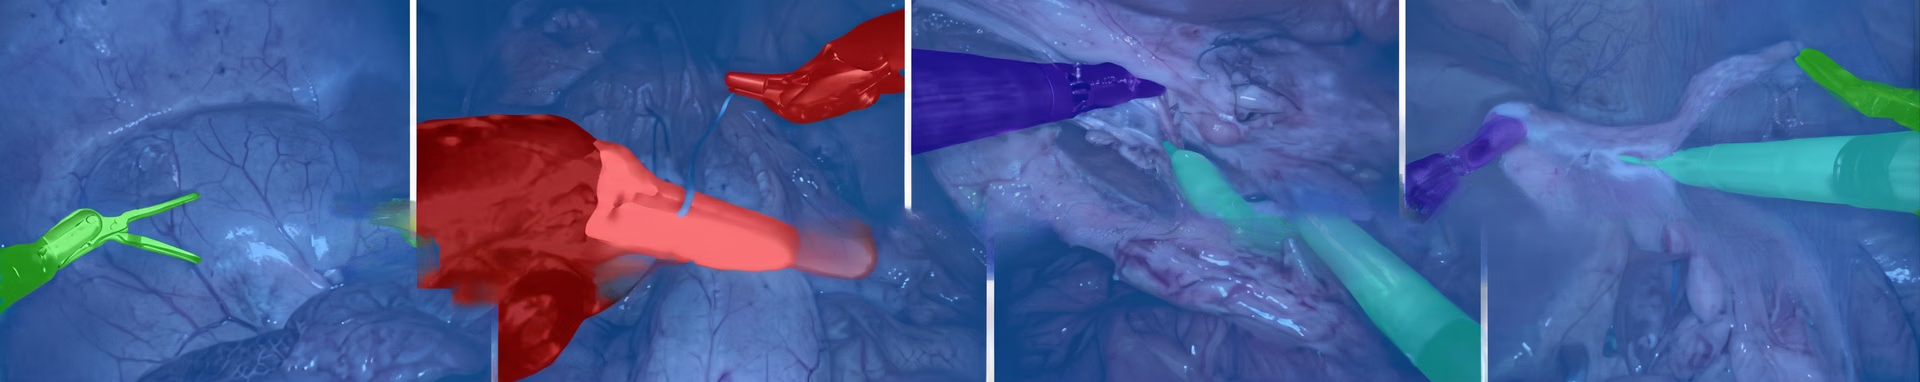
図4. ロボット手術で使用される手術器具のセグメンテーション(出典)
Ultralytics YOLOE-26によるオープンボキャブラリーセグメンテーション#
プロンプト可能な概念セグメンテーションに関連する、もう一つの興味深い最先端モデルがUltralytics YOLOE-26です。オープンボキャブラリーのプロンプト主導型セグメンテーションを、Ultralytics YOLOモデルファミリーに導入します。
YOLOE-26はUltralytics YOLO26アーキテクチャを基盤とし、オープンボキャブラリーのインスタンスセグメンテーションに対応しています。YOLOE-26では、複数の方法でセグメンテーションを指定できます。
短く視覚的に根拠のあるフレーズで対象物体を指定するテキストプロンプトと、画像内の手掛かりに基づいて追加の指示を与えるビジュアルプロンプトに対応しています。さらにYOLOE-26には、ユーザーのプロンプトを必要とせず、組み込みの語彙を使ってモデルが物体を検出・セグメンテーションする、ゼロショット推論向けのプロンプト不要モードもあります。
YOLOE-26は、物体カテゴリが変化する一方で、低レイテンシと安定したスループットが不可欠な動画分析、ロボティクスの認識、エッジベースのシステムなどのアプリケーションに適しています。また、アノテーションプロセスの一部を自動化してワークフローを効率化するため、データのラベル付けやデータセットのキュレーションにも特に役立ちます。
プロンプト可能な概念セグメンテーションの長所と短所#
プロンプト可能な概念セグメンテーションを使う主な利点を以下に示します。
- 反復とプロトタイピングの高速化: データセットを再構築したりモデルを再学習させたりする代わりに、プロンプトを変更して新しいセグメンテーションタスクをすばやく試せるため、実験と開発を加速できます。
- ドメインをまたいだ適応性: 同じPCSモデルを、ワークフローをほとんど変更せずに、医用画像、ロボティクス、動画分析などの異なるドメインに適用できることがよくあります。
- 対話的な改善: ユーザーはプロンプトを反復的に調整したり指示を追加したりして結果を改善できるため、再学習なしで曖昧なシーンやエッジケースに対応しやすくなります。
PCSには明確な利点がありますが、以下のような制約も考慮する必要があります。
- プロンプトへの感度: プロンプトの表現方法や与え方を少し変えただけでも、出力に影響することがあります。曖昧すぎるプロンプトや具体的すぎるプロンプトは、不完全または誤ったセグメンテーションにつながる可能性があります。
- 予測しにくい動作: 固定ラベルから選ぶのではなく、モデルがプロンプトを解釈するため、シーンや入力によって結果のばらつきが大きくなる場合があり、厳密に制御されたパイプラインでは問題となる可能性があります。
- 概念の解釈が曖昧: 主観的または明確に定義されていない概念もあり、ユーザー間や画像間でセグメンテーション結果に一貫性がなくなることがあります。
- 非常に具体的な対象に対する信頼性の限界: 欠陥検出のように、微細な特徴を正確かつ一貫して識別する必要がある、限定的で個別性の高いタスクでは、プロンプトベースのモデルは一般に信頼性が低くなります。
プロンプト可能なセグメンテーションと従来型セグメンテーションの選択#
プロンプト可能なセグメンテーションを検討する際、どの用途に最も適しているのか、また、解決しようとしている問題にはUltralytics YOLO26のような従来型のコンピュータービジョンモデルが適しているのはどのような場合か、疑問に思うかもしれません。プロンプト可能なセグメンテーションは一般的な物体には有効ですが、非常に正確で一貫した結果が必要な用途には適していません。
欠陥検出はその好例です。製造業では、欠陥は小さな傷、へこみ、位置ずれ、表面の不規則性など、微細で目立ちにくいことがよくあります。また、材料、照明、生産条件によって大きく異なる場合もあります。
こうした問題は単純なプロンプトで説明するのが難しく、汎用モデルで確実に検出するのはさらに困難です。全体として、プロンプトベースのモデルは欠陥を見逃したり、不安定な結果を出したりする傾向があります。一方、欠陥データで特別に学習させたモデルは、実環境の検査システムにおいてはるかに高い信頼性を発揮します。
重要なポイント#
プロンプト可能な概念セグメンテーションにより、新しい物体や概念が常に現れる実環境に合わせて、ビジョンシステムを調整しやすくなります。固定ラベルに縛られるのではなく、ユーザーはセグメンテーションしたい対象を説明するだけでモデルに処理を任せられるため、時間を節約し、手作業を減らせます。PCSにはまだ制約がありますが、すでに実際のセグメンテーションの活用方法を変えつつあり、将来のビジョンシステムにおいて中核的な役割を担う可能性があります。
GitHubリポジトリをご覧いただき、コミュニティに参加して、AIについてさらに詳しく学びましょう。ロボティクスにおけるAIと製造業におけるコンピュータービジョンについては、ソリューションページをご覧ください。ライセンスオプションを確認して、今すぐビジョンAIを始めましょう。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









