ビジョンAIが実現する非接触ジェスチャー認識技術
コンピュータービジョンが、さまざまなアプリケーションで手のジェスチャーを検出、追跡、認識するジェスチャー認識技術をどのように支えるのかをご紹介します。
 Abirami Vina11 分で読めます
テクノロジーの進化に伴い、テクノロジーとの関わり方も変化しています。初期の機械は人力や機械式の操作部に依存していましたが、現代のコンピュータサイエンスによってタッチスクリーンや音声入力が登場しました。
ジェスチャー認識は次の段階の一部として、自然な動きをユーザーインターフェースに活用します。簡単な手振りやつまむ動き、素早いハンドサインで、アプリ、画面、機械を操作できるようになっています。
この非接触型の操作は、カメラが捉えた映像を機械が認識して解釈できるようにするAI分野のコンピュータビジョンによって実現できます。ビジョンAIシステムは、スマートフォン、仮想現実(VR)・拡張現実(AR)ヘッドセット、自動車、スマートホームデバイスに組み込めます。そこでジェスチャーをタップ、クリック、ボタンの代わりに使うことで、よりスムーズなユーザー体験を実現できます。
タッチレス操作は、日常生活でますます一般的になっています。職場や共有スペースでは、物理的な接触を避けることで衛生面と安全性を高められます。また、多くのデジタル製品がハンズフリー操作へ移行しており、ジェスチャーはデバイスに触れずに操作するための簡単で直感的な方法となっています。
この記事では、ジェスチャー認識とは何か、コンピュータービジョンがどのように精度を高めるのか、そして実世界のアプリケーションでどのように使われているのかを紹介します。
ジェスチャー認識とは何ですか?#
ジェスチャー認識は、手のサインや体の動きなどの人間のジェスチャーを機械が理解し、デジタル操作に変換できるようにするセンシング技術です。画面をタップしたりボタンを押したりする代わりに、ユーザーは簡単で自然な動きでデバイスを操作できます。
操作がより直感的になるため、ジェスチャーベースの入力は多くの機械学習およびAI駆動型制御システムで採用されています。特に、手のジェスチャー認識は広く使われているジェスチャー認識の一種で、コンピュータビジョンを活用することがよくあります。
簡単に言えば、ビジョンAIソリューションはカメラ映像内の手を検出し、その動きや形の変化を追跡して、既知のジェスチャーパターンと照合し、画面上の操作を実行できます。
こうしたソリューションの重要な要素が、さまざまな手のジェスチャーを示すラベル付き画像や動画のデータセットで学習させるコンピュータビジョンモデルです。多様な学習データと慎重な評価により、モデルはさまざまなユーザー、照明条件、背景に対して汎化しやすくなり、実環境でより確実にジェスチャーを認識できます。
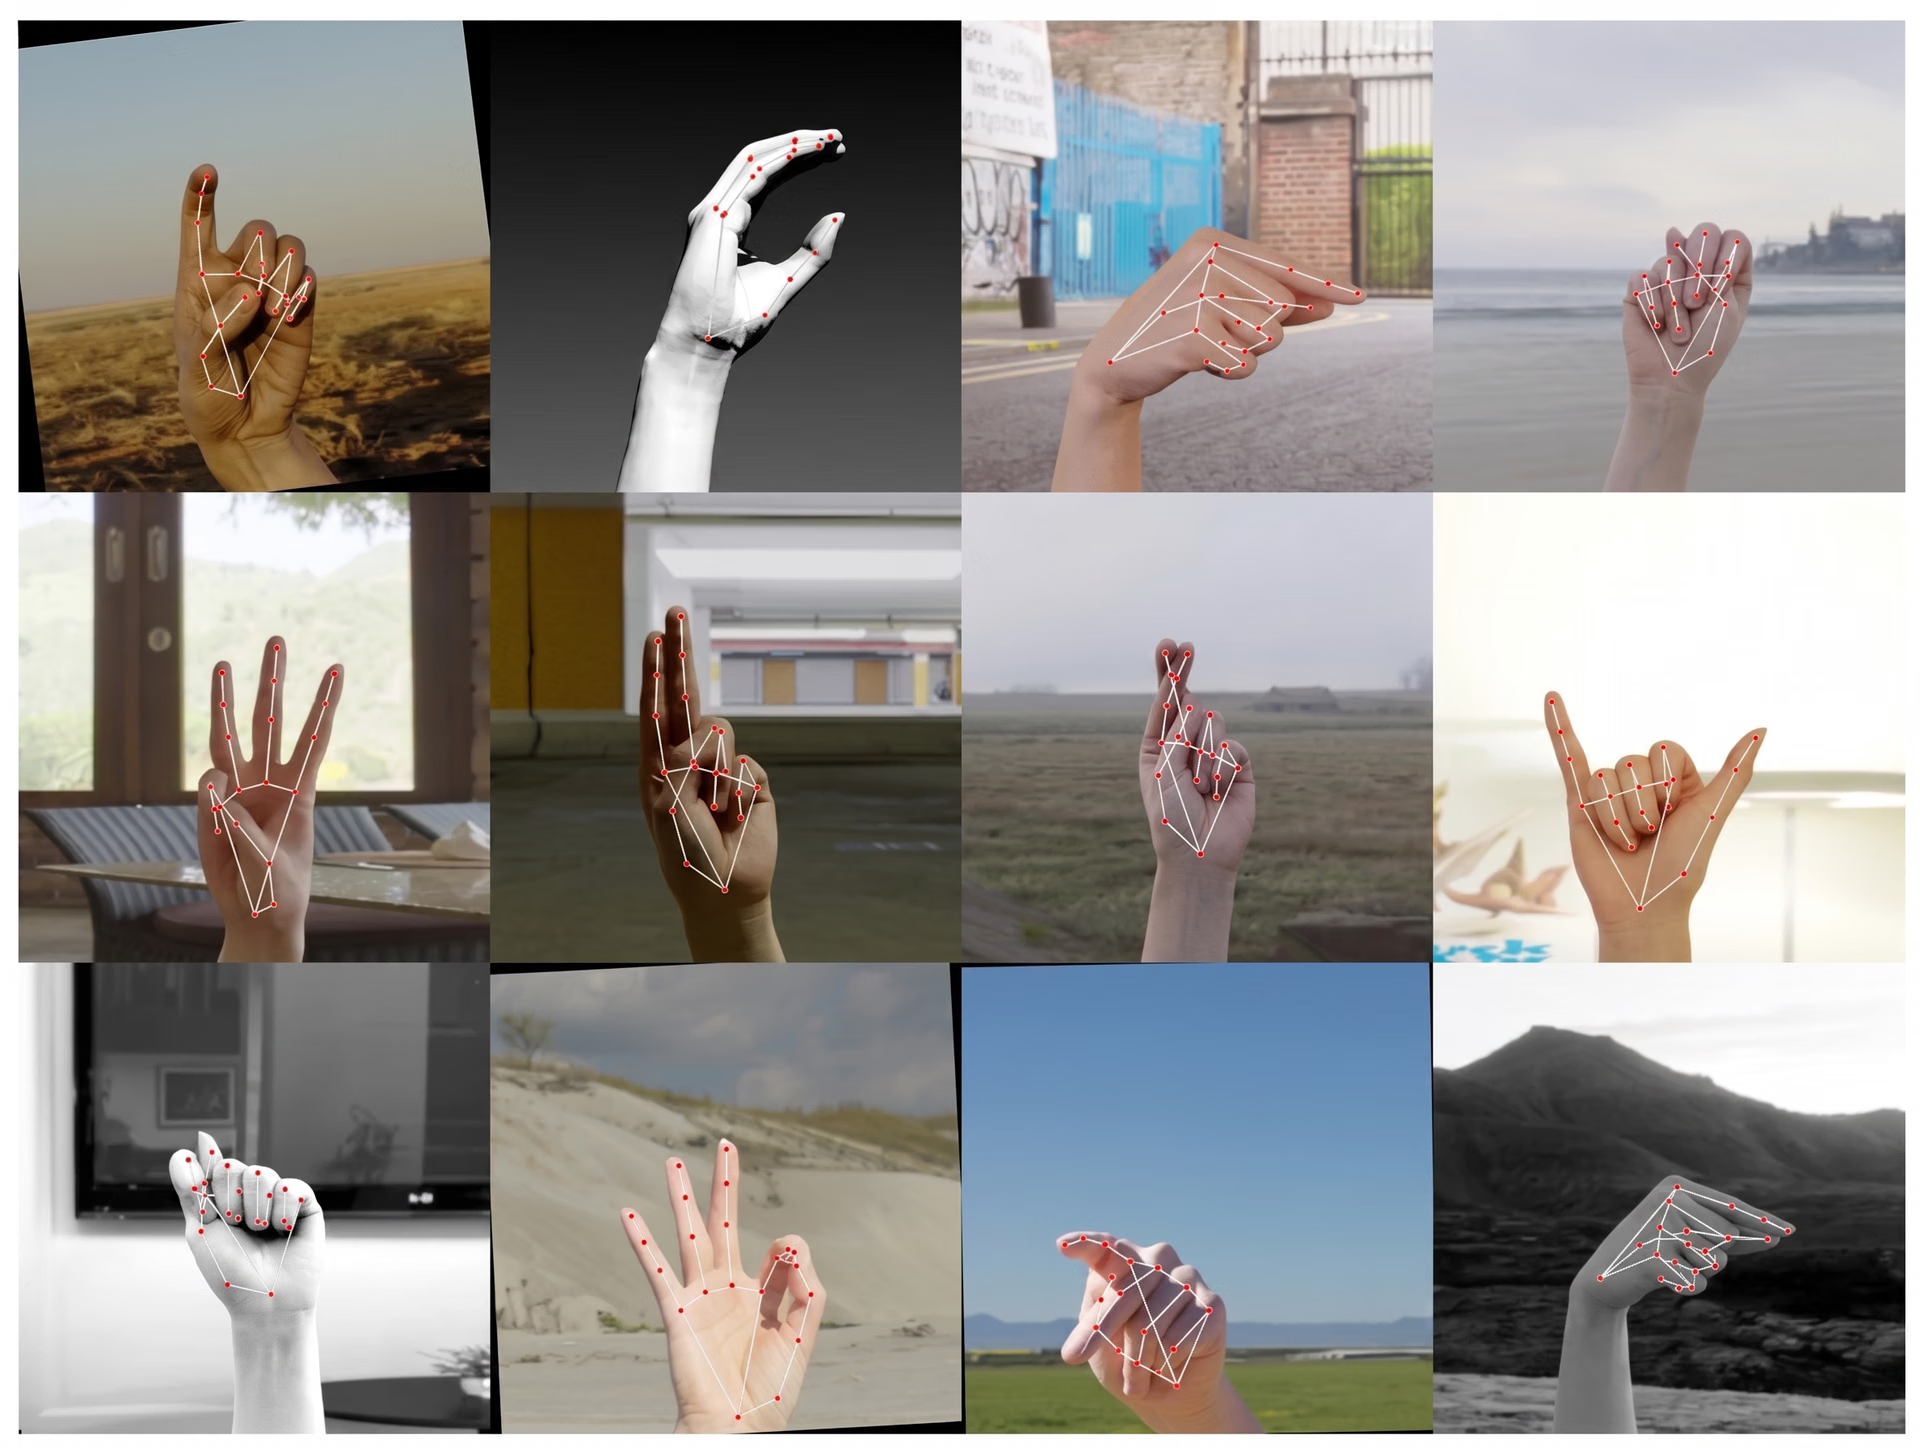
図1. ジェスチャーのキーポイントを検出するコンピュータビジョンモデルの学習に使用するデータ(出典)
さまざまなジェスチャーと人間とコンピュータのインタラクションを探る#
ジェスチャー認識におけるコンピュータビジョンの役割を詳しく見る前に、少し立ち戻り、こうしたシステムが一般に認識するジェスチャーの種類を見てみましょう。
多くの場合、ジェスチャーは静的ジェスチャーと動的ジェスチャーの2種類に分けられます。静的ジェスチャーは、親指を立てる動作、停止の合図、ピースサインなど、固定された手の形です。動きを伴わないため、多くの場合、単一の画像フレームから認識できます。
一方、動的ジェスチャーは、手を振ったり空中でスワイプしたりするような、時間経過に伴う動きを含みます。認識するには、ビジョンAIシステムが複数のフレームを分析し、手の動きを追跡してジェスチャーの方向とタイミングを理解する必要があります。
ジェスチャー認識におけるコンピュータビジョンアルゴリズムの役割#
ジェスチャー認識システムは、さまざまな方法で構築できます。手の動きを捉えるために、手袋や手首に装着するトラッカーなどのウェアラブルセンサーを使うシステムもあります。
こうした構成は高精度になり得ますが、必ずしも実用的とは限りません。ウェアラブルデバイスは装着、設定、充電、保守が必要であり、共有スペースや日常的な利用では制約に感じられることがあります。
そのため、現在の多くのシステムは、代わりにコンピュータービジョンを採用しています。標準的なRGBカメラや深度センサー、飛行時間センサーを使うと、デバイスはユーザーが追加の機器を装着することなく、手や体の動きをリアルタイムで捉えられます。そのため、ビジョンベースのジェスチャー認識は、スマートフォン、自動車、スマートテレビ、AR・VRヘッドセットに適しています。
たとえば、Ultralytics YOLO11や新しいUltralytics YOLO26などのコンピュータービジョンモデルは、物体検出、物体追跡、姿勢推定などのタスクに対応しています。これらの機能を使って、各フレーム内の手を検出し、時間経過に伴う動きを追跡し、指先や関節などのキーポイントをマッピングできます。これにより、手のひらを上げて一時停止する、指でつまんでズームする、スワイプしてメニューを操作する、AR・VRで指さして項目を選択するといったジェスチャーを認識できます。
人間と機械のインタラクション認識に用いられるコンピュータビジョンタスク#
ジェスチャー認識で使用される主なコンピュータビジョンタスクを紹介します。
- 物体検出:画像やビデオフレーム内の手の位置を特定するタスクで、通常は手の周囲にバウンディングボックスを描きます。システムがジェスチャーの領域に集中し、不要な背景の詳細を無視するのに役立ちます。
- 物体追跡:物体検出を基盤とし、複数のフレームにわたって検出された手を追跡し、時間経過に伴う個体識別情報を維持します。動きや方向が重要な動的ジェスチャーで特に役立ちます。
- 姿勢推定:バウンディングボックスに注目する代わりに、姿勢推定では指先、関節、手首などの手のキーポイントを特定します。これらのランドマークによって指の位置や微細な動きを捉える簡易的な手の骨格が生成され、より詳細なジェスチャー分類が可能になります。Hand Keypointsなどのデータセットには、学習用にラベル付けされた手のランドマークが含まれています。
- インスタンスセグメンテーション:見えている手ごとにマスクを生成し、ピクセル単位で各手を背景から分離するタスクです。複雑なシーン、手が重なっている場合、フレーム内に複数の手がある場合に役立ちます。
多くのビジョンAIソリューションでは、単一のパイプラインの一部としてこれらのタスクを組み合わせます。たとえば、物体検出で手を見つけた後、追跡を使って動的ジェスチャーのために複数のフレームにわたって手を追跡するシステムが考えられます。
ジェスチャーが指の位置に依存する場合、姿勢推定でキーポイントを追加して詳細を捉えられます。また、インスタンスセグメンテーションを使えば、複雑なシーンや複数の手が重なる場合に各手をより正確に分離できます。これらの処理を組み合わせることで位置と動きの両方の情報が得られ、ジェスチャー認識の精度と信頼性が高まります。
ビジョンベースのジェスチャー認識の仕組み#
ジェスチャー認識を支えるコンピュータビジョンタスクについて理解したところで、ビジョンベースのシステムの仕組みを順を追って見ていきましょう。
一般的なシステムでは、まずカメラから動画を取り込み、デバイスが対応している場合は深度データも取得します。その後、画像処理によってフレームを前処理し、リサイズ、安定化、ノイズやモーションブラーの軽減などを行って、モデルが一貫して処理しやすくします。
次に、システムは検出またはセグメンテーションを使ってフレーム内の手を特定し、追跡によって時間経過に伴う動きを捉えます。より細かな情報が必要なアプリケーションでは、姿勢推定を実行して指先や関節などのキーポイントを抽出することもあります。この情報を使って、モデルは親指を立てるような単一フレームのポーズや、スワイプのような動作パターンなど、ジェスチャーを分類します。
最後に、認識したジェスチャーを、スクロール、拡大・縮小、項目の選択、音量調整、AR・VRの操作など、インターフェース上のアクションに対応付けます。具体的なパイプラインはさまざまで、シンプルなアプリケーションでは手順を少なくし、複雑なアプリケーションでは検出、追跡、姿勢推定を組み合わせて精度を高めます。
ビジョンベースのジェスチャー認識の応用例#
次に、ビジョンベースのジェスチャー認識の実世界における活用例を見ていきましょう。
車載インフォテインメントシステムでのジェスチャー操作#
ジェスチャー認識は、特にインフォテインメントシステムを中心に、スマートな車載インターフェースで使われ始めています。簡単な手の動きで特定の機能を操作できるため便利で、ドライバーがタッチスクリーンや物理ボタンに手を伸ばす頻度を減らせます。たとえば、短いジェスチャーで音量を調整したり、通話を操作したり、画面上のメニューを移動したりできます。
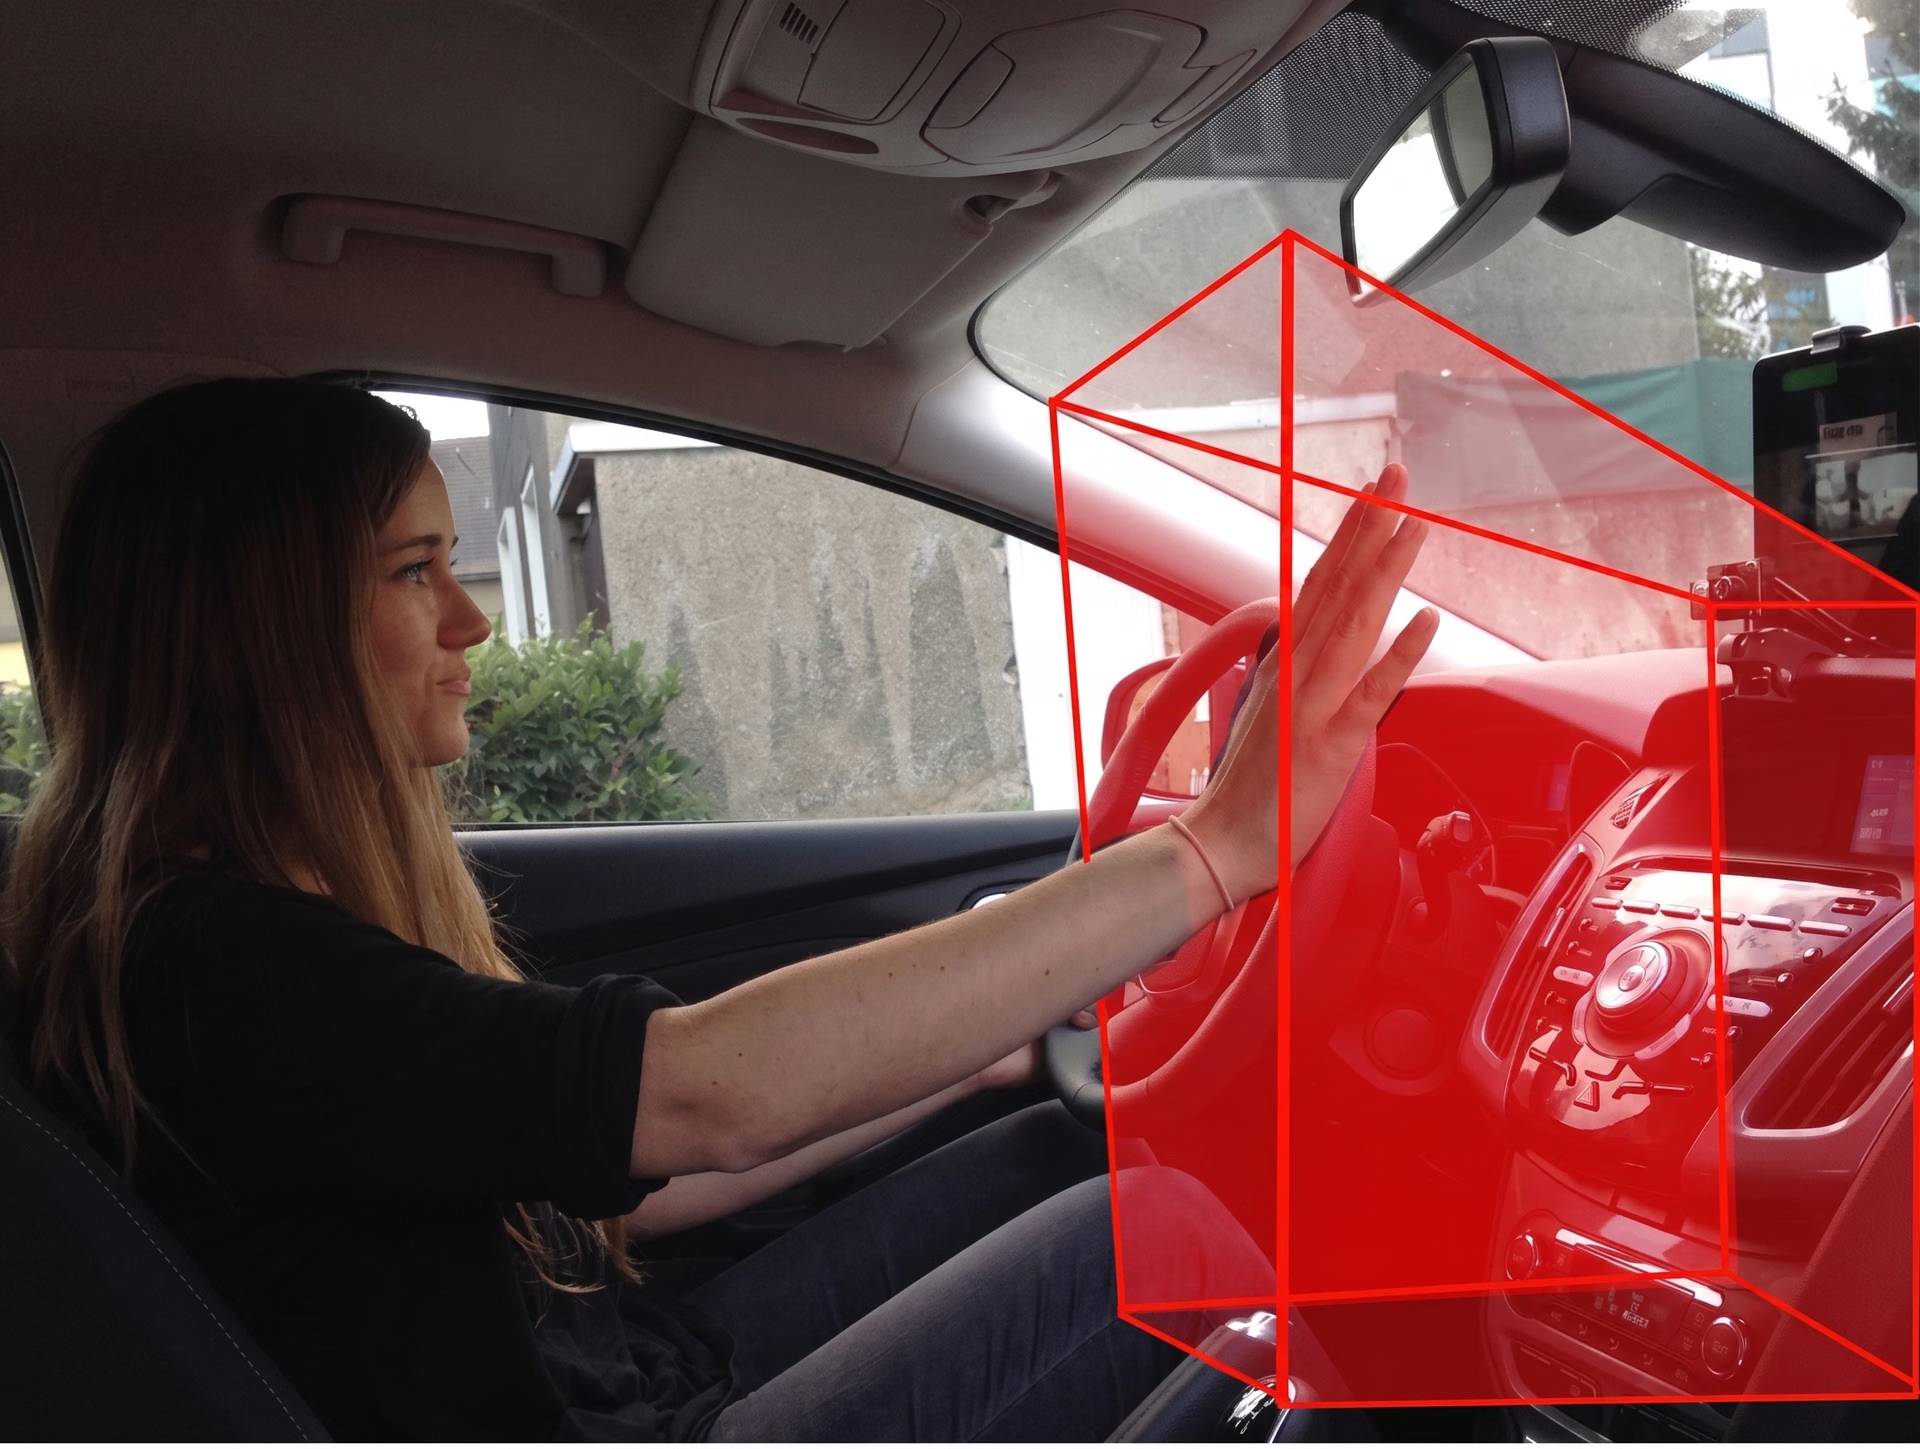
図2. インフォテインメントシステムの検出範囲内で手のジェスチャーをするドライバー(出典)
ゲームにおけるジェスチャー操作#
ゲームや没入型体験では、ジェスチャーベースの操作によって、仮想世界との関わり方が変わりつつあります。コントローラーやジョイスティックだけに頼るのではなく、プレイヤーは自然な手の動きでメニューを操作したり、仮想オブジェクトを拾ったり、キャラクターを操作したり、ゲーム内のアクションを実行したりできます。
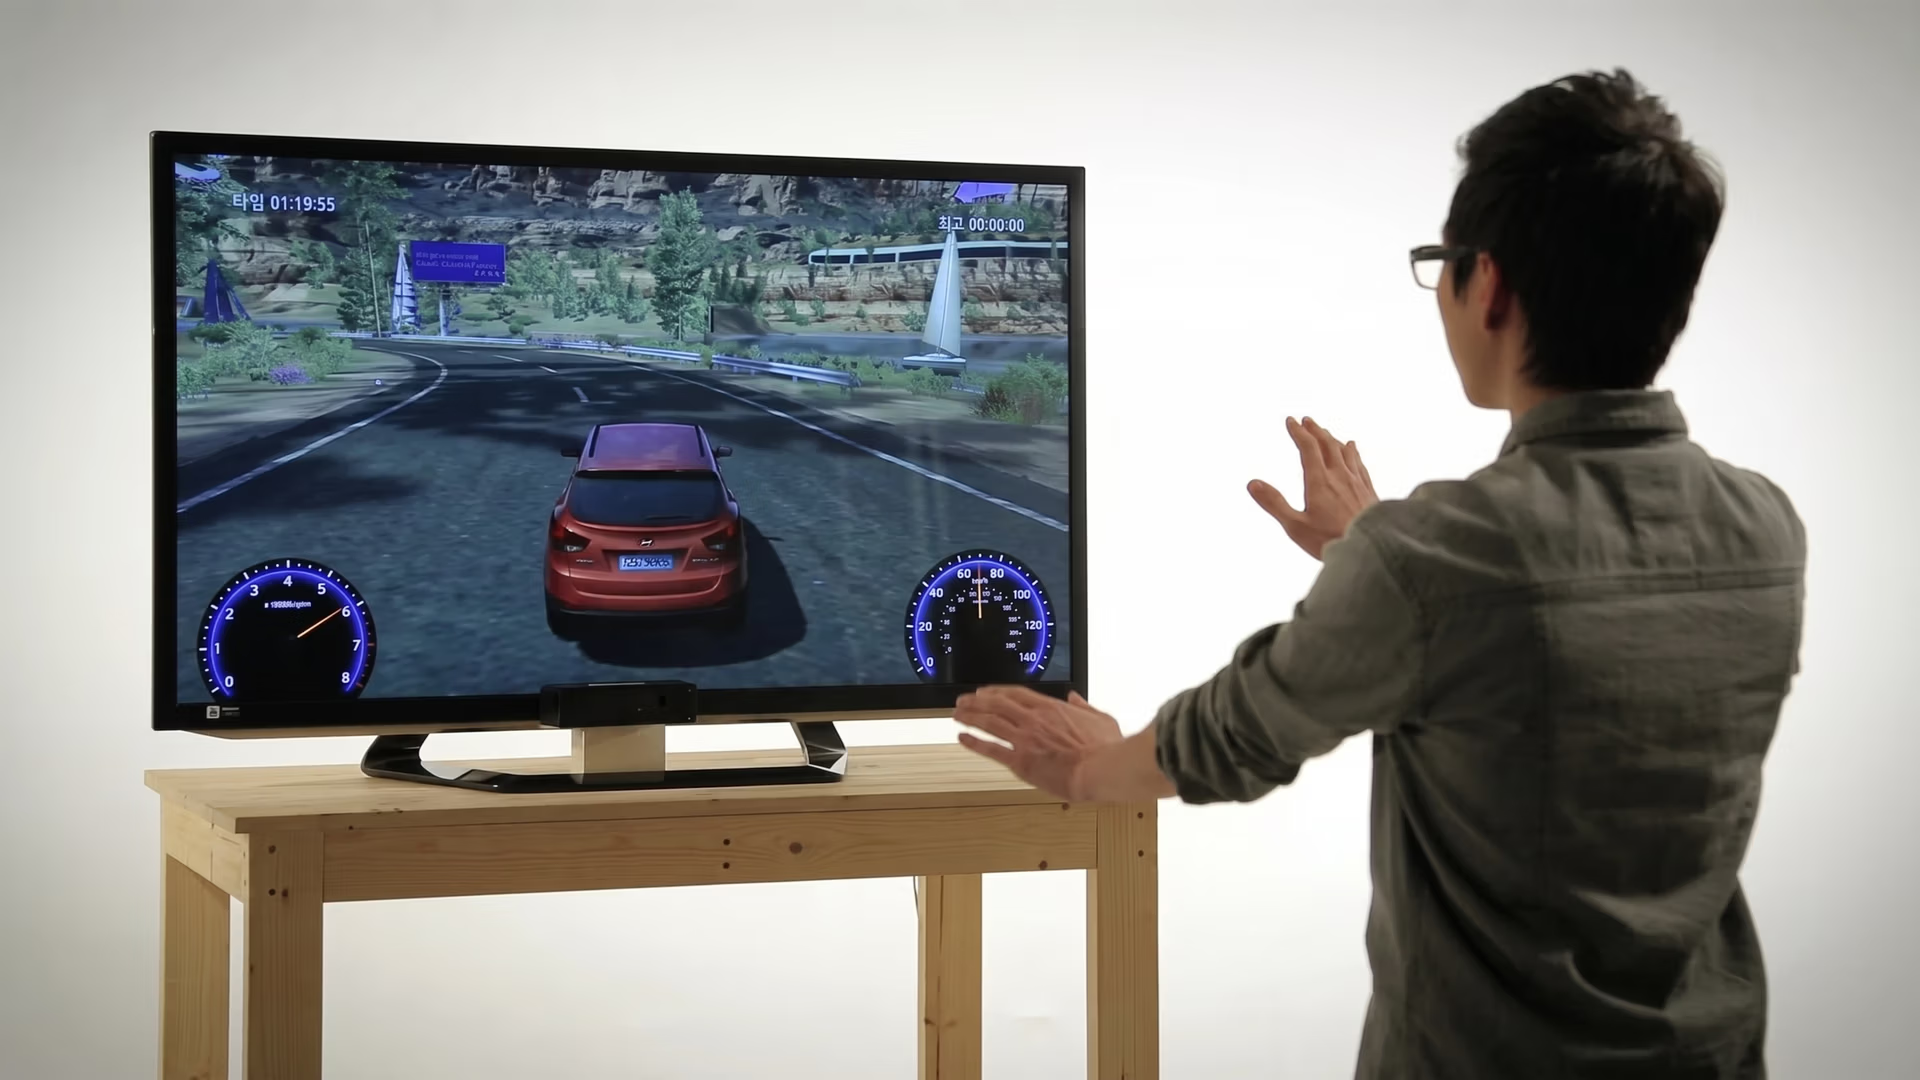
図3. 手のジェスチャーを使ったゲームプレイ(出典)。
このような非接触型の操作は、特にAR・VRで、より滑らかな操作感をもたらします。その結果、手のトラッキングとジェスチャー操作は、VRや複合現実ヘッドセットの一般的な機能になりつつあります。
スマートホームデバイスのシームレスなジェスチャー操作#
スマートテレビ、スピーカー、ネットワーク接続型照明などのスマートホームデバイスでは、すばやく非接触で操作できるジェスチャー制御への対応が始まっています。簡単な手の動きで、スイッチやリモコンに手を伸ばすことなく、照明をつけたり、音量を調整したり、基本的なコマンドを実行したりできます。
たとえば、ホームエンターテインメント環境では、内蔵または接続された深度カメラが、スワイプ、指差し、手を上げる動作などを認識できます。これにより、部屋の離れた場所からでもメニューの閲覧、設定変更、選択の確定がしやすくなります。カメラ映像は、バックグラウンドでコンピュータビジョンモデルによってリアルタイムに処理され、ジェスチャーが検出・解釈されます。
人工知能を活用したロボティクスのジェスチャー制御#
工場で、部品を運んでいる作業員や手袋を着用している作業員、稼働中の装置から安全な距離を保つ必要がある作業員が、ロボットを誘導しなければならない状況を考えてみましょう。こうした環境では、ボタンや操作パネルに手を伸ばすのに時間がかかり、危険を伴うことさえあります。
これに対し、ジェスチャーベースの制御システムは、こうした機械を操作するための、より実用的でハンズフリーな方法となります。人と並んで作業するよう設計された協働ロボット、いわゆるコボットで特に役立ちます。
操作パネルに近づく代わりに、作業者は簡単な手の合図で、離れた場所からロボットの起動、停止、誘導を行えます。物理的な操作部への依存を減らし、工場現場でより安全な作業工程を支援できます。
ディープラーニングモデルや学習アルゴリズムを活用した高度なビジョンベース制御システムは、基本的なコマンドを超えることもできます。より細かな手の動きを解釈し、小さな方向の変化にも滑らかに応答することで、より精密な誘導と自動化を実現します。
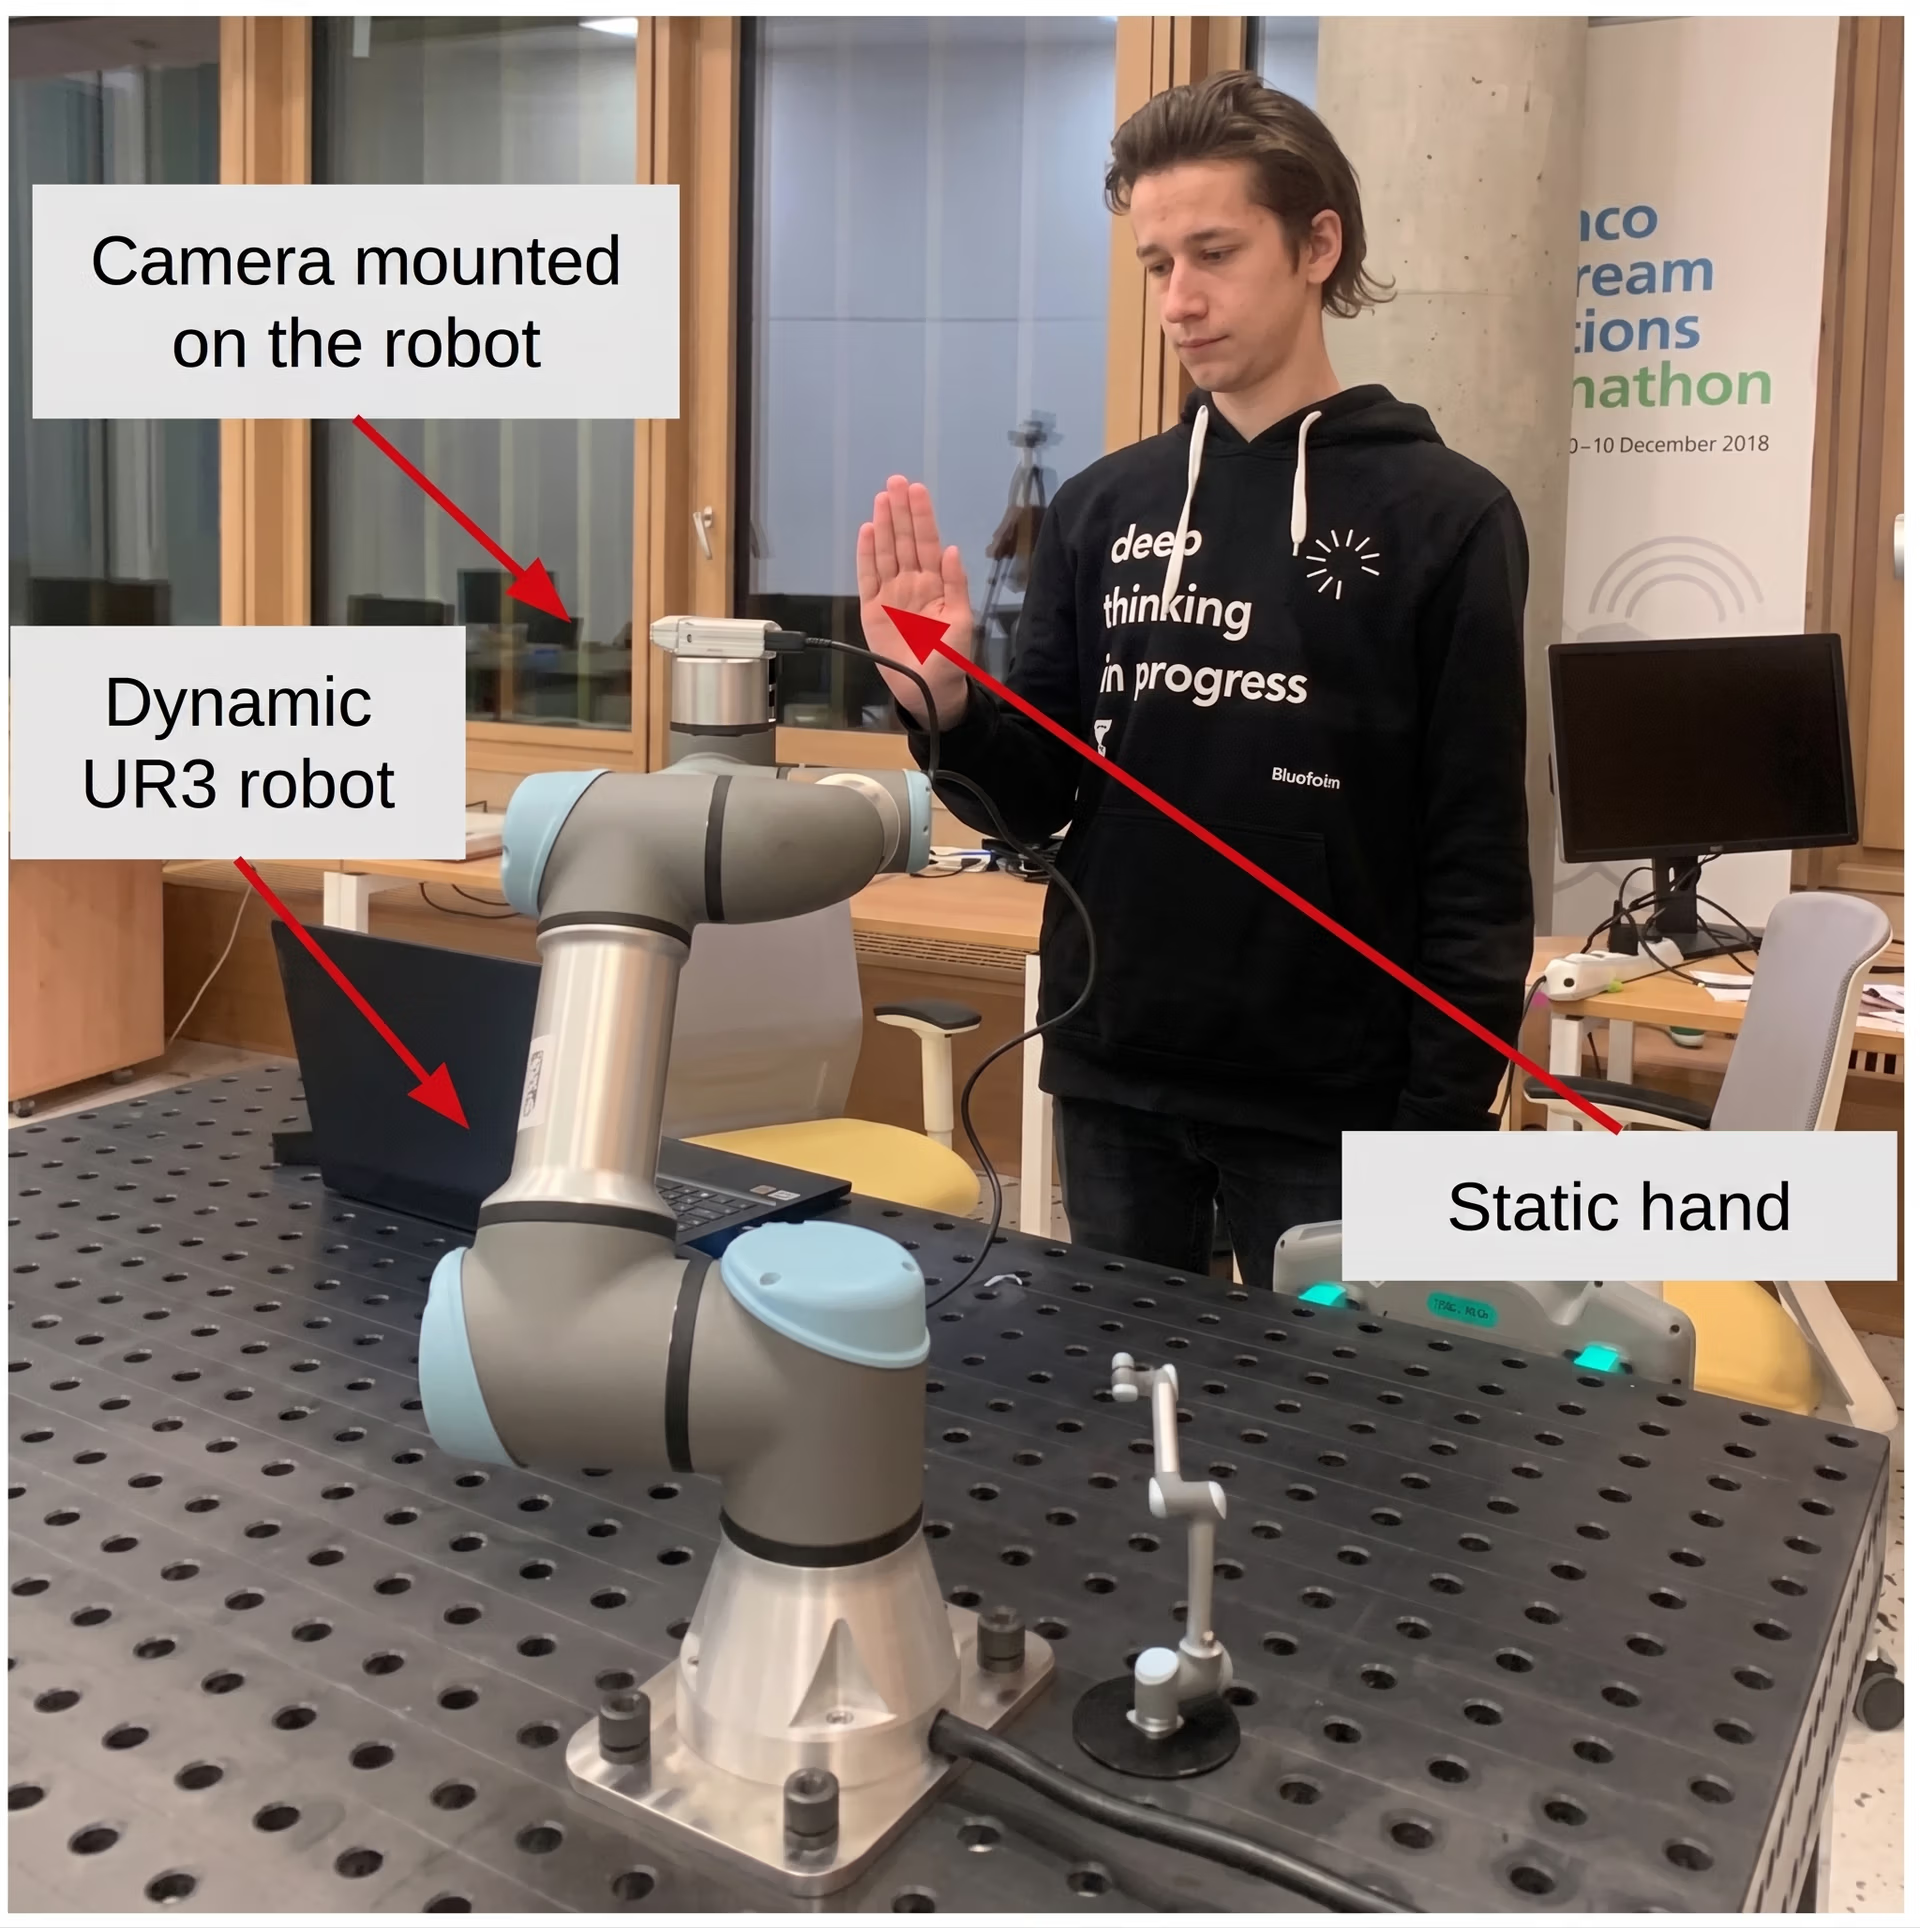
図4. ユーザーのジェスチャーを分析するロボットハンド(出典)
ジェスチャー認識技術のメリットとデメリット#
ジェスチャー認識技術を利用する主なメリットをいくつか紹介します。
- アクセシビリティの向上:ジェスチャーは、キーボード、タッチスクリーン、コントローラーの操作が難しいユーザーにとって、代替手段となります。
- 離れた場所から操作可能:部屋の離れた場所からでもジェスチャーを認識できるため、スマートテレビ、キオスク、家庭用デバイスで役立ちます。
- デバイス間の柔軟性:スマートフォン、自動車、スマートディスプレイ、AR・VRヘッドセットで同じようなジェスチャーを使えるため、一貫性のある操作が可能です。
一方で、実環境では精度や一貫性に影響する課題もあります。考慮すべき要素をいくつか紹介します。
- 照明やカメラ品質の問題:暗い場所、まぶしさ、影、低解像度のカメラは、認識性能を低下させる可能性があります。その結果、モーション制御にも影響する場合があります。
- ユーザーごとの違い:ジェスチャーの仕方には自然な個人差があり、手の大きさ、指の柔軟性、アクセサリーの違いが精度に影響することがあります。
- 高速な動きによる制約: 素早いジェスチャーはモーションブラーを引き起こしたり、モデルが重要なフレームを見逃したりする原因になることがあります。特に、フレームレートの低いカメラでは顕著です。
重要なポイント#
ジェスチャー認識技術は研究室を飛び出し、今では日常的なデバイスやイノベーションの一部になっています。具体的には、コンピュータービジョンによって、ゲーム、ロボティクス、スマートホーム、自動車システムでタッチレス操作が可能になっています。ビジョンモデルの性能向上に伴い、こうしたタッチレスインターフェースは構築しやすくなり、さらに広く使われるようになるでしょう。
コンピュータービジョンモデルの詳細については、コミュニティやGitHubリポジトリをご覧ください。ソリューションページでは、ロボティクスにおけるコンピュータービジョンや物流におけるコンピュータービジョンなどの活用例を紹介しています。ライセンスオプションを確認して、独自のビジョンAIモデルの構築を始めましょう。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









