密集シーンでのUltralytics YOLOセグメンテーション:1,000個のマスク
Ultralytics 8.4.213では、YOLO26n-segがRTX PRO 6000上で合成1080p画像の1,000個のマスクを予測して要約する時間が56.4 msとなり、821.2 msから短縮されました。
 Glenn Jocher12 分で読めます
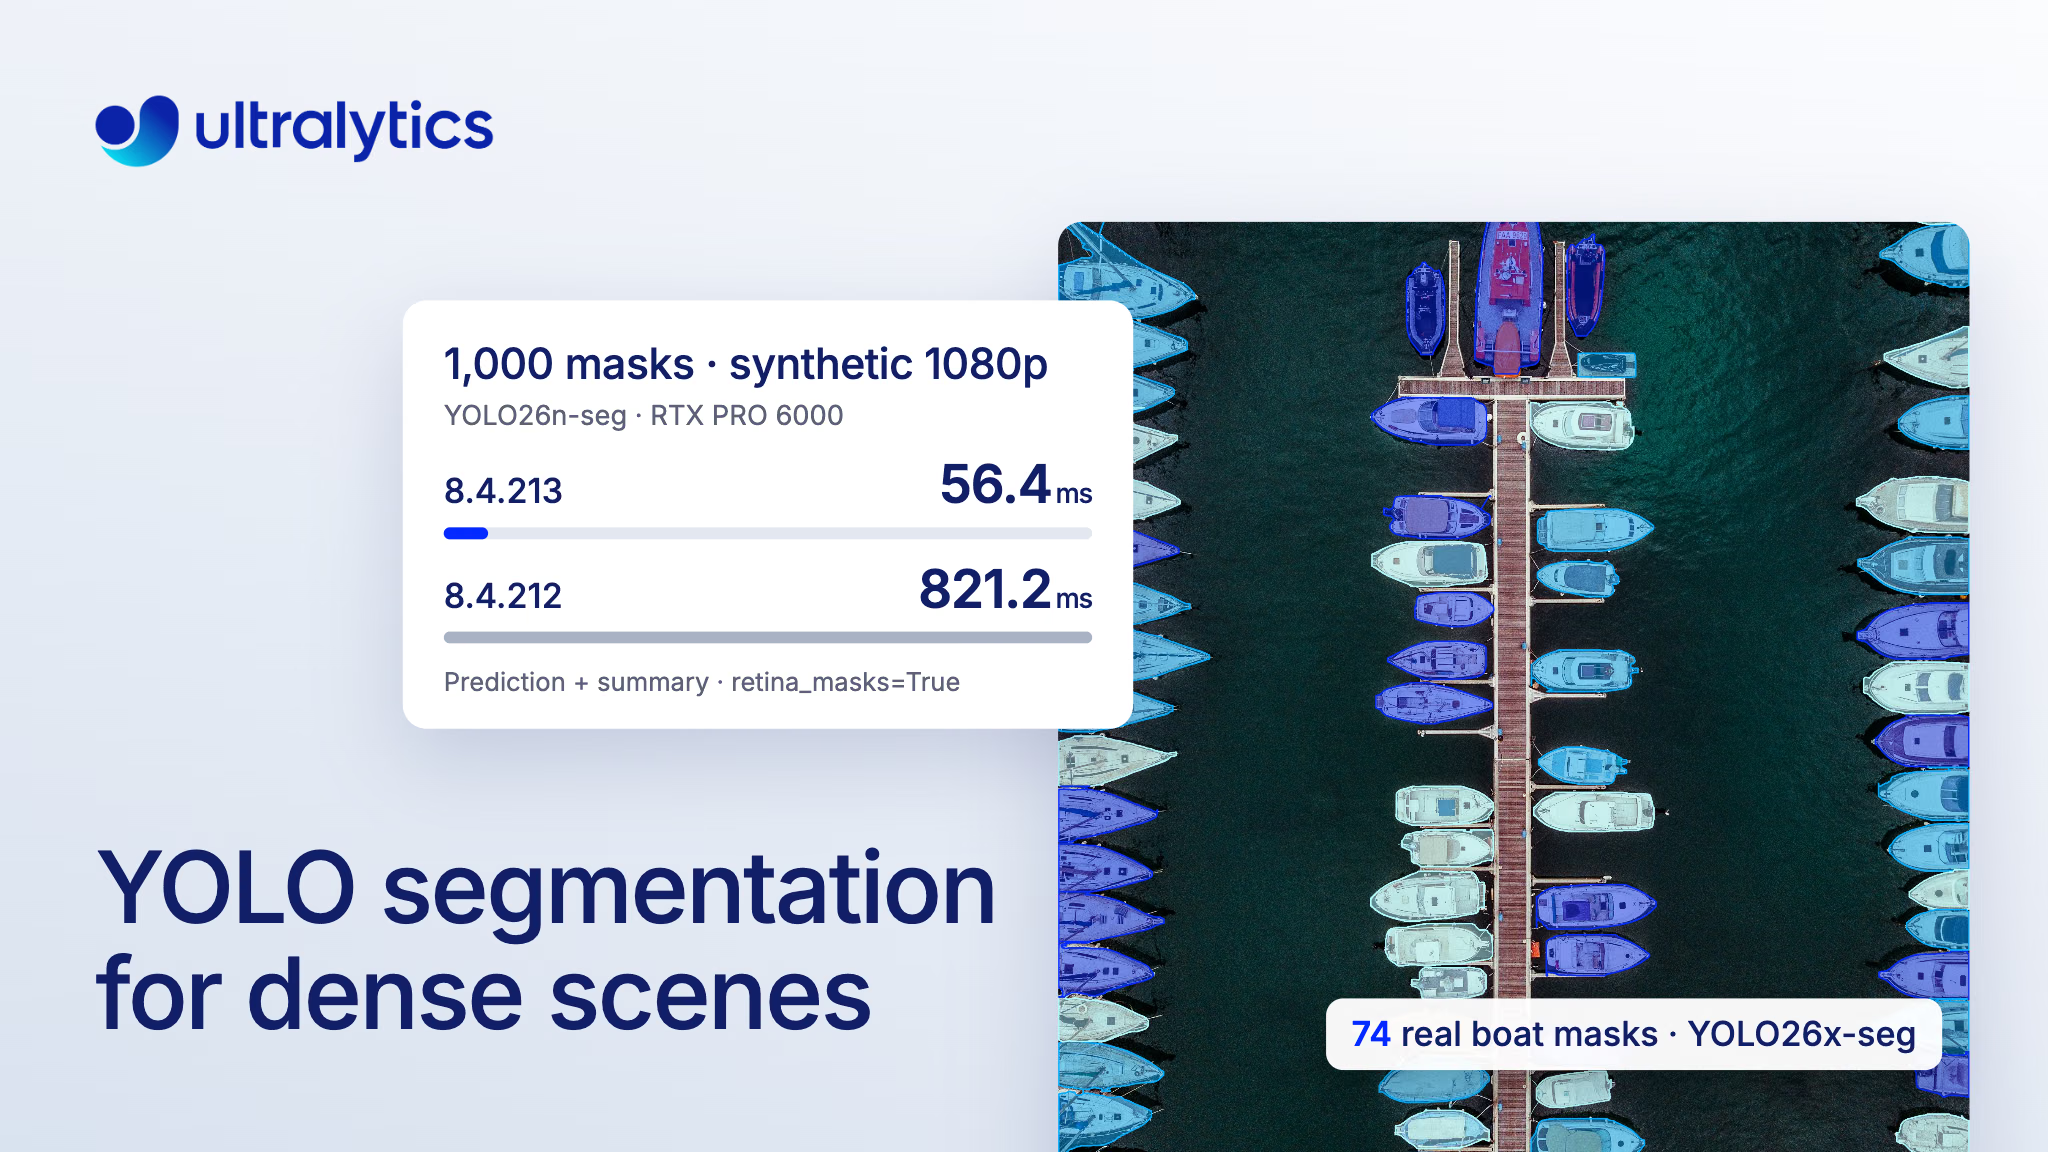
2026年11月14日にリリースされたUltralytics 8.4.213では、各検出ボックス内で大きなマスクスタックをデコードすることで、密集シーンにおけるYOLOセグメンテーションが高速化されました。棚、荷物、群衆、航空画像などをセグメンテーションする場合、セグメンテーションモデルが物体を検出しても、その後のマスク処理が時間またはメモリ不足になる状況に直面したことがあるでしょう。このリリースでは、その限界を大幅に引き上げています。合成した高密度タイル状の1080p画像を使ったベンチマークでは、YOLO26n-segが1,000個のフル解像度インスタンスマスク(retina_masks=True)を返し、予測と結果の要約を合わせた処理時間はRTX PRO 6000上で56.4 ms、ピークGPUメモリ使用量は321 MiBでした。8.4.212では、それぞれ821.2 ms、4,291 MiBでした。
モデル自体は変わっていません。変わったのは、YOLOセグメンテーションがモデルの出力をマスクに変換する方法です。大きなマスクスタックは、フレーム全体ではなく各オブジェクトのボックス内でデコードされるようになりました。Ultralytics Platformでは、PredictタブとAPIが画像ごとに最大1,000件の結果を返します。この記事では、密集したシーンで処理コストが高かった理由、8.4.213での変更点、測定結果、そして1,000個のマスク予測を実行する方法を紹介します。
これまでは、密集したシーンで各ボックスの外側のピクセルにも処理コストがかかっていました#
インスタンスセグメンテーションでは、各オブジェクトに専用のマスクを割り当てます。これは、面積の測定、オブジェクトの切り抜き、接触しているアイテムの識別に必要です。YOLOセグメンテーションモデルは、共有する少数のプロトタイプマスクと検出ごとのいくつかの係数を予測し、後処理でそれらを組み合わせてオブジェクトごとに1つのマスクを生成します。
これまでは、この処理で各マスクをフレームサイズで生成していました。デフォルトではモデルの推論サイズで、retina_masks=Trueやタイル処理を使う場合は元画像のサイズです。H x Wのフレーム上にN個のオブジェクトがある場合、各マスクはバウンディングボックスの外側ではすべてゼロであるにもかかわらず、N x H x Wのスタックを確保し、切り抜き、フィルタリングし、走査していました。密集した1080pシーンでは、重複を含めた1,000個のボックスの合計面積はフレーム面積の約2倍ですが、スタックのサイズはフレーム面積の1,000倍でした。処理コストは画像内のボックス数ではなく、max_detと画像サイズに応じて増加していました。
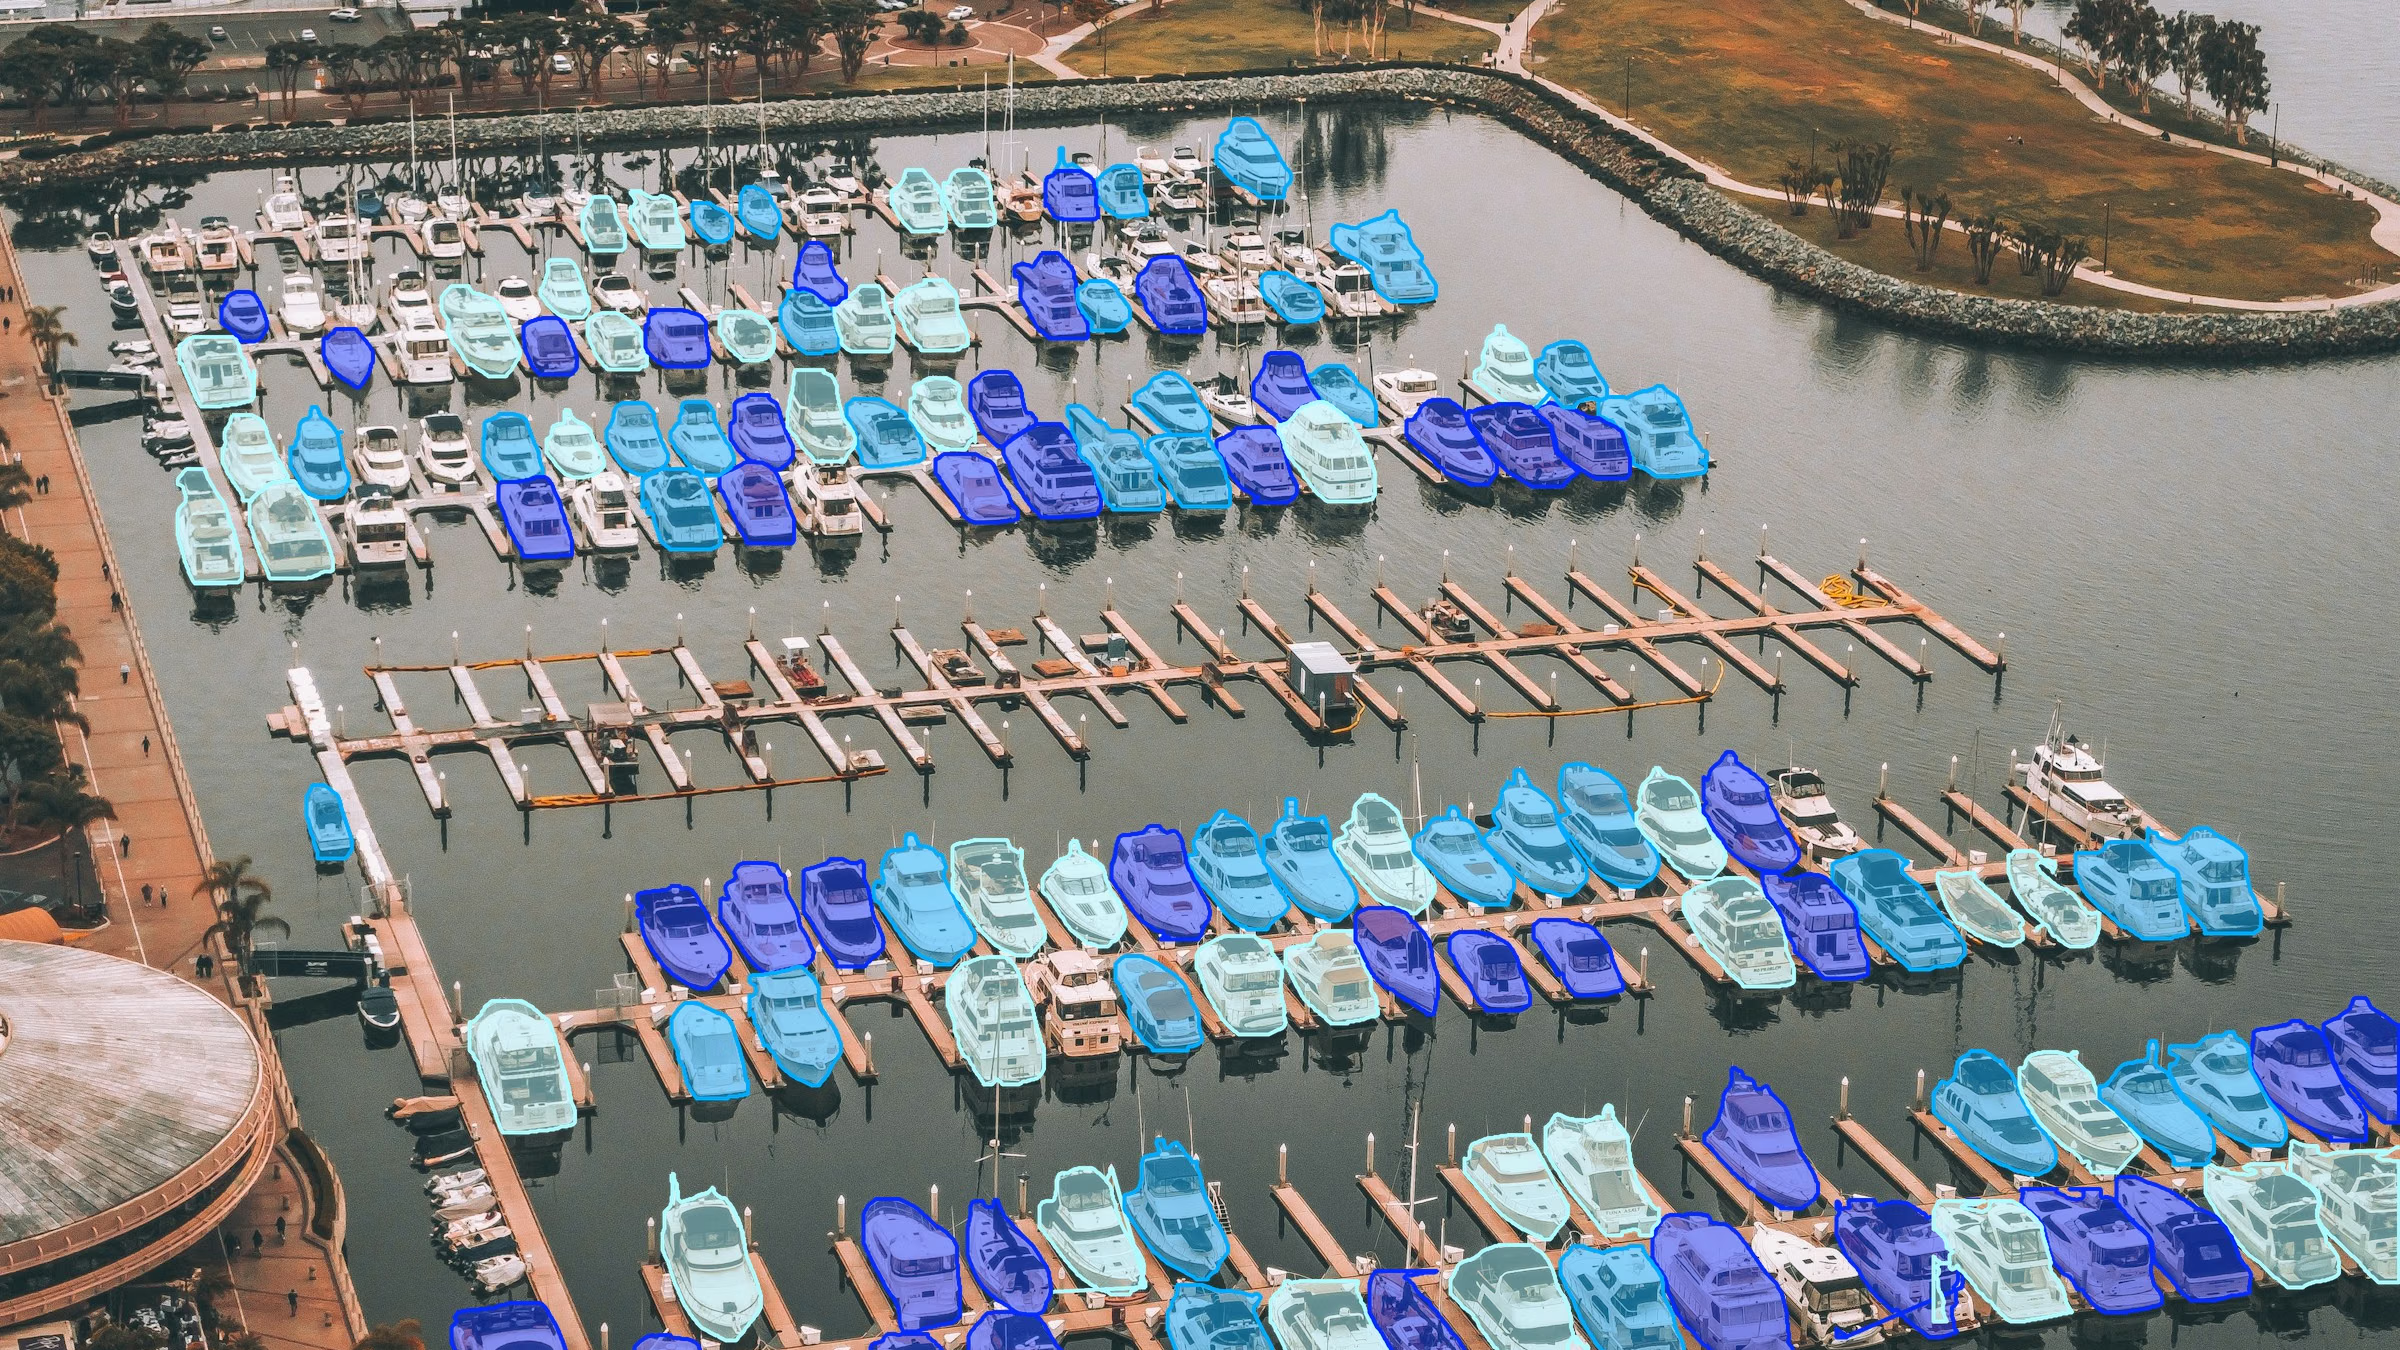
YOLO26x-segはこのマリーナの写真で127個のボートマスクを返しました。マスクは切り抜いて表示しています(imgsz=1920、conf=0.25、max_det=1000、retina_masks=True)。写真:Unsplash。
そのため、max_detをデフォルトの300より大きくすると、セグメンテーションでは実用的ではなく、大きな画像に多数のインスタンスがあるとメモリが枯渇することがありました。SKU-110Kのような商品が密集した小売棚、荷物の山、空撮フレームは、300個を超えるオブジェクトを扱いたい代表的なシーンです。
Ultralytics 8.4.213では大きなマスクスタックを各ボックス内でデコードします#
PR #27197で導入された新しい処理経路では、各ボックス内のピクセル位置に限ってプロトタイプのロジットを補間します。PyTorchの補間と同じ分離可能なバイリニアサンプリングを使い、サイズが近いボックスをまとめてバッチ処理します。大きなスタックでは、デコードの処理コストがボックスの合計面積に応じて決まるようになりました。
実運用では、次の3点が重要です。
- 固定されたマスクスタックサイズを超えると切り替わります。 セグメンテーション予測器は、密なスタックがCUDAで33,554,432ピクセル、CPUやその他のデバイスで4,194,304ピクセルを超える場合に、ボックス内に限定したマスクを使用します。それより小さいスタックでは従来の密な処理経路を使います。マスクが少数の場合は、従来の方法が同等か、より高速です。
- この処理経路では、輪郭をボックス内マスクから直接取得します。
masks.xyとmasks.xynはボックスごとにポリゴンをトレースするため、summary()、to_json()、save_txtは全体のスタックを生成しません。 - 出力形式は変わりません。
masks.dataは引き続き密なN x H x Wテンソルを返します。ボックス内に限定した処理経路では、最初に読み取るときにこのテンソルが生成されます。
密なテンソルを読み取る場合、確保するメモリは引き続き必要ですが、PRの測定ではその量が減りました。GPU上で、1080p、300個のマスク、retina_masks=Trueを使用した場合、masks.dataの読み取りは14.1 ms、1,366 MiBから9.1 ms、795 MiBになりました。
1080pでの1,000個のマスク処理は、GPU上で821.2 msから56.4 msになりました#
PRではYOLO26n-segを使い、model.predict(...)とresult.summary()(ボックスとポリゴン)を含む一連の処理をベンチマークしています。各行につき1プロセスでウォームアップ後に実行し、その中央値を報告しています。密集したシーンには、conf=0.01とimgsz=1280でタイル状にした合成画像を使用しています。標準のbus.jpgをデフォルト設定で使った一般的なシーンでは、マスク数は5個です。「Before」は8.4.212を指します。これらは予測と要約の後処理が大きな割合を占める測定値であり、一般的な推論速度を示すものではありません。
| シーン(GPU、RTX PRO 6000) | マスク数 | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
一般的なシーン(bus.jpg) | 5 | False | 4.3 ms、59 MiB | 4.4 ms、59 MiB |
| 1920 x 1080 | 300 | False | 118.5 ms、1,673 MiB | 16.3 ms、174 MiB |
| 1920 x 1080 | 300 | True | 248.7 ms、1,366 MiB | 18.0 ms、201 MiB |
| 1920 x 1080 | 1,000 | True | 821.2 ms、4,291 MiB | 56.4 ms、321 MiB |
| 4000 x 3000 | 300 | True | 1,352.1 ms、7,070 MiB | 26.5 ms、172 MiB |
| 4000 x 3000 | 1,000 | True | 4,323.1 ms、23,305 MiB | 130.7 ms、258 MiB |
処理時間とGPUメモリのピーク値。PyTorch 2.15.0、CUDA 13.2を使用。出典:PR #27197。
設計どおり、マスクが5個の一般的な画像では変化はありません。効果が現れるのは従来のスタックが大きくなるケースで、以前は最も処理コストが高かったフル解像度マスクで最大の効果が得られます。
大きな画像で必要なメモリが大幅に減少します#
4000 x 3000ピクセルの画像で1,000個のマスクを予測した場合、従来の処理経路ではGPUメモリのピーク使用量が23,305 MiBでした。新しい処理経路ではピーク使用量が258 MiBとなり、4,323.1 msではなく130.7 msで完了しました。この削減により、1,200万画素のドローン、衛星、検査用フレームを扱う際に、パイプラインの残りの処理により多くのGPUメモリを使えます。
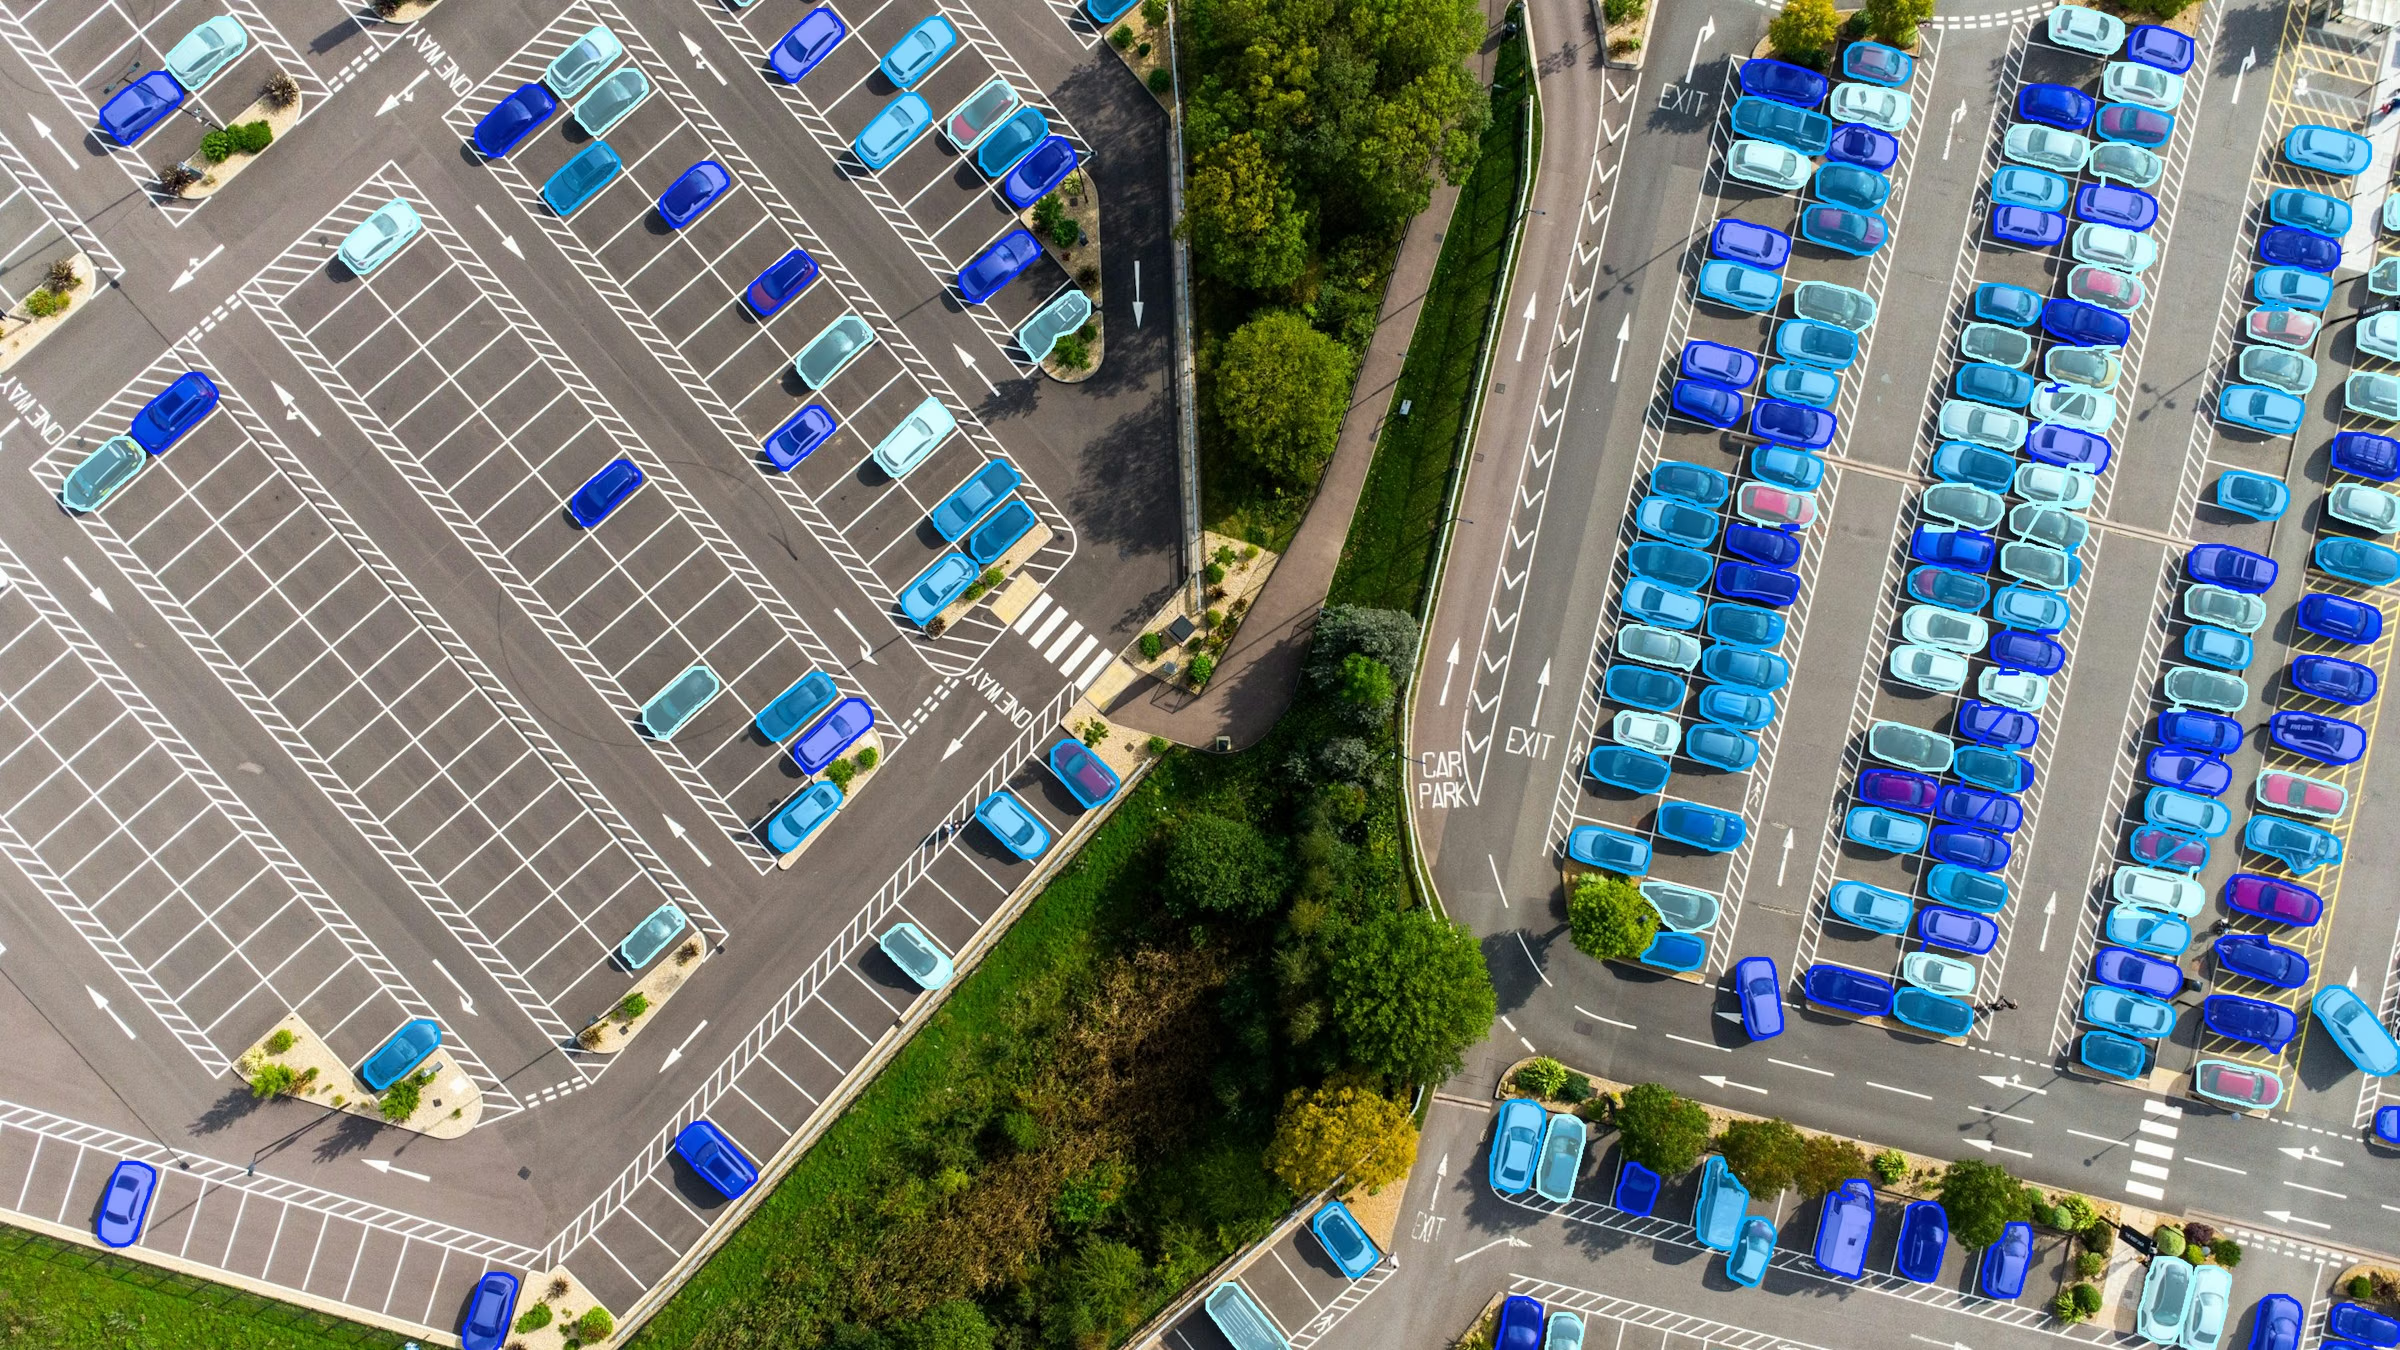
YOLO26x-segはこの空撮フレームで222個の車マスクを返しました(imgsz=1920、conf=0.15、max_det=1000、retina_masks=True)。写真:Unsplash。
CPUでの予測も大幅に高速化します#
8スレッドのLinux x86 CPUでは、マスクを生成する前のプロセスメモリは約840 MiBです。1080pでフル解像度のマスクを1,000個生成した場合、プロセスメモリのピークは5,217 MiBから1,072 MiBに減り、処理時間も以下のように短縮されました。
1920 x 1080でマスク300個および1,000個、4000 x 3000(12MP)でマスク300個。YOLO26n-segの予測と要約。変更前は8.4.212、変更後は8.4.213。出典:PR #27197。
8.4.212とマスクは一致しますが、1つのモードではエッジにわずかな差があります#
高速な処理経路が役立つのは、同じ結果が得られる場合に限られます。PRではYOLO26n-segとYOLO11n-segを使い、2枚の画像、6つのサイズ、confの0.25と0.01、両方のマスクモードで、ボックス内に限定した処理経路を強制的に有効にして、8.4.213と8.4.212の96件の予測を比較しました。
- デフォルトのマスク(
retina_masks=False):ボックス、マスク、ポリゴンは同一で、マスクピクセル760万個のうち異なるものは0個です。 - フル解像度マスク(
retina_masks=True):従来のコードで補間を1回行っていた場合は同一です。それ以外の画像形状では、マスクピクセルの0.07%(2,480万個中18,105個)に差があり、すべてマスクのエッジ部分でした。従来のコードではその箇所で補間を2回行っていましたが、新しいコードでは正確な座標でプロトタイプを1回だけサンプリングするためです。 - Apple MPS:密集した1080pシーンにある179個のマスクについて、どちらのマスクモードでもマスク、ボックス、ポリゴンは同一です。
Pythonで画像ごとに1,000個のオブジェクトをセグメンテーションする方法#
pip install -U ultralytics(8.4.213以降)にアップグレードし、max_detをデフォルトの300より大きく設定します。それ以外のコードはそのまま使えます。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # COCOのクラスです。棚や荷物には、独自にトレーニングしたモデルを読み込んでください
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # オブジェクトごとに1つの(P, 2)配列を返します。座標は元画像のピクセル単位です
rows = r.summary() # ボックスとポリゴンmax_detは上限であり、目標値ではありません。返されるオブジェクトの数は、モデル、画像、信頼度しきい値によって変わります。この変更を最大限に活用する方法は次のとおりです。
- 可能であれば輪郭を読み取ってください。大きなスタックを処理する経路では、
masks.xy(ピクセル単位)とmasks.xyn(正規化済み)はボックス内に限定したマスクから取得されます。to_json()とsave_txtも同様です。Resultsリファレンスにすべての属性が記載されています。 - ピクセルを直接計算する場合は
masks.dataを読み取ってください。面積や重なりの計算には密なテンソルが最も簡単です。masks.xyの輪郭から切り抜くこともできます。Ultralytics Academyのコードでマスクを使用する方法では各形式の使い分けを説明し、オブジェクト分離ガイドでは輪郭から切り抜きを作成します。 - 元画像の解像度でマスクが必要な場合は
retina_masks=Trueを使用してください。1080p、GPU、マスク300個のベンチマークでは、デフォルトのマスクが16.3 msなのに対し、現在は18.0 msです。非常に大きなフレーム内の小さなオブジェクトを扱う場合は、画像タイル処理による小物体検出の記事と高解像度タイル処理ガイドをご覧ください。タイル処理による予測では元画像サイズのマスクが返されるため、タイル処理を使う場合も元画像のサイズに比例したメモリが必要です。 - 密集したシーンでは
confとiouを調整してください。max_detを上げると、confをすでに通過した検出結果をより多く保持できます。confを下げると、信頼度の低い検出結果も含まれるようになります。予測設定ではconf、iou、max_detを説明しています。また、NMSのIoUしきい値に関するガイドでは、接触しているオブジェクトの扱い方を説明しています。
この変更はPythonの後処理に含まれるため、PyTorchモデルと、Ultralyticsのpredict APIを通じて実行するエクスポート済みモデルに適用されます。PRではYOLO26n-segとYOLO11n-segをテストしました。同じ後処理は、融合後のパラメーター数が270万のYOLO26n-segから6,280万のYOLO26x-segまで、すべてのYOLO26およびYOLO11セグメンテーションモデルで使用されます。独自の密集したデータでモデルをトレーニングするには、インスタンスセグメンテーション用のYOLO26カスタムトレーニングガイドをご覧ください。
Ultralytics Platformが画像ごとに最大1,000件の結果を返すようになりました#
同じ上限がUltralytics Platformにも適用されます。モデルのPredictタブは画像ごとに最大1,000件の結果を返し、その背後にあるREST APIも同様です。例外はRT-DETRモデルで、デコーダー内のクエリ数に合わせて上限は300件です。
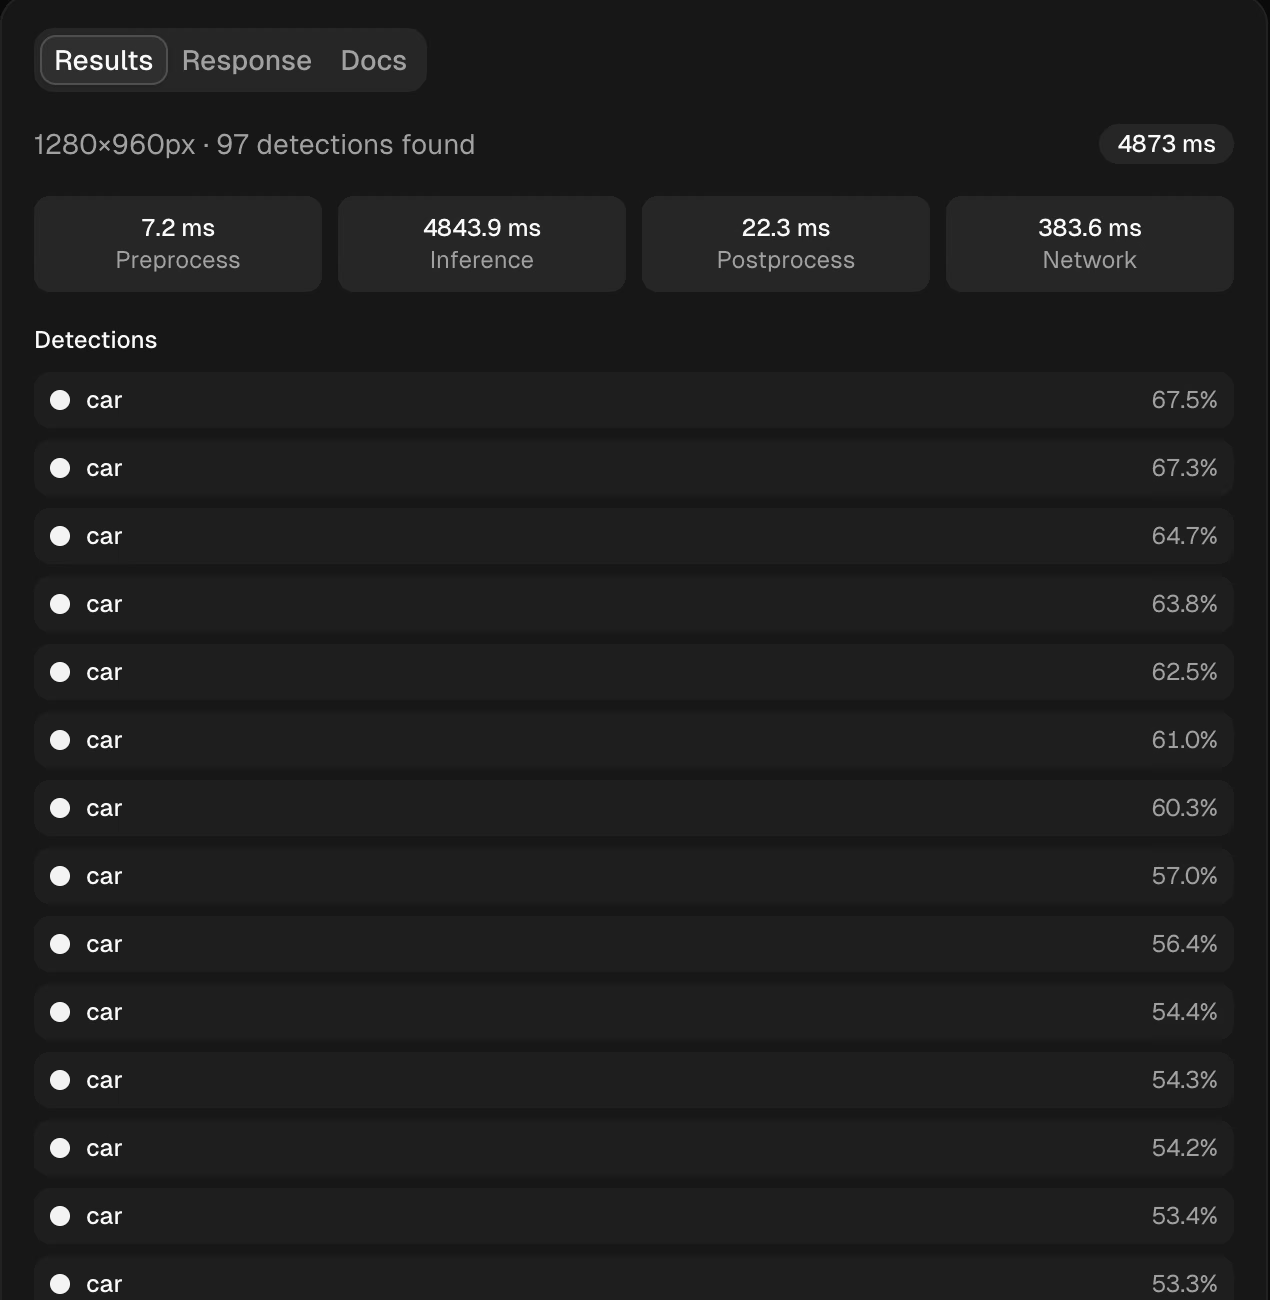
画像サイズ1280でYOLO26x-segを実行し、上の空撮写真から検出された車97件を表示するPredictタブ。Platformの推論ドキュメントでは、パネルの詳細を説明しています。
結果パネルは、長いリストを表示できるように設計されています。結果が10件を超える場合、画像上ではオブジェクトを隠さないようにラベルなしのボックスが表示され、リストには各結果の名前が表示され、拡大画像にはラベルが表示されます。行にカーソルを合わせると対応するオブジェクトが強調表示され、オブジェクトにカーソルを合わせると対応する行が分かります。
独自のデータで試すには、Package-Segの荷物セグメンテーションデータセットを使ってクラウドでトレーニングし、Predictタブまたは専用エンドポイントで結果を実行してください。
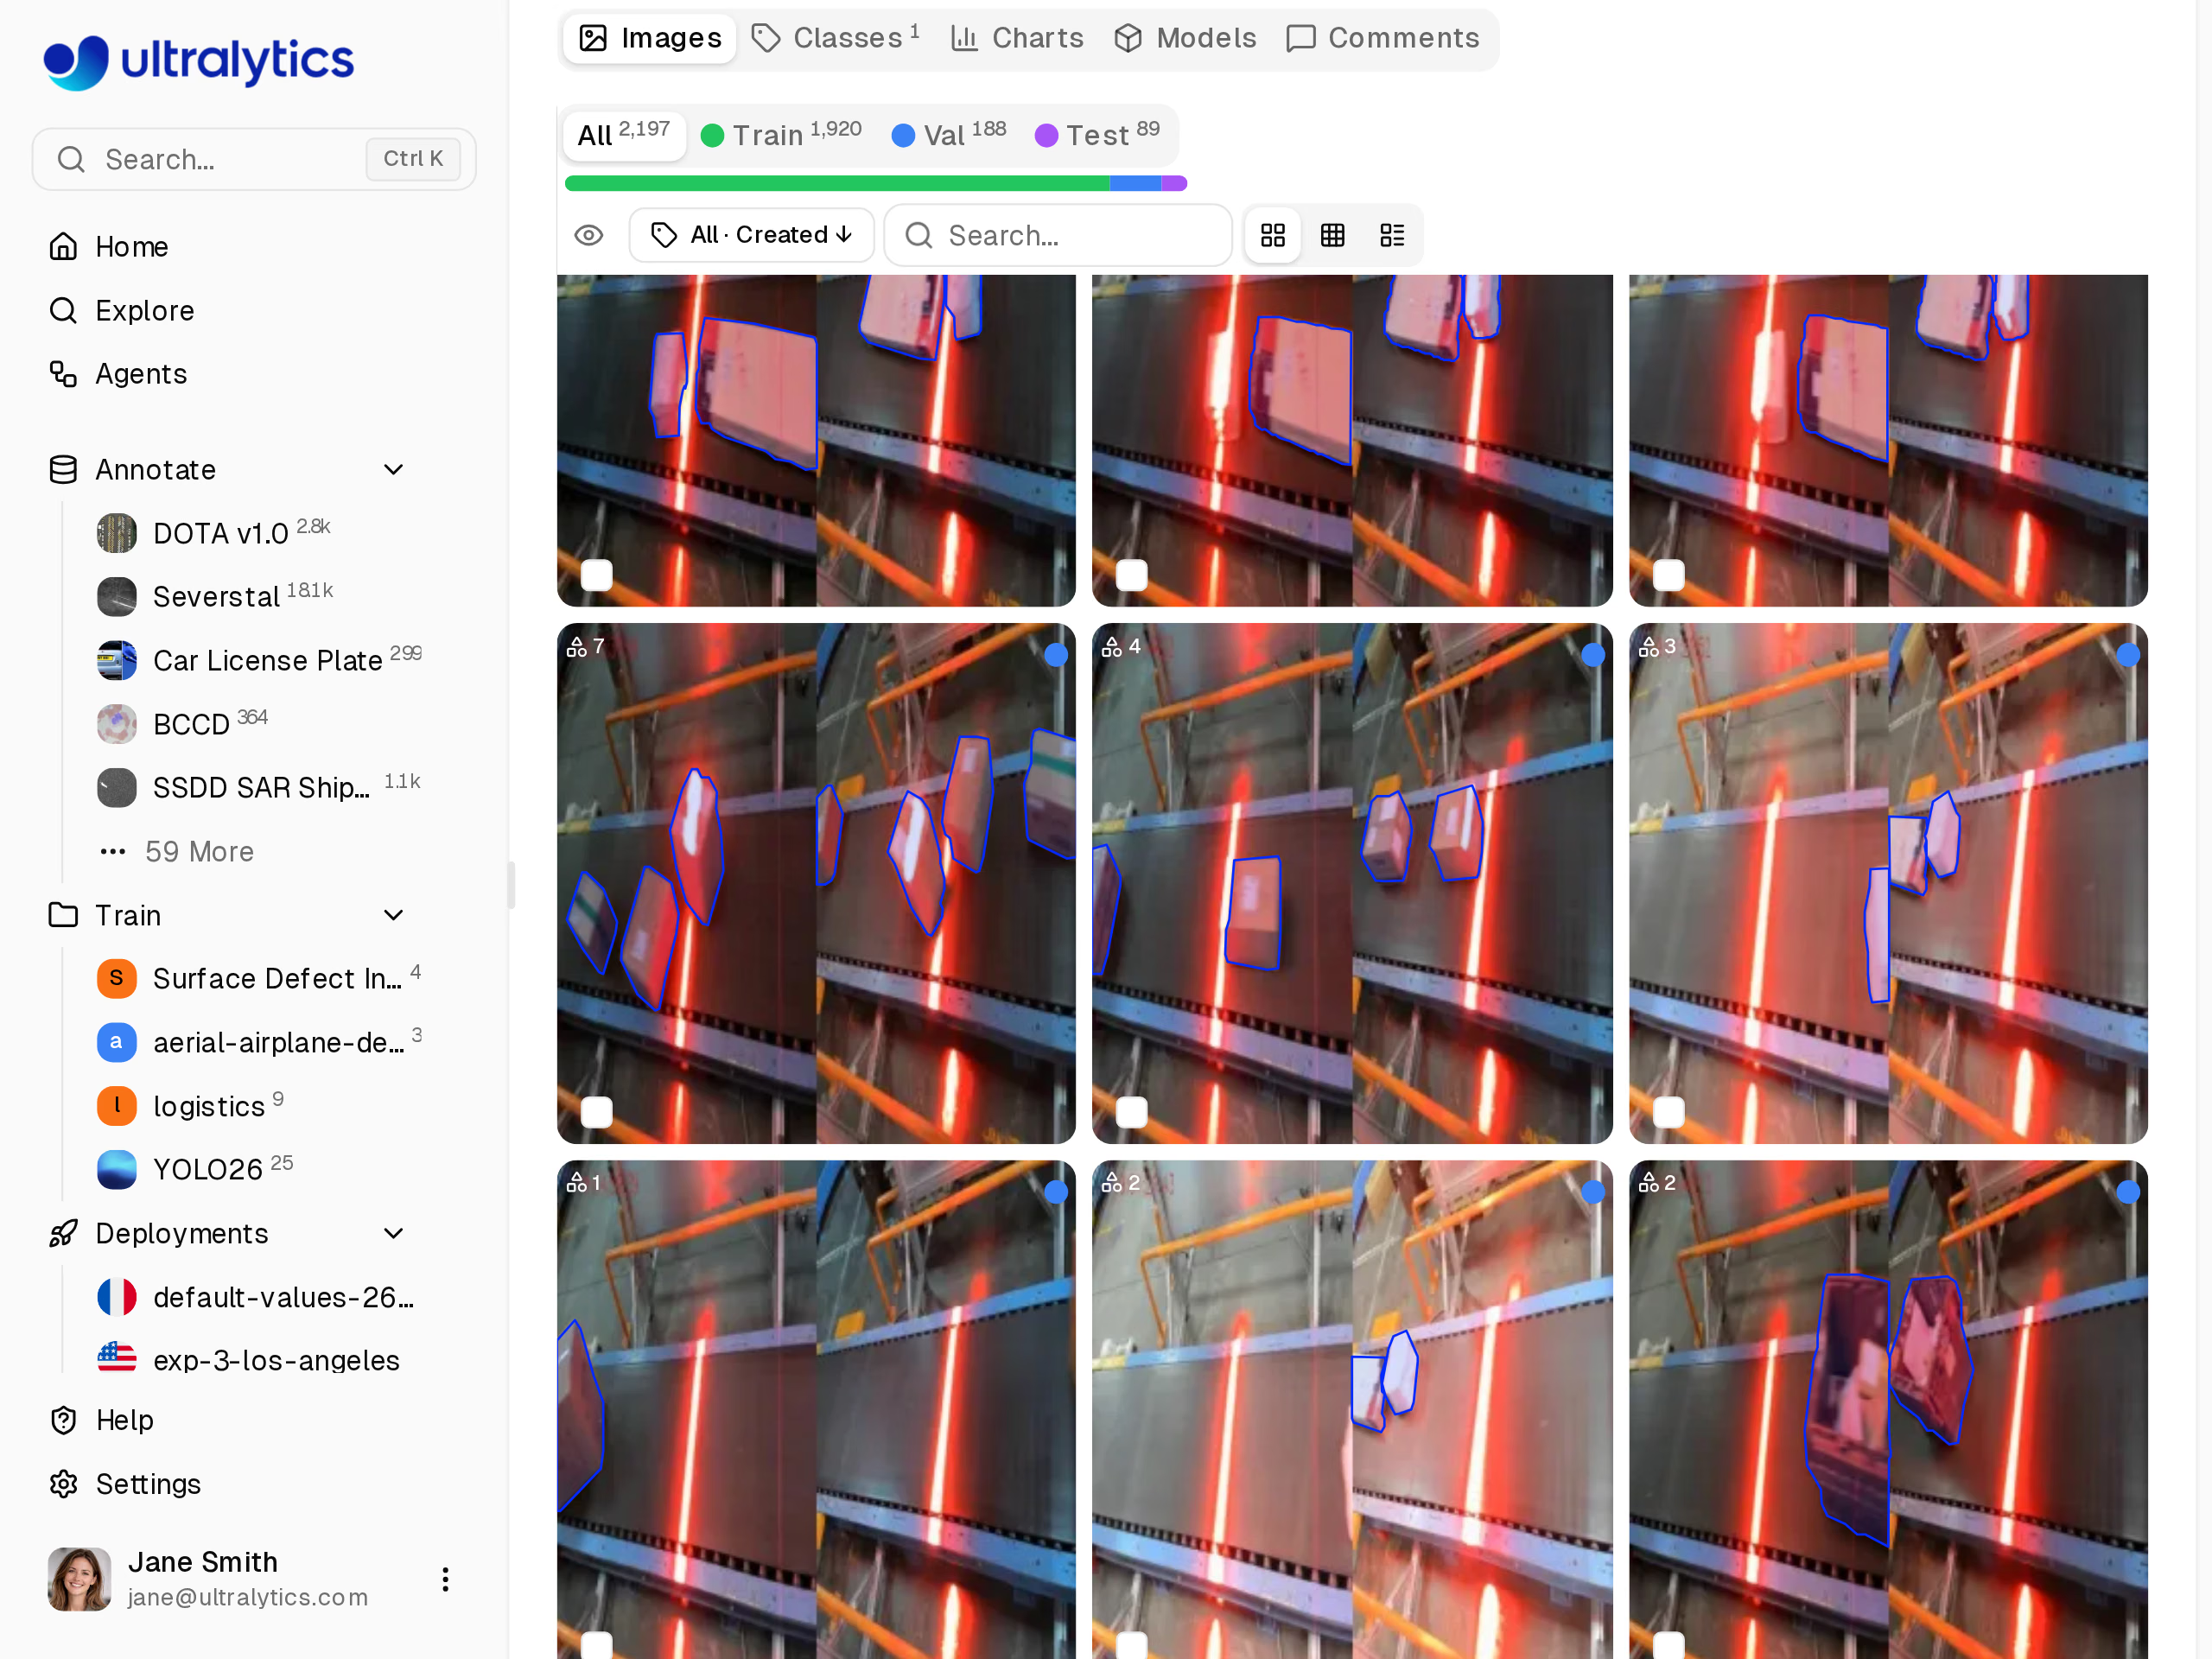
Ultralytics Platform上のPackage-Segデータセット。物流セグメンテーションをすぐに始められる出発点です。
アップグレードをおすすめするユーザー#
密集したシーンや大きな画像をセグメンテーションする場合は、今すぐアップグレードしてください。対象となるのは、小売棚、荷物の仕分け、空撮やドローン調査、細胞顕微鏡画像などです。また、メモリ制限を守るためにmax_detに上限を設定したり、画像サイズを小さくしたり、retina_masksを削除したりしている場合も対象です。こうした回避策を見直せます。
マスクスタックがしきい値以下の場合は、従来の密な処理経路が引き続き使われます。しきい値はオブジェクト数と画像サイズの積に基づくため、非常に大きな画像ではマスクが少数でも超えることがあります。パイプラインで常にmasks.dataを読み取る場合は、引き続き密なテンソルが生成されますが、PRの1080p、マスク300個のGPUテストでは、以前より処理時間とメモリ使用量が減りました。インスタンスマスクが必要かどうかを確認するには、セマンティックセグメンテーションとインスタンスセグメンテーションの違いをご覧ください。
よくある質問
YOLOセグメンテーションは、Ultralytics YOLOのインスタンスセグメンテーションタスクです。モデルはオブジェクトごとに、クラス、ボックス、信頼度スコア、ピクセルマスクを返します。YOLO26セグメンテーションモデルにはYOLO26n-segからYOLO26x-segまで5つのサイズがあり、COCOの80クラスで事前トレーニング済みです。独自のデータでファインチューニングしてすぐに利用できます。
max_detが上限を設定し、デフォルトは300です。返される数はモデル、画像、信頼度しきい値によっても変わります。8.4.213以降は、ベンチマークのようなワークロードで上限を1,000に設定できます。合成1080p画像では、YOLO26n-segがフル解像度のマスク1,000個を予測して要約するのに、RTX PRO 6000で56.4 ms、メモリのピーク使用量321 MiBでした。Ultralytics Platformは画像ごとに最大1,000件の結果を返します。以前のバージョンでは各マスクをフレームサイズで生成していたため、メモリ使用量はオブジェクト数とフレーム面積の積に応じて増加していました。合成画像を使った4000 x 3000のベンチマークでフル解像度マスクを1,000個生成した場合、GPUメモリのピーク使用量は23,305 MiBでした。バージョン8.4.213では大きなスタックを各ボックス内でデコードするため、同じ条件でピーク使用量は258 MiBでした。
ultralyticsの8.4.213以降にアップグレードしてください。大きなマスクスタックではボックス内に限定した処理経路が自動的に有効になるため、ほかにコードを変更する必要はありません。masks.dataは従来と同じ密な形式を維持するため、既存のコードはそのまま動作します。この処理経路でテンソルの生成を避けるには、masks.xyを読み取るか、summary()を呼び出してください。retina_masks=Trueは、モデルの推論サイズではなく元画像の解像度でマスクを返し、密なマスクを元画像に合わせます。合成1080p画像でマスク300個を生成した場合、この設定を有効にしたYOLO26n-segの予測と要約にかかった時間は、RTX PRO 6000で8.4.212では248.7 ms、8.4.213では18.0 msでした。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









