Data Curation
データキュレーションとは、機械学習と評価に信頼できるデータセットを継続的に整理、検証、文書化、維持するプロセスです。
データキュレーションとは、データを特定の目的に役立つ状態に保つために、データを選択、整理、確認、文書化、維持する継続的なプロセスです。機械学習では、モデルが学習するサンプルと、モデルを評価するための根拠を形作ります。キュレーションされたデータセットは、関連性の高いサンプル、教師ありタスク向けの一貫したラベル、コンテキスト情報、追跡可能なバージョンを組み合わせたものです。
キュレーション、クリーニング、前処理#
キュレーションはデータセットのライフサイクル全体にわたります。データクリーニングではエラーを修正し、使用できないレコードを削除します。データ前処理では、リサイズや正規化などの処理を通じて入力を変換します。データアノテーションはデータラベリングとも呼ばれ、教師あり学習で使用するターゲットを追加します。キュレーションでは、どのサンプルを含めるか、カテゴリをどのように定義するか、コレクションを時間の経過とともにどのように変更するかを決定しながら、これらの作業を調整します。一貫したカテゴリ定義とラベリングルールは、画像とターゲットの間の信頼性の高い関係をモデルが学習するのに役立ちます。
このため、キュレーションは、データを改善することでシステムを改善するデータ中心AIの実践的な構成要素となります。
データキュレーションの仕組み#
このプロセスは、予測タスク、対象カテゴリ、運用条件、包含基準を定めたデータセット仕様の作成から始まります。物体検出では、バウンディングボックスと部分的に見える物体に関するルールも含まれます。カテゴリの頻度や撮影条件を確認すると、過小評価されているクラスや環境などのデータセットバイアスが明らかになります。
品質チェックでは、自動検査と人によるレビューを組み合わせます。ファイルチェックでは読み取れない画像を検出し、アノテーションチェックでは無効な座標や一貫性のないクラスを特定します。ファイル全体のハッシュを使って同一のコピーを検出し、画像内容の数値表現である埋め込みを使って、見た目が類似したサンプルを特定します。レビューでは、修復可能なエラーと使用できないレコードを区別し、タスクを適切に表す有効で難易度の高いサンプルを保持します。
ファイルハッシュ監査では、一意なファイルごとに1つのパスを保持できます。この例では、ultralyticsパッケージに含まれる画像を確認します。このパッケージはpip install ultralyticsでインストールします。
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
このカウントは、完全一致の重複排除後に残ったファイル数を示します。カウントが等しい場合は、サンプリングしたすべてのファイルのハッシュが異なることを意味します。
データを分割することで、学習データ、検証データ、テストデータの独立性を保てます。近接する動画フレームには共通するシーン情報が含まれるため、異なる分割に振り分けるとデータリークが発生し、評価スコアが過大になります。録画セッション、カメラ、または撮影場所ごとにグループ化すると、評価結果が想定する汎化タスクを反映するようになります。固定されたデータセットバージョンでは、ラベルとともにこれらの割り当てが保持されます。
Ultralytics Platformは、カバレッジの不足、重複、外れ値を見つけるクラス分布チャートと画像クラスタリングにより、キュレーションをサポートします。データセット管理ツールを使うと、チームはこれらのグループを確認し、画像、ラベル、分割の割り当てを更新できます。
データキュレーターの役割#
データキュレーターは、データコレクションの意味と使いやすさを維持します。主な責任には、データソースの文書化、アノテーションガイドラインの調整、ラベリングに関する意見の相違の解決、変更の記録が含まれます。メタデータ、つまりサンプルを説明する情報には、取得日時、センサー、場所、アノテーションのステータスが記録されます。再利用可能なデータの維持には、説明と補足ドキュメントの保存も含まれます。
データプロビナンスには、サンプルの出所と変換方法が記録されます。データセットのバージョンを実験追跡に結び付けると、モデルの比較を再現可能にできます。デプロイ後は、アクティブラーニングによってレビューに有益なサンプルを優先し、データドリフトを監視します。データドリフトが検出されると、新たなデータ収集が必要になる場合があります。
コンピュータビジョンでの例#
自動車の知覚では、BDD100Kの元のコレクションに、米国内のさまざまな場所、天候条件、昼夜の状況を網羅した運転動画が10万本含まれています。環境属性を利用すると、撮影条件ごとの評価が可能になります。Platform版には、検出用のキーフレーム画像が99,996枚含まれています。
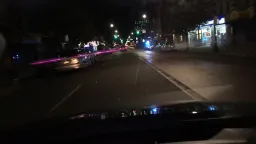 BDD100Kのプレビュー 1
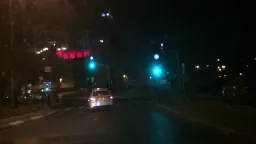 BDD100Kのプレビュー 2
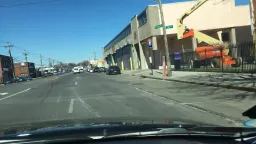 BDD100Kのプレビュー 3
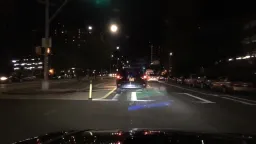 BDD100Kのプレビュー 4
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
画像分類では、ciFAIRによる修正により、CIFAR-10とCIFAR-100の元のテストセットに含まれていた類似画像が置き換えられました。学習画像または他のテスト画像との一致は、それぞれ元のテストセットの3.25%と10%に影響していました。学習データを変更せずに、ResNeXt-29 (8x64d)の分類エラー率は、CIFAR-10での3.56%からciFAIR-10での3.95%に上昇しました。









