밀집 장면에서의 Ultralytics YOLO 세그멘테이션: 마스크 1,000개
Ultralytics 8.4.213에서 YOLO26n-seg는 RTX PRO 6000으로 합성 1080p 이미지의 마스크 1,000개를 56.4ms에 예측하고 요약합니다. 이전 버전의 821.2ms에서 단축된 시간입니다.
 Glenn Jocher11 분 읽기
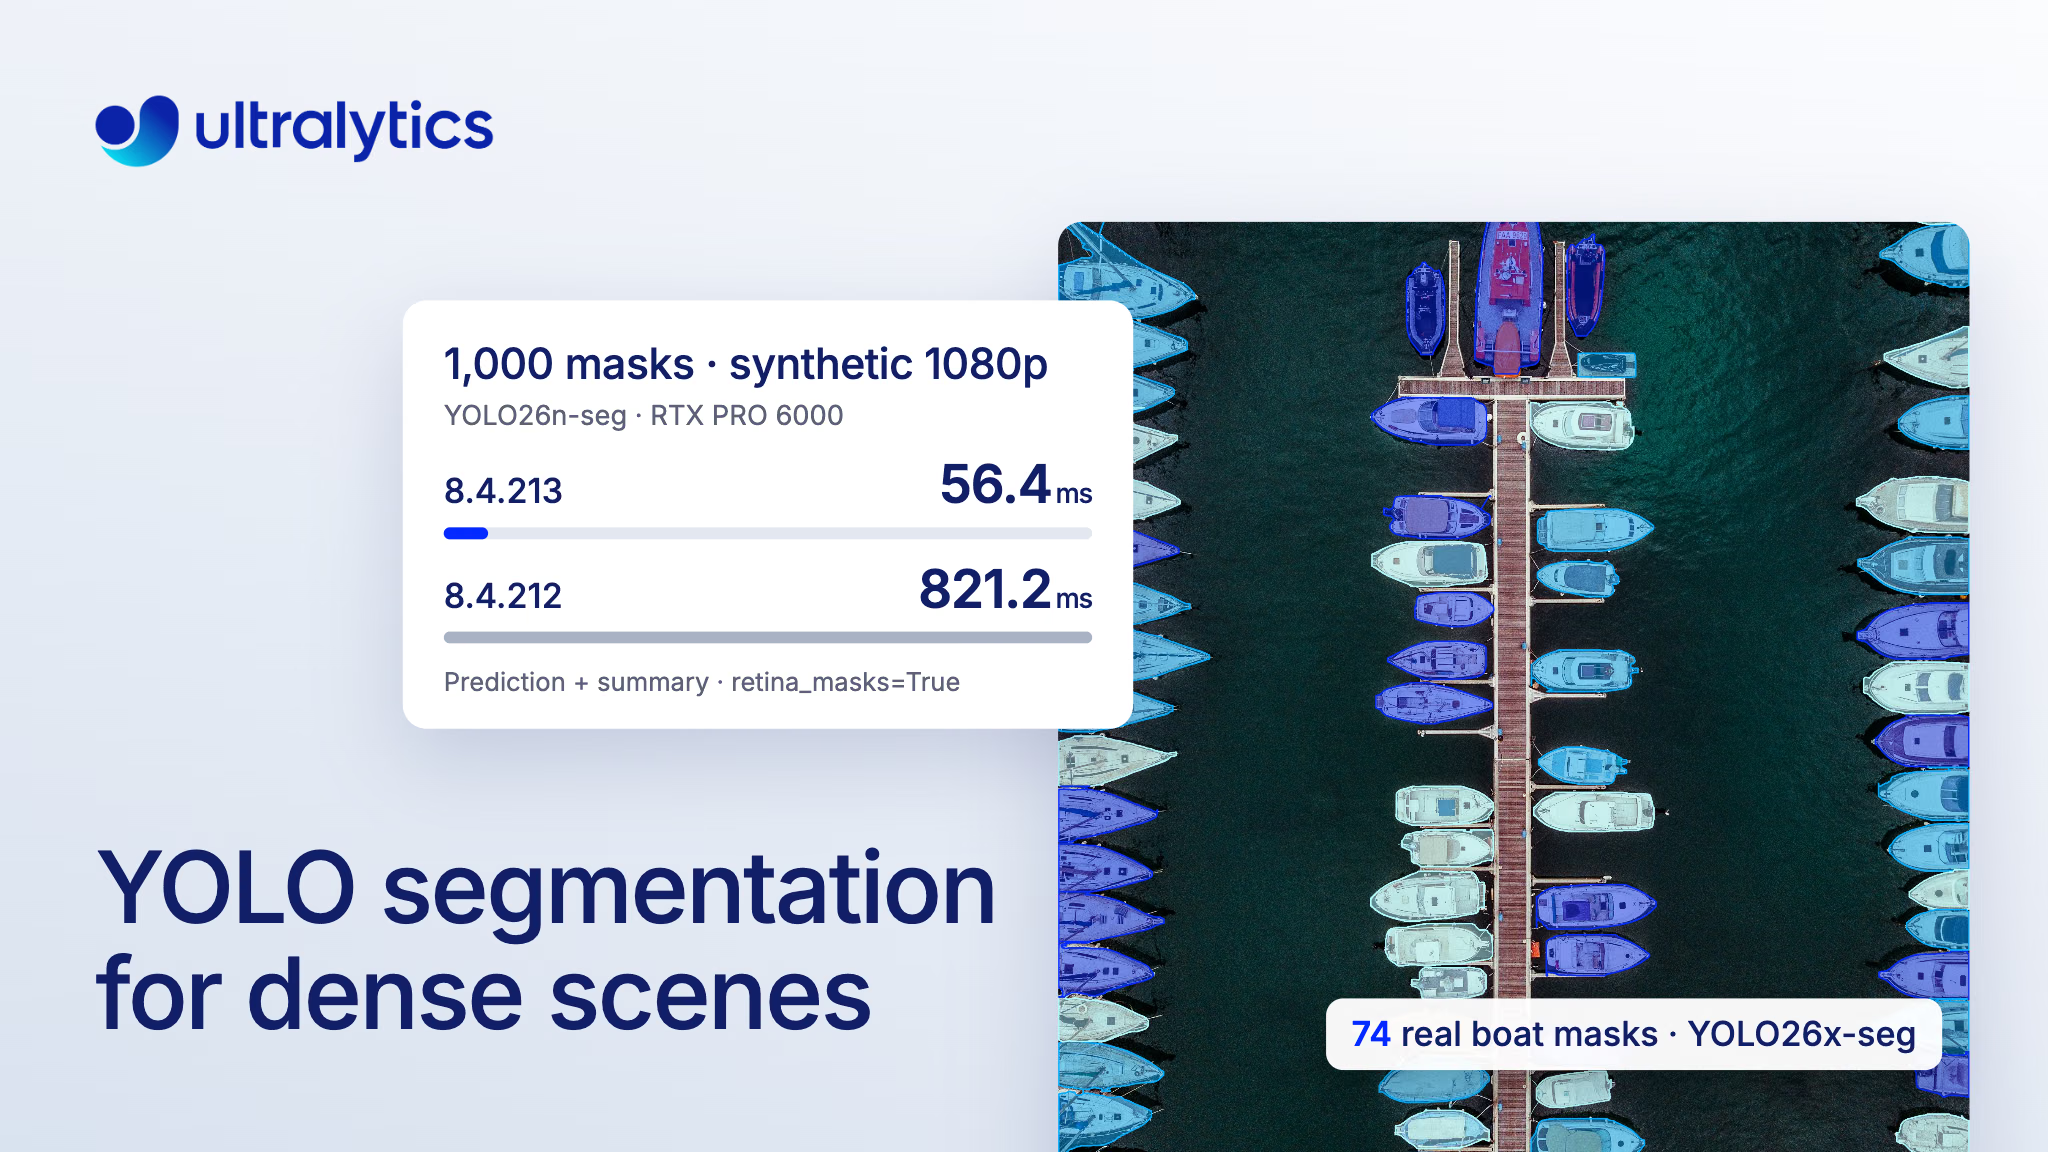
2026년 11월 14일 출시된 Ultralytics 8.4.213은 각 탐지 박스 내부에서 대규모 마스크 스택을 디코딩해 밀집 장면에서의 YOLO 세그멘테이션 속도를 높입니다. 선반, 소포, 군중 또는 항공 이미지를 세그멘테이션한다면 세그멘테이션 모델이 객체는 찾지만 후속 마스크 처리 단계에서 시간이나 메모리가 부족해지는 순간을 경험했을 수 있습니다. 이번 릴리스에서는 그 지점에 도달하기까지 훨씬 더 많은 여유가 생겼습니다. 합성된 고밀도 타일 1080p 이미지로 벤치마크한 결과, YOLO26n-seg는 RTX PRO 6000에서 전체 해상도 인스턴스 마스크 1,000개(retina_masks=True)를 반환하고 예측 및 결과 요약까지 완료하는 데 56.4ms가 걸렸으며, GPU 메모리 최대 사용량은 321MiB였습니다. 8.4.212의 821.2ms 및 4,291MiB에서 크게 개선된 수치입니다.
모델 자체는 변경되지 않았습니다. 변경된 점은 YOLO 세그멘테이션이 모델 출력을 마스크로 변환하는 방식입니다. 이제 큰 마스크 스택은 전체 프레임이 아니라 각 객체의 박스 내부에서 디코딩됩니다. Ultralytics Platform의 Predict 탭과 API는 이미지당 최대 1,000개의 결과를 반환합니다. 이 게시물에서는 밀집 장면의 처리 비용이 컸던 이유, 8.4.213의 변경 사항, 측정 결과, 그리고 직접 마스크 1,000개를 예측하는 방법을 다룹니다.
밀집 장면에서는 모든 박스 바깥의 픽셀까지 처리해야 했습니다#
인스턴스 세그멘테이션은 객체마다 개별 마스크를 제공하므로, 면적을 측정하거나 객체를 잘라내거나 서로 맞닿은 항목을 구분할 때 유용합니다. YOLO 세그멘테이션 모델은 소수의 공유 프로토타입 마스크와 탐지별 계수를 예측하고, 후처리 과정에서 이를 결합해 객체마다 하나의 마스크를 생성합니다.
지금까지는 각 마스크를 프레임 크기로 생성했습니다. 기본적으로 모델의 추론 크기를 사용하고, retina_masks=True 또는 타일링을 사용하면 원본 이미지 크기로 생성했습니다. H x W 프레임에서 객체가 N개라면, 각 마스크가 바운딩 박스 밖에서는 모두 0임에도 N x H x W 스택을 할당하고, 잘라내고, 필터링하고, 스캔했습니다. 밀집된 1080p 장면에서는 겹치는 부분을 포함한 박스 1,000개의 총 면적이 프레임 면적의 약 2배이지만, 스택의 면적은 프레임 면적의 1,000배였습니다. 처리 비용은 이미지에 있는 박스 수가 아니라 max_det와 이미지 크기에 따라 증가했습니다.
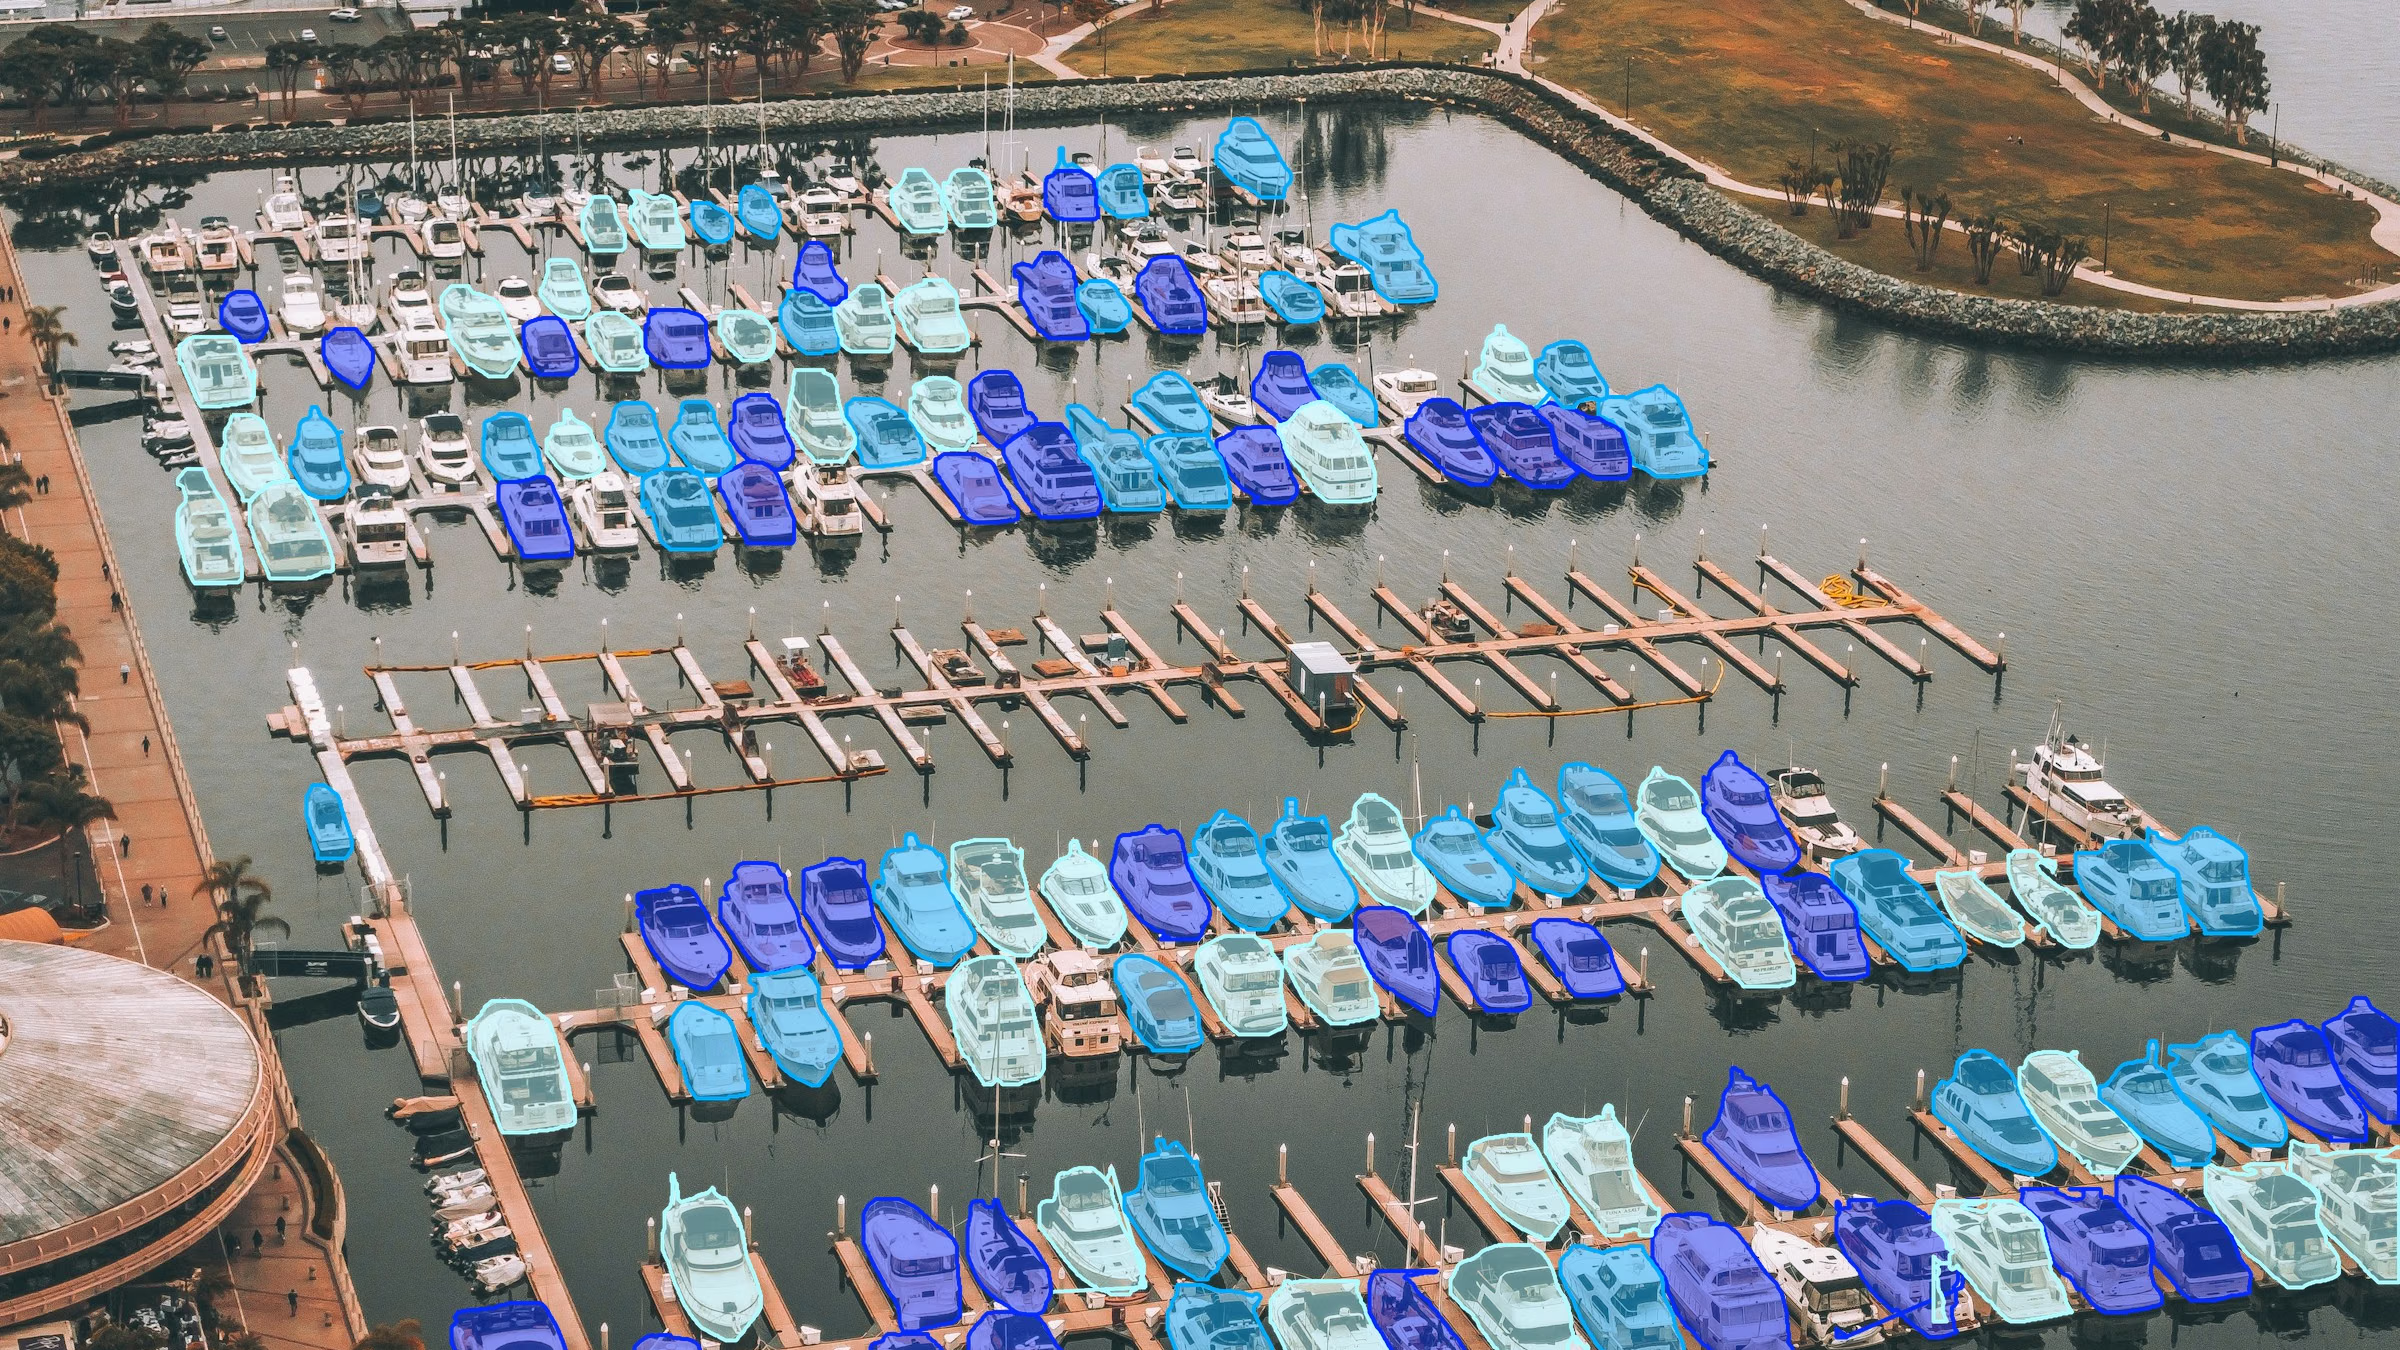
YOLO26x-seg는 이 마리나 사진에서 보트 마스크 127개를 반환했습니다. 잘라낸 결과입니다(imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). 사진: Unsplash.
이 때문에 세그멘테이션에서 max_det을 기본값 300보다 높이는 것은 실용적이지 않았고, 인스턴스가 많은 큰 이미지에서는 메모리가 고갈될 수 있었습니다. SKU-110K와 같은 밀집된 소매 매대, 소포 더미, 항공 프레임은 객체 300개를 초과해도 처리할 수 있는 여유가 필요한 대표적인 장면입니다.
Ultralytics 8.4.213은 큰 마스크 스택을 각 박스 내부에서 디코딩합니다#
PR #27197에서 도입된 새 처리 경로는 각 박스의 픽셀에서만 프로토타입 로짓을 보간합니다. PyTorch의 보간과 동일한 샘플링 방식인 분리형 쌍선형 샘플링을 사용하며, 크기가 비슷한 박스들을 묶어 처리합니다. 큰 스택의 경우 이제 디코딩 비용은 박스 면적의 총합에 따라 증가합니다.
실제로 중요한 세 가지 사항은 다음과 같습니다.
- 마스크 스택 크기가 고정 임계값을 넘으면 전환됩니다. 세그멘테이션 예측기는 밀집 스택이 CUDA에서 33,554,432픽셀, CPU 및 기타 장치에서 4,194,304픽셀을 초과할 때 박스 단위 마스크를 사용합니다. 스택이 더 작으면 기존의 밀집 처리 경로를 유지하며, 마스크가 몇 개뿐인 경우 이 경로가 더 빠르거나 속도가 같습니다.
- 해당 경로에서는 윤곽선을 박스 단위 마스크에서 바로 생성합니다.
masks.xy과masks.xyn은 박스마다 폴리곤을 추적하므로summary(),to_json(),save_txt는 전체 스택을 생성하지 않습니다. - 출력 형식은 변경되지 않았습니다.
masks.data은 여전히 밀집된 N x H x W 텐서를 반환합니다. 박스 단위 경로에서는 이 텐서를 처음 읽을 때 생성합니다.
밀집 텐서를 읽을 때는 여전히 메모리 할당 비용이 발생하지만, PR에서 측정한 비용은 감소했습니다. GPU에서 masks.data을 사용해 1080p 마스크 300개를 읽는 데 걸리는 시간과 메모리가 retina_masks=True 적용 시 14.1ms와 1,366MiB에서 9.1ms와 795MiB로 줄었습니다.
1080p 마스크 1,000개 처리 시간은 GPU에서 821.2ms에서 56.4ms로 감소했습니다#
PR에서는 YOLO26n-seg로 전체 model.predict(...)과 result.summary()(박스와 폴리곤)을 실행하는 벤치마크를 수행하고, 각 행에 프로세스 하나를 사용해 예열된 실행의 중앙값을 보고합니다. 밀집 장면은 conf=0.01와 imgsz=1280에서 타일링한 합성 이미지이며, 일반적인 장면은 기본 설정에서 마스크 5개를 생성하는 표준 bus.jpg입니다. 이전 버전은 8.4.212입니다. 이 측정은 예측과 요약 과정에서 후처리 비중이 높은 경우를 대상으로 하며, 일반적인 추론 속도를 나타내는 수치는 아닙니다.
| 장면(GPU, RTX PRO 6000) | 마스크 | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
일반적인 장면(bus.jpg) | 5 | 아니요 | 4.3ms, 59MiB | 4.4ms, 59MiB |
| 1920 x 1080 | 300 | 아니요 | 118.5ms, 1,673MiB | 16.3ms, 174MiB |
| 1920 x 1080 | 300 | 예 | 248.7ms, 1,366MiB | 18.0ms, 201MiB |
| 1920 x 1080 | 1,000 | 예 | 821.2ms, 4,291MiB | 56.4ms, 321MiB |
| 4000 x 3000 | 300 | 예 | 1,352.1ms, 7,070MiB | 26.5ms, 172MiB |
| 4000 x 3000 | 1,000 | 예 | 4,323.1ms, 23,305MiB | 130.7ms, 258MiB |
시간 및 최대 GPU 메모리. CUDA 13.2를 사용하는 PyTorch 2.15.0. 출처: PR #27197.
설계 의도대로 일반적인 마스크 5개 이미지의 결과는 변하지 않았습니다. 기존 스택이 커지는 경우에 성능 향상이 나타나며, 이전에 처리 비용이 가장 컸던 전체 해상도 마스크에서 개선 폭이 가장 큽니다.
대형 이미지의 메모리 사용량이 크게 줄어듭니다#
예측 마스크 1,000개가 있는 4000 x 3000픽셀 이미지에서 기존 경로는 GPU 메모리 최대 23,305MiB를 사용했습니다. 새 경로는 최대 258MiB를 사용하고 4,323.1ms 대신 130.7ms 만에 완료됐습니다. 메모리 사용량 감소로 1,200만 화소 드론, 위성 및 검사 프레임을 처리할 때 파이프라인의 나머지 단계에 더 많은 GPU 메모리를 할당할 수 있습니다.
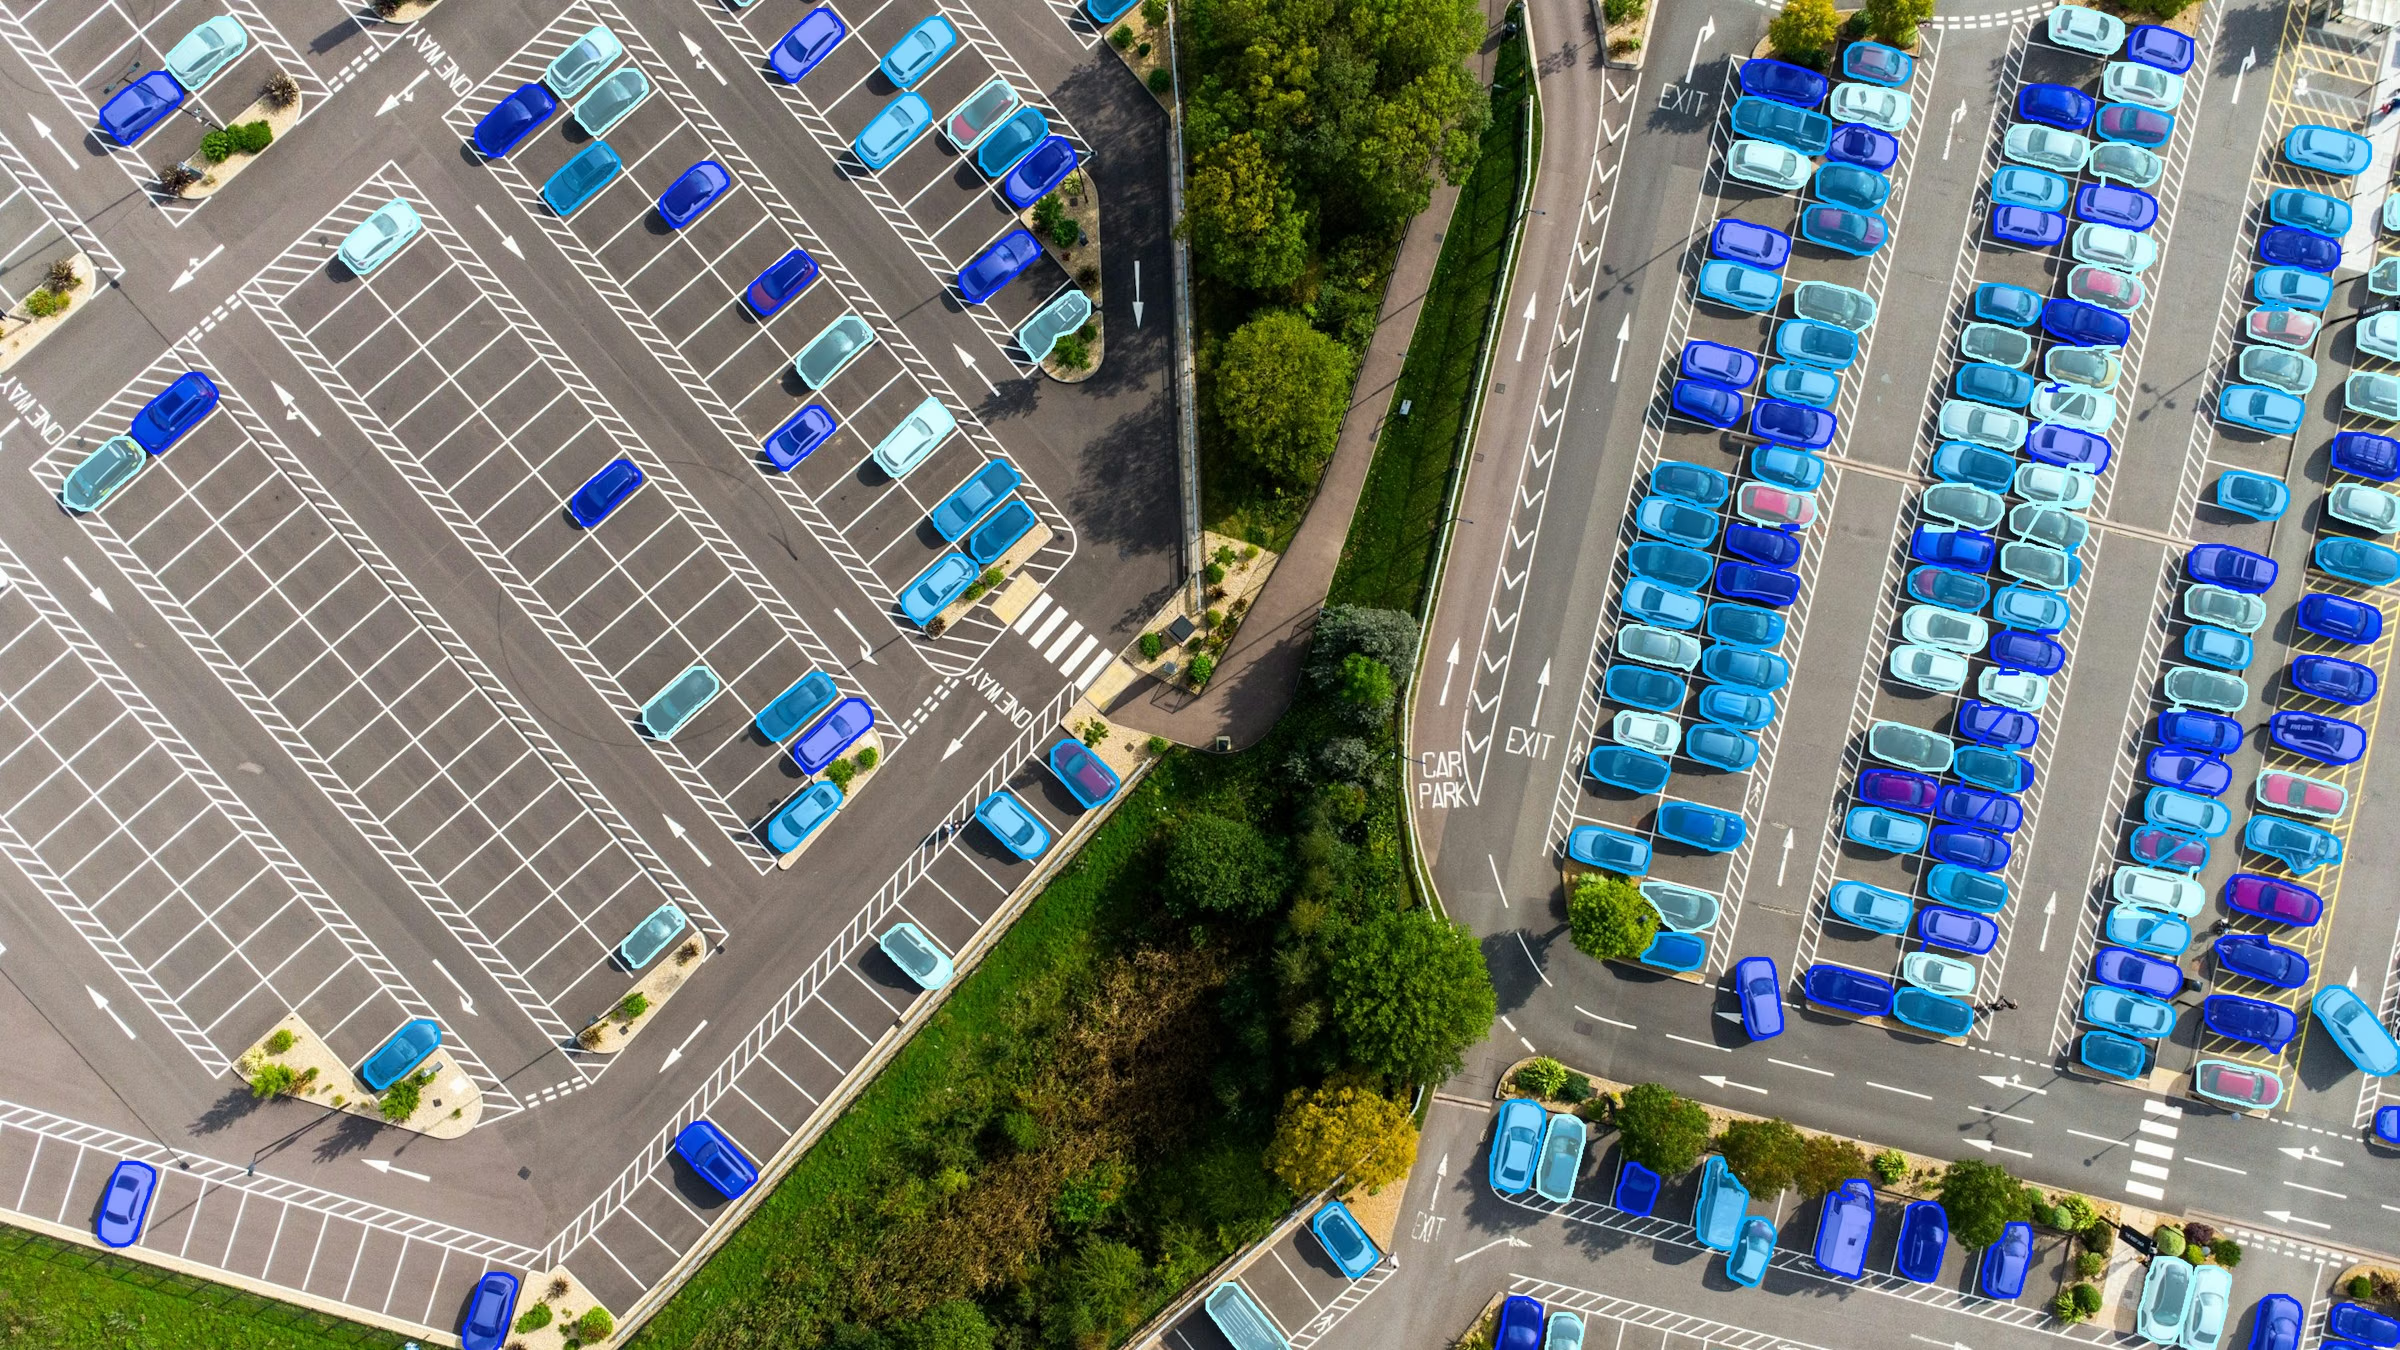
YOLO26x-seg는 이 항공 프레임에서 차량 마스크 222개를 반환했습니다(imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). 사진: Unsplash.
CPU 예측도 훨씬 빨라집니다#
스레드 8개를 사용하는 Linux x86 CPU에서는 마스크를 생성하기 전 프로세스 메모리가 약 840MiB입니다. 1080p 이미지에서 전체 해상도 마스크 1,000개를 처리할 때 프로세스 메모리 최대 사용량은 5,217MiB에서 1,072MiB로 줄었고, 처리 시간도 아래와 같이 단축됐습니다.
1920 x 1080에서 마스크 300개와 1,000개, 4000 x 3000(12MP)에서 마스크 300개를 측정했습니다. YOLO26n-seg의 예측과 요약 결과이며, 이전은 8.4.212, 이후는 8.4.213입니다. 출처: PR #27197.
마스크 결과는 8.4.212와 일치하며, 한 모드에서 가장자리만 미세하게 다릅니다#
더 빠른 경로도 같은 결과를 반환해야 유용합니다. PR에서는 YOLO26n-seg와 YOLO11n-seg를 사용해 이미지 2개와 크기 6개, conf 값 0.25와 0.01, 두 가지 마스크 모드를 조합한 예측 96개에서 8.4.213과 8.4.212를 비교했으며, 박스 단위 경로를 강제로 활성화했습니다.
- 기본 마스크(
retina_masks=False): 박스, 마스크, 폴리곤이 동일하며, 마스크 픽셀 760만 개 중 차이가 있는 픽셀은 0개입니다. - 전체 해상도 마스크(
retina_masks=True): 기존 코드에서 한 번 보간한 경우 결과가 동일합니다. 다른 이미지 형태에서는 마스크 픽셀의 0.07%(2,480만 개 중 18,105개)가 다르며, 모두 마스크 가장자리에서 발생합니다. 기존 코드는 해당 경우에 두 번 보간했지만 새 코드는 정확한 좌표에서 프로토타입을 한 번 샘플링하기 때문입니다. - Apple MPS: 마스크 모드 두 가지 모두에서 마스크, 박스, 폴리곤이 마스크 179개가 있는 밀집된 1080p 장면에서 동일합니다.
Python에서 이미지당 객체 1,000개를 세그멘테이션하는 방법#
pip install -U ultralytics(8.4.213 이상)으로 업그레이드한 다음 max_det을 기본값 300보다 높이세요. 나머지 코드는 그대로 사용할 수 있습니다.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # COCO 클래스입니다. 매대나 소포에 사용할 경우 직접 학습한 모델을 불러오세요
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # 객체마다 하나씩 반환되는 (P, 2) 배열이며, 좌표는 원본 이미지 픽셀 기준입니다
rows = r.summary() # 박스와 폴리곤max_det은 목표값이 아니라 상한값입니다. 반환되는 객체 수는 모델, 이미지, 신뢰도 임계값에 따라 달라집니다. 이번 변경을 최대한 활용하려면 다음을 참고하세요.
- 가능하면 윤곽선을 읽으세요. 큰 스택 경로에서
masks.xy(픽셀)과masks.xyn(정규화)은 박스 단위 마스크에서 생성되며,to_json()와save_txt도 마찬가지입니다. Results 참조 문서에서 모든 속성을 확인할 수 있습니다. - 픽셀 단위 연산을 직접 수행하려면
masks.data을 읽으세요. 면적과 중첩은 밀집 텐서에서 가장 간단하게 계산할 수 있으며, 잘라낸 이미지는masks.xy윤곽선에서도 얻을 수 있습니다. 코드에서 마스크 사용하기에 관한 Academy 강의에서는 각 뷰의 사용 시점을 설명하고, 객체 분리 가이드에서는 윤곽선으로 잘라낸 이미지를 생성합니다. - 원본 해상도 마스크가 필요하면
retina_masks=True을 사용하세요. GPU에서 마스크 300개를 처리한 1080p 벤치마크의 경우, 이제 기본 마스크의 16.3ms에 비해 18.0ms가 소요됩니다. 매우 큰 프레임에서 작은 객체를 처리하려면 이미지 타일링을 사용한 소형 객체 탐지 게시물과 고해상도 타일링 가이드를 참고하세요. 타일링 예측은 원본 크기 마스크를 반환하므로, 타일링을 사용해도 원본 이미지 크기에 비례하는 메모리가 필요합니다. - 밀집 장면에 맞게
conf과iou을 조정하세요.max_det를 높이면 이미conf을 통과한 탐지 결과를 더 많이 유지하고,conf를 낮추면 신뢰도가 더 낮은 결과도 포함합니다. 예측 설정에서는conf,iou,max_det을 다루며, NMS IoU 임계값 가이드에서는 맞닿은 객체를 처리하는 방법을 설명합니다.
이 변경은 Python 후처리 단계에 적용되므로 PyTorch 모델과 Ultralytics predict API를 통해 실행하는 내보낸 모델 모두에 적용됩니다. PR에서는 YOLO26n-seg와 YOLO11n-seg를 테스트했으며, YOLO26n-seg의 융합 파라미터 2.7M부터 YOLO26x-seg의 62.8M까지 모든 YOLO26 및 YOLO11 세그멘테이션 모델에 동일한 후처리가 적용됩니다. 자체 밀집 데이터로 모델을 학습하려면 인스턴스 세그멘테이션을 위한 YOLO26 사용자 지정 학습 가이드를 따르세요.
Ultralytics Platform에서 이미지당 최대 1,000개의 결과를 반환합니다#
이제 Ultralytics Platform에도 동일한 상한값이 적용됩니다. 모델의 Predict 탭은 이미지당 최대 1,000개의 결과를 반환하며, 그 뒤에서 동작하는 REST API도 마찬가지입니다. 예외적으로 RT-DETR 모델은 디코더의 쿼리 수인 300개로 제한됩니다.
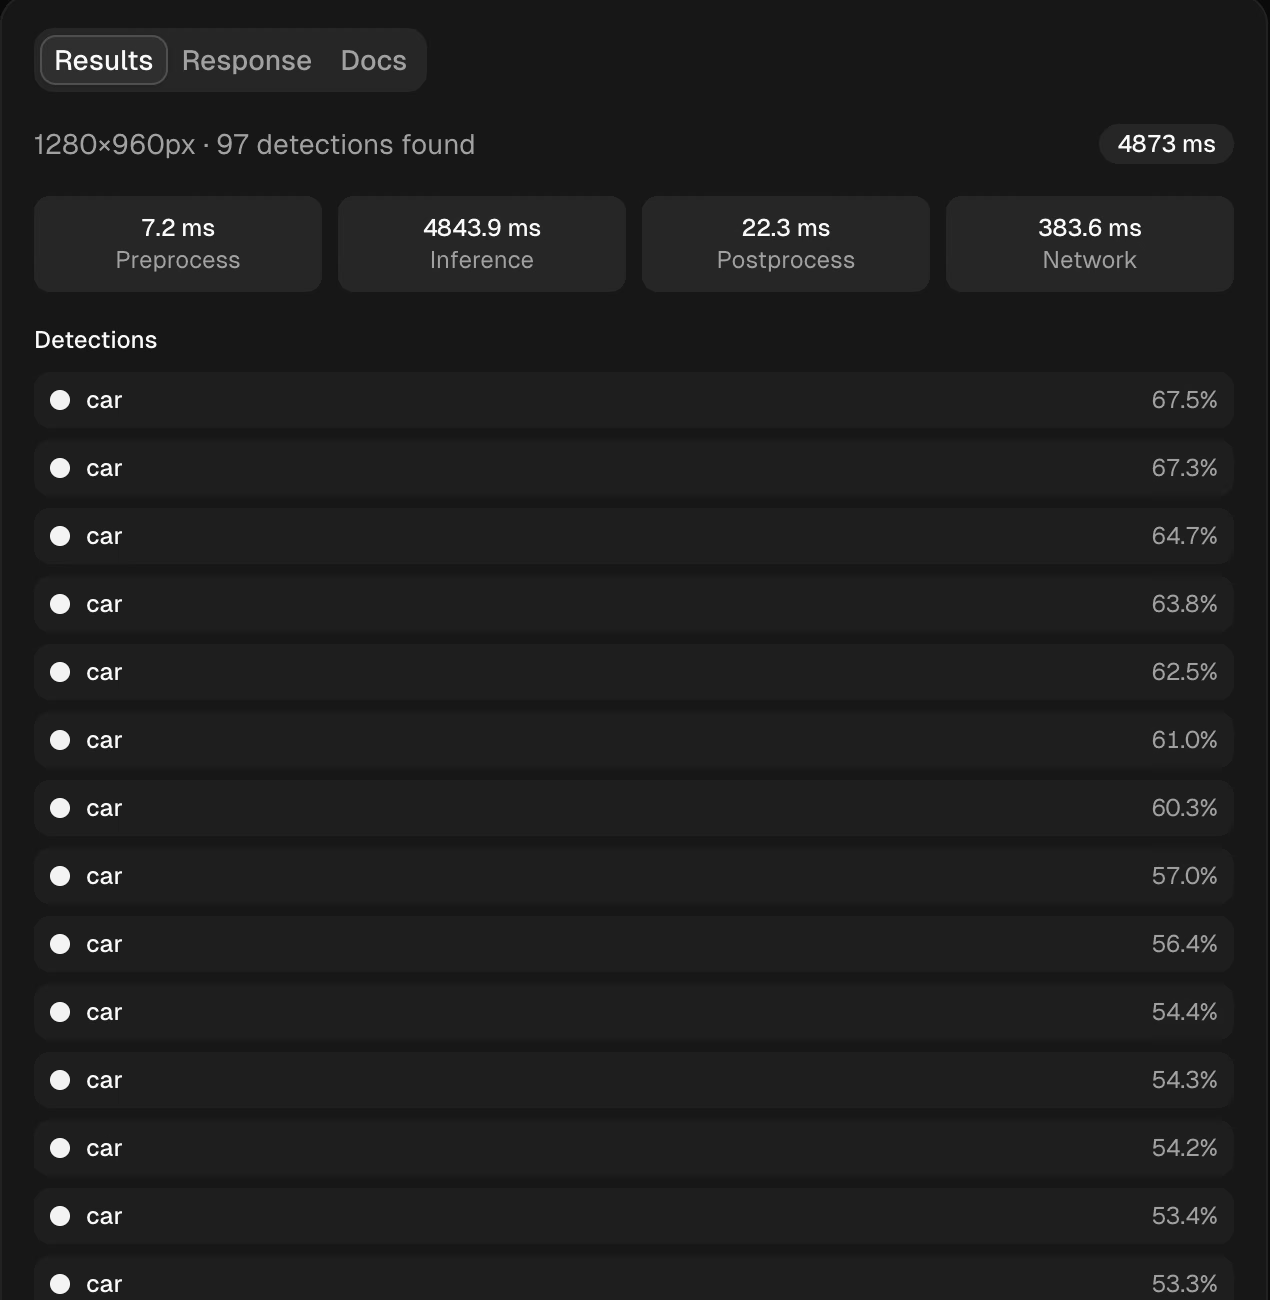
이미지 크기 1280에서 YOLO26x-seg의 Predict 탭은 위 항공 사진에서 차량 탐지 결과 97개를 표시합니다. Platform 추론 문서에서 패널을 자세히 설명합니다.
결과 패널은 긴 목록을 표시하도록 설계되었습니다. 결과가 10개를 초과하면 이미지에 박스만 표시해 레이블이 객체를 가리지 않도록 하고, 목록에는 각 결과의 이름을 표시하며, 확대 이미지에는 레이블을 표시합니다. 행 위에 마우스를 올리면 해당 객체가 강조 표시되고, 객체 위에 마우스를 올리면 해당 행을 찾을 수 있습니다.
자체 데이터로 시험하려면 Package-Seg 소포 세그멘테이션 데이터셋에서 시작해 클라우드에서 학습한 다음 Predict 탭이나 전용 엔드포인트를 통해 결과를 실행하세요.
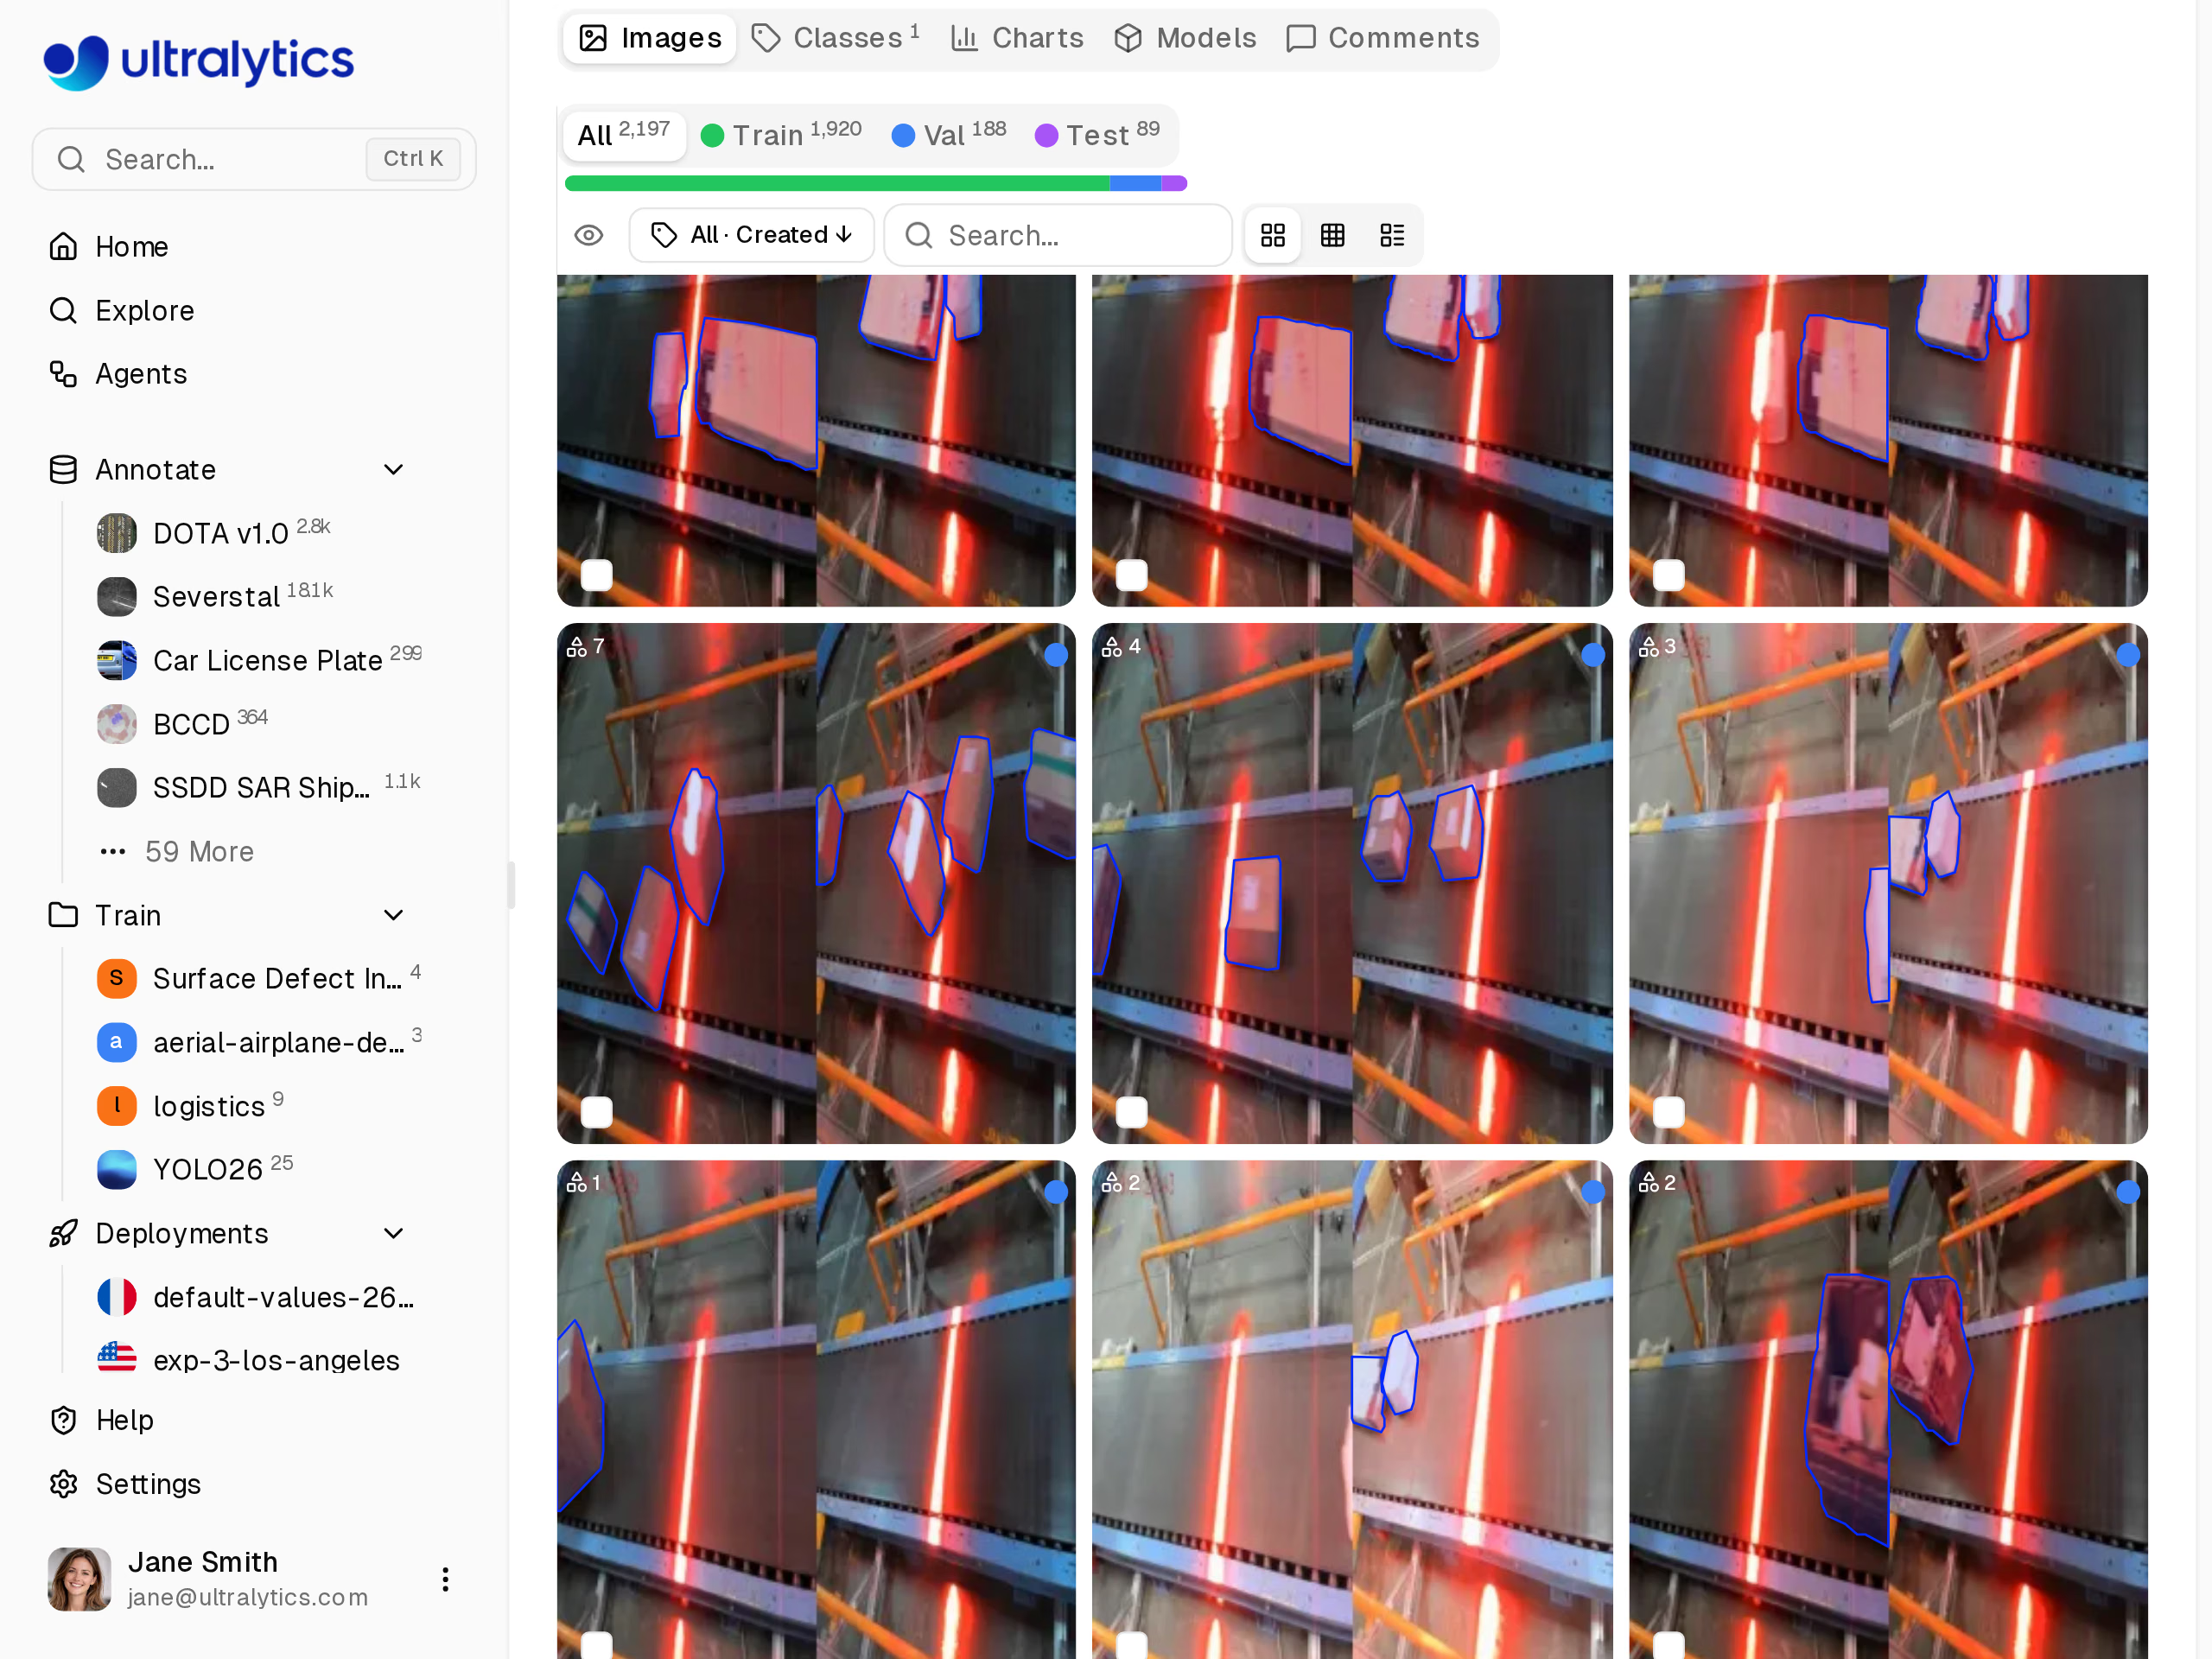
물류 세그멘테이션을 바로 시작할 수 있는 Ultralytics Platform의 Package-Seg 데이터셋입니다.
어떤 사용자가 업그레이드해야 하나요?#
밀집 장면이나 대형 이미지, 예를 들어 소매 매대, 소포 분류, 항공 및 드론 측량, 세포 현미경 이미지를 세그멘테이션하거나 메모리 한도를 지키기 위해 max_det을 제한하고, 이미지 크기를 줄이거나 retina_masks을 제외한 경우 지금 업그레이드하세요. 이제 이러한 우회 방법을 다시 검토할 수 있습니다.
마스크 스택이 임계값 이하라면 기존의 밀집 처리 경로가 유지됩니다. 임계값은 객체 수와 이미지 크기의 곱으로 계산하므로, 매우 큰 이미지에서는 마스크가 몇 개뿐이어도 임계값을 넘을 수 있습니다. 파이프라인에서 항상 masks.data을 읽는다면 밀집 텐서는 여전히 생성되지만, PR의 1080p GPU 테스트에서 마스크 300개를 처리하는 데 든 시간과 메모리는 이전보다 줄었습니다. 인스턴스 마스크가 필요한지 다시 확인하려면 시맨틱 세그멘테이션과 인스턴스 세그멘테이션 비교를 참고하세요.
자주 묻는 질문
YOLO 세그멘테이션은 Ultralytics YOLO의 인스턴스 세그멘테이션 작업입니다. 모델은 객체마다 클래스, 박스, 신뢰도 점수, 픽셀 마스크를 반환합니다. YOLO26 세그멘테이션 모델은 YOLO26n-seg부터 YOLO26x-seg까지 다섯 가지 크기로 제공되며, COCO의 80개 클래스로 사전 학습되어 자체 데이터에 맞게 파인튜닝할 수 있습니다.
max_det은 기본값 300인 상한값을 설정합니다. 반환되는 수는 모델, 이미지, 신뢰도 임계값에 따라서도 달라집니다. 8.4.213부터는 벤치마크와 같은 작업에서 상한값 1,000을 실용적으로 설정할 수 있습니다. 합성 1080p 이미지에서 YOLO26n-seg는 RTX PRO 6000을 사용해 전체 해상도 마스크 1,000개를 56.4ms 만에 예측하고 요약했으며, 최대 메모리 사용량은 321MiB였습니다. Ultralytics Platform은 이미지당 최대 1,000개의 결과를 반환합니다.이전 버전에서는 모든 마스크를 프레임 크기로 생성했으므로 메모리 사용량은 객체 수와 프레임 면적의 곱에 따라 증가했습니다. 전체 해상도 마스크 1,000개를 사용한 합성 4000 x 3000 벤치마크에서는 GPU 메모리 사용량이 최대 23,305MiB에 달했습니다. 버전 8.4.213은 큰 스택을 각 박스 내부에서 디코딩하므로 동일한 조건에서 메모리 사용량이 최대 258MiB였습니다.
ultralytics8.4.213 이상으로 업그레이드하세요. 큰 마스크 스택에서는 박스 단위 경로가 자동으로 활성화되므로 다른 코드는 변경할 필요가 없습니다.masks.data은 기존의 밀집 형식을 그대로 유지하므로 기존 코드도 계속 작동합니다. 해당 경로에서 텐서를 생성하지 않으려면masks.xy를 읽거나summary()을 호출하세요.retina_masks=True은 모델의 추론 크기 대신 원본 이미지 해상도의 마스크를 반환하므로 밀집 마스크가 원본 이미지에 맞춰집니다. 합성 1080p 이미지에서 마스크 300개를 사용해 RTX PRO 6000으로 YOLO26n-seg의 예측과 요약을 수행한 결과, 이 설정을 활성화했을 때 8.4.212에서는 248.7ms, 8.4.213에서는 18.0ms가 걸렸습니다.
작성자
댓글
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.









