Segmentação Ultralytics YOLO em cenas densas: 1.000 máscaras
No Ultralytics 8.4.213, o YOLO26n-seg prevê e resume 1.000 máscaras em uma imagem sintética de 1080p em 56.4 ms em uma RTX PRO 6000, contra 821.2 ms anteriormente.
 Glenn Jocher12 min de leitura
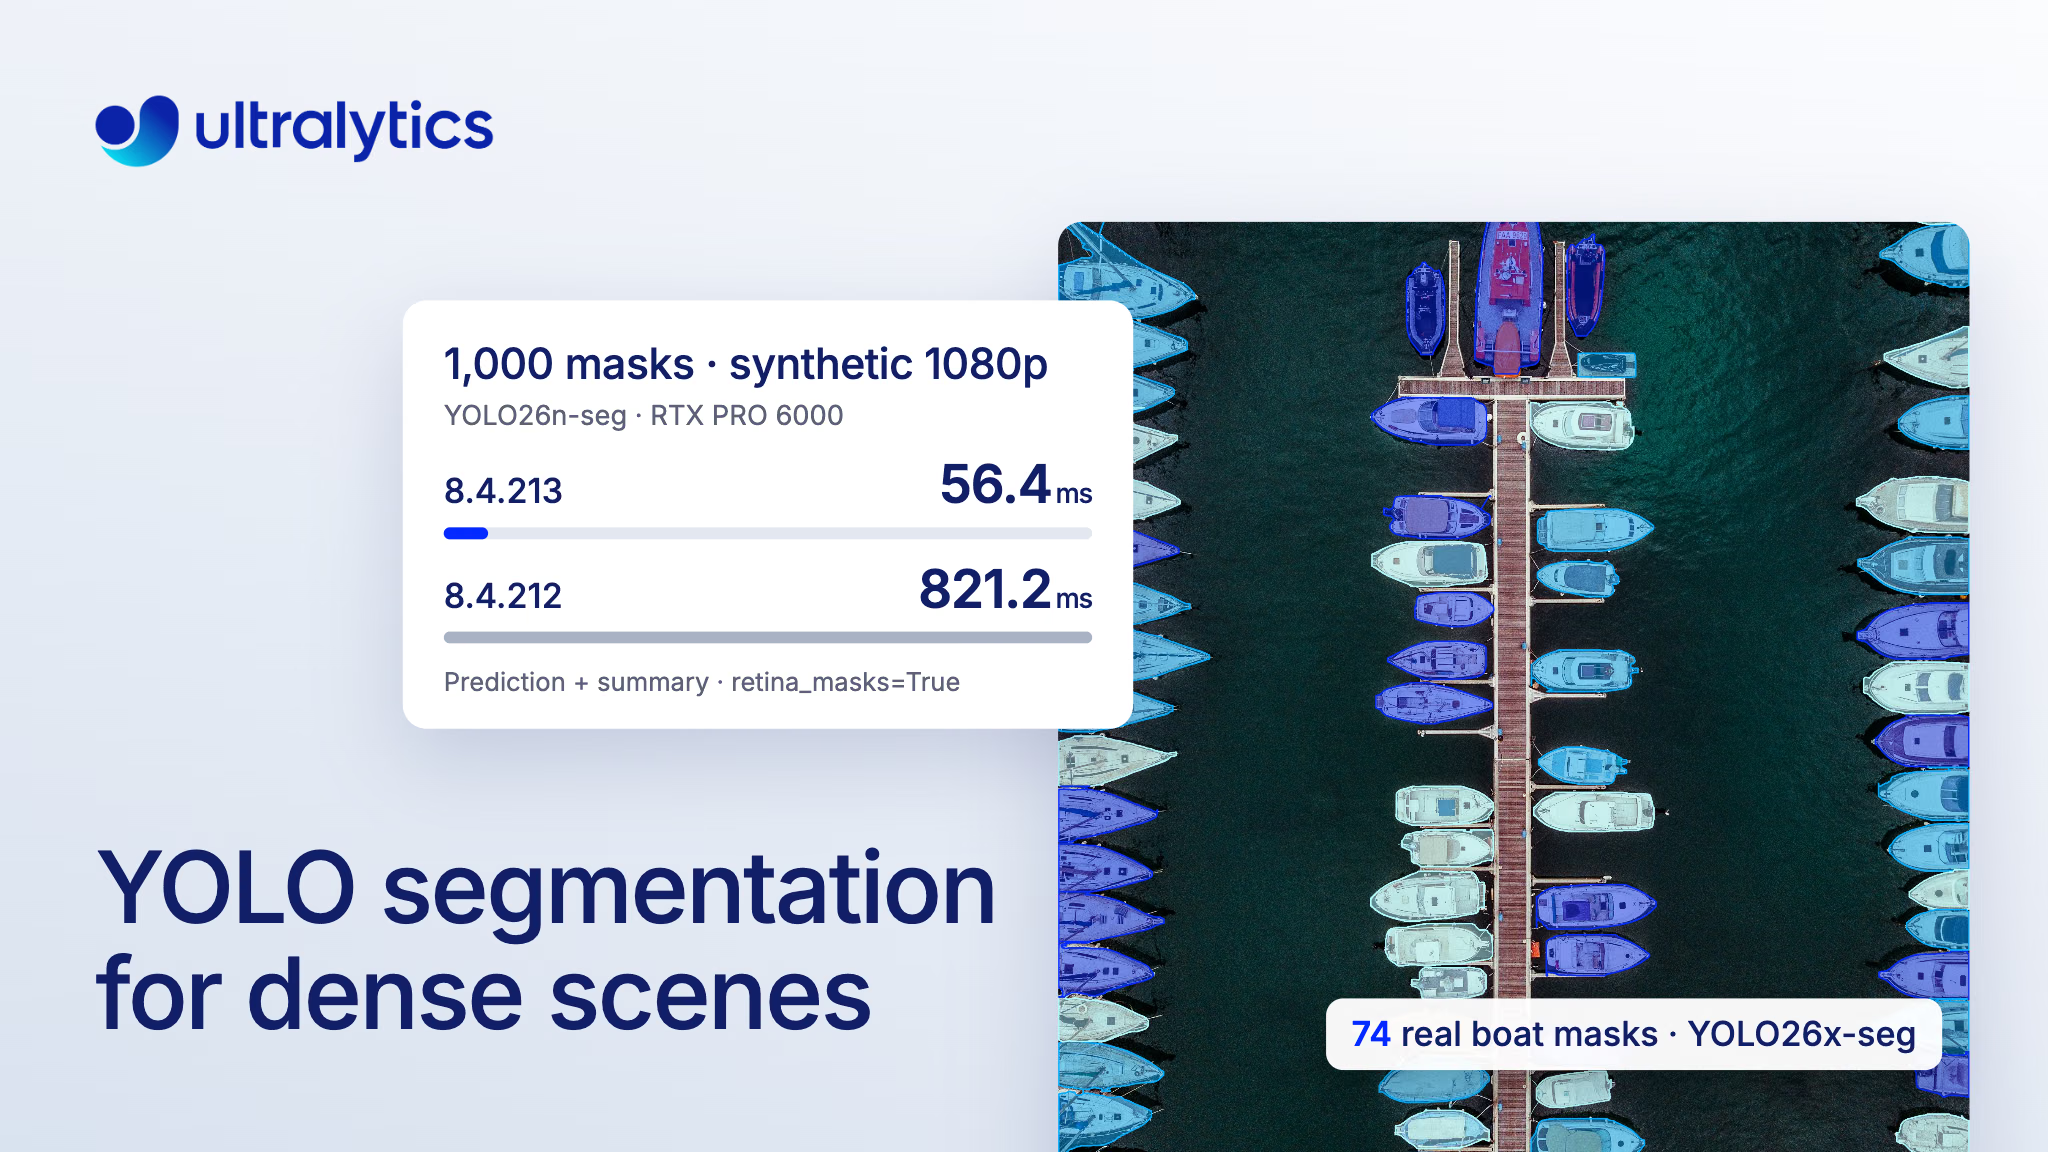
O Ultralytics 8.4.213, lançado em 14 de novembro de 2026, acelera a segmentação YOLO em cenas densas ao decodificar pilhas grandes de máscaras dentro de cada caixa de detecção. Se você segmenta prateleiras, encomendas, multidões ou imagens aéreas, provavelmente já chegou ao ponto em que um modelo de segmentação encontra os objetos, mas a etapa de geração das máscaras fica sem tempo ou memória; esta versão permite avançar muito mais antes de atingir esse limite. No nosso benchmark com uma imagem sintética de 1080p densamente preenchida, o YOLO26n-seg retornou 1.000 máscaras de instância em resolução total (retina_masks=True), incluindo a previsão e um resumo dos resultados, em 56.4 ms e com pico de uso de memória GPU de 321 MiB numa RTX PRO 6000, contra 821.2 ms e 4,291 MiB no 8.4.212.
O modelo em si não mudou. O que mudou foi a forma como a segmentação YOLO transforma a saída do modelo em máscaras: agora, pilhas grandes de máscaras são decodificadas dentro da caixa de cada objeto, em vez de em todo o quadro. Na Ultralytics Platform, a aba Predict e a API retornam até 1.000 resultados por imagem. Esta publicação explica por que cenas densas eram custosas, o que a 8.4.213 faz de forma diferente, os resultados medidos e como executar você mesmo predições com 1.000 máscaras.
Cenas densas costumavam processar pixels fora de cada caixa sem necessidade#
A segmentação de instâncias atribui uma máscara própria a cada objeto, algo necessário para medir áreas, recortar objetos ou distinguir itens encostados. Um modelo de segmentação YOLO prevê um pequeno conjunto de máscaras de protótipo compartilhadas e alguns coeficientes por detecção; o pós-processamento os combina em uma máscara por objeto.
Até agora, essa etapa criava cada máscara no tamanho do quadro: por padrão, no tamanho de inferência do modelo ou, com retina_masks=True ou divisão em blocos, no tamanho da imagem original. Para N objetos em um quadro H x W, era alocada, recortada, filtrada e percorrida uma pilha N x H x W, embora cada máscara fosse zero fora de sua caixa delimitadora. Em uma cena densa de 1080p, a área total de 1.000 caixas, contando as sobreposições, é cerca de duas vezes a área do quadro; ainda assim, a pilha tinha 1.000 vezes a área do quadro. O custo crescia com max_det e com o tamanho da imagem, em vez de acompanhar as caixas na imagem.
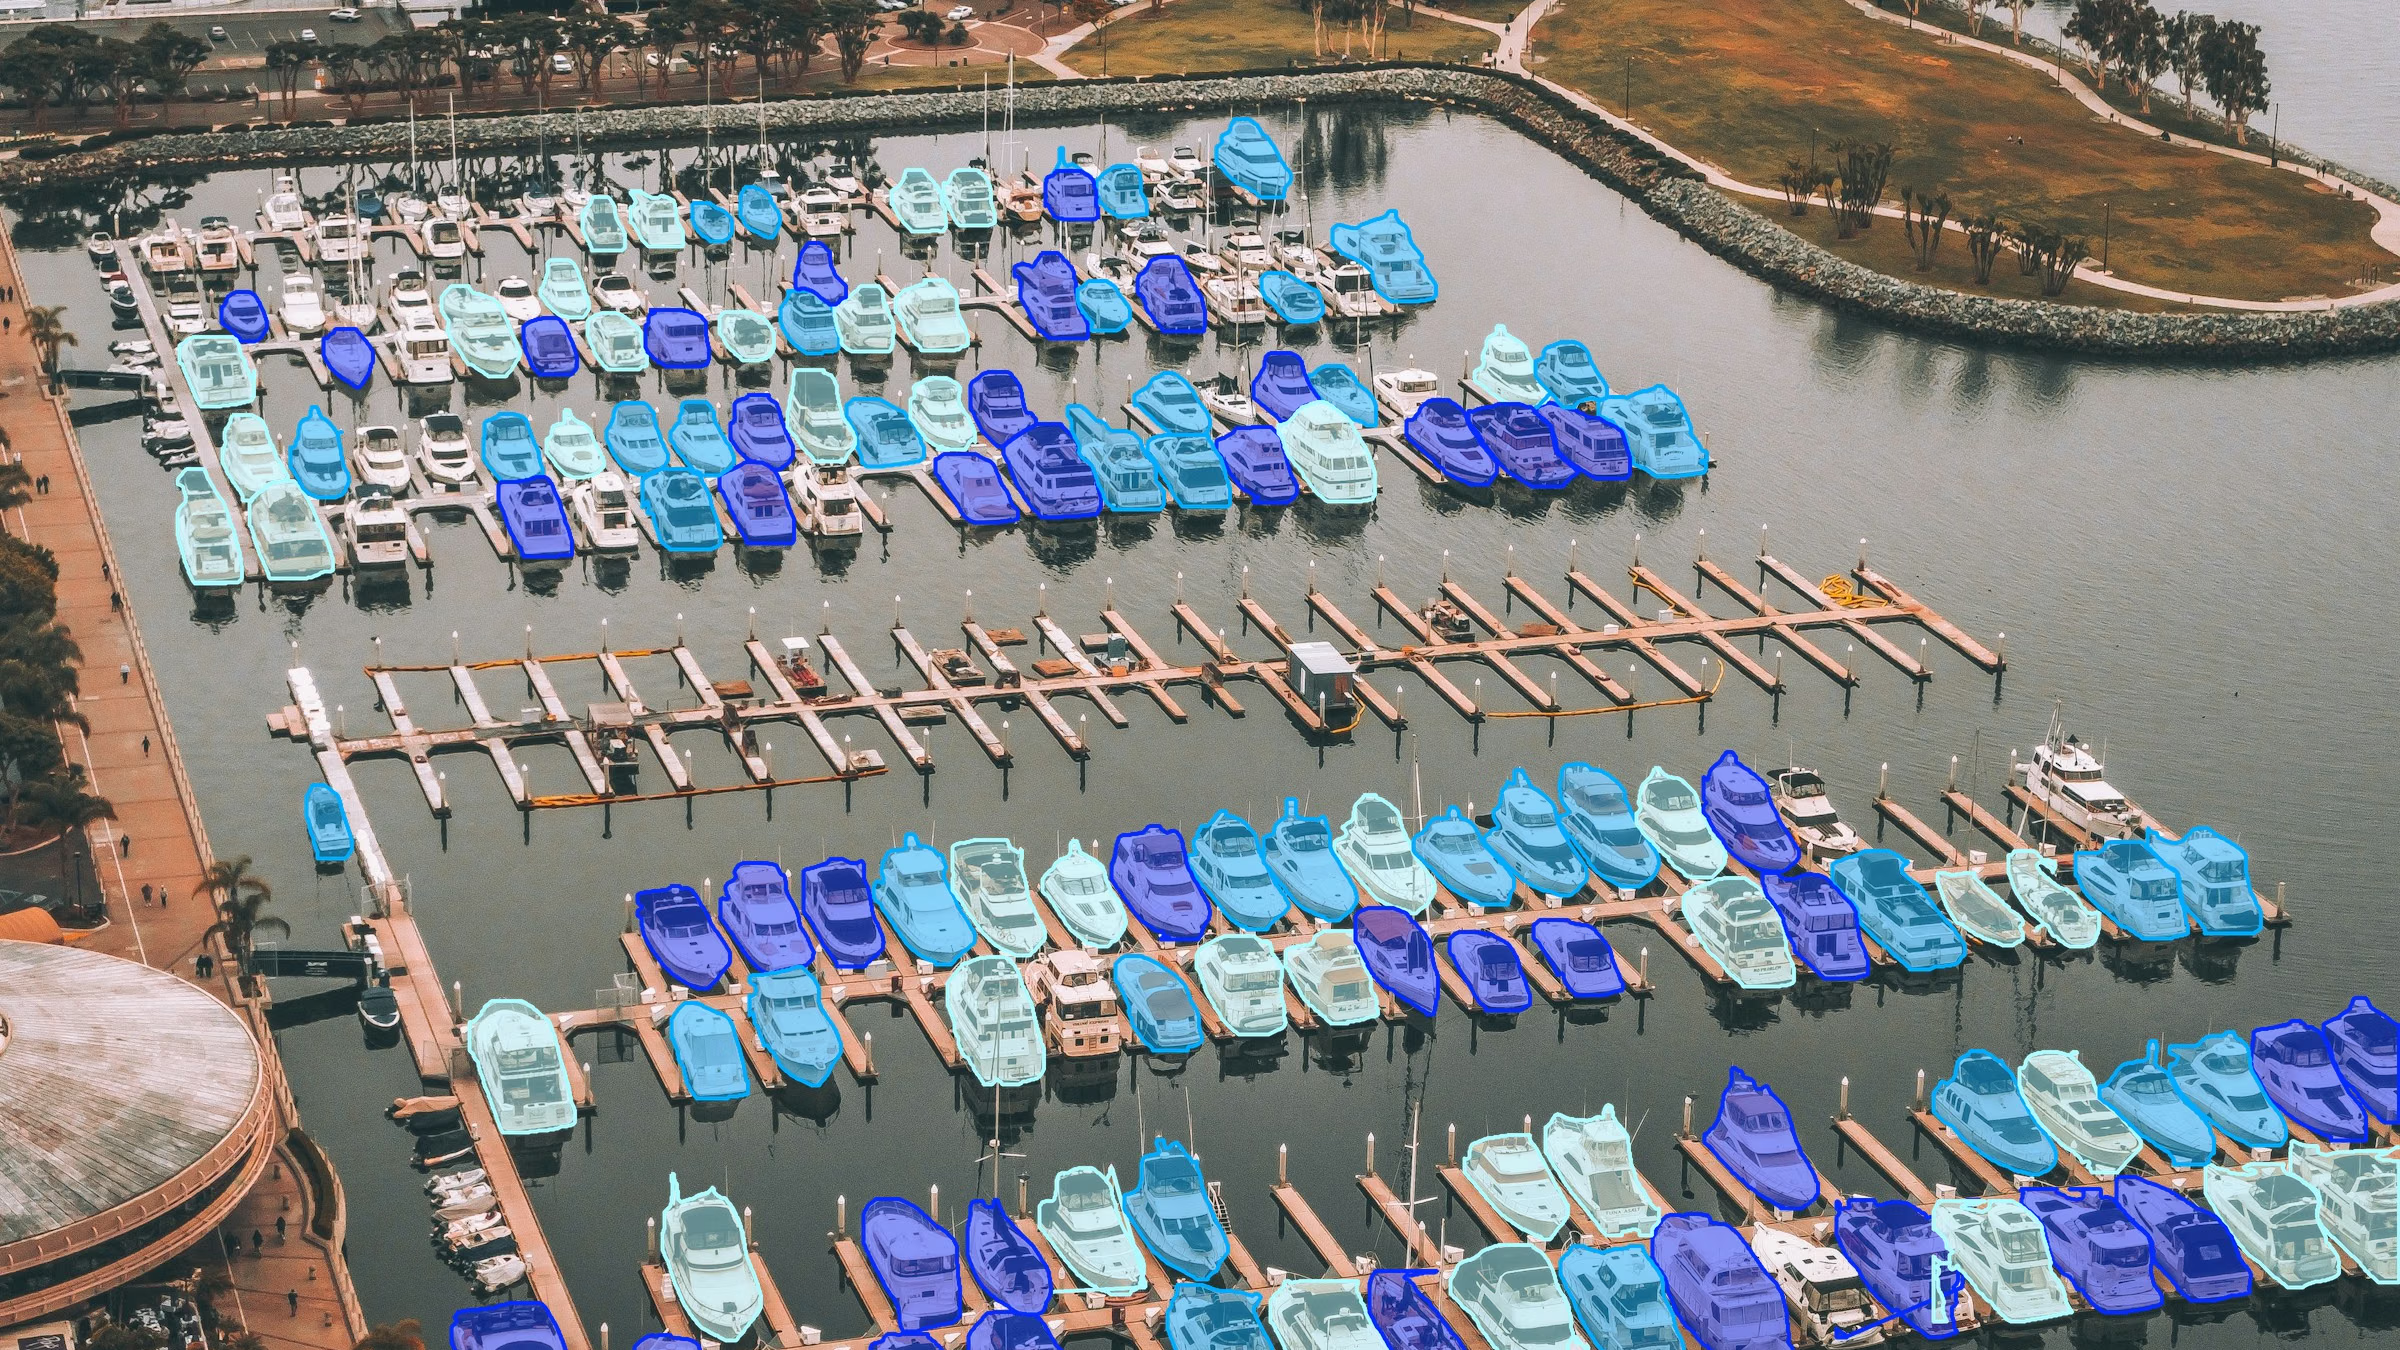
O YOLO26x-seg retornou 127 máscaras de barcos nesta foto da marina, exibidas recortadas (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Foto: Unsplash.
Por isso, aumentar max_det acima do padrão de 300 era impraticável para segmentação, e imagens grandes com muitas instâncias podiam esgotar a memória. Prateleiras de varejo densas, como as do SKU-110K, pilhas de encomendas e imagens aéreas são exatamente os tipos de cena em que você precisa de espaço para mais de 300 objetos.
Ultralytics 8.4.213 decodifica pilhas grandes de máscaras dentro de cada caixa#
O novo caminho, da PR #27197, interpola os logits dos protótipos apenas nos pixels de cada caixa. Ele usa amostragem bilinear separável, a mesma amostragem usada pela interpolação do PyTorch, e agrupa caixas de tamanho semelhante. Para pilhas grandes, o custo da decodificação agora acompanha a área total das caixas.
Três detalhes são importantes na prática:
- É ativado quando o tamanho da pilha de máscaras ultrapassa um limite fixo. O previsor de segmentação usa máscaras locais à caixa quando a pilha densa ultrapassaria 33.554.432 pixels em CUDA ou 4.194.304 pixels em CPU e outros dispositivos. Pilhas menores continuam usando o caminho denso existente, que é tão rápido quanto ou mais rápido para poucas máscaras.
- Nesse caminho, os contornos são gerados diretamente a partir das máscaras locais à caixa.
masks.xyemasks.xyntraçam polígonos por caixa, entãosummary(),to_json()esave_txtnão constroem a pilha completa. - O formato da saída não mudou.
masks.dataainda retorna um tensor denso N x H x W. No caminho local à caixa, ele é criado na primeira vez que você o lê.
A leitura do tensor denso ainda tem o custo de alocação, mas a PR mediu uma redução: na GPU, a leitura de masks.data para 300 máscaras em 1080p com retina_masks=True caiu de 14,1 ms e 1.366 MiB para 9,1 ms e 795 MiB.
1.000 máscaras em 1080p: de 821,2 ms para 56,4 ms na GPU#
A PR compara o YOLO26n-seg executando todo o model.predict(...) mais result.summary() (caixas e polígonos), informando a mediana de execuções aquecidas com um processo por linha. As cenas densas são uma imagem sintética em mosaico em conf=0.01 e imgsz=1280; a cena típica é o bus.jpg padrão com as configurações predefinidas, com 5 máscaras. “Antes” corresponde à 8.4.212. Estas são medições com alto custo de pós-processamento, da predição mais o resumo, e não uma medida geral da velocidade de inferência.
| Cena (GPU, RTX PRO 6000) | Máscaras | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Típica (bus.jpg) | 5 | Falso | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | Falso | 118,5 ms, 1.673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | Verdadeiro | 248,7 ms, 1.366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | Verdadeiro | 821,2 ms, 4.291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | Verdadeiro | 1.352,1 ms, 7.070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | Verdadeiro | 4.323,1 ms, 23.305 MiB | 130,7 ms, 258 MiB |
Tempo e pico de memória da GPU, PyTorch 2.15.0 com CUDA 13.2. Fonte: PR #27197.
A imagem típica com cinco máscaras não muda, como previsto. Os ganhos aparecem quando a pilha antiga ficava grande e são maiores para máscaras na resolução total, que antes eram o caso mais custoso.
Imagens grandes precisam de uma fração da memória#
Com 4000 x 3000 pixels e 1.000 máscaras previstas, o caminho antigo atingia um pico de 23.305 MiB de memória da GPU. O novo caminho atingiu 258 MiB e terminou em 130,7 ms, em vez de 4.323,1 ms. Essa redução deixa mais memória da GPU disponível para o restante do pipeline quando você trabalha com imagens de drones, satélites e inspeção de 12 megapixels.
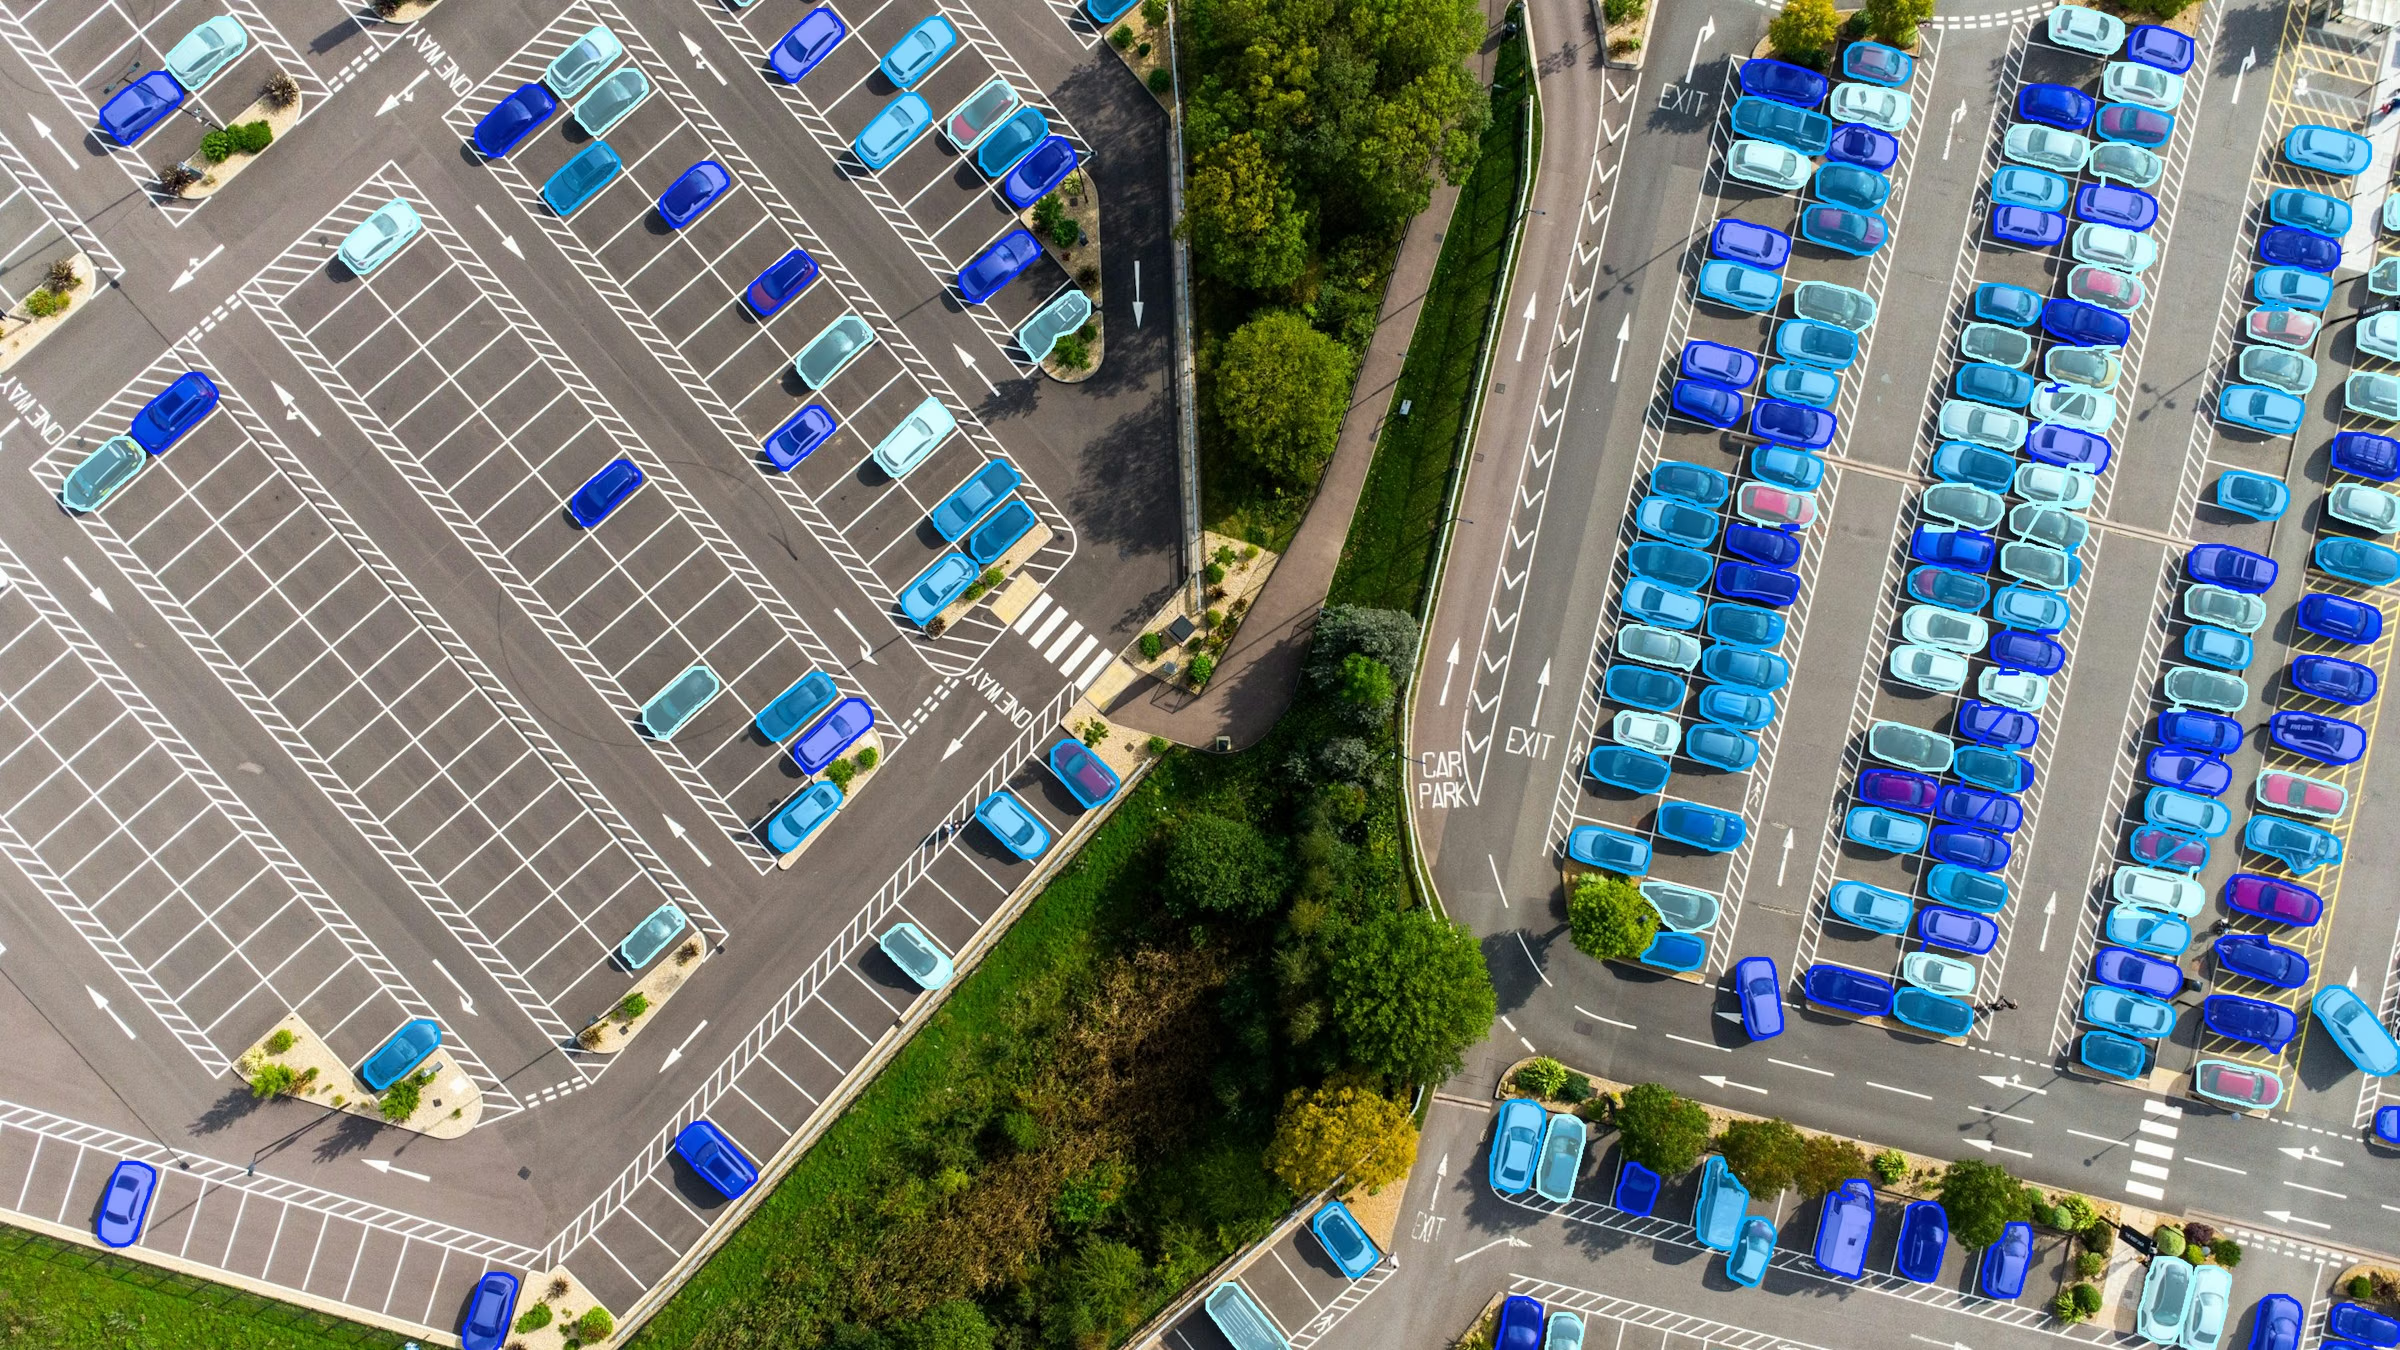
O YOLO26x-seg retornou 222 máscaras de carros nesta imagem aérea (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Foto: Unsplash.
As predições em CPU também ficam muito mais rápidas#
Em uma CPU Linux x86 com 8 threads, o processo ocupa cerca de 840 MiB antes da criação de qualquer máscara. Em 1080p, com 1.000 máscaras na resolução total, o pico de memória do processo caiu de 5.217 MiB para 1.072 MiB, e o tempo diminuiu conforme mostrado abaixo.
300 e 1.000 máscaras em 1920 x 1080, e 300 máscaras em 4000 x 3000 (12 MP). YOLO26n-seg, predição mais resumo, 8.4.212 antes e 8.4.213 depois. Fonte: PR #27197.
As máscaras correspondem às da 8.4.212, com pequenas diferenças nas bordas em um modo#
Um caminho mais rápido só é útil se retornar a mesma resposta. A PR comparou a 8.4.213 com a 8.4.212 em 96 predições, usando YOLO26n-seg e YOLO11n-seg em duas imagens com seis tamanhos, conf de 0.25 e 0.01, os dois modos de máscara e o caminho local à caixa forçado a ficar ativado:
- Máscaras padrão (
retina_masks=False): caixas, máscaras e polígonos são idênticos; 0 de 7,6 milhões de pixels de máscara são diferentes. - Máscaras em resolução total (
retina_masks=True): idênticas sempre que o código antigo fazia uma única interpolação. Para os demais formatos de imagem, 0,07% dos pixels de máscara são diferentes (18.105 de 24,8 milhões), todos nas bordas das máscaras, porque o código antigo interpolava duas vezes nesses casos e o novo amostra os protótipos uma vez na coordenada exata. - Apple MPS: máscaras, caixas e polígonos são idênticos em uma cena densa de 1080p com 179 máscaras, nos dois modos de máscara.
Como segmentar 1.000 objetos por imagem em Python#
Atualize com pip install -U ultralytics (8.4.213 ou posterior) e aumente max_det acima do padrão de 300. O restante do seu código continua igual.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # Classes COCO; carregue seu próprio modelo treinado para prateleiras ou encomendas
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # um array (P, 2) por objeto, em pixels da imagem original
rows = r.summary()  # caixas e polígonos
max_det é um limite máximo, não uma meta: a quantidade de objetos retornados ainda depende do modelo, da imagem e do limiar de confiança. Para aproveitar ao máximo essa mudança:
- Leia os contornos sempre que puder.
masks.xy(pixels) emasks.xyn(normalizados) são gerados a partir de máscaras locais à caixa no caminho de pilhas grandes, assim comoto_json()esave_txt. A referência de Results lista todos os atributos. - Leia
masks.datapara fazer cálculos diretamente com pixels. É mais simples calcular áreas e sobreposições no tensor denso; os recortes também podem ser obtidos a partir dos contornosmasks.xy. Nossa aula da Academy sobre como usar máscaras no código mostra quando usar cada visualização, e o guia de isolamento de objetos explica como gerar recortes a partir de contornos. - Use
retina_masks=Truequando precisar de máscaras na resolução da imagem original. No benchmark de GPU com 300 máscaras em 1080p, agora leva 18,0 ms, contra 16,3 ms para as máscaras padrão. Para objetos pequenos em imagens muito grandes, confira nossa publicação sobre detecção de objetos pequenos com divisão da imagem em blocos e o guia de divisão em blocos de alta resolução. A predição em blocos retorna máscaras do tamanho da imagem original; portanto, uma execução em blocos ainda precisa de memória proporcional à imagem original. - Ajuste
confeioupara cenas movimentadas. Aumentarmax_detmantém mais detecções que já passam emconf; diminuirconfpermite detecções menos confiáveis. As configurações de predição explicamconf,iouemax_det, e nosso guia sobre o limiar IoU do NMS explica como lidar com objetos encostados.
A mudança está no pós-processamento em Python, então se aplica ao modelo PyTorch e a modelos exportados executados pela API predict da Ultralytics. A PR testou YOLO26n-seg e YOLO11n-seg, e o mesmo pós-processamento atende a todos os modelos de segmentação YOLO26 e YOLO11, do YOLO26n-seg, com 2,7 milhões de parâmetros fundidos, ao YOLO26x-seg, com 62,8 milhões. Para treinar um modelo com seus próprios dados densos, siga nosso guia de treinamento personalizado do YOLO26 para segmentação de instâncias.
A Ultralytics Platform agora retorna até 1.000 resultados por imagem#
O mesmo limite máximo agora se aplica à Ultralytics Platform. A aba Predict de um modelo retorna até 1.000 resultados por imagem, assim como a REST API por trás dela. Os modelos RT-DETR são a exceção, com limite de 300, correspondente ao número de consultas no decodificador.
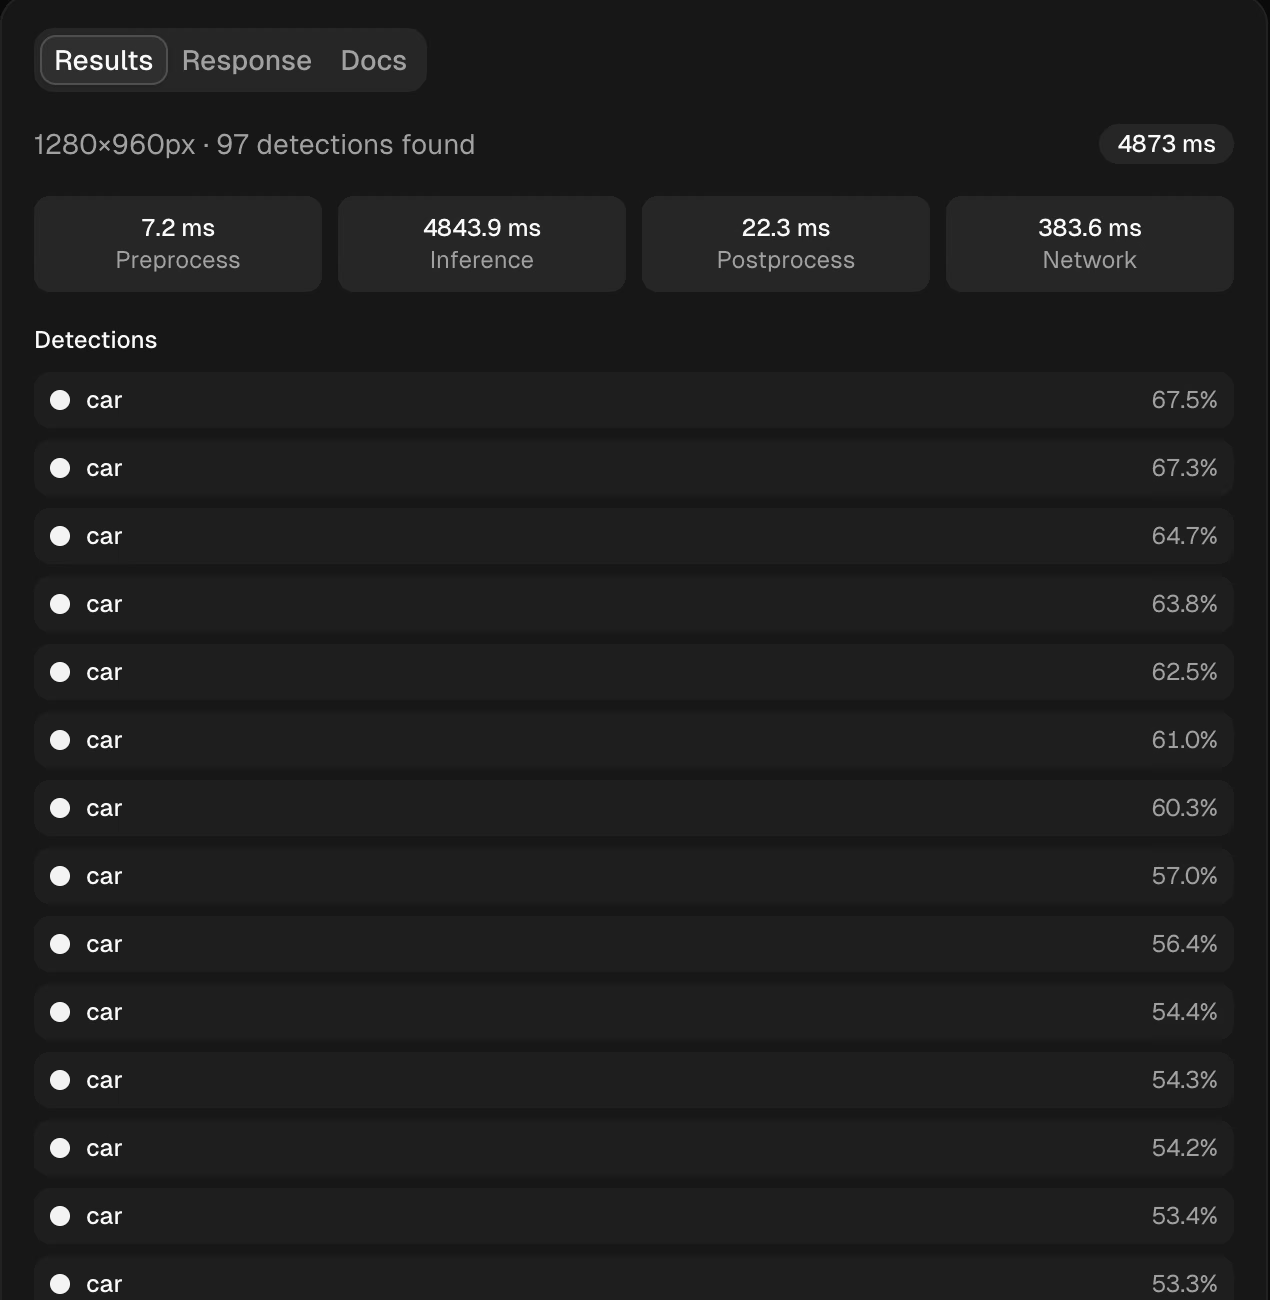
A aba Predict do YOLO26x-seg com tamanho de imagem 1280, listando 97 detecções de carros na foto aérea acima. A documentação de inferência da Platform explica o painel em detalhes.
O painel de resultados foi projetado para listas longas. Com mais de 10 resultados, a imagem exibe as caixas sem rótulos para que não ocultem os objetos, a lista identifica cada resultado e a imagem ampliada mantém os rótulos. Passe o cursor sobre uma linha para destacar o objeto correspondente ou sobre um objeto para encontrar sua linha.
Para testar com seus próprios dados, comece pelo conjunto de dados de segmentação de encomendas Package-Seg, treine na nuvem e execute o resultado na aba Predict ou por trás de um endpoint dedicado.
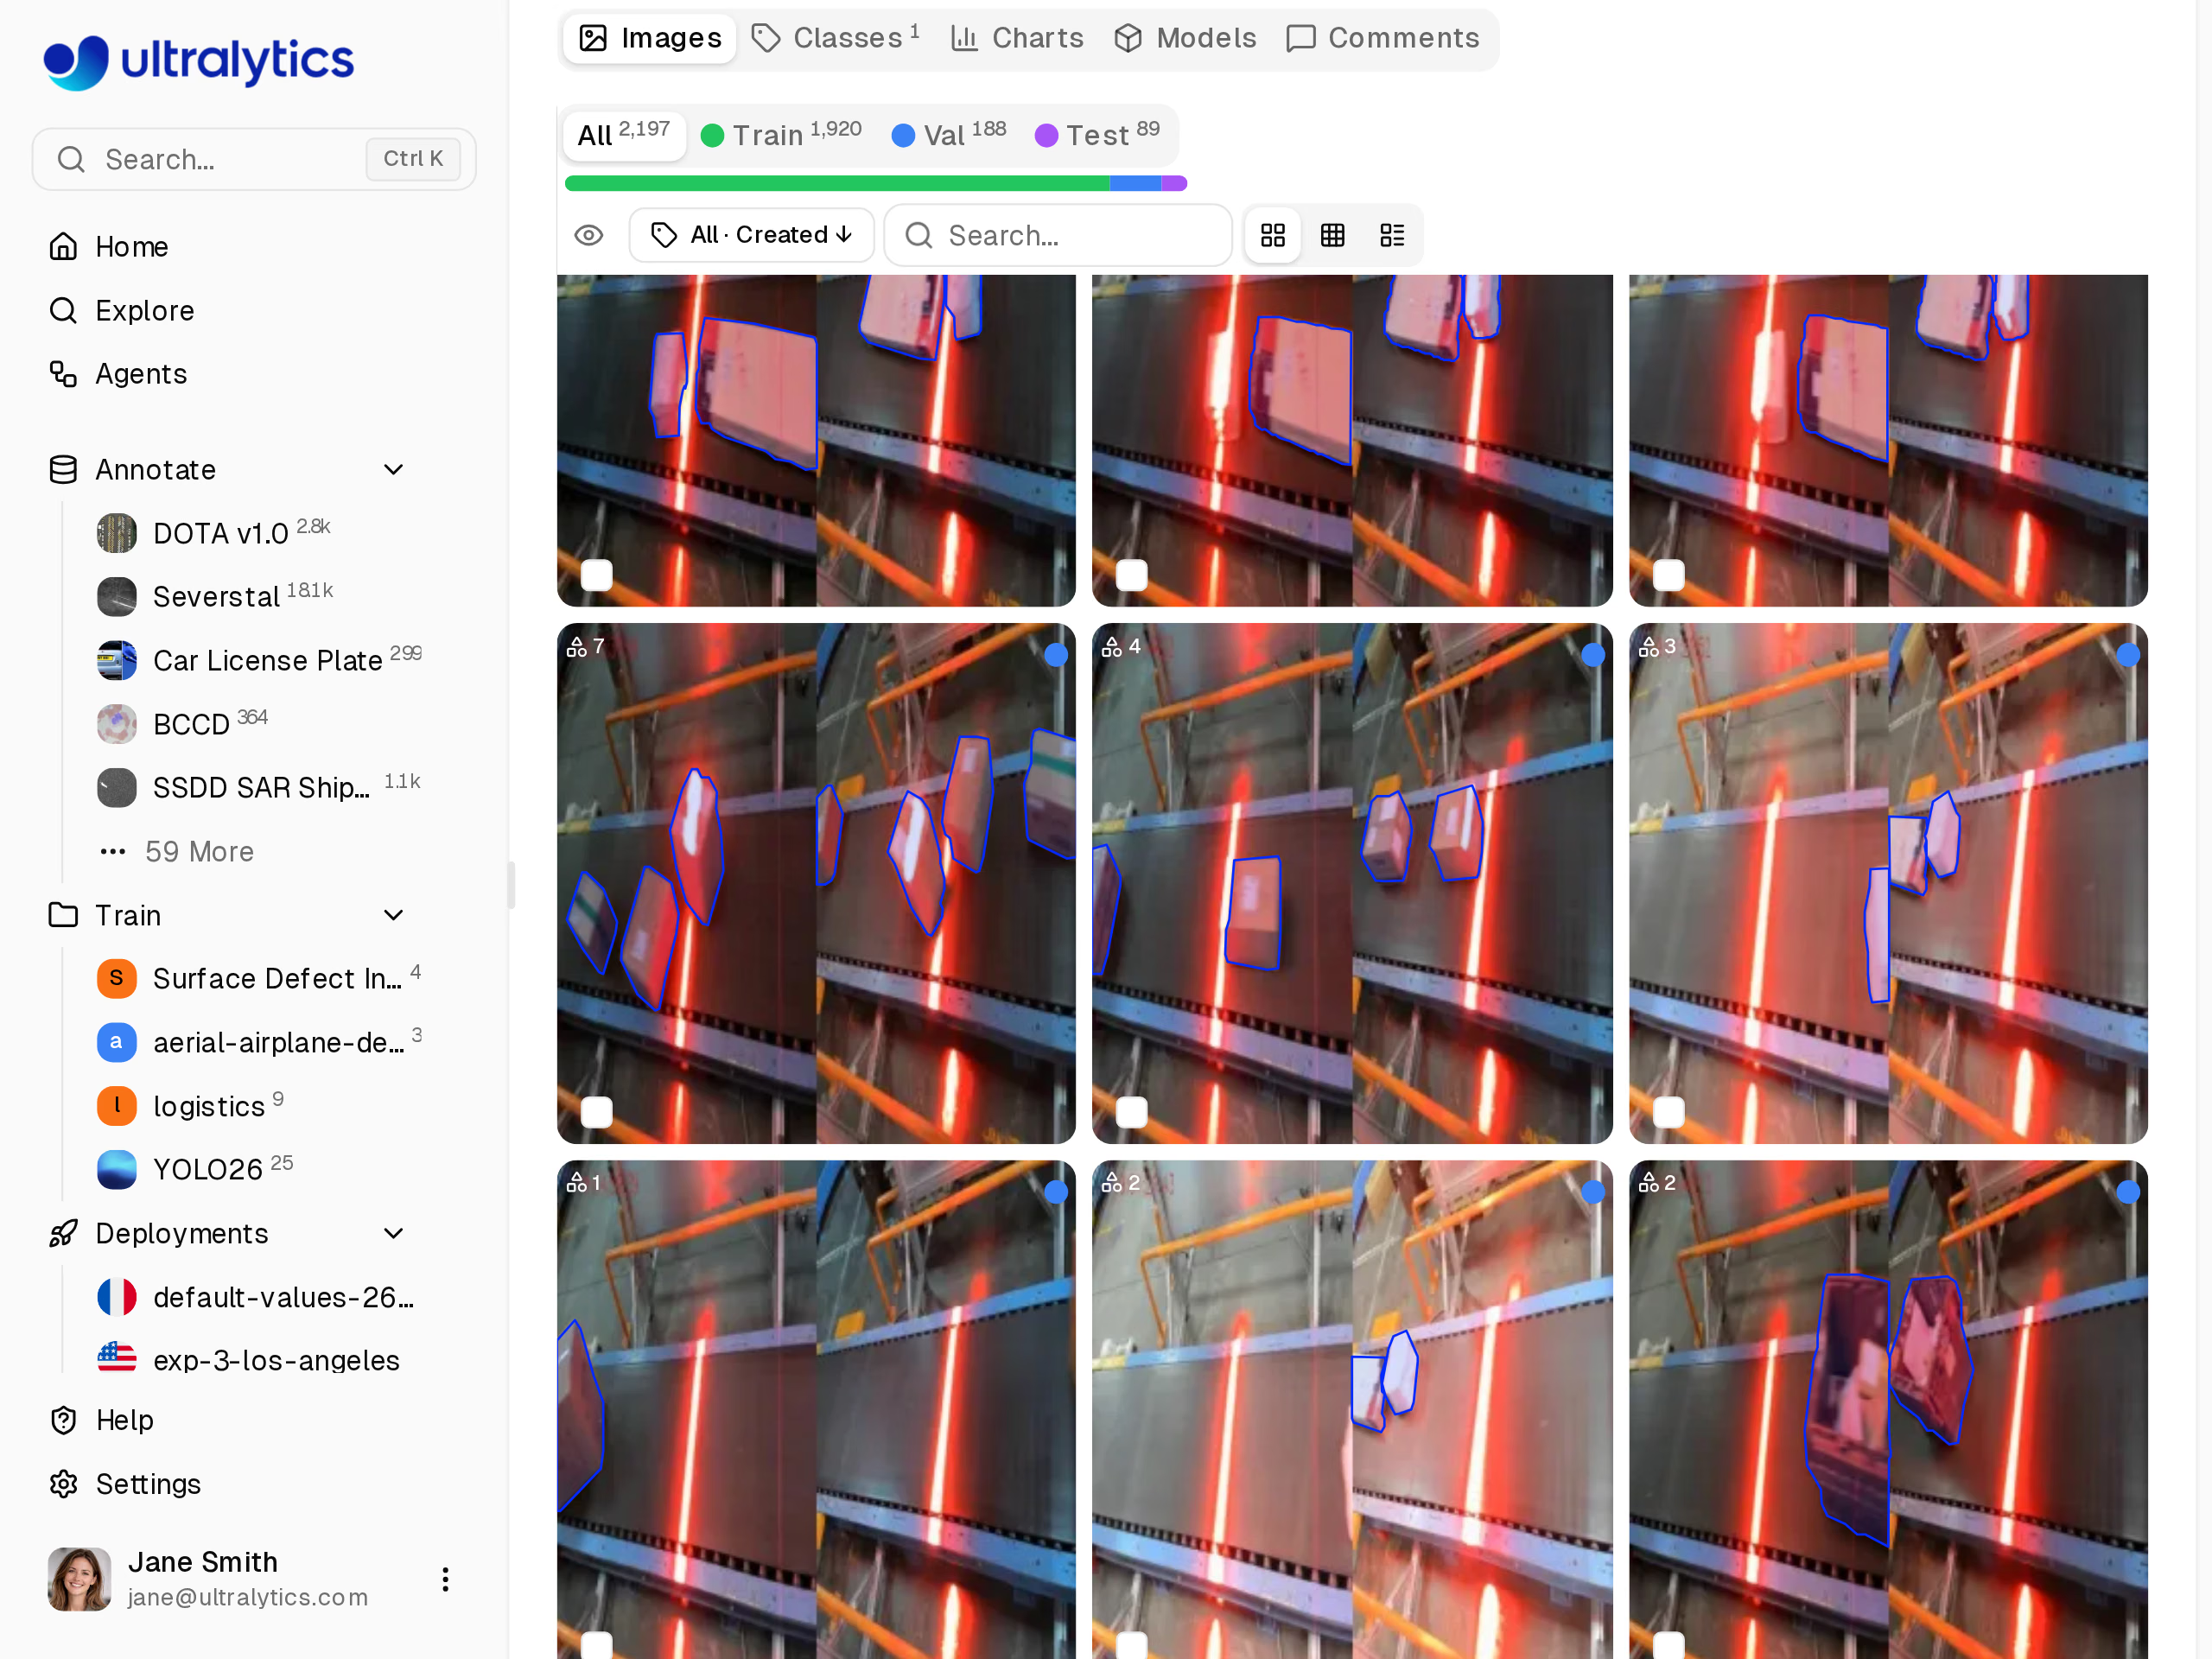
O conjunto de dados Package-Seg na Ultralytics Platform, um ponto de partida pronto para segmentação logística.
Quem deve atualizar#
Atualize agora se você segmenta cenas movimentadas ou imagens grandes: prateleiras de varejo, triagem de encomendas, levantamentos aéreos e com drones, microscopia celular ou qualquer situação em que você tenha limitado max_det, reduzido o tamanho da imagem ou descartado retina_masks para caber na memória. Você pode rever essas soluções alternativas.
Se suas pilhas de máscaras ficarem abaixo do limite, elas continuarão usando o caminho denso existente; lembre-se de que o limite considera o número de objetos multiplicado pelo tamanho da imagem, então até mesmo poucas máscaras em uma imagem muito grande podem ultrapassá-lo. Se seu pipeline sempre lê masks.data, você ainda cria o tensor denso; no teste de GPU da PR com 300 máscaras em 1080p, isso consumiu menos tempo e memória do que antes. Para relembrar se você precisa mesmo de máscaras de instâncias, consulte segmentação semântica vs. segmentação de instâncias.
Perguntas frequentes
A segmentação YOLO é a tarefa de segmentação de instâncias do Ultralytics YOLO: para cada objeto, o modelo retorna uma classe, uma caixa, uma pontuação de confiança e uma máscara de pixels. Os modelos de segmentação YOLO26 estão disponíveis em cinco tamanhos, do YOLO26n-seg ao YOLO26x-seg, pré-treinados nas 80 classes do COCO e prontos para ajuste fino com seus próprios dados.
max_detdefine o limite máximo, que é 300 por padrão; a quantidade retornada também depende do modelo, da imagem e do limiar de confiança. Desde a 8.4.213, um limite máximo de 1.000 é viável para cargas de trabalho como a do benchmark: em uma imagem sintética de 1080p, o YOLO26n-seg previu e resumiu 1.000 máscaras em resolução total em 56,4 ms, com um pico de memória de 321 MiB em uma RTX PRO 6000. A Ultralytics Platform retorna até 1.000 resultados por imagem.As versões anteriores criavam cada máscara no tamanho do quadro, então a memória crescia com o número de objetos multiplicado pela área do quadro. No benchmark sintético de 4000 x 3000 com 1.000 máscaras em resolução total, o pico foi de 23.305 MiB de memória da GPU. A versão 8.4.213 decodifica pilhas grandes dentro de cada caixa e atingiu um pico de 258 MiB no mesmo caso.
Atualize para
ultralytics8.4.213 ou posterior; não é preciso alterar mais nada no código, pois o caminho local à caixa é ativado automaticamente para pilhas grandes de máscaras.masks.datamantém o mesmo formato denso, então o código existente continua funcionando; lermasks.xyou chamarsummary()em vez disso evita a criação do tensor nesse caminho.retina_masks=Trueretorna máscaras na resolução original da imagem, em vez de no tamanho de inferência do modelo, alinhando a máscara densa à imagem original. Com 300 máscaras em uma imagem sintética de 1080p, a predição mais o resumo do YOLO26n-seg em uma RTX PRO 6000 levou 248,7 ms na 8.4.212 e 18,0 ms na 8.4.213 com essa configuração ativada.
Escrito por
Fundador e CEO · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









