Data Curation
A curadoria de dados é o processo contínuo de organizar, validar, documentar e manter conjuntos de dados confiáveis para aprendizado de máquina e avaliação.
A curadoria de dados é o processo contínuo de selecionar, organizar, verificar, documentar e manter dados para que continuem úteis para uma finalidade específica. Em aprendizado de máquina, ela molda os exemplos dos quais um modelo aprende e as evidências usadas para avaliá-lo. Um conjunto de dados curado reúne amostras relevantes, rótulos consistentes para tarefas supervisionadas, informações contextuais e versões rastreáveis.
Curadoria, limpeza e pré-processamento#
A curadoria abrange todo o ciclo de vida do conjunto de dados. A limpeza de dados corrige erros e remove registros inutilizáveis; o pré-processamento de dados transforma as entradas por meio de operações como redimensionamento ou normalização. A anotação de dados, também chamada de rotulagem de dados, adiciona os alvos usados no aprendizado supervisionado. A curadoria coordena essas atividades e, ao mesmo tempo, determina quais amostras incluir, como definir as categorias e como a coleção muda ao longo do tempo. Definições de categorias e regras de rotulagem consistentes ajudam os modelos a aprender relações confiáveis entre imagens e alvos.
Isso torna a curadoria um componente prático da IA centrada em dados, que aprimora os sistemas por meio da melhoria dos dados.
Como funciona a curadoria de dados#
O processo começa com uma especificação do conjunto de dados: a tarefa de previsão, as categorias-alvo, as condições operacionais e os critérios de inclusão. Para a detecção de objetos, isso inclui regras para caixas delimitadoras e objetos parcialmente visíveis. A análise da frequência das categorias e das condições de captura revela o viés do conjunto de dados, incluindo classes ou ambientes sub-representados.
As verificações de qualidade combinam inspeção automatizada e revisão humana. As verificações de arquivos identificam imagens ilegíveis; as verificações de anotações detectam coordenadas inválidas e classes inconsistentes. Hashes de arquivos exatos detectam cópias idênticas, enquanto incorporações—representações numéricas do conteúdo das imagens—ajudam a localizar amostras visualmente semelhantes. A revisão separa erros corrigíveis de registros inutilizáveis e mantém exemplos válidos e difíceis que representam a tarefa.
Uma auditoria de hash de arquivos pode manter um caminho por arquivo exclusivo. Este exemplo verifica as imagens incluídas no pacote ultralytics, instalado com pip install ultralytics:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
As contagens mostram quantos arquivos permanecem após a deduplicação exata; contagens iguais indicam que todos os arquivos amostrados têm hashes distintos.
A divisão protege a independência dos dados de treinamento, dos dados de validação e dos dados de teste. Quadros de vídeo próximos compartilham o conteúdo da cena, então distribuí-los entre as divisões introduz vazamento de dados e eleva artificialmente as pontuações de avaliação. Agrupar por sessão de gravação, câmera ou local faz com que a avaliação reflita a tarefa de generalização pretendida. Uma versão fixa do conjunto de dados preserva essas atribuições junto com os rótulos.
A Ultralytics Platform oferece suporte à curadoria com gráficos de distribuição de classes e agrupamento de imagens, que revelam lacunas de cobertura, duplicatas e valores atípicos. As ferramentas de gerenciamento de conjuntos de dados permitem que as equipes inspecionem esses grupos e atualizem imagens, rótulos e atribuições de divisão.
O que faz um curador de dados#
Um curador de dados mantém o significado e a utilidade da coleção. Entre as responsabilidades estão documentar as fontes, coordenar as diretrizes de anotação, resolver divergências de rotulagem e registrar alterações. Os metadados—informações que descrevem as amostras—registram o horário de aquisição, o sensor, a localização e o status da anotação. Manter dados reutilizáveis inclui preservar descrições e documentação de apoio.
A proveniência dos dados registra a origem das amostras e como elas foram transformadas. Vincular as versões do conjunto de dados ao rastreamento de experimentos torna reproduzíveis as comparações entre modelos. Após a implantação, o aprendizado ativo prioriza amostras informativas para revisão; o monitoramento detecta a deriva de dados, que pode levar a uma nova coleta.
Exemplos em visão computacional#
Em percepção automotiva, a coleção original BDD100K contém 100.000 vídeos de direção que abrangem locais nos EUA, condições climáticas e períodos diurnos e noturnos. Seus atributos ambientais permitem avaliar diferentes condições de captura. A edição da Platform contém 99.996 imagens de quadros-chave para detecção.
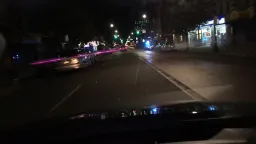 Prévia 1 de BDD100K
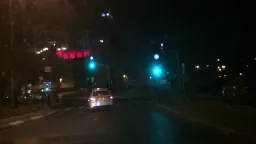 Prévia 2 de BDD100K
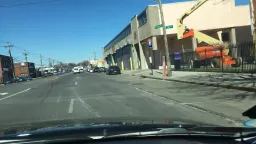 Prévia 3 de BDD100K
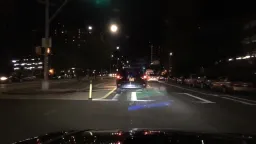 Prévia 4 de BDD100K
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
Para a classificação de imagens, a correção ciFAIR substituiu quase duplicatas nos conjuntos de teste originais do CIFAR-10 e do CIFAR-100. Correspondências com imagens de treinamento ou outras imagens de teste afetaram 3,25% e 10% dos conjuntos de teste originais, respectivamente. Com o treinamento inalterado, o erro de classificação do ResNeXt-29 (8x64d) aumentou de 3,56% no CIFAR-10 para 3,95% no ciFAIR-10.









