Cách Ultralytics Platform dùng AI để tự động hóa việc gán nhãn
Khám phá cách Ultralytics Platform dùng AI để tự động hóa việc gán nhãn, quản lý dataset lớn, cải thiện tính nhất quán và tăng tốc phát triển thị giác máy tính.
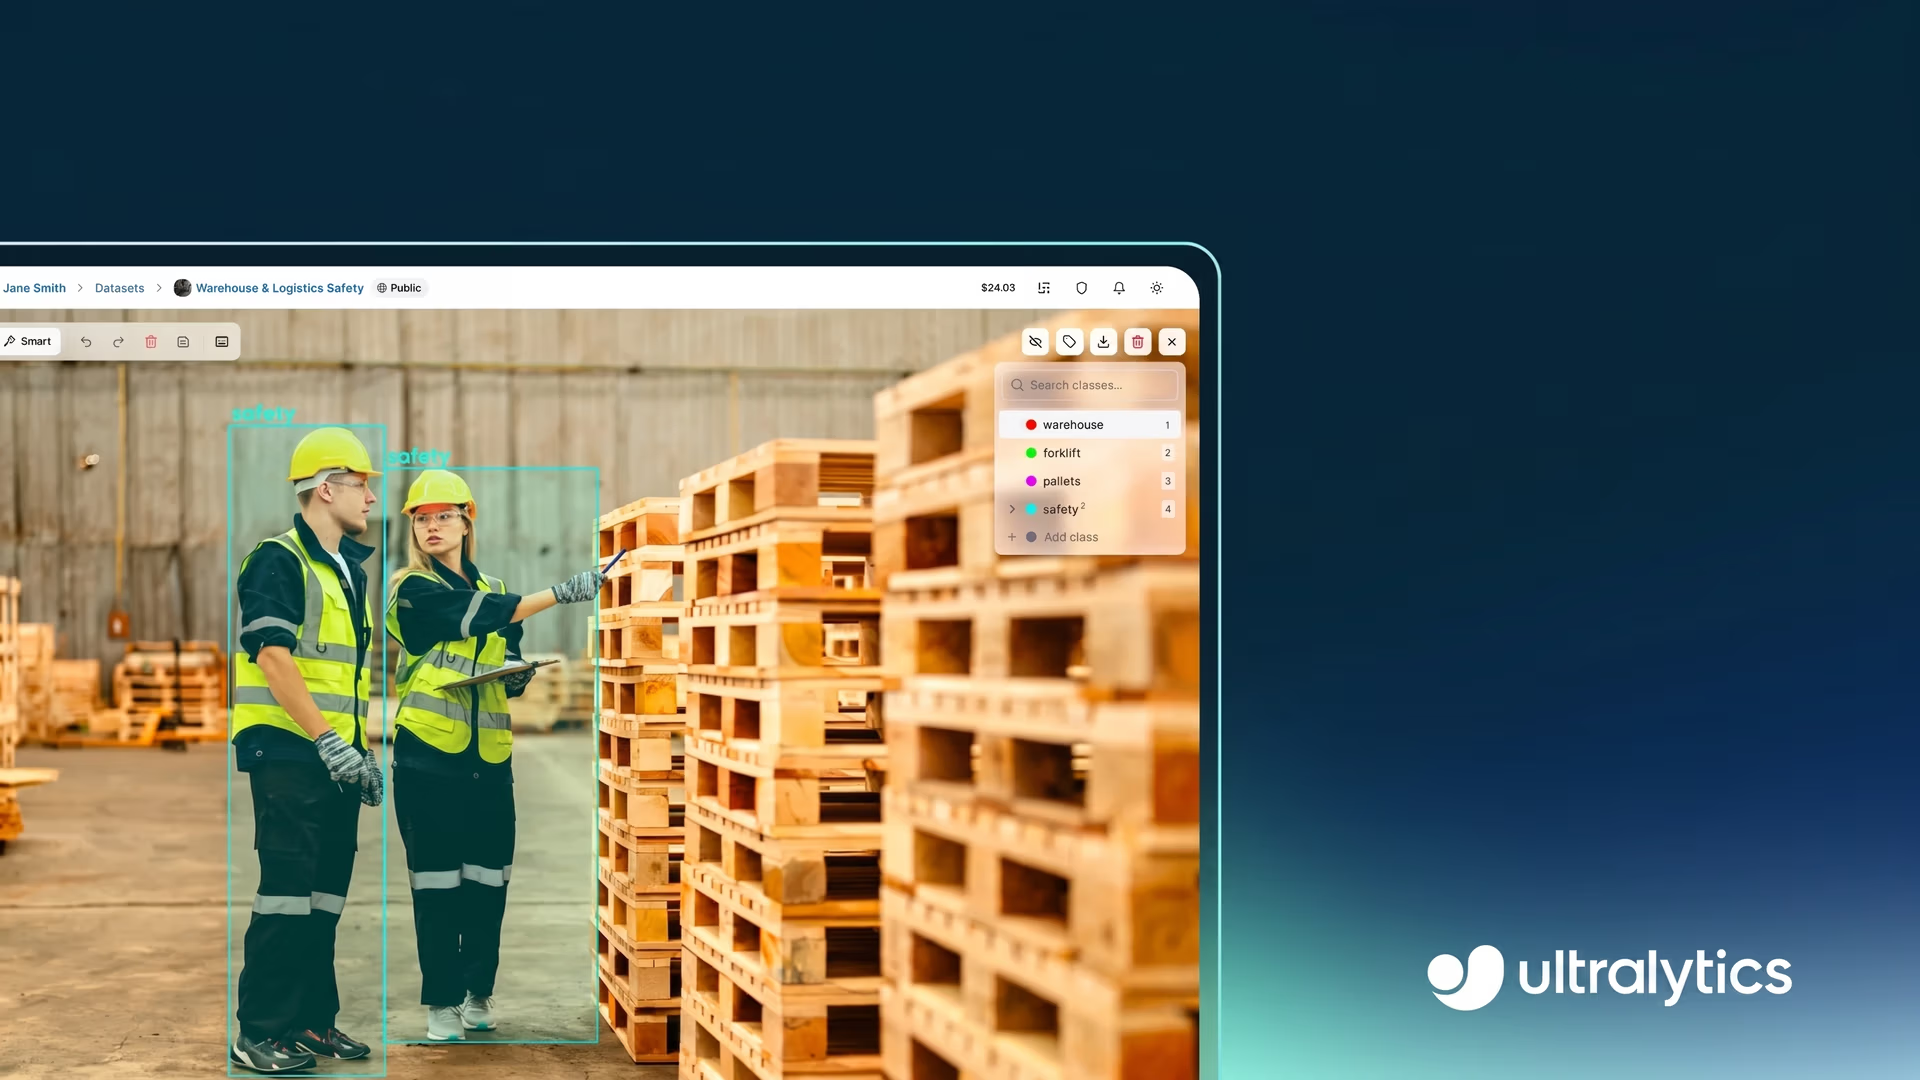
Các giải pháp thị giác máy tính phân tích hình ảnh và video đang trở thành một phần thường xuyên trong quy trình làm việc của nhiều ngành, từ sản xuất đến chẩn đoán hình ảnh. Chẳng hạn, trong sản xuất, việc phát hiện khuyết tật bề mặt trên sản phẩm di chuyển dọc theo băng chuyền phụ thuộc vào model thị giác máy tính có khả năng nhận ra các mẫu tinh vi.
Để các model như vậy hoạt động hiệu quả, chúng cần được huấn luyện bằng dữ liệu đã gắn nhãn, trong đó từng khuyết tật được xác định rõ ràng. Nhờ đó, các model có thể học những gì cần tìm và nhận diện các mẫu tương tự.
Quá trình tạo các nhãn này được gọi là annotation dữ liệu. Cụ thể, annotation hình ảnh và annotation video bao gồm việc vẽ bounding box, phác thảo hình dạng hoặc gắn nhãn các vùng cụ thể trong hình ảnh và khung hình video.
Việc này có thể quản lý được với dataset nhỏ, nhưng nhanh chóng trở nên khó khăn hơn khi dữ liệu tăng lên. Gắn nhãn hàng nghìn hình ảnh đòi hỏi nỗ lực thủ công liên tục, khiến annotation trở thành một nút thắt lớn. Các công cụ truyền thống thường chậm, rời rạc và khó mở rộng.
Ultralytics Platform, nền tảng AI thị giác tất-cả-trong-một, giúp giải quyết những thách thức này bằng tính năng annotation có AI hỗ trợ. Bằng cách sử dụng AI để tự động tạo nhãn ban đầu, sau đó có thể nhanh chóng rà soát và tinh chỉnh, nền tảng giảm công sức thủ công và cải thiện hiệu quả.
Trong bài viết này, chúng ta sẽ tìm hiểu cách annotation có AI hỗ trợ hoạt động trong Ultralytics Platform và cách tính năng này cải thiện quy trình gắn nhãn. Hãy bắt đầu!
Tổng quan về quy trình annotation dữ liệu#
Trước khi tìm hiểu sâu về cách annotation được hỗ trợ bởi AI hoạt động trên Ultralytics Platform, trước tiên hãy cùng xem kỹ hơn về annotation dữ liệu.
Annotation dữ liệu, còn được gọi là gắn nhãn dữ liệu, là quá trình gán nhãn có cấu trúc cho dữ liệu thô để có thể dùng dữ liệu đó huấn luyện các model machine learning. Trong thị giác máy tính, những nhãn này xác định các đối tượng, vùng hoặc đặc trưng cần quan tâm trong hình ảnh hoặc video.
Trong quá trình huấn luyện, model hoặc thuật toán học cách ánh xạ dữ liệu đầu vào với các nhãn này, khiến chất lượng annotation trở thành yếu tố then chốt đối với hiệu suất model. Dataset được gắn nhãn chính xác và nhất quán giúp model học các mẫu đúng, trong khi annotation kém chất lượng hoặc không nhất quán có thể dẫn đến dự đoán không đáng tin cậy.
Ví dụ, trong trường hợp sử dụng phát hiện lỗi, hình ảnh sản phẩm trên băng chuyền có thể được annotation bằng cách đánh dấu vị trí xuất hiện của khuyết tật và gắn nhãn loại khuyết tật. Điều này giúp model học được hình dạng của các khuyết tật để có thể nhận diện chúng trong hình ảnh mới.
Tổng quan về các tác vụ annotation phổ biến#
Tiếp theo, hãy cùng xem một số cách phổ biến để annotation hình ảnh trong thị giác máy tính. Các phương pháp này được dùng để gắn nhãn dữ liệu hình ảnh cho những tác vụ như phát hiện đối tượng, phân đoạn instance và phân loại hình ảnh. Mỗi phương pháp annotation phục vụ một chức năng khác nhau, chẳng hạn như xác định vị trí đối tượng, ghi nhận hình dạng hoặc nhận diện các cấu trúc chính.
Bounding box#
Bounding box là các hình chữ nhật đơn giản được vẽ quanh đối tượng trong hình ảnh để thể hiện vị trí của đối tượng. Đây là một trong những cách gắn nhãn dữ liệu phổ biến nhất trong thị giác máy tính.
Bằng cách huấn luyện trên các hình ảnh có những box này, model phát hiện đối tượng học cách nhận diện các đối tượng khác nhau và xác định vị trí của chúng trong hình ảnh. Nhờ đó, model có thể phát hiện nhiều đối tượng cùng lúc và xác định vị trí xuất hiện của từng đối tượng.
Ví dụ, hãy xem xét một trận bóng chày được phân tích bằng thị giác máy tính. Có thể vẽ box quanh các cầu thủ, gậy và bóng trong từng khung hình, giúp model phát hiện và nhận diện các đối tượng này trong suốt trận đấu.
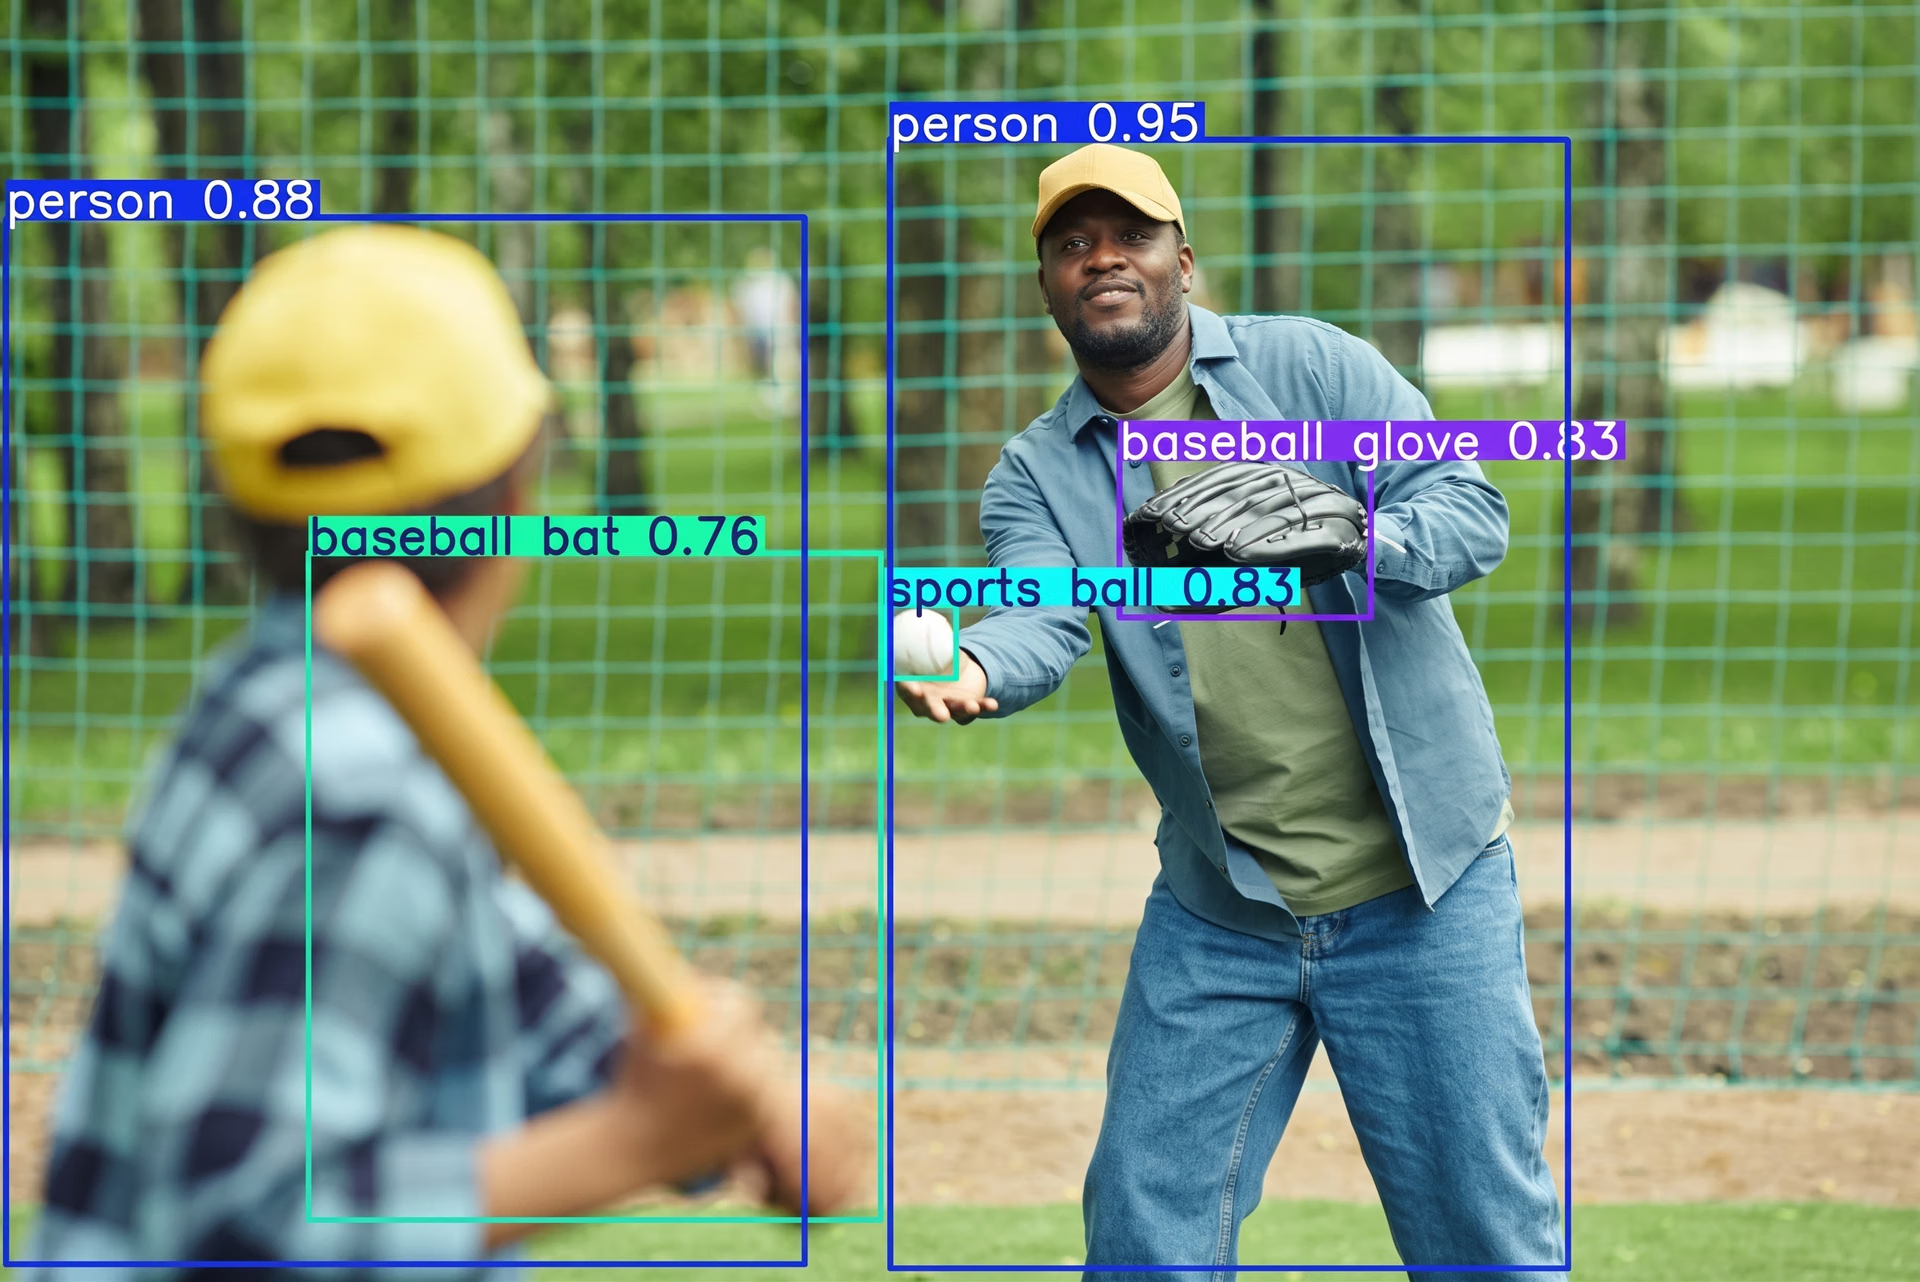
Hình 1. Có thể dùng bounding box để gắn nhãn và xác định vị trí của nhiều đối tượng. (Nguồn)
Đa giác hoặc mask phân đoạn#
Đa giác, còn được gọi là mask phân đoạn, tiến xa hơn bounding box bằng cách gắn nhãn đối tượng ở cấp pixel. Thay vì vẽ một hình chữ nhật gần đúng, chúng thể hiện chính xác hình dạng và đường viền của từng đối tượng trong hình ảnh. Điều này khiến chúng hữu ích cho các tác vụ cần mức độ hiểu chi tiết hơn.
Ví dụ, trong xe tự hành, mask phân đoạn được dùng trong các tác vụ như phân đoạn ngữ nghĩa, trong đó mỗi pixel được gán một loại như đường hoặc bầu trời, và phân đoạn instance, trong đó từng đối tượng riêng lẻ như phương tiện hoặc người đi bộ được nhận diện độc lập.
Chúng cũng được sử dụng cho các tác vụ như xóa nền, trong đó cần tách một đối tượng, chẳng hạn như người, khỏi phần còn lại của hình ảnh.
Keypoint#
Keypoint được dùng để đánh dấu các điểm cụ thể trên một đối tượng, chẳng hạn như khớp trên cơ thể người hoặc các bộ phận của động vật. Bằng cách xác định những điểm này, model có thể hiểu cấu trúc của đối tượng và vị trí tương quan giữa các bộ phận.
Trong thị giác máy tính, kỹ thuật này được gọi là ước tính tư thế (pose estimation), với mục tiêu xác định vị trí của các keypoint và hiểu mối liên hệ giữa chúng. Theo dõi những điểm này theo thời gian giúp phân tích chuyển động và thay đổi tư thế.
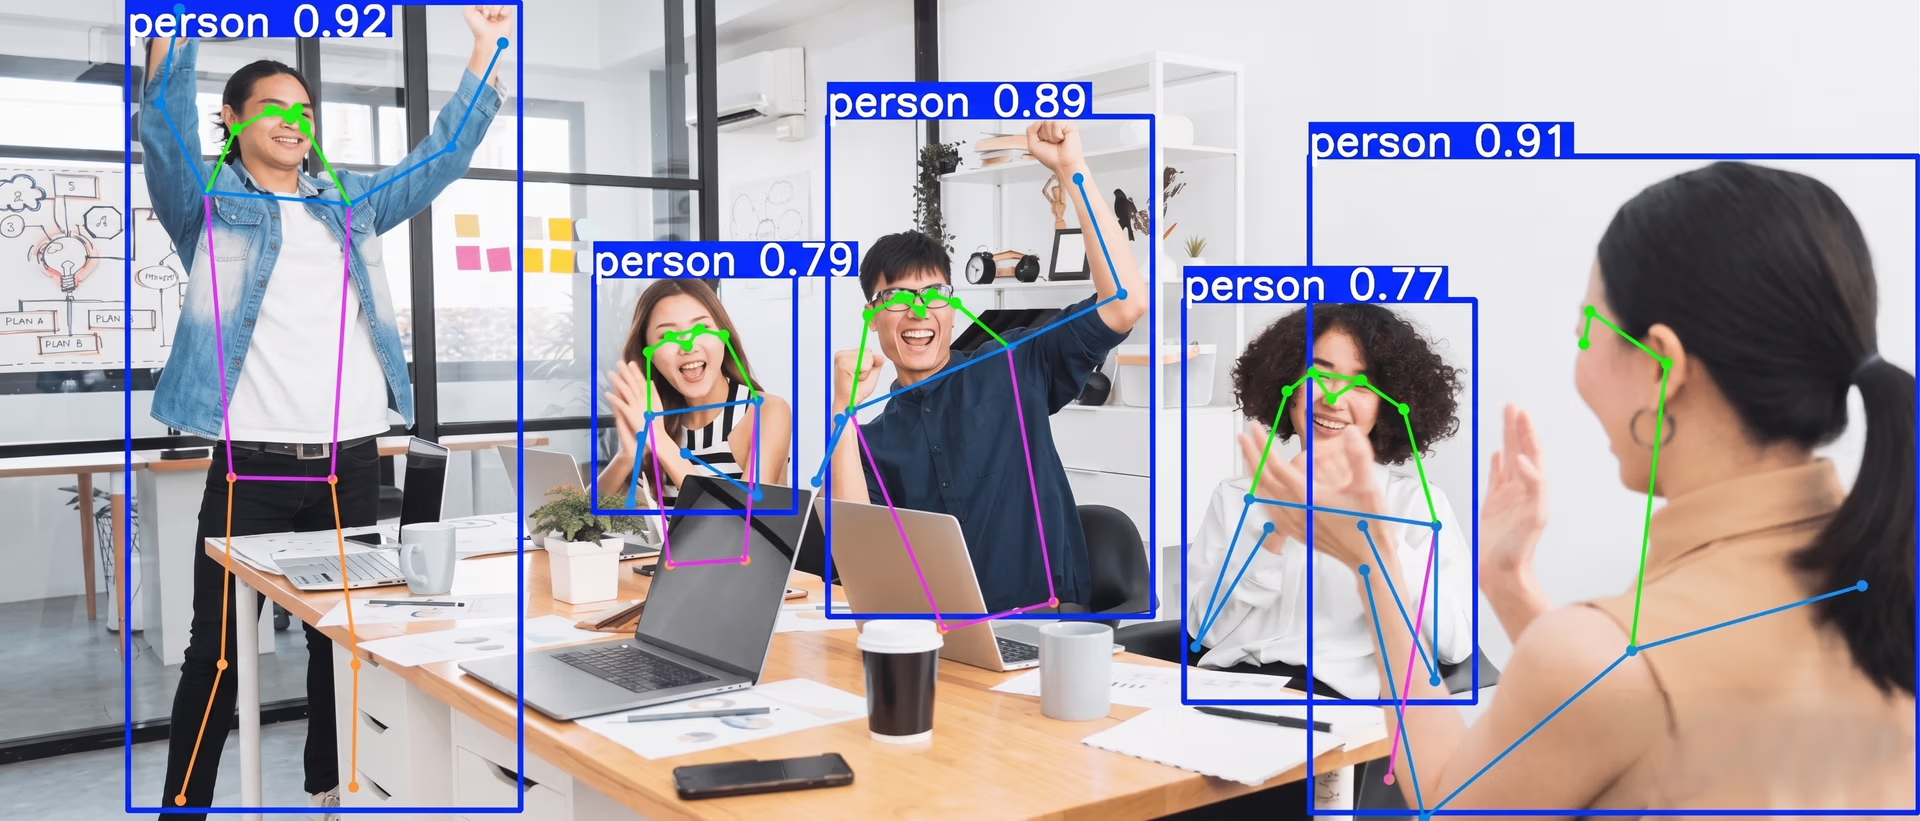
Hình 2. Chú thích keypoint có thể được dùng để đánh dấu khớp nhằm ước tính tư thế người. (Nguồn)
Một ví dụ phổ biến là đánh dấu các khớp trên cơ thể trong video để phân tích chuyển động của con người. Tập trung vào những keypoint này giúp model ghi nhận tư thế của một người và cách tư thế đó thay đổi theo thời gian.
Bounding box định hướng (OBB)#
Không phải mọi đối tượng trong ảnh đều được căn chỉnh hoàn hảo. Trong nhiều tình huống thực tế, đối tượng có thể bị nghiêng, xoay hoặc được nhìn từ nhiều góc độ khác nhau.
Bounding box tiêu chuẩn thường gặp khó khăn trong những trường hợp này vì có thể bao gồm phần nền không cần thiết hoặc không khớp sát với đối tượng. Bounding box định hướng giải quyết vấn đề này bằng cách sử dụng các hình chữ nhật xoay khớp với hướng của đối tượng. Nhờ vậy, chú thích sẽ sát hơn và chính xác hơn.
Cách tiếp cận này được dùng trong tác vụ phát hiện bounding box định hướng (OBB), trong đó model xác định cả vị trí lẫn hướng của đối tượng. Một ví dụ là ảnh chụp từ trên không, nơi các đối tượng như tòa nhà, tàu thuyền hoặc phương tiện thường xuất hiện ở nhiều góc độ khác nhau. Hộp xoay giúp ghi nhận hình dạng và hướng thực tế của chúng trong khung cảnh dễ dàng hơn.
Nhãn phân loại#
Nhãn phân loại áp dụng cách tiếp cận khác với các phương pháp chú thích khác: gán một nhãn duy nhất cho toàn bộ ảnh thay vì đánh dấu các đối tượng hoặc vùng cụ thể. Phương pháp này được dùng khi mục tiêu là xác định nội dung xuất hiện trong ảnh mà không cần quan tâm vị trí của nội dung đó.
Ví dụ, có thể gán nhãn ảnh là “mèo” hoặc “chó” dựa trên nội dung tổng thể. Vì vậy, phân loại ảnh hữu ích cho các tác vụ chỉ cần hiểu khái quát về hình ảnh.
Hạn chế của các công cụ chú thích truyền thống#
Nhiều công cụ gán nhãn truyền thống dựa vào nhiều bước và quy trình rời rạc. Các nhóm phát triển AI thường phải chuyển đổi giữa những nền tảng chú thích khác nhau để gán nhãn, lưu trữ và xác thực dữ liệu, làm chậm tiến độ dự án AI.
Hầu hết công cụ chỉ hỗ trợ một số loại chú thích và kiểu dữ liệu hạn chế, nên các nhóm phải sử dụng nhiều công cụ khác nhau cho bounding box, segmentation và keypoint. Cách thiết lập phân mảnh này có thể khó quản lý, đặc biệt với các nhóm mới làm quen với thị giác máy tính.
Khối lượng công việc thủ công cũng là một thách thức lớn. Dù chỉ mất vài phút để chú thích một ảnh, việc xử lý các dataset lớn nhanh chóng trở nên tốn thời gian, nhất là khi các ảnh tương tự đòi hỏi những thao tác lặp đi lặp lại.
Khi dataset phát triển, các nhóm còn phải quản lý tệp, theo dõi phiên bản dataset và duy trì tính nhất quán giữa các chú thích. Điều này làm tăng khối lượng công việc, khiến họ mất nhiều thời gian hơn cho việc quản lý dữ liệu và ít thời gian hơn để cải thiện hiệu suất model.
Một cách tiếp cận hiệu quả hơn là sử dụng tính năng chú thích có AI hỗ trợ trong Ultralytics Platform. Tính năng này dùng AI để tạo và tinh chỉnh nhãn, giảm công sức thủ công đồng thời cải thiện tốc độ và tính nhất quán, tất cả trong một môi trường duy nhất kết hợp quản lý dataset, chú thích, huấn luyện model, triển khai và giám sát.
Cách Ultralytics Platform hỗ trợ quy trình chú thích#
Ultralytics Platform đơn giản hóa việc chú thích bằng cách kết nối trực tiếp quy trình này với các phần còn lại của workflow thị giác máy tính. Thay vì phụ thuộc vào các công cụ riêng biệt, các nhóm có thể làm việc với dữ liệu, chú thích và model trong cùng một môi trường.
Nền tảng hỗ trợ nhiều tác vụ thị giác máy tính, bao gồm phát hiện đối tượng, phân loại ảnh, segmentation instance, ước tính tư thế và phát hiện bounding box định hướng.
Trong quy trình này, có thể thực hiện chú thích theo nhiều cách. Các nhóm có thể gán nhãn dữ liệu thủ công để kiểm soát hoàn toàn, sử dụng tính năng chú thích thông minh dựa trên SAM để gán nhãn tương tác bằng các điểm hoặc dùng tính năng chú thích thông minh dựa trên YOLO để tự động tạo chú thích rồi rà soát, tinh chỉnh. Tính linh hoạt này giúp xử lý nhiều dataset và yêu cầu chú thích khác nhau dễ dàng hơn.
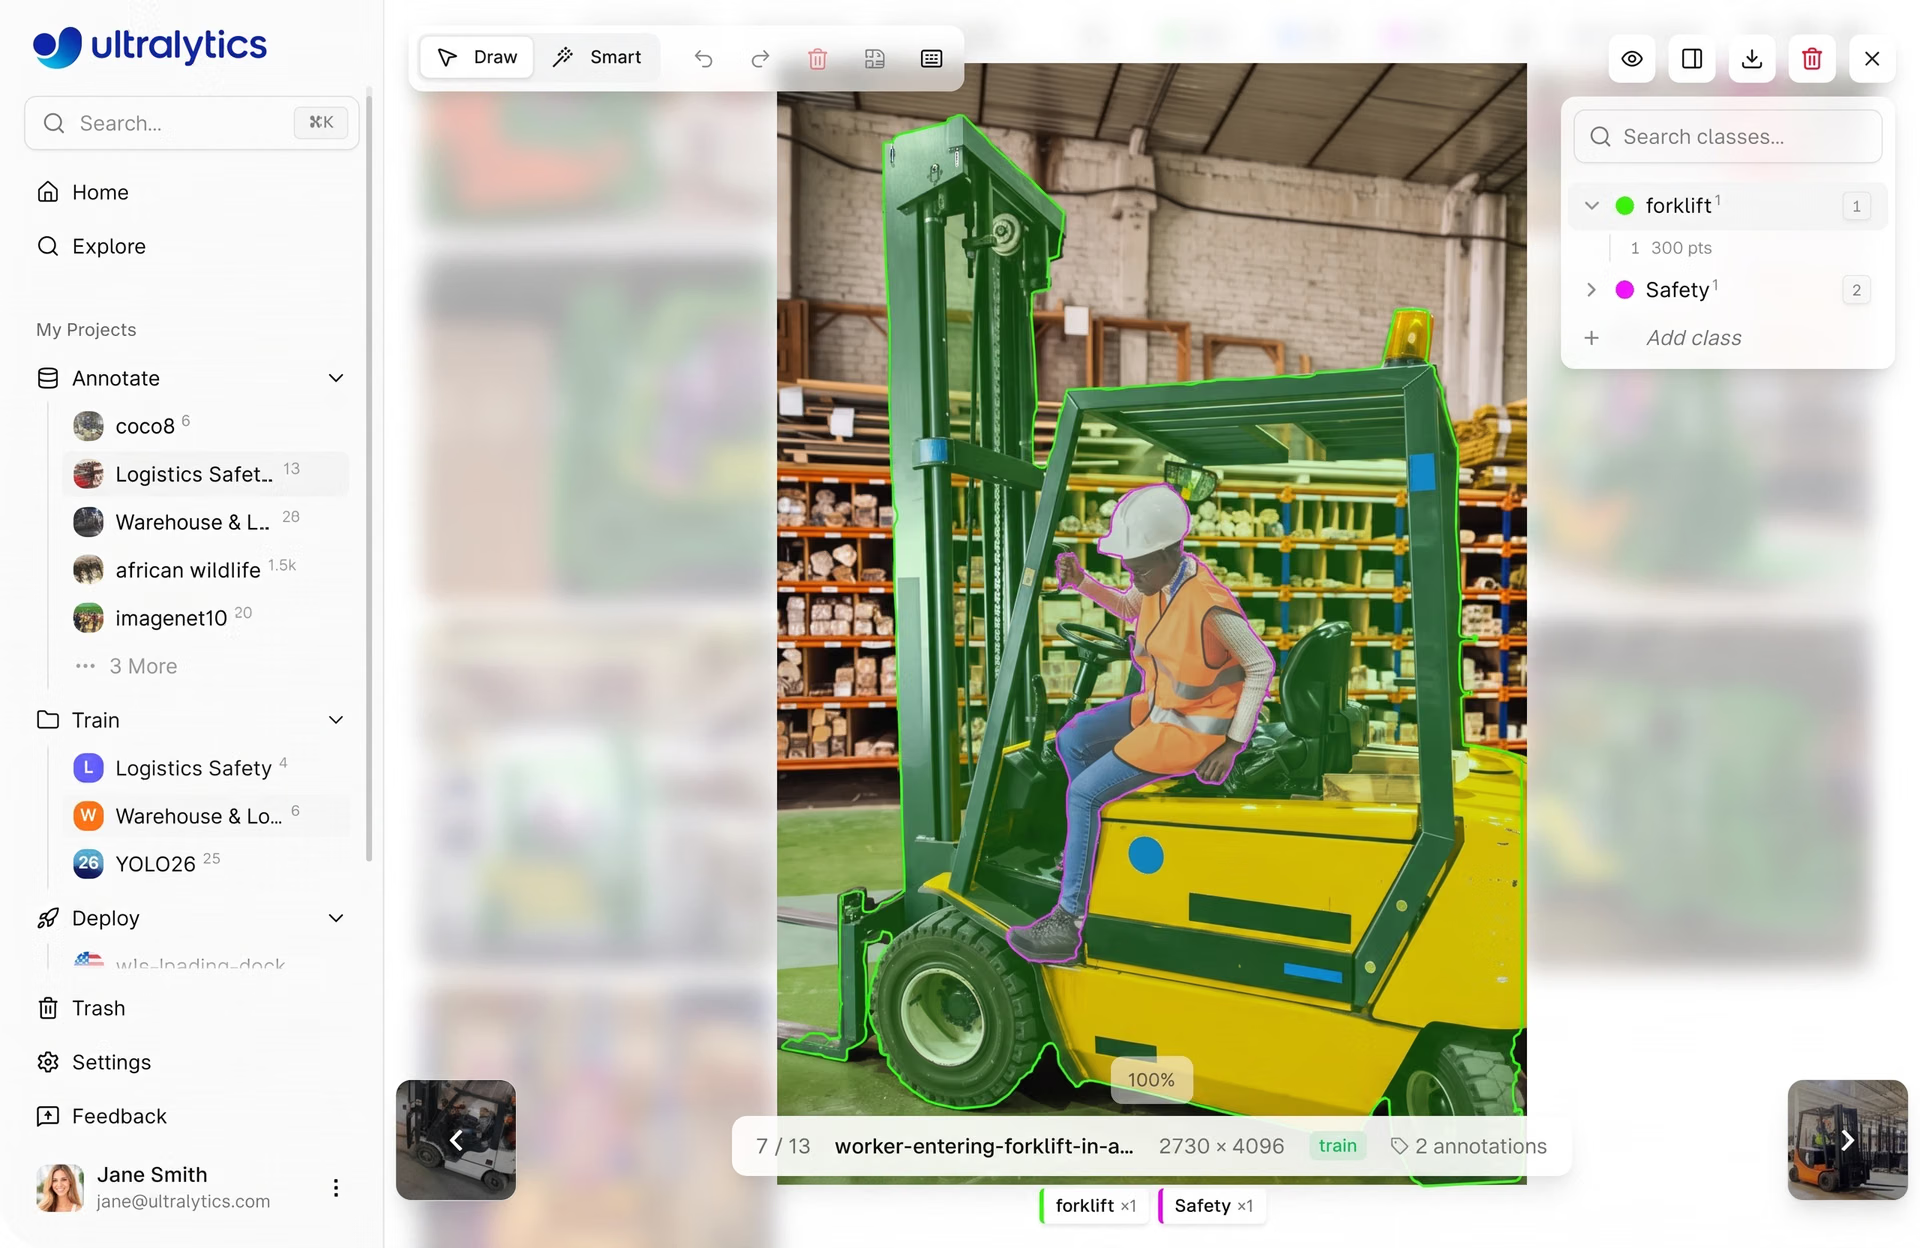
Hình 3. Tổng quan về tính năng chú thích trong Ultralytics Platform (Nguồn)
Vì tính năng chú thích thủ công và có AI hỗ trợ được tích hợp với quản lý dataset và huấn luyện model, các nhóm có thể chuyển liền mạch từ gán nhãn dữ liệu sang sắp xếp dataset và huấn luyện model. Nhờ đó, workflow luôn có cấu trúc và không cần chuyển đổi giữa các công cụ hoặc định dạng lại chú thích.
Nền tảng cũng hỗ trợ các model Ultralytics YOLO như Ultralytics YOLO11 và Ultralytics YOLO26, cho phép sử dụng trực tiếp dữ liệu đã chú thích để huấn luyện và kiểm thử. Nhờ vậy, việc xác định thiếu sót trong dataset, tinh chỉnh chú thích và huấn luyện lại model qua các vòng lặp liên tục trở nên dễ dàng hơn.
Các tính năng chính của tính năng chú thích thông minh bằng SAM trên Ultralytics Platform#
Tính năng chú thích thông minh dựa trên SAM trong Ultralytics Platform được thiết kế để tăng tốc chú thích cho các tác vụ phát hiện đối tượng, segmentation instance và bounding box định hướng (OBB).
Nền tảng cung cấp nhiều phiên bản model SAM, gồm SAM 2.1 Tiny, SAM 2.1 Small, SAM 2.1 Base, SAM 2.1 Large và SAM 3, cho phép người dùng lựa chọn giữa tốc độ và độ chính xác.
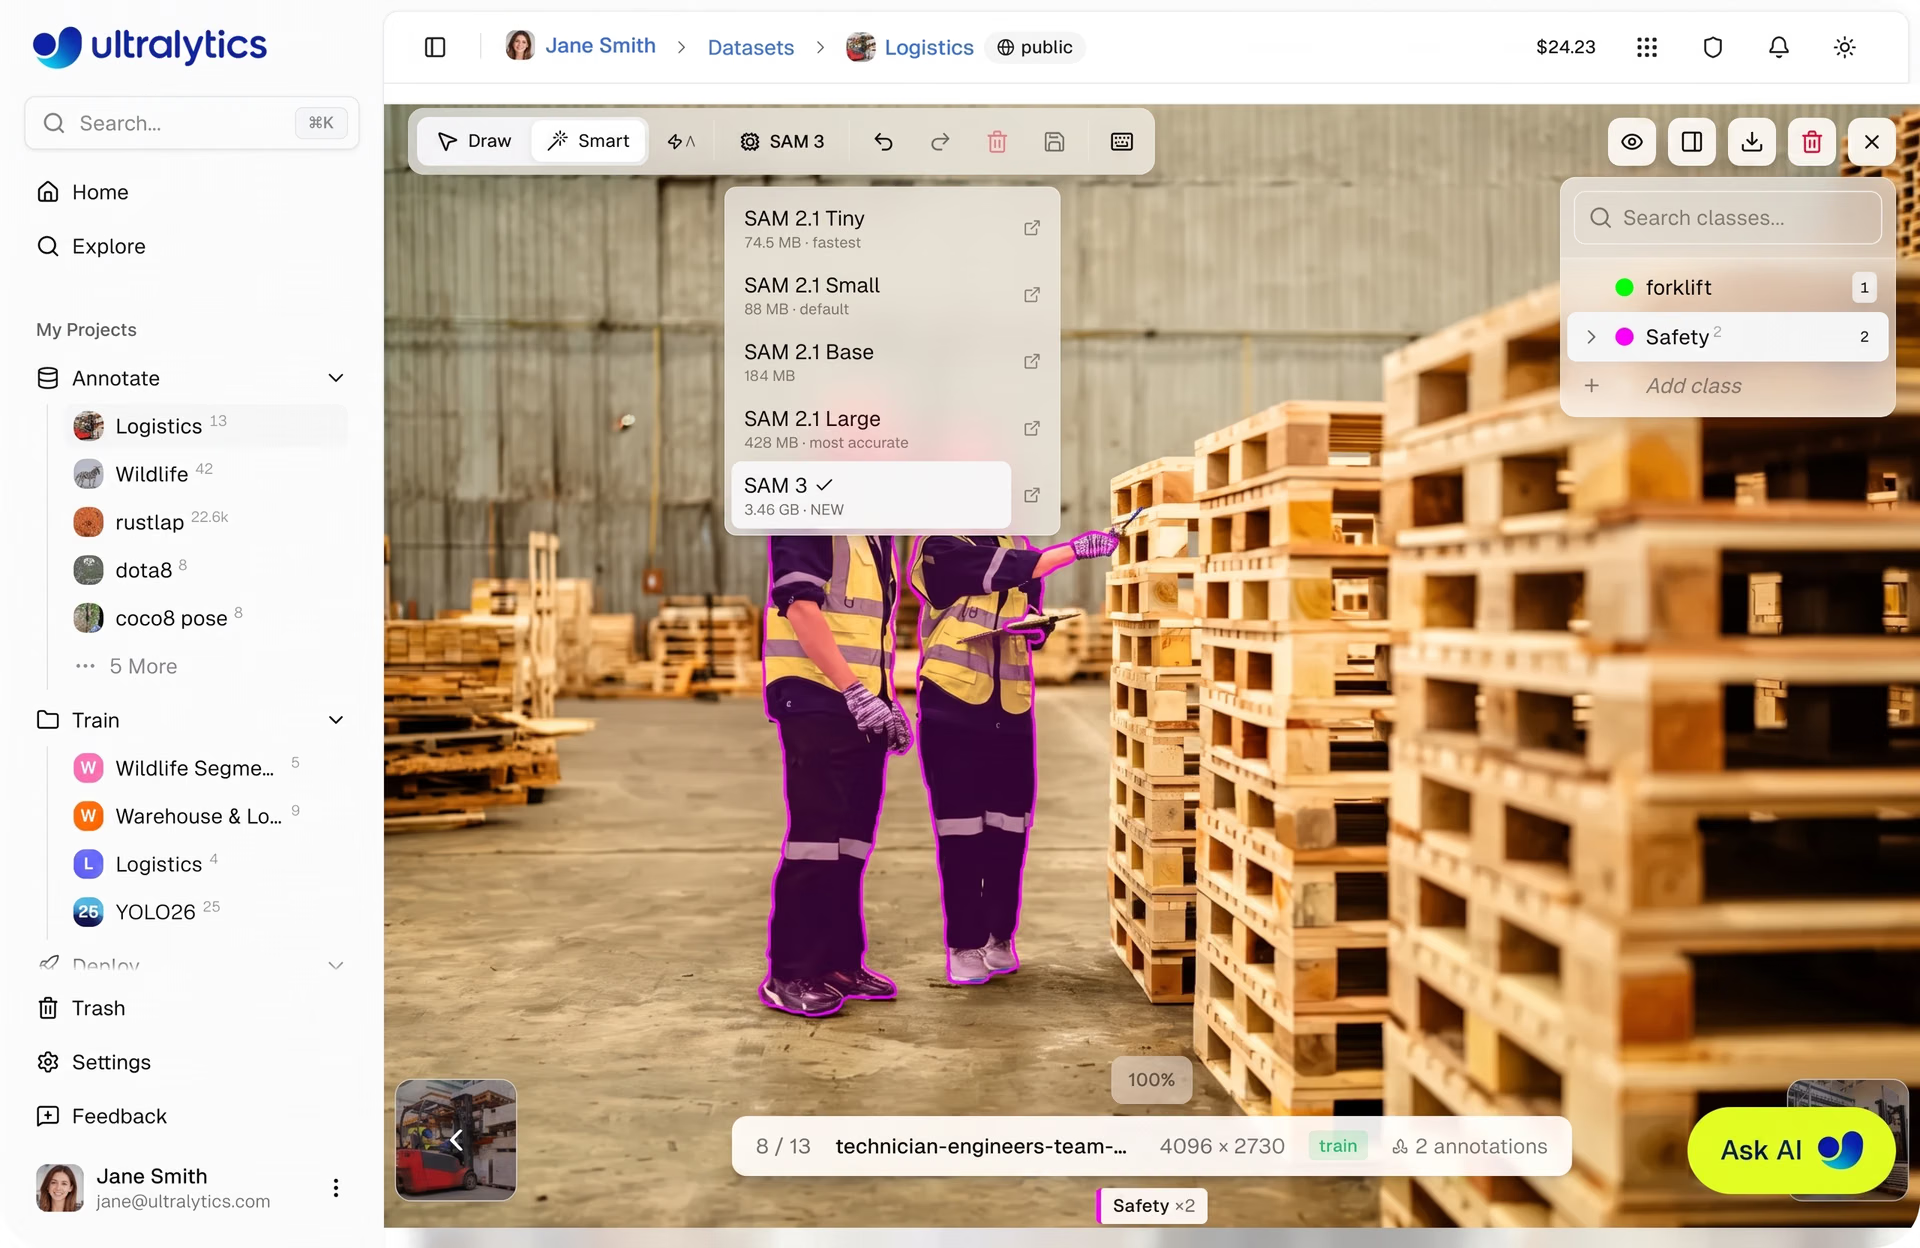
Hình 4. Tính năng chú thích thông minh dựa trên SAM trong Ultralytics Platform (Nguồn)
Các model nhỏ hơn như Tiny và Small chạy nhanh hơn, phù hợp với workflow chú thích nhanh, trong khi các model lớn hơn như Large và SAM 3 cho độ chính xác cao hơn trong những khung cảnh phức tạp. Việc chuyển đổi model sẽ cập nhật ngay cách thức chú thích.
Trong trình chỉnh sửa chú thích, sau khi chọn model SAM, người gán nhãn có thể chuyển sang chế độ Smart để bắt đầu gán nhãn. Thay vì tự vẽ hình, người dùng hướng dẫn model bằng các điểm nhập đơn giản.
Nhấp chuột trái để thêm điểm dương tính nhằm đưa một vùng vào, còn nhấp chuột phải để thêm điểm âm tính nhằm loại trừ vùng không mong muốn. Dựa trên các điểm nhập này, model tạo mask chính xác theo thời gian thực.
Để tăng tốc workflow, có thể bật chế độ tự động áp dụng. Khi bật chế độ này, mỗi lần nhấp sẽ tự động tạo và lưu chú thích mà không cần xác nhận thủ công. Với các đối tượng phức tạp hơn, người gán nhãn có thể giữ phím "Shift" để đặt nhiều điểm trước khi áp dụng mask, hoặc tắt chế độ tự động áp dụng để tự do thêm điểm rồi nhấn "Enter" để áp dụng mask.
Tìm hiểu tính năng chú thích thông minh bằng YOLO trên Ultralytics Platform#
Tương tự tính năng chú thích thông minh dựa trên SAM, tính năng chú thích thông minh bằng YOLO trên Ultralytics Platform sử dụng AI để tăng tốc quá trình gán nhãn. Thay vì hướng dẫn model bằng các lần nhấp chuột, tính năng này sử dụng dự đoán của model để tự động tạo chú thích.
Cách tiếp cận này hỗ trợ các tác vụ như phát hiện đối tượng, segmentation instance và chú thích bounding box định hướng (OBB). Tính năng này hoạt động cụ thể với các model Ultralytics YOLO, bao gồm model pretrained do Ultralytics cung cấp và model YOLO được huấn luyện tùy chỉnh.
Trong trình chỉnh sửa chú thích, người gán nhãn có thể chuyển sang chế độ Smart, chọn model YOLO từ bộ chọn model rồi nhấp vào Predict. Bộ chọn model chỉ hiển thị các model YOLO phù hợp với tác vụ của dataset hiện tại, đảm bảo chú thích được tạo ra tương thích.
Model phân tích ảnh và tạo chú thích dựa trên các dự đoán, sau đó thêm trực tiếp vào ảnh. Nếu dự đoán trùng lặp với chú thích hiện có cùng lớp, các phát hiện trùng lặp sẽ tự động bị bỏ qua khi mức độ chồng lấn vượt ngưỡng đã đặt, giúp duy trì nhãn sạch và nhất quán.
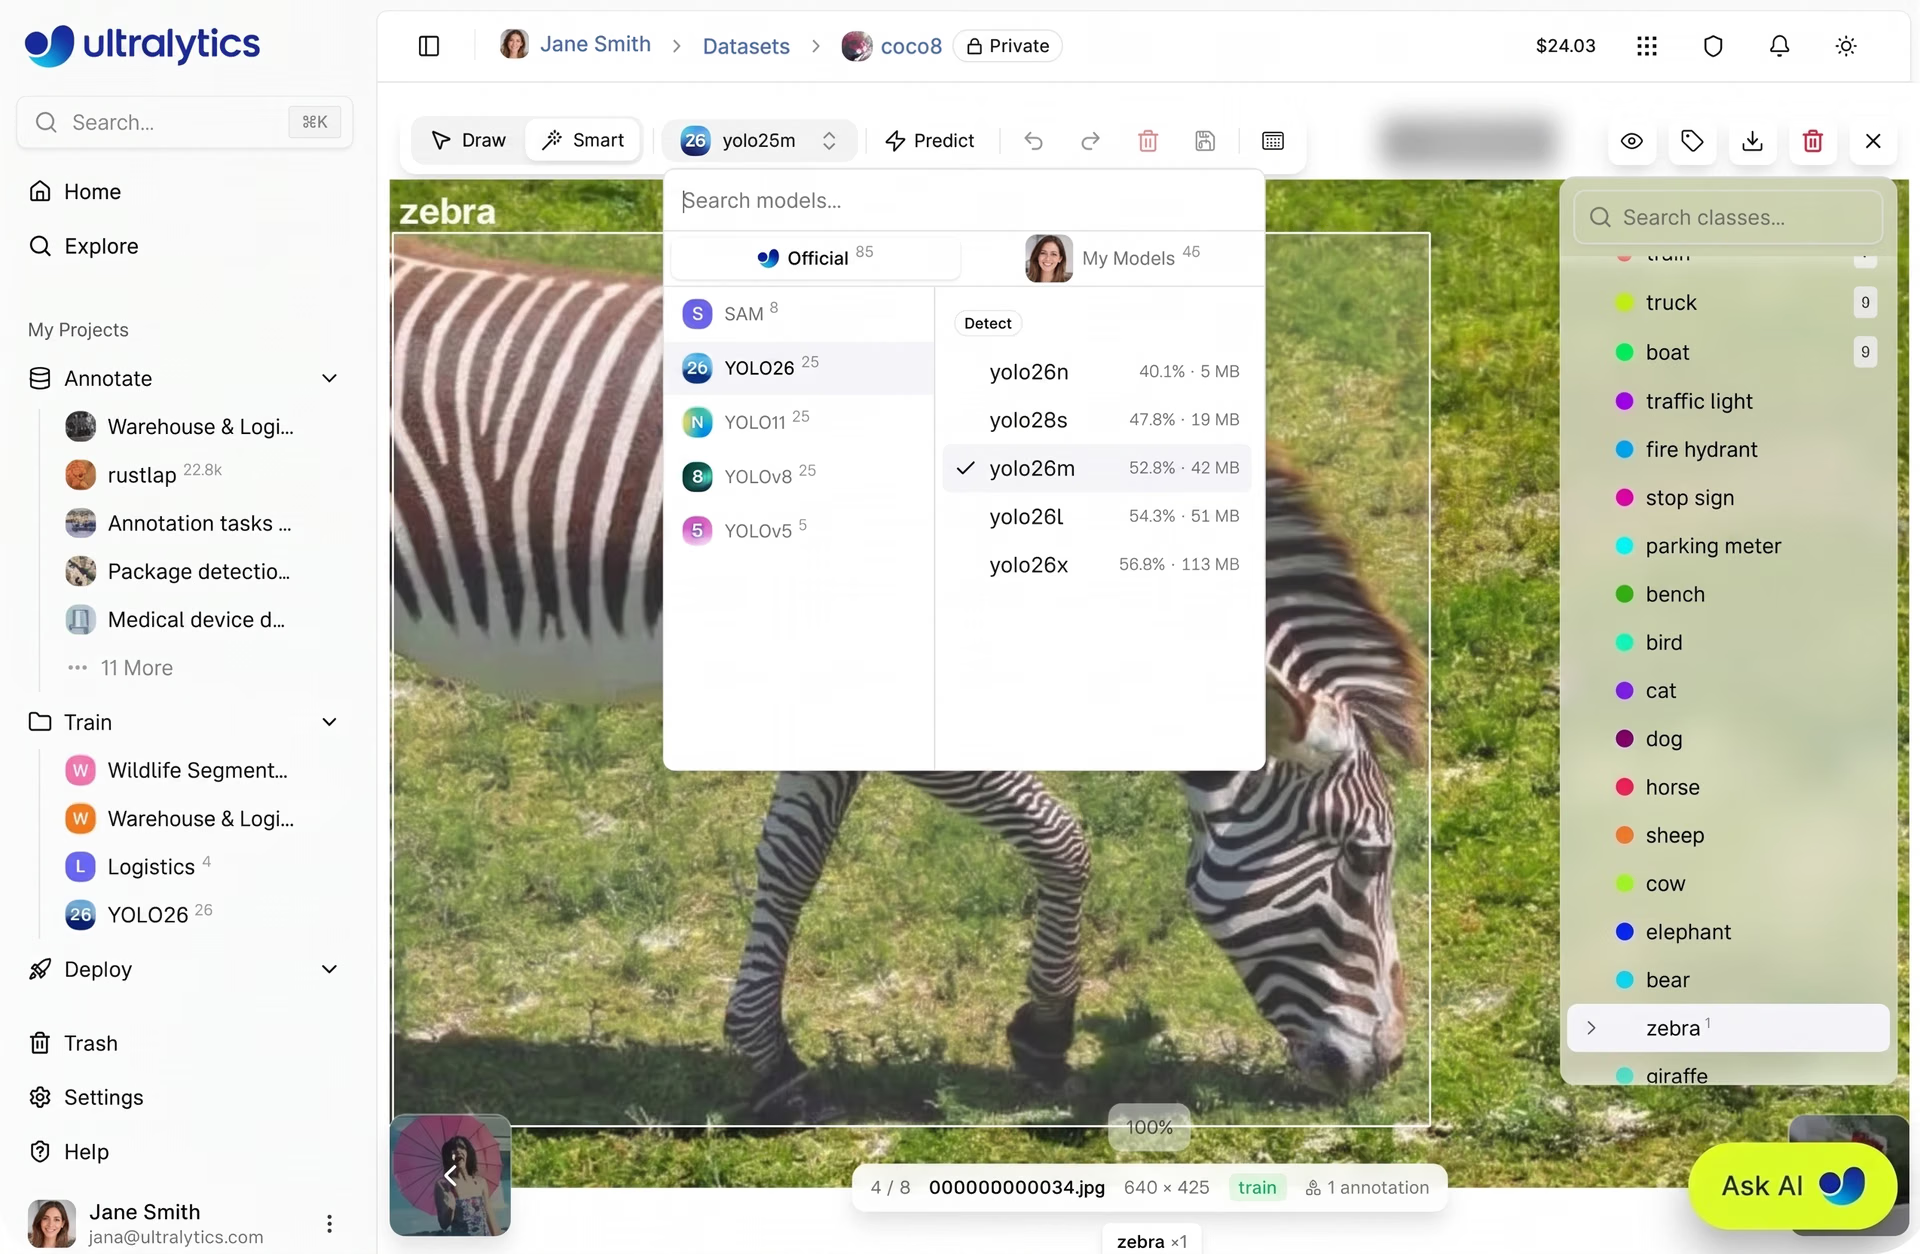
Hình 5. Tính năng chú thích thông minh trên Ultralytics Platform được hỗ trợ bởi các model Ultralytics YOLO (Nguồn)
Sau khi tạo dự đoán, người gán nhãn trong quy trình human-in-the-loop có thể rà soát, điều chỉnh hoặc xóa dự đoán khi cần. Nhờ bắt đầu bằng chú thích do model tạo rồi tinh chỉnh thay vì chú thích mọi thứ thủ công, việc gán nhãn nhanh cho dataset lớn trở nên dễ dàng hơn.
Theo thời gian, có thể tái sử dụng các model YOLO đã cải thiện để tạo dự đoán tốt hơn, hỗ trợ workflow tự động gán nhãn theo vòng lặp.
Áp dụng gán nhãn có AI hỗ trợ trong các pipeline thực tế#
Tiếp theo, hãy xem các ví dụ về cách Ultralytics Platform hỗ trợ chú thích dữ liệu trong những trường hợp sử dụng thực tế.
Segmentation trong xe tự hành#
Xe tự hành tích hợp các model thị giác máy tính dựa vào dữ liệu hình ảnh được chú thích kỹ lưỡng để hiểu môi trường xung quanh theo thời gian thực. Các model được huấn luyện trên dữ liệu này có thể phát hiện và phân đoạn phương tiện, người đi bộ, biển báo giao thông và ranh giới đường.
Các tác vụ segmentation đòi hỏi ranh giới chính xác đến từng pixel, khiến việc chú thích vừa thiết yếu vừa tốn thời gian. Gán nhãn thủ công lượng lớn dữ liệu cảm biến có thể nhanh chóng trở thành nút thắt cổ chai, nhất là trong các cảnh lái xe phức tạp.
Ultralytics Platform tinh giản quy trình này bằng tính năng chú thích có AI hỗ trợ, sử dụng cả model SAM và YOLO. Tính năng chú thích thông minh dựa trên SAM cho phép segmentation nhanh bằng thao tác nhấp chuột, tạo mask chính xác; trong khi đó, model YOLO có thể tự động tạo chú thích cho nhiều ảnh.
Kết hợp lại, các phương pháp này giúp xử lý những khung cảnh phức tạp có các đối tượng chồng lấn dễ dàng hơn.
Vì chú thích được kết nối trực tiếp với quá trình huấn luyện model, có thể dùng ngay các dataset quy mô lớn đã cập nhật để huấn luyện lại và đánh giá model. Nhờ đó, các nhóm có thể liên tục cải thiện hiệu suất và thích ứng hiệu quả hơn với điều kiện lái xe mới.
Nâng cao hệ thống đảm bảo chất lượng trong sản xuất#
Trong sản xuất, việc duy trì kiểm soát chất lượng nhất quán phụ thuộc vào khả năng phát hiện lỗi chính xác trong quá trình sản xuất. Model thị giác máy tính thường được dùng để xác định vấn đề theo thời gian thực, nhưng hiệu suất của chúng phụ thuộc vào mức độ phản ánh chính xác điều kiện sản xuất thực tế của dữ liệu huấn luyện.
Những thay đổi trong môi trường sản xuất, chẳng hạn như biến động về nguyên liệu thô, thiết lập máy móc hoặc ánh sáng, có thể tạo ra các loại lỗi mới và hiếm gặp vốn không có trong dữ liệu huấn luyện ban đầu. Điều này tạo ra khoảng cách giữa những gì model đã học và những gì xuất hiện trên dây chuyền sản xuất.
Để duy trì tính phù hợp, cần thường xuyên cập nhật dataset bằng các chú thích chất lượng cao do nội bộ tạo. Ultralytics Platform giúp dễ dàng cập nhật chú thích và mở rộng dataset khi xuất hiện các dạng lỗi mới. Sau đó, có thể dùng các dataset đã cập nhật để huấn luyện lại model, giúp các nhóm thích ứng nhanh hơn với điều kiện sản xuất thay đổi.
Giám sát công trường và an toàn trong xây dựng#
Công trường xây dựng là môi trường biến động, có nhiều nhóm làm việc, thiết bị di chuyển và bố cục liên tục thay đổi. Việc duy trì an toàn trong những điều kiện này phụ thuộc vào dữ liệu hình ảnh rõ ràng, được chú thích kỹ lưỡng.
Chú thích chính xác có thể nâng cao chất lượng dữ liệu và giúp hệ thống AI nhận diện công nhân, thiết bị, đồ bảo hộ và các nguy cơ tiềm ẩn trong nhiều điều kiện công trường, bao gồm cảnh đông đúc, hậu cảnh thay đổi và ánh sáng khác nhau.
Ultralytics Platform hỗ trợ việc này bằng cách giúp cập nhật và tinh chỉnh chú thích dễ dàng khi điều kiện tại công trường thay đổi. Có thể thu thập ảnh mới và thêm vào dataset khi chúng xuất hiện, giúp dataset luôn phù hợp với tình huống thực tế.
Điểm chính cần ghi nhớ#
Chú thích chất lượng cao là yếu tố thiết yếu để xây dựng các model thị giác máy tính và AI đáng tin cậy, nhưng workflow truyền thống thường làm chậm tiến độ của các nhóm. Ultralytics Platform tinh giản quy trình này bằng các công cụ chú thích tự động và workflow có khả năng mở rộng. Nhờ đó, các nhóm có thể chuyển nhanh hơn từ dữ liệu sang model mà vẫn duy trì độ chính xác và tính nhất quán.
Hãy xem cộng đồng đang phát triển và repository GitHub của chúng tôi để tìm hiểu thêm về thị giác máy tính. Nếu bạn muốn xây dựng các giải pháp thị giác, hãy xem các tùy chọn cấp phép của chúng tôi. Khám phá các trang giải pháp để tìm hiểu thêm về lợi ích của thị giác máy tính trong sản xuất và AI trong chăm sóc sức khỏe.








